SEO e GEO para quem decide · Capítulo 30 de 30 · 20 min
Aprofundamento: quando automatizar a operação com agentes
Quando uma chamada simples resolve e quando vale montar agentes, com o nível de modelo certo para cada tarefa.
Este capítulo faz parte do curso gratuito SEO e GEO para quem decide.
Neste aprofundamento, decida se um fluxo de conteúdo ou de pesquisa justifica montar agentes de IA e peça a quem opera o único número que sustenta a decisão: a taxa de aprovação de primeira do modelo mais barato naquela tarefa.
Exemplo: o time propõe montar cinco agentes, um para pesquisar, um para escrever, um para revisar, um para otimizar e um para publicar, para produzir quatro artigos por mês.
A decisão é aprovar ou recusar a montagem de um conjunto de agentes, e o critério é volume repetido, tarefas de tipos diferentes no mesmo fluxo e dono nomeado para manter. Errar custa nos dois sentidos: lote grande rodando no modelo mais caro por descuido, ou texto institucional publicado com dado inventado pelo mais barato. A pergunta para quem opera: qual é a taxa de aprovação de primeira do nível barato nesta tarefa, medida em quantos itens?
Agente de IA é um programa que recebe um objetivo, divide em passos, usa ferramentas e decide sozinho o passo seguinte, como você viu na etapa 5. Orquestração é pôr vários deles para trabalhar em sequência, com uma regra que diz qual recebe cada tarefa.
Quatro artigos por mês não pedem cinco agentes. Volume baixo e tarefa que não se repete resolvem com uma chamada direta a um modelo e uma pessoa revisando, e o tempo de engenharia para montar e manter o conjunto passaria do tempo economizado.
Orquestrar ou fazer uma chamada só?
Chamada única basta
Condições que dispensam pipeline
- Volume baixo e tarefa que não se repete.
- O tempo de engenharia para montar o pipeline supera o custo de fazer manualmente.
- Relatório mensal produzido 12 vezes por ano, que não justifica roteamento com fallback, cache e observabilidade.
- Ninguém precisará auditar depois qual executor produziu qual trecho.
Orquestração paga o próprio custo
Condições que justificam pipeline
- Volume repetitivo em lote, onde a economia unitária multiplicada pelo volume supera o custo de manutenção.
- Heterogeneidade real dentro do mesmo fluxo: pesquisa, extração e redação numa mesma rodada, com propriedades diferentes.
- Necessidade de auditoria, quando é preciso saber depois qual executor produziu qual trecho e a que custo.
- Passivo a contabilizar desde o dia um: cada orquestração é código que quebra quando um fornecedor muda o formato da API, como a Perplexity fez ao aposentar o Sonar em 27/09/2026.
Quando o fluxo justifica, a regra que decide qual modelo recebe cada tarefa precisa ser escrita pela natureza da tarefa, e não pela marca do modelo. Três propriedades classificam qualquer tarefa. A tolerância a erro: um título mal etiquetado num lote de milhares some no meio; uma afirmação errada na página institucional custa credibilidade. O custo de verificar: um formato fechado se confere por máquina; uma tabela de números com fonte exige conferir cada fonte. E o valor do acerto: milhares de classificações corretas pagam o pipeline, um parágrafo de posicionamento bem feito pode pagar o mês.
Ver como texto
Espaço de decisão de roteamento em dois eixos, sem citar nenhum nome de modelo, com os quatro quadrantes empilhados. Um eixo é o custo de verificar a saída, de baixo a alto; o outro é a consequência do erro, de baixa a alta. Consequência baixa e custo de verificar baixo: volume barato com verificação amostral, exemplificado por classificar intenção de 40 mil títulos de URL, com regra de mais barato disponível e sem escalonamento. Consequência baixa e custo de verificar alto: barato mas confiando no verificador e não no modelo, exemplificado por sumarizar 500 páginas concorrentes, com regra de barato mais verificador. Consequência alta e custo de verificar baixo: caro por chamada com verificação automática obrigatória, exemplificado por gerar JSON-LD validado contra schema, com regra de melhor disponível mais validador e até dois escalonamentos. Consequência alta e custo de verificar alto: revisão humana no caminho crítico, exemplificado por copy institucional com afirmação factual sobre o cliente, com regra de melhor disponível mais humano e sem escalonamento.
Qual executor recebe esta tarefa?
Eixo horizontal: Custo de verificar a saída (barato à esquerda, caro à direita)Eixo vertical: Consequência do erro (alta em cima, baixa embaixo)
Nível barato com verificador determinístico obrigatório
- JSON-LD que precisa validar contra schema antes de publicar
- Extração de campos de uma resposta, com formato fechado
- O verificador carrega o rigor, então escalone no máximo duas vezes
Nível alto direto, com revisão humana antes de publicar
- Página institucional de cliente do setor de saúde
- Afirmação factual com número que vai para a home
- Aqui o verificador é uma pessoa, e o tempo dela é o recurso caro do sistema
Nível barato, sem escalonamento
- Classificação de intenção de busca em lote de milhares
- Geração de 300 meta descriptions de páginas de produto
- Verificação amostral resolve, e o próximo passo do pipeline absorve o erro residual
Nível médio com amostragem ampliada
- Resumos internos de reunião que ninguém vai conferir linha a linha
- Rascunho de pauta cujo erro só custa tempo de quem lê
- O quadrante que engana: consequência baixa convida a ignorar, e a verificação cara faz o erro sobreviver
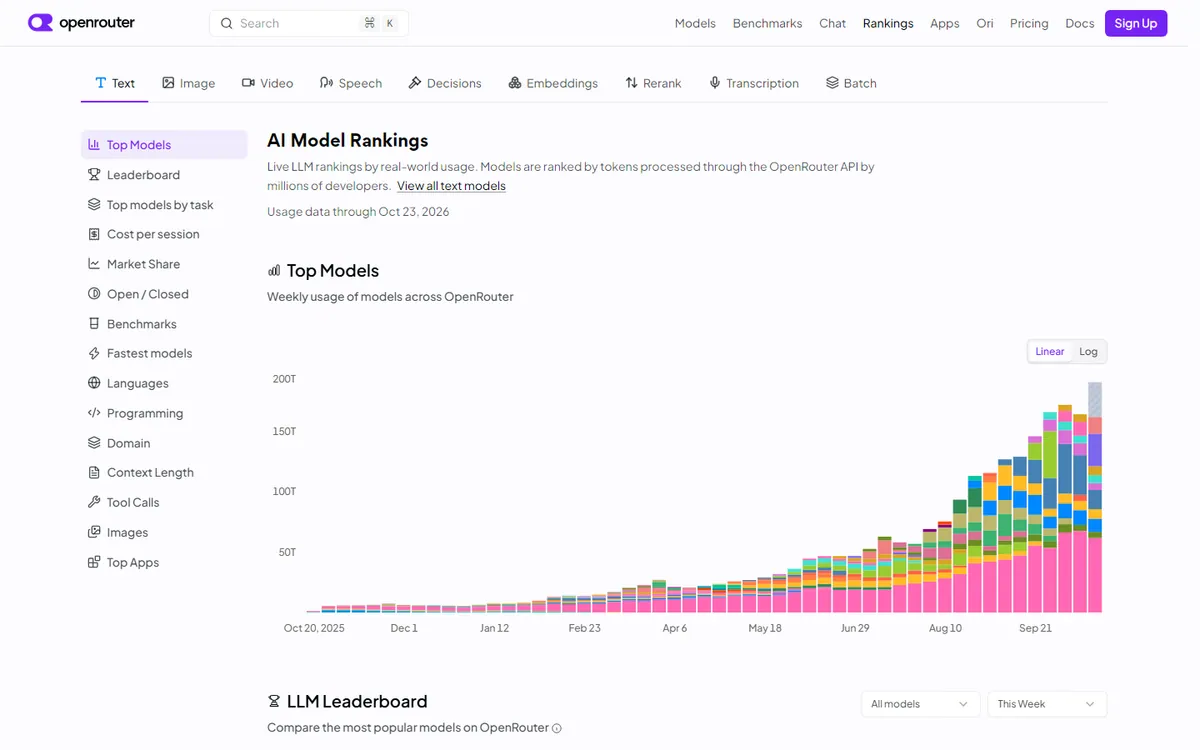
O catálogo de modelos envelhece em meses, e o ranking público de uso mostra isso a olho nu. Por isso a política fica com os níveis (barato, médio, alto, pesquisa) e os nomes de modelo moram num único bloco datado, o único ponto que muda quando o mercado se mexe.
Ver como texto
Página de rankings do OpenRouter com o gráfico de barras empilhadas "Top Models", que mostra o uso semanal de modelos de outubro de 2025 a outubro de 2026, com dados até 23 de outubro de 2026 e o volume subindo de perto de zero para cerca de 190 trilhões de tokens por semana.
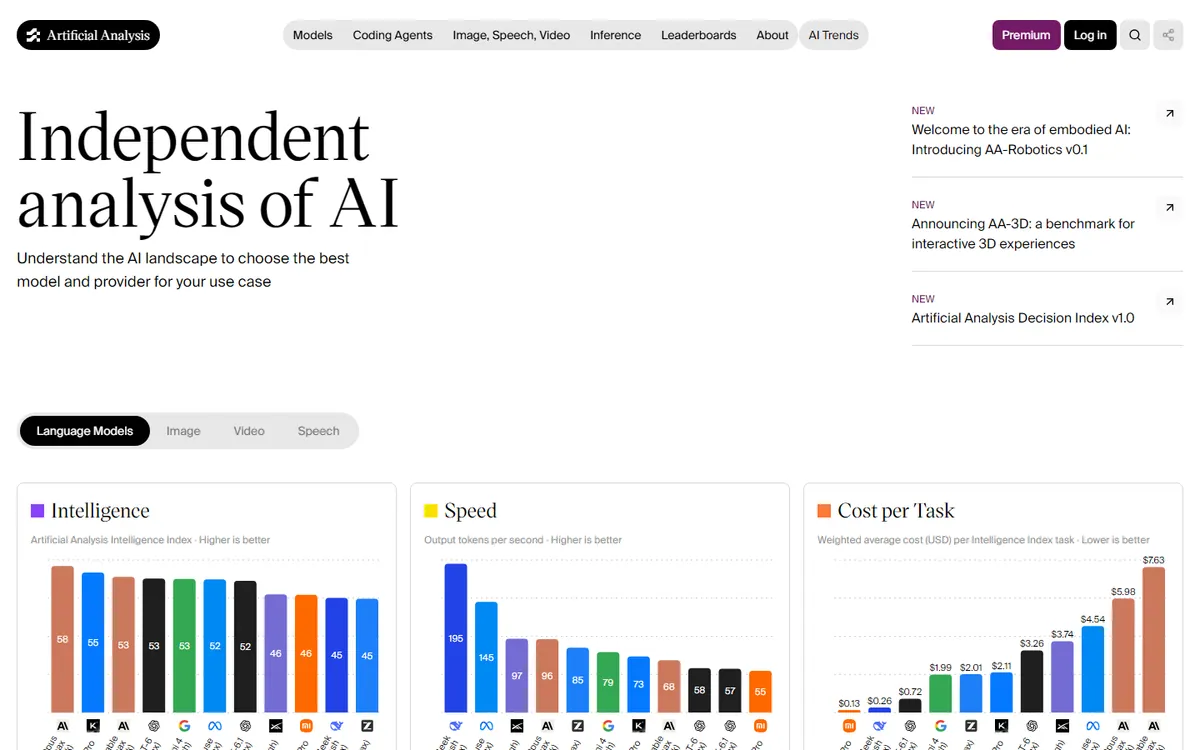
A diferença de preço entre níveis é o que justifica a regra. Nas comparações públicas de preço e qualidade, os modelos mais capazes estão entre os mais caros por tarefa, numa distância de dezenas de vezes. Mandar a tarefa simples para o nível barato e reservar o caro para o que falha na primeira tentativa é onde está a economia, desde que a taxa de reprovação do barato seja medida.
Ver como texto
Página inicial da Artificial Analysis com três gráficos de barras lado a lado para modelos de linguagem: Intelligence (índice de inteligência), Speed (tokens por segundo) e Cost per Task (custo médio por tarefa em dólares, de 0,13 a 7,63).
| Nível | Exemplo na fotografia | Data e fonte | O que muda na política |
|---|---|---|---|
| Barato, alto volume | Gemini 3.5 Flash, padrão do Modo IA gratuito | Google, 20/05/2026 | Nada; a regra de volume continua apontando para o nível barato |
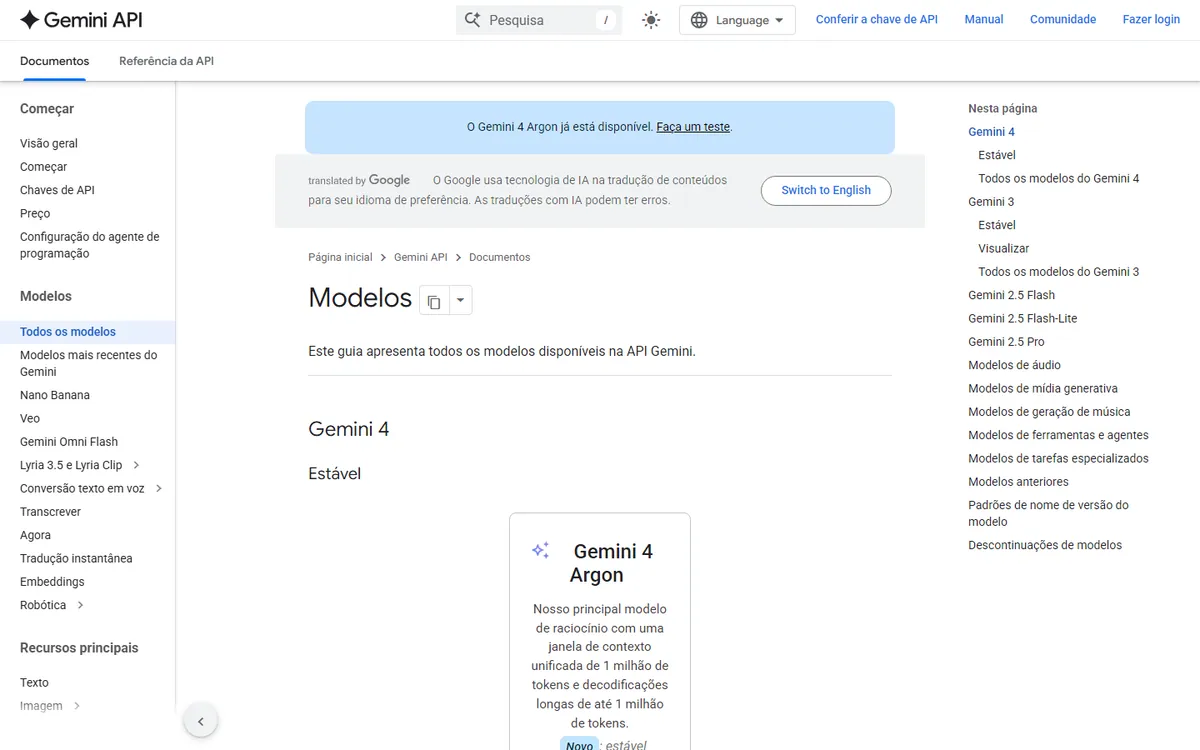
| Alto, raciocínio | Gemini 4 Argon, no Modo IA só para assinantes Pro e Ultra e na API Gemini | Search Engine Journal, 13/10/2026 (jornalística), e documentação de modelos da API Gemini | Nada na regra; a medição de citação no Modo IA passa a declarar se o modelo é o padrão ou o de assinante |
| Alto, raciocínio | GPT-6.1 Sol | DevDay da OpenAI, 29/09/2026, via InfoQ e Axios (jornalísticas) | Nada na regra; o nome entra só neste bloco |
| Barato, médio e alto | Claude Haiku 5.5, Sonnet 5.5 e Opus 5.5 | Anthropic, de 22/09 a 07/10/2026, notas de versão da plataforma (conferência jornalística) | Nada na regra; a família cobre os três níveis e a troca é de uma linha |
| Pesquisa com fontes | Perplexity Agent API, sucessora do Sonar | Perplexity, Sonar aposentado em 27/09/2026 | O alias de pesquisa já precisa apontar para a Agent API |
Sem preços nesta fotografia: confira a tabela oficial de cada fornecedor no dia da decisão. A coluna da direita é a prova de que a política por propriedade sobrevive: cinco mudanças de catálogo em cinco meses e nenhuma regra alterada.
Ver como texto
Documentação "Modelos" da API Gemini, em português, com o aviso "O Gemini 4 Argon já está disponível", a seção Gemini 4 com o cartão do Gemini 4 Argon marcado como novo e estável e, no índice lateral, as famílias Gemini 4, Gemini 3, Gemini 2.5 e a página de descontinuações.
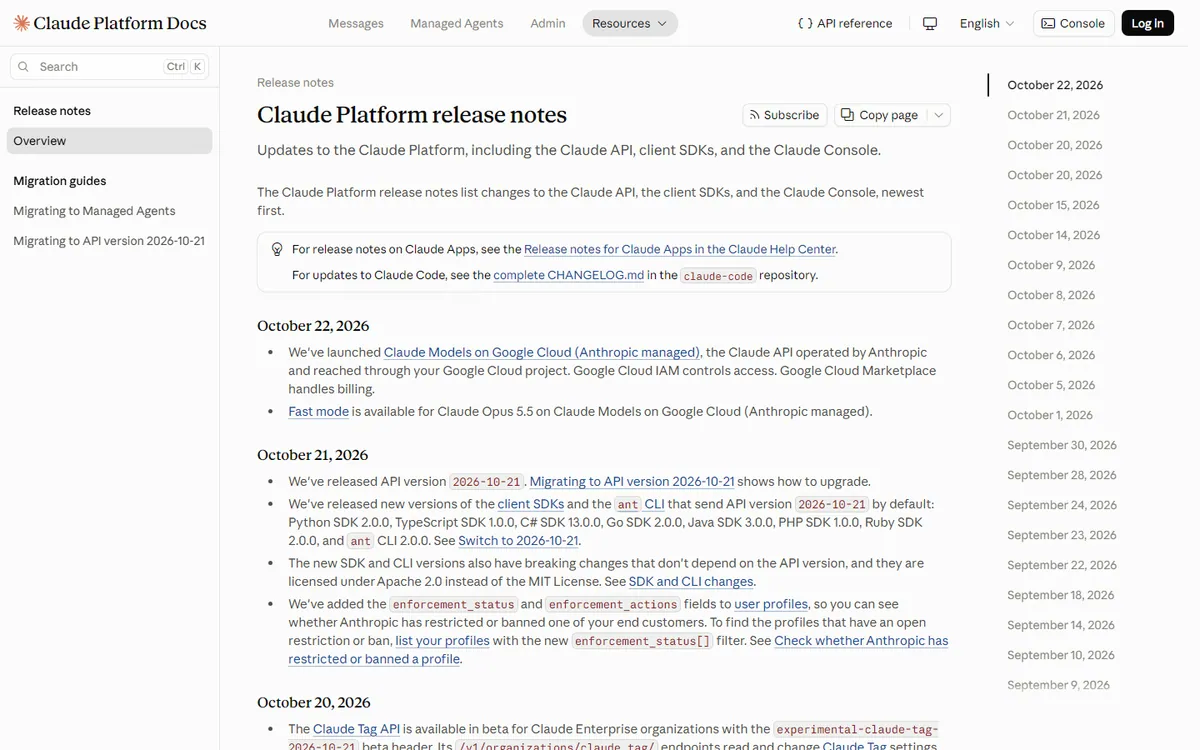
Quem monta agentes assume também o custo de acompanhar o fabricante. As notas de versão da Anthropic registraram mais de vinte atualizações entre 09/09 e 22/10/2026, e a documentação do Google mantém uma página própria de descontinuações. Alguém com nome precisa ler essas páginas e trocar o modelo antes da data de corte, e esse tempo entra na conta.
Ver como texto
Página "Claude Platform release notes" da Anthropic com entradas de 22, 21 e 20 de outubro de 2026 e, na coluna da direita, uma lista de datas de atualização entre 9 de setembro e 22 de outubro de 2026.
O contra-exemplo mais caro é a cascata sem teto: começar pelo modelo barato e subir de nível sempre que a saída reprova. Se o barato reprova em metade dos itens e o fluxo escalona duas vezes, boa parte do lote paga os três níveis e sai mais cara do que se tivesse ido direto ao alto. Meça a taxa real de aprovação de primeira antes de acreditar na economia e limite a dois escalonamentos. A armadilha irmã é a nova tentativa automática sem disjuntor (circuit breaker) durante uma queda do fornecedor, que consome o orçamento da rodada em minutos sem produzir uma linha útil.
- Etapa 1 de 4: Fechado
Tráfego normal. O contador de falhas consecutivas roda dentro de uma janela de 60 segundos e zera a cada sucesso.
- Etapa 2 de 4: 5 falhas na janela
Gatilho de abertura. Cinco falhas consecutivas dentro dos 60 segundos indicam indisponibilidade do provedor, e não azar de uma chamada.
- Etapa 3 de 4: Aberto
Bloqueado por 120 segundos. Nenhuma chamada sai. É aqui que o orçamento da rodada é preservado, porque retry cego durante uma queda queima a verba inteira em minutos sem produzir uma linha útil.
- Etapa 4 de 4: Meio aberto
Uma única chamada de sondagem. Sucesso devolve ao estado fechado; falha reabre por mais um intervalo, sem consumir o lote inteiro para descobrir isso.
Ver como texto
- Fechado: Tráfego normal. O contador de falhas consecutivas roda dentro de uma janela de 60 segundos e zera a cada sucesso.
- 5 falhas na janela: Gatilho de abertura. Cinco falhas consecutivas dentro dos 60 segundos indicam indisponibilidade do provedor, e não azar de uma chamada.
- Aberto: Bloqueado por 120 segundos. Nenhuma chamada sai. É aqui que o orçamento da rodada é preservado, porque retry cego durante uma queda queima a verba inteira em minutos sem produzir uma linha útil.
- Meio aberto: Uma única chamada de sondagem. Sucesso devolve ao estado fechado; falha reabre por mais um intervalo, sem consumir o lote inteiro para descobrir isso.
O verificador barato costuma ser outro modelo julgando a saída do primeiro, e ele tem limite medido. Em arXiv 2609.02246 (02/09/2026), Wahi catalogou 11 modos de falha do modelo-juiz e encontrou agentes com 100% de aprovação do juiz escondendo 68% de capacidade real. Na política, o juiz opina; quem decide publicar são conferências fixas que ele não anula: o formato valida, o número tem fonte com endereço, o texto tem acentuação e links íntegros.
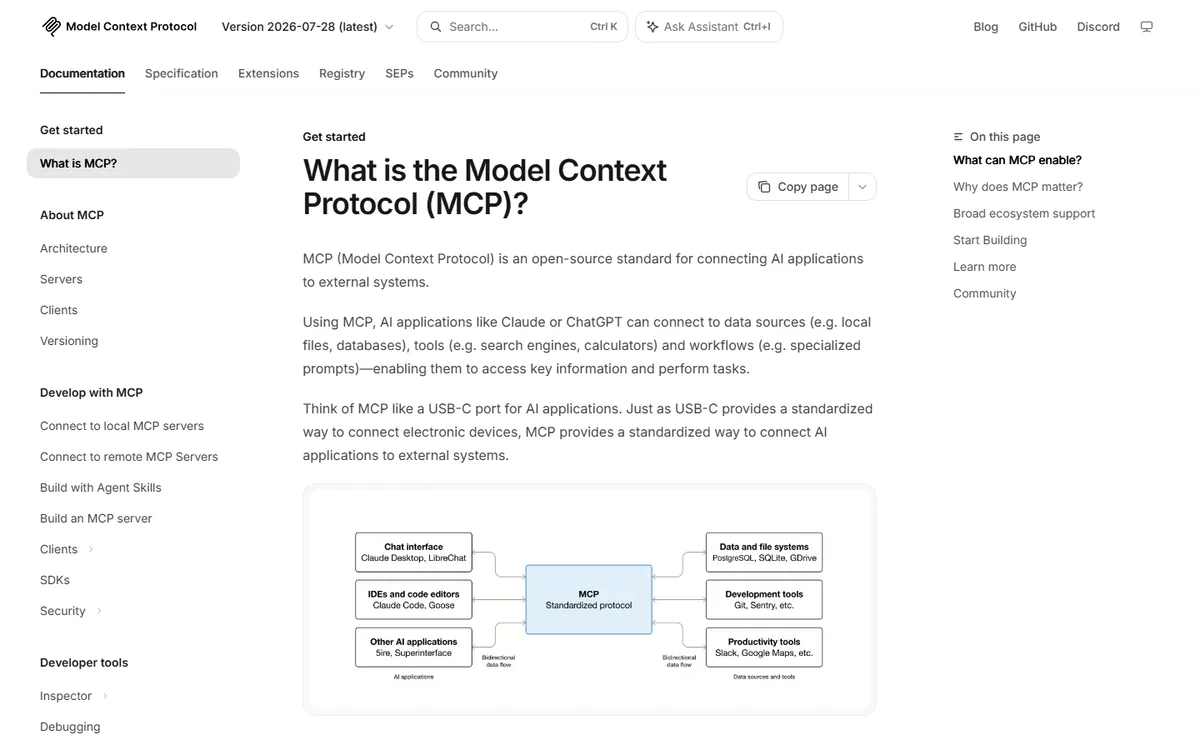
O protocolo de contexto de modelos (MCP, Model Context Protocol) reduz o custo de trocar de fornecedor. Ele fica entre o assistente e as ferramentas da empresa, de modo que mudar o modelo não obriga a refazer as integrações.
Ver como texto
Página "What is the Model Context Protocol (MCP)?" com a definição do MCP como padrão aberto para conectar aplicações de IA a sistemas externos, a comparação com uma porta USB-C e um diagrama que liga clientes de IA, como Claude e ChatGPT, a fontes de dados e ferramentas por meio do protocolo.
Vale a pena orquestrar este fluxo?
Pontue o fluxo que você tem em mente nas quatro dimensões. A soma é um instrumento de conversa, e não uma medida: ela existe para tornar explícito o que costuma ser decidido por entusiasmo. Ajuste os pesos ao seu contexto e registre a data da leitura ao lado do resultado.
0 para tarefa única no trimestre, 3 para lote recorrente de centenas de itens por semana.
0 quando tudo é a mesma coisa, 3 quando pesquisa, extração e redação convivem na mesma rodada com propriedades diferentes.
0 quando ninguém vai perguntar depois, 3 quando é preciso reconstruir qual executor produziu qual trecho e a que custo.
0 quando não há dono nomeado para o pipeline, 3 quando existe pessoa responsável e cadência de revisão acordada.
Orquestrar aqui cria um passivo de manutenção maior que o problema resolvido. Faça a tarefa na mão ou com um script de uma página, meça o tempo real gasto por mês e volte a este cálculo quando esse tempo incomodar de verdade.
Heurística de praticante para o primeiro mês: implemente na ordem cache, teto de orçamento por rodada, circuit breaker e só então roteamento. Essa ordem parece invertida porque roteamento é a parte interessante, e é justamente por isso que ela costuma vir primeiro e dar errado. Cache elimina o desperdício mais óbvio sem nenhuma decisão difícil. Teto de orçamento converte um bug de laço em um aviso em vez de uma fatura. Circuit breaker impede que uma indisponibilidade externa vire prejuízo interno. Roteamento fino, sem essas três camadas embaixo, otimiza centavos por chamada enquanto o sistema queima dezenas de dólares em tentativas contra um provedor fora do ar.
Faça agora (15 min, além da leitura)
Cinco perguntas que a pessoa que decide faz a quem opera, por escrito, e que bastam para aprovar ou recusar a orquestração com número.
Passo 1: Liste os fluxos de IA que rodam hoje e o dono de cada um
Um fluxo sem dono nomeado não é candidato a orquestração; é candidato a chamada única com planilha ao lado.
Deu certo quando: Uma lista com nome de pessoa em cada linha.
Erro comum: Colocar 'o time' como dono.
Passo 2: Peça a taxa de aprovação de primeira do nível barato
Para o fluxo mais volumoso, pergunte a quem opera: em quantos itens foi medida e qual foi a taxa. Sem essa medida, a cascata é aposta.
Deu certo quando: Um percentual com o número de itens ao lado.
Erro comum: Aceitar 'funciona bem' como taxa.
Passo 3: Pergunte a data do catálogo de modelos
Peça o arquivo em que os nomes de modelo vivem e a data da última revisão. Se a política cita marca no corpo das regras, ela envelheceu com os lançamentos de setembro e outubro de 2026.
Deu certo quando: Um arquivo só, revisto no último trimestre.
Erro comum: Política com nome de modelo espalhado em cada regra.
Passo 4: Confirme os três guarda-corpos
Cache, teto de orçamento por rodada e circuit breaker existem e têm parâmetro escrito? Se algum falta, ele entra antes de qualquer roteamento novo.
Deu certo quando: Três respostas 'sim', cada uma com o parâmetro.
Passo 5: Confira se algum fluxo ainda chama a API antiga da Perplexity
Os endpoints Sonar foram aposentados em 27/09/2026, com a Agent API como sucessora. Fluxo de pesquisa que ainda aponta para eles está falhando em silêncio ou já caiu.
Deu certo quando: A confirmação escrita de que nenhum fluxo usa o Sonar.
Erro comum: Descobrir pelo erro no log semanas depois.
No fim você tem: a lista de fluxos com dono, a taxa de aprovação medida do fluxo mais volumoso, a data do catálogo de modelos e os três guarda-corpos confirmados, o suficiente para aprovar ou recusar a orquestração com número.
Confira antes de fechar: o fluxo candidato tem dono nomeado, a taxa de aprovação de primeira do nível barato foi medida em pelo menos 30 itens, o catálogo de modelos tem data e cache, teto por rodada e disjuntor têm parâmetro escrito. Os cinco agentes para quatro artigos por mês viram uma chamada direta e uma revisão humana, até o volume mudar.
Você fecha o curso com as cinco decisões assinadas, a régua para cobrar fornecedores e, se seguiu a parte opcional, um plano de 90 dias com regra de parada. Reveja o catálogo e as datas a cada trimestre.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Confira como a sua empresa aparece em respostas de IAsugerido pelo grafoApresenta o conceito “Agent API (Perplexity)”, usado em “Aprofundamento: quando automatizar a operação com agentes”.
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “Perplexity” e “Schema.org”, usados em “Aprofundamento: quando automatizar a operação com agentes”.
- CursoGEO e Knowledge Graphsugerido pelo grafo1 capítulo de “SEO e GEO para quem decide” usa conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Modelo de trabalho com agentes de IAComo calcular o custo por entrega aceita?Examinar conexões de Como calcular o custo por entrega aceita?
- Gestão de Projetos GEOExecutar em ciclos de duas semanasExaminar conexões de Executar em ciclos de duas semanas
- Avaliar e melhorar agentesConferir a passagem do piloto para o uso realExaminar conexões de Conferir a passagem do piloto para o uso real
- Prompt Engineering para ExecutivosDecidir quanto a IA deve pensar, e pagar, em cada tarefaExaminar conexões de Decidir quanto a IA deve pensar, e pagar, em cada tarefa
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.