SEO e GEO para quem decide · Capítulo 7 de 30 · 16 min
A base que permite ao robô ler o seu site
Em qual das quatro etapas da busca o site falha, e o que cobrar da equipe antes de aprovar verba de conteúdo.
Este capítulo faz parte do curso gratuito SEO e GEO para quem decide.
Peça à equipe os dois dados que mostram se o site é lido pelos robôs (sete dias de registro de acessos e o robots.txt que está no ar) e cruze uma queda de tráfego com o painel de atualizações do Google antes de culpar o conteúdo.
Exemplo: o tráfego orgânico da distribuidora cai 15% na primeira semana de outubro de 2026, e o time de conteúdo já propõe reescrever 50 páginas. Antes de aprovar seis semanas de redação, vale descobrir em que ponto a busca falhou.
Ver como texto
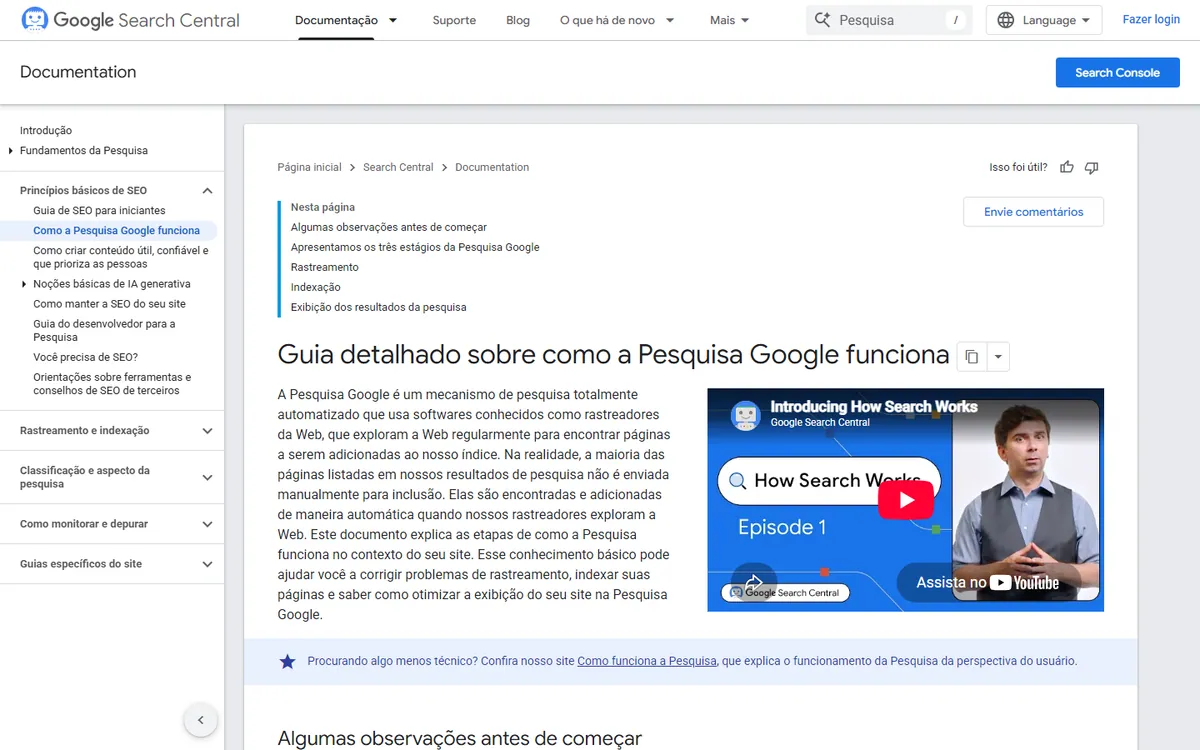
Página Guia detalhado sobre como a Pesquisa Google funciona, na Central da Pesquisa Google, com o sumário listando os três estágios: rastreamento, indexação e exibição dos resultados.
Toda busca passa por quatro etapas, e cada uma falha por um motivo próprio. Na descoberta, o Google fica sabendo que a página existe. No rastreio, um robô (crawler) visita a página e precisa receber resposta 200, o código que quer dizer "página entregue". Na indexação, o conteúdo é entendido e guardado. Na exibição, o sistema decide mostrar a página para alguma consulta, na lista de links ou numa resposta de IA.
Quem acompanha cada visita é o log de servidor, o livro de registro do site que anota cada robô que entrou e a resposta que recebeu. Quase todo diagnóstico ruim começa pela quarta etapa e ignora as três primeiras.
- Etapa 1 de 4: Descoberta
O mecanismo sabe que a URL existe. Verifique no sitemap enviado e na cobertura do Search Console.
- Etapa 2 de 4: Rastreio
Ele consegue buscar a URL e recebe 200. Verifique no log de servidor, por user agent.
- Etapa 3 de 4: Renderização e indexação
Ele entende o conteúdo e o guarda. Verifique na inspeção de URL, comparando HTML servido e HTML renderizado.
- Etapa 4 de 4: Serviço
Ele decide mostrar aquilo, em alguma superfície, para alguma consulta. Verifique no relatório de desempenho.
Ver como texto
- Descoberta: O mecanismo sabe que a URL existe. Verifique no sitemap enviado e na cobertura do Search Console.
- Rastreio: Ele consegue buscar a URL e recebe 200. Verifique no log de servidor, por user agent.
- Renderização e indexação: Ele entende o conteúdo e o guarda. Verifique na inspeção de URL, comparando HTML servido e HTML renderizado.
- Serviço: Ele decide mostrar aquilo, em alguma superfície, para alguma consulta. Verifique no relatório de desempenho.
Ver como texto
Funil de busca em quatro etapas, descoberta, rastreio, renderização e indexação e serviço, com três superfícies do Google saindo do mesmo índice, e uma faixa separada em que os robôs de busca da OpenAI, da Anthropic e da Perplexity chegam à resposta de assistente sem passar pelo índice do Google.
| Etapa | Falha típica | Sintoma no relatório | Onde conferir | Quem resolve |
|---|---|---|---|---|
| Descoberta | Página fora do sitemap ou sem link interno | A página nunca aparece no Search Console | Sitemap enviado e cobertura do Search Console | Equipe do site |
| Rastreio | Firewall ou CDN devolvendo 403 ao robô | Impressões caindo junto com os cliques | Log de servidor, por robô | Infraestrutura |
| Indexação | Conteúdo principal só aparece depois de JavaScript que falha | Página rastreada e não indexada | Inspeção de URL no Search Console | Desenvolvimento |
| Exibição | Conteúdo fraco ou atualização do Google | Impressões estáveis e cliques caindo | Relatório de desempenho e painel de status do Google | Conteúdo e SEO |
A coluna do sintoma é a que você usa na reunião: impressões caindo junto com os cliques apontam para rastreio ou indexação; impressões estáveis com cliques caindo apontam para a exibição.
O caso mais caro desta tabela é o do rastreio. Num cenário ilustrativo que se repete em muitas empresas, uma equipe passou seis semanas reescrevendo 30 páginas para ficarem citáveis por IA e, três meses depois, não tinha nenhuma citação. O robô de busca do assistente recebia 403 do firewall havia cinco meses, por uma regra genérica contra cópia de conteúdo. O texto estava certo; ele nunca foi lido.
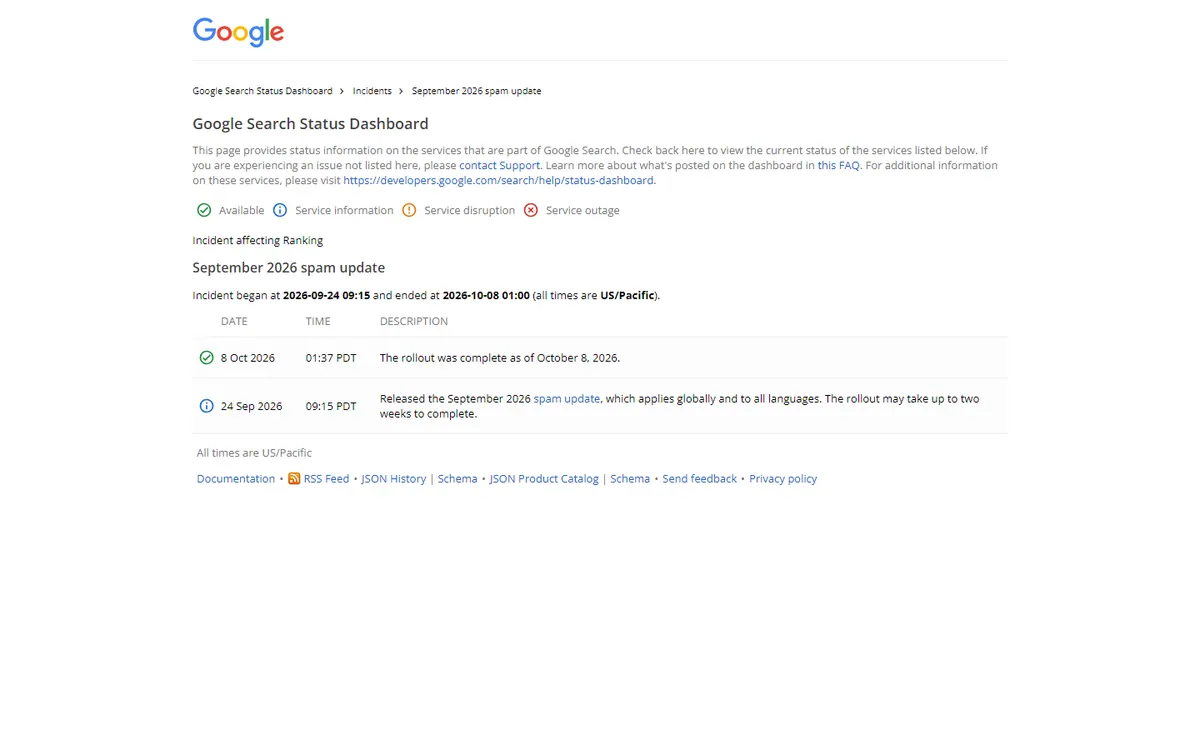
A segunda verificação é o calendário do Google. Ele faz dois tipos de mudança que derrubam tráfego: a atualização de combate a spam (spam update), que pune práticas de manipulação, e a atualização geral de classificação (core update), que reavalia a qualidade das páginas. As datas de ambas ficam no painel público de status da Busca.
A atualização de spam de setembro de 2026 valeu para o mundo todo e para todos os idiomas, de 24/09 a 08/10, durante 13 dias e quase 16 horas, a mais longa das quatro do ano. Entre agosto e 24/10 não houve atualização geral. A queda da distribuidora na primeira semana de outubro cai dentro dessa janela, e essa é a primeira hipótese a examinar.
Ver como texto
Painel de status da Pesquisa Google mostrando o incidente September 2026 spam update, iniciado em 24 de setembro de 2026 e concluído em 8 de outubro de 2026, com as duas atualizações datadas.
O tráfego orgânico caiu 15% entre 01 e 07/10/2026. O time de conteúdo propõe reescrever 50 páginas a partir da semana que vem. O painel de status do Google mostra uma atualização de spam em curso de 24/09 a 08/10, e ninguém ainda olhou se as impressões caíram junto com os cliques.
Qual é o primeiro movimento?
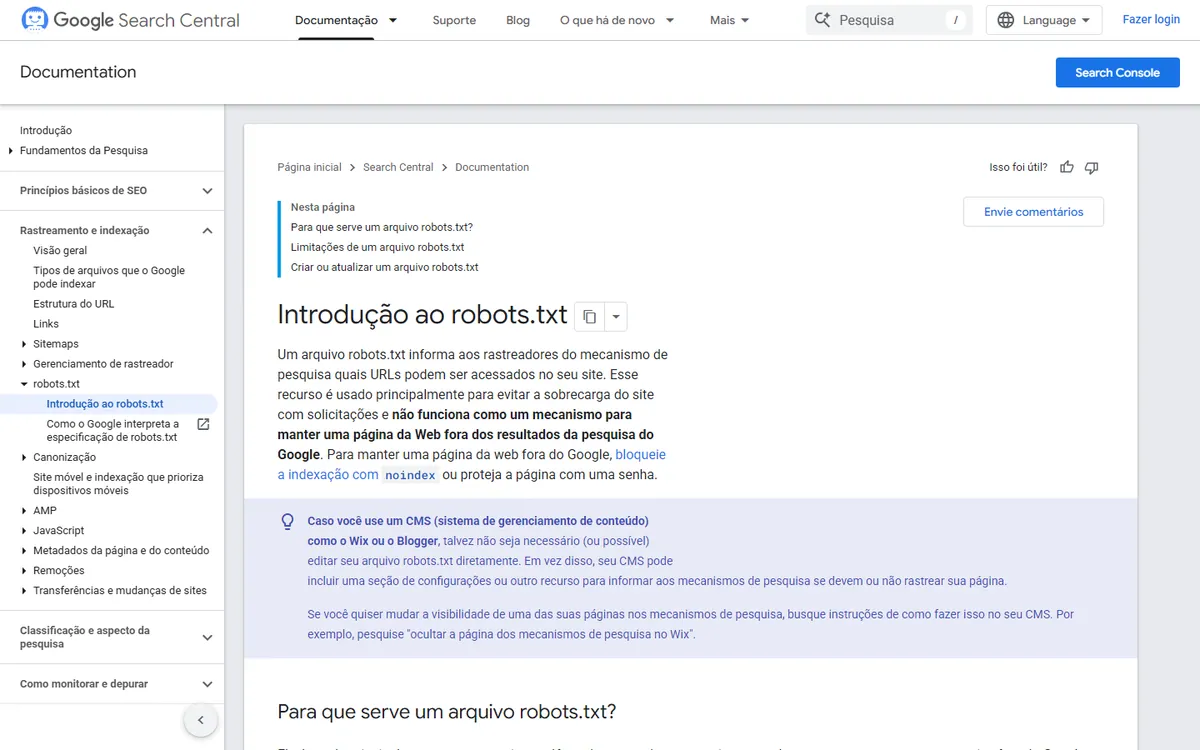
O robots.txt é o arquivo na raiz do site que diz a cada robô onde ele pode entrar. Funciona como um aviso na porta: os robôs sérios respeitam, mas o arquivo não tranca nada. Para tirar uma página do Google, o caminho é a marcação noindex ou uma senha, como a própria documentação avisa.
Cada empresa de IA opera robôs separados por função: um para treinar modelos, outro para buscar fontes da resposta, outro para abrir uma página a pedido do usuário. Quem quer aparecer nas respostas precisa deixar entrar o robô de busca, mesmo que recuse o de treino.
Ver como texto
Página Introdução ao robots.txt da Central da Pesquisa Google, com o destaque de que o arquivo não funciona como mecanismo para manter uma página fora dos resultados e a recomendação de usar noindex ou senha.
Robôs de IA por função, e um robots.txt que expressa uma decisão
Quem é quem
| Fornecedor | Treino do modelo | Busca e citação | Ação a pedido do usuário |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User |
| Perplexity | Nenhum: a documentação diz que não rastreia para treinar modelos | PerplexityBot | Perplexity-User, que em geral ignora o robots.txt |
| Meta | Meta-ExternalAgent | Meta-WebIndexer (busca do Meta AI) | Meta-ExternalFetcher, que pode ignorar o robots.txt |
| Google-Extended (treino e grounding de Gemini e Vertex AI) | Googlebot | Via produto |
Bloquear GPTBot ou ClaudeBot deixa o site nas respostas de busca desses assistentes, porque quem alimenta a resposta ao vivo é a coluna do meio; a OpenAI escreve que sites que bloqueiam o OAI-SearchBot não aparecem nas respostas de busca do ChatGPT. A OpenAI mantém ainda um quarto robô, o OAI-AdsBot, que só visita páginas enviadas como anúncio. Perplexity-User e Meta-ExternalFetcher só se controlam por firewall ou regra de servidor.
Exemplo de robots.txt
Exemplo de uma empresa que decidiu recusar treino e aceitar busca. Cada bloco registra o motivo da escolha, porque um arquivo sem justificativa é revertido pelo próximo que ler um post contraditório.
# robots.txt - decisão registrada em 2026-09-07
# Política: recusamos treino, aceitamos busca e citação.
# Revisar a cada trimestre. Não alterar sem atualizar os comentários.

User-agent: *
Allow: /
Sitemap: https://exemplo.com.br/sitemap.xml

# --- Busca e citação: LIBERADOS ---
# São estes que alimentam a resposta ao vivo. Bloqueá-los é
# desaparecer da resposta, que é exatamente o oposto do objetivo.
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Meta-WebIndexer
Allow: /

# --- Ação a pedido do usuário: LIBERADOS ---
# Disparados quando uma pessoa real pediu aquela página no chat.
# Bloquear aqui frustra um usuário que já demonstrou intenção.
# Perplexity-User e Meta-ExternalFetcher em geral ignoram este
# arquivo: se a decisão fosse bloqueá-los, seria no firewall.
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

# --- Treino: BLOQUEADOS ---
# Escolha do negócio, não recomendação técnica deste curso.
# Antes de copiar, confira o padrão do seu CDN: o capítulo sobre
# permitir, cobrar ou bloquear explica os padrões da Cloudflare.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: CCBot
Disallow: /

# Não usamos Google-Extended com Disallow porque a decisão acima é
# sobre treino de terceiros. Se optássemos por bloquear, valeria
# registrar que isso NÃO retira o site de AI Overviews nem de AI Mode;
# quem faz isso é o controle Search generative AI, no Search Console.
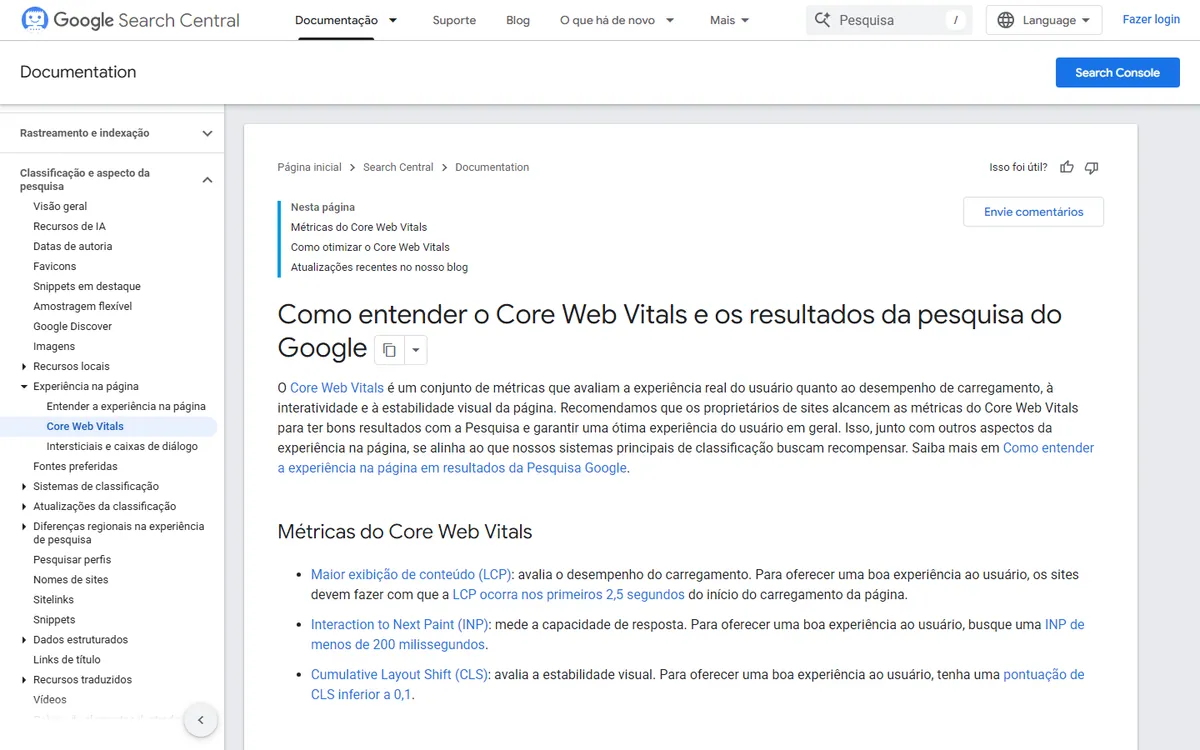
A velocidade da página entra como defeito de experiência, não como alavanca de posição. As três medidas oficiais do Google (Core Web Vitals, os sinais vitais da página) têm limites estáveis: o maior elemento deve carregar em até 2,5 segundos, a resposta a um toque ou clique deve vir em até 200 milissegundos e a página não deve pular mais que 0,1 na escala de estabilidade. Qualquer pessoa confere esses números de graça no PageSpeed Insights.
Ver como texto
Página Como entender o Core Web Vitals e os resultados da pesquisa do Google, com as três métricas e seus limites: LCP nos primeiros 2,5 segundos, INP abaixo de 200 milissegundos e CLS inferior a 0,1.
O erro provável: aceitar limiar sem fonte. O "INP bom é 150 ms" circula em material de fornecedor e contradiz a documentação, que fixa 200 ms. Quando um limiar aparecer num relatório interno, peça o link da documentação, porque meta apertada com base em número inventado consome sprint de engenharia sem retorno.
Aprofundamento: a linha do tempo do SEO, com o que cada fase deixou de herança
Anos 1990: Diretórios e repetição de palavra
Herança negativa e persistente: a intuição de que existe uma alavanca textual simples capaz de enganar o sistema. Ela ressurge a cada ciclo tecnológico, e voltou em 2025 na forma de arquivos e marcações supostamente secretas para IA.
Anos 2000: PageRank transforma link em voto
Nasce a economia de link building. A herança é a ideia de que evidência externa ao seu domínio vale mais que declaração interna, e ela continua correta em 2026, com a moeda mudada de link para menção.
2011 a 2019: Panda, Penguin, Hummingbird, RankBrain e BERT
Panda (2011) contra conteúdo de baixa qualidade, Penguin (2012) contra links manipulativos, Hummingbird (2013) com interpretação semântica, RankBrain (2015) com aprendizado de máquina e BERT (2019) com contexto na consulta. Herança que sustenta este curso: o sistema passou a tratar significado, e deixou de tratar cadeia de caracteres.
Março de 2024: INP substitui o FID nos Core Web Vitals
Os limiares seguem inalterados desde então: LCP até 2,5 s, INP até 200 ms e CLS até 0,1, sempre avaliados no percentil 75. Nenhuma métrica nova foi anunciada para 2026.
04/03/2026: Google remove orientação obsoleta de JavaScript SEO
A justificativa oficial é que o Google renderiza JavaScript de forma confiável há anos, o que rebaixa a renderização dinâmica a contorno pontual.
07/05/2026: Fim dos resultados enriquecidos de FAQ
A funcionalidade deixou de existir em 07/05/2026 (entrada do changelog em 08/05/2026) e a documentação correspondente saiu em 15/06/2026.
15/05/2026: Guia oficial de otimização para busca com IA
Publicado em 15/05/2026 e atualizado em 10/07/2026, o documento sustenta que otimizar para busca generativa continua sendo SEO. A atualização acrescentou uma seção sobre agentes, apresentada pelo próprio Google como opcional.
03/06 a 31/08/2026: Search Console ganha relatório de busca generativa e o controle Search generative AI
Primeiro instrumento nativo de medição da nova superfície: impressões por página, país, dispositivo e data, sem cliques. Lançado em 03/06 e disponível para todos os sites do mundo desde 31/08/2026.
Agosto a outubro de 2026: atualizações de spam e nenhuma atualização geral
A atualização de spam de setembro durou de 24/09 a 08/10/2026, 13 dias e quase 16 horas, a mais longa das quatro de 2026 (março, junho, agosto e setembro). A última atualização geral foi a de maio (21/05 a 02/06); manchetes de core update de agosto ou de setembro vieram de blogs de agregação e não constam do painel.
Antes de qualquer diagnóstico sofisticado, rode a auditoria de três minutos. Primeiro, busque a sua página mais importante com o user agent (o nome com que o robô se apresenta) do OAI-SearchBot, do Claude-SearchBot e do Meta-WebIndexer, e confira o código de resposta. Segundo, abra o robots.txt em produção, e não o do repositório, que às vezes diverge do que o CDN serve. Terceiro, procure no log dos últimos sete dias qualquer resposta 4XX ou 5XX servida a robô verificado. Bloqueio inadvertido é a causa raiz mais comum e a mais barata de corrigir, e nenhuma reescrita de conteúdo compensa um 403.
Faça agora (15 min, além da leitura)
Você não precisa abrir nenhum arquivo técnico: precisa fazer três pedidos e ler três respostas.
Passo 1: Peça ao time de infraestrutura os últimos sete dias de log
Mande a pergunta por escrito: quantas requisições de OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer e Googlebot receberam resposta diferente de 200?
Deu certo quando: Uma tabela com o nome do robô e a contagem por código de resposta.
Erro comum: Aceitar "está tudo certo" sem número.
Passo 2: Peça o robots.txt que está no ar
Abra o endereço do seu site seguido de /robots.txt no celular e pergunte à equipe se o CDN serve o mesmo arquivo do repositório.
Deu certo quando: O arquivo diz, em comentário, qual decisão de negócio ele expressa e quando foi revisado.
Erro comum: Ler o arquivo do repositório e presumir que é o que o robô recebe.
Passo 3: Abra o relatório de IA do Search Console
Peça a quem tem acesso para mostrar as impressões em recursos de IA dos últimos 28 dias e confirmar como está o controle Search generative AI (incluir é o padrão).
Deu certo quando: Você sabe se o site aparece em AI Overviews e AI Mode, e quem decidiu isso.
Erro comum: Confundir esse controle com o Google-Extended, que só trata de treino.
Passo 4: Se o log não existir ou durar menos de 90 dias, abra o chamado de retenção
Sem log você fica cego na única camada que é totalmente sua. O chamado é o entregável desta etapa.
Deu certo quando: Um ticket com prazo e responsável.
Passo 5: Marque a reunião de 30 minutos com a pauta pronta
Três itens: respostas diferentes de 200 a robôs de busca, decisão registrada no robots.txt, estado do controle de IA no Search Console. Conteúdo novo só entra na pauta depois do primeiro item zerado.
Deu certo quando: A pauta cabe em cinco linhas e cada item tem um número ou um sim ou não.
No fim você tem: o número de respostas erradas a robôs de busca na última semana, o robots.txt que está no ar com a decisão registrada e a pauta de uma reunião que decide onde entra o primeiro real.
A sua base passa nas quatro etapas do funil?
Descoberta e rastreio
0/5Renderização e indexação
0/3Decisão registrada
0/4Com o site legível, a pergunta passa a ser se o Google sabe quem é a empresa. O próximo capítulo trata da entidade: como fazer o buscador reconhecer a distribuidora como uma só, e não confundi-la com a homônima de outro estado.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Confira se o site abre bem e pode ser lido pelos buscadoressugerido pelo grafoApresenta os conceitos “Core Web Vitals”, “PerplexityBot” e “CDN”, usados em “A base que permite ao robô ler o seu site”.
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “meta-webindexer”, “Claude-SearchBot” e “OAI-SearchBot”, usados em “A base que permite ao robô ler o seu site”.
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta os conceitos “Robots.txt” e “Spam update”, usados em “A base que permite ao robô ler o seu site”.
- CursoGEO e Knowledge Graphsugerido pelo grafo1 capítulo de “SEO e GEO para quem decide” usa conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Glossário Completo de SEO e GEO 2026Confira se o site abre bem e pode ser lido pelos buscadoresExaminar conexões de Confira se o site abre bem e pode ser lido pelos buscadores
- E-E-A-T e Qualidade de ConteúdoConteúdo feito com IA: o que o Google pune e o que aceitaExaminar conexões de Conteúdo feito com IA: o que o Google pune e o que aceita
- Vibecoding para SEORevisão de texto antes de publicar, com regras e com genteExaminar conexões de Revisão de texto antes de publicar, com regras e com gente
- SEO programáticoEscolher quais páginas devem aparecer na buscaExaminar conexões de Escolher quais páginas devem aparecer na busca
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.