SEO e GEO para quem decide · Capítulo 13 de 30 · 25 min
Quais robôs de inteligência artificial podem ler o site
Uma política de acesso assinada, que separa robô de treino de robô de citação e diz o que cada bloqueio custa.
Este capítulo faz parte do curso gratuito SEO e GEO para quem decide.
Começa aqui a parte das decisões que a diretoria assina. Escreva em três linhas quais robôs de inteligência artificial podem ler o site e peça à equipe uma prova simples: o código de resposta que o servidor deu ao robô de busca da OpenAI nos últimos 30 dias.
Exemplo: o jurídico de uma rede de clínicas de estética manda "tirar a empresa da IA" em uma semana. A equipe de tecnologia bloqueia no firewall todos os robôs com nome de empresa de IA, inclusive os de busca. Um mês depois, a clínica sumiu das respostas do ChatGPT, e um terço dos agendamentos vinha de descoberta em busca.
Cada empresa de IA mantém mais de um robô (crawler), o programa que visita as páginas do site, e cada robô tem uma função. Há três funções que importam. O robô de treino coleta material para versões futuras do modelo. O robô de busca e citação monta o índice que o assistente consulta para responder hoje, com link. O robô de ação do usuário abre uma página quando alguém pede, durante a conversa.
Bloquear o robô de treino não tira a marca das respostas de hoje. Bloquear o de busca tira, e sem aviso em nenhum painel.
O que cada bloqueio produz
Eixo horizontal: Efeito na resposta de hoje, de nenhum a totalEixo vertical: Função do robô bloqueado
Treino bloqueado: nenhum efeito na resposta de hoje
- GPTBot (OpenAI)
- ClaudeBot (Anthropic)
- Google-Extended (Google)
- Applebot-Extended (Apple)
Busca bloqueada: a marca some das respostas em semanas
- OAI-SearchBot (ChatGPT)
- Claude-SearchBot (Claude)
- PerplexityBot (Perplexity)
- Meta-WebIndexer (Meta AI)
Ação do usuário bloqueada: a visita pedida pela pessoa falha
- ChatGPT-User
- Claude-User
- Perplexity-User, que em geral ignora o robots.txt e só cai com regra no servidor
Validador de anúncio bloqueado: o anúncio é reprovado
- OAI-AdsBot, que confere a página de destino dos anúncios no ChatGPT
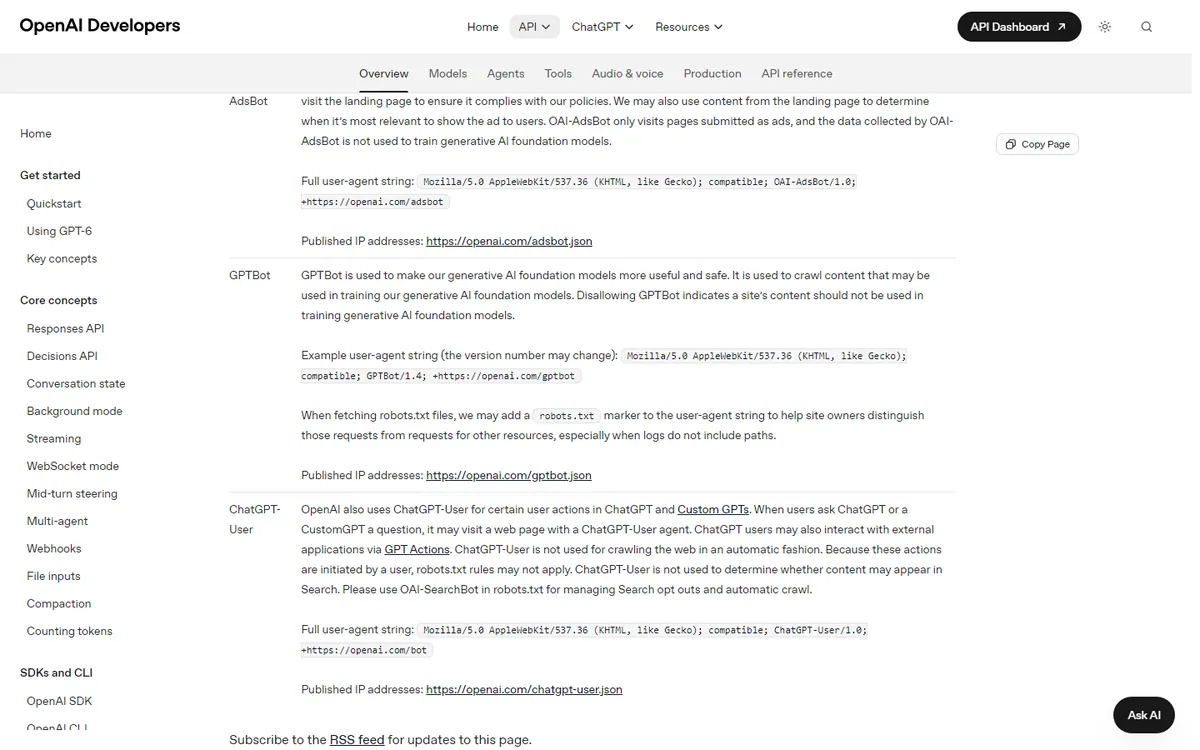
A documentação da OpenAI é literal nos dois sentidos: "Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers", e "Disallowing GPTBot indicates a site's content should not be used in training". O ChatGPT-User atende pedidos feitos por uma pessoa e pode não seguir o robots.txt, o arquivo na raiz do site que diz a cada robô onde pode entrar. A política escrita da empresa precisa tratar cada robô em linha própria.
Ver como texto
Documentação da OpenAI, Overview of OpenAI Crawlers, no trecho das linhas GPTBot e ChatGPT-User, explicando que bloquear o GPTBot indica que o conteúdo não deve ser usado em treinamento e que o ChatGPT-User atende ações iniciadas pelo usuário.
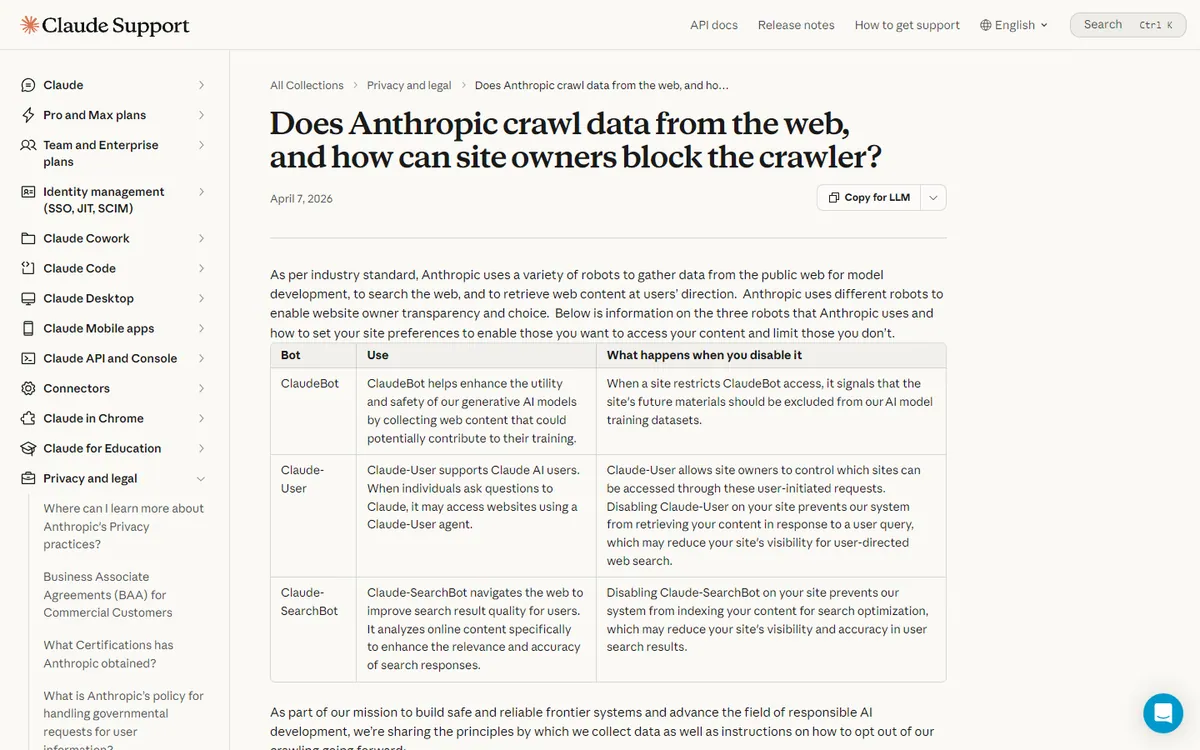
A Anthropic segue o mesmo desenho, com três robôs documentados em 07/04/2026, e a coluna que interessa a quem decide é a que diz o que se perde ao desligar cada um. Desligar o Claude-SearchBot pode reduzir a visibilidade nas respostas de busca; desligar o ClaudeBot afeta o treinamento futuro.
Ver como texto
Artigo da Central de Suporte do Claude, de 7 de abril de 2026, com a tabela dos três robôs da Anthropic (ClaudeBot, Claude-User e Claude-SearchBot), o uso de cada um e o efeito de desativá-lo.
Ver como texto
Matriz de crawlers de inteligência artificial em três funções por dois fornecedores. Coluna 1, treino: GPTBot e ClaudeBot. Coluna 2, busca: OAI-SearchBot e Claude-SearchBot. Coluna 3, ação do usuário: ChatGPT-User e Claude-User. Bloquear a coluna 1 afeta apenas o treino futuro; bloquear a coluna 2 remove o site das respostas de busca; bloquear a coluna 3 quebra a busca que o próprio usuário pediu. Google-Extended pertence somente à coluna 1.
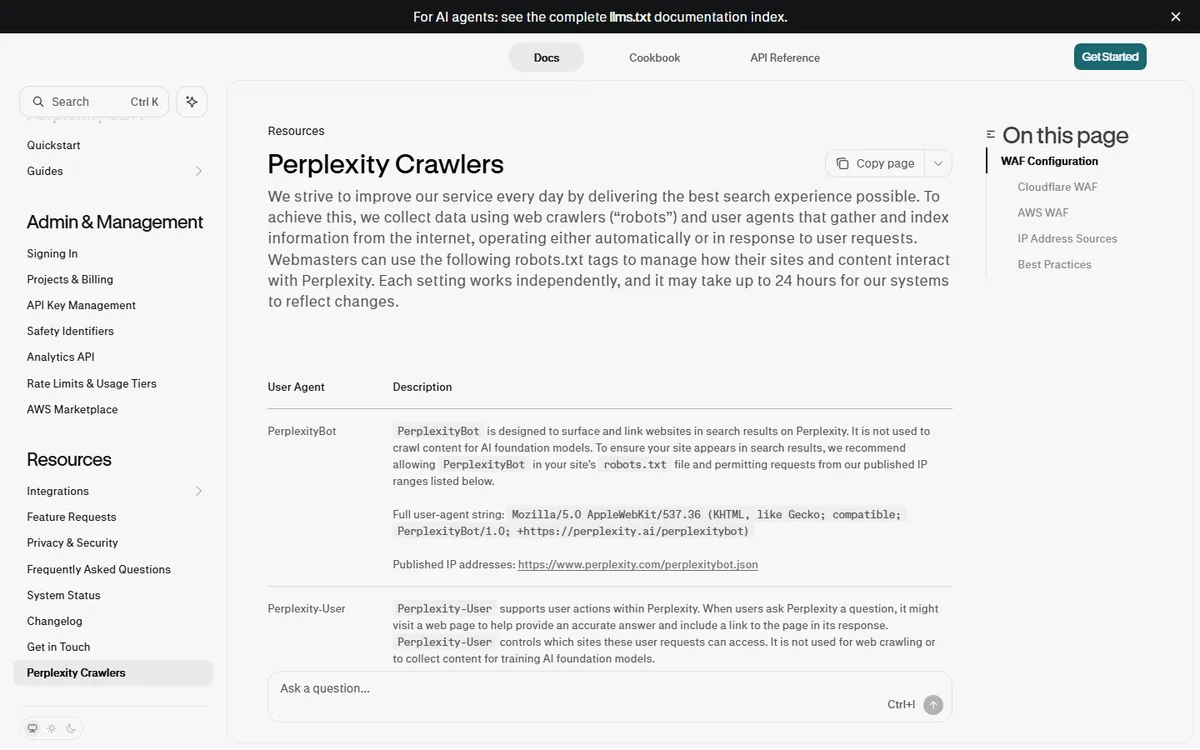
A Perplexity repete o padrão com uma diferença que muda a ferramenta de bloqueio. O PerplexityBot aparece na busca e, segundo a empresa, não é usado para treinar modelos. O Perplexity-User, que abre a página a pedido do usuário, "generally ignores robots.txt rules": quem quiser barrá-lo precisa de regra no servidor ou no firewall de aplicação (WAF). A Meta faz o mesmo com o Meta-ExternalFetcher, enquanto o Meta-WebIndexer é o robô que decide a citação no Meta AI.
Ver como texto
Documentação da Perplexity, Perplexity Crawlers, com a tabela que descreve o PerplexityBot, usado para exibir e linkar sites nos resultados, e o Perplexity-User, que atende ações do usuário.
| Operador | Treino | Busca e citação | Ação do usuário e observação |
|---|---|---|---|
| Google-Extended (treino e grounding em Gemini Apps e Vertex AI) | Googlebot, que também alimenta AI Overviews e AI Mode | Sem robô separado; sair das superfícies de IA é pelo Search Console, global desde 31/08/2026 | |
| Perplexity | Nenhum: a documentação diz que os dois robôs não coletam para treino de modelos | PerplexityBot, respeita o robots.txt | Perplexity-User ignora o robots.txt; só regra no servidor ou no WAF o barra |
| Meta | Meta-ExternalAgent | Meta-WebIndexer, decide citação no Meta AI (Instagram, WhatsApp, Facebook) | Meta-ExternalFetcher, pode ignorar o robots.txt |
| Apple | Applebot-Extended (recusa de treino) | Applebot: Spotlight, Siri e Safari | Sem robô separado; a meta tag nosnippet impede uso da página como contexto em resposta gerada |
| OpenAI, quarta função | GPTBot | OAI-SearchBot | ChatGPT-User; e o OAI-AdsBot, que valida páginas de destino de anúncios e reprova o anúncio quando é barrado |
Datas das documentações abertas em 07/09/2026: OpenAI (developers.openai.com/api/docs/bots), Anthropic (07/04/2026), Perplexity, Meta e Apple (republicada em 04/09/2026; conteúdo de 08/06/2026).
O que cada bloqueio de robô produz de fato
Escolha um robô e leia a consequência no painel de estado. Compare o GPTBot com o OAI-SearchBot: os dois pertencem à OpenAI, e só um deles apaga a marca da resposta de hoje quando bloqueado.
A cor do painel de estado é a consequência, não um enfeite: robô de índice de busca em vermelho apaga a marca da resposta de hoje quando bloqueado; robô de treino e de ação do usuário em verde não muda a resposta de hoje. Tratar bot de IA como categoria única é a origem da confusão mais cara desta camada.
O Google tem dois controles com nomes parecidos e efeitos diferentes, e confundi-los explica boa parte das ordens mal executadas. O Google-Extended, uma linha no robots.txt, recusa o uso do conteúdo no treinamento e nas respostas dos aplicativos Gemini e do Vertex AI, sem tirar o site da Busca. O controle "Search generative AI", no Search Console, tira o site dos resumos de IA, do Modo IA e do Discover generativo. Anunciado em 03/06/2026, está disponível para todos os sites desde 31/08/2026, faz efeito em um ou dois dias e não afeta o ranking do restante da Busca.
Para a maioria das empresas, a combinação defensável é recusar treino pelo Google-Extended e manter os resumos. O controle do Search Console entra quando a saída dos resumos estiver assinada com o custo em cliques ao lado, decisão que o próximo capítulo detalha.
| Controle | O que controla | O que não faz | Onde e desde quando |
|---|---|---|---|
| Google-Extended (robots.txt) | Uso do conteúdo em treinamento e grounding dos aplicativos Gemini e do Vertex AI | Não tira o site da Busca, de AI Overviews nem de AI Mode; não é sinal de ranqueamento | Linha no robots.txt; documentação de 14/07/2026 |
| Search generative AI (Search Console) | Presença em AI Overviews, AI Mode e Discover generativo: incluir, excluir ou herdar | Não afeta treinamento (para isso, Google-Extended); não é sinal de ranqueamento no restante da Busca; sem granularidade por página | Painel do Search Console; anunciado em 03/06/2026, global em 31/08/2026; efeito em 1 a 2 dias |
| nosnippet, data-nosnippet, max-snippet | Quanto da página pode aparecer em trecho, inclusive nos recursos de IA | Não exclui o site; encolhe também o trecho orgânico | Meta tag ou HTML da página; documentação de recursos de IA do Google |
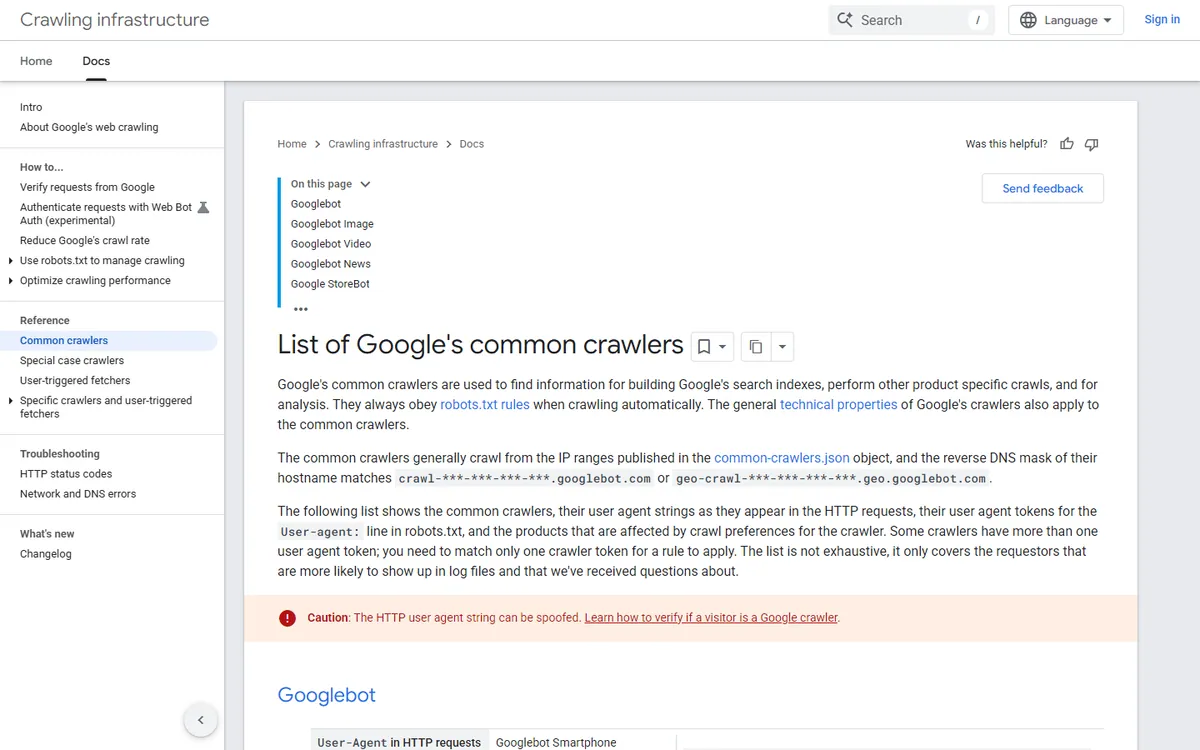
Liberar ou bloquear por nome exige um cuidado que a equipe técnica conhece e a diretoria costuma ignorar: qualquer programa pode se apresentar como robô do Google. Antes de abrir exceção no firewall, o time confere o robô pelo endereço publicado pela empresa dona dele.
Ver como texto
Documentação do Google, List of Google's common crawlers, com a explicação dos rastreadores comuns, a máscara de DNS reverso e o alerta de que a string de user agent pode ser falsificada.
Voltemos à rede de clínicas, no exemplo: a decisão certa custa uma reunião: levar ao jurídico as três funções separadas, com o efeito de cada bloqueio e o número de agendamentos vindos de busca. A política assinada fica em três linhas: treino restringido, busca e citação liberadas, ação do usuário liberada. O firewall volta a atender o OAI-SearchBot, e o log de 30 dias passa a ser a conferência.
O jurídico determinou que a empresa deve sair das inteligências artificiais. A ordem chegou por escrito, sem detalhe técnico, e o prazo é de uma semana. O site roda sob Cloudflare, tem blog ativo com boa presença em busca orgânica e recebe cerca de um terço dos agendamentos por descoberta no Google. Você precisa escrever a diretiva que será aplicada e defender a escolha na reunião seguinte.
Qual conjunto de diretivas você escreve, e o que cada um de fato produz?
O erro mais comum é bloquear GPTBot e ClaudeBot, dar a tarefa por concluída e descobrir seis meses depois que a marca continua nas respostas, porque nada mudou na busca. O inverso custa mais: uma regra genérica de "proteção contra IA" devolve erro ao robô de busca e a marca some sem sintoma no analytics. A correção é a mesma nos dois casos: a decisão por função, assinada, e o log que prova o que cada robô recebe.
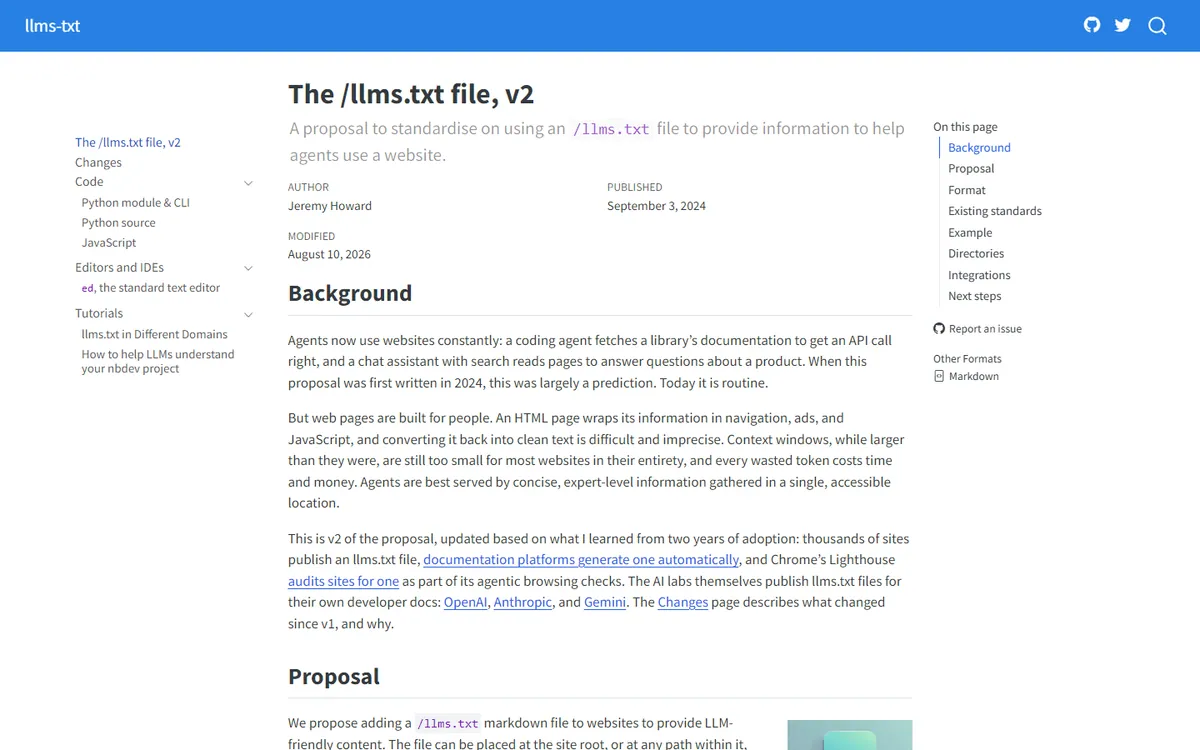
Resta o llms.txt, um arquivo de texto na raiz do site que descreve o conteúdo para modelos. Ele é uma proposta de um autor, Jeremy Howard, sem aprovação formal dos buscadores. O guia do Google para busca com IA (15/05/2026, atualizado em 10/07/2026) diz que a Busca "ignores them", e o Common Crawl achou, em 584.107 arquivos do rastreio de julho de 2026, 68,27% gerados por plugin e 22,56% sem nenhum link (31/08/2026).
Ver como texto
Página da proposta The /llms.txt file, v2, de Jeremy Howard, publicada em 3 de setembro de 2024 e modificada em 10 de agosto de 2026, com a seção Background.
Na medição própria deste projeto, o arquivo mostrou as duas faces. O Perplexity citou uma rota alternativa do site seis vezes por rodada porque o llms.txt apontava para ela, sem nenhum efeito no Google. Na varredura de 09/09/2026, 84 das 481 URLs listadas no arquivo respondiam com redirecionamento. O arquivo pode ficar quando o produto tem documentação técnica lida por agentes de programação; como entregável de busca ou meta de agência, não entra.
| Destinatário | O que faz com o arquivo | Como se sabe disso | Consequência prática |
|---|---|---|---|
| Busca do Google | Ignora | Guia de otimização para busca com IA, publicado em 15/05/2026 e atualizado em 10/07/2026, mais o changelog de 15/06/2026 | Fora de proposta de SEO, fora de KPI e fora de qualquer promessa de posição |
| Motor que consome o arquivo | Segue os endereços que o arquivo indica | Atribuição por URL do monitor de citação deste projeto: seis citações da rota alias por corrida no Perplexity, registradas em 10/09/2026 | O arquivo dirige o motor para onde você apontar, inclusive para a URL errada |
| Agente de programação e servidor MCP | Lê como índice de documentação técnica | Uso corrente em editores com agente; John Mueller registrou em 31/08/2026 que nos sites de teste dele só ferramentas de SEO declaram aceitar Markdown | Caso de uso legítimo, sem relação com busca e sem efeito em ranqueamento |
A regra de leitura é uma só: antes de perguntar se o arquivo funciona, pergunte para quem. A resposta muda a pessoa que vai cobrar o resultado, e muda a métrica que prova que ele aconteceu.
Fonte: Documentação do Google Search Central, declaração de John Mueller e medição própria do monitor de citação e da varredura de 09/09/2026
Guia: decidir por escrito quais robôs de IA entram
Sete passos em duas semanas. Cada um diz quem faz, quanto tempo leva, o que entrega e como você confere.
Passo 1: 1. Levante o que já entra hoje
Quem faz: a equipe técnica, em dois dias. Entrega: tabela dos últimos 30 dias de log com oito robôs (GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, Claude-SearchBot, Claude-User, PerplexityBot, Meta-WebIndexer), acessos e códigos de resposta, com IP conferido.
Deu certo quando: Confira: você diz quantas respostas diferentes de 200 os robôs de busca receberam, e em quais URLs.
Erro comum: Aceitar "está tudo liberado no robots.txt": o bloqueio que apaga a marca costuma morar no firewall.
Passo 2: 2. Escreva a decisão em três linhas, uma por função
Quem faz: você, em 20 minutos. Entrega: treino, busca e citação, ação do usuário, cada linha com "permitir" ou "restringir" e o motivo em uma frase.
Deu certo quando: Confira: nenhuma linha diz "sair da IA"; cada uma nomeia a função.
Passo 3: 3. Some o que cada bloqueio custa
Quem faz: marketing, em um dia. Entrega: sessões e leads vindos de assistentes no último trimestre, pelo canal AI Assistant do GA4, ao lado de cada linha que restringe.
Deu certo quando: Confira: toda restrição tem um número de receita em risco ao lado, mesmo que seja zero.
Passo 4: 4. Decida os dois controles do Google separadamente
Quem faz: você com o jurídico, em 30 minutos. Entrega: o estado do Google-Extended (treino) e do controle Search generative AI do Search Console (resumos), cada um com dono.
Erro comum: Bloquear o Google-Extended achando que sai do AI Overview: ele só trata de treino.
Passo 5: 5. Revise a borda se o site usa Cloudflare
Quem faz: infraestrutura, em uma semana. Entrega: as posições de Search, Agent e Training, a lista de robôs mistos sem selo Accountable que o log mostra e um teste de sete dias em subdomínio.
Erro comum: Tratar a categoria Training como botão de política de conteúdo: robô misto sem selo cai por inteiro.
Passo 6: 6. Publique o robots.txt com o motivo comentado
Quem faz: a equipe técnica, em um dia. Entrega: arquivo em produção com um bloco por fornecedor, a decisão no topo e a data de revisão.
Deu certo quando: Confira: o arquivo aberto no navegador bate com as três linhas assinadas.
Passo 7: 7. Confira em 30 dias e marque a revisão trimestral
Quem faz: você, em 15 minutos. Entrega: nova tabela de log com zero erro servido a robô de busca e a próxima revisão na agenda.
Deu certo quando: Confira: robôs de busca com 100% de respostas 200 e revisão marcada com data.
No fim você tem: a política de acesso assinada, o custo de cada restrição escrito, o robots.txt coerente com ela e a prova de log de que os robôs de busca entram.
Os robôs que importam estão sendo atendidos?
Log de servidor, últimos 30 dias
0/5robots.txt e diretivas
0/5Camada de CDN e WAF
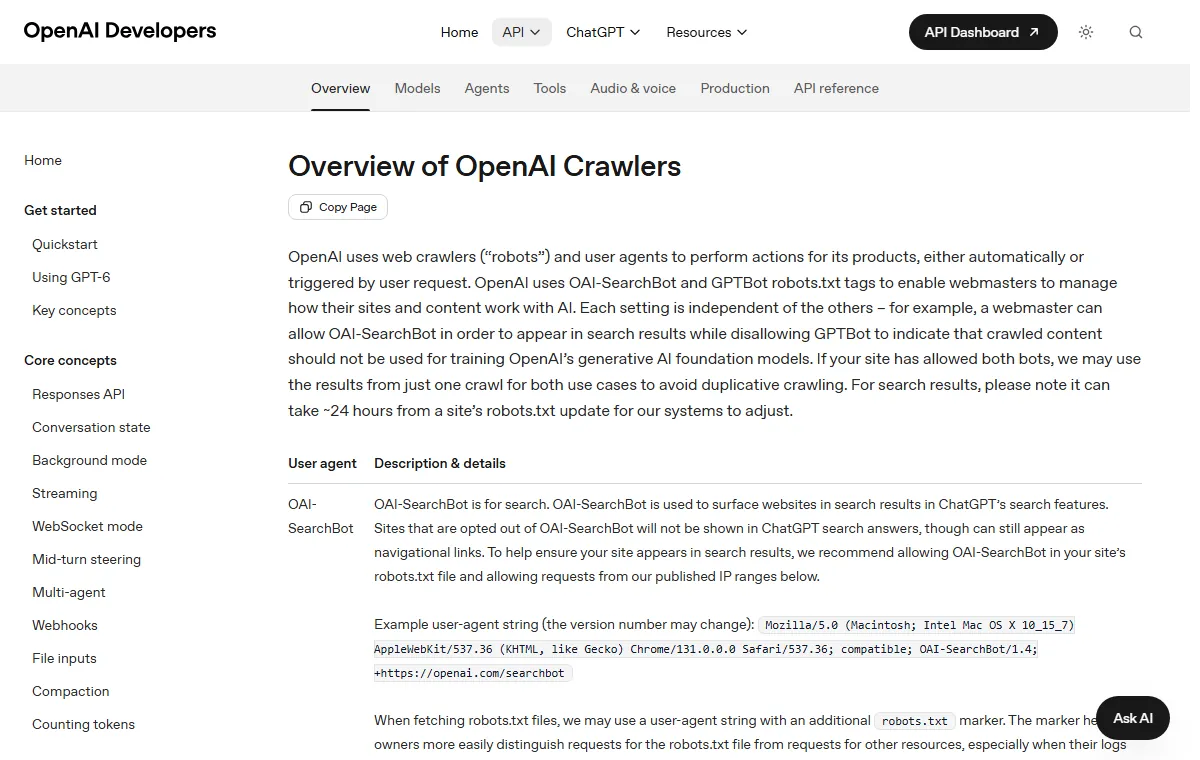
0/4Guia prático de outubro de 2026: o robots.txt por caso de marketing. A pergunta não é liberar ou bloquear a IA. É separar quem busca para citar de quem coleta para treinar. OpenAI e Perplexity documentam robôs diferentes para cada função, e cada regra vale de forma independente, com até 24 horas para surtir efeito.
Revise o robots.txt em uma hora
Para o analista de SEO com acesso ao arquivo e ao log do servidor ou da CDN.
Passo 1: Anote o que vale hoje para cada robô
Abra seudominio.com.br/robots.txt e liste a regra para OAI-SearchBot, GPTBot, PerplexityBot, ClaudeBot, Claude-SearchBot e Google-Extended.
Deu certo quando: Cada nome tem permitir, bloquear ou nenhuma regra, com a data da leitura.
Erro comum: Ler só o grupo User-agent: * e supor que vale para todos.
Passo 2: Libere os robôs de busca
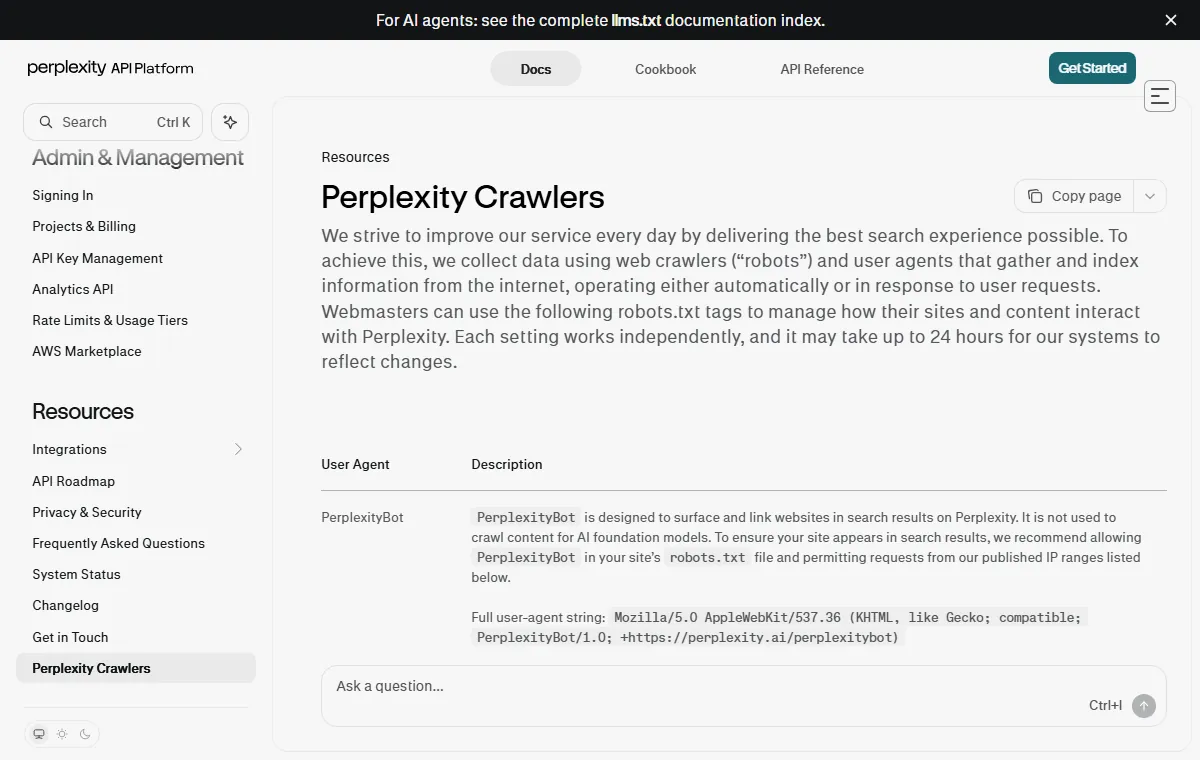
A OpenAI orienta não bloquear o OAI-SearchBot para o site aparecer em resumos e trechos do ChatGPT. Na Perplexity, o PerplexityBot indexa para a busca e não coleta para treinar modelos.
Deu certo quando: OAI-SearchBot e PerplexityBot têm acesso às páginas que você quer ver citadas.
Erro comum: Bloquear tudo que tem IA no nome e perder a citação junto com o treino.
Passo 3: Decida o treino pelo caso
Loja e negócio local costumam liberar, porque o ganho de ser conhecido supera o risco. Editora e infoprodutor com conteúdo pago costumam bloquear GPTBot e Google-Extended nas áreas de aula e de assinante.
Deu certo quando: A decisão sobre treino está escrita, com o motivo e o nome de quem aprovou.
Erro comum: Bloquear o Google-Extended achando que isso tira o site de AI Overviews; esse é o controle do Search Console.
Passo 4: Use noindex para a página que não pode aparecer
A OpenAI avisa que uma página bloqueada no robots.txt ainda pode surgir como link e título, se a URL vier de outra fonte. Para impedir, a página precisa estar liberada ao robô e ter a meta noindex.
Deu certo quando: As páginas sensíveis têm noindex e ficam acessíveis ao robô, que precisa ler a meta.
Erro comum: Bloquear e aplicar noindex na mesma página: o robô nunca lê a meta.
Passo 5: Confirme no log uma semana depois
Filtre os pedidos por nome de robô e confira o código de resposta. Confronte o IP com as listas oficiais publicadas pela OpenAI e pela Perplexity.
Deu certo quando: Nenhum robô de busca liberado aparece com 403, e o volume falso fica separado.
Erro comum: Culpar o robots.txt por um 403 que vem da regra de bots da CDN.
No fim você tem: um robots.txt que libera a busca, decide o treino por escrito e protege as páginas certas com noindex.
Ver como texto
Página Overview of OpenAI Crawlers com a explicação de que cada robô tem regra independente e a linha do OAI-SearchBot com o texto completo do User-Agent
Ver como texto
Página Perplexity Crawlers com a tabela de User Agent e a descrição do PerplexityBot, que não coleta conteúdo para treinar modelos
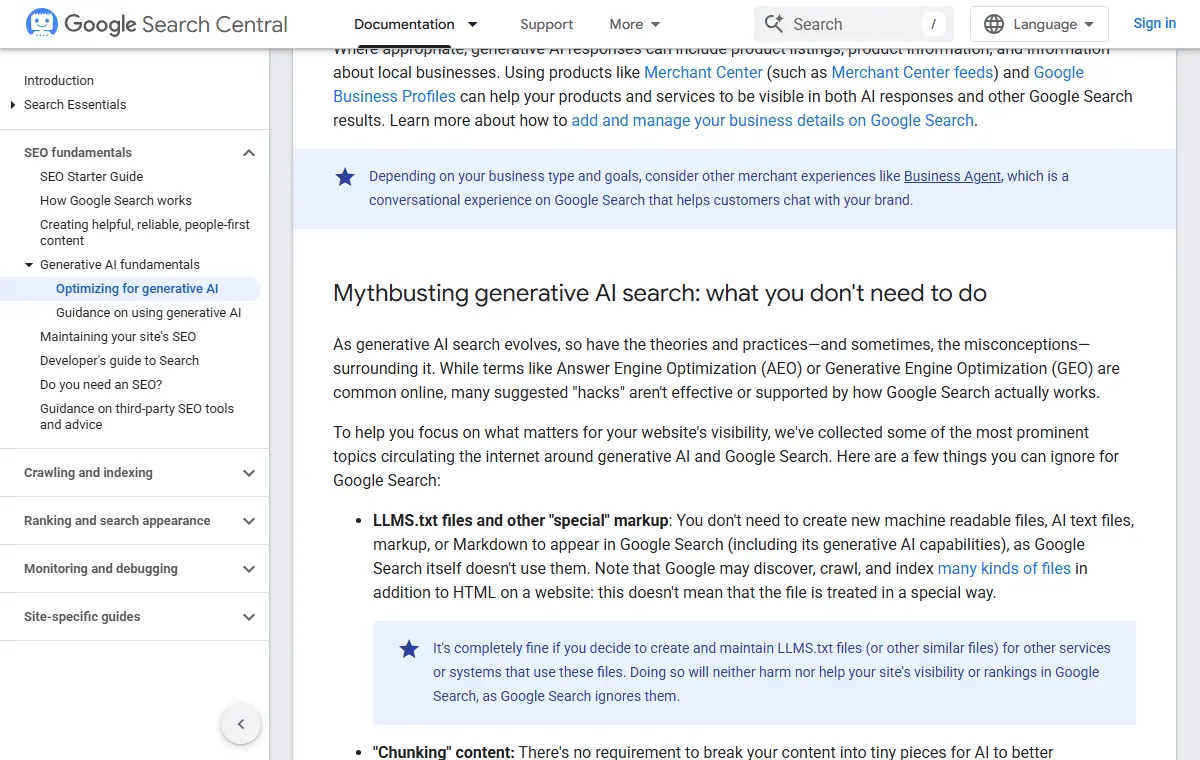
O Google registrou em 15/06/2026 que o arquivo não é necessário para a Busca e não ajuda nem prejudica a visibilidade, mas que não há problema em mantê-lo para outros sistemas. Se já existe e é gerado sozinho, mantenha; se for cobrado como trabalho de GEO, recuse.
Ver como texto
Seção Mythbusting generative AI search do guia do Google, com o item sobre arquivos LLMS.txt e a nota de que a Busca do Google os ignora
Saber quem entra resolve a parte técnica. A decisão de negócio é se a empresa permite, cobra ou bloqueia, e é o assunto do próximo capítulo.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Confira se o site abre bem e pode ser lido pelos buscadoressugerido pelo grafoApresenta os conceitos “Google-Extended”, “PerplexityBot” e “Perplexity-User”, usados em “Quais robôs de inteligência artificial podem ler o site”.
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “GPTBot”, “ClaudeBot” e “meta-webindexer”, usados em “Quais robôs de inteligência artificial podem ler o site”.
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta o conceito “Robots.txt”, usado em “Quais robôs de inteligência artificial podem ler o site”.
- CursoGEO e Knowledge Graphsugerido pelo grafo1 capítulo de “SEO e GEO para quem decide” usa conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- SEO programáticoAvaliar o que favorece a presença nas respostas de IAExaminar conexões de Avaliar o que favorece a presença nas respostas de IA
- Gestão de Projetos GEOO que a equipe controla: robôs, página e a primeira semanaExaminar conexões de O que a equipe controla: robôs, página e a primeira semana
- Glossário Completo de SEO e GEO 2026Confira se o site abre bem e pode ser lido pelos buscadoresExaminar conexões de Confira se o site abre bem e pode ser lido pelos buscadores
- Marcas pessoais na busca e na IAComo conferir o que a IA diz sobre vocêExaminar conexões de Como conferir o que a IA diz sobre você
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.