SEO e GEO para quem decide · Capítulo 28 de 30 · 30 min
Etapa 6: medir com grupo de controle e decidir
Um critério escrito antes da coleta decide cada mudança, sem somar camadas de evidência diferentes.
Este capítulo faz parte do curso gratuito SEO e GEO para quem decide.
Devolva qualquer taxa que chegue sem faixa de incerteza e exija, para cada mudança creditada no relatório, o critério de manter ou reverter escrito com data anterior à coleta.
Exemplo: a equipe reescreveu 12 páginas na primeira semana de outubro e, no dia 20, apresenta alta nas citações como resultado do trabalho. Em 13/10/2026 o Google colocou um modelo novo no AI Mode e, dois dias depois, passou a exibir links mais altos nas respostas. Sem um grupo de páginas que não foram mexidas, não dá para saber quanto da alta é da equipe e quanto é do Google.
Para quem decide: a decisão é aceitar um resultado de GEO como real ou registrá-lo como inconclusivo, e o critério é escrito antes da coleta: diferença mínima na taxa de menção e faixas de incerteza que não se cruzem. Errar custa o trimestre seguinte: uma medição única mostra só 62% a 77% das marcas que cinco rodadas revelam. Pergunta para a equipe: quantas execuções, qual instrumento, qual modelo e qual faixa estão por trás deste número?
O ponto de partida é aceitar que a régua treme. A mesma pergunta feita ao mesmo assistente devolve fontes diferentes a cada execução, mesmo nas configurações vendidas como fixas: Berk Atil e colegas mediram variação de até 15% em cinco modelos (arXiv 2408.04667). Uma rodada só mostra de 62% a 77% das marcas que cinco rodadas revelam (Żatuchin, arXiv 2609.05059, 04/09/2026).
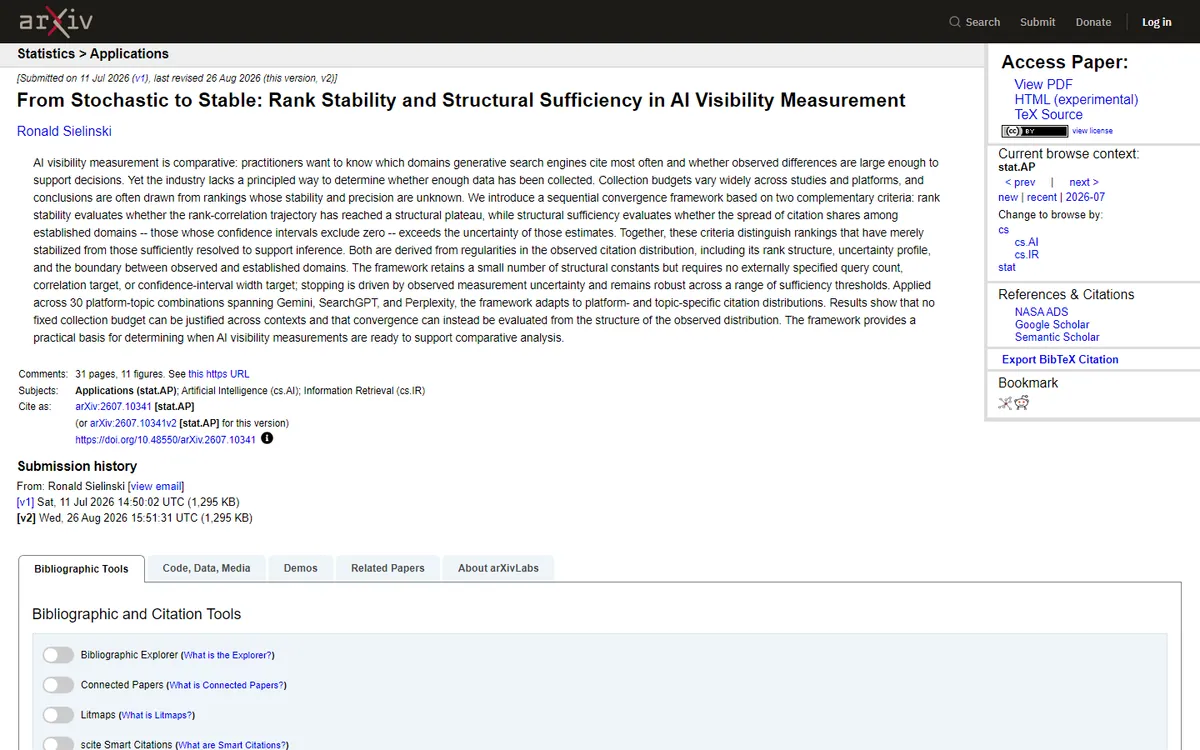
Quantas rodadas bastam também deixou de ser número fixo. Ronald Sielinski (arXiv 2607.10341, versão de 26/08/2026) mostrou, em 30 combinações de plataforma e tema, que a coleta deve parar quando a ordem dos domínios citados se estabiliza, e não num total combinado de antemão.
Ver como texto
Página do arXiv do artigo From Stochastic to Stable, de Ronald Sielinski, versão 2 de 26 de agosto de 2026, com resumo sobre estabilidade de ranking e suficiência na medição de visibilidade em IA.
Ver como texto
A mesma métrica lida de duas formas: no painel de cima, uma execução por mês desenha a linha 12, 18, 15 e 21 por cento e parece tendência de alta; no painel de baixo, os mesmos quatro pontos com trinta execuções e intervalo de confiança de 95 por cento aparecem com barras de erro largas e sobrepostas, mostrando que não há mudança detectável, com a faixa de piso de ruído atravessando os dois painéis.
As oito regras abaixo transformam esses achados em rotina. Cada uma responde a um erro que aparece em relatório de agência; a quinta ganhou em outubro mais um motivo, a troca de modelo de 13/10/2026.
| Regra | O que fazer | Por quê |
|---|---|---|
| 1. Congele e versione o conjunto de prompts | De 100 a 200 prompts num arquivo com data, com paráfrases por intenção. Se o conjunto mudar, a série quebra, e o relatório diz isso | Prompt escolhido depois de ver o resultado é viés de seleção, o erro mais comum em times que reportam para dentro |
| 2. Repita até a convergência | Piso de segurança de 10 execuções por prompt por plataforma, 30 para intervalo de 95%. Pare quando o ranking estabilizar e a diferença entre domínios superar a incerteza; reporte quantas execuções isso exigiu. Não feche a lista de concorrentes | arXiv 2607.10341: nenhum orçamento fixo se justifica; arXiv 2609.05059: uma rodada mostra 62% a 77% das marcas, e lista fixa fabrica platôs |
| 3. Reporte distribuição, nunca ponto | Taxa de menção de 18%, IC 95% de 11% a 26%, n igual a 30, ChatGPT com busca, modelo declarado, pt-BR, Brasil, 12 a 18 de julho. Nunca "estamos em 18%" | arXiv 2604.07585: a observação pontual não é confiável |
| 4. Não reporte movimento dentro do ruído | Intervalos sobrepostos significam sem mudança detectável, e essa é a frase que vai para o slide | arXiv 2603.08924: muitas diferenças aparentes caem no piso de ruído |
| 5. Documente o instrumento, com modelo | API ou interface, modelo e versão, busca web ligada ou desligada, localidade e idioma, sessão limpa ou com histórico, data e hora | O modelo por trás da resposta muda dentro do mês: o AI Mode trocou de Flash três vezes em seis semanas, o 3.8 Flash respondeu sem links em 03/09 e o Google prometeu correção em 04/09, e em 13/10/2026 o Gemini 4 Argon chegou ao AI Mode para assinantes dos planos pagos |
| 6. Publique o denominador | Conjunto de prompts, plataforma e número de execuções em toda participação de voz | O denominador muda a cada conjunto e move o resultado sem que nada tenha acontecido no mundo |
| 7. Meça um controle | Dois ou três concorrentes, uma marca irrelevante para o tema e, quando o teste é de conteúdo, páginas do próprio domínio que não receberam a mudança | Marca irrelevante com taxa parecida com a sua denuncia conjunto de prompts que induz a resposta; arXiv 2606.04362: 5,7 vezes bruto virou 1,82 vez com controle |
| 8. Não leia razão calculada sobre poucos eventos | Piso de 30 impressões por lado antes de comparar posição média entre janelas, e a mesma disciplina para qualquer taxa. Abaixo do piso, o relatório informa a contagem e omite a comparação | Apuração própria de 10/09/2026: quatro URLs com uma a três impressões por dia produziram queda aparente de 1,5 para 46,5 de posição média, sobre duas impressões de cada lado |
As regras 2 e 7 mudaram em 2026: a regra de parada substituiu o número fixo, e o controle ganhou a versão mais barata, que é a própria propriedade.
Dez execuções por pergunta e por plataforma são o piso para leitura de direção; 30 continuam a referência para uma faixa de 95%. A calculadora mostra por que a faixa é larga: com 30 execuções e taxa de 50%, a margem fica perto de 18 pontos para cima e para baixo, e quadruplicar as execuções só corta a margem pela metade.
Quanto a sua amostra realmente sabe: largura do intervalo por número de execuções
Mova os dois controles para montar o total de execuções por prompt, somando a primeira rodada e a rodada de repetição. A margem indicada abaixo usa a aproximação normal de 95% com taxa observada de 50%, que é o pior caso, ou seja, o ponto em que o intervalo fica mais largo. Taxas próximas de zero ou de cem estreitam o intervalo: com 30 execuções, a margem é de 10,7 pontos para uma taxa de 10% e de 17,9 pontos para 50%. Quadruplicar o n corta a margem pela metade, porque o ganho vai com a raiz. Cálculo próprio deste curso pela fórmula padrão de intervalo para proporção; use o bootstrap do exemplo em Python quando as execuções vierem de prompts repetidos.
Quantas vezes você roda cada prompt na coleta de baseline, na mesma plataforma e com o mesmo instrumento.
Repetição é o que aumenta o n sem mexer no conjunto de prompts. Trocar prompts para ganhar volume quebra a série temporal.
Com dez execuções, uma taxa observada de 50% vem acompanhada de margem de cerca de 31 pontos, ou seja, o intervalo cobre de 19% a 81%. Esta faixa serve para leitura direcional interna e não sustenta comparação entre dois períodos nem entrada em relatório de resultado. Se o total ficar aqui, a frase correta no slide é que a coleta ainda não distingue movimento de ruído.
Quanto a sua amostra realmente sabe
Mexa no número de execuções e na taxa observada. Comece com n igual a 10 e repare na largura do intervalo antes de tirar qualquer conclusão. Depois suba para 30 e para 60 e observe onde o ganho de precisão começa a desacelerar.
Mês 1: taxa de 18% com intervalo de 95% de 0,0% a 41,8%, margem de 23,8 pontos, n igual a 10 execuções. Mês 2: taxa de 24% com intervalo de 0,0% a 50,5%, margem de 26,5 pontos, n igual a 10 execuções. Os dois intervalos se sobrepõem, então a leitura honesta é sem mudança detectável.
Atenção: com n em torno de 10 o intervalo cobre quase todo o eixo, e essa leitura não sustenta comparação entre dois períodos nem entrada em relatório de resultado.
Aproximação de Wald para proporção, adequada para planejamento. A margem cai com a raiz de n, então quadruplicar as execuções corta a margem pela metade e não a um quarto. Ancorado em arXiv 2604.07585 e arXiv 2603.08924, que o curso já cita: quando os intervalos se sobrepõem, movimento de posição não deve ser reportado como resultado.
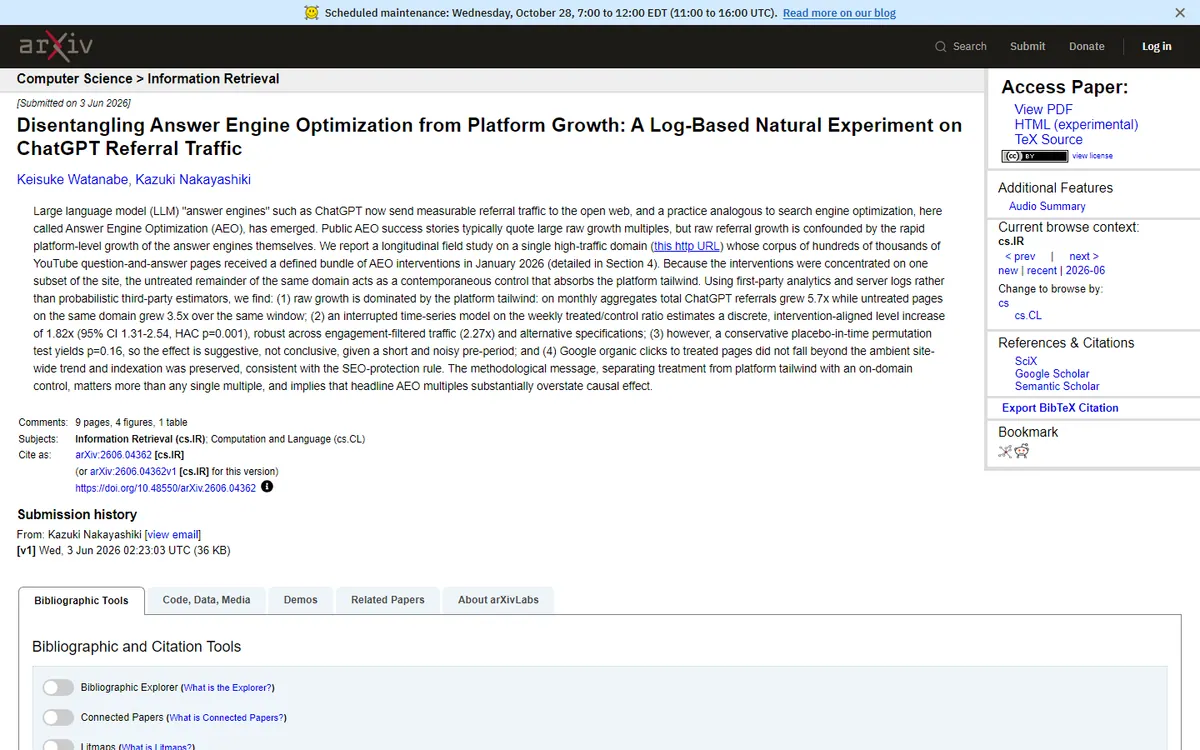
O grupo de controle mais barato é a própria empresa. Keisuke Watanabe e Kazuki Nakayashiki (arXiv 2606.04362, 03/06/2026) mediram as visitas vindas do ChatGPT para páginas otimizadas e para páginas do mesmo site que não receberam nada. O total cresceu 5,7 vezes e as páginas sem mudança, 3,5 vezes, porque o ChatGPT inteiro cresceu no período. Descontado esse crescimento, o efeito atribuível foi de 1,82 vez, e o teste de placebo (aplicar o método a uma data em que nada mudou) deu resultado sugestivo, sem ser conclusivo.
Ver como texto
Página do arXiv do artigo Disentangling Answer Engine Optimization from Platform Growth, de Watanabe e Nakayashiki, enviado em 3 de junho de 2026, com resumo sobre tráfego de indicação do ChatGPT.
O mesmo case, do número bruto ao número defensável
5,7x
crescimento bruto do referral do ChatGPT
O número que vai para o slide de fornecedor
3,5x
crescimento das páginas não tratadas do mesmo domínio
O controle na própria propriedade
1,82x
salto atribuível à intervenção no modelo
IC de 95% de 1,31 a 2,54
p = 0,16
teste placebo no tempo
Efeito sugestivo, não conclusivo
Fonte: Keisuke Watanabe e Kazuki Nakayashiki, "Disentangling Answer Engine Optimization from Platform Growth", arXiv:2606.04362, 03/06/2026. Achados do resumo do artigo.
O instrumento também precisa ser declarado. A coleta feita pela API do modelo, a porta de acesso para programadores, não reproduz o que o usuário vê na tela, e esse é o erro de método mais comum em ferramenta de monitoramento.
Fronteira metodológica que quase nenhum fornecedor destaca: coleta por API não reproduz o que o usuário vê. O produto de consumo aplica localização, memória, personalização, busca web e formatação de citação que a API não aplica. Uma chamada de API sem busca devolve apenas a memória do modelo, e pode retornar zero citações num prompt em que o usuário real vê cinco. A coleta por interface captura mais da realidade, é frágil e pode violar termos de serviço. Antes de assinar qualquer ferramenta, exija por escrito: coleta por API ou por interface, modelo exato, busca web ligada ou não, localidade, execuções por prompt por período e como a regra de parada é aplicada. Fornecedor que não responde está vendendo um número que você não consegue defender, e o preço não é o problema desse produto. A segunda fronteira é do lado do resultado. O GA4 mede cliques resultantes de IA e os subestima por magnitude desconhecida, porque sessões sem cabeçalho de referrer (a etiqueta que diz de onde a visita veio) caem em Direto. Aplicativos nativos de assistente frequentemente não enviam essa etiqueta. Escrever desconhecido é mais honesto e mais defensável do que qualquer faixa sem método. Visibilidade em IA o GA4 simplesmente não mede, e confundir cliques vindos de IA com visibilidade em IA é o erro de medição mais comum do mercado.
As três camadas de evidência organizam o resto e nunca viram um índice único. Acessibilidade (o robô pega a página?) vem do log e é censitária; visibilidade (a IA cita a marca?) vem de amostragem e é ruidosa; consequência (virou visita, contato, venda?) vem do GA4 e do CRM e é sabidamente subestimada. Somar um dado censitário com um dado ruidoso produz um número que não tem a confiabilidade de nenhum dos dois.
| Camada | Pergunta que responde | Fonte | Confiabilidade | Sob seu controle |
|---|---|---|---|---|
| Acessibilidade | O robô consegue pegar a página? | Log de servidor; impressões em IA do Search Console | Alta, é censitário | Sim |
| Visibilidade | A IA menciona a marca, cita uma URL dela ou a recomenda? | Amostragem de prompts, com modelo declarado | Média, estatístico e ruidoso | Não |
| Consequência | Gerou visita, lead, receita? | GA4, CRM e pergunta autodeclarada | Baixa a média, sabidamente subestimado | Parcialmente |
A coluna de confiabilidade é o motivo de as três nunca serem somadas. Cada linha responde a uma pergunta diferente, com um instrumento diferente, e a única leitura válida é lado a lado. No relatório para a diretoria, a camada de consequência se abre em duas, visita e resultado, porque o viés de cada uma é diferente, e a posição orgânica entra como camada própria: o capítulo de monitoramento traz as quatro lado a lado.
Ver como texto
As três camadas de evidência em pirâmide invertida: acessibilidade censitária e sob seu controle no topo largo, visibilidade amostral e ruidosa no meio, consequência subestimada na ponta estreita. Abaixo de cada camada, a barra que indica onde o Twin Branch consegue decidir cobre inteiramente as duas primeiras camadas e apenas parte da terceira, e uma faixa tachada proíbe somar tudo num score único de GEO.
Comece pela acessibilidade, a camada mais barata e a única em que se encontra defeito de verdade: um 403 servido ao robô de citação é citação perdida em silêncio. Para marca nova, ela é o indicador principal, porque o primeiro progresso acontece na cauda das citações, onde a instabilidade é maior e quase tudo parece ruído.
Na consequência, calibre a expectativa pela evidência experimental. Dois experimentos independentes de 2026, o de Agarwal e Sen com 1.065 usuários e o de Wang e colegas com 1.100 participantes (arXiv 2608.18352), chegaram à mesma direção: quando o resumo de IA aparece, cliques para sites caem. Ser citado vale na camada da visibilidade e não garante visita.
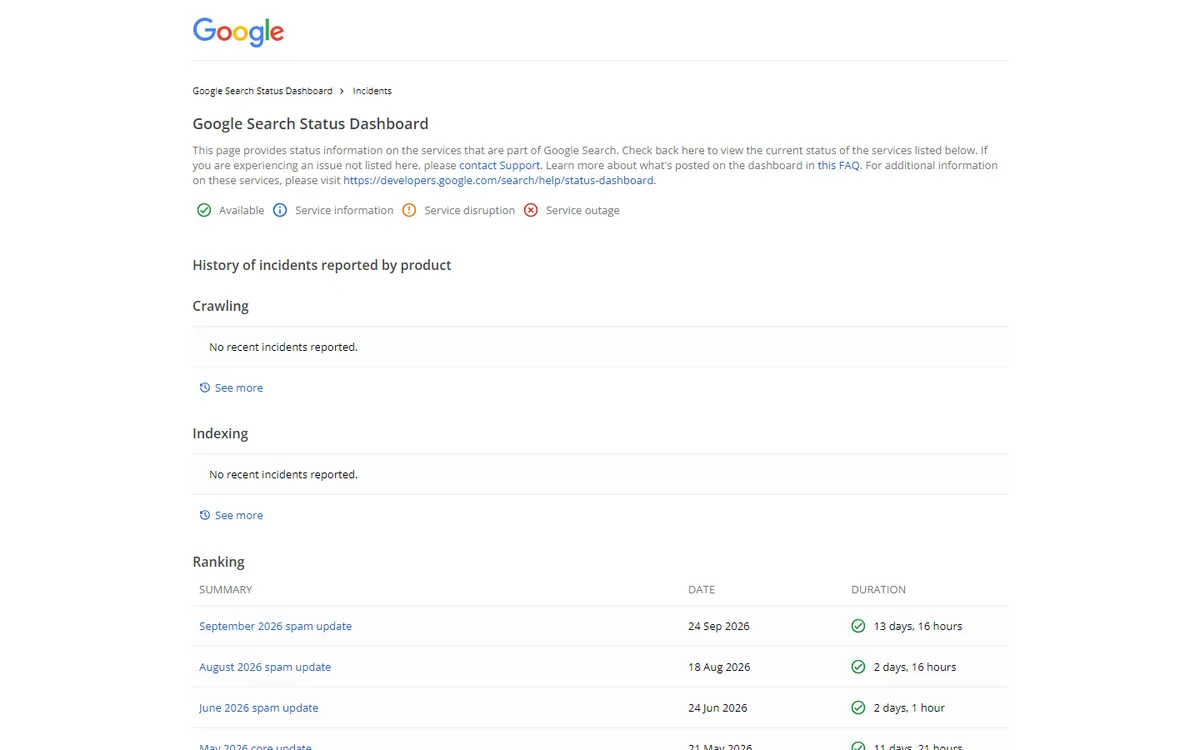
Toda série precisa do calendário de quebras ao lado. Cada atualização do Google com data de início e duração aparece no painel público de status; se o teste caiu dentro de uma delas, a comparação está contaminada para os dois grupos, teste e controle.
Ver como texto
Histórico de incidentes do Google Search Status Dashboard, seção Ranking, listando September 2026 spam update (24 de setembro de 2026, 13 dias e 16 horas), August 2026 spam update, June 2026 spam update e May 2026 core update.
O que quebrou a sua série entre maio e outubro de 2026
- 13/05/2026Concluído
Início do canal AI Assistant no GA4
Classifica sessões vindas de assistentes só a partir desta data, sem reprocessar o passado; AI Overviews e AI Mode ficam fora.
- 31/08/2026Concluído
Relatório de IA do Search Console para todos os sites
Impressões em AI Overviews e AI Mode por página, país, dispositivo e data, sem cliques. Buraco de 13 a 17/08 restaurado em 21/08.
- 01/09/2026Concluído
Dia sem dados no GA4
Somado às URLs goto do Google desde 26/08 e à troca de modelo do AI Mode em 02/09.
- 24/09/2026Concluído
Filtro de busca multimodal no Search Console
Buscas feitas com imagem ganham relatório próprio; agosto e setembro deixam de ser a mesma série.
- 24/09 a 08/10/2026Concluído
Spam update de setembro
Global, em todos os idiomas, com 13 dias e quase 16 horas, o mais longo dos quatro spam updates de 2026 (painel de status do Google).
- 13/10/2026Concluído
Gemini 4 Argon no AI Mode para assinantes
Escolhido no menu do AI Mode pelos planos pagos; o padrão gratuito segue no Gemini 3.5 Flash (Search Engine Journal).
- 15/10/2026Concluído
Links mais altos dentro das respostas
Google passa a mostrar links no texto do AI Mode e das Visões gerais com mais frequência (9to5Google e Search Engine Journal).
- 24/10/2026Agora
Onde você está agora
Cerca de cinco meses de série do GA4 e menos de dois da série oficial do Search Console. Comparação ano contra ano segue inviável.
- 13/05/2027Previsto
Primeira comparação anual possível no GA4
Antes desta data, variação anual apresentada como resultado compara com um período em que o instrumento não media.
O Twin Branch é o procedimento que fecha o ciclo: medir a versão nova e a antiga na mesma janela, com o critério de aprovação escrito antes da coleta e três saídas possíveis, manter, reverter ou inconclusivo. O protocolo foi proposto por Beining Wu e colegas (arXiv 2604.19516, aceito no ACL 2026 Findings) num desenho de laboratório; este curso o adapta à rotina editorial.
O valor de referência deste curso é diferença de pelo menos 0,05 na métrica escolhida, com a condição de as faixas de incerteza dos dois grupos não se cruzarem. O 0,05 é convenção operacional do curso, não constante de literatura. Com volume pequeno, aumente a janela em vez de afrouxar o critério.
Ver como texto
O fluxo do Twin Branch em sete etapas numeradas, de cima para baixo, terminando num gate condicional que pergunta se o delta é maior ou igual a 0,05 e se os intervalos de confiança não se sobrepõem, com três saídas: manter e documentar, registrar inconclusivo quando os intervalos se sobrepõem, e reverter quando o delta fica abaixo do gate; antes do gate, a lista do que invalida a rodada inteira.
Aprovar, reverter ou inconclusivo
Suba o delta observado até um valor grande e depois aumente a largura dos intervalos. Procure a faixa em que o delta é alto e o veredito ainda é inconclusivo. É esse ponto que separa medição honesta de teatro de medição.
Os intervalos das duas medições se sobrepõem, então a diferença é compatível com duas amostras da mesma distribuição. Delta acima do gate com intervalos sobrepostos ainda é inconclusivo: a saída honesta é estender a janela e aumentar o n, sem afrouxar o gate.
Delta observado de 6,0 pontos, sobre baseline de 15%. Medição A: 7,0% a 23,0%. Medição B: 13,0% a 29,0%. Intervalos sobrepostos. Gate de delta cumprido. Veredito: Inconclusivo.
O valor de 0,05 é convenção operacional deste framework, calibrada para barrar ruído, e não constante derivada de literatura. O baseline de 15% é âncora fixa do simulador, escolhida para caber no eixo. A terceira saída, inconclusivo, é o que impede o teste de aprovar sorte quando o delta parece grande mas os intervalos ainda se cobrem.
A condição das faixas é o que impede o teste de aprovar sorte. Antes de decidir, confira se o intervalo do grupo alterado e o do controle se sobrepõem; se sim, a saída honesta é inconclusivo, mesmo com diferença acima do critério e trabalho já investido. O caso abaixo é esse dilema.
Ver como texto
Página do arXiv do artigo Quantifying Uncertainty in AI Visibility, de Ronald Sielinski, versão 3 de 26 de agosto de 2026, com resumo que cita intervalos de confiança por bootstrap.
A equipe implementou marcação estruturada nova em doze páginas de uma seção, com gate definido por escrito antes da coleta: delta maior ou igual a 0,05 na taxa de menção, com a condição adicional de os intervalos de confiança não se sobreporem. A janela de duas semanas fechou. O baseline deu taxa de menção de 0,14, com IC 95% de 0,08 a 0,21, n igual a 30 execuções por prompt. A releitura deu 0,20, com IC 95% de 0,13 a 0,28, mesmo n, mesmo instrumento, mesmo modelo, mesma localidade. O delta é de 0,06, acima do gate. Os intervalos se cobrem de 0,13 a 0,21, ou seja, na maior parte da extensão de ambos. A apresentação de fechamento é depois de amanhã.
Qual saída do Twin Branch você registra na ata?
| Enriquecimento testado | Janela mínima | Métrica do gate | Armadilha específica |
|---|---|---|---|
| Marcação estruturada nova numa página | 2 semanas | Taxa de menção da página no conjunto de prompts | Confundir aparecer no validador com aparecer na resposta |
| Reescrita de página com resposta direta no topo | 3 semanas | Taxa de menção mais posição da citação | Reescrever cinco páginas na mesma janela e não saber qual funcionou |
| Expansão de perfis sameAs consistentes | 4 semanas | Taxa de menção da entidade em prompts de identidade | Efeito lento demais para janela de 4 semanas em marcas pequenas |
| Nova frente de presença externa | 8 semanas | Taxa de menção mais acessos verificados nos logs | A frente leva mais tempo para ser indexada do que para publicar |
| Correção de bloqueio a robô de citação | 2 semanas | Acessos verificados com status 200 nos logs | Esta é a única em que a camada de acessibilidade já responde sozinha |
| Servidor MCP de leitura | Indefinida | Nenhuma métrica de visibilidade responde a isso | Não teste com Twin Branch, porque não há mecanismo esperado |
As janelas são heurísticas de praticante, calibradas por tempo típico de recrawl e de atualização de índice, e não por estudo publicado. O valor de 0,05 usado como gate de delta é convenção operacional deste framework, e não constante derivada de literatura.
Para quem roda a medição, o código abaixo calcula a faixa de 95% por bootstrap, reamostrando por pergunta, que é a unidade que se repete no desenho. Faixa larga com poucas perguntas é a resposta correta do instrumento: ele está dizendo que ainda não sabe.
# Exemplo trabalhado: intervalo de confiança por bootstrap sobre execuções.
# Método de Sielinski, arXiv 2603.08924 (versão 3, 26/08/2026), adaptado.
# Decisão 1: uso bootstrap e não fórmula analítica porque a métrica é uma
#   proporção com n pequeno (30) e as execuções não são independentes de forma
#   limpa (mesmo prompt repetido), o que quebra as suposições da aproximação normal.
# Decisão 2: reamostro por PROMPT e não por execução solta, porque a unidade que
#   se repete no desenho é o prompt. Reamostrar execução solta subestima a
#   incerteza e produz intervalo estreito demais, o que é pior do que não ter intervalo.
# Decisão 3: 1000 reamostragens. Acima disso o ganho de estabilidade é marginal
#   para reportar percentis 2,5 e 97,5.

import random

# execuções[prompt] = lista de 0/1, uma entrada por execução daquele prompt.
# 1 = a marca foi mencionada na resposta; 0 = não foi.
execuções = {
    "p01": [1, 0, 0, 1, 0],
    "p02": [0, 0, 0, 0, 0],
    "p03": [1, 1, 1, 0, 1],
    "p04": [0, 1, 0, 0, 0],
    "p05": [0, 0, 1, 0, 0],
    "p06": [1, 0, 0, 0, 0],
}


def taxa(amostra_prompts):
    """Taxa de menção agregada sobre a lista de prompts recebida."""
    plano = [r for p in amostra_prompts for r in execuções[p]]
    return sum(plano) / len(plano)


def ic95_bootstrap(n_reamostragens=1000, semente=42):
    rng = random.Random(semente)  # semente fixa: o relatório precisa ser reproduzível
    prompts = list(execuções.keys())
    k = len(prompts)
    distribuição = []
    for _ in range(n_reamostragens):
        amostra = [rng.choice(prompts) for _ in range(k)]  # com reposição
        distribuição.append(taxa(amostra))
    distribuição.sort()
    baixo = distribuição[int(0.025 * n_reamostragens)]
    alto = distribuição[int(0.975 * n_reamostragens)]
    return taxa(prompts), baixo, alto


ponto, baixo, alto = ic95_bootstrap()
n_exec = sum(len(v) for v in execuções.values())
print(
    f"taxa de menção {ponto:.1%} "
    f"(IC 95%: {baixo:.1%} a {alto:.1%}; "
    f"n={n_exec} execuções em {len(execuções)} prompts)"
)

# Leitura do resultado: com 6 prompts o intervalo sai largo, e isso é a resposta
# correta, não um defeito do código. Intervalo largo com n pequeno é o instrumento
# dizendo que você ainda não sabe. A saída é coletar mais, nunca estreitar o
# intervalo escolhendo um método mais generoso.Quatro semanas à mão antes de automatizar
Rode a coleta em planilha manual por um mês antes de escrever qualquer automação.
- Você aprende a reconhecer a cara do ruído, coisa que script nenhum ensina.
- Depois de automatizar, mantenha dez perguntas por mês feitas à mão.
- Coletor quebrado devolve zero citações com aparência de queda real.
- A coleta manual é o controle da automação.
O teste: Compare a coleta manual com a automática no mesmo dia. Divergência grande é coletor quebrado.
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
Para quem monta o relatório mensal
Em que ordem a diretoria lê o relatório?
Em três níveis. Nível 1, negócio: conversões orgânicas, de visitas vindas de IA, autodeclaradas e de anúncio em IA. Nível 2, visibilidade: citação e menção por motor com modelo e execuções até a convergência, impressões em IA do Search Console, fatia de página própria e cobertura de feed. Nível 3, apoio, trimestral: sentimento, substituição, backlinks e prontidão para agentes. Cinco linhas nunca se misturam: orgânico clássico, citação orgânica em IA, visita vinda de IA (sempre como piso), anúncio em IA e conversão assistida ou autodeclarada.
Quais são os dez blocos do relatório mensal?
1. Sumário executivo em cinco linhas: ganhos, perdas, riscos, decisões, próximos testes; 2. Nível 1: conversões orgânicas, conversões de referral de IA, autodeclaradas e pago em IA; 3. Nível 2: visibilidade por motor (ChatGPT, Perplexity, Gemini, AI Overviews, AI Mode com modelo, Copilot, Claude e Claude Code separados), com n exigido pela regra de parada e faixa; 4. Impressões em IA do Search Console por página; 5. Páginas vencedoras e perdedoras por URL; 6. Concorrentes e fontes citáveis por motor: participação de voz, lacunas de fonte, fatia de página própria; 7. Técnico e agentes: crawl, schema, feeds, regras de bot, camadas de prontidão para agentes, quebras de série; 8. Conteúdo publicado e a hipótese de cada peça; 9. Nível 3 trimestral: sentimento, substituição, backlinks; 10. Plano de 30 dias com prioridade, responsável e prazo.
Por que o GA4 subestima a visita vinda de IA?
O canal AI Assistant classifica sessões desde 13/05/2026 a partir de uma lista de assistentes que o Google não publica inteira, e exclui AI Overviews e AI Mode, contados como busca orgânica. Aplicativos de assistente muitas vezes não enviam a etiqueta de origem da visita, e a sessão cai em Direto. Mantenha um grupo próprio de canais por expressão regular sobre a origem da sessão e uma pergunta de "como nos conheceu" no formulário, com o viés da autodeclaração escrito no relatório.
Relatório de medição honesta, em uma linha reportável
Preencha os campos e o parágrafo abaixo se monta sozinho. Ele foi desenhado para que seja impossível entregar um número sem instrumento, sem modelo, sem localidade, sem n e sem intervalo. Se algum campo ficar vazio, o marcador aparece no documento montado, e é essa lacuna que você leva para a reunião em vez de um número que não se sustenta.
Documento montado
RELATÓRIO DE MEDIÇÃO DE VISIBILIDADE

Métrica: {{metrica_nome}}

Resultado: [TAXA OBSERVADA], com intervalo de confiança de 95% de [INTERVALO DE CONFIANÇA DE 95%], sobre [NÚMERO DE EXECUÇÕES (N) ATÉ A CONVERGÊNCIA, E NÚMERO DE PROMPTS].

Instrumento e modelo declarados: [INSTRUMENTO E MODELO]. Localidade e idioma: [LOCALIDADE E IDIOMA]. Período: {{periodo_medido}}.

Calibração do instrumento: a marca-controle irrelevante registrou [TAXA DA MARCA-CONTROLE IRRELEVANTE]. Se essa taxa estiver próxima da taxa medida, o conjunto de prompts está induzindo a resposta e a rodada deve ser descartada antes de qualquer leitura.

Comparação com o período anterior: [COMPARAÇÃO COM O PERÍODO ANTERIOR, EM UMA DAS TRÊS FORMAS].

Limites desta medição: [O QUE ESTE NÚMERO NÃO PERMITE AFIRMAR].

Frase reportável, para o slide:
"{{metrica_nome}} de [TAXA OBSERVADA] (IC 95%: [INTERVALO DE CONFIANÇA DE 95%]; [NÚMERO DE EXECUÇÕES (N) ATÉ A CONVERGÊNCIA, E NÚMERO DE PROMPTS]; [INSTRUMENTO E MODELO]; [LOCALIDADE E IDIOMA]; {{periodo_medido}}). Contra o período anterior: [COMPARAÇÃO COM O PERÍODO ANTERIOR, EM UMA DAS TRÊS FORMAS]."
O que você digitar fica salvo neste navegador. Nada é enviado para servidor algum.
Sem voltar ao texto, escreva a frase que você colocaria no relatório para descrever este resultado. A taxa de menção do mês passado foi 14% com IC 95% de 8% a 21%; a deste mês foi 19% com IC 95% de 12% a 27%; ambas com n igual a 30. A frase precisa dizer o que aconteceu e o que não pode ser afirmado. Depois preveja: se você tivesse rodado 100 execuções em vez de 30 e as taxas continuassem 14% e 19%, o que mudaria na sua frase?
Faça agora (20 min, além da leitura)
Cinco movimentos que a pessoa que decide executa sobre o último relatório recebido, sem abrir planilha nenhuma.
Passo 1: Procure a faixa ao lado de cada taxa
Toda taxa de menção, de citação por URL ou de recomendação precisa de intervalo, número de execuções, instrumento e modelo na mesma linha. Marque as que vieram soltas.
Deu certo quando: Cada número do relatório tem faixa e n, ou está marcado para devolução.
Erro comum: Aceitar "subimos de 14% para 19%" sem as faixas.
Passo 2: Pergunte se os intervalos se cruzam
Se as faixas do mês passado e deste mês se sobrepõem, a frase correta é sem mudança detectável, e é ela que vai para o slide.
Deu certo quando: Nenhum movimento dentro do ruído apresentado como resultado.
Passo 3: Exija o gate escrito antes da coleta
Para cada mudança que o relatório credita, peça a data do documento em que o critério de aprovação foi definido. Sem data anterior à coleta, o resultado é inconclusivo por definição.
Deu certo quando: Um gate datado por mudança creditada.
Erro comum: Gate ajustado depois de ver o número.
Passo 4: Peça o controle
Marca irrelevante no conjunto de prompts e, em teste de conteúdo, páginas do próprio domínio que não receberam a mudança. Sem controle, o crescimento pode ser da plataforma.
Deu certo quando: O relatório mostra o bruto e o descontado, como 5,7x e 1,82x.
Passo 5: Confira as quebras de série e o modelo
13 a 17/08 (Search Console), 26/08 (goto), 01/09 (GA4), 24/09 (filtro multimodal), 24/09 a 08/10 (spam update), 13/10 (Gemini 4 Argon) e 15/10 (links nas respostas). Toda comparação que cruza essas datas leva nota, e toda leitura de AI Mode declara o modelo.
Deu certo quando: As quebras estão anotadas no calendário do relatório.
Erro comum: Comparar setembro com outubro sem a nota do spam update.
No fim você tem: a lista de números devolvidos por falta de faixa, os gates datados por mudança, o controle exigido por escrito e as quebras de série anotadas para o próximo relatório.
Confira antes de fechar: cada taxa do relatório tem faixa, número de execuções, instrumento e modelo; cada mudança creditada tem critério datado antes da coleta; e as quebras de 24/09 a 15/10/2026 estão anotadas. No exemplo da reescrita de outubro, a resposta honesta é comparar as 12 páginas com um grupo de páginas não mexidas no mesmo período e, se as faixas se cruzarem, registrar inconclusivo.
Com a régua de medição pronta, a etapa 7 junta tudo num plano de 90 dias com regra de parada assinada antes do primeiro gasto.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta os conceitos “Spam update” e “AI Mode”, usados em “Etapa 6: medir com grupo de controle e decidir”.
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “Agent Readiness”, “AEO” e “Search Status Dashboard”, usados em “Etapa 6: medir com grupo de controle e decidir”.
- CursoGEO e Knowledge Graphsugerido pelo grafo1 capítulo de “SEO e GEO para quem decide” usa conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Gestão de Projetos GEOQuando uma queda merece reuniãoExaminar conexões de Quando uma queda merece reunião
- E-E-A-T e Qualidade de ConteúdoTrês indicadores para levar à diretoriaExaminar conexões de Três indicadores para levar à diretoria
- SEO programáticoConferir uma fonte antes de usar o númeroExaminar conexões de Conferir uma fonte antes de usar o número
- CRO: Otimização de Conversão e ExperimentaçãoAntes de aprovar o vencedor: seis checagens de validadeExaminar conexões de Antes de aprovar o vencedor: seis checagens de validade
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.