SEO e GEO para quem decide · Capítulo 24 de 30 · 25 min
Etapa 2: abrir o site aos robôs certos
Robô de citação atendido, conteúdo presente sem JavaScript, três limiares de velocidade e só a marcação que ainda funciona.
Este capítulo faz parte do curso gratuito SEO e GEO para quem decide.
Peça à equipe três provas que cabem numa folha: o código de resposta que o servidor deu a cada robô de citação nos últimos sete dias, o estado dos dois controles do Google com o nome de quem decidiu e a confirmação de que a página principal existe sem JavaScript. Com elas, você aprova ou devolve a parte técnica de qualquer plano de busca com IA.
Exemplo: a empresa lança o site novo, bonito e rápido no navegador do diretor, e três semanas depois a marca some das respostas do ChatGPT. Quando alguém abre a página como um robô a abre, a tela vem em branco: o conteúdo só aparece depois que o JavaScript roda, e o robô não esperou.
Para quem decide: a decisão desta etapa é aprovar a política de acesso dos robôs e exigir que o conteúdo exista no HTML servido, antes de qualquer gasto com texto novo. Errar custa invisibilidade sem sintoma: um firewall que devolve 403 ao OAI-SearchBot tira a marca das respostas do ChatGPT e nenhum relatório de tráfego acusa. Pergunta para a equipe: qual código de resposta o servidor deu a OAI-SearchBot, Claude-SearchBot e PerplexityBot nos últimos sete dias?
A postura certa vem do próprio Google. O guia oficial de otimização para busca com IA, publicado em 15/05/2026 e atualizado em 10/07/2026, diz que otimizar para a busca generativa "is optimizing for the search experience, and thus still SEO". A mesma página afirma que não existe marcação especial a acrescentar para aparecer nos resumos de IA.
A etapa técnica, portanto, é o SEO técnico feito com disciplina, mais uma decisão nova: quais robôs de inteligência artificial entram no site. Robô (ou crawler) é o programa que visita as páginas e copia o texto para um índice ou para um modelo. Cada empresa de IA mantém vários, cada um com uma função, e liberar ou barrar um deles tem consequências diferentes.
Ver como texto
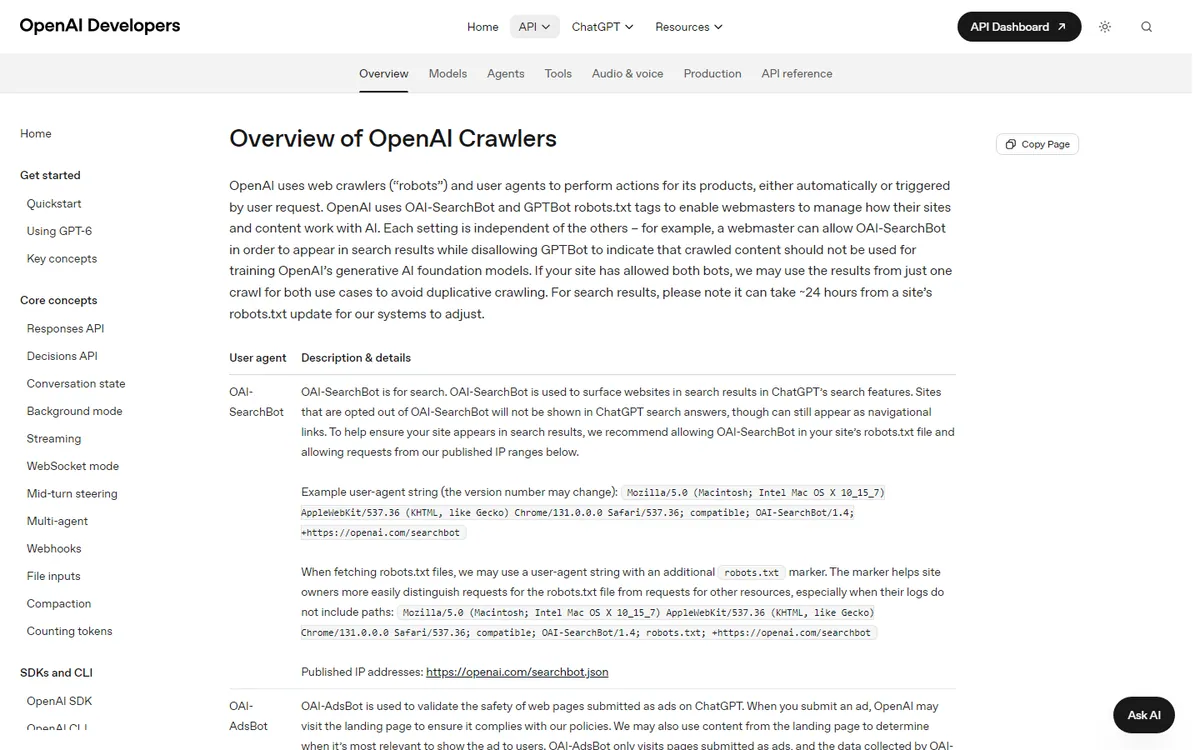
Página Overview of OpenAI Crawlers na documentação da OpenAI, com o texto de abertura e a tabela que descreve o robô OAI-SearchBot e o início da linha do OAI-AdsBot.
A tabela abaixo é a que mais erra no mercado. Muito material ensina a bloquear o GPTBot "para sair da IA", mas o GPTBot cuida do treino; quem leva a página às respostas com link do ChatGPT é o OAI-SearchBot. Bloquear o robô errado deixa o problema intacto e cria outro.
Leia pela última coluna: ela diz o que a empresa perde em cada bloqueio.
| Agente | Fornecedor | Função na matriz | O que o bloqueio produz |
|---|---|---|---|
| GPTBot | OpenAI | Treino | Sai do treino. A presença nas respostas de busca do ChatGPT permanece. |
| OAI-SearchBot | OpenAI | Busca e citação | Some das respostas com busca do ChatGPT. A OpenAI escreve que site excluído dele "will not be shown in ChatGPT search answers". |
| ChatGPT-User | OpenAI | Ação do usuário | Quebra a busca que o próprio usuário pediu ao abrir a sua URL. |
| OAI-AdsBot | OpenAI | Validação de anúncio | Só visita páginas enviadas como anúncio no ChatGPT. Bloqueado, a página de destino não passa na validação. |
| ClaudeBot | Anthropic | Treino | Sai do treino. A busca do Claude continua alcançando o site. |
| Claude-SearchBot | Anthropic | Busca e citação | Some das respostas com busca do Claude. |
| PerplexityBot | Perplexity | Busca e citação | Some do índice de citação da Perplexity. Respeita robots.txt. |
| Perplexity-User | Perplexity | Ação do usuário | Em geral ignora robots.txt; só firewall ou regra de servidor o detém, e deter quebra o pedido do usuário. |
| Meta-WebIndexer | Meta | Busca e citação | Some das citações do Meta AI (Instagram, WhatsApp, Facebook). A Meta diz que liberá-lo "helps Meta cite and link to that content". |
| Google-Extended | Treino e grounding de Gemini e Vertex AI | Sai do treino. Não impede aparição em AI Overviews nem em AI Mode e não afeta ranking. | |
| Googlebot | Busca, e alimenta as features generativas | Sai da busca inteira. Bloquear aqui para escapar da IA custa a indexação. |
A coluna de função é o que quase todo material de mercado erra. Ensinar a bloquear GPTBot para sair da IA prescreve a coluna errada: quem alimenta a resposta de busca é OAI-SearchBot. Só a linha de busca e citação se verifica com curl e log de servidor; as outras se declaram no robots.txt (o arquivo em que o site diz a cada robô o que pode ler) e nunca aparecem em relatório de tráfego.
Fonte: Documentação pública de crawlers de OpenAI, Anthropic, Perplexity, Meta e Google, aberta em 07/09/2026
Ver como texto
Matriz de crawlers cruzando três fornecedores, OpenAI, Anthropic e Google, com três funções, treino do modelo, busca e citação e ação do usuário, cada função num cartão empilhado, mostrando que só o bloqueio da função de busca e citação remove o site das respostas geradas.
No Google existem dois controles oficiais, e eles fazem coisas diferentes. O Google-Extended, declarado no robots.txt (o arquivo em que o site diz a cada robô o que pode ler), trata do treino e do uso do conteúdo para embasar respostas no aplicativo Gemini e no Vertex AI. Segundo a documentação de 14/07/2026, ele não tira o site da Busca nem pesa no ranking.
Quem tira o site dos resumos de IA, do Modo IA e dos recursos generativos do Discover é o controle "Search generative AI", no Search Console, o painel gratuito do Google para donos de site. Ele tem três opções (incluir, excluir ou herdar), faz efeito em um a dois dias e vale para todos os sites desde 31/08/2026. A pergunta que escolhe o controle é uma só: a empresa quer sair do treino ou sair da resposta?
| Controle | O que faz | O que não faz |
|---|---|---|
| Google-Extended (robots.txt) | Retira o conteúdo do treinamento e do grounding em Gemini Apps e Vertex AI | Não tira o site de AI Overviews nem de AI Mode; não afeta inclusão nem ranking |
| Search generative AI (Search Console) | Exclui o site de AI Overviews, AI Mode e Discover generativo; incluir, excluir ou herdar; efeito em 1 a 2 dias | Não afeta treinamento (para isso, Google-Extended); não é sinal de ranking no restante da Busca |
| nosnippet, data-nosnippet, max-snippet, noindex (por página) | Limitam o trecho exibido, ocultam partes da página ou a tiram do índice | Não separam IA de orgânico: o snippet clássico encolhe junto |
A pergunta que decide qual controle usar é uma só: a empresa quer sair do treino ou sair da resposta? Treino é Google-Extended; resposta é o controle do Search Console; nenhum dos dois altera a posição orgânica.
Fonte: Google Search Central, documentação de crawlers comuns (14/07/2026) e de recursos de IA; Search Console Help, artigo 16908024; abertos em 07/09/2026
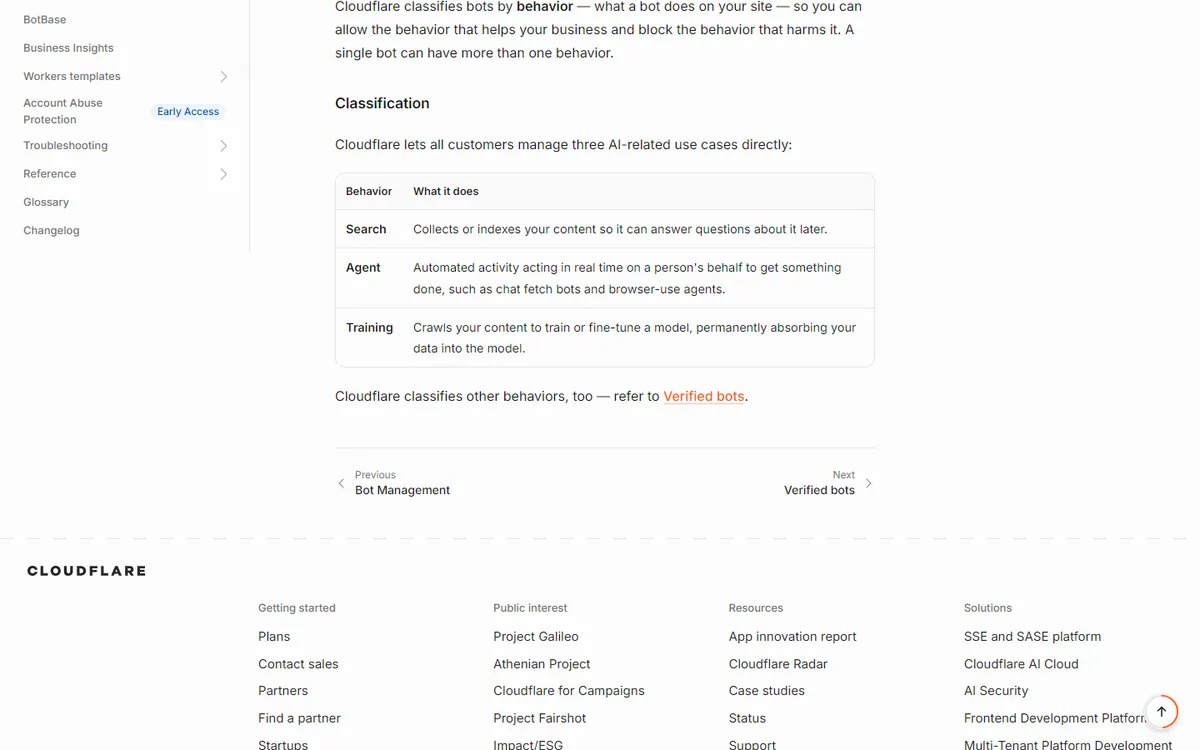
A terceira peça da decisão de acesso mora fora do site, na camada de borda. A Cloudflare, que fica entre o visitante e o servidor de boa parte dos sites, classifica robôs de IA em três comportamentos desde 01/07/2026: Search (busca para responder depois), Agent (age em nome de uma pessoa) e Training (treina modelo).
Desde 15/09/2026, em domínios novos com páginas que exibem anúncios, Training e Agent ficam bloqueados por padrão e Search segue liberado. O detalhe caro é o robô misto, que faz busca e treino ao mesmo tempo: ele é bloqueado inteiro quando não tem o selo "Accountable", dado a quem permite recusar o treino sem perder ranking. Googlebot, Applebot e Bingbot receberam o selo. Desde 21/08/2026 o Bot Preference Sync escreve no robots.txt o que o painel decidir, em todos os planos.
Ver como texto
Documentação da Cloudflare sobre bots, seção Classification, com a tabela de três comportamentos de robôs de IA: Search, Agent e Training, e a descrição de cada um.
Como a data de 15/09/2026 já passou, a tarefa agora é conferir: peça o print do painel e o log de Googlebot, Applebot e Bingbot depois dessa data. Um bloqueio na borda vence um robots.txt liberado, e a queda aparece semanas depois, longe demais para alguém ligar uma coisa à outra. Quem quiser cobrar pelo acesso em vez de bloquear encontra o Pay Per Use, em beta desde 30/09/2026, no capítulo sobre licenciamento.
O jurídico da casa quer bloquear o treino de modelos sobre o acervo; a decisão saiu do conselho e o prazo é o fim do mês. O site roda atrás da Cloudflare, exibe anúncios nas páginas de acervo aberto e a busca orgânica responde por boa parte das assinaturas novas. Desde 15/09/2026 a Cloudflare aplica padrões novos a domínios novos; o seu domínio é antigo, então vale nele a configuração que você mandar ligar. O time de tecnologia pergunta apenas qual chave ligar.
Qual encaminhamento você leva para a reunião de terça, com a decisão do conselho tomada e o prazo curto?
Com o acesso resolvido, a pergunta seguinte é o que o robô encontra quando chega. Existem dois jeitos de montar uma página: no servidor, quando o HTML chega pronto, ou no navegador, quando chega uma casca vazia e o JavaScript monta o conteúdo depois. Essa montagem se chama renderização.
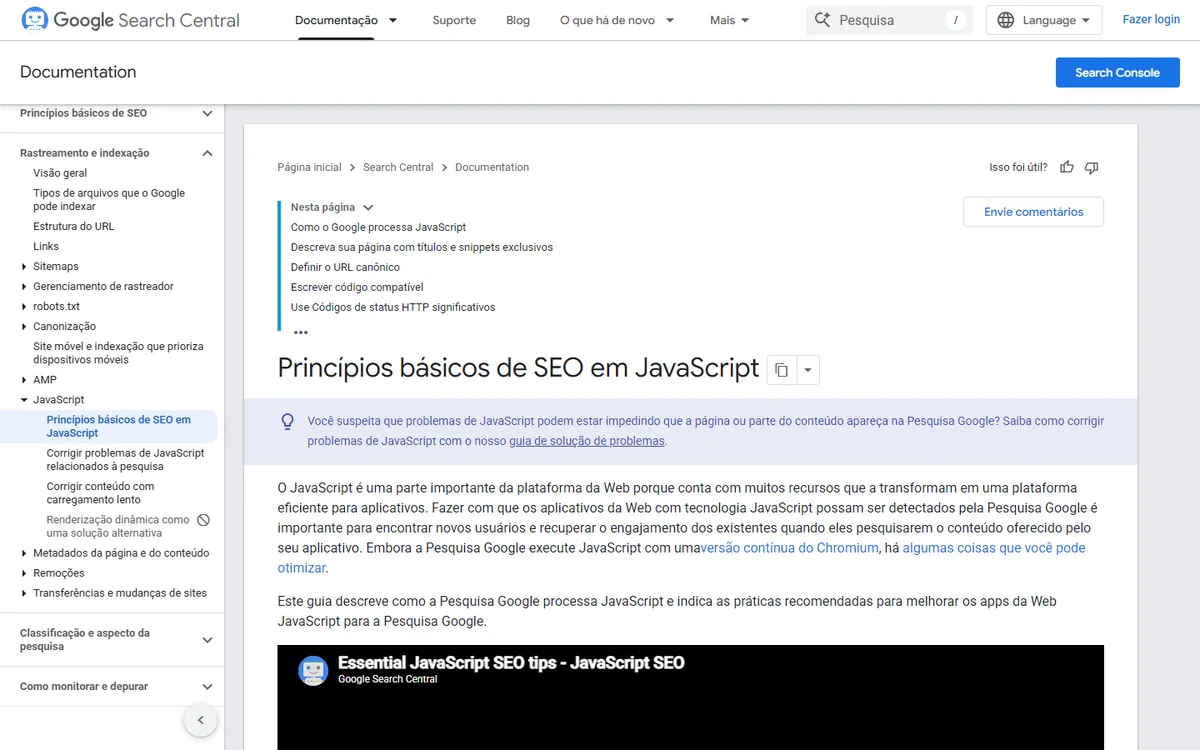
O Google executa JavaScript há anos e, em 04/03/2026, tirou da documentação orientações antigas sobre o tema. Os robôs de citação de outras empresas não publicam documentação estável sobre o que executam, e o comportamento muda por robô e por período. A postura defensável é conservadora: conteúdo principal, preço e dados estruturados presentes no HTML entregue. Evite a frase categórica que circula em material antigo ("robôs de IA não executam JavaScript, exceto o Gemini"), porque nenhuma fonte primária a sustenta.
Ver como texto
Documentação do Google Search Central em português, página Princípios básicos de SEO em JavaScript, com o sumário da página e o parágrafo que explica que a Pesquisa Google executa JavaScript com uma versão contínua do Chromium.
A mesma página, montada de dois jeitos
Montada no navegador (o robô pode ver em branco)
Coluna a evitar
- O servidor entrega uma casca vazia e o script preenche o conteúdo depois.
- O Google executa o script, mas com fila e custo de processamento.
- Robôs de citação de outros fornecedores não têm capacidade documentada de executar script.
- Preço, descrição e contato somem para quem não executa o script.
Entregue pronta no HTML (o robô lê na primeira visita)
Coluna recomendada
- O texto principal, o preço e o bloco de dados estruturados já vêm no HTML.
- Qualquer robô lê sem depender de execução.
- A página tende a carregar mais rápido, o que aparece nas métricas de experiência.
- O teste é simples: desligar o JavaScript no navegador e ver se o conteúdo continua lá.
Velocidade é a terceira camada e a que mais gera número falso em proposta. O Google mede a experiência com três métricas, as Core Web Vitals: LCP (Largest Contentful Paint, o tempo até o maior elemento aparecer), INP (Interaction to Next Paint, a demora para a página reagir a um toque) e CLS (Cumulative Layout Shift, o quanto a página pula enquanto carrega).
Os limiares de "bom" não mudaram desde março de 2024, quando o INP substituiu o FID, e valem no percentil 75: três de cada quatro visitas precisam ficar abaixo deles. A média aprova páginas que o percentil 75 reprova, porque esconde os celulares e as conexões que você não vê no seu laptop. A cifra de 150 ms para o INP, comum em blog de fornecedor, contradiz a documentação.
Ver como texto
Artigo Web Vitals no web.dev, em tradução automática para português, com autor, data de atualização e menu lateral com as métricas LCP, CLS e INP.
Os três limiares oficiais de Core Web Vitals, sem mudança até 07/09/2026
2,5 s
LCP, limiar de bom
Largest Contentful Paint, o tempo até o maior elemento aparecer, medido no percentil 75
200 ms
INP, limiar de bom
Interaction to Next Paint, a demora para a página reagir a um toque. Substituiu o FID em março de 2024; a cifra de 150 ms que circula contradiz a documentação
0,1
CLS, limiar de bom
Cumulative Layout Shift, o quanto a página pula enquanto carrega, sem alteração no período
p75
Percentil de avaliação
A média aprova páginas que o percentil 75 reprova
Fonte: web.dev/articles/vitals, página atualizada em 31/10/2024, aberta em 07/09/2026
Ver como texto
Os três medidores de Core Web Vitals com os limiares oficiais: LCP até 2,5 segundos, INP até 200 milissegundos e CLS até 0,1, todos avaliados no percentil 75 das visitas reais, com a correção do número falso de 150 milissegundos que circula para o INP.
Camada 4, notificação. O Google não aceita IndexNow: o protocolo, que avisa o motor de que uma URL mudou, serve Bing, Yandex, Naver, Seznam e Yep. Para o Google os canais continuam sendo sitemap (a lista de URLs do site) e Search Console. O protocolo segue útil por causa dos motores que o adotam, e o que passa a ser obrigatório é dizer no relatório qual motor foi notificado. Um deploy anunciado como "notifica os motores de busca automaticamente", apresentado ao cliente como ganho de indexação no Google, descreve algo que não acontece.
Um arquivo aparece em quase toda proposta de GEO e merece decisão própria: o llms.txt, um texto na raiz do site que resume o conteúdo para modelos. Como alavanca de busca, o Google o descartou no registro de mudanças de 15/06/2026: não é necessário, não ajuda e não prejudica. Como documentação para agentes de programação, ele tem uso real, desde que a empresa tenha API ou documentação para desenvolvedores.
llms.txt serve para alguma coisa?
Como alavanca de busca, desmentido
Coluna a evitar
- O Google afirma que você não precisa criar arquivos legíveis por máquina, arquivos de texto para IA, markup ou Markdown novos para aparecer no Google Search.
- O changelog de 15/06/2026 registra que llms.txt não é necessário, não ajuda e não prejudica.
- John Mueller comparou publicamente o arquivo à meta tag keywords.
- Se o objetivo escrito no relatório é aparecer no ChatGPT, tire do escopo e realoque as horas para a camada 1, onde os bugs de verdade moram.
Como documentação para agentes, defensável
Coluna recomendada
- Agentes de IDE como Cursor, Claude Code, Copilot e Windsurf consomem sumários legíveis por máquina com resultado prático.
- Servidores MCP (o protocolo que conecta um modelo a ferramentas e documentos) usam o mesmo tipo de sumário para navegar documentação extensa.
- Se o seu produto tem API, SDK ou documentação para desenvolvedores, publicar custa pouco e ajuda quem integra.
- No relatório, este item entra como entrega de developer experience, com o efeito de busca declarado como nulo.
A última camada só existe para quem vende por agente de compra. A SALT.agency auditou 50 sites grandes, segundo a Search Engine Journal de 01/09/2026: recuperabilidade média de 74,4%, atribuição e significado em 38,5% e prontidão para transação por agente em 2,1%; dos 48 sites com dado nessa camada, 46 marcaram zero. A fonte é secundária e a amostra é de sites grandes, então use os números como ordem de grandeza.
O erro provável desta etapa é começar pelo fim: aprovar marcação, llms.txt e protocolo de comércio antes de saber se o robô de citação recebe a página. A correção é a ordem do cartão abaixo. Se a empresa não vende por agente, o zero da terceira camada não é defeito, e a etapa 5 explica quando ele passa a ser.
Comece pelo 403, termine no JSON-LD
Uma hora lendo o log dos robôs rende mais do que uma semana de marcação nova.
- Bloqueio no firewall, na CDN ou no robots.txt é a causa mais comum e a mais barata.
- É a única falha que tira a marca das respostas sem sintoma em outra ferramenta.
- Teste manual com 200 não prova nada: o firewall libera o teste e barra o volume.
- Só depois do acesso provado vale discutir velocidade e dados estruturados.
O teste: Peça o código de resposta do OAI-SearchBot nos últimos sete dias. Se ninguém sabe, a etapa começa aí.
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
# Verificação de acesso por robô: rode antes de qualquer diagnóstico
# Cada linha deve devolver HTTP/2 200. Qualquer 403, 429 ou 5XX aqui é
# citação perdida de forma silenciosa: não aparece em nenhum outro relatório.

curl -A "OAI-SearchBot/1.0; +https://openai.com/searchbot" -I https://seudominio.com/pagina
curl -A "Claude-SearchBot"  -I https://seudominio.com/pagina
curl -A "PerplexityBot"     -I https://seudominio.com/pagina
curl -A "Meta-WebIndexer"   -I https://seudominio.com/pagina
curl -A "Googlebot"         -I https://seudominio.com/pagina

# Por que estes cinco e não a lista inteira:
# escolhi só a coluna "busca e citação" da matriz mais o Googlebot, porque são
# os únicos com efeito de curto prazo sobre aparecer ou não em resposta gerada.
# Testar GPTBot aqui não informa nada sobre visibilidade hoje.

# ATENÇÃO ao falso negativo: um curl que devolve 200 não prova acesso liberado.
# WAF e CDN costumam liberar por IP de origem e bloquear por assinatura de
# comportamento em volume. A prova real está no log de servidor, filtrando por
# user agent e por faixa de IP publicada pelo operador, com retenção de 90 dias.
# Reporte apenas hits verificados por faixa de IP; user agent é falsificável.

# Relatório semanal mínimo, em ordem de utilidade prática:
#   1. códigos de resposta por bot        (acha bloqueio)
#   2. URLs mais rastreadas por bot de citação (acha o que interessa a eles)
#   3. cobertura: páginas prioritárias nunca tocadas (acha buraco de descoberta)
#   4. latência e peso da resposta        (acha custo de crawl)
#   5. série temporal por provedor        (acha mudança de comportamento)
Aprofundamento para quem opera o site
Como provar o acesso no log, e não no teste manual?
Puxe sete dias de log do servidor ou da camada de borda e separe duas colunas. Na primeira, robôs de treino: GPTBot, ClaudeBot, CCBot e meta-externalagent. Na segunda, robôs de busca, citação e ação do usuário: OAI-SearchBot, Claude-SearchBot, PerplexityBot, Meta-WebIndexer, ChatGPT-User, Claude-User e Perplexity-User. Para cada um, registre volume de acessos e distribuição de códigos de resposta, e liste as páginas prioritárias que nenhum robô da segunda coluna tocou. Qualquer 403, 429 ou 5XX na segunda coluna é bloqueio a corrigir na borda; página prioritária sem visita é problema de descoberta e vai para a etapa 4. Conte só acessos verificados pela faixa de IP publicada pelo operador, porque o nome do robô se falsifica.
O que é a Soft Navigations API e muda alguma meta?
É um recurso do Chrome, em teste aberto a sites inscritos do Chrome 147 ao 149, com chegada sem configuração prevista para o Chrome 151. Mede a navegação entre telas de aplicações de página única, que hoje escapa da medição clássica. O próprio Google diz que ainda não decidiu se essas navegações entram no CrUX, o painel de dados reais do Chrome; por isso não vale como métrica de contrato.
Vale cadastrar os perfis oficiais com sameAs?
Vale, pelo motivo certo. sameAs é a propriedade que aponta para os perfis oficiais da empresa em outros sites. A documentação de Organization do Google fala em páginas com informação adicional sobre a organização e não promete pontuação de confiança. Mantenha uma lista curta, com nome exato idêntico e a mesma descrição em todos os perfis: Wikidata, Wikipedia e ORCID quando existirem, depois LinkedIn, GitHub e o site. O ganho é reduzir a confusão entre homônimos, assunto do capítulo sobre entidades.
Que marcação de dados estruturados ainda tem função?
A tabela completa, com FAQPage, HowTo e os tipos aposentados, está no capítulo sobre dados estruturados. O resumo para esta etapa: Organization, Article, Product, Breadcrumb, Video e Local business seguem na galeria oficial de 25 tipos, atualizada em 15/06/2026, e são a base. FAQPage deixou de aparecer como resultado especial em 07/05/2026; mantenha se já existe, sem priorizar. Confira a galeria vigente antes de remover marcação em produção.
Monte a matriz de robôs do seu site em quatro colunas: agente, função, código de resposta observado e origem da observação (teste manual ou log). Escreva a política de bloqueio que recomendaria, com uma frase de justificativa e outra dizendo o que ela não resolve. Se o site está atrás da Cloudflare, acrescente o que o painel mostra hoje para Search, Agent e Training.
Faça agora (15 min, além da leitura)
Quinze minutos com quem administra o site; o resultado é a camada de acesso provada e a lista do que cobrar nas outras três.
Passo 1: Peça o código de resposta dado a quatro robôs de citação nos últimos sete dias
OAI-SearchBot, Claude-SearchBot, PerplexityBot e Meta-WebIndexer: total de acessos e quantos receberam 403, 429 ou 5XX, tirado do log ou do painel do CDN.
Deu certo quando: Quatro linhas com número; qualquer 403 vira tarefa de hoje.
Erro comum: Aceitar um teste manual de curl como prova: o firewall libera o teste e bloqueia o robô em volume.
Passo 2: Confira os dois controles do Google e quem decidiu cada um
No Search Console, o estado do controle Search generative AI (incluir é o padrão); no robots.txt, se Google-Extended está bloqueado e por quê.
Deu certo quando: Você sabe dizer o estado dos dois e o nome de quem decidiu.
Passo 3: Desligue o JavaScript no navegador e abra a página mais importante
Com JavaScript desativado, o texto principal, o preço e o contato precisam aparecer; se a tela fica em branco, o conteúdo depende de montagem no navegador.
Erro comum: Testar só a home: a página de produto ou de serviço é a que o robô de citação precisa ler.
Passo 4: Pegue os três números de velocidade no relatório do Search Console
Em Core Web Vitals, veja LCP, INP e CLS no percentil 75 de celular e compare com 2,5 s, 200 ms e 0,1.
Erro comum: Aceitar média em vez de percentil 75: a média aprova página que o Google reprova.
Passo 5: Se o site usa Cloudflare, confira o que os padrões de 15/09/2026 bloquearam
Peça o print do painel com as categorias Search, Agent e Training e o log dos últimos sete dias de Googlebot, Applebot e Bingbot, além dos robôs de citação da primeira linha.
Deu certo quando: Nenhum robô de busca com 403 depois de 15/09/2026, e a configuração tem dono com nome.
Erro comum: Ligar Training como se fosse política de conteúdo: robô que mistura busca e treino sem o selo Accountable cai inteiro.
No fim você tem: os códigos de resposta dos quatro robôs de citação, o estado dos dois controles do Google com dono, a prova de que a página principal existe sem JavaScript, os três números de velocidade no percentil 75 e, se houver Cloudflare, o painel conferido.
Confira antes de fechar: você tem quatro linhas com o código de resposta de cada robô de citação, sabe quem decidiu cada controle do Google e viu a página principal com o JavaScript desligado. No site novo do exemplo, essa última conferência teria mostrado a tela em branco na semana do lançamento, e não três semanas depois.
Com o robô lendo a página, a etapa 3 cuida do que ele lê: o trecho que continua verdadeiro quando é recortado e colado numa resposta.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Confira se o site abre bem e pode ser lido pelos buscadoressugerido pelo grafoApresenta os conceitos “Google-Extended”, “PerplexityBot” e “CLS”, usados em “Etapa 2: abrir o site aos robôs certos”.
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “OAI-SearchBot”, “GPTBot” e “Claude-SearchBot”, usados em “Etapa 2: abrir o site aos robôs certos”.
- CursoGEO e Knowledge Graphsugerido pelo grafo1 capítulo de “SEO e GEO para quem decide” usa conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- SEO programáticoAvaliar o que favorece a presença nas respostas de IAExaminar conexões de Avaliar o que favorece a presença nas respostas de IA
- Gestão de Projetos GEOO que a equipe controla: robôs, página e a primeira semanaExaminar conexões de O que a equipe controla: robôs, página e a primeira semana
- Glossário Completo de SEO e GEO 2026Confira se o site abre bem e pode ser lido pelos buscadoresExaminar conexões de Confira se o site abre bem e pode ser lido pelos buscadores
- Marcas pessoais na busca e na IAComo conferir o que a IA diz sobre vocêExaminar conexões de Como conferir o que a IA diz sobre você
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.