SEO e GEO para quem decide · Capítulo 14 de 30 · 21 min
Permitir, cobrar ou bloquear: a postura de acesso por escrito
O memorando de uma página com as três alavancas oficiais de acesso, a data de revisão e as métricas que avisam quando rever.
Este capítulo faz parte do curso gratuito SEO e GEO para quem decide.
Assine a postura de acesso do site aos robôs de IA num memorando de uma página, com as três alavancas oficiais nomeadas, a data de revisão e as métricas que avisam se a decisão derrubou a busca. E sai sabendo por que, para a maioria dos sites, cobrar ainda não é opção real.
Exemplo: um portal de conteúdo sobre agronegócio, com 2 milhões de visitas por mês, recebe de uma consultoria a proposta de "monetizar os robôs de IA" ligando a cobrança por acesso na Cloudflare. O diretor de tecnologia quer bloquear tudo; o comercial quer saber quanto vale o tráfego que vem dos assistentes.
Há cinco posturas possíveis: permitir tudo, permitir a busca e restringir o treino, cobrar pelo acesso, bloquear e licenciar por contrato. Elas não se excluem. A combinação mais comum em veículos de conteúdo é permitir a busca, restringir o treino e negociar licença em paralelo. A figura posiciona o site por duas perguntas: o conteúdo é o produto ou é meio para vender outra coisa, e o volume dá alavanca para negociar?
Ver como texto
Espaço de decisão de acesso a crawlers de IA em duas dimensões. Uma é a alavanca de negociação, de baixa, com conteúdo substituível, a alta, com acervo difícil de reproduzir. A outra é a dependência de descoberta, de baixa, quando a demanda vem de marca e canal direto, a alta, quando a receita depende de ser encontrado. Os quadrantes aparecem empilhados. Quadrante 2, descoberta alta e alavanca alta: licenciar sem bloquear, exemplo veículo com acervo próprio e dependente de audiência. Quadrante 3, descoberta baixa e alavanca alta: cobrar ou bloquear, exemplos base de dados proprietária, arquivo histórico e pesquisa original paga. Uma linha tracejada marca o limiar de volume, abaixo do qual não há mesa de negociação. Abaixo dela, o quadrante 1, descoberta alta e alavanca baixa: permitir e medir, onde está a maioria, exemplos site de serviço local e SaaS em crescimento; e o quadrante 4, descoberta baixa e alavanca baixa: irrelevante para o debate, onde bloquear não custa e não rende, exemplos intranet e site institucional sem funil.
| Postura | O que você ganha | O que você entrega | Quando ela se sustenta |
|---|---|---|---|
| Permitir rastreio livre | Presença nas respostas, chance de citação, associação de marca na memória dos modelos | O conteúdo integral, sem contrapartida e sem controle sobre a forma da citação | Quando a receita depende de ser encontrado e o conteúdo é meio, não fim. Quadrante 1 da figura |
| Permitir busca e restringir treino | Mantém a citação de curto prazo e reduz a doação de acervo para modelos futuros | A associação de longo prazo entre a marca e o tema na memória paramétrica | Quando o acervo tem valor próprio e a marca já tem demanda direta. Exige atenção ao efeito de segunda ordem |
| Monetizar o acesso | Receita direta por requisição e um preço declarado que vira base de negociação | Parte do alcance, porque operador que não paga simplesmente não entra | Quando o volume de requisições é grande o bastante para que o outro lado prefira pagar a desistir |
| Bloquear | Controle e um argumento jurídico mais limpo em eventual disputa | A presença nas respostas, e com ela o tráfego residual e a citação | Quando há dever de sigilo, licença de terceiro que proíbe, ou o conteúdo é vendido diretamente |
| Licenciar | Receita contratada, atribuição combinada e previsibilidade | Exclusividade parcial e o tempo de uma negociação longa | Quando existe alavanca real. É a única postura que depende do outro lado querer sentar à mesa |
As linhas não são exclusivas entre si. A combinação mais comum em veículos de conteúdo é permitir busca, restringir treino e negociar licença em paralelo.
A recomendação padrão continua sendo liberar os robôs de busca e citação, porque bloqueá-los tira a marca das respostas. Ela vale para a maioria dos sites, em que o conteúdo é meio. O caso que pede outra conta é o do conteúdo que é o produto: servir de matéria-prima gratuita para um assistente que responde no lugar do site tem custo real, e seguir a receita padrão ali financia o próprio substituto.
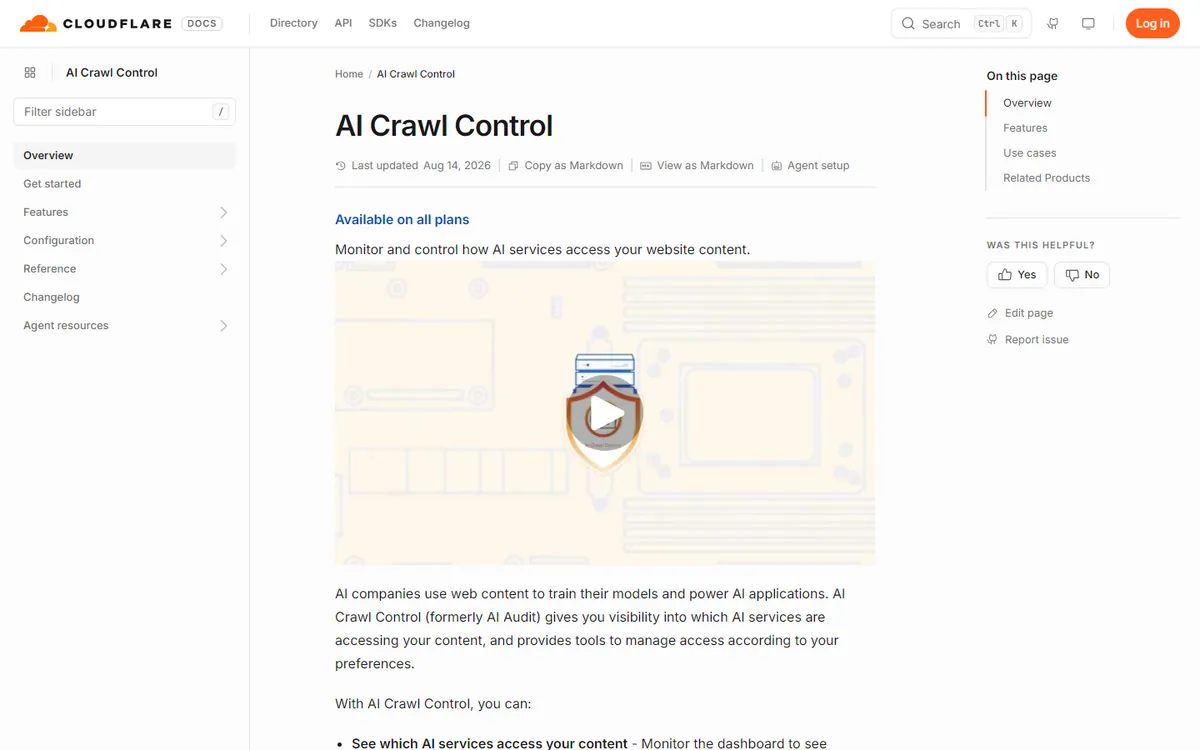
O primeiro passo não custa negociação: medir quem visita o site. A Cloudflare oferece o AI Crawl Control em todos os planos, com a lista dos serviços de IA que acessam o conteúdo e a frequência de cada um. Permitir, cobrar ou bloquear vem depois de saber quais robôs aparecem.
Ver como texto
Documentação da Cloudflare, AI Crawl Control, atualizada em 14 de agosto de 2026, com o selo Available on all plans e a descrição de que a ferramenta mostra quais serviços de IA acessam o conteúdo e permite gerenciar o acesso.
Desde 01/07/2026 a Cloudflare classifica os robôs em três categorias: Search (busca), Agent (agente que age pelo usuário) e Training (treino). Em 15/09/2026 vieram padrões novos, e o texto oficial vale ler como está: "bots classified as Training or as Agent will be blocked on pages that display ads, and Search will remain allowed". A frase seguinte traz o efeito colateral: "Mixed-purpose crawlers that combine Search and Training will also be blocked by all configurations".
O gatilho é domínio novo com página que exibe anúncio. Há divergência na imprensa sobre se o padrão alcançou também clientes gratuitos, por isso a ordem para a equipe é conferir no painel o que está ativo no seu domínio. No mesmo dia a Cloudflare criou o selo "Accountable" para robôs mistos que permitem recusar treino sem perder ranking, e deu o selo a Apple, Google e Microsoft. Robô misto sem o selo cai por inteiro quando o site bloqueia Training: alguém aperta um botão de política de conteúdo e a marca some de um buscador menor.
Marcos de acesso e de regulação, de 2025 a outubro de 2026
- 01/07/2025Concluído
Bloqueio padrão para domínios novos e beta do pay-per-crawl
A Cloudflare passou a bloquear robôs de IA por padrão em domínios novos e abriu em beta fechado a cobrança por acesso, com resposta HTTP 402 e preço por requisição.
- 28/08/2025Concluído
Dados de crawl-to-refer de julho de 2025
Série primária por plataforma, com a ressalva da própria Cloudflare de que o denominador exclui visitas sem cabeçalho Referer.
- 01/07/2026Concluído
Categorias Search, Agent e Training
A classificação por finalidade permite decidir separadamente cada propósito de coleta. A leitura por operador passa a ser vendida a clientes Enterprise.
- 21/08/2026Concluído
Bot Preference Sync
O robots.txt passa a ser escrito a partir das escolhas do painel, do plano gratuito ao Enterprise.
- 31/08/2026Concluído
Controle Search generative AI para todos os sites
O Google libera no Search Console o controle que tira o site dos resumos de IA, do Modo IA e do Discover generativo sem tirá-lo da busca.
- 15/09/2026Concluído
Padrões novos para domínios novos e selo Accountable
Training e Agent bloqueados em páginas com anúncio, Search liberado, robôs mistos sem selo bloqueados. Apple, Google e Microsoft recebem o selo.
- 30/09/2026Agora
Pay Per Use e Monetization Gateway em beta
Cobrança pelo uso que a empresa de IA declara e cobrança por requisição de agentes (beta fechado, só Estados Unidos). Compradores não nomeados.
- 16/10/2026Agora
3º relatório do Sandbox de IA da ANPD
Três soluções testadas sem atestar conformidade; resultados poderão subsidiar futuras orientações e normas.
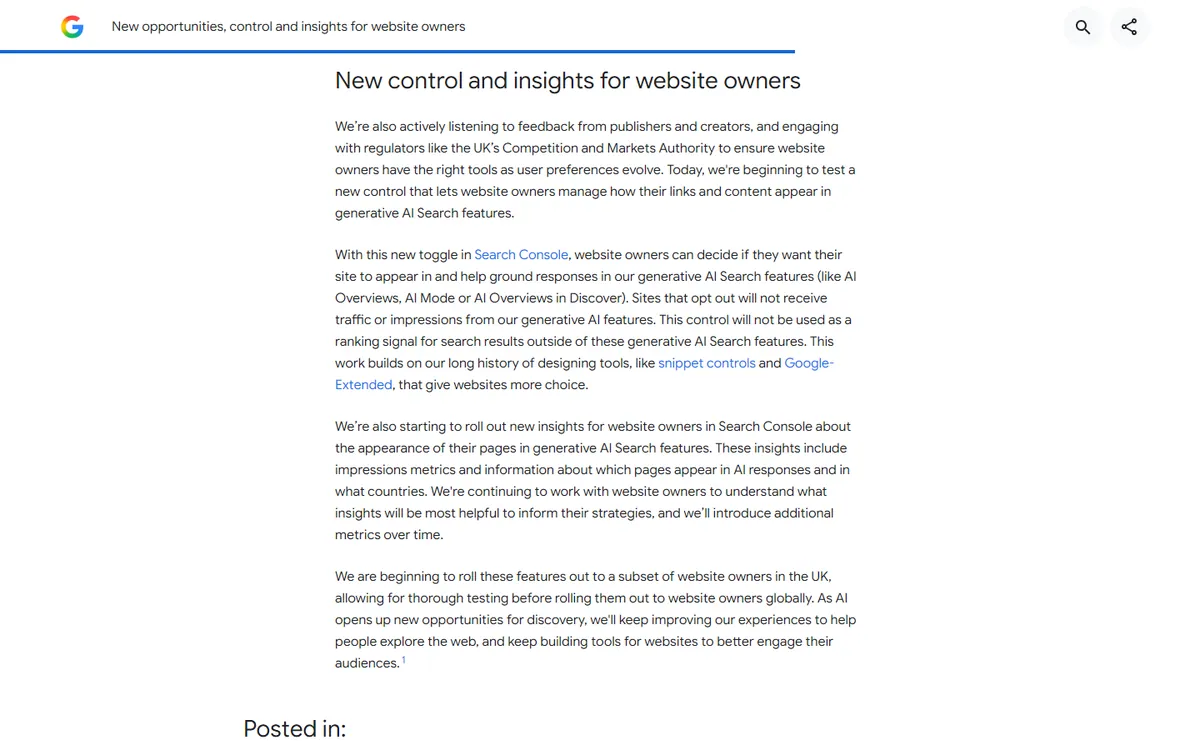
O Google oferece a terceira alavanca, e ela muda a ordem da conversa. A primeira é o robots.txt e as regras da rede de entrega (CDN), que decidem por robô. A segunda é o Google-Extended, que recusa o uso do conteúdo em treino e nas respostas do Gemini fora da busca. A terceira é o controle "Search generative AI" do Search Console, global desde 31/08/2026, que tira o site dos resumos de IA, do Modo IA e do Discover generativo em um a dois dias.
Ver como texto
Trecho do post do Google New opportunities, control and insights for website owners, na seção New control and insights for website owners, que descreve a opção no Search Console para o site sair dos recursos de IA generativa da busca.
O post do Google deixa a conta explícita: quem sai não recebe tráfego nem impressões desses recursos, e a escolha não vira sinal de classificação na busca comum. Quem quer ficar fora do resumo e dentro da busca tem, pela primeira vez, um botão oficial para isso.
Cobrar é a alavanca mais anunciada e a menos disponível. No pay-per-crawl, o robô pede a página, o servidor responde com o preço e o acesso só acontece se o operador aceitar, com a Cloudflare liquidando a cobrança. O preço mínimo é US$ 0,001 por requisição, e não existe lista pública de operadores que aceitaram pagar. A figura mostra o caminho de uma requisição.
Ver como texto
Fluxo do pay-per-crawl. O crawler pede a página com um GET, a borda verifica a identidade do bot por assinatura e faixa de IP publicada, e o servidor responde HTTP 402 Payment Required, cujo cabeçalho declara o preço por requisição. A partir daí, dois desfechos. Se o operador aceita, o conteúdo é entregue e a cobrança é liquidada pelo intermediário, gerando receita. Se o operador recusa, o acesso é negado, com o mesmo efeito prático de bloqueio. A variável que decide é a taxa de aceite, e ela não tem publicação auditável. Um efeito colateral de segunda ordem, ligado ao acesso negado, é que o crawler multipropósito acaba bloqueado por todos os seus comportamentos.
A conta do portal do exemplo mostra o limite. Se os robôs fizerem 1 milhão de requisições por mês, o piso de US$ 0,001 rende US$ 1.000 mensais, desde que alguém aceite pagar; quem não aceita simplesmente não entra, e o efeito prático é o de um bloqueio com mais configuração.
O passo seguinte da Cloudflare, o Pay Per Use, entrou em beta em 30/09/2026: a empresa de IA define o uso pelo qual paga e o preço, e o site aceita ou recusa. O item 3 do índice do post diz quem informa o uso: o comprador. Receita baseada em autodeclaração de quem paga é hipótese até existir histórico de pagamentos.
Ver como texto
Post do blog da Cloudflare de 30 de setembro de 2026, Pay Per Use: when AI uses your work, you should get paid, com o índice lateral que inclui The buyer reports each use e Cloudflare settles both sides.
O Monetization Gateway, que cobra por requisição de agentes, segue em beta fechado só nos Estados Unidos, com lista de espera. Acompanhe, sem reestruturar contrato com base num mecanismo que ainda não tem escala.
Ver como texto
Post do blog da Cloudflare de 1º de julho de 2026, Announcing the Monetization Gateway: charge for any resource behind Cloudflare via x402, com índice que inclui Sign up for our waitlist.
O número mais usado para acusar as IAs de extrativas é a razão de rastreio por visita devolvida (crawl-to-refer): quantas páginas um assistente lê para cada visita que manda ao site. A própria Cloudflare adverte que os cálculos podem superestimar as razões, porque o aplicativo do Claude não envia o cabeçalho que identifica a origem da visita. A regra deste curso é citar com a ressalva colada ao número, ou não citar.
Crawl-to-refer, dados primários de julho de 2025
38.066:1
Anthropic
requisições de HTML por visita referida
1.091:1
OpenAI
mesma metodologia, mesmo período
195:1
Perplexity
mesma metodologia, mesmo período
5:1
referência de comparação com busca tradicional
80%
Crawl para treino
propósito declarado das requisições
18%
Crawl para busca
os 2% restantes são ação do usuário
Fonte: Cloudflare, dados primários de julho de 2025, publicados em 28/08/2025. A ressalva da própria fonte está no parágrafo seguinte.
Licenciar é a alternativa que não se configura em painel. Os acordos publicados seguem um padrão: acervo grande e difícil de substituir de um lado, fornecedor de IA do outro, com acesso técnico combinado, atribuição e prazo em contrato. A Associated Press fechou com a OpenAI em julho de 2023, a Axel Springer em dezembro de 2023 e a News Corp em maio de 2024. O New York Times processou OpenAI e Microsoft em dezembro de 2023 e licenciou conteúdo para a Amazon em maio de 2025. Os valores não constam dos anúncios oficiais.
Bloquear ou licenciar, quando existe alavanca?
Bloquear
Caminho unilateral
- Decisão unilateral, executável hoje, reversível em minutos
- Custo zero de negociação e nenhuma receita
- Impõe custo ao outro lado apenas se o acervo for difícil de substituir
- Risco de segunda ordem sobre indexação quando o crawler é multipropósito
- Some das respostas, e a citação migra para quem deixou aberto
Licenciar
Caminho negociado
- Decisão bilateral, com ciclo medido em meses e dependente do interesse do outro lado
- Custo alto de negociação e jurídico, com receita contratada e previsível
- Só existe se o acervo for difícil de substituir, então pressupõe a mesma alavanca
- Costuma vir com acesso técnico combinado, o que remove a ambiguidade de crawler
- Preserva presença e adiciona atribuição negociada
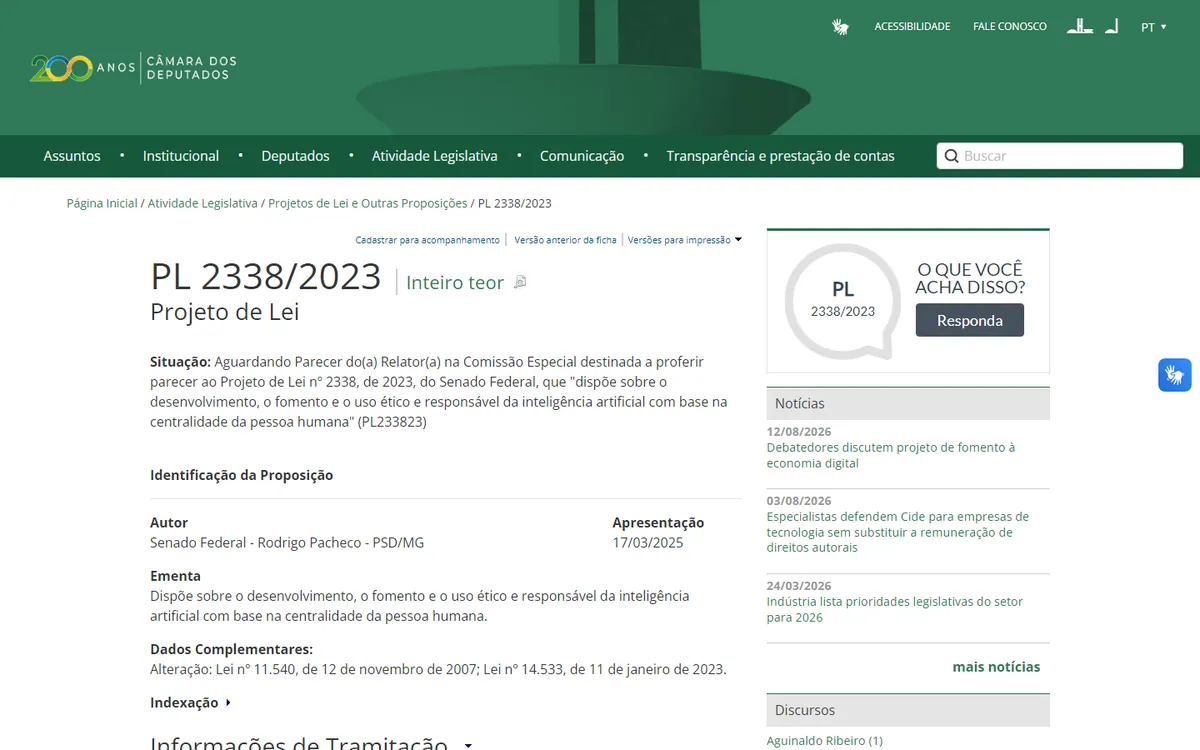
No Brasil não há lei específica de IA em vigor. Em outubro de 2026 o PL 2338/2023 continua na Comissão Especial da Câmara, aguardando parecer do relator, sem data de votação. O fato regulatório do trimestre veio da Autoridade Nacional de Proteção de Dados (ANPD), que publicou em 16/10/2026 o 3º relatório parcial do seu ambiente de testes de IA, com três soluções testadas e nenhuma conformidade atestada. O processo do CADE contra o Google sobre uso de conteúdo jornalístico, com os resumos de IA no escopo, aberto em 23/04/2026, segue como o precedente nacional sobre quem paga pelo conteúdo que a IA resume.
Ver como texto
Ficha de tramitação do PL 2338/2023 no portal da Câmara dos Deputados, com a situação Aguardando Parecer do Relator na Comissão Especial e a ementa sobre desenvolvimento e uso ético e responsável da inteligência artificial.
Na Europa, regulação abriu uma mesa que a negociação não abria: o Google abriu em 17/09/2026 os contratos do programa europeu de licenciamento de dados de busca, restrito a motores com 50 mil usuários mensais no bloco e dois anos de operação, ou 50 milhões de euros de capital. E a Comissão Europeia designou o ChatGPT como motor de busca de grande porte sob a lei europeia de serviços digitais (DSA) em 31/08/2026, com prazo até janeiro de 2027 para auditoria independente.
O tráfego de busca caiu de forma consistente ao longo do ano. Assistentes citam o veículo com frequência, e a conversão para newsletter paga vinda desses cliques é maior do que a média dos outros canais, embora o volume absoluto seja pequeno. O conselho quer uma posição sobre bloquear os crawlers de IA. A infraestrutura roda sobre Cloudflare, o domínio é antigo e o time quer decidir se replica no domínio atual os novos padrões de 15/09/2026, que valem para domínios novos.
Qual postura você defende na reunião do conselho, e com qual justificativa verificável?
O portal do exemplo fecha a conta assim: liberar busca e citação, restringir treino no acervo anterior a 2024, deixar a cobrança em observação e medir por quatro semanas a cobertura no Search Console e os acessos do Googlebot no log. O memorando registra a data de revisão em 90 dias e o gatilho de reversão.
O erro provável é tratar cobrar e bloquear como escolha real num site sem alavanca. Um site com conteúdo que existe em outros vinte lugares não impõe custo a ninguém quando bloqueia; só transfere a citação para o concorrente que deixou aberto. A correção é permitir, medir e construir o motivo pelo qual alguém precisaria do seu conteúdo, e só então abrir a conversa sobre preço.
Como a sua decisão de acesso fica por escrito?
Preencha os campos e leve o texto gerado para a reunião. O valor deste modelo está em obrigar a escrever o critério de revisão: decisão de acesso sem data de revisão vira configuração permanente por esquecimento.
Documento montado
MEMORANDO DE DECISÃO DE ACESSO A CRAWLERS DE IA

Domínio: [DOMÍNIO]

Enquadramento: [QUADRANTE DA FIGURA E JUSTIFICATIVA EM UMA FRASE]

Postura adotada: [POSTURA ESCOLHIDA]

Vigilância pós-mudança: [TRÊS MÉTRICAS DE VIGILÂNCIA NAS QUATRO SEMANAS SEGUINTES]

Revisão e reversão: [DATA DE REVISÃO E GATILHO DE REVERSÃO]

Ressalvas registradas nesta decisão:
1. O valor do tráfego de assistentes usado neste memorando está subestimado por magnitude desconhecida, porque aplicativos nativos e navegadores in-app não enviam cabeçalho de referrer.
2. Restringir a categoria Training sob Cloudflare pode atingir crawlers multipropósito e afetar a indexação de busca. Por isso a vigilância acima é condição da decisão, e não uma sugestão.
3. Razões de crawl-to-refer citadas em qualquer discussão sobre este tema carregam a ressalva da própria Cloudflare de superestimação provável, em grau não determinado.
O que você digitar fica salvo neste navegador. Nada é enviado para servidor algum.
Guia: decidir se o site sai dos AI Overviews
O controle Search generative AI do Search Console tira o site de AI Overviews, AI Mode e Discover generativo sem mexer no ranking do resto da busca. Sete passos, em seis semanas, para decidir com número.
Passo 1: 1. Nomeie o dono e registre o estado atual
Quem faz: quem administra o Search Console, em 10 minutos. Entrega: print de Configurações > Search generative AI com a opção vigente (incluir é o padrão) e das propriedades filhas, que herdam a escolha da principal.
Deu certo quando: Confira: um nome e um print com data.
Passo 2: 2. Meça o que o site ganha hoje com os resumos
Quem faz: o analista, em uma hora. Entrega: impressões em IA dos últimos 28 dias por página e cliques orgânicos das mesmas páginas no relatório principal, onde o clique no link do resumo conta como clique.
Erro comum: Decidir pela média de mercado: com resumo, o CTR orgânico foi de 1,3% a 2,4% na Seer, e o seu pode ser outro.
Passo 3: 3. Escreva o motivo da exclusão em uma frase
Quem faz: você, em 15 minutos. Entrega: o dano concreto, como conteúdo pago resumido de graça ou resposta errada sobre a marca. "Proteger o conteúdo do treino" não serve: o controle não afeta treino, que é assunto do Google-Extended.
Deu certo quando: Confira: a frase cita uma perda medida, e não um princípio.
Passo 4: 4. Compare o que se perde ao sair
Quem faz: marketing, em um dia. Entrega: quem sai não recebe tráfego nem impressões desses recursos. No Brasil ainda não há anúncio dentro do AI Overview, então a conta é só de orgânico.
Erro comum: Esquecer o AI Mode e o Discover generativo: a exclusão vale para os três de uma vez.
Passo 5: 5. Teste numa seção antes do site inteiro
Quem faz: a equipe técnica, em 28 dias. Entrega: exclusão numa propriedade filha de menor receita, com a data anotada; a mudança leva de 1 a 2 dias, às vezes mais.
Deu certo quando: Confira: impressões em IA da seção caem a zero e os cliques orgânicos do resto ficam na faixa das quatro semanas anteriores.
Passo 6: 6. Decida com os dois números na mesa
Quem faz: a diretoria, em 30 minutos. Entrega: memorando com a postura (incluir, excluir ou excluir por seção), o motivo, as métricas de vigilância e o gatilho de reversão.
Erro comum: Memorando sem data de revisão vira configuração permanente.
Passo 7: 7. Revise a cada trimestre
Quem faz: o dono do controle, em 15 minutos. Entrega: a mesma comparação de impressões e cliques, com as quebras de série anotadas.
Deu certo quando: Confira: a revisão está na agenda com data e o memorando tem versão.
No fim você tem: a decisão sobre os resumos do Google tomada com número próprio, testada numa seção, escrita com motivo e com data para rever.
Decidido quem lê o site, falta decidir o que a empresa publica quando a IA ajuda a escrever. É a política do próximo capítulo.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Confira se o site abre bem e pode ser lido pelos buscadoressugerido pelo grafoApresenta os conceitos “Pay-per-crawl”, “Google-Extended” e “CDN”, usados em “Permitir, cobrar ou bloquear: a postura de acesso por escrito”.
- Leia o relatório sem confundir aparições, visitas e vendassugerido pelo grafoApresenta o conceito “Dados primários”, usado em “Permitir, cobrar ou bloquear: a postura de acesso por escrito”.
- Planeje uma melhoria com responsável, limite e forma de conferirsugerido pelo grafoApresenta o conceito “PL 2338/2023”, usado em “Permitir, cobrar ou bloquear: a postura de acesso por escrito”.
- CursoGEO e Knowledge Graphsugerido pelo grafo1 capítulo de “SEO e GEO para quem decide” usa conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Glossário Completo de SEO e GEO 2026Confira se o site abre bem e pode ser lido pelos buscadoresExaminar conexões de Confira se o site abre bem e pode ser lido pelos buscadores
- SEO programáticoAvaliar o que favorece a presença nas respostas de IAExaminar conexões de Avaliar o que favorece a presença nas respostas de IA
- Gestão de Projetos GEOO que a equipe controla: robôs, página e a primeira semanaExaminar conexões de O que a equipe controla: robôs, página e a primeira semana
- Autoridade temáticaDefinir metas realistas para aparecer nas respostas de IAExaminar conexões de Definir metas realistas para aparecer nas respostas de IA
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.