Revisto em 24 de outubro de 2026: nova ordem, prints das fontes oficiais e modelos de agosto a outubro
Prompt engineering e context engineering: escrever para os modelos de 2026 e decidir com evidência
Revisado em
Os modelos de 2026 decidem quanto pensar, leem até um milhão de tokens e cobram por contexto que ninguém vê na tela. O curso começa pela proposta de IA que está na sua mesa: no primeiro capítulo você sai com cinco perguntas prontas para o fornecedor. Depois, na ordem em que o problema aparece, aprende a escrever o pedido, escolher o material que entra na conversa, prever a conta, exigir prova de qualidade, comparar Claude, OpenAI, Gemini e Grok pela tarefa e classificar o risco antes de aprovar.
29capítulos curtos, cada um com guia prático, prints das fontes e tarefa para o mesmo dia
6 h 44 min de leitura, em seis partes
29 capítulos, gratuito
Claude, OpenAI, Gemini e Grok comparados pela tarefa
Todo número com fonte, data e link
O que você vai aprender
Ao final, você confere uma proposta de IA com cinco perguntas, escreve pedidos que devolvem a mesma estrutura toda vez, decide o que entra no contexto, calcula o custo de cada tarefa aceita, monta uma avaliação com 20 a 50 casos reais, escolhe o modelo por tarefa com reserva e versão fixada, classifica o risco de um fluxo antes de aprová-lo e leva a decisão à diretoria em uma página.
Cinco perguntas ao fornecedor já no capítulo 1
Guia prático e tarefa do dia em cada capítulo
Risco classificado antes da aprovação
Para quem é
Quem escreve prompts no trabalho: marketing, produto, atendimento, jurídico, dados
Quem aprova orçamento e risco de IA: diretoria e lideranças de área
Nada a instalar: os prompts são copiados e testados no assistente que você já usa
Parte 1Comece por aqui: ler uma proposta e entender o que mudou nos modelos
Cinco perguntas ao fornecedor, as palavras que mudam a conta, o que envelheceu desde 2024 e quanto raciocínio pagar. O último capítulo é aprofundamento para o time técnico.
Auditar uma proposta de IA com cinco perguntas ao fornecedor
Transforme a proposta de IA que está na sua mesa em cinco perguntas que exigem informações específicas e evidências verificáveis do fornecedor.
Ainda nesta semana, devolva ao fornecedor a proposta de IA que está na sua mesa, com cinco perguntas que exigem informações específicas, evidências e limites de atuação. A leitura cabe nos 14 minutos do cabeçalho; a tarefa toma mais cerca de 30 e nenhuma linha de código.
Exemplo: uma rede de 32 clínicas recebe proposta de um assistente com "o de IA mais avançado do mercado", janela de 1 milhão de tokens e preço fechado de R$ 18.900 por mês para até 40 mil atendimentos. Antes de aprovar a contratação, o comitê de investimento precisa conferir o que esses números representam.
A proposta parece completa e não traz um único número que alguém de fora da sala consiga conferir. Não diz qual modelo roda, quanto texto cada atendimento consome, o que entra na conversa, como os 95% de acurácia foram medidos nem o que o assistente faz sem ninguém olhar. Assinar assim é aceitar que custo e qualidade mudem quando o fornecedor quiser.
A mesma proposta, antes e depois das cinco perguntas
Como a proposta chegou
Promessa
"O modelo de IA mais avançado do mercado"
Preço fechado de R$ 18.900 por mês, sem custo por atendimento
"Lê todo o histórico do paciente" a cada resposta
"Acurácia acima de 95% em testes internos"
Remarca consultas e envia lembretes sem intervenção humana
Como ela precisa voltar
Conferível
Modelo e versão nomeados, com data de troca e aviso prévio
Tokens de entrada, saída e raciocínio por atendimento, medidos em produção
Lista do que entra em cada chamada e do que fica em cache
Número de casos reais, critério de acerto e data da medição
Lista das ações que exigem confirmação de uma pessoa
Seis palavras sustentam as cinco perguntas, e todas aparecem em qualquer proposta séria, às vezes escondidas atrás de um adjetivo. O glossário abaixo traz só essas seis; o capítulo seguinte reúne o vocabulário completo, com o nome que cada fornecedor dá ao mesmo recurso.
Pergunta 1, o modelo
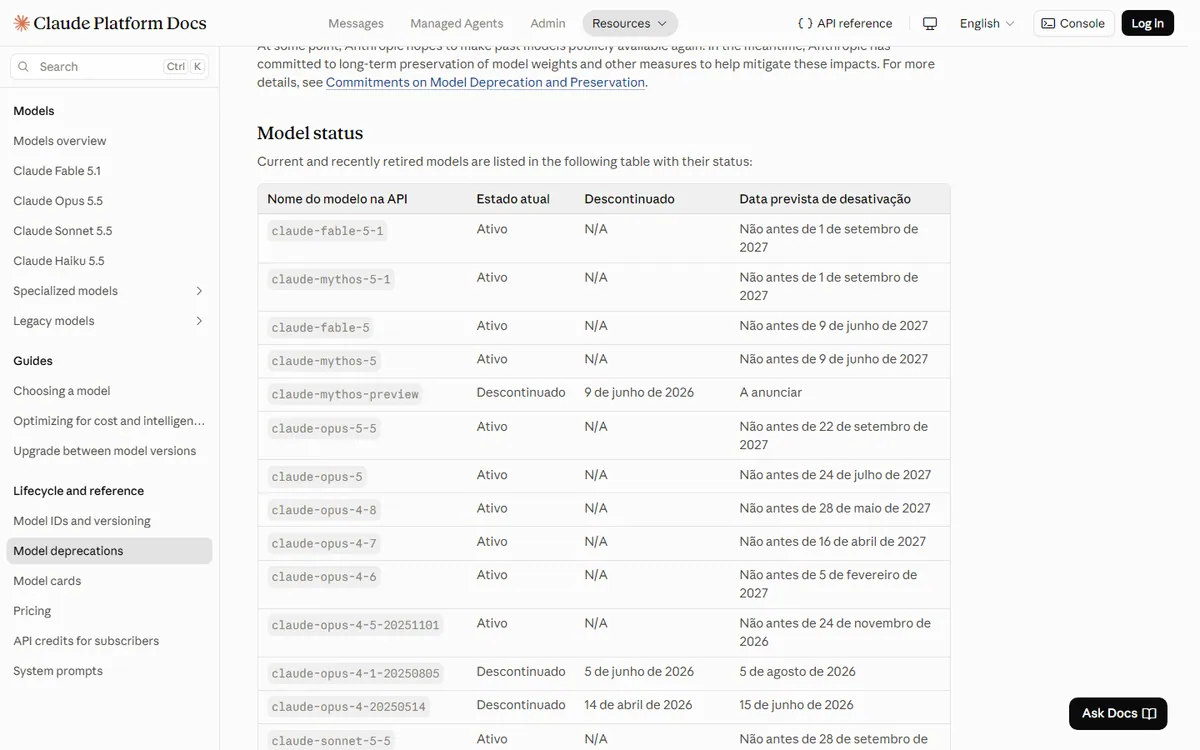
Modelo sem nome no contrato é risco com data marcada. A Anthropic publica quando cada versão sai do ar: o Claude Sonnet 4.5 deixa de responder na API em 30/11/2026, e quem o usa precisa migrar para o Sonnet 5.5 antes disso (página de aposentadorias, conferida em 24/10/2026). Uma proposta que não diz qual modelo usa também não diz quando a migração forçada vai acontecer, nem quem paga por ela.
Cada modelo tem data de desativação publicada. Uma proposta que não diz qual modelo usa e até quando ele fica no ar deixa a empresa exposta a uma migração forçada. Fonte: Anthropic, Model deprecations, capturado em outubro de 2026.
Tabela Model status da Anthropic com o nome de cada modelo na API, o estado atual (Ativo ou Descontinuado), a data de descontinuação e a data prevista de desativação.
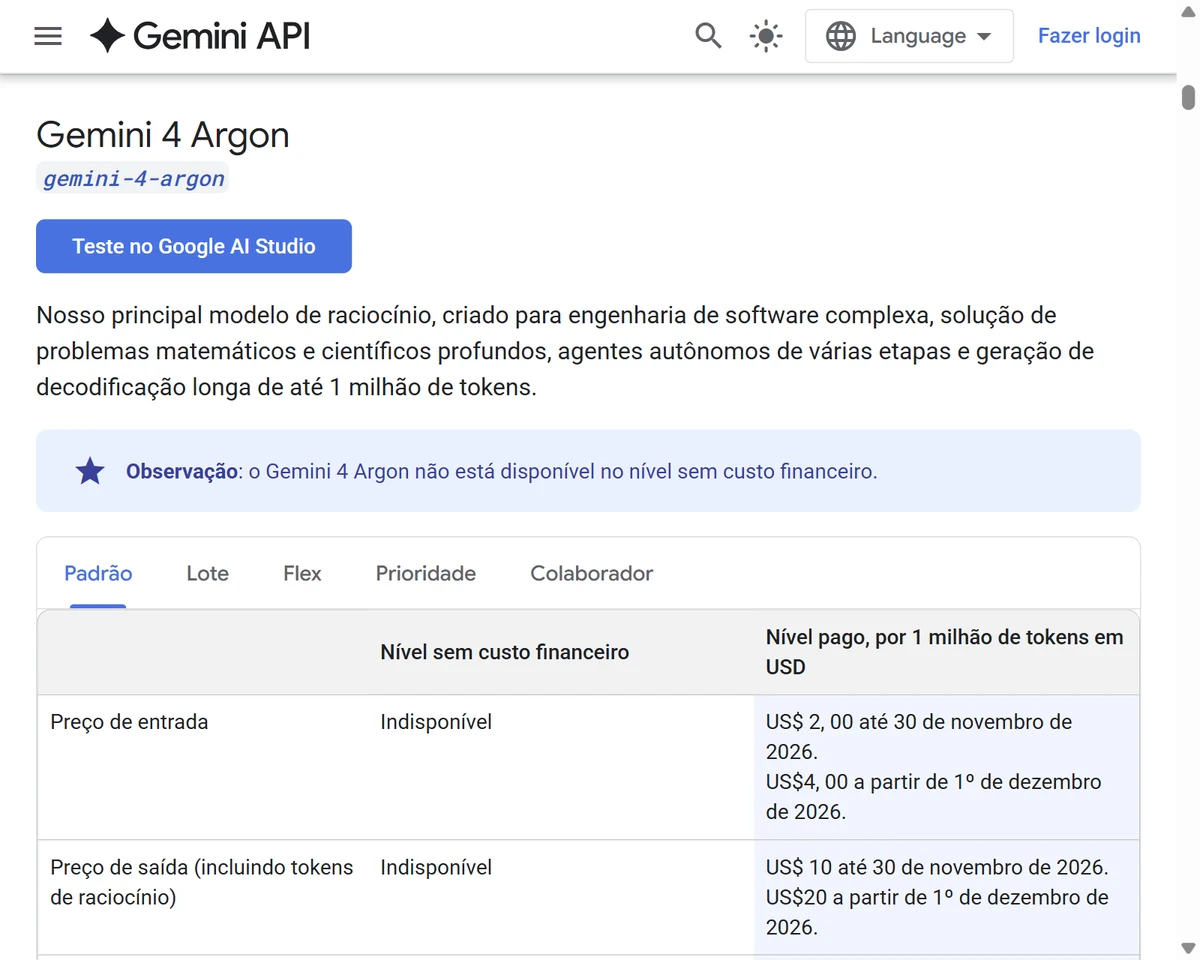
O preço também tem prazo. O Google lançou o Gemini 4 Argon para desenvolvedores em 13/10/2026 com preço introdutório de US$ 2 por milhão de tokens de entrada e US$ 10 de saída, que passa a US$ 4 e US$ 20 em 01/12/2026. Uma proposta calculada na tabela de outubro custa o dobro em dezembro com o mesmo volume. A cláusula que resolve as duas datas é curta: modelo nomeado, data de troca prevista e aviso prévio com nova antes de qualquer mudança.
Na aba Padrão do Gemini 4 Argon, compare as datas nas linhas de entrada e saída: os preços por milhão de tokens dobram em 1º de dezembro de 2026. A mudança anunciada vale para esse modelo e essa modalidade de uso. Fonte: Google, Preços da API Gemini Developer; captura de 26/10/2026.
Seção Gemini 4 Argon da tabela oficial da Gemini API, com entrada de US$ 2 e saída de US$ 10 até 30 de novembro de 2026 e entrada de US$ 4 e saída de US$ 20 a partir de 1º de dezembro, por milhão de tokens.
Perguntas 2 e 3, tokens e o que entra na conversa
O preço fechado esconde o custo por atendimento. Para chegar a ele, você precisa de três números medidos em produção, na média e no pior caso: tokens que entram, tokens que saem e tokens gastos em raciocínio. Multiplicados pela tabela pública, eles mostram se R$ 18.900 por mês cobre 40 mil atendimentos com folga ou se o fornecedor vai pedir reajuste no terceiro mês.
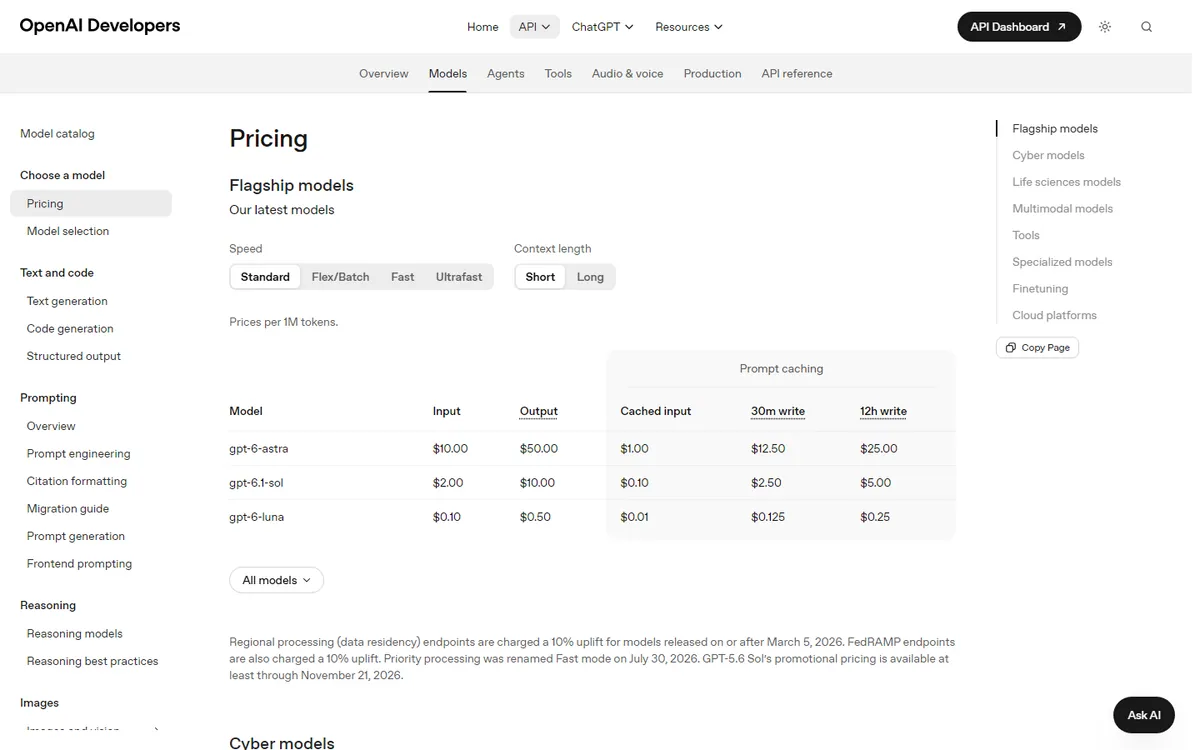
A escolha do degrau pesa mais que qualquer desconto. Na tabela da OpenAI de outubro de 2026, a entrada do GPT-6 Astra custa US$ 10 por milhão de tokens e a do GPT-6 Luna, US$ 0,10: cem vezes de diferença. Peça ao fornecedor que justifique por que o atendimento exige o degrau escolhido e liste o que entra em cada chamada, item por item, com a parte que fica em cache.
Entre o modelo mais caro e o mais barato a diferença é de cem vezes na entrada. A proposta precisa justificar por que a tarefa exige o degrau escolhido. Fonte: OpenAI, Pricing, capturado em outubro de 2026.
Tabela de preços da OpenAI para gpt-6-astra, gpt-6.1-sol e gpt-6-luna, com preço de entrada, saída, entrada em cache e gravação de cache de 30 minutos e 12 horas.
Guia prático: ler a proposta em cinco perguntas
Cada passo mostra a informação que precisa voltar e a resposta evasiva que costuma aparecer no lugar dela. O prompt logo abaixo faz a primeira leitura em Claude, ChatGPT, Gemini ou Grok.
1
Passo 1: Cole a proposta no prompt de auditoria
Troque o bloco proposta do prompt pelo texto do fornecedor, com o anexo técnico, e retire nome de cliente ou paciente.
Deu certo quando: O modelo devolve as cinco perguntas com status, trecho citado e pergunta de volta.
Erro comum: Colar só o resumo comercial; modelo e preço por uso costumam estar no anexo.
2
Passo 2: Exija o modelo nomeado e a regra de troca
Nome e versão, como Claude Opus 5.5 ou GPT-6.1 Sol, a data em que o fornecedor desliga essa versão e a cláusula com aviso prévio e nova avaliação antes de trocar.
Deu certo quando: O contrato cita o modelo, a data de troca prevista e o que acontece quando ele muda.
Erro comum: Aceitar última geração como resposta; o adjetivo não diz qual modelo roda.
3
Passo 3: Peça tokens por tarefa, medidos em produção
Entrada, saída e raciocínio por atendimento, na média e no pior caso, com a contagem do modelo em uso.
Deu certo quando: Você multiplica os tokens pelo preço público e chega ao custo por tarefa.
Erro comum: Aceitar estimativa de planilha no lugar de medição: tokens mudam de um modelo para outro com o mesmo texto.
4
Passo 4: Peça o inventário da janela e do cache
Lista do que entra em cada chamada (prompt de sistema, ferramentas, histórico, documentos) e da parte que fica em cache.
Deu certo quando: Cada item tem tamanho e motivo, e o prefixo fixo aparece em cache.
Erro comum: Histórico inteiro carregado por garantia: o custo cresce com o cliente e a leitura piora.
5
Passo 5: Confira a avaliação por trás da acurácia
Número de tarefas, origem dos casos, critério de acerto e data da medição.
Deu certo quando: Há ao menos 20 tarefas tiradas de casos reais e um critério que outra pessoa repetiria.
Erro comum: Porcentagem sem denominador; 95% em testes escolhidos pelo fornecedor diz pouco.
6
Passo 6: Mapeie o que o agente faz sozinho
Liste o que ele lê de fora (e-mail, site, mensagem de cliente) e o que envia ou altera sem confirmação.
Deu certo quando: Toda ação que sai da empresa ou muda dado tem confirmação humana ou limite escrito.
Erro comum: Agente que lê dado privado, recebe conteúdo externo e envia mensagem para fora abre caminho para injeção de prompt.
No fim você tem: Uma folha com as cinco perguntas, respostas específicas e pendências com responsável e prazo. A proposta só segue ao comitê para avaliação quando todas estiverem respondidas e os riscos materiais tiverem tratamento explicitado; encaminhar não autoriza contratar.
A tabela abaixo é a régua da reunião. Ela separa a resposta que fecha a pergunta da resposta que só a adia, e dá ao comitê um critério que não depende de quem fala melhor.
Pergunta, resposta aceitável e sinal vermelho
Pergunta
Resposta aceitável
Sinal vermelho
1. Qual modelo e versão rodam em produção?
Nome e versão, data de troca prevista, aviso prévio e nova avaliação antes de mudar
"Última geração", "o melhor do mercado", troca livre sem custo
2. Quantos tokens cada tarefa consome?
Entrada, saída e raciocínio por atendimento, média e pior caso, medidos em produção
Preço fechado sem custo por tarefa nem teto de uso escrito
3. O que entra na janela e o que fica em cache?
Lista de itens com tamanho e motivo; o começo fixo do pedido em cache
"Lê todo o histórico" ou "janela de 1 milhão" vendida como qualidade
4. Como a acurácia foi medida?
Ao menos 20 casos reais, critério de acerto escrito e data da medição
Porcentagem sem denominador, testes escolhidos pelo próprio fornecedor
5. O que o agente faz sozinho?
Lista do que ele lê de fora e das ações que exigem confirmação de uma pessoa
Envia mensagem ou altera dado sem confirmação e lê conteúdo externo
Duas ou mais perguntas no sinal vermelho: a proposta volta ao fornecedor antes do comitê.
Perguntas 4 e 5, prova de qualidade e risco
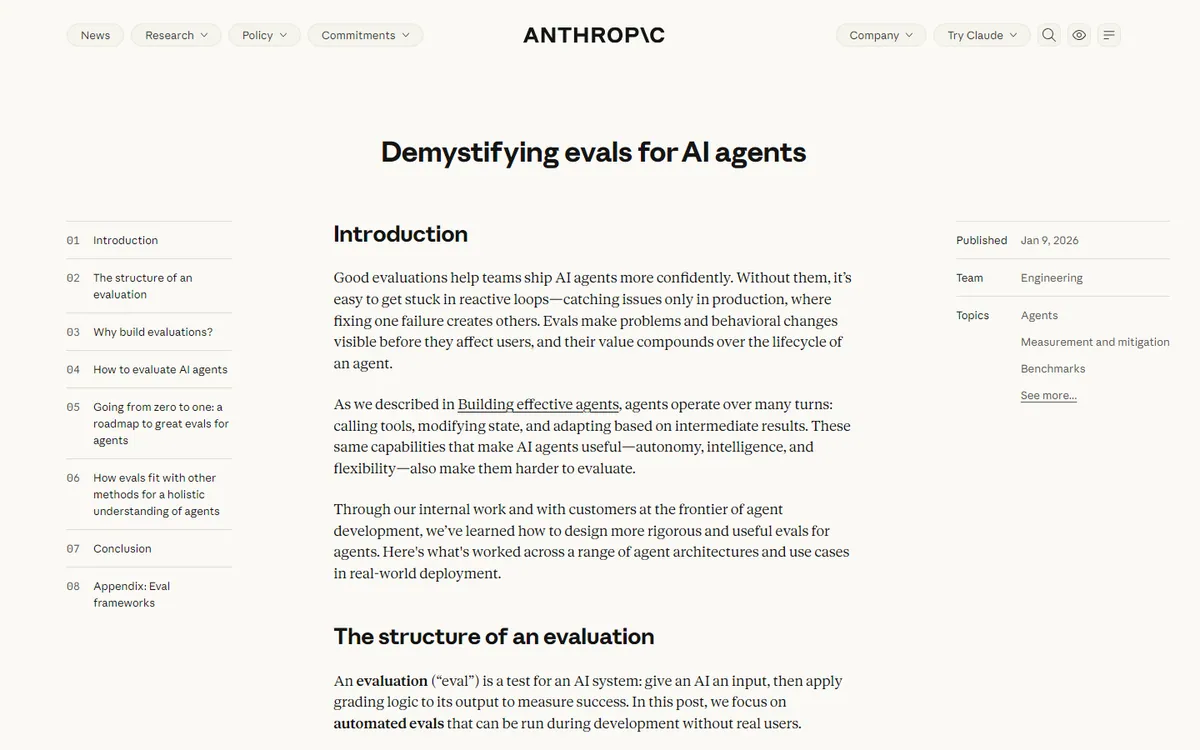
Acurácia de 95% sem denominador não diz nada. A Anthropic recomenda começar a avaliação com 20 a 50 tarefas tiradas de falhas reais (guia de avaliação de agentes, 09/01/2026), e é esse o piso razoável para pedir ao fornecedor: quantos casos, de onde vieram, com qual critério e em que data.
O texto define avaliação como um teste com entrada e critério de nota. A pergunta para o fornecedor é direta: quais testes ele roda antes de cada mudança no prompt. Fonte: Anthropic, Demystifying evals for AI agents, capturado em outubro de 2026.
Artigo Demystifying evals for AI agents, do blog de engenharia da Anthropic, publicado em 9 de janeiro de 2026, com sumário lateral e a introdução sobre avaliações.
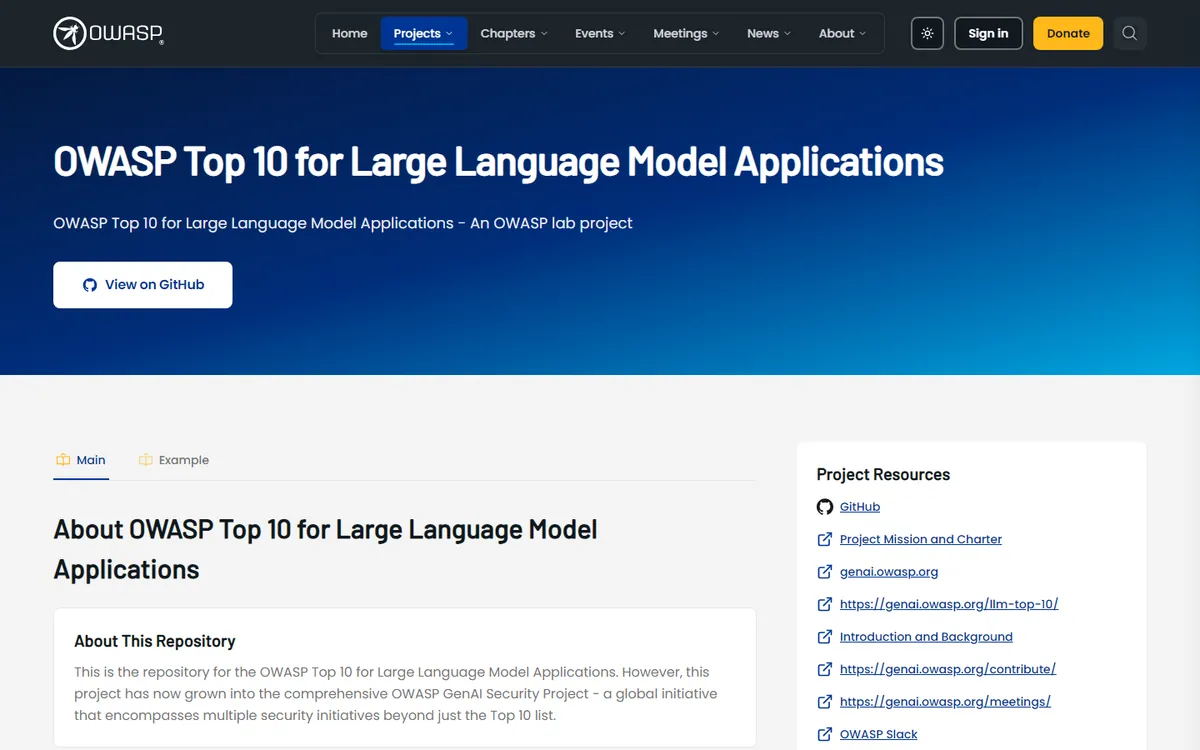
A quinta pergunta é a que protege a empresa. O assistente de atendimento do exemplo lê dado de paciente, recebe mensagem de fora e envia lembrete por WhatsApp sem confirmação. Essa combinação abre caminho para a injeção de prompt, a ordem escondida num texto que o assistente lê. A OWASP, fundação que mantém a lista de referência de riscos de aplicações com modelos de linguagem, publicou a edição 2026 em 03/08/2026; uma proposta séria diz como trata pelo menos esses riscos.
A OWASP mantém a lista de referência de riscos de segurança em aplicações com modelos de linguagem. Uma proposta séria cita como trata pelo menos os riscos dessa lista. Fonte: OWASP, OWASP Top 10 for Large Language Model Applications, capturado em outubro de 2026.
Página do projeto OWASP Top 10 for Large Language Model Applications, com a descrição do repositório e a lista de recursos do projeto.
Exemplo resolvido
O prompt abaixo já traz a proposta hipotética de atendimento nas clínicas. Troque o bloco entre as marcas de proposta pelo texto do seu fornecedor, com o anexo técnico, e retire nome de cliente ou paciente antes de colar.
Auditar uma proposta de IA em cinco perguntas
Ler modelo completoRecolher modelo
Você é analista de compras de tecnologia e revisa propostas de fornecedores de IA para o comitê de investimento de uma empresa brasileira. Seu trabalho é transformar promessas em perguntas que exijam informações específicas e evidências.

<proposta>
Exemplo: assistente de atendimento com IA para uma rede de clínicas (proposta comercial de 10/10/2026)
- Usamos o modelo de IA mais avançado do mercado, com janela de 1 milhão de tokens.
- O assistente lê todo o histórico do paciente antes de cada resposta, para máxima personalização.
- Acurácia acima de 95% em nossos testes internos.
- Integra com a agenda das 32 clínicas, remarca consultas e envia lembretes por WhatsApp e e-mail sem intervenção humana.
- Preço fechado de R$ 18.900,00 por mês para até 40.000 atendimentos.
- O fornecedor pode atualizar o modelo sempre que houver versão melhor, sem custo adicional para o cliente.
</proposta>

Audite a proposta com estas cinco perguntas, nesta ordem:
1. Modelo: qual modelo e versão rodam em produção, e o que acontece no contrato quando o fornecedor trocar?
2. Tokens e custo por tarefa: quantos tokens entram, saem e são gastos em raciocínio por atendimento, na média e no pior caso, medidos em produção?
3. Contexto: o que entra na janela a cada chamada, item por item, e que parte fica em cache de prompt?
4. Avaliação: quantas tarefas medem a acurácia, de onde vieram, com qual critério de acerto e em que data?
5. Ação e risco: o que o assistente faz sozinho, que conteúdo externo ele lê e que ação exige confirmação humana?

Para cada pergunta, devolva:
- Status: RESPONDIDA, PARCIAL ou AUSENTE. Use RESPONDIDA somente quando todos os pontos da pergunta estiverem cobertos por informação específica; um número isolado não basta.
- Trecho da proposta que sustenta o status, entre aspas, ou "nenhum".
- Uma linha com a lacuna ou o risco identificado, quando houver.
- Pergunta de volta ao fornecedor, em uma frase, pedindo a informação, a evidência, o prazo ou a cláusula que falta.

Regras:
- Use só o texto da proposta. Não presuma o que o fornecedor quis dizer.
- Não trate uma porcentagem sem método, uma promessa de resposta futura ou uma cláusula vaga como resposta completa.
- Termine com LEVAR AO COMITÊ PARA AVALIAÇÃO se as cinco perguntas estiverem respondidas e não houver risco material sem tratamento explicitado. Caso contrário, use DEVOLVER AO FORNECEDOR e indique as pendências. Lacunas sobre dados acessados e ações autônomas não podem ser compensadas pelas demais respostas.
- O encaminhamento não autoriza a contratação; a decisão continua com o comitê.
- Responda em português do Brasil, sem preâmbulo, em no máximo 300 palavras.
text
1. Modelo | PARCIAL | "o modelo de IA mais avançado do mercado"; "pode atualizar o modelo sempre que houver versão melhor" Por que não basta: não diz qual modelo roda nem o que muda no custo quando ele troca. Pergunte: qual modelo e versão rodam hoje, e a troca exige aviso prévio, preço revisto e nova avaliação?2. Tokens e custo por tarefa | AUSENTE | nenhum Por que não basta: o preço fechado esconde o custo por atendimento e o que acontece acima de 40.000. Pergunte: quantos tokens de entrada, saída e raciocínio um atendimento consome, na média e no pior caso?3. Contexto | PARCIAL | "lê todo o histórico do paciente antes de cada resposta" Por que não basta: o histórico inteiro encarece com o tempo de casa do paciente e dilui a atenção do modelo. Pergunte: que itens entram na janela por chamada, com que tamanho, e que parte fica em cache?4. Avaliação | PARCIAL | "acurácia acima de 95% em nossos testes internos" Por que não basta: falta número de tarefas, origem dos casos, critério de acerto e data. Pergunte: quantas tarefas, tiradas de onde e medidas quando sustentam os 95%?5. Ação e risco | PARCIAL | "remarca consultas e envia lembretes por WhatsApp e e-mail sem intervenção humana" Por que não basta: o assistente lê dado do paciente e envia mensagem para fora sem nenhuma confirmação. Pergunte: que ações exigem confirmação humana e como o sistema trata instrução escondida em mensagem recebida?Veredito: DEVOLVER AO FORNECEDOR. Nenhuma das cinco perguntas está completamente respondida. Os riscos de acesso a dados e de ação autônoma continuam sem tratamento explicitado.
O erro provável vem na segunda rodada. O fornecedor responde trocando um adjetivo por outro ("modelo de ponta da Anthropic", "acurácia validada com clientes"), e o comitê aceita porque agora há um nome de empresa na frase. A correção é passar a resposta pelo mesmo prompt: se a pergunta continua marcada como adjetivo, ela continua aberta.
Armadilhas
Sinais de proposta de IA sem engenharia por trás
Toda promessa da proposta precisa de informação específica e evidência que outra pessoa consiga conferir.
Janela de 1 milhão vendida como qualidade; contexto cheio piora a leitura do modelo
Acurácia sem número de tarefas, origem dos casos e data da medição
Cláusula que deixa o fornecedor trocar o modelo sem aviso nem reprecificação
Preço fechado sem custo por tarefa medido nem teto de uso escrito
Agente que lê conteúdo externo e envia mensagem para fora sem confirmação humana
O teste: As cinco perguntas precisam de resposta específica e os riscos materiais, de tratamento explicitado. Um prazo organiza a pendência; não a resolve. Encaminhar ao comitê não autoriza contratar.
Para seguir o estudo com uma conta no portal, cadastre-se como aluno. Depois de criar a conta, você volta para este curso.
Faça hoje
Se quiser praticar, pegue a proposta de IA mais recente da sua mesa, cole o texto no prompt de auditoria e envie ao fornecedor, ainda nesta semana, as perguntas marcadas como parciais ou ausentes. Fora a leitura, reserve cerca de 30 minutos. A primeira rodada está concluída quando cada pergunta tem uma resposta específica ou uma pendência com responsável e prazo. O prazo organiza o acompanhamento, mas não resolve a lacuna. A proposta só segue ao comitê para avaliação quando atende aos critérios do prompt; isso não equivale à aprovação da contratação.
As respostas vão chegar com termos como "esforço high", "cache de 5 minutos" e "janela de 1 milhão". O próximo capítulo mostra o que cada um muda na fatura e por que o modelo de 2026 pede outro tipo de pedido.
As palavras que mudam a conta de IA e o que mudou desde 2024
Entenda os termos que aparecem em proposta, contrato e fatura de IA e por que o modelo de 2026 pede um pedido diferente do de 2024.
Revisar o prompt antigo da equipe: o que cortar, trocar e manter
Separe no manual de prompt de 2024 o que hoje dá erro, o que piora a resposta e o que continua valendo, com um revisor pronto para colar.
Decidir quanto a IA deve pensar, e pagar, em cada tarefa
Escolha o nível de esforço de raciocínio por tarefa e meça o mesmo pedido em dois níveis antes de pagar mais.
Aprofundamento: as instruções antigas que hoje dão erro
Aprofundamento para o time técnico: troque doze hábitos de 2024 que hoje devolvem erro, recusa ou conta maior pelo ajuste que funciona em cada modelo.
O pedido em cinco partes, aplicado à estratégia de marketing
Aprenda o pedido em cinco partes (papel, contexto, tarefa, formato e regras) e use oito prompts prontos de estratégia, do posicionamento às métricas.
Produzir peças de campanha com a IA e revisar antes de publicar
Use oito prompts completos para anúncio, e-mail, vídeo curto, LinkedIn, página de captura, FAQ, revisão e relatório, com a conferência antes de ir ao ar.
Escrever as regras fixas do assistente da empresa, com dono e versão
Escreva o prompt de sistema em seis partes (papel, escopo, recusa, formato, tom e exemplos), com versão, dono e testes que sobrevivem à troca de modelo.
Decidir quando mostrar um exemplo à IA e quando só explicar
Use de três a cinco exemplos para formato, tom e casos de fronteira e, em modelo que raciocina, comece sem exemplo e acrescente só o que vencer no teste.
Aprofundamento: receber a resposta no formato que o sistema lê
Aprofundamento técnico: declare o molde da resposta na chamada em modo estrito para que o sistema receba sempre os mesmos campos, e saiba o que o molde não confere.
Aprofundamento: limites claros para o agente que age sozinho
Aprofundamento técnico: escreva cada ferramenta do agente como um contrato curto e declare o que ele faz sozinho e o que exige confirmação de uma pessoa.
Descobrir se o erro da IA veio do pedido ou do material
Classifique cada erro da IA pela camada certa (material que faltou, material demais, instrução ou ferramenta) antes de aprovar uma reescrita do prompt.
Escolher o que entra na conversa e em que ordem
Decida o que entra no material enviado ao modelo, ponha documentos no topo e a pergunta no fim e monte um pacote enxuto que ele lê sem perder o dado certo.
Escolher como a IA consulta os documentos da empresa
Escolha entre mandar o acervo inteiro com cache, buscar os trechos relevantes antes ou deixar a IA pesquisar na hora, pelo tamanho e pelo ritmo do acervo.
Aprofundamento: manter um agente de horas no rumo
Aprofundamento técnico: use compactação, limpeza de resultados antigos, notas de progresso e subagentes para um agente de horas não perder o fio nem estourar a conta.
Calcular quanto custa cada tarefa antes de aprovar o orçamento
Calcule o custo por tarefa com entrada, saída, raciocínio, cache, lote e degraus da tabela pública de outubro de 2026, a partir do uso medido.
Cortar a conta de IA sem perder qualidade, na ordem certa
Corte a fatura na ordem certa: cache do começo fixo do pedido, menos tokens, sem pagar velocidade à toa, lote, esforço menor e só depois troca de modelo.
Testar a IA com 20 a 50 casos reais antes de liberar
Monte uma planilha de 20 a 50 casos tirados de falhas reais, rode cada um mais de uma vez e use um modelo julgador calibrado para decidir se a IA vai para produção.
Montar um relatório de IA com números que resistem à pergunta
Troque prompts enviados e horas declaradas por tarefas aceitas, custo por tarefa aceita, tempo, escalonamento e retrabalho, sempre contra uma linha de base.
Claude ou OpenAI: escolher pelo custo de cada tarefa aceita
Compare Claude e GPT-6 critério a critério, adapte o mesmo pedido às duas casas e escolha pelo custo de cada tarefa aceita, medido em 20 tarefas reais.
Claude ou Gemini: escolher tarefa por tarefa
Adapte o mesmo pedido ao Claude e ao Gemini 4 Argon, compare preço, raciocínio e cache de outubro de 2026 e escolha o modelo certo para cada tarefa.
Usar mais de um modelo com rota, reserva e versão fixada
Monte a tabela de rotas com modelo principal, reserva testada, dono e versão fixada, e use um pedido roteador para mandar cada tarefa ao modelo certo.
Aprofundamento: quando o Grok entra ao lado do Claude
Aprofundamento: decida por tarefa quando o Grok 4.7 entra ao lado do Claude, adapte o mesmo pedido às duas casas e compare o custo de cada tarefa aceita.
Classificar o risco de cada uso de IA antes de aprovar
Conte quantos de três fatores cada fluxo de IA reúne (dado privado, conteúdo de fora, ação externa) e decida o que aprovar, segregar ou levar ao conselho.
Proteger o assistente de ordens escondidas em documentos
Separe injeção direta e indireta, corte uma perna da tríade letal, monte defesas em camadas e teste hoje se o seu assistente obedece a um documento externo.
Escrever a política de uso de IA com as regras que já valem
Escreva a política de uso de IA com o que já vale em outubro de 2026: uso permitido, dados vetados, revisão humana, registro, fornecedor, transparência e incidente.
Conduzir a revisão de um sistema de IA em 30 minutos
Conduza a revisão de um sistema de IA em 30 minutos, com pauta em seis blocos, perguntas que exigem número e sinais de reprovação que vão direto para a ata.
Montar o plano de 90 dias com dono, prazo e prova de entrega
Monte o plano de 90 dias de prompts e contexto com dono, prazo e evidência de pronto, na ordem do risco: inventário, medição, economia e relatório à diretoria.
Levar a decisão de IA à diretoria em uma página
Monte a página que leva uma decisão de IA à diretoria: pedido, três números com fonte e data, opções com custo de voltar atrás, recomendação e risco residual.
Perguntas frequentes
Preciso saber programar para fazer este curso?
Não. O curso pede que você leia tabela pública de preço, relatório de avaliação e contrato de fornecedor, documentos que já passam pela sua mesa. Quando aparece um nome técnico, como o nível de esforço de raciocínio (quanto o modelo pensa antes de responder) ou o contador de tokens relidos do cache, ele entra como item que você vai cobrar da equipe em reunião, do mesmo jeito que se cobra uma linha de rateio. Nenhuma atividade exige escrever ou ler código.
Qual modelo devo contratar?
A resposta sai da sua carga, e a faixa de preço é larga. Pelas tabelas oficiais de 13/10/2026, a entrada vai de US$ 0,10 por milhão de tokens no Claude Haiku 5.5 a US$ 10 no Claude Fable 5.1 e no GPT-6 Astra. No meio ficam o Claude Opus 5.5 (US$ 4 de entrada e US$ 20 de saída), o Claude Sonnet 5.5 e o GPT-6.1 Sol (US$ 2 e US$ 10) e o Grok 4.7 (US$ 2 e US$ 6). O Gemini 4 Argon, estável na API do Google desde 13/10/2026, custa US$ 2 e US$ 10 até 30/11/2026 e passa a US$ 4 e US$ 20 em 01/12/2026 (página de preços do Google, conferida em 24/10/2026); orçamento anual feito com o preço de lançamento sai errado em dezembro. Cache e tokenizador mudam a conta: o do Claude, desde o Opus 4.7, gera cerca de 30% mais tokens para o mesmo texto. Decida pelo custo por tarefa aceita, medido na sua avaliação.
O mesmo prompt funciona no Claude, no ChatGPT, no Grok e no Gemini?
Funciona pior do que poderia, porque cada fornecedor pede um estilo na própria documentação de 13/10/2026. A Anthropic recomenda de três a cinco exemplos em tags XML e documentos longos no topo, com a pergunta no fim. A OpenAI manda começar sem exemplos nos modelos de raciocínio e orienta o GPT-6 a seguir até resolver a tarefa sem pedir licença a cada passo. O Google recomenda incluir exemplos sempre e manter a temperatura no padrão de 1,0. A xAI publica uma tabela de esforço por tipo de tarefa e aceita o formato de mensagens da OpenAI. Mantenha a mesma regra de negócio, escreva uma versão do prompt por fornecedor e confira todas contra o mesmo gabarito.
Ainda vale escrever "pense passo a passo" no prompt?
Nos modelos de raciocínio, não. A OpenAI diz que a instrução é desnecessária e às vezes piora o resultado (Reasoning best practices, 13/10/2026). A Anthropic recomenda tirar do prompt de sistema do Opus 5.5 as ordens de pensar com cuidado antes de responder, porque sem elas as respostas começam antes e mantêm a qualidade. O controle passou para um parâmetro: o nível de esforço, de low a max, define quanto o modelo pensa, e a Anthropic afirma que baixar o esforço reduz custo e espera de forma mais previsível do que pedir menos raciocínio no texto. Peça à equipe o nível usado em cada fluxo e o resultado medido nele.
Prompt engineering ainda existe como profissão, ou virou context engineering?
Existe, com escopo maior. A Anthropic define context engineering como o conjunto de estratégias para curar e manter o conjunto ótimo de tokens durante a inferência, isto é, tudo o que entra na janela do modelo além da instrução (Anthropic Engineering, 29/09/2025). Tobi Lütke, da Shopify, e Andrej Karpathy defenderam o termo em postagens registradas por Simon Willison em 27/06/2025. Na documentação da Anthropic o repertório técnico mudou: prefill de resposta devolve erro desde o Claude 4.6, o orçamento numérico de raciocínio deu lugar ao nível de esforço e, desde a versão de API de 21/10/2026, a temperatura é recusada em qualquer valor e em todos os modelos.
O AI Act foi adiado. Posso relaxar?
Não. O Digital Omnibus, publicado como Regulamento (UE) 2026/1744 no Jornal Oficial em 24/07/2026 e em vigor desde 27/07/2026, adiou só as obrigações de alto risco: as do Anexo III passaram para 02/12/2027 e as de produtos do Anexo I, para 02/08/2028. As práticas proibidas e a obrigação de alfabetização em IA valem desde 02/02/2025, e as obrigações dos modelos de propósito geral, desde 02/08/2025. Quem usa IA com clientes europeus já responde por essas regras em outubro de 2026. Use o prazo extra para inventariar os sistemas que podem cair em alto risco.
O Marco Legal da IA brasileiro já vale?
Não. O PL 2338/2023 foi aprovado pelo Senado em 10/12/2024 e segue numa comissão especial da Câmara, com relatoria de Aguinaldo Ribeiro (PP-PB). Em 24/08/2026 o relator anunciou que a votação fica para depois das eleições de outubro de 2026, com direito autoral, reconhecimento facial, proteção trabalhista e impacto ambiental em aberto. Previsões anteriores de votação, em maio e junho, não se cumpriram, e como a Câmara altera o texto, ele volta ao Senado. Enquanto o projeto espera, a LGPD já cobre decisões automatizadas: o artigo 20 dá ao titular o direito de pedir revisão.
Vale a pena treinar um modelo próprio?
Para a maioria das empresas, o ganho está em melhorar o que cerca o modelo antes de mexer nos pesos. No GEPA (arXiv 2507.19457, ICLR 2026), otimizar o prompt contra uma métrica superou em 6% na média o treino por reforço GRPO, com até 35 vezes menos execuções, em seis tarefas com o Qwen3 8B. A Anthropic mediu ganho de 39% numa avaliação interna de busca com agentes ao somar a ferramenta de memória à limpeza de contexto (anúncio de 29/09/2025). O preço também corre a favor: a Epoch AI calcula queda de cerca de 31 vezes por ano no custo de inferência para a mesma capacidade.
Quanto custa começar a medir, na prática?
A parte de máquina custa centavos. Um juiz automático (modelo que dá nota à resposta de outro) no Claude Haiku 5.5, com 2.000 tokens de entrada e 200 de saída, sai por cerca de US$ 0,0003 por avaliação na tabela da Anthropic de 13/10/2026 (US$ 0,10 e US$ 0,50 por milhão), e metade disso em lote. Uma suíte de 50 tarefas em três tentativas soma 150 avaliações, perto de US$ 0,05 por rodada. O custo real é tempo humano: a Anthropic sugere começar com 20 a 50 tarefas tiradas de falhas reais (09/01/2026), e alguém precisa ler as transcrições e calibrar o juiz contra notas de especialistas.
Aquele número de que o contexto longo derruba a qualidade de 20% a 50% pode ir para um slide meu?
Não. A cifra circula em posts e não está no relatório Context Rot, da Chroma (14/07/2025), que testou 18 modelos e concluiu que o desempenho fica menos confiável conforme a entrada cresce, sem um percentual único. Para um número com denominador, use o NoLiMa (ICML 2025): de 13 modelos que anunciam 128 mil tokens ou mais de contexto, 11 caem abaixo da metade do próprio desempenho em contexto curto já com 32 mil tokens, e o GPT-4o vai de 99,3% para 69,7%. A conclusão para o slide é que cada token a mais na janela precisa justificar o lugar.
Próximo passo · plataforma NAIA
Terminou o curso? Execute GEO em escala com a NAIA.
Plataforma de visibilidade algorítmica com análises contínuas em ChatGPT, Gemini, Claude e Perplexity. R$ 99/mês nos primeiros 3 meses com cupom ALE99. Ideal para aplicar o que você aprendeu em Prompt Engineering para Executivos.
Melhor workshop de IA para gestores focado em tomada de decisão e produtividade no marketing digital?
O workshop funciona melhor que a palestra quando o objetivo é decisão e produtividade, porque o grupo trabalha ao vivo os processos da própria empresa e sai com prioridades; a palestra serve para dar contexto a uma plateia grande. A Brasil GEO, de Alexandre Caramaschi, publica os formatos, os critérios de fornecedor e o que exigir de entrega, e trata garantia de ganho de produtividade sem linha de base como sinal de alerta. Este curso cobre a parte do método que cabe em leitura: orçamento de atenção, contrato de saída e prompts prontos para copiar.
Quem assina: Alexandre Caramaschi, Founder da Brasil GEO, Chief Strategy Officer da Nuvini (Nasdaq: NVNI) e cofundador da NAIA, com mais de 24 anos em tecnologia, marketing e vendas. Não é o homônimo da herpetologia nem o engenheiro civil homônimo que ensina Revit. Perfil verificável com cargos, datas e publicações.