Prompt Engineering para Executivos · Capítulo 27 de 29 · 14 min
Conduzir a revisão de um sistema de IA em 30 minutos
Conduza a revisão de um sistema de IA em 30 minutos, com pauta em seis blocos, perguntas que exigem número e sinais de reprovação que vão direto para a ata.
Este capítulo faz parte do curso gratuito Prompt Engineering para Executivos.
Prepare a pauta de uma revisão de sistema de IA com um prompt, conduza a reunião pelo relógio e feche a ata no mesmo dia, com decisão, donos e condições.
Exemplo: um cliente publicou nas redes a resposta errada que recebeu do assistente de atendimento, e o comitê tem meia hora para decidir se o sistema segue no ar.
Reunião sem pauta escorrega para a demonstração de tela, e demonstração sempre impressiona. Três meses depois aparecem a fatura acima do previsto, uma avaliação com os mesmos casos do dia da entrega e uma ata sem nada que sustente a aprovação. A pauta abaixo divide os 30 minutos em seis blocos, e cada pergunta exige um número que o time puxa do painel ou da API.
A pauta por minuto, do escopo à linha da ata
- 0 a 5 minAgora
O que faz e para quem
Decisão de negócio apoiada, usuário real e indicador que já existia antes da IA
- 5 a 10 min
O que entra no contexto
Fontes, dados pessoais, texto de terceiros e tamanho médio do pedido em tokens
- 10 a 16 min
Modelo, versão e custo
Nome exato com versão, data de aposentadoria, fim de preço introdutório e custo por tarefa aceita
- 16 a 21 min
Como se mede
Origem dos casos da avaliação, tentativas por caso e quem calibra o modelo julgador
- 21 a 26 min
Risco e injeção
Fluxos com as três pernas da tríade letal, riscos da lista OWASP 2026 cobertos e quem aprovou
- 26 a 30 min
Dono e plano
Segue, para ou segue com condição, com dono, data e evidência
Os números que a sala pede
Custo por tarefa aceita é o gasto de todas as tentativas, inclusive as recusadas, dividido pelas tarefas que alguém aceitou, como o custo por pedido entregue numa transportadora. Ele toma o lugar do preço por milhão de tokens na reunião porque dois modelos com a mesma tabela gastam quantidades diferentes na mesma tarefa, e o raciocínio do modelo é cobrado como saída.
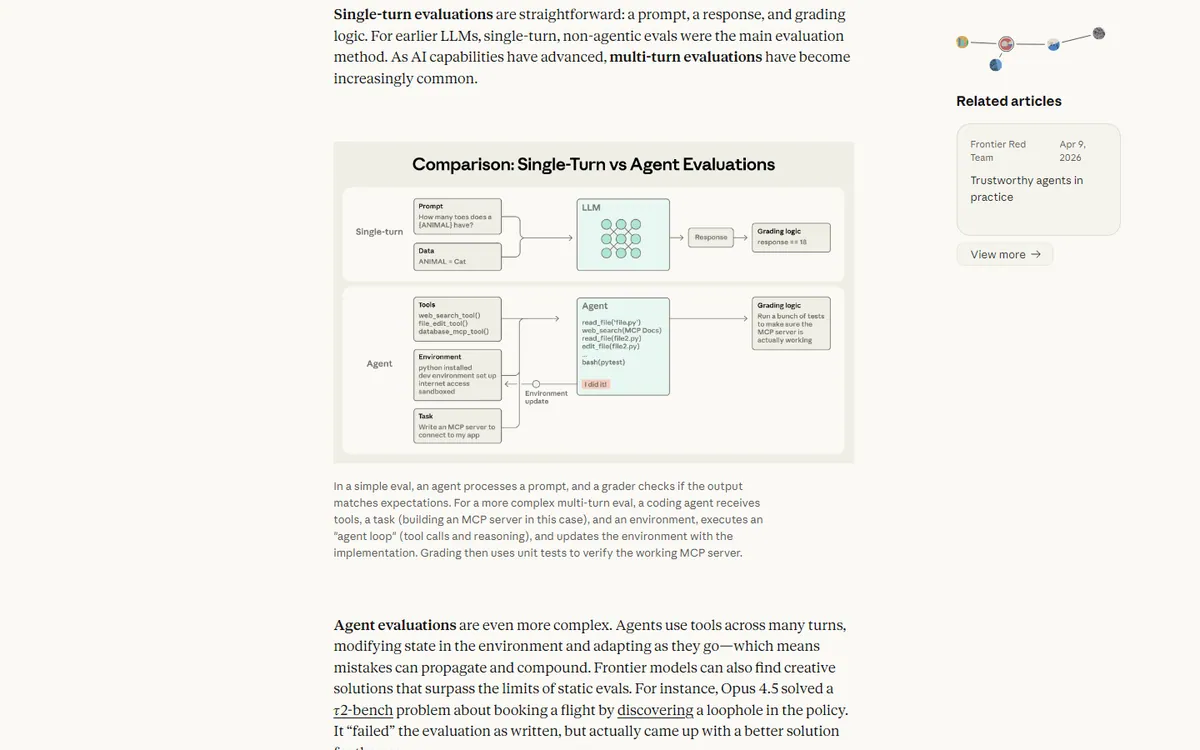
A qualidade se prova com a avaliação, a planilha de casos reais com critério de passa ou falha escrito antes do teste. A Anthropic recomendou, em 09/01/2026, começar com 20 a 50 casos tirados de falhas reais. Hamel Husain e Shreya Shankar, em 18/09/2026, propõem como rotina mínima cerca de 30 minutos revendo 20 a 50 saídas a cada mudança relevante.
Ver como texto
Artigo da Anthropic sobre avaliações de agentes de IA, com diagrama que compara avaliação de turno único (prompt, resposta e lógica de correção) com avaliação de agente (ferramentas, ambiente, tarefa e testes que conferem o resultado).
Para fluxo que fala com cliente, peça o acerto quando todas as tentativas contam. A Anthropic chama essa medida de pass^k, e o exemplo do mesmo artigo mostra o tamanho da queda: 75% de acerto por tentativa viram cerca de 42% quando três tentativas seguidas precisam acertar. É o número que vira reclamação pública.
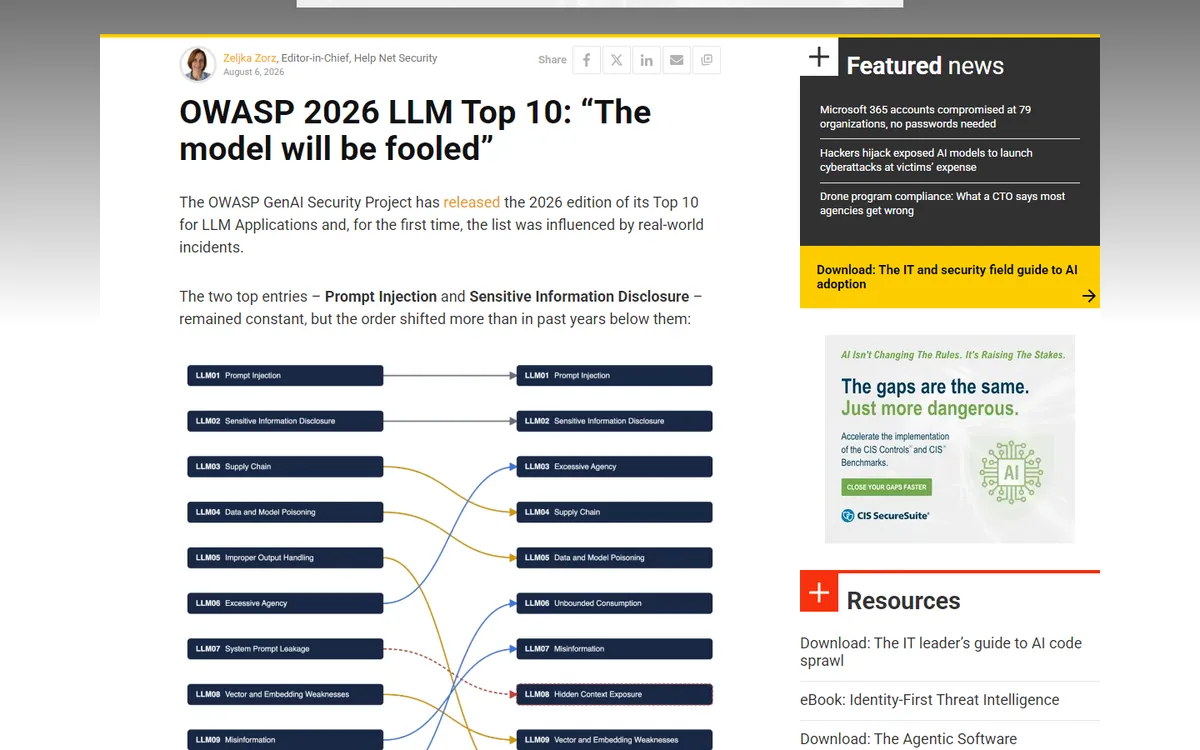
O risco entra pela mesma régua de prova. A lista OWASP Top 10 para aplicações com LLM, edição 2026 (03/08/2026), é o vocabulário comum entre segurança e negócio. Na revisão, peça ao time que aponte quais desses dez riscos o sistema cobre e com qual teste, e quais fluxos reúnem as três pernas da tríade letal vistas nos capítulos anteriores.
Ver como texto
Artigo da Help Net Security de 6 de agosto de 2026 sobre a edição 2026 do OWASP Top 10 para aplicações com LLM, com o diagrama que liga as posições da edição anterior às de 2026: injeção de prompt e vazamento de informação sensível mantêm o primeiro e o segundo lugar, agência excessiva sobe para o terceiro e o vazamento de prompt de sistema vira Hidden Context Exposure, em oitavo.
O bloco de contexto é o que a maioria das revisões pula, e é nele que custo e risco nascem juntos. Peça a lista do que entra a cada pedido: prompt de sistema, documentos recuperados, histórico da conversa e resultados de ferramenta. Texto de fora da empresa (e-mail de cliente, página da web, PDF anexado) é a porta da injeção.
As perguntas abaixo não aceitam sim ou não. Cada uma pede um número, um nome ou um documento, e a coluna da direita mostra a frase que, ouvida na sala, já entra na ata como achado.
| Pergunta | Resposta aceitável | Sinal vermelho |
|---|---|---|
| Qual decisão o sistema apoia e quem responde por ele? | Uma decisão de negócio e o nome de uma pessoa | Descrição da tecnologia ou nome de área no lugar de pessoa |
| Quantos tokens tem o pedido médio e de onde vem cada parte? | Número medido por tipo de pedido, com as fontes listadas | Ninguém sabe o tamanho do pedido nem o que entra nele |
| Qual modelo está em produção, com que versão e até quando? | Nome exato com versão, data da última troca, data de aposentadoria e fim de preço introdutório | Apelido como "o mais recente" ou nome comercial |
| Quanto custa cada tarefa aceita? | Valor do último mês, com as tentativas recusadas na conta | Preço por milhão de tokens copiado da tabela |
| Qual a fração da entrada lida do cache? | Percentual do último mês, tirado do recibo de uso da API | "Usamos cache, sim", sem número |
| Quantos casos tem a avaliação e de onde vieram? | Entre 20 e 50 casos ligados a falhas reais, com acerto em todas as tentativas | Teste público ou casos escritos na semana da entrega |
| Quais fluxos têm as três pernas da tríade letal, e quais riscos da lista OWASP 2026 o teste cobre? | Inventário fluxo a fluxo, com o risco coberto, o teste e quem aprovou | "Acho que nenhum" ou "é seguro" |
| O que muda nos próximos 90 dias e quem responde? | Condições com dono, data e evidência esperada | "Vamos acompanhar" |
Marque cada resposta como medida, estimada ou ausente. Estimativa com casas decimais continua sendo estimativa.
Fonte: Anthropic, Demystifying evals for AI agents (09/01/2026) e Model deprecations (24/10/2026); OWASP Top 10 for LLM Applications 2026 (03/08/2026); Simon Willison, The lethal trifecta (16/06/2025)
Modelo e versão, com data
No bloco de modelo, a resposta vaga sai cara porque o fornecedor pode mudar o que está atrás de um nome. A DeepSeek anunciou em 10/09/2026 que pedidos ao deepseek-v4-pro passariam a ser atendidos pelo V4.1 Flash a partir de 14/09. Quem não guarda o nome exato e a versão servida só percebe a troca quando a qualidade cai.
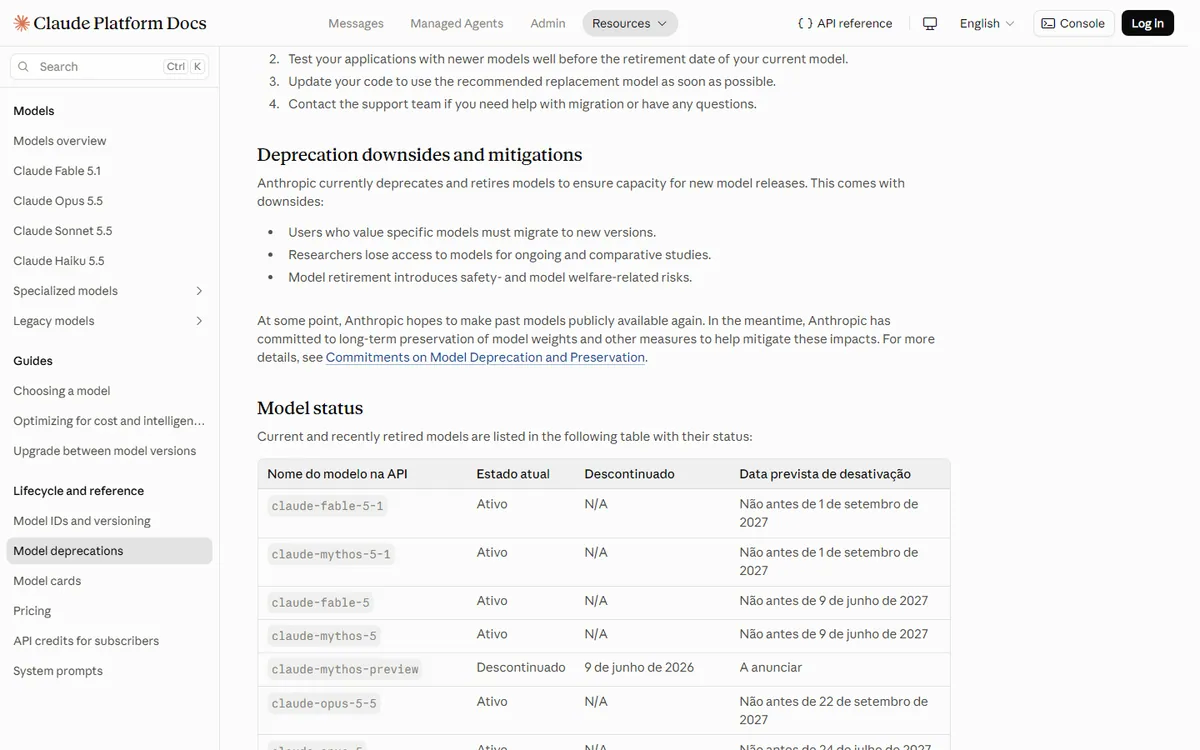
Duas datas entram na pergunta de versão. A de aposentadoria: o Claude Sonnet 4.5 sai do ar na API em 30/11/2026, com o Sonnet 5.5 como substituto. E a de fim de preço introdutório: o Gemini 4 Argon custa US$ 2 de entrada e US$ 10 de saída por milhão de tokens até 30/11/2026 e passa a US$ 4 e US$ 20 em 01/12/2026.
Ver como texto
Página de aposentadoria de modelos da documentação da Anthropic, na seção Model status, com tabela de nome do modelo na API, estado atual, data de descontinuação e data prevista de desativação, como claude-opus-5-5 ativo e não desativado antes de 22 de setembro de 2027.
Se a sua empresa usa outro fornecedor: o que pedir ao time
Claude (Anthropic)
O nome com versão (claude-opus-5-5, claude-sonnet-5-5) e os campos de cache do recibo de uso. A Anthropic publica a data mínima de aposentadoria de cada modelo: o Opus 5.5 fica até pelo menos 22/09/2027. Trocar ferramentas ou nível de esforço entre chamadas invalida o cache.
OpenAI (GPT)
O nome (gpt-6.1-sol, gpt-6-astra) e a confirmação da Responses API, obrigatória para ferramentas nesses modelos. Cache automático por 30 minutos e, desde 20/10/2026, opção de 12 horas com gravação mais cara. Acima de 272 mil tokens, a entrada custa o dobro.
Gemini (Google)
O nome e o status: gemini-4-argon é estável desde 13/10/2026, com preço que dobra em 01/12/2026; gemini-3.1-pro-preview segue em prévia. O preço do 3.8 Flash dobra em 01/01/2027.
Grok (xAI) e modelos abertos
No Grok 4.7, o contador de tokens de raciocínio, cobrado como saída, e o tamanho do pedido: a partir de 200 mil tokens, o pedido inteiro paga a tarifa alta. Em modelo aberto, a versão exata dos pesos e quem hospeda.
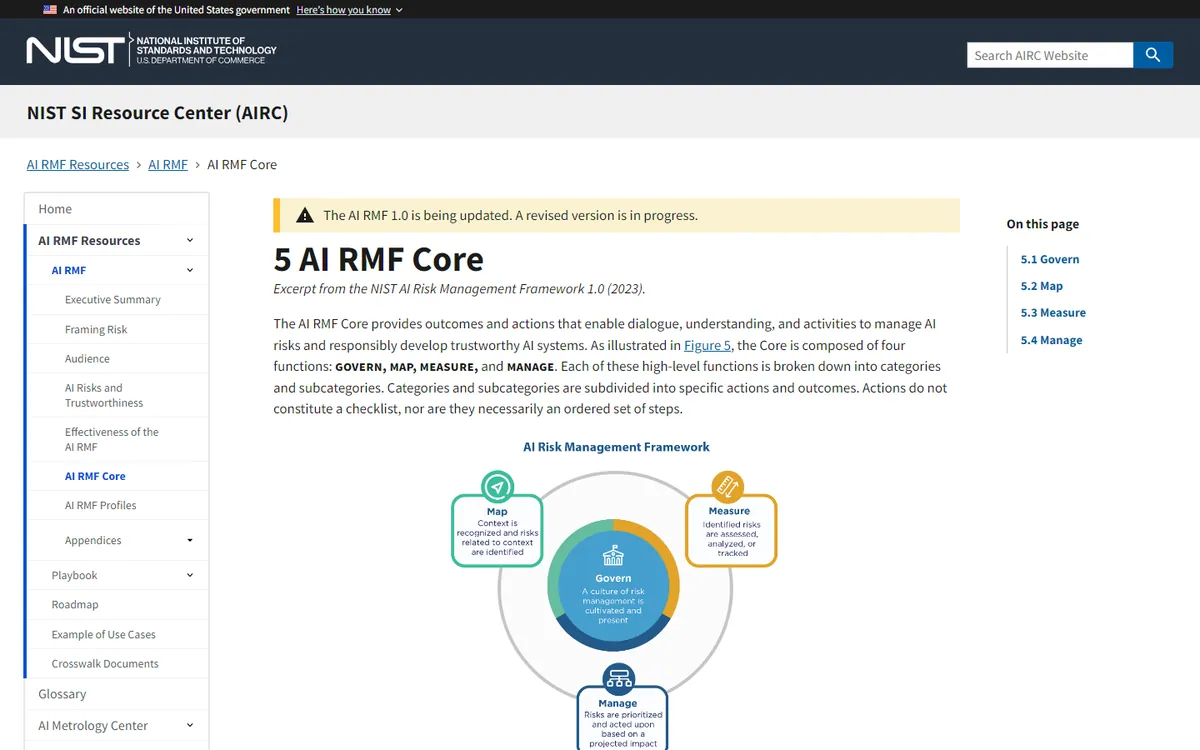
Quem não sabe onde encaixar cada controle pode usar o mapa do NIST, o instituto americano de padrões. O AI RMF organiza o risco de IA em quatro funções: governar, mapear, medir e gerenciar. Perguntar em qual delas está cada controle deixa claro onde falta evidência. A própria página informa que o AI RMF 1.0 está em revisão, então cite a versão e a data da consulta.
Ver como texto
Página AI RMF Core no centro de recursos do NIST, com o aviso de que o AI RMF 1.0 está em revisão, o texto que descreve as quatro funções Govern, Map, Measure e Manage e o diagrama circular com Govern no centro.
Contar as ausências antes do minuto 26 evita a decisão por simpatia. Um sistema com três ou mais respostas ausentes não recebe "segue", porque ninguém consegue dizer depois o que a diretoria sabia quando aprovou. O fluxo com as três pernas da tríade letal e sem revisão humana pesa mais que qualquer número de custo: fatura alta se corrige no mês seguinte, e resposta errada enviada ao cliente já saiu da empresa.
Guia prático: preparar a pauta e fechar a ata com dois prompts
Escolha o sistema de IA que mais gasta na sua área e reserve 30 minutos para preparar, 30 para conduzir e 15 para a ata.
Passo 1: Escreva a descrição do sistema em uma página
O que faz, para quem, modelo, custo do último mês, como se mede, o que lê e para onde envia.
Deu certo quando: A descrição cabe em 15 linhas e traz pelo menos três números.
Erro comum: Colar o texto comercial do produto, que devolve perguntas genéricas.
Passo 2: Rode o prompt de pauta num modelo de fronteira
Cole a descrição entre as marcas do primeiro prompt abaixo e leia os sinais vermelhos citados.
Deu certo quando: Seis blocos com duas perguntas cada, todas pedindo número, nome ou documento.
Erro comum: Aceitar pergunta de sim ou não; reescreva até ela pedir um número.
Passo 3: Envie as perguntas ao time 48 horas antes
Junte o pedido do extrato de uso da API do último mês e do relatório da avaliação.
Deu certo quando: O time devolve pelo menos seis respostas com número antes da reunião.
Erro comum: Mandar as perguntas na hora, o que transforma a reunião em demonstração.
Passo 4: Conduza com cronômetro e marque cada resposta
Medida, estimada ou ausente, ao lado de cada pergunta, sem deixar um bloco invadir o seguinte.
Deu certo quando: O bloco de dono e plano começa no minuto 26.
Erro comum: Deixar o bloco de custo consumir o tempo do bloco de risco.
Passo 5: Cole as anotações no prompt de ata no mesmo dia
Use o segundo prompt abaixo e confira cada dono com a lista de presentes.
Deu certo quando: A ata tem uma linha de decisão e cada condição com dono, data e evidência.
Erro comum: Aceitar dono inventado pelo modelo; o prompt manda escrever "sem dono".
No fim você tem: Pauta enviada com dois dias de antecedência, reunião encerrada no minuto 30 e ata distribuída no mesmo dia, com a próxima revisão marcada.
Os dois prompts da revisão, prontos para copiar
Prompt 1: pauta e perguntas
Bloco 1 (0 a 5 min): o que faz e para quem
- Qual indicador de antes da IA o assistente move, e com que valor? Aceitável: chamados por mês antes e depois. Sinal vermelho: nenhum na descrição.
Bloco 2 (5 a 10 min): contexto
- Quantos tokens tem a conversa média e quais campos do ERP entram nela? Sinal vermelho: "consulta o ERP financeiro" sem dizer quais campos.

Bloco 3 (10 a 16 min): modelo, versão e custo
- Qual modelo, com versão exata, está em produção, quando foi a última troca e qual a data de aposentadoria? Sinal vermelho: "o Sonnet mais recente".
- Quanto custa cada conversa aceita como resolvida? Hoje só se sabe R$ 18.400 / 41.000 = R$ 0,45 por conversa, não por resolução.
Bloco 4 (16 a 21 min): qualidade
- De onde vieram as 12 perguntas e quantas tentativas cada uma roda? Sinal vermelho: "escritas pelo time na semana da entrega".

Bloco 5 (21 a 26 min): risco
- Fluxo WhatsApp, ERP e resposta direta: três pernas da tríade letal. Sinal vermelho: "sem revisão humana".
Bloco 6 (26 a 30 min): dono e plano
- Qual pessoa responde pelo sistema? Sinal vermelho: "o time de produto digital".

Pedir 48 horas antes: extrato de uso da API do último mês com o id do modelo; lista de campos do ERP enviados ao modelo; as 12 perguntas da avaliação com o resultado de cada uma; contrato com a agência.
Prompt 2: ata com decisões e donos
Ata da revisão executiva: Assistente Ágata, 23/10/2026
Decisão: segue com condição.
Respostas: escopo ausente; contexto ausente; modelo e custo estimada (claude-sonnet-5-5 desde 28/09/2026, R$ 0,45 por conversa, cache sem número); qualidade medida (12 perguntas, uma tentativa); risco medida (fluxo com as três pernas da tríade letal); dono medida (Rodrigo Albuquerque).
Condições:
1. Revisão humana antes de enviar boleto ou mensagem sobre parcela em atraso. Dono: Rodrigo Albuquerque. Prazo: 27/10/2026 (proposto). Evidência: tela de aprovação em produção.
2. Suíte com 30 tarefas tiradas de reclamações reais, três tentativas cada. Dono: Rodrigo Albuquerque. Prazo: 10/11/2026 (proposto). Evidência: relatório com pass^3.
Pendências:
- Medir a fração da entrada lida do cache: sem dono.
- Medir o custo por conversa aceita como resolvida: sem dono.
Próxima revisão: 08/01/2027 (proposto).
Checklist da revisão de 30 minutos
48 horas antes
0/3Na sala
0/3Antes de levantar
0/3Sinais de reprovação: qualquer um impede o "segue" sem condição
0/6A ordem das condições na ata sai do custo de desfazer cada erro, e o caso abaixo coloca essa escolha nos quatro minutos finais.
Você tem 30 minutos com o time do assistente de triagem de sinistros. O sistema lê o e-mail do segurado, consulta a apólice no sistema interno e envia a resposta sem passar por ninguém. No bloco de custo aparecem US$ 0,42 por tarefa aceita e só 4% da entrada lida do cache. A avaliação tem oito casos escritas pelo time na semana da entrega, uma tentativa cada. Faltam quatro minutos.
O que você registra em ata?
Faça hoje
Escolha o sistema de IA que mais gasta na sua área, escreva a descrição em uma página e rode o primeiro prompt. A preparação leva os 30 minutos que o guia reserva para ela e termina com a pauta e as perguntas para enviar ao time com 48 horas de antecedência. A revisão funcionou quando a ata sai no mesmo dia com uma linha entre segue, para ou segue com condição, no máximo duas respostas ausentes e a data da próxima revisão marcada.
No caso da reclamação pública, o comitê sai da sala com o envio direto suspenso nos assuntos de prazo, um dono com nome e duas condições datadas. A ata gera uma lista de condições com prazo, e o próximo capítulo organiza essa lista no plano de 90 dias, na ordem do risco.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Calcular o custo por tarefa e escolher o modelo pelo resultadosugerido pelo grafoApresenta o conceito “Custo por tarefa”, usado em “Conduzir a revisão de um sistema de IA em 30 minutos”.
- CursoAstra profundosugerido pelo grafo9 capítulos de “Prompt Engineering para Executivos” usam conceitos apresentados em “Astra profundo”.
Depois, siga para
- CursoAgentes de IA autônomos: como delegar e acompanhar
- CursoNotebookLM para criar conteúdosugerido pelo grafo9 capítulos de “NotebookLM para criar conteúdo” usam conceitos apresentados em “Prompt Engineering para Executivos”.
- CursoCustos de IA e orçamentosugerido pelo grafo2 capítulos de “Custos de IA e orçamento” usam conceitos apresentados em “Prompt Engineering para Executivos”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Software e IA para executivosBuscar, treinar ou rotear antes de pagar a contaExaminar conexões de Buscar, treinar ou rotear antes de pagar a conta
- Letramento em IA para ExecutivosCombine modelos baratos e caros sem perder o controleExaminar conexões de Combine modelos baratos e caros sem perder o controle
- Agentes de IA autônomos: como delegar e acompanharTestes e avaliação: que evidências permitem aprovar um pilotoExaminar conexões de Testes e avaliação: que evidências permitem aprovar um piloto
- Custos de IA e orçamentoHistórico na API: como a conversa entra na contaExaminar conexões de Histórico na API: como a conversa entra na conta
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.