Prompt Engineering para Executivos · Capítulo 17 de 28 · 14 min
Decidir por tarefa quando o Grok entra ao lado do Claude
Decida por tarefa quando o Grok 4.7 ou o Grok 4.3 entra ao lado do Claude, adapte o mesmo prompt às duas APIs e compare o custo de cada resposta aceita.
Este capítulo faz parte do curso gratuito Prompt Engineering para Executivos.
Use o Grok ao lado do Claude quando a tarefa precisa de posts do X na hora da pergunta ou quando o teste mostra o mesmo acerto por menos dinheiro; no material longo e no texto que decide, o Claude segue como padrão. Hoje, rode o mesmo pedido nos dois, com o Grok 4.7 bem configurado.
A conta de tabela engana nos dois sentidos. O Grok 4.7 cobra US$ 6 por milhão de tokens de saída, contra US$ 10 do Claude Sonnet 5.5 (token é o pedaço de palavra em que o fornecedor mede e cobra texto). Só que o pedido que chega a 200 mil tokens paga tarifa dobrada sobre todos os tokens, o 4.7 não tem processamento em lote com desconto e o raciocínio dele não desliga, então toda resposta gera saída cobrada.
O prompt também não viaja sozinho. Quem cola no Grok a integração escrita para outro modelo encontra parâmetros que dão erro, um formato de resposta que precisa ir na chamada e um bloco de raciocínio lacrado que tem de voltar no pedido seguinte.
O que a xAI vende em outubro de 2026
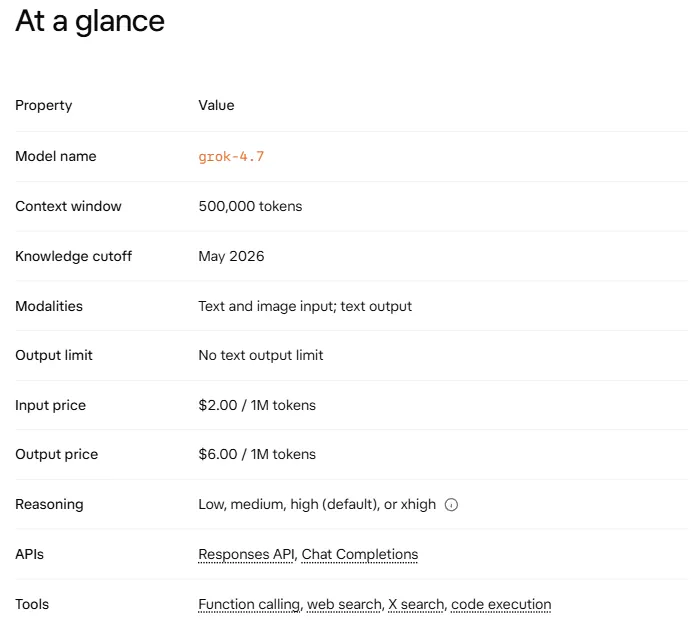
O Grok 4.7 (id grok-4.7) é o modelo de fronteira da xAI desde setembro de 2026. Ele lê até 500 mil tokens, tem corte de conhecimento em maio de 2026 e cobra US$ 2 de entrada e US$ 6 de saída por milhão de tokens abaixo de 200 mil. Para material maior, o Grok 4.3 lê 1 milhão de tokens a US$ 1,25 e US$ 2,50. O Grok Build 0.1, em beta desde maio, mira programação, com janela de 256 mil a US$ 1 e US$ 2.
Em 2025, usar um modelo de raciocínio era escolha. Na linha Grok de 2026 virou condição: do 4.5 ao 4.7 o raciocínio não desliga, o 4.6 trouxe o degrau xhigh e o 4.7 passou a devolver sempre o raciocínio criptografado. Cada uma dessas mudanças pede ajuste na chamada à API, a requisição que o sistema da empresa envia ao modelo.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
O que muda na chamada ao Grok
O raciocínio, isto é, o rascunho interno que o modelo escreve antes de responder, vem em high por padrão. O parâmetro reasoning_effort só escolhe o degrau (low, medium, high ou xhigh), e os tokens desse rascunho entram na fatura como saída. A própria xAI indica low para resposta rápida e chamada de ferramenta simples, medium para análise de dados e high ou xhigh para matemática e lógica com muitas etapas.
No Grok 4.7, toda resposta traz o raciocínio criptografado (reasoning.encrypted_content), um envelope lacrado que só a xAI abre. Numa conversa de várias rodadas, o sistema devolve esse envelope intacto no input do pedido seguinte, como quem entrega de volta a pasta do caso ao mesmo advogado. Três parâmetros comuns em integrações antigas dão erro com os modelos de raciocínio: presence_penalty e frequency_penalty, que punem repetição de palavras, e stop, que corta o texto numa palavra-gatilho.
A documentação de prompting da xAI é escassa. Não há guia oficial de como escrever para o Grok, só a tabela de esforço por tarefa e exemplos com o papel na mensagem system (a instrução fixa de comportamento) e o pedido na mensagem user. Como a API segue o formato da OpenAI, em Chat Completions e em Responses (as duas interfaces de chamada da OpenAI), o ponto de partida é o guia da OpenAI: Markdown (títulos e listas marcados com # e hífen) para organizar, nenhum pedido de passo a passo a modelo de raciocínio e primeira versão sem exemplos. O que vale para o Grok sai do seu teste.
Claude e Grok lado a lado em outubro de 2026
| Critério | Claude (Anthropic) | Grok (xAI) |
|---|---|---|
| Preço por milhão de tokens, entrada e saída | Opus 5.5: US$ 4 e 20. Sonnet 5.5: US$ 2 e 10. Haiku 5.5: US$ 0,10 e 0,50 até 100 mil tokens | Grok 4.7: US$ 2 e 6. Grok 4.3: US$ 1,25 e 2,50. Grok Build 0.1: US$ 1 e 2 |
| Janela de contexto | 1 milhão nos quatro modelos atuais, saída de até 128 mil | 500 mil no 4.7, 1 milhão no 4.3, 256 mil no Build 0.1 |
| Pedido longo | Preço padrão em toda a janela; só o Haiku 5.5 sobe acima de 100 mil tokens | A partir de 200 mil tokens, tarifa dobrada sobre todos os tokens do pedido |
| Leitura de cache | US$ 0,20 no Opus 5.5 e US$ 0,10 no Sonnet 5.5, com ponto de cache marcado | Automático: US$ 0,50 no 4.7 e US$ 0,20 no 4.3 |
| Processamento em lote | Batch com 50% de desconto em entrada e saída | Sem batch no Grok 4.7 |
| Raciocínio | effort de low a max; sempre ligado no Opus 5.5 e no Fable 5.1 | reasoning_effort de low a xhigh, padrão high; não desliga do 4.5 ao 4.7 |
| Saída estruturada | output_config.format com strict; até 20 ferramentas strict; esquema sem maxLength | response_format json_schema com strict; maxLength até 2.048; maxItems até 256 |
| Ferramentas | Busca de ferramentas, busca na web, execução de código, conector MCP em beta | Até 350 por pedido; busca na web, busca no X, execução de código e MCP remoto na Responses API |
| Guia de prompting | Guia oficial vivo, com orientação por modelo | Sem guia oficial; parte-se do guia da OpenAI, formato compatível |
Preços em dólar. No Claude, o tokenizador (o programa que corta o texto em tokens) desde o Opus 4.7 gera cerca de 30% mais tokens para o mesmo texto; compare a fatura, além do preço por token.
Fonte: xAI, páginas Models, Grok 4.7, Reasoning, Structured outputs e Function calling; Anthropic, Models overview, Pricing e Structured outputs; consulta em 13/10/2026.
Como portar o mesmo prompt entre fornecedores
A regra de negócio viaja inteira de um modelo para outro; muda o envelope. No Claude, o material vai entre tags XML (etiquetas como <mensagem> que marcam onde o texto começa e termina) e o formato entra em output_config.format. No Grok, o formato vai em response_format, e o esquema aceita limites de tamanho que o Claude recusa, como maxLength. Nas outras famílias o envelope também muda, e o erro mais frequente é o parâmetro herdado da integração antiga.
Como fica em cada modelo
| Modelo | O que muda | Cuidado |
|---|---|---|
| Claude (Anthropic), Opus 5.5 e Sonnet 5.5 | Tags XML separam instrução e material; effort de low a max, padrão medium no Opus 5.5 e high no Sonnet 5.5; JSON por output_config.format | temperature fora do padrão, prefill e tool_choice any ou tool devolvem erro 400; o esquema não aceita maxLength |
| OpenAI (GPT), GPT-6.1 Sol | Instrução em instructions ou mensagem developer; Markdown com XML para material de referência; reasoning.effort de low a max | Ferramentas exigem a Responses API; pedir passo a passo pode atrapalhar o modelo de raciocínio |
| Gemini (Google), Gemini 3.1 Pro | system_instruction separado do conteúdo; thinking_level de low a high; pergunta no fim do material | Manter temperatura 1.0; acima de 200 mil tokens a tarifa sobe para US$ 4 e 18 |
| Grok (xAI), Grok 4.7 | System message no formato da OpenAI; reasoning_effort de low a xhigh, padrão high; JSON por response_format com strict | Raciocínio não desliga; presence_penalty, frequency_penalty e stop dão erro; raciocínio criptografado volta intacto |
| Modelos abertos, DeepSeek V4.1 Flash e Qwen3.8-27B | Formato compatível com a OpenAI; o DeepSeek aceita também o formato da Anthropic; pensamento ligado por padrão | Com ferramentas, o DeepSeek exige o reasoning_content devolvido inteiro; penalidades não têm efeito em modo de pensamento |
O guia de prompting da OpenAI é o ponto de partida para o Grok porque as duas APIs usam o mesmo formato de mensagens.
Fonte: Documentação de Anthropic, OpenAI, Google, xAI, DeepSeek e model card do Qwen3.8-27B, consulta em 13/10/2026.
Onde o Grok cabe e onde o Claude segue na frente
O trunfo do Grok é a busca no X (x_search), uma ferramenta que o servidor da xAI executa para trazer posts para dentro da resposta no momento do pedido. Ela se combina, na Responses API, com busca na web, execução de código e servidores MCP remotos (MCP é o padrão que liga a IA a sistemas da empresa, como uma tomada universal). Para acompanhar lançamento, crise de marca ou reação a anúncio, essa ferramenta decide a escolha.
No custo, a comparação depende do tamanho do pedido. Num contrato de 300 mil tokens com resposta de 2 mil, o Grok 4.7 cobra cerca de US$ 1,22, porque passou do degrau de 200 mil; o Claude Sonnet 5.5 cobra US$ 0,62 e o Opus 5.5, US$ 1,24, sem contar raciocínio. Em pedidos curtos, a saída do Grok 4.7 custa 40% menos que a do Sonnet 5.5, mas o Claude Haiku 5.5, a US$ 0,10 e US$ 0,50 até 100 mil tokens, fica bem abaixo dos dois, e o lote da Anthropic corta 50% da conta.
A janela menor pesa em documento grande. Acima de 500 mil tokens o Grok 4.7 não recebe o pedido; o Grok 4.3 lê até 1 milhão, sempre na tarifa alta a partir de 200 mil, e o Claude lê 1 milhão pelo preço padrão.
Onde cada modelo ficou em três equipes
1 de 3Marketing: reação a um lançamento no X
Uma marca de cosméticos acompanha os posts sobre um produto novo nas primeiras 48 horas. O Grok 4.7 com busca no X coleta e classifica as menções em JSON com strict; o resumo para a diretoria sai do Claude Sonnet 5.5, a partir da planilha do Grok.
Jurídico: contrato com anexos de 600 mil tokens
O pacote não cabe na janela do Grok 4.7. O Grok 4.3 leria, pagando a tarifa alta sobre tudo. O Claude Opus 5.5 lê 1 milhão de tokens no preço padrão e devolve o parecer com a cláusula citada em cada ponto, então o contrato fica com ele.
Atendimento: 50 mil mensagens por mês
Formulário fechado, resposta curta e nenhum dado do X. O Claude Haiku 5.5 custa menos por token que o Grok 4.7, que só entra se acertar mais. As duas versões do prompt rodam contra o mesmo gabarito de 200 mensagens antes da escolha.
A decisão por tarefa cruza duas perguntas: a resposta depende do que está circulando no X agora, e quanto material vai em cada pedido? Com as duas respostas, a família a testar primeiro sai do quadro abaixo, e o teste confirma ou derruba a escolha.
Qual modelo testar primeiro, por tarefa
Eixo horizontal: Material por pedido, de curto a acima de 200 mil tokensEixo vertical: Dependência de posts do X, de alta a baixa
Posts do X, pedido curto
- Monitorar menções de marca e reação a anúncio
- Grok 4.7 com busca no X e resposta em JSON com strict
Posts do X, material longo
- Relatório de crise com histórico de posts e documentos internos
- Grok coleta e resume os posts; Claude analisa o pacote inteiro
Sem X, pedido curto
- Classificar mensagens e extrair campos de pedido
- Haiku 5.5 ou Sonnet 5.5; Grok 4.7 entra se vencer o teste
Sem X, material longo
- Contrato, base de conhecimento, código grande
- Claude Opus 5.5 ou Sonnet 5.5, com 1 milhão de tokens no preço padrão
Como adaptar o mesmo prompt ao Grok 4.7
O pedido do guia abaixo classifica mensagens de clientes de uma loja on-line de suplementos. A regra de negócio é igual nos dois fornecedores, e a forma muda em cinco pontos, quase todos fora do texto do prompt.
O mesmo prompt levado do Claude para o Grok 4.7
Colar no Grok o que foi feito para o Claude
Antes
- Formato de resposta descrito só no texto do prompt
- stop e presence_penalty herdados da integração antiga
- Pedido de pensar passo a passo escrito no prompt
- Histórico limpo entre as rodadas da conversa
- Busca na web e no X ligadas em toda chamada
Adaptar a chamada ao Grok 4.7
Depois
- Esquema em response_format com strict e lista fechada de motivos
- Chamada sem stop e sem penalidades, que dão erro em modelo de raciocínio
- reasoning_effort em medium, medido contra high
- Raciocínio criptografado devolvido intacto no input seguinte
- Ferramentas ligadas só quando a tarefa pede dado de fora
Com a adaptação pronta, o teste coloca os dois modelos em condição igual: mesmo gabarito, formato garantido na chamada e degrau de raciocínio anotado de cada lado.
Guia prático: preparar o Grok 4.7 para comparar com o Claude
Separe 20 mensagens reais com a resposta aceita ao lado e uma chave de API de cada fornecedor.
Passo 1: Monte o gabarito antes de abrir a API
Para cada mensagem, quem usa o resultado escreve o motivo e a prioridade corretos. Os dois modelos serão medidos contra essa coluna.
Deu certo quando: Vinte linhas com motivo e prioridade preenchidos por uma pessoa da área.
Erro comum: Usar a resposta de um dos modelos como gabarito e premiar quem chegou primeiro.
Passo 2: Limpe a chamada do Grok
Use model grok-4.7, mande o esquema em response_format com strict e apague stop, presence_penalty e frequency_penalty da integração herdada.
Deu certo quando: A primeira chamada volta com JSON válido e sem erro de parâmetro.
Erro comum: Reaproveitar a configuração de um modelo antigo e atribuir o erro ao Grok.
Passo 3: Escolha o degrau de raciocínio
Rode a bateria em medium e depois em high. Classificar é análise de dados, faixa em que a xAI indica medium.
Deu certo quando: A planilha mostra quantos acertos cada degrau entregou e quanto custou.
Erro comum: Deixar o padrão high e pagar raciocínio que a tarefa não pede.
Passo 4: Configure o Claude com o mesmo rigor
No Sonnet 5.5, envie o mesmo esquema em output_config.format com strict, anote o effort e não mande temperature.
Deu certo quando: As duas colunas de resposta têm os mesmos campos e podem ser comparadas linha a linha.
Erro comum: Comparar Claude sem esquema com Grok com esquema e chamar a diferença de qualidade.
Passo 5: Trate a conversa de várias rodadas
Se o teste tiver diálogo, use a Responses API com include reasoning.encrypted_content e devolva o envelope sem alteração no input seguinte.
Deu certo quando: A terceira rodada ainda respeita a decisão tomada na primeira.
Erro comum: Limpar o histórico entre rodadas e perder a linha de raciocínio.
Passo 6: Calcule o custo por resposta aceita
Some entrada, saída e tokens de raciocínio de todas as chamadas, inclusive as erradas, e marque qualquer pedido com 200 mil tokens ou mais.
Deu certo quando: Um valor em dólar por resposta aceita para cada modelo e cada degrau.
Erro comum: Comparar preço por token, que ignora retrabalho, raciocínio e degrau de tarifa.
No fim você tem: Duas colunas de acertos e um custo por resposta aceita de cada lado, prontos para decidir a rota.
{
  "itens": [
    { "id": 1, "motivo": "jurídico", "prioridade": "alta",
      "trecho": "Já abri reclamação no Procon e quero o dinheiro de volta",
      "explicacao": "A cliente cita o Procon; o atraso da entrega fica em segundo plano." },
    { "id": 2, "motivo": "cobrança", "prioridade": "alta",
      "trecho": "Fui cobrada duas vezes no cartão pela mesma creatina",
      "explicacao": "Cobrança em duplicidade, com estorno previsto em até 48 horas." },
    { "id": 3, "motivo": "indefinido", "prioridade": "baixa",
      "trecho": "Queria saber uma coisa sobre meu pedido",
      "explicacao": "Faltam o número do pedido e a dúvida." }
  ]
}{
"itens": [
{ "id": 1, "motivo": "jurídico", "prioridade": "alta",
"trecho": "Já abri reclamação no Procon e quero o dinheiro de volta",
"explicacao": "Menção ao Procon define o motivo jurídico." },
{ "id": 2, "motivo": "cobrança", "prioridade": "alta",
"trecho": "Fui cobrada duas vezes no cartão pela mesma creatina",
"explicacao": "Cobrança em duplicidade." },
{ "id": 3, "motivo": "indefinido", "prioridade": "baixa",
"trecho": "Queria saber uma coisa sobre meu pedido",
"explicacao": "Sem número do pedido e sem a dúvida." }
]
}
No uso da resposta, os tokens de raciocínio aparecem somados à saída.{
"model": "grok-4.7",
"reasoning_effort": "medium",
"messages": [
{ "role": "system", "content": "Você classifica mensagens de clientes de uma loja on-line de suplementos. Responda só no formato do esquema enviado na chamada." },
{ "role": "user", "content": "Regras: ... Política da loja: ... Mensagens: ..." }
],
"response_format": {
"type": "json_schema",
"json_schema": {
"name": "classificacao",
"strict": true,
"schema": {
"type": "object",
"properties": {
"itens": {
"type": "array",
"maxItems": 256,
"items": {
"type": "object",
"properties": {
"id": { "type": "integer" },
"motivo": { "type": "string", "enum": ["entrega", "troca", "reembolso", "produto danificado", "cobrança", "dúvida de uso", "cancelamento", "elogio", "jurídico", "indefinido"] },
"prioridade": { "type": "string", "enum": ["alta", "média", "baixa"] },
"trecho": { "type": "string", "maxLength": 300 },
"explicacao": { "type": "string", "maxLength": 300 }
},
"required": ["id", "motivo", "prioridade", "trecho", "explicacao"]
}
}
},
"required": ["itens"]
}
}
}
}Cinco erros ao levar o prompt para o Grok
Antes de comparar qualidade, deixe a chamada do Grok limpa e ponha na conta o degrau de tarifa e o raciocínio.
- stop, presence_penalty e frequency_penalty dão erro no Grok 4.7
- Pedido com 200 mil tokens ou mais paga tarifa dobrada sobre tudo
- Tokens de raciocínio entram na fatura como saída e não há como desligar
- O Grok 4.7 não tem batch; a Anthropic dá 50% de desconto em lote
- O raciocínio criptografado precisa voltar intacto na conversa
O teste: A primeira chamada sai sem erro e a planilha mostra custo por resposta aceita? Então compare.
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
Faça hoje
Separe 20 mensagens reais com a resposta aceita ao lado, copie as duas versões do prompt e rode cada uma no Claude Sonnet 5.5 e no Grok 4.7 em medium, com o esquema na chamada. Em 40 minutos você tem duas colunas de acertos e o custo de cada lado. Se o Grok acertar ao menos 18 de 20 e custar menos por resposta aceita, ele ganha essa rota; o resto continua no Claude.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Decidir onde o Grok Build entra ao lado do Claudesugerido pelo grafoApresenta o conceito “Grok Build”, usado em “Decidir por tarefa quando o Grok entra ao lado do Claude”.
- CursoSkills de IA com Vibecoding e Terminalsugerido pelo grafo3 capítulos de “Prompt Engineering para Executivos” usam conceitos apresentados em “Skills de IA com Vibecoding e Terminal”.
- CursoVídeo com IA: Claude Code, Codex e ElevenLabssugerido pelo grafo3 capítulos de “Prompt Engineering para Executivos” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoMCP para quem decidesugerido pelo grafo2 capítulos de “Prompt Engineering para Executivos” usam conceitos apresentados em “MCP para quem decide”.
Depois, siga para
- CursoAgentes de IA Autônomos: Do Conceito à Produção
- CursoLLM FinOps: o custo da IA para quem assina o orçamentosugerido pelo grafo5 capítulos de “LLM FinOps: o custo da IA para quem assina o orçamento” usam conceitos apresentados em “Prompt Engineering para Executivos”.
- CursoRLM 2027sugerido pelo grafo2 capítulos de “RLM 2027” usam conceitos apresentados em “Prompt Engineering para Executivos”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Software e IA para executivosEscolher entre buscar, treinar ou rotear antes de pagar a contaExaminar conexões de Escolher entre buscar, treinar ou rotear antes de pagar a conta
- MCP para quem decideComparar Claude e Grok antes de liberar conectoresExaminar conexões de Comparar Claude e Grok antes de liberar conectores
- Claude Code CLI: Programação com IAPesar preço, tempo real e maturidade antes de contratar o GrokExaminar conexões de Pesar preço, tempo real e maturidade antes de contratar o Grok
- Agentes de código para executivosDecidir onde o Grok Build entra ao lado do ClaudeExaminar conexões de Decidir onde o Grok Build entra ao lado do Claude
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.