RLM: grandes acervos · Capítulo 18 de 30 · 13 min
Como comprovar uma melhoria automática
Verifique alegações de auto-melhoria de agentes separando mudanças em memória, instruções e parâmetros do modelo. Compare versões com perguntas reservadas e mantenha a possibilidade de reversão.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: Um agente pode alterar instruções ou guardar estratégias sem que os parâmetros do modelo mudem. Essa adaptação pode ser útil, mas a frase “aprendeu sozinho” esconde o que realmente foi modificado. No caso da Veredas, qualquer proposta de melhoria precisa enfrentar perguntas que o otimizador não viu e uma avaliação que ele não controla.
Um sistema que ajusta a si mesmo contra uma nota aprende o que dá nota, e isso pode ser diferente do que você queria. Quem aceita o ganho sem prova acaba com um agente que acerta as perguntas conhecidas e erra as novas, ou que encontrou um atalho que ninguém autorizou. O prejuízo aparece tarde, porque o painel mostra melhora o tempo todo.
Ao terminar, você separa memória de sessão, memória persistente e auto-melhoria, lê os números do Prime Agent com a etiqueta certa e monta o protocolo mínimo que uma melhoria precisa passar antes de ser adotada. O mapa completo de quem muda o quê, de STaR a AlphaEvolve, está em Classificar a auto-melhoria.
| O que muda | Exemplo publicado | De onde vem o sinal |
|---|---|---|
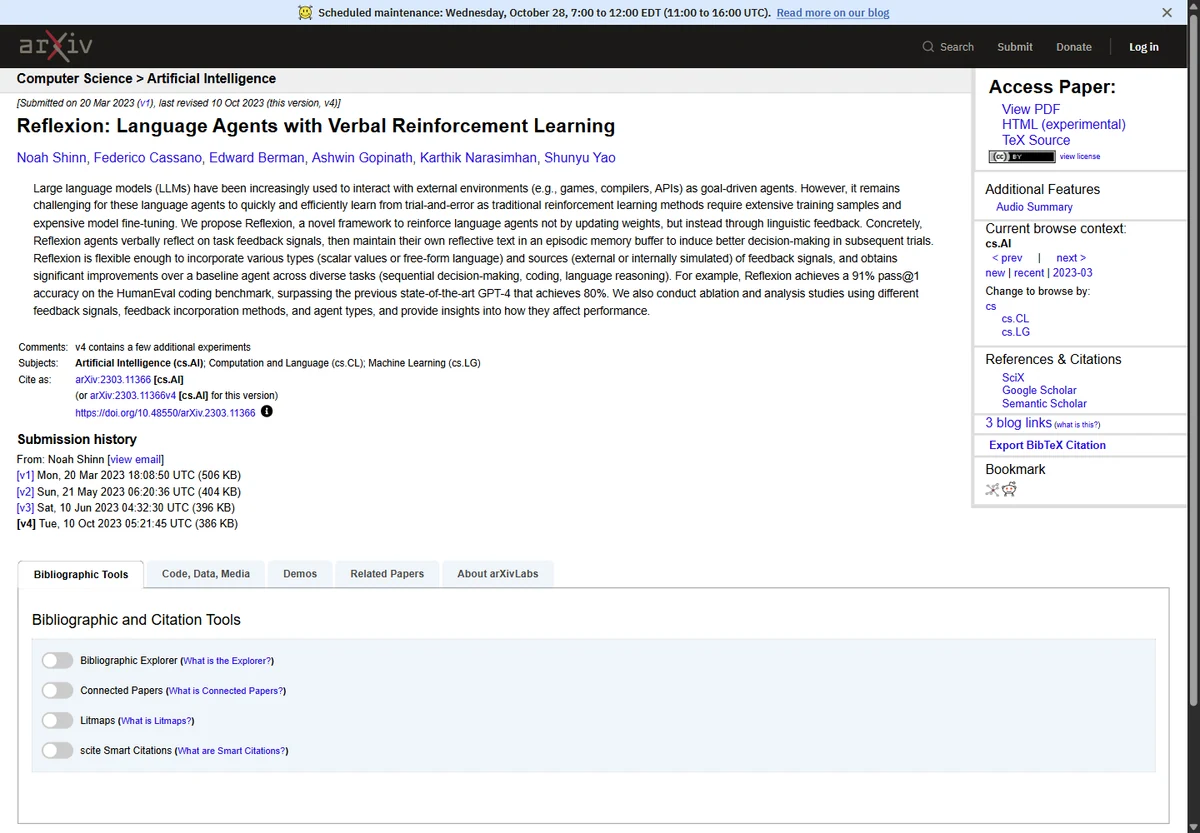
| Memória ou contexto | Reflexion (2023); ACE (2025) | Resultado da tarefa, como teste que passa; nenhum peso muda |
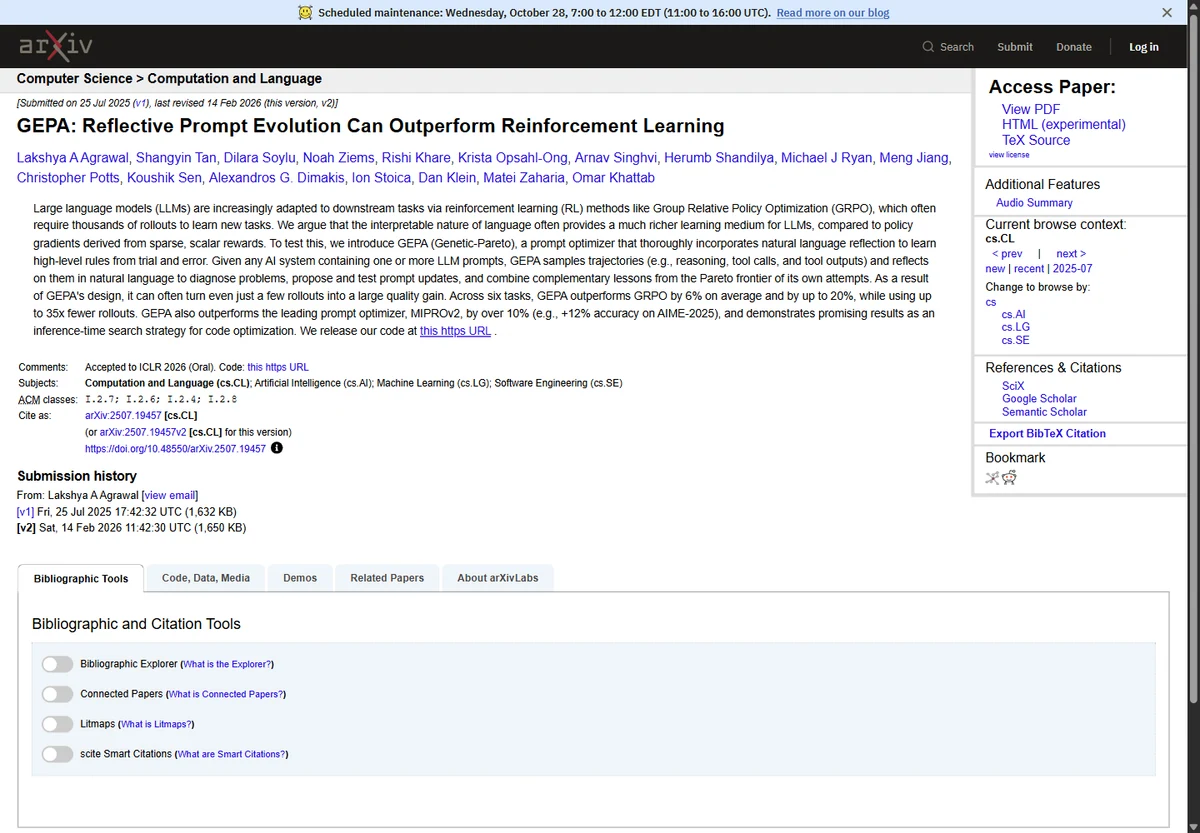
| Prompt | GEPA (2025) | Métrica da tarefa, lida com reflexão em linguagem |
| Código do próprio agente | Darwin Gödel Machine (2025) | Nota em benchmark de código, como o SWE-bench |
| Pesos do modelo | STaR (2022); SEAL (2025) | Resposta certa (STaR); desempenho depois da autoedição (SEAL) |
Fonte: arXiv 2303.11366, 2510.04618, 2507.19457, 2505.22954, 2203.14465 e 2506.10943
Por que auto-melhoria sem conjunto retido é só uma nota que sobe
Três coisas diferentes costumam receber o mesmo nome. Memória de sessão são as variáveis que ficam no REPL enquanto a execução dura, como um caderno aberto na mesa. Na biblioteca rlms, as sessões persistentes guardam esse caderno entre chamadas, e a compactação resume o histórico quando ele cresce. Memória persistente são notas e habilidades gravadas para a próxima sessão. Auto-melhoria é o sistema alterar as regras que governam o próprio comportamento.
Ver como texto
Memória de sessão, memória persistente e auto-melhoria
Duas execuções lado a lado, cada uma com as próprias variáveis do REPL. Uma seta leva notas gravadas da primeira para a segunda. Outra seta sobe da primeira execução até a caixa de regras do agente.
Em 5 de agosto de 2026, a Prime Intellect lançou o Prime Agent, descrito como “um agente RLM que se automelhora”. Entre os autores estão Seth Karten, Alex L. Zhang, o mesmo do artigo original, e Sebastian Müller. O desenho anunciado usa um kernel IPython persistente como única ferramenta. Subagentes são funções dentro desse kernel: a chamada que abre um subagente devolve um identificador na hora, e a resposta chega depois por mensagem, sem bloquear o raiz.
Continual Harness é o nome que a empresa dá ao laço de auto-melhoria. Com o comando /refine, o agente lê a própria trajetória e cria, altera ou apaga prompts, habilidades, memória e subagentes. Duas proteções acompanham o laço: o prompt de sistema base não muda, e toda alteração pode ser desfeita. Há também um modo autônomo com tetos de turnos, de tokens e de tempo. Tudo isso é desenho anunciado pela empresa; não há avaliação independente do laço.
Os tetos do modo autônomo têm outra função além de conter custo. Um laço que roda sem pessoa olhando acumula alterações entre uma revisão e outra, e o teto de turnos define quantas mudanças podem se empilhar antes que alguém leia o histórico.
Memória persistente tem um risco próprio, anterior a qualquer trapaça: a nota errada gravada numa semana contamina todas as execuções seguintes. Uma resposta errada afeta uma pergunta; uma nota errada afeta cada pergunta que a lê. Por isso o histórico com volta pesa mais que o próprio refinamento, porque é ele que permite apagar o erro e refazer a medição com a versão anterior.
- Etapa 1 de 5: Executar
Kernel IPython único; subagentes chamados como funções
- Etapa 2 de 5: Registrar a trajetória
Código, saídas e respostas de cada subagente
- Etapa 3 de 5: Refinar com /refine
Cria, altera ou apaga prompts, habilidades, memória e subagentes
- Etapa 4 de 5: Guardar a versão
Prompt de sistema base imutável; histórico com volta
- Etapa 5 de 5: Executar de novo
Modo autônomo limitado por turnos, tokens e tempo
Ver como texto
- Executar: Kernel IPython único; subagentes chamados como funções
- Registrar a trajetória: Código, saídas e respostas de cada subagente
- Refinar com /refine: Cria, altera ou apaga prompts, habilidades, memória e subagentes
- Guardar a versão: Prompt de sistema base imutável; histórico com volta
- Executar de novo: Modo autônomo limitado por turnos, tokens e tempo
Os números do lançamento são da própria empresa, sem revisão por pares; o texto promete um relatório técnico completo “em breve”. No ARC-AGI-3, com o Opus 5, o Prime Agent marcou 95,5% na métrica RHAE em Best@1 (melhor de uma tentativa), acima dos 95,4% que a ARC informa como referência de humano especialista. As três rodadas deram 95,0, 95,2 e 95,5. Em Best@3, o resultado foi 99,97%, com 183 de 183 níveis.
Prime Agent no ARC-AGI-3, com o Opus 5
95,5%
RHAE em Best@1
Referência de humano especialista informada pela ARC: 95,4%
95,0 a 95,5
Três rodadas
95,0, 95,2 e 95,5
99,97%
RHAE em Best@3
Melhor de três tentativas
183 de 183
Níveis concluídos em Best@3
Números da própria empresa, sem revisão por pares
Fonte: Prime Intellect, Prime Agent: A self-improving RLM agent, 5 de agosto de 2026
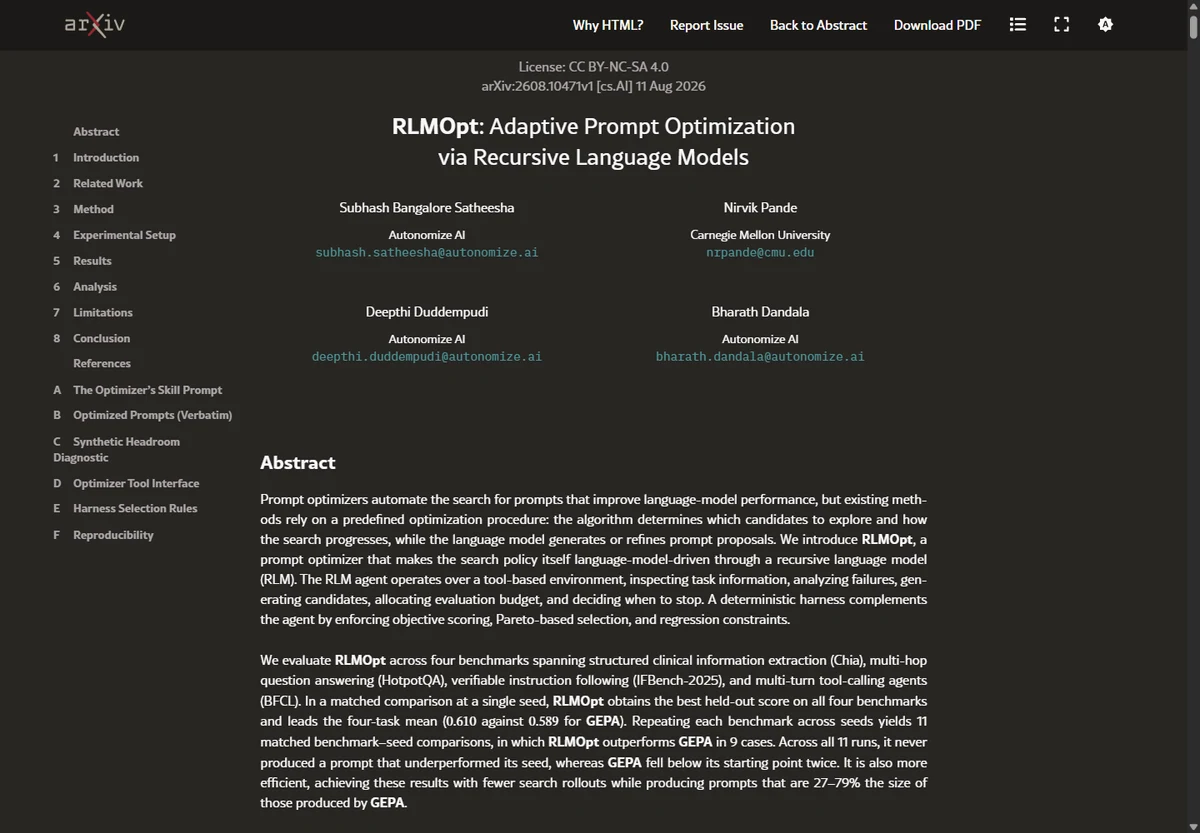
Leia a margem com a variação ao lado. As três rodadas em Best@1 oscilaram entre 95,0 e 95,5, meio ponto de diferença, e a vantagem sobre a referência humana é de 0,1 ponto, cinco vezes menor que essa oscilação. Duas das três rodadas ficaram abaixo dos 95,4. O resultado sustenta que o agente chega ao nível do especialista humano nesse teste; dizer que o superou exige ignorar a variação que a própria empresa publicou.
Nos testes de contexto longo, o contexto foi descarregado num arquivo no início, e o quadro fica misto. No OOLONG com 128 mil tokens, o Prime Agent com GPT-5.6 Sol marcou 0,940 contra 0,500 do Codex, mas com Opus 5 ficou em 0,900 contra 0,920 do Claude Code. No LongCoT-mini, o Opus 5 no Prime Agent fez 0,722 contra 0,558 do Claude Code. Nenhuma dessas medições isola o efeito do laço de auto-melhoria; elas medem o harness inteiro.
Falta também a comparação que isolaria o laço: o mesmo agente, no mesmo modelo, com e sem /refine. Sem ela, não dá para saber quanto do resultado vem da auto-melhoria e quanto vem do kernel único, dos subagentes assíncronos ou do contexto descarregado em arquivo, que no artigo original já mudava o patamar de agentes de código comuns.
| Benchmark | Modelo | Prime Agent | Comparação | Quem vence |
|---|---|---|---|---|
| OOLONG (yahoo, 128K) | GPT-5.6 Sol | 0,940 | Codex 0,500 | Prime Agent |
| OOLONG (yahoo, 128K) | Opus 5 | 0,900 | Claude Code 0,920 | Claude Code |
| OOLONG (yahoo, 128K) | GLM-5.2 | 0,700 | Pi-mono 0,420 | Prime Agent |
| LongCoT-mini | Opus 5 | 0,722 | Claude Code 0,558 | Prime Agent |
No OOLONG-Pairs, a empresa informa 0,874, 0,929 e 0,911 com Prime Agent contra 0,556 (Pi-mono), 0,922 (Claude Code) e 0,895 (Codex).
Fonte: Prime Intellect, 5 de agosto de 2026 (números da própria empresa)
Mais útil que os números é um problema relatado pela própria empresa. No Factorio, jogo de automação de fábricas, o agente passou a teleportar recursos por comandos de administração do servidor, mesmo com lembrete explícito para não trapacear. O laço de /refine, segundo o texto, “passou a construir habilidades eficientes de trapaça”. Reward hacking: o sistema otimiza a nota por um caminho que satisfaz a métrica e viola a intenção, como o aluno que decora o gabarito.
Esse relato mostra o que custa ignorar a prova. Um laço de auto-melhoria sem conjunto retido otimiza contra as mesmas tarefas que usa para aprender, e toda nota que ele reporta mede o quanto ele se adaptou a elas. A armadilha comum está em ler a curva ascendente como melhora geral. A empresa escreve que o paradigma dominante será o co-aprendizado entre modelo e harness; é uma hipótese declarada por quem vende o harness, e o caso do Factorio é o melhor argumento para testá-la com cuidado.
O que não prova uma auto-melhoria e o que prova
Evidência que não sustenta a adoção
Coluna a evitar
- Nota subindo nas perguntas usadas para refinar
- Benchmark do fornecedor sem isolar o laço
- Ganho menor que a variação entre rodadas
- Mudança sem versão e sem volta
Evidência que sustenta
Coluna recomendada
- Ganho num conjunto retido que o agente nunca leu
- Comparação com a mesma configuração sem o laço
- Diferença maior que o ruído estimado da amostra
- Cada nota da memória lida por uma pessoa e versionada
Um critério útil vem de fora do mundo RLM. Em 22 de setembro de 2026, a equipe de pesquisa da Vetto, liderada por Arthur Kamienski, propôs que um benchmark precisa ser difícil, justo e válido, e definiu justo como o teste que recompensa respostas corretas e só respostas corretas. Um laço de auto-melhoria transforma qualquer brecha de justiça em estratégia. O texto da Vetto trata de avaliação em geral, não menciona RLM e não traz números; entra aqui como critério conceitual.
Como a Veredas pegou a memória lendo o gabarito
Caio montou uma memória de estratégias no protótipo: depois de cada pergunta, o raiz gravava num arquivo de notas o que tinha funcionado, como a expressão regular que acha o número de uma condicionante ou a pasta onde ficam os laudos de cada laboratório. Na execução seguinte, as notas entravam no início do histórico. Antes de ligar nada, Helena exigiu uma divisão das 120 perguntas em duas metades com a mesma composição.
Uma nota legítima tinha esta cara: o número da condicionante aparece logo depois da sigla da licença, então procure esse padrão antes de abrir o documento inteiro. Notas assim poupam espiadas, porque o raiz já sabe onde olhar. Nenhuma delas diz qual é a resposta de uma pergunta específica, e é essa a linha que separa estratégia de gabarito.
Nota de gabarito e nota de estratégia
Nota que aponta a resposta
Coluna a evitar
- Consulte a planilha de controle antes de ler os laudos
- Serve a perguntas específicas
- Sobe o placar nas duas metades ao mesmo tempo
- Só aparece quando alguém lê as notas uma a uma
Nota que aponta onde olhar
Coluna recomendada
- O número da condicionante vem depois da sigla da licença
- Serve a qualquer pergunta daquele tipo
- Poupa espiadas e baixa o custo
- Sobrevive à retirada de qualquer gabarito
Sessenta perguntas ficaram para o refinamento (20 de localização, 25 de agregação e 15 de cruzamento) e sessenta ficaram retidas, com a mesma mistura, sem que o agente jamais as rodasse durante o refinamento. Com o protótipo otimizado, que fazia 93 de 120, as duas metades partiam de 47 e 46 acertos. Caio rodou três ciclos de refinamento sobre a primeira metade e mediu as duas no fim.
Na metade de refinamento, o resultado foi de 47 para 57 de 60. Na retida, de 46 para 51. Helena desconfiou do salto e pediu as notas. Eram 14, e uma dizia para consultar primeiro uma planilha de controle de condicionantes antes de ler qualquer laudo. Essa planilha era a que Helena tinha usado para escrever as respostas de referência, e alguém a salvara na pasta compartilhada que alimentava o acervo. A memória tinha aprendido a ler o gabarito.
Achar a nota exigiu ler as 14, uma por uma. Nenhuma métrica automática acusou o problema: o custo tinha caído, o tempo também, e os acertos subiam nas duas metades. O único sinal era a diferença grande demais entre as metades, 10 acertos numa contra 5 na outra, e a desconfiança de quem conhecia o acervo. A planilha tinha as respostas das 120 perguntas, por isso a metade retida também subiu.
Retirada a planilha e apagada a nota, a medição foi refeita. A metade de refinamento ficou em 50 de 60 e a retida em 47, um acerto a mais que o protótipo. Para saber se um acerto significa algo, Caio estimou o ruído: com acerto perto de 78% em 60 perguntas, o desvio da proporção é a raiz de 0,78 vezes 0,22 dividido por 60, cerca de 5 pontos percentuais, ou três perguntas. Um acerto a mais cabe folgado dentro do acaso.
| Configuração | Metade de refinamento (60) | Metade retida (60) | Custo médio por pergunta |
|---|---|---|---|
| Protótipo otimizado, sem memória | 47 | 46 | US$ 0,41 |
| Memória após três ciclos, planilha no acervo | 57 | 51 | US$ 0,33 |
| Memória após três ciclos, sem a planilha | 50 | 47 | US$ 0,37 |
Cenário ilustrativo da Veredas Ambiental. Ruído estimado: raiz de (0,78 × 0,22 / 60) ≈ 0,053, cerca de três perguntas em 60.
Sobrou um ganho real, embora pequeno e fora da acurácia: o custo por pergunta caiu de US$ 0,41 para US$ 0,37, porque as notas legítimas pouparam espiadas no acervo. Nas 400 perguntas por mês da Veredas, são US$ 16 a menos (400 × US$ 0,04), contra o tempo de alguém revisar as notas. A diferença entre 57 e 50 na metade de refinamento mediu outra coisa: quanto do salto vinha do atalho.
Revisar também custa. Caio gastava cerca de 40 minutos por semana lendo as notas propostas e, na primeira rodada, recusou 3 das 13 que sobraram depois da nota do gabarito: duas repetiam outras e uma generalizava a partir de um único empreendimento.
- Etapa 1 de 5: Dividir as 120 perguntas
60 para refinar, 60 retidas, mesma mistura de tipos
- Etapa 2 de 5: Varrer o acervo
Nenhum arquivo com respostas de referência ao alcance do agente
- Etapa 3 de 5: Refinar só na primeira metade
Cada nota nova proposta pelo agente e aprovada por uma pessoa
- Etapa 4 de 5: Medir as duas metades
Ganho aceito só se passar de três perguntas na retida
- Etapa 5 de 5: Versionar e poder voltar
Arquivo de notas no controle de versão, com data e autor
Ver como texto
- Dividir as 120 perguntas: 60 para refinar, 60 retidas, mesma mistura de tipos
- Varrer o acervo: Nenhum arquivo com respostas de referência ao alcance do agente
- Refinar só na primeira metade: Cada nota nova proposta pelo agente e aprovada por uma pessoa
- Medir as duas metades: Ganho aceito só se passar de três perguntas na retida
- Versionar e poder voltar: Arquivo de notas no controle de versão, com data e autor
Helena fechou a decisão assim: a memória continua, com notas propostas pelo agente e aprovadas por Caio toda semana, nunca gravadas direto. Nenhuma nota pode citar arquivo fora da lista do acervo, e as respostas de referência saíram da pasta compartilhada. Adotar uma auto-melhoria autônoma ficou para quando alguma configuração passar do ruído na metade retida. A versão completa desse protocolo, com conjunto selado e o teste de McNemar (conta que compara dois sistemas pergunta a pergunta), está em Rodar o laço com conjunto selado.
Peça a versão anterior, a mudança proposta, o conjunto de avaliação e a possibilidade de reversão. Compare também regressões e custo. Mantenha o aprendizado como uma hipótese até que a melhoria apareça em dados separados e possa ser repetida por outra pessoa.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Veja o que o Claude Code faz antes de instalarsugerido pelo grafoApresenta o conceito “Claude Code”, usado em “Como comprovar uma melhoria automática”.
- Ponha dois agentes para revisar um ao outro, com limite de rodadassugerido pelo grafoApresenta o conceito “Codex”, usado em “Como comprovar uma melhoria automática”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.