RLM: grandes acervos · Capítulo 20 de 30 · 14 min
Como avaliar imagens, séries temporais e tarefas longas
Avalie hipóteses de RLMs híbridos e multimodais para imagens, séries temporais e tarefas prolongadas. Relacione cada combinação de busca, código e modelos à evidência disponível e ao teste necessário.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: Nem todo acervo é texto, e nem toda tarefa termina em uma conversa. Há pesquisas sobre séries temporais, encadeamento de sessões e combinação de busca com código. Essas frentes têm evidências diferentes. Na Veredas, é preciso separar uma imagem mal extraída de um problema que realmente exige uma nova arquitetura.
Planejar 2027 pela manchete leva a duas perdas. Uma é investir numa capacidade que ninguém mediu no seu tipo de documento. A outra é deixar passar uma combinação que já tem número publicado e resolveria um erro recorrente. Sem um mapa que separe o medido do anunciado, a decisão vira gosto pessoal.
Ao terminar, você sabe quais híbridos já têm resultado controlado, o que falta de evidência sobre RLM com imagem e sobre trabalho prolongado, e monta um mapa de oportunidades em que cada linha traz a evidência, a lacuna e o teste que a fecharia.
Ver como texto
Quanto cada frente para 2027 já foi medida
Três frentes com até três blocos de evidência cada. Híbridos têm os três blocos cheios, trabalho prolongado tem dois, e RLM com imagem não tem nenhum.
Por que os híbridos já vencem onde o RLM puro tropeça
A tabela principal do artigo de Zhang, Kraska e Khattab traz um resultado que costuma passar despercebido. Quando o contexto é descarregado num arquivo, agentes de código comuns mudam de patamar. Com o GPT-5, o OpenCode marcou 94,0 no BrowseComp+ com mil documentos, acima dos 91,3 do RLM de profundidade 1. No OOLONG-Pairs, o mesmo OpenCode ficou em 4,8, contra 58,0 do RLM. O Claude Code com Opus 4.1 e contexto em arquivo fez 84,0 e 6,5 nos mesmos testes.
| Método | Modelo | BrowseComp+ (1K) | OOLONG | OOLONG-Pairs (F1) |
|---|---|---|---|---|
| OpenCode, contexto em arquivo | GPT-5 | 94,0 | 52,0 | 4,8 |
| Claude Code, contexto em arquivo | Claude Opus 4.1 | 84,0 | 48,0 | 6,5 |
| Agente de compactação | GPT-5 | 70,5 | 46,0 | 0,1 |
| RLM, profundidade 1 | GPT-5 com GPT-5-mini | 91,3 | 56,0 | 58,0 |
| RLM, profundidade 3 | GPT-5 com GPT-5-mini | 92,0 | 58,0 | 76,0 |
Acurácia em %, exceto OOLONG-Pairs. O custo do OpenCode não foi medido no artigo.
Fonte: Zhang, Kraska e Khattab, Recursive Language Models, arXiv 2512.24601 v3, Tabela 1 (maio de 2026)
Quem vence depende da tarefa. Achar um documento num corpus de milhões de tokens é trabalho de busca, e o agente de código com o corpus em arquivo faz isso bem. Cruzar pares de itens em todo o contexto exige laço programático com subchamadas, e só o RLM chega lá. A armadilha comum é escolher o harness por um número único: o OpenCode vence o BrowseComp+ e desaba no OOLONG-Pairs, sem que nenhum dos dois números esteja errado.
Compactação é o resumo automático do histórico quando ele passa de um limite, como a ata que substitui a gravação da reunião. Na mesma tabela, o agente de compactação com GPT-5 marcou 0,1 no OOLONG-Pairs, contra 58,0 do RLM, e 70,5 no BrowseComp+, contra 91,3. Resumir perde justamente os pares que a pergunta cruzada precisa. A compactação vendida como serviço resolve o limite da janela e continua sujeita a essa perda.
Os fornecedores de harness caminham na mesma direção. A Anthropic descreveu em 2 de junho de 2026 os dynamic workflows do Claude Code. São um arquivo JavaScript que cria e coordena subagentes, escolhe modelo e cópia de trabalho para cada um e retoma após interrupção, com padrões como distribuir e sintetizar, verificação adversarial e torneio. O Claude Code não tem modo “RLM” oficial; subagentes e workflows são parentes do conceito, não a mesma coisa.
Em maio de 2026, a LangChain lançou os recursive workflows no Deep Agents 0.6 e, em julho, publicou como usar RLMs ali, admitindo que o que entrega fica mais perto de agentes recursivos do que do RLM do artigo. A compactação virou serviço de plataforma na Anthropic e na OpenAI; a da OpenAI devolve um item criptografado e opaco, que a aplicação não consegue ler. E o DSPy depreciou em agosto os módulos CodeAct e ProgramOfThought em favor do dspy.RLM, com remoção prevista para a versão 3.5.
Sinais de convergência entre RLM e harnesses em 2026
- maio de 2026Concluído
Deep Agents 0.6
Recursive workflows na LangChain.
- junho de 2026Concluído
Dynamic workflows no Claude Code
Subagentes coordenados por arquivo JavaScript, com retomada.
- agosto de 2026Concluído
Prime Agent e depreciação no DSPy
Agente RLM com kernel único; CodeAct e ProgramOfThought depreciados.
- setembro de 2026Agora
Compactação sob demanda da Anthropic
Cabeçalho beta de 4 de setembro.
- sem data anunciadaPrevisto
DSPy 3.5 e relatório do Prime Agent
Remoção dos módulos antigos; relatório técnico prometido “em breve”.
Um cenário condicional decorre daí. Se os harnesses de código continuarem incorporando REPL persistente e subchamadas em laço, o RLM tende a aparecer em 2027 como um modo de execução dentro deles, e menos como produto separado. O sinal que confirmaria o cenário é um fornecedor de harness documentar a variável de contexto fora da janela e a subchamada programática como recurso oficial. Até setembro de 2026, nenhum documentou.
Imagem e trabalho de meses, com a evidência que existe e a que falta
Sobre imagem, a lacuna é completa. Os benchmarks do artigo original, da reprodução, do λ-RLM e do estudo de envenenamento são de texto e código. Os resultados no ARC-AGI, do Prime Agent e do agente em REPL da Symbolica, envolvem quebra-cabeças e jogos em grades de cores, sem foto nem página escaneada. Até setembro de 2026, nenhum trabalho publicado mediu um RLM lendo laudo escaneado, mapa ou fotografia.
Já existe mecanismo para tentar. A biblioteca rlms aceita ferramentas próprias nas subchamadas, e a Prime Intellect propôs em janeiro de 2026 que ferramentas extras fiquem só com os sub-LLMs, para não inchar o contexto do raiz. Um modelo com visão plugado como ferramenta de subchamada receberia uma página por vez e devolveria texto ao REPL. É desenho plausível, sem medição que o sustente, e entra no mapa como hipótese a testar.
- Etapa 1 de 4: Raiz marca a página escaneada
Pelo índice do acervo, sem abrir a imagem
- Etapa 2 de 4: Subchamada chama o modelo com visão
Uma página por vez, com a pergunta da extração
- Etapa 3 de 4: Texto volta ao REPL
Tabela transcrita, com página e documento
- Etapa 4 de 4: Raiz agrega como qualquer leitura
O contexto do raiz não recebe a imagem
Ver como texto
- Raiz marca a página escaneada: Pelo índice do acervo, sem abrir a imagem
- Subchamada chama o modelo com visão: Uma página por vez, com a pergunta da extração
- Texto volta ao REPL: Tabela transcrita, com página e documento
- Raiz agrega como qualquer leitura: O contexto do raiz não recebe a imagem
Para fechar essa lacuna, o experimento teria o formato de sempre: mesmo acervo, mesmas perguntas, com e sem a ferramenta de visão, e medição separada das perguntas que dependem de página escaneada. Sem essa separação, o ganho em poucas perguntas some na média das outras, ou a piora nelas fica escondida.
Trabalho prolongado tem mais evidência, quase toda de parentes do RLM. O Context-Folding, da ByteDance Seed com CMU e Stanford, treinou por reforço um agente que abre subtrajetórias e as dobra num resumo. Com 32 mil tokens de contexto ativo, o Seed-OSS-36B marcou 62,0% no BrowseComp-Plus e 58,0% no SWE-Bench Verified; o mesmo modelo como agente comum, com 327 mil tokens, fez 47,8% e 55,2%. O GPT-5 como agente comum, com os mesmos 327 mil, fez 79,3% e 71,8%.
| Configuração | Contexto ativo | BrowseComp-Plus | SWE-Bench Verified |
|---|---|---|---|
| Seed-OSS-36B com FoldGRPO | 32K | 62,0% | 58,0% |
| Seed-OSS-36B como agente ReAct | 327K | 47,8% | 55,2% |
| GPT-5 como agente ReAct | 327K | 79,3% | 71,8% |
Dobrar supera o mesmo modelo com contexto inteiro; não alcança um modelo de fronteira com contexto inteiro.
Fonte: Sun et al., Scaling Long-Horizon LLM Agent via Context-Folding, arXiv 2510.11967 (outubro de 2025)
Para trabalho que dura dias, faltam duas medições. A primeira é latência: o blog original descreve chamadas bloqueantes, sem cache de prefixo, e a Prime Intellect registrou que o RLM aumenta de forma significativa o tempo de execução em todos os ambientes que testou. O Prime Agent responde com subagentes assíncronos, cuja chamada devolve um identificador na hora, e com tetos de turnos, tokens e tempo no modo autônomo. A segunda é acúmulo de erro ao longo de semanas, e essa ninguém publicou.
Quem paga a conta precisa saber que trabalho prolongado herda a cauda do RLM. O artigo original mostra custo com desvio-padrão muitas vezes maior que a média, como os US$ 1,10 ± 3,25 do RLM de profundidade 2 no OOLONG. Num agente que roda por semanas, a cauda deixa de ser exceção: em milhares de execuções, algumas vão cair nela. Os tetos de turno, token e tempo passam a fazer parte do contrato de operação.
Os subagentes assíncronos do Prime Agent atacam o problema certo e continuam sem medição independente de latência. Até setembro de 2026, os tempos publicados sobre RLM são os da reprodução, com o DeepSeek v3.2 indo de 3,6 segundos na base a 344,5 segundos na profundidade 2, e os do λ-RLM. Nenhum deles mede um agente rodando por dias.
Uma medida pública para tarefas longas é outra: o horizonte de tempo do METR, a duração, para um especialista humano, das tarefas que o modelo completa com 50% de sucesso. Em setembro de 2026, o maior valor da página era de 17 h. O próprio METR avisa que medições acima de 16 h não são confiáveis com a suíte atual e que o número mede a dificuldade da tarefa, não o tempo de autonomia.
Estado, checkpoint e retomada para um agente que roda dia e noite estão em Montar o harness de longa duração.
Horizonte de tempo do METR, com a condição de cada número
cerca de 50 min
Claude 3.7 Sonnet, em 2025
Tarefa humana completada com 50% de sucesso
cerca de 7 meses
tempo para o horizonte dobrar
Tendência desde 2019, talvez mais rápida em 2024
17 h
Claude Mythos Preview (versão inicial)
Maior valor da página, acrescentado em maio de 2026
acima de 16 h
medição não confiável
Aviso do próprio METR sobre a suíte de tarefas atual
Fonte: METR, arXiv 2503.14499 (v4, julho de 2026) e página Task-Completion Time Horizons (última atualização em 8 de setembro de 2026)
Como a Veredas montou o mapa de oportunidades
Helena pediu a Caio uma lista das apostas para 2027 que não dependesse de manchete. Ele começou pelos erros. O protótipo otimizado acertava 93 de 120, então errava 27. Caio leu o rastro de cada um e os classificou pela causa. Nove vinham de laudos escaneados em que o reconhecimento de texto perdeu as colunas das tabelas; sete, de prazos prorrogados que o modelo leu como vencidos. Outros seis eram documentos que não estavam no acervo, e cinco eram erros de soma na agregação.
| Causa | Erros | Frente de 2027 que poderia resolver |
|---|---|---|
| Laudo escaneado com tabela perdida no reconhecimento de texto | 9 | Subchamada com leitura de imagem |
| Prazo prorrogado lido como vencido | 7 | Nenhuma técnica nova; regra de negócio no pipeline |
| Documento ausente do acervo | 6 | Nenhuma técnica; processo de coleta |
| Erro de soma na agregação | 5 | Pipeline de combinadores, já adotado |
Cenário ilustrativo da Veredas Ambiental. 120 perguntas menos 93 acertos resultam em 27 erros; 9 + 7 + 6 + 5 = 27.
A classificação mudou a conversa. Treze dos 27 erros, os 7 de prazo e os 6 de documento ausente, não se resolvem com técnica nova de RLM, e sim com regra de negócio e coleta. Dos 14 restantes, 5 já estavam cobertos pelo pipeline de combinadores. Sobraram 9 para a única frente em que a lacuna de evidência é total, a leitura de imagem, e isso deu ao teste um tamanho definido.
Caio acrescentou duas frentes que não vinham dos erros e sim do negócio. O acervo cresce cerca de 460 documentos por ano, 6.400 divididos por 14, perto de 38 por mês, e Helena queria um agente que acompanhasse as condicionantes continuamente em vez de responder perguntas soltas. A outra frente era o modelo pequeno treinado, parado no gatilho de 1.000 trajetórias aprovadas.
| Oportunidade | Evidência publicada | Lacuna | Teste da Veredas | Critério de adoção |
|---|---|---|---|---|
| Híbrido: busca escolhe o empreendimento, RLM lê | Tabela 1 do artigo: vencedor muda com a tarefa | Nenhum estudo com acervo de licenciamento | Rodar as 120 perguntas no projeto final | Passar de 93 acertos sem subir de US$ 0,41 por pergunta |
| Subchamada com leitura de imagem | Nenhuma medição de RLM com imagem | Total | Reprocessar as 9 perguntas com laudo escaneado | Acertar ao menos 5 das 9 sem perder nenhuma das outras 111 |
| Acompanhamento contínuo das condicionantes | Context-Folding; tetos do modo autônomo do Prime Agent | Acúmulo de erro ao longo de meses | Reprocessar 2025 mês a mês e comparar com a auditoria de Helena | Nenhuma condicionante vencida perdida em 12 meses |
| Pipeline de combinadores | λ-RLM: 29 de 36 em modelos abertos | Modelos de fronteira fechados | Já em uso na agregação | Teto de custo mantido a cada documento novo |
| Modelo pequeno treinado | RLM-Qwen3-8B: mediana de +28,3% sobre si mesmo | Escala e dados próprios | Nenhum antes do gatilho | 1.000 trajetórias aprovadas fora do conjunto de avaliação |
Cenário ilustrativo da Veredas Ambiental. Evidências com a condição descrita ao longo desta trilha.
O híbrido ocupa a primeira linha porque a divisão de trabalho já aparecia nos números. O RAG antigo acertava 36 de 40 em localização e errava contagens; o RLM lia bem e gastava para achar. Deixar a busca escolher o empreendimento e o RLM ler só o que foi escolhido junta as duas forças, e o projeto final vai medir se a soma passa dos 93 acertos.
Mais caro de todos, o teste de acompanhamento contínuo ficou desenhado e sem data. Caio reprocessaria 2025 mês a mês, cerca de 38 documentos novos por vez, com o agente guardando o estado de cada empreendimento entre um mês e outro. Ao fim dos 12 meses, a lista de condicionantes vencidas seria comparada com a auditoria que Helena fez no fim daquele ano. É o único jeito de medir o acúmulo de erro que nenhum trabalho publicado mediu.
As cinco frentes por evidência publicada e valor para a Veredas
Eixo horizontal: Evidência publicada, de fraca a forteEixo vertical: Valor para a Veredas, de baixo a alto
Testar com amostra pequena: valor alto, evidência fraca
- Subchamada com leitura de imagem (9 perguntas)
- Acompanhamento contínuo das condicionantes
Adotar ou testar já: valor alto, evidência forte
- Pipeline de combinadores na agregação
- Híbrido de busca e RLM no projeto final
Esperar sinal externo: valor baixo, evidência fraca
- Nenhuma das cinco frentes; aqui cairia anúncio sem número publicado
Acompanhar sem pressa: valor baixo hoje, evidência média
- Modelo pequeno treinado, até o gatilho de 1.000 trajetórias
Rodou primeiro o teste de imagem, por ser o menor. Caio plugou um modelo com visão como ferramenta da subchamada, só para páginas marcadas como escaneadas, e reprocessou as 9 perguntas. Acertou 6, acima do critério de 5, e nenhuma das outras 111 mudou de resposta, porque a ferramenta nunca foi chamada nelas. O custo dessas 9 perguntas subiu de US$ 0,41 para US$ 0,68 em média, e a decisão ficou para quando houver mais páginas escaneadas no acervo de teste.
Em escala, a conta é pequena. Se 7,5% das perguntas reais dependerem de página escaneada, a mesma proporção das 9 em 120 do conjunto de Helena, mil perguntas por mês teriam 75 delas; a US$ 0,27 a mais cada, a ferramenta acrescentaria cerca de US$ 20 por mês.
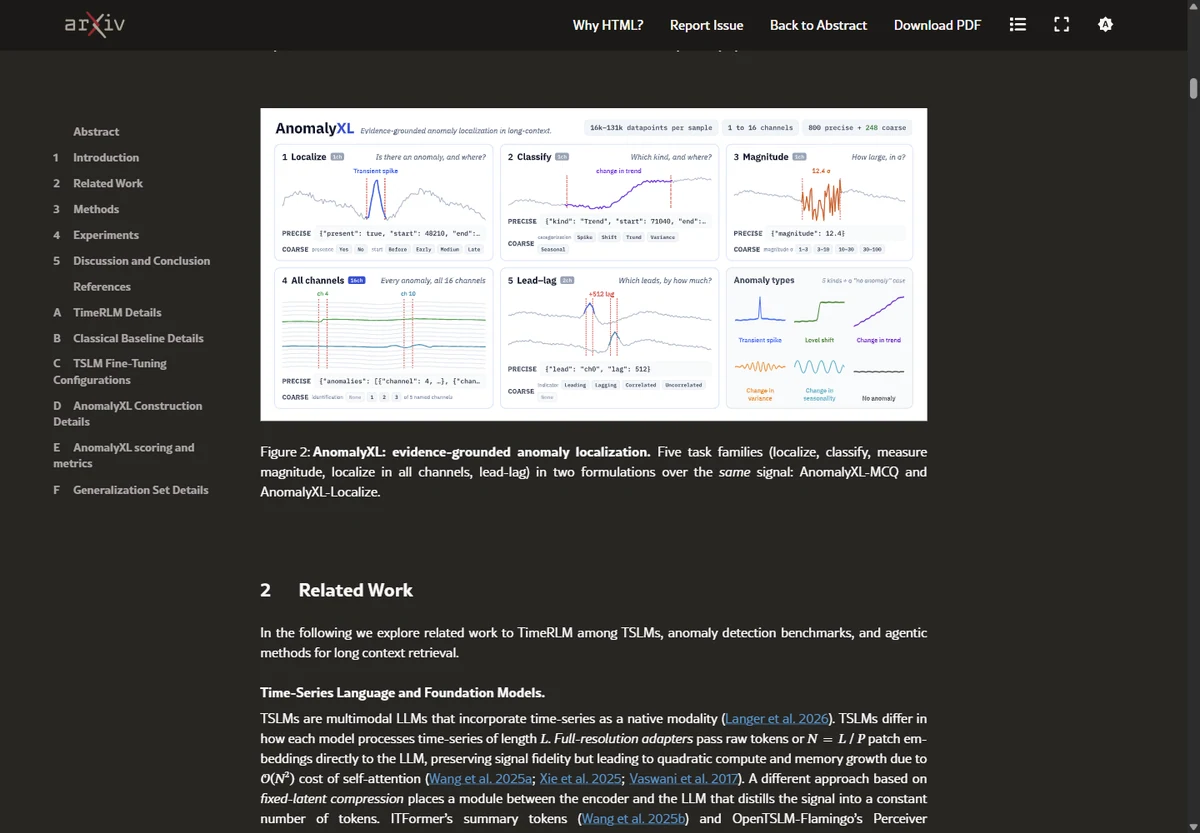
O [TimeRLM, revisado em 6 de setembro de 2026](https://arxiv.org/html/2608.03391v2), investiga séries temporais. Seu conjunto AnomalyXL usa anomalias sintéticas: isso ajuda a controlar o teste, mas não demonstra desempenho equivalente em toda anomalia operacional. O [Chained RLM, de 5 de agosto](https://arxiv.org/html/2608.05124v1), estuda a continuidade entre sessões por resumos e artefatos. Persistir informação pode prolongar o trabalho, mas também transportar erros e acrescentar custo.
Para cada hipótese, registre evidência, limitação e teste necessário. Verifique primeiro se o erro vem da preparação do material. Só invista em uma nova abordagem quando ela enfrentar uma lacuna relevante e puder ser comparada com uma alternativa simples.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Veja o que o Claude Code faz antes de instalarsugerido pelo grafoApresenta o conceito “Claude Code”, usado em “Como avaliar imagens, séries temporais e tarefas longas”.
- Construir as cenas do orquestrador, do paralelismo e do robôsugerido pelo grafoApresenta o conceito “React”, usado em “Como avaliar imagens, séries temporais e tarefas longas”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Avaliar e melhorar agentesEntender o aprendizado em tarefas com várias etapasExaminar conexões de Entender o aprendizado em tarefas com várias etapas
- Frontends com VibecodingConstruir as cenas do orquestrador, do paralelismo e do robôExaminar conexões de Construir as cenas do orquestrador, do paralelismo e do robô
- Prompt Engineering para ExecutivosAs palavras que mudam a conta de IA e o que mudou desde 2024Examinar conexões de As palavras que mudam a conta de IA e o que mudou desde 2024
- Agentes de IA autônomos: como delegar e acompanharComo o agente age, confere e decide quando pararExaminar conexões de Como o agente age, confere e decide quando parar
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.