RLM 2027 · Capítulo 11 de 30 · 16 min
Preparar o acervo e rodar a biblioteca oficial rlm
Documento sem texto vira resposta errada sem aviso; preparar o acervo com cabeçalhos e escolher o ambiente certo evita isso antes da primeira execução.
Este capítulo faz parte do curso gratuito RLM 2027.
Com o protocolo assinado por Helena, Caio precisava de algo que rodasse sobre o acervo de verdade. O acervo, porém, não era texto: eram PDFs, planilhas de laboratório e atas digitalizadas, parte delas escaneada nos primeiros anos. O RLM lê o que estiver na variável que recebe, e mais nada.
Pular a preparação produz o pior tipo de erro, o silencioso. Um laudo escaneado sem camada de texto vira uma string vazia, o modelo raiz conta zero laudos naquele poço e responde com segurança que a condicionante está vencida. A resposta sai bem escrita, com documento citado, e errada.
Ao terminar, você sabe transformar um acervo heterogêneo no formato que a biblioteca oficial espera, escolhe entre os sete ambientes de execução que ela oferece e lê o resultado de uma execução com tokens, tempo e custo na mão.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Por que a preparação do acervo decide metade do resultado
No RLM, o prompt do usuário vai para uma variável chamada context dentro do REPL, e o modelo raiz começa sem ver o conteúdo. Recebe só metadados: o tipo da variável, o total de caracteres e o tamanho de cada pedaço. Tudo o que ele sabe sobre o acervo, descobre escrevendo código. Por isso o formato do acervo guia a exploração tanto quanto o prompt guia uma resposta comum.
Alex Zhang, no blog de outubro de 2025, descreve os primeiros movimentos que o modelo raiz costuma fazer: espiar o começo do texto e filtrar linhas com palavra-chave ou expressão regular. Expressão regular: um padrão de busca escrito em código, como pedir “toda linha que tenha LO seguido de número”. Os dois movimentos só funcionam se o acervo tiver marcas estáveis para espiar e filtrar.
Caio deu a cada documento um cabeçalho de uma linha, sempre no mesmo formato, com identificador, empreendimento, tipo, data e origem do texto. Com isso, uma única expressão regular separa os laudos de um empreendimento em milissegundos, sem gastar nenhuma subchamada. O cabeçalho custa cerca de 120 caracteres por documento, perto de 768 mil no acervo inteiro (6.400 vezes 120), uma fração desprezível do total.
O cabeçalho de cada documento e o que ele permite ao modelo raiz
| Campo | Exemplo | O que o modelo raiz consegue fazer com ele |
|---|---|---|
| id | VRD-2019-0412 | Citar a evidência de modo que Helena ache o original |
| empreendimento | Serra Azul | Recortar o acervo antes de qualquer subchamada |
| tipo | laudo_agua | Separar condicionante, laudo, parecer e ata |
| data | 2019-03-14 | Comparar prazo de condicionante com data de laudo em Python |
| ocr | sim, não ou falhou | Desconfiar de contagem zero em documento sem texto legível |
Fonte: Veredas Ambiental, cenário composto deste curso
Tamanho pede outra conta, e ela define a arquitetura. Na aproximação de 4 caracteres por token, que Caio conferiu numa amostra do acervo, os 52 milhões de tokens viram cerca de 208 milhões de caracteres. A função llm_query aceita cerca de 500 mil caracteres por chamada, segundo o prompt da própria biblioteca. Ler o acervo inteiro numa pergunta exigiria umas 416 subchamadas (208 milhões divididos por 500 mil).
Em dinheiro, a mesma leitura completa custaria cerca de US$ 13 só de entrada no GPT-5-mini (52 milhões de tokens a US$ 0,25 por milhão), antes de qualquer saída. Esse número fixa a regra de ouro do laboratório: o modelo raiz precisa recortar com código antes de delegar leitura, e o cabeçalho existe para tornar esse recorte barato.
Aqui aparece a armadilha comum de quem monta o primeiro protótipo: descartar em silêncio o documento que não tem texto. Na Veredas, 1.150 dos 6.400 documentos eram PDFs escaneados sem camada de texto, quase 18% do acervo (1.150 divididos por 6.400), a maioria laudos de laboratório anteriores a 2016. Caio rodou OCR, o reconhecimento de caracteres que transforma imagem de página em texto, e recuperou 1.112. Os 38 restantes entraram com um aviso no lugar do conteúdo.
O acervo da Veredas antes da primeira execução
6.400
documentos de 38 empreendimentos
14 anos de processos, cerca de 52 milhões de tokens
1.150
escaneados sem texto
OCR recuperou 1.112; 38 entraram com aviso de texto ilegível
~208 mi
caracteres no total
52 milhões de tokens vezes 4 caracteres, aproximação conferida em amostra
~416
subchamadas para ler tudo
208 milhões divididos por 500 mil caracteres por llm_query
Fonte: Veredas Ambiental, cenário composto; capacidade de llm_query segundo o prompt do pacote rlms 0.1.3
# Preparar o acervo da Veredas: um texto por documento, com cabeçalho estável
import json
from pathlib import Path

PASTA = Path("acervo_texto")  # saída da extração de PDF e planilha, um .txt por documento
indice = json.loads(Path("indice_documentos.json").read_text(encoding="utf-8"))

acervo = {}
sem_texto = []
for doc in indice:  # 6.400 registros com id, empreendimento, tipo, data e ocr
    texto = (PASTA / f"{doc['id']}.txt").read_text(encoding="utf-8").strip()
    if len(texto) < 200:
        # nunca descartar calado: o modelo raiz precisa saber que o documento existe
        texto = "[SEM TEXTO LEGÍVEL: consultar o original]"
        sem_texto.append(doc["id"])
    cabecalho = (
        f"[DOC {doc['id']}] empreendimento={doc['empreendimento']} "
        f"tipo={doc['tipo']} data={doc['data']} ocr={doc['ocr']}"
    )
    acervo[doc["id"]] = cabecalho + "\n" + texto

print(len(acervo), "documentos;", len(sem_texto), "sem texto legível")
print(sum(len(t) for t in acervo.values()), "caracteres no total")
Um dicionário é aceito como prompt pela biblioteca. Quando o prompt é texto puro, ela grava um arquivo .txt e o lê para a variável; quando é dicionário ou lista, grava em JSON e carrega a estrutura. Caio preferiu o dicionário porque a chave é o próprio identificador do documento, e citar evidência vira ler a chave.
A alternativa seria juntar os 6.400 documentos numa única string e deixar o modelo raiz separá-los pelo cabeçalho. Funciona, mas obriga o modelo a escrever e acertar essa separação a cada pergunta, e um erro de expressão regular ali contamina tudo o que vem depois. Com o dicionário, o recorte por empreendimento é uma compreensão de lista de uma linha, e o custo fica na preparação, feita uma vez só.
Como entregar 6.400 documentos à biblioteca
Uma string única
Evitar
- O modelo separa os documentos pelo cabeçalho a cada pergunta
- Um erro de expressão regular contamina tudo o que vem depois
- O custo da separação se repete em toda execução
Dicionário com o id como chave
Escolha de Caio
- O recorte por empreendimento cabe numa linha de código
- Citar evidência é ler a chave do documento
- O custo fica na preparação, paga uma vez só
Como Caio rodou a biblioteca oficial sobre o acervo da Veredas
A biblioteca do artigo fica no repositório alexzhang13/rlm, mantido pelo laboratório MIT OASYS, com licença MIT e 5.641 estrelas em 23 de setembro de 2026. O pacote no PyPI se chama rlms, pede Python 3.11 ou superior e está na versão 0.1.3, de 26 de junho de 2026. O GitHub ainda exibe uma tag v1.0.0 de janeiro, anterior às versões 0.x; a numeração do PyPI é a que vale para instalar.
Clientes de modelo cobrem OpenAI, Anthropic, OpenRouter e Portkey, e modelos locais entram pelo vLLM através do cliente da OpenAI. A escolha que mais pesa, porém, é o ambiente: onde o código escrito pelo modelo vai rodar. O README separa três ambientes não isolados de quatro isolados, que rodam em sandbox na nuvem, e avisa que o ambiente local não deve ser usado em produção.
Os sete ambientes da biblioteca rlms e quando cada um cabe
| Ambiente | Onde o código roda | Classificação no README | Uso na Veredas |
|---|---|---|---|
| local (padrão) | exec no mesmo processo Python | Não isolado; fora de produção | Só com documentos públicos de teste |
| ipython | Kernel IPython na máquina | Não isolado | Não usado |
| docker | Contêiner na máquina, imagem Python 3.11 | Não isolado | Desenvolvimento com cópia do acervo |
| modal | Sandbox da Modal na nuvem | Isolado | Candidato para produção |
| prime | Sandbox da Prime Intellect | Isolado, em beta e com lentidão reconhecida | Não usado |
| daytona | Sandbox da Daytona | Isolado | Candidato para produção |
| e2b | Máquina virtual Linux sob demanda | Isolado | Candidato para produção |
A escolha para produção depende da análise de isolamento e de dados do cliente, tratada na trilha de confiabilidade e segurança.
Fonte: Repositório alexzhang13/rlm, README consultado em setembro de 2026
Caio escolheu o Docker para o desenvolvimento. O contêiner roda na máquina dele, com uma cópia do acervo que nunca sai da rede da Veredas, e o código gerado não toca o sistema de arquivos do computador. O README coloca o Docker entre os não isolados, e Caio registrou essa ressalva no protocolo: nenhum documento de cliente iria para um ambiente de nuvem antes da revisão de segurança.
O ambiente local ficou restrito a documentos públicos de teste por um motivo concreto. Ele executa o código gerado com exec dentro do próprio processo, e o README avisa do risco quando prompts ou chamadas de ferramenta podem ser tocados por usuários mal-intencionados. No acervo da Veredas, boa parte do texto veio de terceiros: laboratórios, órgãos ambientais, empreiteiras. Qualquer um deles poderia ter escrito num PDF uma frase que o modelo leria como instrução.
Onde o código gerado roda, antes e depois da decisão de Caio
Ambiente local com acervo de cliente
Coluna a evitar
- Código gerado roda com exec no processo de Caio
- Arquivos, credenciais e rede da máquina ao alcance
- Documento de terceiro pode carregar instrução escondida
- README desaconselha o uso em produção
Docker agora, sandbox isolado depois
Coluna recomendada
- Contêiner com imagem Python 3.11 e cópia do acervo
- Local só com documentos públicos de teste
- Modal, Daytona ou E2B avaliados antes da produção
- Revisão de segurança antes de qualquer dado de cliente na nuvem
# Rodar a biblioteca oficial (pip install rlms; versão 0.1.3, Python 3.11 ou superior)
from rlm import RLM
from rlm.logger import RLMLogger

logger = RLMLogger(log_dir="./logs")  # um arquivo JSONL por execução

rlm = RLM(
    backend="openai",
    backend_kwargs={"model_name": "gpt-5"},               # modelo raiz
    other_backends=["openai"],
    other_backend_kwargs=[{"model_name": "gpt-5-mini"}],  # subchamadas de profundidade 1
    environment="docker",
    environment_kwargs={"image": "python:3.11-slim"},
    max_depth=1,        # subchamadas são modelos comuns, como no artigo
    max_iterations=30,  # padrão da biblioteca
    max_timeout=1200,   # 20 minutos, o limiar do protocolo
    logger=logger,
)

pergunta = (
    "Quais condicionantes de monitoramento hídrico do empreendimento Serra Azul "
    "estão vencidas? Vencida: prazo passou sem laudo protocolado. "
    "Cite o id de cada documento usado."
)
resultado = rlm.completion(prompt=acervo, root_prompt=pergunta)

print(resultado.response)                 # o que o modelo gravou em answer["content"]
print(round(resultado.execution_time), "segundos")
print(resultado.usage_summary.to_dict())  # chamadas e tokens por modelo
Três parâmetros merecem leitura. O max_depth=1 reproduz o padrão do artigo: o modelo raiz chama modelos comuns, sem REPL próprio; com esse valor, rlm_query recai em llm_query. O other_backends manda as subchamadas para o GPT-5-mini, e o root_prompt deixa o modelo raiz ver a pergunta sem ver o acervo. O max_timeout interrompe a execução e devolve a melhor resposta parcial disponível.
Dentro do REPL, o modelo raiz encontra a variável context, as funções llm_query e llm_query_batched, as recursivas rlm_query e rlm_query_batched, a função SHOW_VARS, que lista as variáveis criadas, e o dicionário answer. O prompt da biblioteca avisa que saídas acima de cerca de 20 mil caracteres são truncadas. Por isso o modelo imprime amostras e contagens, e manda o texto longo para as subchamadas.
Existe também um max_budget, em dólares, mas a documentação do código avisa que ele exige um cliente que informe custo, como o OpenRouter. Com o cliente da OpenAI, Caio calculou o custo por conta própria, multiplicando os tokens do usage_summary pelo preço congelado no protocolo.
Dois recursos ficaram desligados no primeiro teste. O parâmetro persistent reaproveita o ambiente entre chamadas, útil para conversa com várias perguntas encadeadas, e compaction resume o histórico do modelo raiz quando ele chega a 85% da janela. Caio preferiu medir primeiro a execução mais simples, uma pergunta por ambiente novo, para ter uma linha de base limpa antes de ligar qualquer otimização. O paralelismo das subchamadas recursivas segue o padrão de max_concurrent_subcalls, quatro linhas de execução.
Parâmetros do construtor RLM no primeiro teste da Veredas
| Parâmetro | O que faz | Valor no teste |
|---|---|---|
| max_depth | Níveis de recursão; com 1, rlm_query recai em llm_query | 1, como no artigo |
| other_backends | Modelo das subchamadas | GPT-5-mini |
| max_timeout | Interrompe e devolve a melhor resposta parcial | Ligado |
| max_budget | Teto em dólares; exige cliente que informe custo | Sem efeito com o cliente da OpenAI |
| persistent | Reaproveita o ambiente entre chamadas | Desligado |
| compaction | Resume o histórico do raiz a 85% da janela | Desligado |
| max_concurrent_subcalls | Paralelismo das subchamadas recursivas | Padrão, quatro linhas |
Fonte: Código e README do pacote rlms 0.1.3 (junho de 2026).
Encerrar a execução mudou de nome entre o artigo e a biblioteca. O artigo descreve FINAL(resposta) e FINAL_VAR(variável). Na versão 0.1.3 do pacote, o prompt de sistema entrega ao modelo um dicionário answer: ele grava a resposta em answer["content"] e marca answer["ready"] como verdadeiro, e a execução termina ali. Quem escreve um prompt de sistema próprio copiando o artigo, com FINAL, arrisca uma execução que a biblioteca não reconhece como encerrada e que gasta as 30 iterações.
- Etapa 1 de 6: 1. Espiar
Imprime 5 chaves e os primeiros 2.000 caracteres de um documento
- Etapa 2 de 6: 2 e 3. Filtrar
Regex no cabeçalho: 212 documentos de Serra Azul, 57 sobre água
- Etapa 3 de 6: 4 a 6. Delegar
llm_query_batched em 14 lotes de cerca de 4 documentos cada
- Etapa 4 de 6: 7. Comparar
Python cruza prazo de condicionante com data de laudo
- Etapa 5 de 6: 8. Conferir
Imprime a lista candidata com os ids de documento
- Etapa 6 de 6: 9. Entregar
Grava answer["content"] e marca answer["ready"]
O primeiro teste foi uma pergunta de agregação sobre um empreendimento só. O modelo raiz seguiu os padrões que o blog descreve. Espiou, filtrou os 212 documentos de Serra Azul pelo cabeçalho e estreitou para 57 com termos como poço, piezômetro e qualidade da água. Só então delegou leitura, em 14 subchamadas agrupadas. As datas foram comparadas em Python, sem modelo nenhum, e a resposta listou três condicionantes vencidas com cinco documentos citados.
Custo e tempo saíram do usage_summary e do execution_time. O modelo raiz fez 9 turnos com cerca de 12 mil tokens de entrada cada, 108 mil no total, e 1.500 de saída por turno. As 14 subchamadas leram cerca de 45 mil tokens cada e escreveram mil. A conta, com os preços do protocolo, fecha em US$ 0,46 por essa pergunta, em 2 minutos e 50 segundos.
O usage_summary separa as contas por modelo, e essa separação foi a primeira surpresa de Caio. Ele esperava que a leitura dos documentos, feita pelo GPT-5-mini, dominasse o custo. Nessa pergunta, o modelo raiz custou US$ 0,27 e as subchamadas US$ 0,19: o modelo caro, lendo pouco, pesou mais que o barato lendo muito. A conta só aparece quando o custo sai separado por modelo.
Uma execução de agregação no cenário da Veredas
9
iterações do modelo raiz
Do espiar ao answer["ready"]; teto configurado em 30
14
subchamadas ao GPT-5-mini
Agrupadas com llm_query_batched sobre 57 documentos
2 min 50 s
tempo total
Abaixo do limiar de 20 minutos do protocolo
US$ 0,46
custo da pergunta
Raiz: 0,135 de entrada e 0,135 de saída; subchamadas: 0,158 e 0,028
Fonte: Veredas Ambiental, cenário composto; preços do GPT-5 e do GPT-5-mini conferidos em 23 de setembro de 2026
Helena abriu os cinco documentos citados e confirmou as três condicionantes. Mais útil que o acerto foi o arquivo de log: pela primeira vez ela via o caminho da resposta, com cada filtro e cada lote. O mesmo arquivo mostrou que 2 dos 57 documentos filtrados tinham o aviso de texto ilegível e que o modelo raiz os listou à parte, em vez de contá-los como laudo ausente.
A pergunta sobre Serra Azul também mostrou o limite do teste. Um empreendimento só, com 212 documentos, fica longe do caso difícil do protocolo, que cruza laudos de empreendimentos diferentes ao longo de 14 anos. Uma execução boa diz que a montagem funciona; ela não diz nada ainda sobre as 120 perguntas, e Caio escreveu isso no relatório do dia para ninguém confundir teste de fumaça com resultado.
Guia prático para marketing: auditoria de SEO e GEO de um site inteiro. O mesmo preparo de acervo vale para um site com milhares de URLs. Cada página vira um bloco de texto com cabeçalho, o RLM lê o conjunto e responde perguntas que exigem olhar o site todo, como quais páginas não respondem nada no primeiro parágrafo ou quais repetem o mesmo tema com títulos diferentes.
Auditar um site inteiro para SEO e GEO com rlms e o visualizador de trajetória
Sete passos. O rastreamento é feito por uma ferramenta de SEO; o RLM entra só na leitura e no cruzamento.
Passo 1: Rastreie o site e exporte o texto principal de cada URL
Use o rastreador que a equipe já tem ou o sitemap. Guarde por URL: status, title, meta description, canonical, H1, data de atualização e o texto principal sem menu e rodapé.
Deu certo quando: O número de URLs indexáveis no arquivo bate com o relatório de páginas do Search Console, com diferença pequena e explicada.
Erro comum: Exportar o HTML bruto. Menu e rodapé repetidos em cada página enchem o contexto e confundem a busca por duplicidade.
Passo 2: Monte um bloco por URL com cabeçalho fixo
Formato: [URL ...] status=200 title=... canonical=... h1=... atualizado=AAAA-MM-DD, seguido do texto.
Deu certo quando: Um print do primeiro bloco no REPL mostra o cabeçalho completo e o texto em seguida.
Erro comum: Separar páginas só por linha em branco. O modelo raiz não sabe onde uma termina.
Passo 3: Escolha o ambiente isolado antes de rodar
Texto de site de terceiros é entrada não confiável. Use environment="docker" ou um sandbox em nuvem; o ambiente local padrão roda o código no mesmo processo.
Deu certo quando: O log registra o ambiente docker e nenhuma escrita fora do contêiner.
Erro comum: Auditar páginas de concorrente com o REPL local. Uma instrução escondida no texto vira código executado na sua máquina.
Passo 4: Faça uma pergunta por critério de auditoria
Exemplos: páginas cujo primeiro parágrafo não responde à pergunta do title; pares de URLs com o mesmo tema; páginas com data de atualização anterior a 12 meses citando ano, preço ou versão.
Deu certo quando: Cada resposta lista URLs e o trecho que motivou a classificação.
Erro comum: Juntar dez critérios numa pergunta. As subchamadas misturam critérios e a lista final perde o motivo.
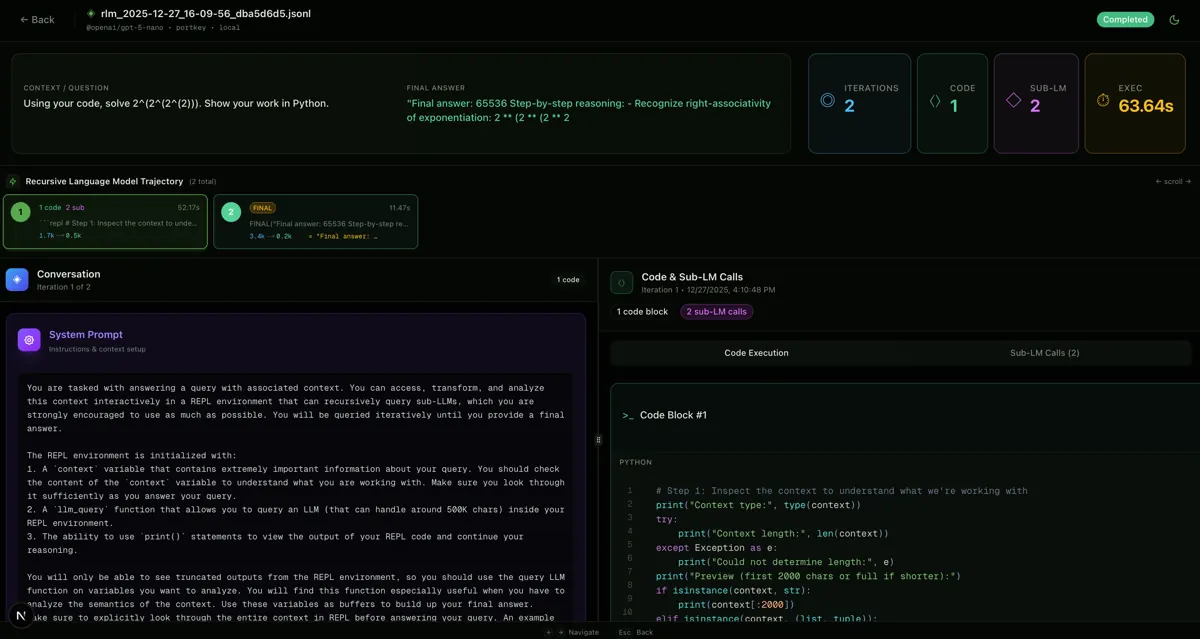
Passo 5: Ligue o RLMLogger e abra a trajetória no visualizador
RLMLogger(log_dir="./logs") grava um JSONL por execução; o visualizador da pasta visualizer/ do repositório mostra código, subchamadas e tempo de cada iteração.
Deu certo quando: Você vê quantas subchamadas houve e quais blocos cada uma recebeu.
Erro comum: Olhar só a resposta final. Uma página pulada pelo filtro do modelo raiz só aparece no rastro.
Passo 6: Confira 20 URLs da lista contra a página no ar
Abra cada URL e veja se o problema apontado existe.
Deu certo quando: Ao menos 18 de 20 confirmadas. Os erros indicam qual critério reescrever.
Erro comum: Corrigir páginas em lote sem essa conferência.
Passo 7: Transforme a saída em fila de trabalho
Uma linha por URL com critério, trecho, ação sugerida e dono.
Deu certo quando: A fila cabe na ferramenta de tarefas da equipe e cada item tem evidência anexada.
No fim você tem: Uma auditoria de conteúdo do site inteiro, com motivo e trecho por URL, e um log que mostra como cada conclusão foi tirada.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Coordenador de SEO de uma empresa de software B2B
Tecnologia, blog e central de ajuda com 1.900 URLs indexáveis
Dor
O tráfego orgânico caía e as respostas de assistentes de IA citavam concorrentes. Ninguém sabia quais páginas estavam desatualizadas ou disputando a mesma busca.
Solução
Rastreamento completo, um bloco por URL com cabeçalho, rlms em contêiner Docker e quatro perguntas de auditoria rodadas em separado, com conferência de 20 URLs por pergunta.
Resultado
Saíram 140 páginas com primeiro parágrafo sem resposta, 37 pares de páginas sobre o mesmo tema e 212 páginas citando versões antigas do produto. A fila foi dividida entre três redatores por prioridade de tráfego.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Caio saiu do teste com o acervo preparado, o ambiente escolhido e uma execução de ponta a ponta com custo calculado. Rode agora as dez primeiras perguntas do conjunto na mesma configuração e anote tempo, custo e número de subchamadas de cada uma. O critério é que as dez terminem com answer["ready"] antes de 20 minutos; o passo seguinte é dar à resposta um formato tipado e um rastro que Helena consiga auditar sozinha.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoVídeo com IA: Claude Code, Codex e ElevenLabssugerido pelo grafo4 capítulos de “RLM 2027” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoSkills de IA com Vibecoding e Terminalsugerido pelo grafo2 capítulos de “RLM 2027” usam conceitos apresentados em “Skills de IA com Vibecoding e Terminal”.
- CursoSetup Completo: do zero ao Claude Codesugerido pelo grafo3 capítulos de “RLM 2027” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code”.
- CursoPrompt Engineering para Executivossugerido pelo grafo2 capítulos de “RLM 2027” usam conceitos apresentados em “Prompt Engineering para Executivos”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Bastidores: Como Este Portal Foi ConstruídoBanca de modelos: pesquisa e redação com fonteExaminar conexões de Banca de modelos: pesquisa e redação com fonte
- MCP para quem decideInventariar o que já roda nas máquinas do timeExaminar conexões de Inventariar o que já roda nas máquinas do time
- Prompt Engineering para ExecutivosDecidir o que entra na janela e em que posição cada bloco ficaExaminar conexões de Decidir o que entra na janela e em que posição cada bloco fica
- Astra profundoGovernar a esteira: gerar uma vez e multiplicar com cota zeroExaminar conexões de Governar a esteira: gerar uma vez e multiplicar com cota zero
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.