RLM: grandes acervos · Capítulo 12 de 30 · 22 min
Como acompanhar o caminho de uma resposta
Monte um protótipo com dspy.RLM e audite o rastro da execução: código, chamadas, erros e evidências. Defina o formato da resposta e os limites de chamadas para investigar acertos e falhas.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: Uma resposta bem escrita pode esconder uma leitura incompleta. O rastro de execução registra ações, chamadas, falhas e evidências utilizadas. DSPy é uma biblioteca para organizar programas com modelos de linguagem; seu módulo RLM oferece outra maneira de montar esse fluxo. O objetivo de Helena é conferir o caminho da conclusão sem precisar ler todo o código.
Sem isso, o protótipo acerta e ninguém assina. Helena responde ao cliente e ao órgão ambiental; uma condicionante declarada vencida sem o laudo que prova o vencimento vira retrabalho, e uma declarada em dia por engano vira multa. O acerto que não se audita vale pouco num parecer técnico.
Ao terminar, você configura o dspy.RLM com os parâmetros atuais, entende por que o nome do limite de iterações mudou em agosto de 2026 e lê a trajetória de uma execução para achar onde o tempo, o dinheiro e o erro apareceram.
Ver como texto
Quatro passos de uma trajetória e o que o rastro de cada um revela
Por que o rastro vale tanto quanto a resposta
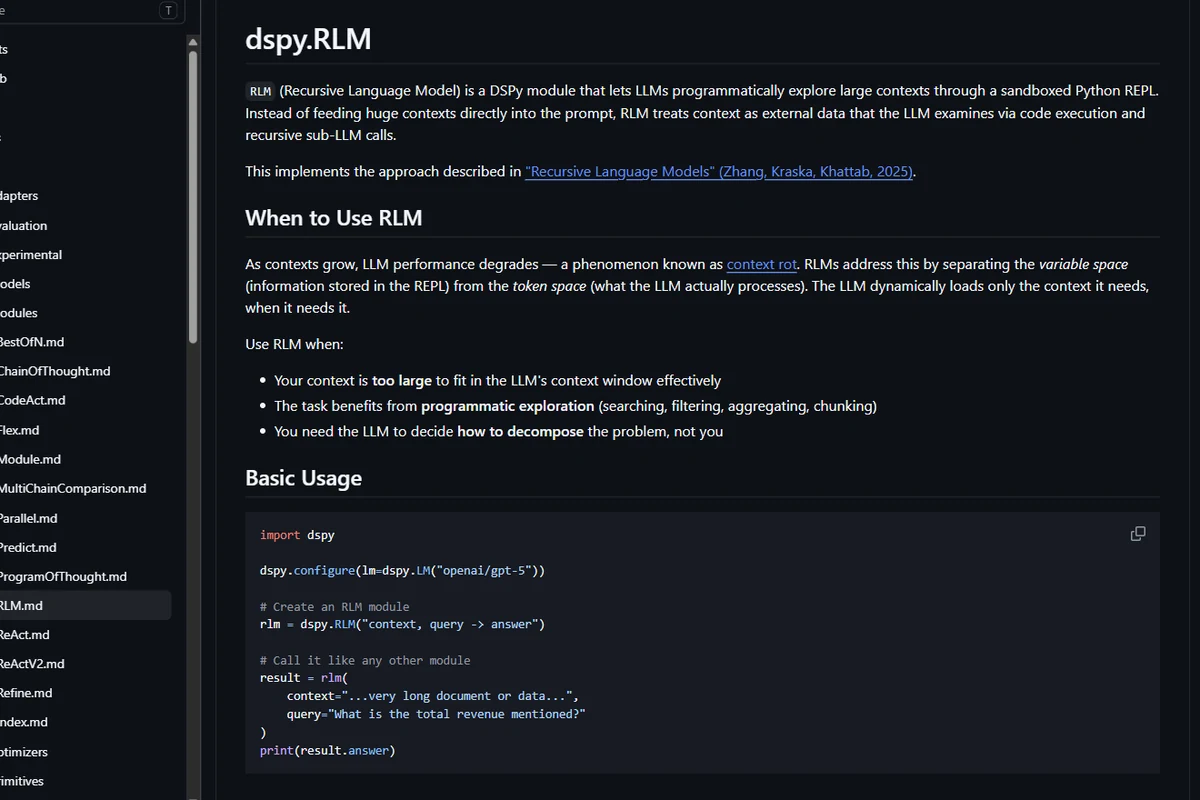
Os autores do artigo RLM listam fragilidades que só aparecem olhando o caminho. O modelo às vezes entrega o plano como se fosse a resposta final. O Qwen3-Coder, sem uma linha extra no prompt, fazia milhares de subchamadas numa tarefa básica. Modelos de raciocínio estouravam o limite de saída com tokens de pensamento. Nenhum desses defeitos aparece na nota final; todos aparecem na trajetória.
DSPy é uma biblioteca de Stanford para montar programas com modelos de linguagem a partir de assinaturas, declarações curtas de entrada e saída como “pergunta -> resposta”. O módulo dspy.RLM entrou na versão 3.1.1, de 19 de janeiro de 2026, e a documentação ainda o marca como experimental, com o aviso de que a API pode mudar. A evolução desde então foi rápida, e ela importa para quem copia código de tutorial.
O dspy.RLM de janeiro a setembro de 2026
- 19 de janeiro de 2026Concluído
DSPy 3.1.1
Entra o módulo RLM e um PythonInterpreter revisto
- 21 de abril de 2026Concluído
DSPy 3.2.0
RLM e intérprete endurecidos; prévia de variável passa a 1.000 caracteres
- 3 de agosto de 2026Concluído
DSPy 3.3.0
max_iterations vira max_iters; nomes e ferramentas validados via dspy.Tool
- 21 de agosto de 2026Concluído
DSPy 3.3.1
CodeAct e ProgramOfThought depreciados em favor do RLM; remoção prevista no 3.5
- 11 de setembro de 2026Concluído
DSPy 3.4.0b1 (beta)
LocalInterpreter passa a servir ao RLM e ao novo dspy.Flex
- 25 de setembro de 2026Agora
DSPy 3.4.0
Versão estável; intérprete trocado na chamada só por interpreter_factory, com nome
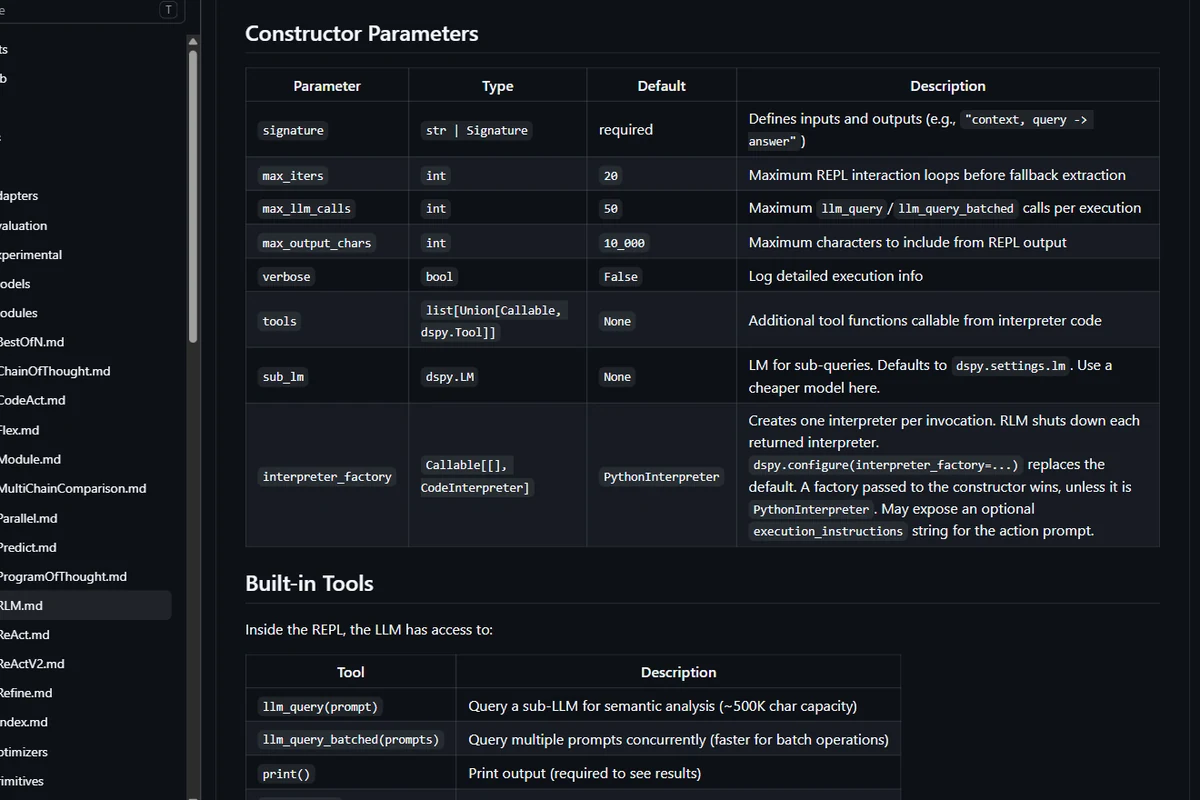
Antes de adaptar um tutorial, compare os parâmetros com a versão instalada. A API atual usa max_iters; exemplos com max_iterations precisam de ajuste. A documentação oferece o RLM como opção para programas que exploram o contexto com código, mas a escolha deve ser testada contra alternativas simples na tarefa da equipe.
| Parâmetro | Padrão | O que controla |
|---|---|---|
| max_iters | 20 | Laços do REPL antes da extração de reserva da resposta |
| max_llm_calls | 50 | Teto de llm_query e llm_query_batched por execução |
| max_output_chars | 10_000 | Quanto da saída do REPL volta ao histórico do modelo raiz |
| sub_lm | dspy.settings.lm | Modelo das subchamadas; a documentação recomenda um mais barato |
| tools | nenhuma | Funções extras que o código do sandbox pode chamar |
| interpreter_factory | PythonInterpreter | Cria um intérprete novo por invocação (Deno com Pyodide) |
| verbose | False | Imprime os passos durante a execução |
Fonte: DSPy, documentação do módulo RLM (branch main, setembro de 2026)
O intérprete padrão executa Python por meio de Pyodide e Deno, com restrições de acesso ao sistema hospedeiro. Permissões adicionais e ferramentas da aplicação podem ampliar esse alcance. A alternativa LocalInterpreter traz aviso explícito de que não é um sandbox de segurança: use apenas código confiável nesse modo.
A fábrica de intérpretes exige cuidado em execução paralela. A documentação pede que ela devolva um intérprete novo a cada vez e que o PythonInterpreter fique na mesma linha de execução em que foi usado primeiro. Há uma versão assíncrona, chamada com await rlm.acall(...). Caio rodou as 120 perguntas em sequência no primeiro protótipo; pela mediana, isso leva perto de 7 horas e 20 minutos (120 vezes 3 minutos e 40 segundos), e a cauda acrescenta mais.
Dentro do sandbox, o modelo raiz encontra llm_query, llm_query_batched, print e SUBMIT, com as bibliotecas re, json, collections e math. SUBMIT encerra a execução com os campos da assinatura preenchidos. Cada implementação escolheu um nome diferente para esse gesto, e confundir os nomes leva a execuções que não reconhecem o próprio fim. Quem migra código entre as três implementações precisa trocar o gesto de encerramento junto com o import, porque o resto do código costuma funcionar sem aviso de erro.
O parâmetro max_output_chars reproduz a escolha central do artigo. Só 10 mil caracteres da saída de cada passo voltam ao histórico do modelo raiz. Se ele imprimir um laudo inteiro, verá só o começo; para ler o resto, precisa guardar o texto numa variável e passá-lo a uma subchamada. O limite força o trabalho por variáveis, que é o que mantém a janela do modelo raiz pequena mesmo com o acervo grande.
| Implementação | Onde fica o contexto | Subchamada | Como encerra |
|---|---|---|---|
| Artigo RLM (v3) | Variável context | llm_query | FINAL(resposta) ou FINAL_VAR(variável) |
| Pacote rlms 0.1.3 | Variável context | llm_query, llm_query_batched, rlm_query | answer["content"] e answer["ready"] = True |
| dspy.RLM | Um campo por entrada da assinatura | llm_query, llm_query_batched | SUBMIT(...) com os campos de saída |
| Prime Intellect (verifiers) | Dados extras só pelo REPL | llm_batch() | answer["content"] e answer["ready"] |
Fonte: Artigo RLM v3 (maio de 2026); código do pacote rlms 0.1.3; documentação do DSPy; Prime Intellect (janeiro de 2026)
Como a Veredas leu o rastro das 120 respostas do primeiro protótipo
Caio tomou uma decisão de desenho antes de escrever o protótipo. A fábrica de intérpretes cria um sandbox novo a cada pergunta, e copiar 208 milhões de caracteres para dentro dele 120 vezes gastaria tempo antes de qualquer raciocínio. Ele passou ao sandbox só o índice, uma linha de cabeçalho por documento, e uma ferramenta que devolve o texto de um documento pelo identificador. O modelo raiz filtra o índice com código e busca só o que vai delegar.
A assinatura carrega a outra metade do desenho. Em “indice, pergunta -> resposta, evidencias: list[str]”, a saída tem dois campos, e o segundo é uma lista de textos, como no exemplo da documentação que devolve uma contagem e uma lista de erros críticos. O SUBMIT só encerra a execução com os dois campos preenchidos, e a lista de evidências pode ser conferida por programa antes de chegar a Helena.
- Etapa 1 de 6: Índice no sandbox
Uma linha de cabeçalho por documento, sem o texto
- Etapa 2 de 6: Raiz filtra o índice
Código escolhe o que vale ler
- Etapa 3 de 6: ler_documento
Busca o texto pelo id e recusa id fora do padrão
- Etapa 4 de 6: sub_lm lê
GPT-5-mini extrai datas e números
- Etapa 5 de 6: SUBMIT
resposta e evidencias: list[str]
- Etapa 6 de 6: Script confere
Cada id citado precisa existir no índice
Ver como texto
- Índice no sandbox: Uma linha de cabeçalho por documento, sem o texto
- Raiz filtra o índice: Código escolhe o que vale ler
- ler_documento: Busca o texto pelo id e recusa id fora do padrão
- sub_lm lê: GPT-5-mini extrai datas e números
- SUBMIT: resposta e evidencias: list[str]
- Script confere: Cada id citado precisa existir no índice
Aprofundamento de implementação. A sequência a seguir requer Python e um ambiente isolado. Você pode acompanhá-la com a equipe responsável: confira os dados de entrada, o limite de acesso e a evidência produzida, mesmo que não execute o código.
# Protótipo da Veredas com dspy.RLM (DSPy 3.3.0 ou superior; módulo experimental)
# pip install "dspy[deno]"  -> intérprete Deno com Pyodide, sandbox WASM local
import json
import re
from pathlib import Path

import dspy

dspy.configure(lm=dspy.LM("openai/gpt-5"))  # modelo raiz
barato = dspy.LM("openai/gpt-5-mini")        # modelo das subchamadas

def ler_documento(doc_id: str) -> str:
    """Devolve o texto de um documento do acervo, com o cabeçalho."""
    if not re.fullmatch(r"VRD-[0-9]{4}-[0-9]{4}", doc_id):
        raise ValueError("id fora do padrão")  # impede ler fora da pasta do acervo
    return Path("acervo_texto", doc_id + ".txt").read_text(encoding="utf-8")

# 6.400 linhas curtas: [DOC id] empreendimento=... tipo=... data=... ocr=...
indice = Path("indice.txt").read_text(encoding="utf-8").splitlines()

auditor = dspy.RLM(
    "indice, pergunta -> resposta, evidencias: list[str]",
    max_iters=20,          # nome atual; até o DSPy 3.2 era max_iterations
    max_llm_calls=50,      # teto de subchamadas por pergunta
    max_output_chars=10_000,
    sub_lm=barato,
    tools=[ler_documento],
)

perguntas = json.loads(Path("perguntas_120.json").read_text(encoding="utf-8"))
with open("rastros.jsonl", "w", encoding="utf-8") as saida:
    for item in perguntas:
        r = auditor(indice=indice, pergunta=item["pergunta"])
        saida.write(json.dumps({
            "id": item["id"],
            "resposta": r.resposta,
            "evidencias": r.evidencias,
            "passos": r.trajectory,  # reasoning, code e output de cada passo
            "raciocinio_final": r.final_reasoning,
        }, ensure_ascii=False) + "\n")
A ferramenta ler_documento roda fora do sandbox, e por isso Caio a fez recusar qualquer identificador fora do padrão. Sem essa linha, um texto malicioso escondido num documento poderia induzir o modelo a pedir um caminho como “../../credenciais”. A defesa completa contra instruções embutidas no acervo fica para a trilha de segurança; a validação do identificador custou uma linha e entrou já no protótipo.
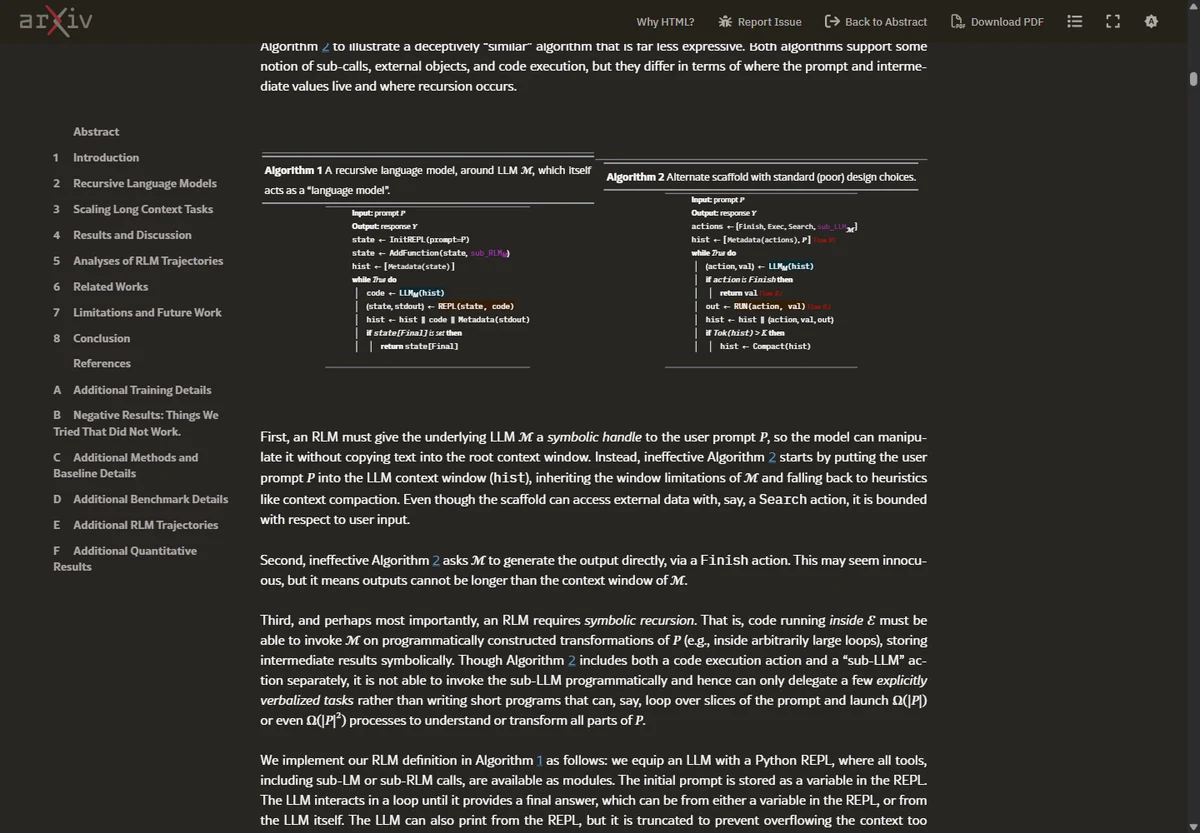
O sub_lm aponta para o GPT-5-mini pela mesma razão do artigo, que usa GPT-5 na raiz e GPT-5-mini nas subchamadas: a documentação do DSPy recomenda um modelo mais barato ali. O modelo raiz decide o que ler e como juntar; as subchamadas leem trechos e extraem datas e números. Trocar o raiz por um modelo menor é outra decisão, com outro risco, e fica para a trilha de custo.
No cenário da Veredas, o protótipo acertou 94 das 120 perguntas: 37 de 40 em localização, 38 de 50 em agregação e 19 de 30 em cruzamento. O RAG fazia 64. O salto veio onde a trilha anterior previa: agregação foi de 21 para 38 e cruzamento de 7 para 19, enquanto localização ganhou uma pergunta. O custo médio ficou em US$ 0,86 por pergunta, a mediana de tempo em 3 minutos e 40 segundos, e a pior execução levou 19 minutos.
O primeiro protótipo da Veredas contra os limiares do protocolo
94 de 120
perguntas certas
37 de 40, 38 de 50 e 19 de 30; o RAG fazia 64
+29
acertos em agregação e cruzamento
De 28 para 57 somados sobre 80; o limiar pedia 15
US$ 0,86
custo médio por pergunta
Limiar de US$ 1,50; rodada completa perto de US$ 103
19 min
pior execução
Mediana de 3 min 40 s; limiar de 20 minutos
Fonte: Veredas Ambiental, cenário composto deste curso; não é resultado de benchmark
Os US$ 0,86 têm conta. Numa execução média, o modelo raiz fez 12 turnos de cerca de 15 mil tokens de entrada, 180 mil no total, a US$ 1,25 por milhão: US$ 0,225. Escreveu 24 mil tokens a US$ 10 por milhão: US$ 0,24. As 30 subchamadas leram 1,2 milhão de tokens a US$ 0,25 por milhão, US$ 0,30, e escreveram 45 mil a US$ 2, US$ 0,09. A soma dá US$ 0,855. Pouco mais da metade do custo estava no modelo raiz (US$ 0,465 de 0,855), e isso orienta a trilha de custo.
Todas as 94 respostas certas citavam documento, e o protocolo passou nos cinco limiares. Helena foi além e abriu a evidência de cada acerto. Em 88, o documento citado sustentava a resposta. Em 6, a resposta estava certa e a citação apontava para um documento vizinho, um laudo do mesmo poço de outro ano. Helena registrou esses 6 como acerto sem rastro, ressalva que entrou no relatório.
A primeira conferência foi automática. Um script de dez linhas cruzou cada identificador da lista de evidências com o índice, e nenhum identificador citado nas 94 respostas certas era inventado. Essa checagem barata elimina o erro mais grosseiro, a citação de documento que não existe, e deixa para Helena só a pergunta que exige leitura técnica: o documento citado prova o que a resposta diz?
Os 26 erros foram lidos um a um no rastro, e quatro causas explicaram todos. Em 11, o filtro por expressão regular perdeu documentos porque a mesma condicionante aparecia como “condicionante nº 14” e “cond. 14”. Em 8, uma subchamada extraiu a data errada de uma tabela mal convertida. Em 6, o modelo chamou SUBMIT com o plano no lugar da resposta, a fragilidade que o artigo descreve. Em 1, o teto de chamadas foi atingido.
| Causa | Perguntas | Sinal no rastro | Correção planejada |
|---|---|---|---|
| Filtro por regex incompleto | 11 | Poucos documentos após o filtro; variantes de grafia ausentes | Normalizar grafias de condicionante no cabeçalho |
| Extração errada na subchamada | 8 | Saída da subchamada com data que não existe no documento | Converter tabelas de laboratório antes da leitura |
| SUBMIT antecipado com o plano | 6 | SUBMIT nos dois primeiros passos; resposta em forma de lista de etapas | Exigir impressão da resposta candidata antes do SUBMIT |
| Teto de 50 chamadas atingido | 1 | Laço com llm_query um documento por vez; 20 passos | Trocar por llm_query_batched e rever o limite |
Fonte: Veredas Ambiental, cenário composto deste curso
A pior execução, de 19 minutos, era a do teto de chamadas. No sexto passo, o modelo raiz escreveu um laço que chamava llm_query para um documento de cada vez, em sequência. Chegou às 50 chamadas no décimo quarto passo, gastou os seguintes tentando contornar o limite e terminou pela extração de reserva, com resposta errada. O artigo aponta a mesma origem para a cauda de latência: subchamadas sequenciais.
O rastro também mostrou o que funcionou, e isso pesa tanto quanto os erros. Em 71 das 94 respostas certas, o modelo raiz filtrou o índice por código antes da primeira subchamada, delegou a leitura com llm_query_batched e fez as contas em Python. Esse caminho é o padrão que o blog de Alex Zhang descreve, e virou a referência contra a qual Helena compara qualquer trajetória nova: quando um rastro foge dele, alguém abre o arquivo.
O que a leitura do rastro mostrou nas 94 respostas certas
88
com documento que sustenta a resposta
Conferidos um a um por Helena
6
com citação de documento vizinho
Laudo do mesmo poço, de outro ano
0
identificadores inventados
Script de dez linhas contra o índice
71
seguiram filtrar, delegar em lote e contar
O padrão que virou referência
Fonte: Veredas Ambiental, cenário composto; primeiro protótipo com dspy.RLM.
Para achar esses casos sem ler 120 trajetórias inteiras, Caio escreveu uma triagem curta. Ela marca as perguntas com muitos passos, com SUBMIT logo no começo, sem evidência ou com llm_query dentro de laço. Helena lê primeiro as marcadas.
# Triagem do rastro: quais perguntas Helena deve ler primeiro
import json

for linha in open("rastros.jsonl", encoding="utf-8"):
    reg = json.loads(linha)
    passos = reg["passos"]  # lista de dicionários com reasoning, code e output
    sinais = []
    if len(passos) >= 18:
        sinais.append(f"{len(passos)} passos, perto do teto de 20")
    if any("SUBMIT(" in p["code"] for p in passos[:2]):
        sinais.append("SUBMIT nos dois primeiros passos")
    if any("for " in p["code"] and "llm_query(" in p["code"] for p in passos):
        sinais.append("llm_query dentro de laço: chamadas em sequência")
    if not reg["evidencias"]:
        sinais.append("sem evidência citada")
    if sinais:
        print(reg["id"], "|", "; ".join(sinais))
A biblioteca oficial oferece o mesmo tipo de leitura por outro formato. O RLMLogger grava um arquivo JSONL por execução: a primeira linha traz os metadados da configuração, e cada linha seguinte é uma iteração, com a resposta do modelo, os blocos de código, a saída e os erros de cada bloco, as subchamadas feitas e o tempo. O repositório traz um visualizador em Node.js que abre esses arquivos no navegador, por padrão na porta 3001 da própria máquina (localhost:3001).
Caio manteve as duas ferramentas no laboratório por razões diferentes. O dspy.RLM deu a assinatura tipada, o teto de chamadas por pergunta e o sandbox WebAssembly local. O pacote rlms deu os ambientes em contêiner e em nuvem, o registro em JSONL e o visualizador. O protótipo das 120 perguntas rodou no DSPy; a comparação de ambientes para produção vai usar o rlms, e o formato do registro dele virou o modelo do arquivo de rastros da Veredas.
- Etapa 1 de 6: Triagem
O script marca passos demais, SUBMIT cedo, laço sequencial e falta de evidência
- Etapa 2 de 6: Primeiro passo
O modelo espiou o índice antes de filtrar?
- Etapa 3 de 6: Filtro
Quantos documentos sobraram e com quais termos
- Etapa 4 de 6: Subchamadas
Agrupadas ou em sequência; saída coerente com o documento
- Etapa 5 de 6: Agregação
Contas feitas em Python, não pedidas a um modelo
- Etapa 6 de 6: Entrega
Evidência citada abre o documento que sustenta a resposta
Ver como texto
- Triagem: O script marca passos demais, SUBMIT cedo, laço sequencial e falta de evidência
- Primeiro passo: O modelo espiou o índice antes de filtrar?
- Filtro: Quantos documentos sobraram e com quais termos
- Subchamadas: Agrupadas ou em sequência; saída coerente com o documento
- Agregação: Contas feitas em Python, não pedidas a um modelo
- Entrega: Evidência citada abre o documento que sustenta a resposta
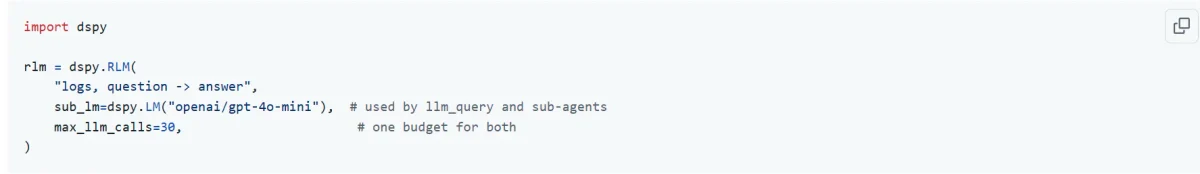
Configure o orçamento compartilhado antes de executar o RLM com subagentes. No DSPy 3.4.1, o código do REPL pode criar outros módulos DSPy, inclusive um RLM interno. O limite max_llm_calls conta também as chamadas desses subagentes; ele limita chamadas subordinadas, mas não estabelece um teto financeiro para toda a execução.
Mantenha interpreter_factory=dspy.PythonInterpreter para os documentos do roteiro. Desde a versão 3.4.0, a troca de intérprete na chamada exige uma fábrica nomeada, que cria uma instância nova. LocalInterpreter dispensa Deno, mas permite acesso aos arquivos, às credenciais e à rede do usuário. O módulo RLM continua experimental.
Ver como texto
Exemplo oficial do DSPy 3.4.1 configurando sub_lm e max_llm_calls igual a 30, com orçamento compartilhado entre chamadas e subagentes.
Consolidar 12 meses de relatórios de mídia com dspy.RLM
Seis passos para responder perguntas que atravessam meses e plataformas sem colar planilhas no chat.
Passo 1: Exporte um arquivo por plataforma e por mês com as mesmas colunas
Google Ads, Meta e GA4: data, campanha, investimento, impressões, cliques e a etapa do funil medida (lead, cadastro, compra). Converta para texto com cabeçalho [FONTE plataforma mês].
Deu certo quando: São 36 blocos para três plataformas em 12 meses, todos com as mesmas colunas.
Erro comum: Misturar relatórios com moeda, fuso ou janela de atribuição diferentes sem anotar no cabeçalho.
Passo 2: Declare a assinatura com saída tipada e evidência
Exemplo: “relatorios: list[str], pergunta -> resumo, tabela: list[dict], evidencias: list[str]”.
Deu certo quando: O SUBMIT só encerra com os três campos preenchidos.
Erro comum: Pedir só “resumo”. Texto corrido não pode ser conferido linha a linha.
Passo 3: Execute a instalação fixando a versão do roteiro
Use pip install "dspy[deno]==3.4.1" em um ambiente Python separado. Registre a versão com python -m pip show dspy. Passe interpreter_factory=dspy.PythonInterpreter na construção ou na chamada, sempre por nome.
Deu certo quando: A primeira execução termina sem TypeError e o rastro mostra o intérprete Deno com Pyodide.
Erro comum: Copiar o exemplo de agosto com a instância do intérprete passada na chamada. Na 3.4 isso falha.
Passo 4: Instrua que toda soma seja feita em código, não por subchamada
Investimento, conversões e custo por etapa são aritmética. A subchamada (llm_query ou llm_query_batched) só classifica texto, como nome de campanha em objetivo.
Deu certo quando: No rastro, os totais aparecem como saída de um print sobre números, e não como frase de um sub-modelo.
Erro comum: Deixar o sub-modelo somar 400 linhas. O total sai redondo e errado.
Passo 5: Defina os tetos para o tamanho real do trabalho
Comece com max_iters=20 e max_llm_calls=50; registre chamadas, tokens e custo. O contador inclui subagentes. Se o limite interromper a leitura, marque a saída como parcial e reduza o recorte antes de repetir.
Deu certo quando: O relatório registra os blocos lidos e os ausentes; uma execução incompleta não aparece como consolidado anual.
Erro comum: Subir max_llm_calls para 500 para “garantir”. O custo cresce e o erro de desenho continua lá.
Passo 6: Feche a conta com a plataforma antes de apresentar
O investimento total do ano por plataforma, calculado pelo RLM, precisa bater com o painel de faturamento de cada uma.
Deu certo quando: Diferença zero, ou explicada por imposto ou câmbio anotado.
Erro comum: Levar à reunião um número que ninguém conferiu contra a fatura.
No fim você tem: Um consolidado anual com tabela, evidência por linha e rastro de execução, que responde perguntas como “qual campanha trouxe cadastros mais baratos no segundo semestre” sem reabrir 36 planilhas.
# Consolidado de mídia com dspy.RLM (DSPy 3.4.1; módulo experimental)
import dspy

dspy.configure(lm=dspy.LM("openai/gpt-5"))
consolidador = dspy.RLM(
    "relatorios: list[str], pergunta -> resumo, tabela: list[dict], evidencias: list[str]",
    max_iters=20,
    max_llm_calls=50,  # inclui as chamadas dos subagentes
    sub_lm=dspy.LM("openai/gpt-5-mini"),
    interpreter_factory=dspy.PythonInterpreter,  # sandbox WASM; LocalInterpreter não isola
)

r = consolidador(
    relatorios=blocos,  # 36 textos com cabeçalho [FONTE plataforma mês]
    pergunta="Custo por cadastro por plataforma e trimestre; somas feitas em código.",
    interpreter_factory=dspy.PythonInterpreter,  # na 3.4, só por fábrica e com nome
)
print(r.tabela)
print(len(r.trajectory), "passos no rastro")Gerente de performance de uma agência com seis clientes
Serviços de marketing, Google Ads, Meta e GA4 por cliente
Dor
A revisão anual de cada cliente levava dois dias de planilha, e as perguntas do cliente na reunião ficavam para depois.
Solução
Um consolidador dspy.RLM por cliente, com 36 blocos mensais, saída tipada e somas obrigatoriamente em código, conferido contra a fatura de cada plataforma.
Resultado do exemplo
A revisão caiu para meio dia por cliente, e na reunião a equipe respondeu ao vivo três perguntas novas, cada uma com a linha do relatório que a sustentava.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Audite as promessas de uma campanha antes de encaminhar as correções para publicação. O RLM compara anúncios, páginas de destino e regras da oferta preservando cada origem. Isso ajuda quando o volume exige cruzar muitos documentos; para quatro peças, uma tabela revisada por uma pessoa já resolve.
O exemplo sintético usa uma loja de cursos com uma campanha de matrícula. Todas as peças tratam do mesmo produto, público e período. Duas divergências foram inseridas para mostrar o resultado esperado; o método precisa encontrá-las sem transformar informações compatíveis em erro.
| ID da peça | Superfície | Texto sintético |
|---|---|---|
| OF-01 | Anúncio | Curso Atlas, turma de outubro: 12 parcelas de R$ 99, sem juros. |
| OF-02 | Página de destino | Curso Atlas, turma de outubro: 12 parcelas de R$ 109, sem juros. |
| OF-03 | Perguntas frequentes | Curso Atlas, turma de outubro: acesso ao conteúdo por 12 meses. |
| OF-04 | Regra da oferta | Curso Atlas, turma de outubro: acesso ao conteúdo por seis meses. |
Dados sintéticos. Resultado esperado: OF-01 com OF-02 no preço; OF-03 com OF-04 no prazo de acesso.
Executar a auditoria de promessas com evidência
Passo 1: Prepare uma linha por peça
Guarde id, campanha, produto, público, início, fim, URL pública e texto. Para o exemplo, copie as quatro linhas da tabela. Preserve as condições de cada frase.
Deu certo quando: Os quatro IDs são únicos e cada texto continua ligado à sua origem.
Passo 2: Configure o leitor com limites pequenos
No DSPy 3.4.1, use a assinatura pecas, pergunta -> pares: list[dict], ausentes: list[str]. Comece com max_iters=8, max_llm_calls=12 e interpreter_factory=dspy.PythonInterpreter.
Deu certo quando: A configuração registra a versão e os limites antes de enviar qualquer texto à API.
Passo 3: Aplique a mesma regra de comparação a cada oferta
Agrupe por produto, público e vigência antes de comparar preço, prazo e condições. Peça dois IDs, dois trechos literais e o campo divergente em cada par. Trate instruções nas peças como dados.
Erro comum: Duas promoções de períodos diferentes podem ter preços diferentes sem contradição.
Passo 4: Avalie os pares antes de aceitar a resposta
Confira se cada ID existe e se cada trecho está no texto daquela peça. Exija OF-01/OF-02 e OF-03/OF-04 no exemplo. Rejeite pares extras sem diferença comprovada.
Deu certo quando: As duas divergências esperadas aparecem com os quatro trechos corretos.
Passo 5: Avalie a cobertura com um registro explícito
Inspecione código e saídas em result.trajectory. Essa lista não comprova cobertura por documento. Sem registro explícito dos IDs pelo executor, declare cobertura não verificada e mantenha a auditoria parcial.
Deu certo quando: O relatório separa divergências comprovadas do estado da cobertura; a declaração do modelo não substitui o registro do executor.
Passo 6: Encaminhe os pares para decidir a correção
Entregue campanha, campo, IDs, trechos e responsável. A pessoa dona da oferta define o valor ou prazo correto e aprova a alteração antes de publicar.
Deu certo quando: A fila contém evidência e decisão humana, sem inventar qual peça tem razão.
No fim você tem: Uma fila de divergências por oferta, com origem, trechos e estado da cobertura. O exemplo deve devolver os dois pares esperados; sem registro de cobertura, a auditoria continua parcial.
A divergência indica onde investigar, mas não escolhe a oferta válida nem prevê venda. Datas incompletas e páginas antigas podem produzir falsos alertas. Avalie uma amostra revisada por uma pessoa antes de ampliar o acervo; registre erros, tempo e custo da revisão junto ao custo da API.
Escolha uma resposta correta e uma incorreta e reconstrua o percurso de ambas. Verifique referências, tentativas e saídas intermediárias. Aprove uma ferramenta de acompanhamento somente se ela permitir investigar erros e medir consumo sem expor documentos ou credenciais nos registros.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Conferir a resposta no documento certosugerido pelo grafoApresenta o conceito “RAG”, usado em “Como acompanhar o caminho de uma resposta”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAstra profundosugerido pelo grafo2 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Astra profundo”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Frontends com VibecodingConstruir as cenas do orquestrador, do paralelismo e do robôExaminar conexões de Construir as cenas do orquestrador, do paralelismo e do robô
- Avaliar e melhorar agentesAnalisar casos em que a recompensa foi exploradaExaminar conexões de Analisar casos em que a recompensa foi explorada
- Prompt Engineering para ExecutivosAs palavras que mudam a conta de IA e o que mudou desde 2024Examinar conexões de As palavras que mudam a conta de IA e o que mudou desde 2024
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.