RLM: grandes acervos · Capítulo 3 de 30 · 17 min
Como o acervo fica disponível fora da conversa
Entenda como o RLM consulta um acervo fora da conversa por meio do REPL, ambiente que executa código e devolve resultados. Acompanhe a relação entre dados, programa e chamadas ao modelo.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Se o material não cabe na conversa, ele pode continuar disponível em um ambiente de execução. No RLM, o modelo escreve pequenos programas para examinar partes desse acervo. REPL é o nome do ambiente que recebe um comando, executa e devolve o resultado. Para o gestor, o ponto central é distinguir acesso ao material de envio do material inteiro ao modelo.
Exemplo: Errar esse lugar produz um sistema caro e cego ao mesmo tempo. Quem envia o acervo no histórico de um agente precisa considerar o material transmitido, a janela disponível e as regras de cobrança do provedor. O reaproveitamento por cache pode alterar o custo; ele deve ser conferido na configuração contratada. Quem esconde o acervo atrás de uma busca volta ao problema dos oito trechos, que custou à Veredas 31 erros de contexto.
No desenho de Zhang, Kraska e Khattab, o acervo fica disponível como variável no ambiente de execução. O modelo coordenador começa com informações sobre esse material e escolhe o que examinar por código. Ele não precisa receber tudo na primeira chamada, mas os trechos e resultados devolvidos pelo programa entram em seu contexto. O limite continua existindo em cada chamada.
| Onde fica o acervo | Quanto o modelo paga | O que se perde |
|---|---|---|
| No histórico do agente | Cada token, a cada turno | Bate no teto da janela e perde o meio do material |
| Atrás de uma busca por trechos | Só os 8 trechos devolvidos | Tudo o que a busca não trouxe; na Veredas, 31 erros de contexto |
| Numa variável do REPL | Metadados de tamanho fixo e as saídas cortadas | Nada fica inacessível; a leitura passa a depender do código |
Números do cenário composto da Veredas Ambiental, medidos no capítulo 1.
Por que tirar o prompt da janela muda o que o modelo consegue fazer
REPL é um terminal que executa uma linha de código por vez e guarda as variáveis entre uma linha e outra, como um caderno de rascunho que lembra as contas anteriores. O nome vem de read, eval, print e loop: ler, avaliar, imprimir e repetir. Quem já usou um notebook de Python conhece a sensação de definir uma lista numa célula e usá-la três células depois.
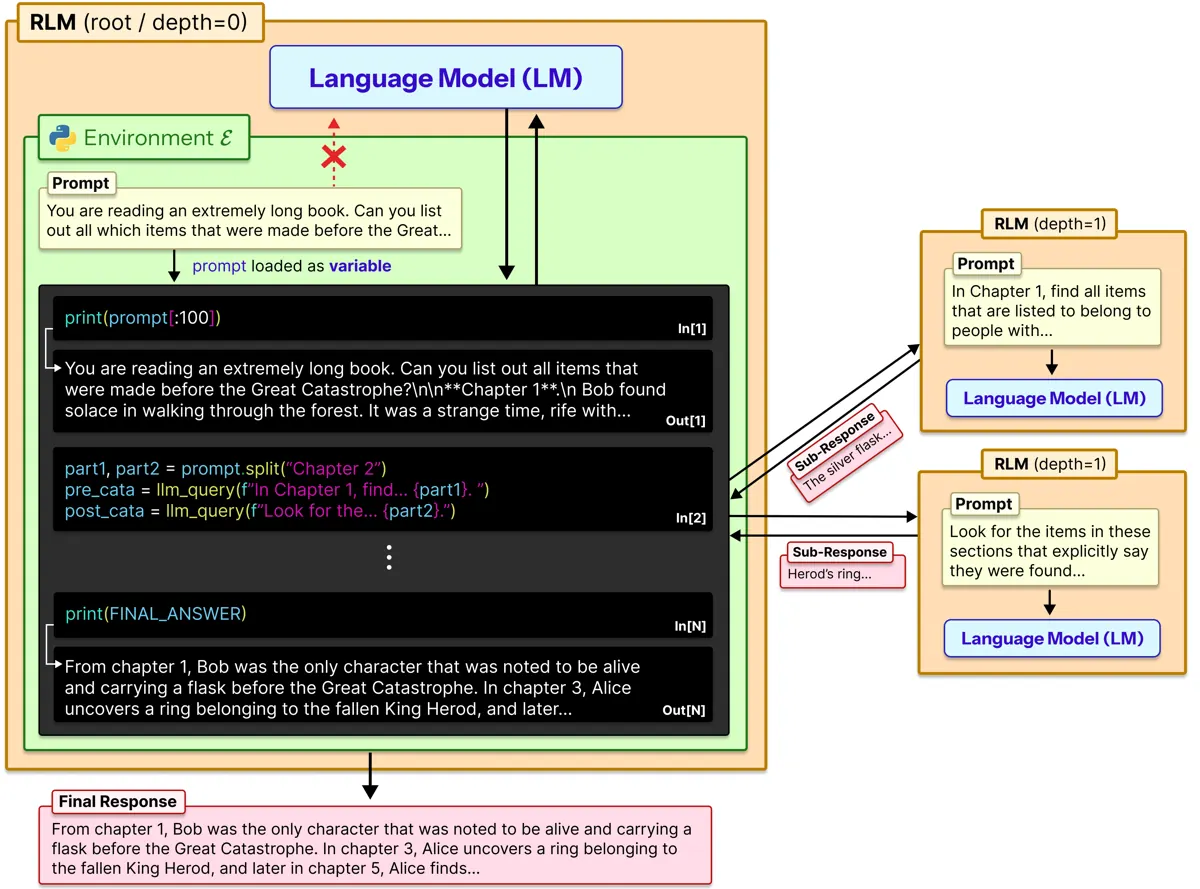
No RLM, o prompt do usuário entra nesse caderno como uma variável chamada context. O modelo que coordena, chamado modelo raiz, não recebe o texto. Recebe metadados de tamanho constante: o tipo da variável, o comprimento total em caracteres, o tamanho dos pedaços, um prefixo curto e a forma de acessar o conteúdo. Um acervo de mil páginas e outro de dez mil geram metadados do mesmo tamanho.
Ver como texto
O modelo raiz manda código ao REPL, recebe só um prefixo da saída, e as subchamadas leem os pedaços do acervo
A partir daí, o modelo raiz trabalha como um analista com um terminal aberto. Escreve código num bloco marcado como repl, o ambiente executa, e o resultado fica guardado em variáveis. O código pode fatiar o texto, usar expressões regulares e chamar a função llm_query, que manda um pedaço a outro modelo. O prompt do artigo informa ao modelo que essa função aceita cerca de 500 mil caracteres.
Essa ideia nasceu de um incômodo prático. No post de outubro de 2025, Zhang descreve o modelo raiz que não vê o contexto e só sabe o tamanho dele. Por isso a primeira coisa que ele faz é espiar: no exemplo do OOLONG, lê os primeiros 2.000 caracteres para entender o formato. Só depois escreve o código que filtra, divide e delega. O autor chama os RLMs de generalização natural das estratégias de resumo.
Depois de cada execução, só um prefixo curto da saída e o tamanho dela voltam ao histórico do modelo raiz. A saída do REPL é truncada de propósito. Se o modelo imprime o acervo inteiro, recebe de volta as primeiras linhas e um aviso de tamanho. Esse corte força o trabalho a acontecer nas variáveis e nas subchamadas, e não na janela do modelo raiz.
- Etapa 1 de 7: Abrir o REPL
O prompt P vira a variável context, fora da janela
- Etapa 2 de 7: Registrar a subchamada
A função llm_query fica disponível para o código
- Etapa 3 de 7: Entregar metadados
O raiz começa só com tipo, tamanho e prefixo de P
- Etapa 4 de 7: Escrever código
O raiz responde com um bloco repl
- Etapa 5 de 7: Executar
O código roda, fatia P, chama subchamadas e guarda variáveis
- Etapa 6 de 7: Devolver só metadados da saída
Prefixo curto e tamanho entram no histórico
- Etapa 7 de 7: Parar
Quando FINAL ou FINAL_VAR define a resposta
Ver como texto
- Abrir o REPL: O prompt P vira a variável context, fora da janela
- Registrar a subchamada: A função llm_query fica disponível para o código
- Entregar metadados: O raiz começa só com tipo, tamanho e prefixo de P
- Escrever código: O raiz responde com um bloco repl
- Executar: O código roda, fatia P, chama subchamadas e guarda variáveis
- Devolver só metadados da saída: Prefixo curto e tamanho entram no histórico
- Parar: Quando FINAL ou FINAL_VAR define a resposta
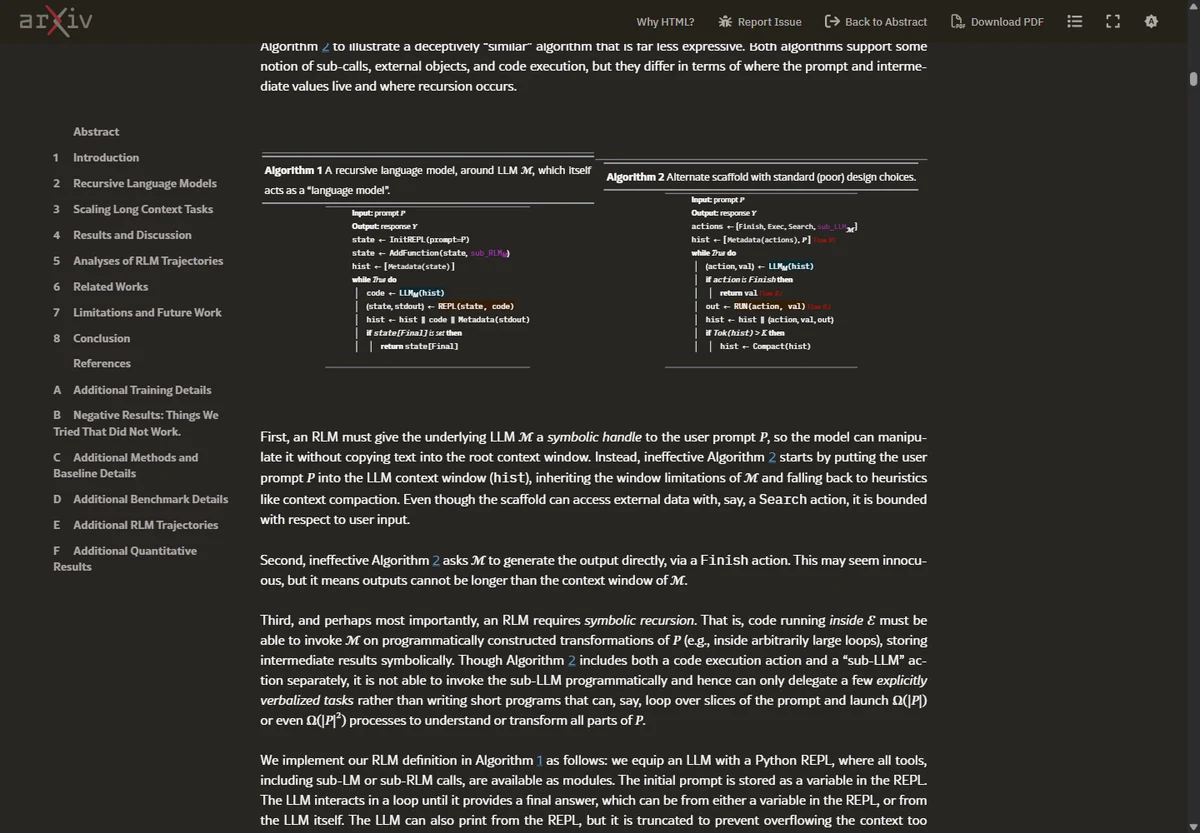
O artigo contrasta esse desenho com um segundo algoritmo, marcado como falho, que descreve como muitos agentes funcionam. A comparação isola três escolhas. Handle simbólico: o prompt fica fora da janela, acessível por um nome; a falha número um é pôr o prompt no histórico. Handle é uma alça, uma referência que permite pegar o objeto sem carregá-lo.
A segunda escolha é a saída construída no REPL. A resposta pode ser montada numa variável, linha a linha, e devolvida no fim, o que permite respostas maiores que a janela do modelo. A falha correspondente é gerar a resposta direto no texto do modelo, limitada ao que ele consegue escrever num turno.
Por último vem a recursão simbólica. O código chama o modelo sobre pedaços do prompt construídos por programa, dentro de laços. Um laço sobre 6.400 documentos pode disparar milhares de subchamadas sem que o modelo raiz escreva milhares de mensagens. A falha número três é tratar a subchamada como uma ação verbal do agente, que ele precisa pedir uma de cada vez e não consegue pôr num laço.
As três escolhas de desenho que o artigo diz faltarem nos agentes comuns
Algoritmo 2, marcado como falho
Coluna a evitar
- O prompt inteiro entra no histórico do modelo
- A resposta final é o texto gerado num turno
- Subchamada é uma ação pedida uma vez por turno
- O tamanho útil do problema para na janela
Algoritmo 1, o RLM
Coluna recomendada
- O prompt fica numa variável, acessível por nome
- A resposta é montada numa variável e devolvida por FINAL_VAR
- Subchamada é uma função, chamável dentro de laços
- O histórico guarda código e metadados, e cresce devagar
Há um custo escondido nesse desenho, e os autores o registram. Se cada turno do modelo raiz for aparado a c tokens, o raiz faz no máximo K dividido por c iterações antes de encher a própria janela K. Cada iteração pode disparar quantas subchamadas quiser, e os autores afirmam que o limite não é fundamental. Na prática, ele explica por que as implementações cortam a saída de cada passo com rigor.
Cada implementação escolheu os próprios nomes e limites. A biblioteca oficial rlms segue o artigo na variável context e nas subchamadas, mas na versão 0.1.3 encerra pelo dicionário answer, e não por FINAL. O dspy.RLM entrega a resposta com SUBMIT e corta a saída do REPL em 10 mil caracteres por padrão. O desenho da Prime Intellect para o verifiers corta em 8.192 caracteres e dá 120 segundos a cada chamada ao REPL. Código escrito para uma implementação não roda em outra sem ajuste.
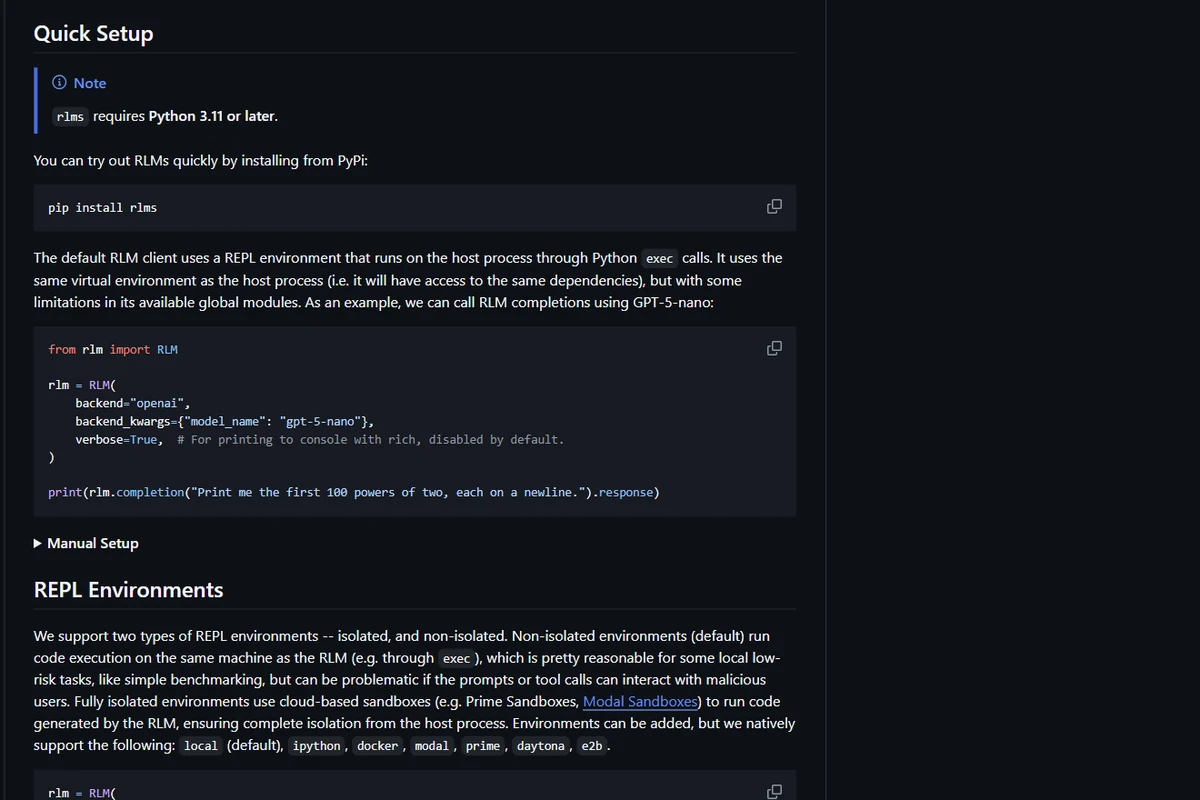
No DSPy, o tamanho da prévia e o intérprete fazem parte da configuração. O parâmetro interpreter_factory fornece a fábrica que cria um intérprete para cada execução; assim, a implementação padrão não reaproveita automaticamente as variáveis da pergunta anterior. Ferramentas externas, arquivos e registros persistentes exigem controle próprio. O módulo continua experimental: confira a versão e os parâmetros antes de adaptar um exemplo.
A Prime Intellect levou a mesma lógica a outra peça, as ferramentas. No desenho publicado em janeiro de 2026, busca na web e outras ferramentas extras ficam disponíveis só para os modelos das subchamadas. O modelo raiz não as recebe, para que as descrições e os resultados delas não inchem a janela de quem coordena. A regra é a mesma do prompt: o raiz decide, e quem lê material volumoso é outro modelo.
Os números que limitam o que volta ao modelo raiz
10.000
caracteres de saída do REPL por passo
Padrão de max_output_chars no dspy.RLM
1.000
caracteres de prévia por variável
DSPy desde a versão 3.2.0, de abril de 2026
8.192
caracteres de saída por turno
Desenho da Prime Intellect no verifiers, ajustável
~500 mil
caracteres por subchamada
Capacidade de llm_query informada ao modelo no prompt do artigo
Fonte: Documentação do dspy.RLM e notas de versão do DSPy; Prime Intellect, janeiro de 2026; Zhang, Kraska e Khattab, versão 3.
| Implementação | Onde fica o contexto | Subchamada | Resposta final | Limite de saída |
|---|---|---|---|---|
| Artigo RLM (versão 3) | Variável context | llm_query | FINAL(...) ou FINAL_VAR(...) | Saída truncada |
| Biblioteca rlms 0.1.3 | Variável context | llm_query, llm_query_batched, rlm_query, rlm_query_batched | answer["content"] com answer["ready"] = True | Saída truncada |
| dspy.RLM | Campos da assinatura | llm_query, llm_query_batched | SUBMIT(...) | max_output_chars = 10.000 |
| Prime Intellect (verifiers) | Dados extras só pelo REPL | llm_batch() | answer["content"] com answer["ready"] = True | 8.192 caracteres; 120 s por chamada |
| Prime Agent | Histórico e variáveis num kernel IPython | await rlm(...) | Sessão | Parâmetros --autonomous-max-* |
Fonte: Zhang, Kraska e Khattab (versão 3); documentação do dspy.RLM; Prime Intellect, janeiro e agosto de 2026.
Armadilha comum: abrir o REPL e, no primeiro turno, mandar o modelo imprimir o contexto para “dar uma olhada”. É a falha número um por outra porta. A saída volta truncada, o modelo decide com base nas primeiras linhas e trata o resto como se fosse igual. O desenho pede o contrário: medir, espiar um pedaço pequeno e só então escrever o código que lê.
O código gerado precisa de um ambiente de execução definido. O ambiente local da biblioteca rlms e o LocalInterpreter do DSPy não oferecem isolamento de segurança. O PythonInterpreter padrão do DSPy usa Deno e Pyodide, com acesso ao hospedeiro restrito por padrão. As permissões podem ser ampliadas e as ferramentas fornecidas pela aplicação executam fora desse compartimento; por isso, o nome “sandbox” não substitui a revisão da configuração.
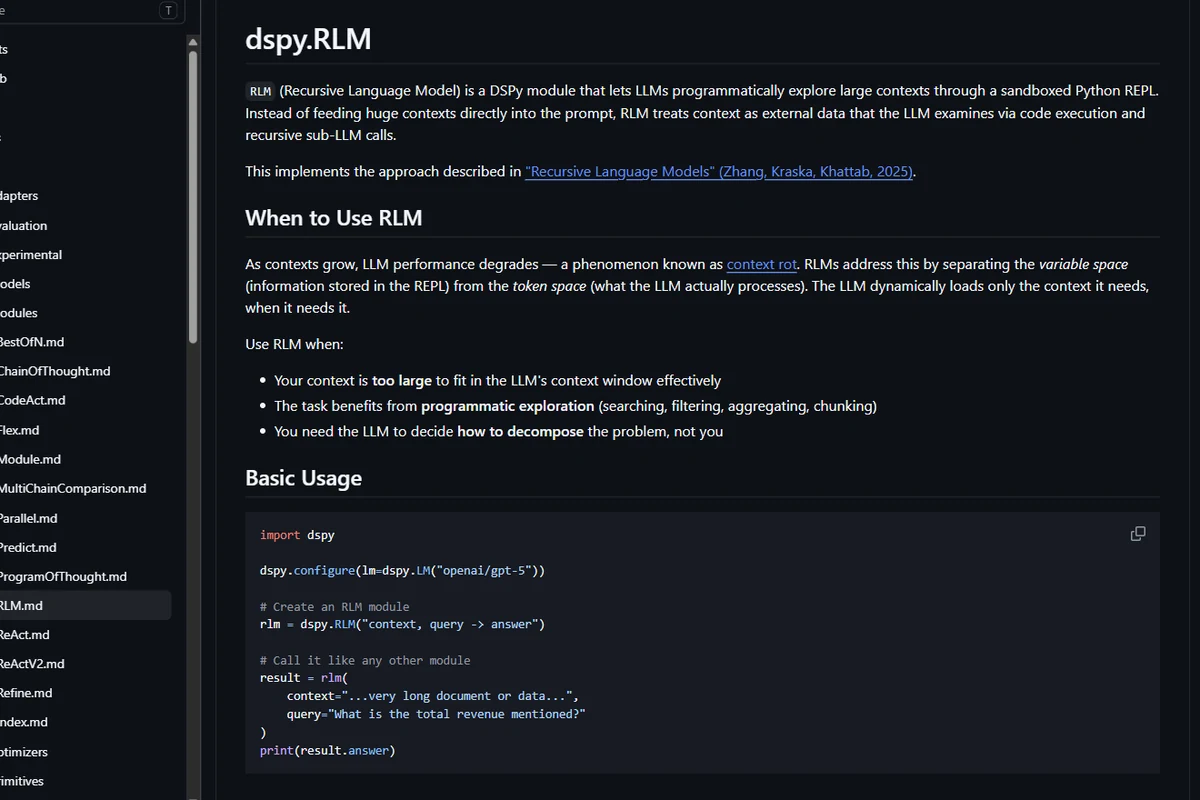
| Ambiente | Isolamento | Uso indicado |
|---|---|---|
| rlms, ambiente local | Nenhum: roda no mesmo processo | Só teste na própria máquina; o README desaconselha em produção |
| dspy.RLM, padrão (Deno e Pyodide) | Sandbox sem rede nem arquivos da máquina | Protótipo com documentos reais |
| dspy.RLM, LocalInterpreter | Nenhum: a documentação diz que não é sandbox | Depuração com dados sem valor |
Fonte: README do pacote rlms 0.1.3 (junho de 2026); documentação do dspy.RLM.
Como a Veredas pôs 52 milhões de tokens numa variável
Caio começou pelo formato. Em vez de um único texto gigante, montou context como uma lista de 6.400 textos, um por documento. Na primeira linha de cada um, acrescentou um cabeçalho padronizado com empreendimento, tipo de documento, data e código interno. Esse cabeçalho custou dois dias de limpeza e é o que permite ao modelo raiz filtrar sem ler.
Na simulação, Caio usa a aproximação de quatro caracteres por token: 52 milhões de tokens equivalem a cerca de 208 milhões de caracteres. Ele adota blocos de até 500 mil caracteres como hipótese inicial do exercício. Um documento de 1,9 milhão de caracteres exigiria pelo menos quatro blocos nessa conta. Na implementação, é preciso medir tokens, reservar espaço para instruções e resposta e verificar se cada bloco conserva o sentido.
O acervo medido em caracteres
208 mi
caracteres no acervo
52 milhões de tokens × 4 caracteres por token
500 mil
caracteres por llm_query
Hipótese de tamanho do exercício; medir tokens no piloto
1,9 mi
caracteres no maior documento
Estudo de impacto ambiental; vira 4 pedaços
6.400
textos na lista context
Um por documento, cada um com cabeçalho
Fonte: Veredas Ambiental, cenário composto; limite de subchamada do artigo RLM v3 (maio de 2026).
Aprofundamento de implementação. A sequência a seguir requer Python e um ambiente isolado. Você pode acompanhá-la com a equipe responsável: confira os dados de entrada, o limite de acesso e a evidência produzida, mesmo que não execute o código.
# Metadados que o modelo raiz recebe no primeiro turno (cenário da Veredas).
# Ele NÃO recebe o conteúdo de context, só esta descrição.
metadados = {
    'tipo': 'list[str]',
    'itens': 6400,
    'caracteres_totais': 208_000_000,
    'maior_item': 1_900_000,
    'formato_do_item': 'EMPREENDIMENTO: ... | TIPO: ... | DATA: AAAA-MM-DD | COD: ...',
    'prefixo': 'EMPREENDIMENTO: PCH Ribeirão Claro | TIPO: laudo de água | DATA: 2019-03-14 ...',
}

# Primeiro bloco repl que o modelo raiz escreveu: medir antes de ler.
import re
from collections import Counter
cabecalhos = [doc.split('\n', 1)[0] for doc in context]
por_tipo = Counter(re.search(r'TIPO: ([^|]+)', c).group(1).strip() for c in cabecalhos)
print(len(context), 'documentos')
print(por_tipo.most_common(12))   # a saída volta truncada ao histórico
No primeiro turno, o modelo raiz fez o que o desenho pede. Não leu nenhum documento: extraiu só os cabeçalhos, contou os tipos e descobriu que o acervo tinha 1.130 laudos de água, 212 documentos de condicionantes e 96 pareceres do órgão ambiental. A saída coube em algumas centenas de caracteres e voltou inteira. No segundo turno, filtrou os documentos de condicionantes e espiou os 2.000 primeiros caracteres de um deles.
Dessa espiada saiu um formato que Caio não tinha documentado. Os documentos de condicionantes da maioria dos empreendimentos traziam uma tabela com número, descrição, prazo e situação, mas os de quatro empreendimentos antigos listavam as condicionantes em texto corrido. O modelo raiz registrou isso numa variável e, no terceiro turno, escreveu dois filtros diferentes, um para cada formato.
| Item | No REPL (variáveis) | No histórico do raiz |
|---|---|---|
| Acervo | 6.400 documentos, cerca de 208 milhões de caracteres | Metadados de cerca de 300 tokens |
| Contagem por tipo | Dicionário completo com todos os tipos | As 12 linhas impressas |
| Documentos de condicionantes | Lista com 212 textos inteiros | O tamanho da lista e 2.000 caracteres de um item |
| Código escrito | Executado e descartado | Os três blocos, cerca de 400 tokens cada |
| Total após três turnos | O acervo inteiro, intocado | Cerca de 9 mil tokens |
Cenário composto da Veredas. Histórico: 300 de metadados + 3 × 400 de código + 3 × 2.500 de saída (10 mil caracteres ÷ 4) = 9.000 tokens.
A conta da tabela mostra por que o desenho escala. Depois de três turnos, o modelo raiz carrega cerca de 9 mil tokens, contra 52 milhões no acervo. Ao preço de referência do GPT-5, o modelo raiz do artigo, US$ 1,25 por milhão de tokens de entrada, o terceiro turno custa pouco mais de um centavo de dólar. O dinheiro vai para as subchamadas, que leem de fato.
Caio também anotou o que o cabeçalho não resolvia. Dos 6.400 documentos, 140 não tinham data legível no arquivo original e ficaram com a data marcada como desconhecida. O filtro por data ignoraria esses 140 em silêncio. Ele deixou a regra explícita no cabeçalho, com o valor desconhecido escrito por extenso, para que qualquer código que filtrasse por data tivesse de decidir o que fazer com eles.
Helena fez a pergunta que todo gestor faz nesse ponto: se o modelo raiz nunca lê os documentos, como ela confia na resposta? Caio mostrou o rastro. Cada bloco de código, cada saída truncada e cada variável ficam registrados, e o filtro que separou os 212 documentos de condicionantes é uma expressão regular que ela pode ler e contestar. A confiança passa a depender de um rastro auditável, e não de uma impressão sobre o texto gerado.
Em que Helena confia quando o raiz não lê os documentos
Confiar no texto gerado
Antes
- A resposta chega sem o caminho que a produziu
- O erro só aparece quando o cliente reclama
- A discussão gira em torno de impressões
Confiar no rastro da execução
Com o REPL
- Cada bloco de código e cada saída ficam registrados
- O filtro dos 212 documentos é uma expressão regular legível
- Helena contesta o passo errado, e não só o resultado
No exemplo, Caio configura o PythonInterpreter sem liberar arquivos, rede ou variáveis de ambiente da empresa ao código gerado. Ele também revisa as ferramentas do processo hospedeiro e quais trechos podem ser enviados ao provedor de modelos. São controles diferentes: isolar a execução não transforma uma chamada de API em processamento local.
Guia prático para marketing: avaliações e comentários numa variável. A ideia deste capítulo resolve uma tarefa que toda equipe de marketing adia, que é ler de verdade milhares de avaliações de loja, comentários de redes sociais e respostas abertas de pesquisa. O passo a passo abaixo usa a biblioteca oficial rlms, versão 0.1.3, com o acervo inteiro guardado na variável do REPL e o modelo raiz programando a leitura.
Ver como texto
Diagrama do RLM: o pedido longo é carregado como variável dentro de um ambiente Python, o modelo raiz escreve código que imprime trechos e divide o texto, e chamadas recursivas de profundidade 1 recebem cada parte e devolvem sub-respostas que viram a resposta final.
Ler 20 mil avaliações de clientes com o acervo numa variável
Seis passos, do arquivo exportado à contagem por tema com evidência. Reserve meia hora para o primeiro ciclo.
Passo 1: Exporte as avaliações num CSV com uma linha por avaliação
Colunas mínimas: id, data, canal (Google, marketplace, Instagram, pesquisa), nota e texto. Junte as fontes num arquivo só.
Deu certo quando: O arquivo abre na planilha sem quebra de linha dentro do texto e o total de linhas bate com o painel de cada canal.
Erro comum: Exportar o texto sem o id. Sem id, nenhuma resposta do RLM pode ser conferida depois.
Passo 2: Retire nome, e-mail, telefone e número de pedido antes de qualquer chamada
Uma expressão regular por padrão resolve a maior parte; o resto sai numa revisão por amostragem.
Deu certo quando: Uma busca por “@” e por sequências de 8 ou mais dígitos devolve zero linhas.
Erro comum: Mandar dado pessoal ao provedor do modelo porque a tarefa parecia só de leitura.
Passo 3: Meça o tamanho antes de escolher o método
Conte os tokens do arquivo com o tokenizador do modelo. Se o acervo e a pergunta cabem com folga na janela nativa e a pergunta é pontual, uma chamada comum basta.
Deu certo quando: Você sabe quantos tokens tem e por que o RLM é a escolha, e não um hábito.
Erro comum: Usar RLM para 300 avaliações. O custo das iterações supera o ganho.
Passo 4: Carregue a lista de avaliações como contexto e peça primeiro só o reconhecimento
Passe o acervo em prompt e a pergunta em root_prompt. A primeira instrução pede ao modelo que imprima o total, as colunas e cinco linhas de amostra.
Deu certo quando: O log mostra print(len(...)) e uma amostra coerente com o CSV antes de qualquer subchamada.
Erro comum: Pedir a análise inteira de saída. O modelo raiz corta o acervo sem conhecer o formato e mistura colunas.
Passo 5: Escreva a pergunta com definição operacional de cada tema
Exemplo: “reclamação de entrega = atraso, extravio ou produto avariado no transporte”. Peça contagem por tema e por mês, com três ids de exemplo por célula.
Deu certo quando: A resposta traz uma tabela tema × mês e, em cada célula, ids que existem no CSV.
Erro comum: Perguntar “do que os clientes reclamam?”. Cada subchamada inventa sua própria lista de temas e a soma deixa de fazer sentido.
Passo 6: Sorteie 30 ids citados e confira à mão
Leia o texto original de cada id e marque se o tema atribuído está certo.
Deu certo quando: Ao menos 27 dos 30 batem. Abaixo disso, ajuste as definições e rode de novo.
Erro comum: Aceitar a contagem porque os números parecem plausíveis.
No fim você tem: Uma tabela de temas por mês com ids verificáveis, pronta para virar pauta de produto, de atendimento e de anúncio.
Analista de CRM de um e-commerce de cosméticos
Varejo digital, vendas pelo site próprio e por dois marketplaces
Dor
Eram 18.400 avaliações em 12 meses, espalhadas em três painéis. A equipe lia as 50 mais recentes e decidia campanhas pelo que lembrava.
Solução
O acervo foi exportado, limpo de dado pessoal e lido com rlms: modelo raiz grande, subchamadas num modelo menor, oito temas com definição escrita e contagem por mês com ids.
Resultado do exemplo
A queixa sobre embalagem vazando apareceu concentrada em dois meses e num só centro de distribuição. A correção virou tarefa de logística, e o anúncio que prometia “chega perfeito” saiu do ar até a troca do fornecedor.
Custo estimado no exemplo: Uma execução completa custou menos que uma hora de leitura manual; a conferência dos 30 ids levou 25 minutos.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Peça um desenho que mostre o acervo, o ambiente de execução e as chamadas ao modelo. Confira quais dados atravessam cada fronteira e quem pode acessá-los. O limite de cada parte precisa considerar o modelo, a tarefa e o orçamento; um tamanho fixo em caracteres não garante que a resposta terá qualidade.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- As palavras que mudam a conta de IA e o que mudou desde 2024sugerido pelo grafoApresenta o conceito “Prompt”, usado em “Como o acervo fica disponível fora da conversa”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAstra profundosugerido pelo grafo2 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Astra profundo”.
O mesmo assunto em outros cursos
- Agentes de IA autônomos: como delegar e acompanharComo o agente age, confere e decide quando pararExaminar conexões de Como o agente age, confere e decide quando parar
- Frontends com VibecodingConstruir as cenas do orquestrador, do paralelismo e do robôExaminar conexões de Construir as cenas do orquestrador, do paralelismo e do robô
- Avaliar e melhorar agentesEntender o aprendizado em tarefas com várias etapasExaminar conexões de Entender o aprendizado em tarefas com várias etapas
- Prompt Engineering para ExecutivosAs palavras que mudam a conta de IA e o que mudou desde 2024Examinar conexões de As palavras que mudam a conta de IA e o que mudou desde 2024
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.