RLM: grandes acervos · Capítulo 5 de 30 · 14 min
Como conhecer o acervo antes de dividi-lo
Explore documentos com código antes de dividir o contexto para o RLM. Use amostras, filtros e contagens para preservar relações entre clientes, datas e assuntos ao separar as partes.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: Um acervo pode estar organizado por cliente, data, assunto ou tipo de documento. Cortá-lo em blocos iguais sem olhar essa estrutura pode separar uma obrigação de sua atualização. Caio começa pela inspeção: formatos, identificadores, períodos e relações. Assim, a divisão preserva o sentido da pergunta de Helena.
Palpite custa caro nos dois sentidos. Um corte fino demais dispara centenas de subchamadas que leem texto irrelevante e cobram por cada token. Um corte grosso demais separa a condicionante do laudo que a contradiz, e a resposta sai limpa, bem escrita e errada, sem nenhum sinal de alerta.
Ao terminar, você reconhece três gestos de exploração que custam quase nada: espiar, filtrar por padrão e contar em código. Sabe ler o que eles revelam sobre a estrutura do material e escolhe a unidade de divisão a partir da pergunta de negócio.
Ver como texto
Três zonas de corte: fino demais, pela pergunta e grosso demais, com o efeito de cada uma
Por que olhar antes de cortar muda a resposta
Alex L. Zhang descreveu esses gestos em outubro de 2025, no post de blog que apresentou os RLMs, assinado com Omar Khattab. Ao observar as execuções, ele deu nome ao que os modelos faziam sem que ninguém pedisse. O primeiro padrão é o peeking, ou espiar: o modelo raiz sabe o tamanho do contexto, mas não o conteúdo, e por isso imprime o começo. No exemplo do OOLONG, um benchmark de agregação sobre texto longo, eram os primeiros 2.000 caracteres.
Em seguida vem o grepping: usar palavra-chave ou expressão regular para estreitar as linhas de interesse. Expressão regular é um padrão de busca escrito em código, como um filtro de planilha que aceita variações de grafia. O autor registra que o modelo prefere esse filtro exato à busca semântica, aquela que acha trechos parecidos em significado e que o RAG da Veredas usava.
Os outros três padrões do post dependem desses dois. Partition + Map divide o contexto em pedaços e roda uma subchamada por pedaço. Summarization resume subconjuntos para o modelo de fora decidir. Long-input, long-output cuida de saídas extensas, como gerar o BibTeX de uma lista inteira de artigos. Esta trilha segue essa ordem: reconhecer, dividir, processar e juntar.
O que o post de outubro de 2025 mediu, em experimento preliminar
2.000
caracteres na primeira espiada
exemplo do OOLONG: o raiz conhece o tamanho e imprime só o começo
+34 pontos
OOLONG trec_coarse a 132 mil tokens
RLM com GPT-5-mini contra GPT-5 direto (cerca de +114%), custo por consulta parecido
+15 pontos
OOLONG a cerca de 263 mil tokens
mesma comparação (cerca de +49%), mais barato na média
1.000
documentos no BrowseComp-Plus sem degradar
mais de 10 milhões de tokens, em 20 consultas sorteadas
Fonte: Zhang, A. e Khattab, O., Recursive Language Models (blog), outubro de 2025
Explorar em código tem uma razão técnica no desenho do laço. Pelo algoritmo do artigo de Zhang, Kraska e Khattab, só um prefixo curto da saída de cada comando volta ao histórico do modelo raiz; o resto fica guardado em variáveis. Um print do acervo inteiro seria truncado e ensinaria pouco. Contar tipos, agrupar cabeçalhos e listar códigos devolve pouca saída e muita informação sobre a forma do material.
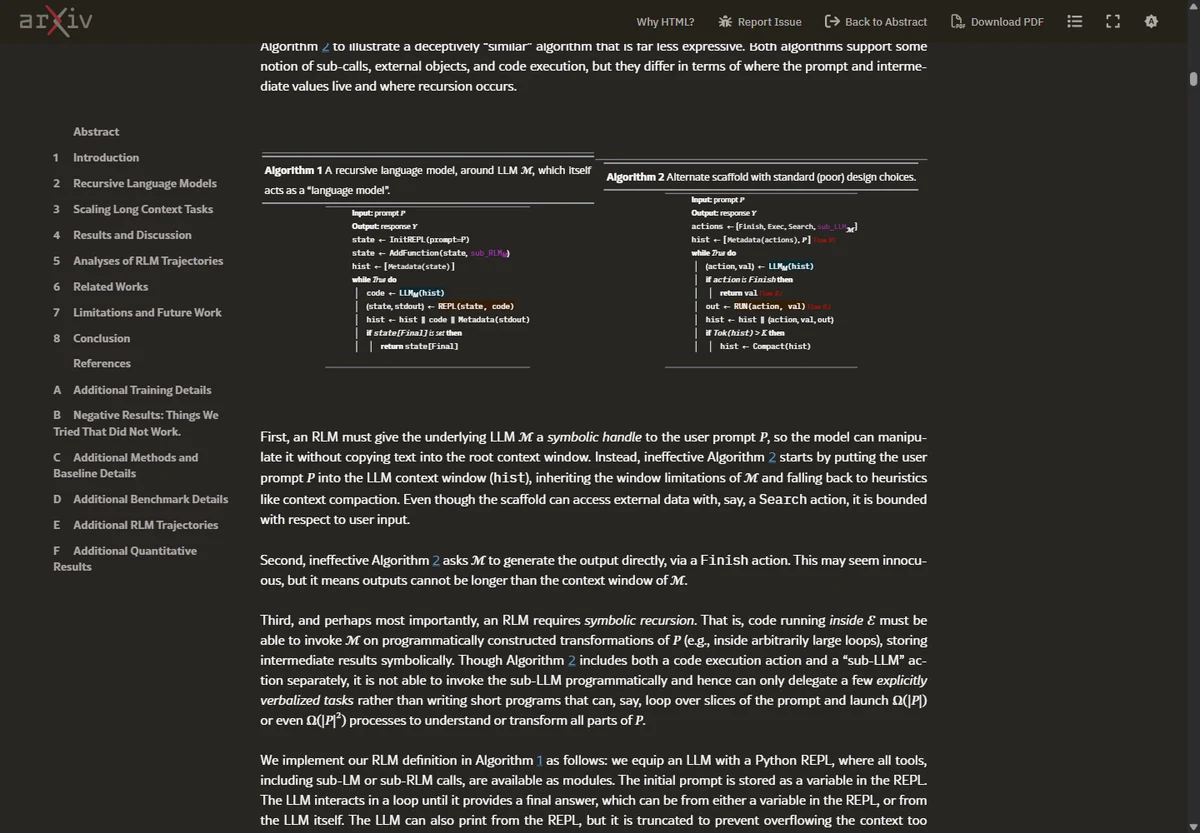
Os metadados iniciais também seguem o artigo. O modelo raiz recebe informação de tamanho constante: o tipo do contexto, o comprimento total em caracteres, os tamanhos dos pedaços, um prefixo curto e a forma de acessar o conteúdo. Tamanho constante quer dizer que a ficha de apresentação de um acervo de mil páginas ocupa o mesmo espaço que a de um acervo de um milhão. O resto, o raiz descobre escrevendo código.
Cada implementação põe o seu teto na saída que volta. No dspy.RLM, o parâmetro max_output_chars tem padrão de 10 mil caracteres, e a versão 3.2.0, de abril de 2026, fixou em 1.000 caracteres a prévia de cada variável. No desenho da Prime Intellect, a saída do REPL fica em 8.192 caracteres por turno. Quem explora com print longo gasta o turno e recebe um recorte; quem explora com contagens recebe a resposta inteira.
Quanto rende explorar só com código aparece numa linha da Tabela 1 do artigo, na versão de maio de 2026. A profundidade 0 é o RLM sem subchamadas: o modelo raiz tem o REPL, filtra, conta e responde, mas não chama outro modelo. A profundidade 1 acrescenta as subchamadas, que no caso do GPT-5 vão ao GPT-5-mini.
| Configuração | CodeQA | BrowseComp+ (1K docs) | OOLONG | OOLONG-Pairs |
|---|---|---|---|---|
| GPT-5, profundidade 0 | 58,0 | 88,0 | 36,0 | 43,9 |
| GPT-5, profundidade 1 | 62,0 | 91,3 | 56,0 | 58,0 |
| Qwen3-Coder-480B, profundidade 0 | 66,0 | 46,0 | 43,5 | 17,3 |
| Qwen3-Coder-480B, profundidade 1 | 56,0 | 44,7 | 48,0 | 23,1 |
Acurácia em %, exceto OOLONG-Pairs (F1). CodeQA de 23 mil a 4,2 milhões de tokens; BrowseComp+ de 6 a 11 milhões; OOLONG com 131 mil; OOLONG-Pairs com 32 mil.
Fonte: Zhang, Kraska e Khattab, Recursive Language Models, v3 (maio de 2026), Tabela 1
Lida com cuidado, a tabela diz duas coisas. Com GPT-5, o REPL sozinho já chega a 88,0 no BrowseComp+, onde a resposta pode ser localizada por padrão; as subchamadas acrescentam pouco ali. No OOLONG e no OOLONG-Pairs, que pedem julgamento semântico sobre cada trecho, as subchamadas somam 20 e 14 pontos. Com Qwen3-Coder, a profundidade 0 vence todas as variantes com subchamadas no CodeQA.
Explorar também contém a conta. O artigo relata que o GPT-5 faz subchamadas “on the order of ten” por consulta, enquanto o Qwen3-Coder chegou a centenas ou milhares numa consulta simples e precisou de uma linha extra no prompt para parar. Um modelo raiz que conhece a forma do acervo antes de dividir tem menos motivo para mandar cada linha a uma subchamada.
Filtros por padrão têm um limite que a pressa esconde. Armadilha comum: tratar o resultado do filtro como inventário completo. Uma expressão regular procura “condicionante” e não acha “condicio-” quebrado no fim de linha de um PDF digitalizado, nem “cond.” abreviado, nem “hidrico” sem acento. O filtro devolve uma lista plausível, e ninguém percebe o que ficou de fora até uma resposta sair curta.
| Variação | Exemplo | Conserto em código |
|---|---|---|
| Palavra quebrada no fim da linha | “condicio-” e “nante” em linhas separadas | Juntar hífen seguido de quebra antes de filtrar |
| Abreviação | “cond.” no lugar de “condicionante” | Incluir as abreviações conhecidas no padrão |
| Acento ausente | “hidrico” em vez de “hídrico” | Remover acentos do texto e do padrão antes de comparar |
Escolher a unidade de divisão pela pergunta
Depois de reconhecer o acervo, o modelo raiz decide como cortar. Há quatro unidades comuns: tamanho fixo (blocos de N caracteres), documento, entidade de negócio (um empreendimento, uma condicionante) e período. A escolha certa é a unidade onde a resposta mora. Se a pergunta cruza uma condicionante com os laudos que a verificam, os dois precisam cair no mesmo pedaço, ou a subchamada nunca os vê juntos.
Cada pedaço precisa caber na chamada que o analisará. Os 500 mil caracteres citados no prompt do artigo são uma referência daquela configuração, não um limite universal do RLM. Meça com o tokenizador do modelo escolhido e reserve espaço para instruções e resposta. Se um grupo ultrapassar o limite definido para o piloto, divida preservando referências entre as partes e confira a qualidade.
O tempo também pode ser a unidade. Uma condicionante vence numa data, e um laudo só a contradiz se for do período que ela cobre. Quando a pergunta depende de prazo, o grupo precisa levar as datas junto, e o reconhecimento deve medir de que ano a que ano vai cada tipo de documento. Um corte que separa a licença de 2019 da renovação de 2023 produz vencimentos que não existem.
Duas maneiras de decidir o corte
Cortar pelo tamanho da janela
Coluna a evitar
- Blocos de tamanho fixo, escolhidos pela capacidade do modelo
- Condicionante e laudo podem cair em blocos diferentes
- Toda subchamada lê tudo, inclusive o que não interessa
- A prova de cada item depende da sorte do corte
Cortar pela unidade da pergunta
Coluna recomendada
- Grupos formados pela entidade que a pergunta cita
- Documentos que se citam ficam no mesmo pedaço
- Código filtra antes; a subchamada lê só o grupo
- Grupo grande demais é dividido de novo, até caber
Esse vocabulário está convergindo. O λ-RLM, proposto em março de 2026 por pesquisadores do IIT Delhi e do Huawei Noah's Ark, troca o código livre por combinadores fixos com nomes como Split, Peek, Map, Filter e Reduce. São os mesmos gestos do post de Zhang, agora em forma de peças verificadas. A trilha de perspectivas volta a ele; por ora, os nomes ajudam a descrever uma execução.
Como a Veredas mapeou o acervo antes do primeiro corte
Caio carregou o acervo como uma lista de 6.400 textos, um por documento, com uma linha de cabeçalho em cada: código do empreendimento, tipo, data e número do processo. Os metadados que o modelo raiz recebeu diziam lista, 6.400 itens e cerca de 208 milhões de caracteres. A conta do cenário usa 4 caracteres por token: 208 milhões divididos por 4 dão os 52 milhões de tokens do acervo.
Aprofundamento de implementação. A sequência a seguir requer Python e um ambiente isolado. Você pode acompanhá-la com a equipe responsável: confira os dados de entrada, o limite de acesso e a evidência produzida, mesmo que não execute o código.
# Turnos de reconhecimento que o modelo raiz escreveu no REPL da Veredas.
# `context` é a lista de 6.400 documentos; nada disso chama subchamada.
import re, collections, unicodedata

print(type(context), len(context))       # <class 'list'> 6400
print(context[0][:2000])                  # espiar: 2.000 caracteres do primeiro

# Contar tipos pelo cabeçalho (primeira linha de cada documento)
cabecalhos = [doc.split("\n", 1)[0].split("|") for doc in context]
print(collections.Counter(c[1].strip() for c in cabecalhos).most_common())

# Filtro por padrão, já com a normalização que Helena pediu
def normalizar(txt):
    txt = re.sub(r"-\n", "", txt)            # junta palavra quebrada no fim da linha
    txt = unicodedata.normalize("NFKD", txt)
    return "".join(ch for ch in txt if not unicodedata.combining(ch)).lower()

padrao = re.compile(r"(condicionante|cond\.)\s*n?[o.]*\s*(\d+)")
mencoes = [(i, m.group(2)) for i, doc in enumerate(context)
           for m in padrao.finditer(normalizar(doc))]
print(len(mencoes), len({i for i, _ in mencoes}))   # 1489 571
No segundo turno, o modelo contou os tipos pelo cabeçalho e devolveu uma tabela de seis linhas, sem ler o corpo de nenhum documento. Helena reconheceu o acervo na hora, com uma surpresa: os relatórios de monitoramento eram mais numerosos que as planilhas de laboratório, e os estudos de impacto, poucos, concentravam mais de um quarto dos tokens.
| Tipo de documento | Documentos | Tokens (milhões) |
|---|---|---|
| Estudos de impacto ambiental | 190 | 14,6 |
| Relatórios de monitoramento de água e fauna | 2.310 | 17,3 |
| Planilhas de laboratório | 1.720 | 7,4 |
| Pareceres do órgão ambiental | 880 | 6,1 |
| Atas e correspondência | 660 | 3,4 |
| Licenças e condicionantes | 640 | 3,2 |
| Total | 6.400 | 52,0 |
Cenário ilustrativo da Veredas Ambiental. Tokens estimados a 4 caracteres por token.
O terceiro turno aplicou o filtro de condicionantes. A primeira versão, sem normalização, achou 1.212 menções em 489 documentos. Helena desconfiou do número e leu 40 PDFs digitalizados por amostragem: encontrou palavras quebradas no fim da linha, “hidrico” sem acento e “cond.” abreviado. Com a normalização do código acima, o filtro passou a 1.489 menções em 571 documentos. A versão ingênua perdia 277 menções, 18,6% do total.
Nos dois turnos seguintes, o modelo agrupou as menções por empreendimento e número de condicionante e mediu o tamanho de cada grupo. Resultado: 214 condicionantes de monitoramento hídrico distintas nos 38 empreendimentos. A mina e a barragem de rejeito, os dois processos com mais condicionantes hídricas, somam 31 delas. O material ligado a cada condicionante tem mediana de 180 mil caracteres, e 17 grupos passam de 500 mil.
A espiada evitou um erro de divisão antes que ele custasse. A primeira ideia de Caio era dividir por documento, uma subchamada por arquivo. A contagem de tamanhos mostrou que 23 dos 190 estudos de impacto passam de 500 mil caracteres e que 1.100 atas e planilhas têm menos de 2 mil caracteres cada. Dividir por documento mandaria textos grandes demais para uma ponta e milhares de chamadas quase vazias para a outra.
Medir as datas completou o mapa. Os relatórios de monitoramento vão de 2012 a 2026, com picos trimestrais. As condicionantes mudam de número a cada renovação de licença, e 9 dos 38 empreendimentos renovaram a licença pelo menos uma vez no período. Esse detalhe voltaria mais tarde, quando um laudo citasse a condicionante pelo número antigo.
- Etapa 1 de 5: Ler os metadados
lista, 6.400 itens, cerca de 208 milhões de caracteres
- Etapa 2 de 5: Espiar o primeiro documento
2.000 caracteres revelam o cabeçalho com código, tipo e data
- Etapa 3 de 5: Contar tipos pelo cabeçalho
seis tipos; estudos de impacto somam 14,6 milhões de tokens
- Etapa 4 de 5: Filtrar condicionantes
1.212 menções na versão ingênua, 1.489 com normalização
- Etapa 5 de 5: Medir os grupos
214 condicionantes; 17 grupos acima de 500 mil caracteres
Ver como texto
- Ler os metadados: lista, 6.400 itens, cerca de 208 milhões de caracteres
- Espiar o primeiro documento: 2.000 caracteres revelam o cabeçalho com código, tipo e data
- Contar tipos pelo cabeçalho: seis tipos; estudos de impacto somam 14,6 milhões de tokens
- Filtrar condicionantes: 1.212 menções na versão ingênua, 1.489 com normalização
- Medir os grupos: 214 condicionantes; 17 grupos acima de 500 mil caracteres
O reconhecimento inteiro custou centavos. Foram seis turnos do modelo raiz, contando o que propôs as divisões, com histórico médio de 12 mil tokens por turno e 700 tokens de saída. A preços de referência do GPT-5, o raiz do artigo (US$ 1,25 por milhão de tokens de entrada e US$ 10 por milhão de saída): 72 mil tokens de entrada custam US$ 0,09, e 4.200 de saída custam US$ 0,04. Total perto de US$ 0,13, sem nenhuma subchamada.
Com o mapa pronto, Caio desenhou duas divisões candidatas. A primeira corta o acervo em blocos fixos de 200 mil caracteres, cerca de 50 mil tokens, e manda cada bloco a uma subchamada. A segunda forma um grupo por condicionante, com o texto da condicionante, os laudos e os pareceres que citam seu número, e divide de novo os 17 grupos grandes demais.
Helena pediu um ensaio antes de qualquer execução no acervo inteiro: rodar as duas divisões nos dois empreendimentos com mais condicionantes hídricas, a mina e a barragem, cerca de 900 mil tokens, contra uma lista de referência escrita por ela. A escolha do recorte foi deliberada. É o mesmo material que o teste de contexto longo já tinha usado, o que permite comparar as três leituras sobre a mesma base.
Compare duas divisões usando a mesma amostra. Observe documentos omitidos, relações rompidas, chamadas e custo. Escolha a menor divisão que mantenha a evidência necessária, com limites definidos para esse ensaio. O passo seguinte é verificar como as respostas parciais serão reunidas.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAstra profundosugerido pelo grafo2 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Astra profundo”.
- CursoIA local na práticasugerido pelo grafo3 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “IA local na prática”.
O mesmo assunto em outros cursos
- Prompt Engineering para ExecutivosAprofundamento: as instruções antigas que hoje dão erroExaminar conexões de Aprofundamento: as instruções antigas que hoje dão erro
- Segundo cérebro com IAPor que informação demais pode piorar a resposta da IAExaminar conexões de Por que informação demais pode piorar a resposta da IA
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.