RLM: grandes acervos · Capítulo 6 de 30 · 23 min
Como reunir respostas sem perder as provas
Processe as partes do acervo e agregue as respostas do RLM com citações verificáveis. Confira duplicações, divergências e o caminho entre cada conclusão e seu documento de origem.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: Dividir a leitura só ajuda se as respostas parciais puderem ser conferidas. No caso da Veredas, uma contagem precisa chegar acompanhada dos documentos que a sustentam. Agregar significa juntar essas partes, eliminar duplicações e explicar os conflitos, em vez de apenas resumir o que cada chamada disse.
Errar aqui não faz barulho. Uma subchamada que responde “há laudo contraditório” sem dizer qual laudo entrega a Helena uma afirmação que ela não consegue conferir nem defender diante do órgão ambiental. Multiplique por 214 condicionantes e o relatório vira opinião bem formatada.
Ao terminar, você desenha o pedido de cada subchamada como um registro com campos fixos e junta os registros em código em vez de pedir um resumo. Também confere os pares suspeitos numa segunda passada e devolve uma resposta maior que a janela do modelo.
Ver como texto
Uma subchamada devolve um registro com campos fixos, e o código valida a prova antes de contar
Por que o formato da resposta parcial decide a qualidade do todo
O padrão Partition + Map, do post de Zhang de outubro de 2025, divide e manda cada pedaço a uma chamada. O artigo de Zhang, Kraska e Khattab explica por que isso só funciona dentro do REPL. A terceira escolha de desenho que eles dizem faltar em outros andaimes é a recursão simbólica: o código chama o modelo sobre pedaços construídos por programa, dentro de laços, quantas vezes for preciso.
Os autores escrevem que o laço pode chamar llm_query Ω(|P|) ou Ω(|P|²) vezes. Traduzindo: um número de chamadas que cresce com o tamanho da entrada, ou com o quadrado dele, como comparar cada documento com todos os outros. Um agente em que a subchamada é uma ação escrita na conversa não consegue isso; o artigo chama esse desenho de falha nº 3, porque a ação verbalizada não entra num laço.
Para disparar várias subchamadas ao mesmo tempo existe llm_query_batched, que recebe uma lista de pedidos e devolve uma lista de respostas, como mandar dez cartas no mesmo malote. A biblioteca rlms oferece a função e limita o paralelismo por max_concurrent_subcalls. Nos experimentos do artigo, todas as chamadas foram bloqueantes e sequenciais, e o blog avisa que não havia cache de prefixo; a latência publicada é a do pior arranjo.
Some as subchamadas antes de executar
No dspy.RLM, max_llm_calls tem padrão de 50 chamadas por execução e max_iters, de 20 turnos do REPL; o nome antigo max_iterations mudou na versão 3.3.0, de agosto de 2026.
- Uma divisão que pede 400 subchamadas estoura o padrão na primeira execução.
- Descubra isso na conta do reconhecimento, e não no meio da leitura.
- Código antigo com max_iterations precisa de ajuste nas versões atuais.
O teste: A conta do reconhecimento prevê menos subchamadas que o teto configurado?
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
Juntar as respostas pede outra decisão. O padrão Summarization do blog resume subconjuntos para o modelo de fora decidir, e o autor chama os RLMs de generalização natural das estratégias de resumo. A diferença está no que sobra depois. Um resumo descarta o detalhe que um par de documentos vai precisar mais adiante; o REPL guarda cada resposta parcial numa variável, e o raiz combina em código.
| Método | CodeQA | BrowseComp+ (1K docs) | OOLONG | OOLONG-Pairs |
|---|---|---|---|---|
| Agente de compactação (GPT-5-nano resume) | 58,0 (US$ 1,31) | 70,5 (US$ 0,57) | 46,0 (US$ 0,13) | 0,1 (US$ 0,13) |
| RLM, profundidade 1 | 62,0 (US$ 0,11) | 91,3 (US$ 0,99) | 56,0 (US$ 0,43) | 58,0 (US$ 0,33) |
| RLM, profundidade 3 | 58,0 (US$ 0,15) | 92,0 (US$ 0,51) | 58,0 (US$ 0,51) | 76,0 (US$ 0,39) |
Acurácia em %, exceto OOLONG-Pairs (F1); custo médio de API por consulta entre parênteses. Subchamadas do RLM ao GPT-5-mini.
Fonte: Zhang, Kraska e Khattab, Recursive Language Models, v3 (maio de 2026), Tabela 1
O OOLONG-Pairs é o teste que mais se parece com a pergunta da Veredas: pede pares de itens que satisfazem uma condição, e o trabalho cresce com o quadrado da entrada. O agente de compactação marca 0,1 de F1, na prática zero, enquanto o RLM com profundidade 1 chega a 58,0 com custo médio menor. Os pares sumiram no resumo antes que alguém pudesse cruzá-los. Na mediana de todos os testes com GPT-5, o resumo da versão 3 registra ganho de 26% do RLM sobre a compactação.
Guardar em variáveis resolve metade do problema; a outra metade é o formato do que volta. Se cada subchamada devolve texto livre, o raiz precisa de outro modelo para juntar textos livres, e o erro reaparece. Armadilha comum: pedir à subchamada “comente o bloco” e depois pedir a um segundo modelo que “consolide os comentários”. A consolidação inventa números que nenhuma subchamada escreveu.
O λ-RLM mediu o custo do código livre com modelos abertos de até 405 bilhões de parâmetros e contextos de até 128 mil tokens. Na ablação em que o modelo volta a escrever código livre no lugar dos combinadores fixos, o OOLONG cai de 48,3% para 24,1% e a latência sobe de 62,4 s para 241,6 s. O resultado não inclui modelos fechados de fronteira, mas aponta a mesma direção: forma fixa reduz a variância.
O que a subchamada devolve ao modelo raiz
Resposta parcial em texto livre
Coluna a evitar
- Parágrafo com a opinião do modelo sobre o bloco
- Documento citado quando o modelo lembra
- Juntar exige outro modelo, que resume de novo
- Número final sem origem conferível
Resposta parcial em registro com prova
Coluna recomendada
- Campos fixos: empreendimento, condicionante, situação
- Id do documento e trecho literal obrigatórios
- Código valida o registro e descarta o que vem sem prova
- Contagem feita em Python sobre registros aceitos
Resta devolver a resposta. No artigo, o raiz encerra com FINAL(resposta) para texto curto ou FINAL_VAR(nome) para devolver uma variável do REPL; no dspy.RLM, o equivalente é SUBMIT(...). Devolver a variável permite uma saída maior que a janela do modelo, que é o padrão long-input, long-output do blog. Na biblioteca rlms 0.1.3, o modelo grava a resposta em answer["content"] e encerra ao marcar answer["ready"] como verdadeiro. Os autores relatam um ponto frágil: o modelo às vezes entrega o plano como se fosse a resposta.
Grupo grande demais levanta outra escolha: partir em código ou delegar a um sub-RLM, que tem REPL próprio e decide sozinho como dividir. A Tabela 1 do artigo mostra que profundidade maior não melhora de forma consistente. Com GPT-5, a profundidade 3 é a melhor no OOLONG-Pairs e piora no CodeQA. Com Qwen3-Coder, o OOLONG cai de 48,0 para 26,0 na profundidade 2, e os autores culpam erros de sintaxe que descem para os sub-RLMs.
A reprodução independente de Daren Wang, de março de 2026, reforça a cautela. Com DeepSeek v3.2 no OOLONG, o acerto sobe de 0,0% para 42,1% na profundidade 1 e desce a 33,7% na profundidade 2, numa amostra de 20 casos e execução única. Por isso a Veredas manteve a profundidade 1 e deixou a partição dos grupos grandes para o código, onde o corte é previsível e fácil de conferir.
- Etapa 1 de 6: Dividir em código
grupos pela unidade da pergunta; grupo grande é dividido de novo
- Etapa 2 de 6: Mapear em lote
llm_query_batched com pedido de registro em campos fixos
- Etapa 3 de 6: Validar cada registro
o código confere se o id existe e se o trecho está no documento
- Etapa 4 de 6: Cruzar os pares suspeitos
segunda subchamada lê só os dois trechos em conflito
- Etapa 5 de 6: Agregar em Python
contagem e tabela montadas sobre registros aceitos
- Etapa 6 de 6: Devolver a variável
FINAL_VAR no artigo, ou answer na biblioteca rlms, entrega a tabela inteira
Ver como texto
- Dividir em código: grupos pela unidade da pergunta; grupo grande é dividido de novo
- Mapear em lote: llm_query_batched com pedido de registro em campos fixos
- Validar cada registro: o código confere se o id existe e se o trecho está no documento
- Cruzar os pares suspeitos: segunda subchamada lê só os dois trechos em conflito
- Agregar em Python: contagem e tabela montadas sobre registros aceitos
- Devolver a variável: FINAL_VAR no artigo, ou answer na biblioteca rlms, entrega a tabela inteira
Como a Veredas comparou duas divisões para a mesma pergunta
O ensaio usou a mina e a barragem de rejeito, cerca de 900 mil tokens. Helena escreveu antes a lista de referência: nesses dois processos, 12 condicionantes de monitoramento hídrico estavam vencidas ou tinham laudos contraditórios. Caio rodou a pergunta de negócio duas vezes, uma com cada divisão, e guardou o rastro das duas execuções para conferir item por item.
Na divisão A, o acervo virou blocos fixos de 200 mil caracteres, 18 no total, e cada subchamada recebeu o pedido de listar condicionantes vencidas ou contraditórias no bloco, com evidência. Na divisão B, o código formou 31 grupos, um por condicionante; dois passavam de 500 mil caracteres e foram partidos ao meio, o que deu 33 leituras. Seis pares suspeitos ganharam uma subchamada de verificação: 39 no total.
Aprofundamento de implementação. A sequência a seguir requer Python e um ambiente isolado. Você pode acompanhá-la com a equipe responsável: confira os dados de entrada, o limite de acesso e a evidência produzida, mesmo que não execute o código.
# Divisão B: um grupo por condicionante, registro fixo e validação em código.
import json

PEDIDO = ("Leia a condicionante e os documentos abaixo. Responda só JSON: "
          '{"situacao": "vencida|contraditoria|em_dia", "doc_id": "...", "trecho": "..."}. '
          "O trecho deve ser copiado literalmente do documento citado.\n\n")

pedidos = [PEDIDO + g["texto"] for g in grupos]      # 33 leituras
respostas = llm_query_batched(pedidos)

aceitos, descartados = [], []
for g, r in zip(grupos, respostas):
    try:
        reg = json.loads(r)
    except json.JSONDecodeError:
        descartados.append((g["id"], "formato")); continue
    doc = documentos.get(reg.get("doc_id"))
    if doc is None or reg.get("trecho", "") not in doc:   # prova tem de existir
        descartados.append((g["id"], "sem prova")); continue
    aceitos.append({**reg, "condicionante": g["id"], "empreendimento": g["emp"]})

tabela = [r for r in aceitos if r["situacao"] != "em_dia"]
# Encerramento da biblioteca rlms 0.1.3 usada neste exemplo.
answer["content"] = json.dumps(tabela, ensure_ascii=False)
answer["ready"] = True| Medida | A: blocos fixos | B: grupos por condicionante |
|---|---|---|
| Subchamadas | 18 | 39 (33 leituras e 6 verificações) |
| Tokens lidos pelas subchamadas | 900 mil | 658 mil |
| Itens listados | 10 | 12 |
| Corretos pela referência de Helena (12) | 7 | 11 |
| Falsos positivos | 3 | 1 |
| Itens da referência perdidos | 5 | 1 |
| Itens com id de documento e trecho literal | 6 de 10 | 12 de 12 |
| Custo da execução | US$ 0,38 | US$ 0,35 |
| Tempo de relógio, 8 subchamadas em paralelo | 1 min 40 s | 3 min 10 s |
Cenário ilustrativo. Custo a preços de referência: GPT-5-mini nas subchamadas (US$ 0,25 e US$ 2 por milhão de tokens de entrada e saída) e cerca de US$ 0,10 do modelo raiz.
A conta do custo fecha assim. Na divisão A, 900 mil tokens de entrada a US$ 0,25 por milhão dão US$ 0,225, e 27 mil tokens de saída a US$ 2 por milhão dão US$ 0,054; com US$ 0,10 do raiz, US$ 0,38. Na divisão B, as leituras somam 610 mil tokens e as verificações 48 mil: 658 mil a US$ 0,25 dão US$ 0,16, e 47 mil de saída dão US$ 0,09. Com o raiz, US$ 0,35.
O tempo de relógio também entrou na comparação. Com oito subchamadas em paralelo, A terminou em 1 min 40 s. B levou 3 min 10 s, porque as seis verificações só começam depois das leituras e o raiz gastou dois turnos a mais montando os grupos. Para uma pergunta que Helena responde ao cliente em dias, a diferença não pesou; numa consulta ao vivo durante uma reunião, pesaria.
Com os registros aceitos, a agregação é Python comum. Um Counter por empreendimento conta as condicionantes vencidas, um dicionário junta as contradições por ponto de coleta, e cada linha da tabela final carrega o id do documento e o trecho. Pedir ao modelo que conte reabriria a porta para número inventado. O código conta o que está na lista e nada mais.
Os cinco itens que A perdeu contam a história da divisão. Em três, a condicionante e o laudo que a contradizia caíram em blocos diferentes, e nenhuma subchamada viu os dois. Nos outros dois, uma planilha de laboratório foi cortada no meio da tabela, na fronteira entre blocos. Os três falsos positivos de A eram condicionantes vencidas no papel cuja prorrogação estava noutro bloco.
Ver como texto
Blocos fixos cortam entre a condicionante e o laudo que a contradiz; o grupo por condicionante mantém os dois juntos
Na divisão B, os dois erros voltaram ao filtro. O falso positivo era uma condicionante cumprida por um ofício que não citava o número dela, e o filtro não o pôs no grupo. O item perdido era um laudo que citava a condicionante pelo número antigo, anterior à renovação da licença. Helena anotou os dois casos como regras para a próxima versão do filtro.
A segunda passada fez diferença mensurável. Das 33 leituras, seis apontaram contradição entre laudo e relatório. Cada verificação recebeu só os dois trechos em conflito, perto de 8 mil tokens, e a pergunta de se falavam do mesmo ponto de coleta, do mesmo parâmetro e da mesma unidade. Quatro contradições se confirmaram. Duas caíram: numa, um laudo media em mg/L e o outro em µg/L; na outra, os pontos de coleta eram diferentes.
Helena decidiu por B e fixou uma regra de conduta que vale para o resto do projeto: item sem id de documento e trecho literal não entra na tabela entregue ao cliente, por mais plausível que pareça. Na execução B, o código descartou dois registros por falta de prova antes da agregação, e nenhum dos dois estava na lista de referência.
A segunda passada e a regra de prova na execução B
6
pares suspeitos verificados
Cada verificação lê só os dois trechos, perto de 8 mil tokens
4
contradições confirmadas
Mesmo ponto, mesmo parâmetro e mesma unidade
2
contradições que caíram
Uma por mg/L contra µg/L, outra por pontos de coleta diferentes
2
registros descartados sem prova
Nenhum estava na lista de referência de Helena
Fonte: Veredas Ambiental, cenário composto; ensaio na mina e na barragem.
A regra tem um limite que Caio documentou. A validação confere o trecho por igualdade de texto, e documentos digitalizados trazem diferenças de espaço, hífen e acento entre a leitura da subchamada e o arquivo guardado. O código compara as duas versões depois da mesma normalização usada no filtro. Sem isso, a regra de prova descartaria registros corretos e daria falsa impressão de rigor.
Para a divisão A havia um remédio conhecido, e Caio o testou fora da tabela: sobrepor os blocos em 20 mil caracteres para que nada caísse inteiro na fronteira. Duas das cinco perdas voltaram. Em troca, o mesmo laudo passou a aparecer em dois blocos e a ser contado duas vezes, o que exigiu um passo de remoção de duplicatas pelo id do documento. A sobreposição remenda o corte; não o põe no lugar certo.
Guia prático para marketing: pesquisa de concorrentes com evidência literal. Dividir e agregar é o desenho natural para comparar concorrentes: uma subchamada por empresa, sempre com o mesmo esquema de saída, e uma agregação feita em código. O cuidado que separa pesquisa de palpite é exigir, em cada célula, o trecho exato da página de onde a informação saiu.
Ver como texto
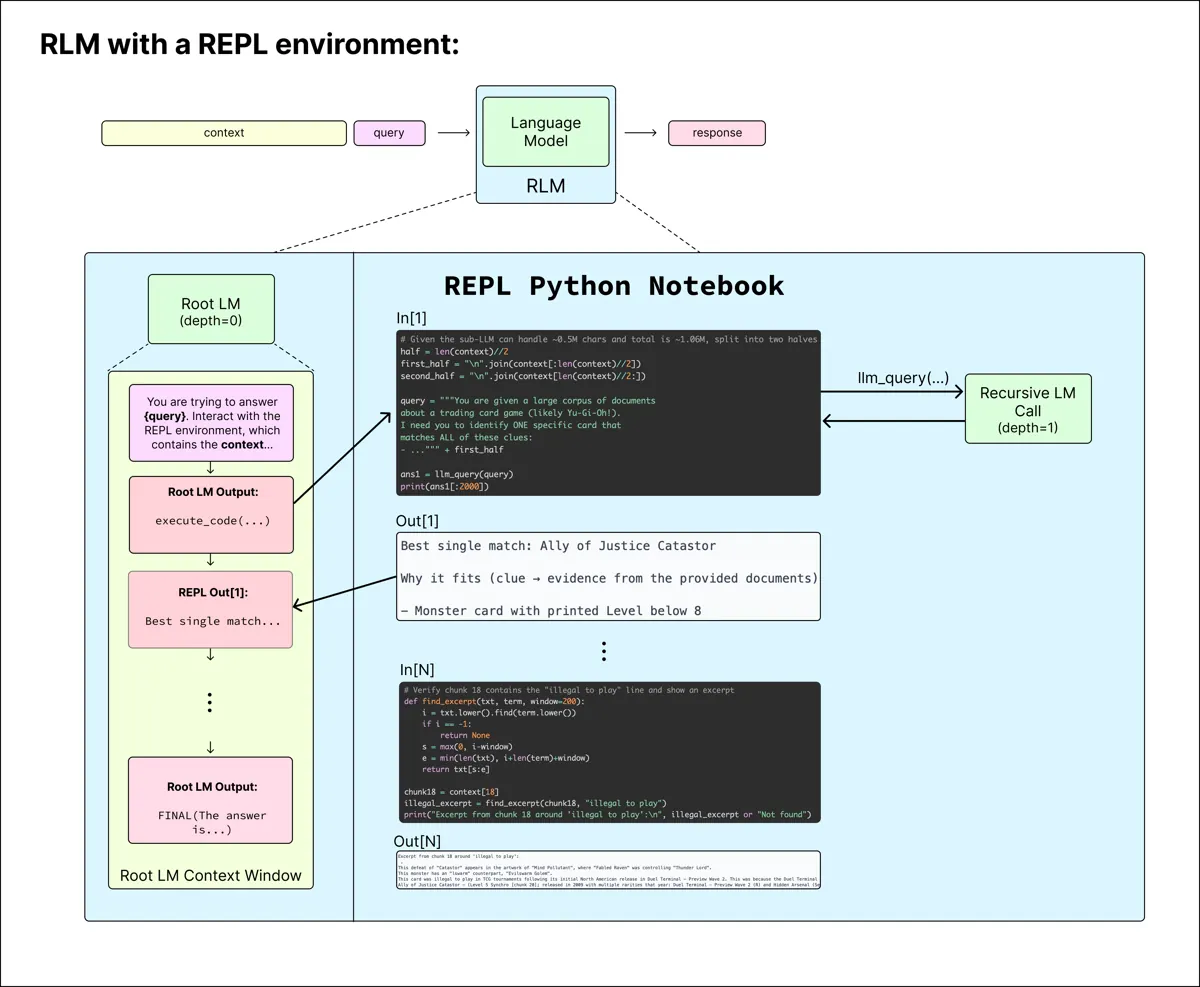
Esquema do RLM com ambiente REPL: à esquerda, a janela de contexto do modelo raiz com saídas de código e a resposta final; ao centro, células de notebook Python que dividem o contexto ao meio e chamam llm_query; à direita, a chamada recursiva de profundidade 1 que devolve a sub-resposta.
Comparar oito concorrentes com uma subchamada por empresa
Seis passos. Colete só páginas públicas e respeite os termos de uso e o robots.txt de cada site.
Passo 1: Defina as perguntas da comparação antes de coletar
Exemplo: preço de entrada, período de teste, público declarado, três promessas da página inicial, integrações citadas e queixas recorrentes em avaliações públicas.
Deu certo quando: Uma lista fechada de 6 a 10 campos, cada um com definição de uma linha.
Erro comum: Coletar tudo e decidir depois o que comparar. O acervo cresce e nenhuma tabela fecha.
Passo 2: Monte um bloco por concorrente com as páginas e a data de coleta
Cabeçalho [CONCORRENTE nome, coletado em AAAA-MM-DD] e, abaixo, [URL ...] seguido do texto de cada página.
Deu certo quando: Cada bloco tem a home, a página de preços, a FAQ e as avaliações públicas daquela empresa.
Erro comum: Misturar páginas de dois concorrentes num bloco. A subchamada atribui a promessa de um ao outro.
Passo 3: Peça ao modelo raiz uma subchamada por bloco com esquema JSON fixo
Cada campo devolve valor, URL e trecho literal. Campo sem evidência volta como “não encontrado”.
Deu certo quando: Oito objetos JSON com os mesmos campos, prontos para virar linhas da tabela.
Erro comum: Aceitar “não informado” sem saber se a página foi lida. Peça a URL consultada mesmo quando o campo vier vazio.
Passo 4: Verifique em código que cada trecho existe no texto coletado
Uma linha de Python no REPL: o trecho citado precisa aparecer no bloco daquela empresa.
Deu certo quando: Toda célula da tabela passa na checagem; as que falham voltam para nova subchamada.
Erro comum: Confiar no trecho porque está entre aspas. Sub-modelos parafraseiam e chamam a paráfrase de citação.
Passo 5: Agregue em código e só então peça a síntese
A tabela é montada pelo REPL; a última chamada escreve três diferenças que importam para a sua oferta.
Deu certo quando: A síntese cita só campos que estão na tabela.
Passo 6: Agende a coleta de novo em 30 dias e compare as tabelas
Mudança de preço ou de promessa entre duas coletas vale mais que a fotografia de um dia.
Deu certo quando: Um diff entre as duas tabelas, com data e URL de cada mudança.
No fim você tem: Uma matriz de concorrentes em que cada célula tem valor, URL e trecho verificado, atualizável todo mês com o mesmo código.
Head de marketing de um software de gestão para clínicas
SaaS vertical de saúde, aquisição por busca paga e conteúdo
Dor
A comparação com concorrentes era um slide de dois anos atrás, e o time comercial ouvia de clientes preços que não sabia confirmar.
Solução
Oito concorrentes, um bloco por empresa, subchamadas com esquema fixo e checagem em código de cada trecho citado, repetida a cada 30 dias.
Resultado do exemplo
Na segunda coleta, dois concorrentes tinham trocado o teste gratuito por demonstração agendada. A página de preços da empresa passou a destacar o teste de 14 dias, e os anúncios de busca ganharam esse argumento.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Agrupe objeções de campanha sem entregar a contagem ao modelo. Use as chamadas subordinadas para classificar os textos e some os rótulos em código. A separação permite conferir a conta e escolher uma mensagem para testar, sem confundir frequência de objeção com causa de perda de vendas.
No caso sintético, uma agência compara respostas abertas de duas campanhas de um software. A campanha A tem três mensagens: duas mencionam preço e uma pede prova de resultado. A campanha B também tem três: uma menciona preço e duas perguntam sobre integração. Esses seis registros servem para conferir o processo antes de usar um acervo maior.
Executar a análise de objeções por campanha
Passo 1: Prepare os registros e o conjunto de conferência
Use id, campanha, período e texto. No primeiro ciclo, aplique os seis registros sintéticos. Em dados reais, remova nomes, contatos e números de pedido antes de enviar o texto ao provedor.
Deu certo quando: Há uma linha por mensagem; reenvios com o mesmo ID não entram duas vezes.
Erro comum: Apagar textos iguais de pessoas diferentes reduz a frequência real da objeção.
Passo 2: Configure a classificação com o mesmo contrato
Use mensagens, regras -> rotulos: list[dict] no dspy.RLM. Comece com max_iters=8 e max_llm_calls=12. Cada rótulo precisa de id, categoria e trecho; a campanha vem do registro original.
Deu certo quando: O limite de chamadas abrange as subchamadas e os subagentes do DSPy 3.4.1.
Passo 3: Valide a cobertura antes de agregar
Exija uma resposta por ID, sem repetição nem ID desconhecido. Confira cada trecho contra a mensagem e aceite apenas as quatro categorias definidas. Se faltar uma linha, apresente o resultado como parcial.
Deu certo quando: O conjunto de IDs da resposta é igual ao conjunto de IDs de entrada.
Passo 4: Calcule a distribuição em código
Conte pares de campanha e categoria com collections.Counter. Divida cada contagem pelo total de mensagens válidas daquela campanha. Mantenha indefinida no denominador e informe seu total separadamente.
Deu certo quando: A soma das categorias bate com o total de mensagens em cada campanha.
Passo 5: Avalie a classificação contra os textos
Confira todos os seis registros do exemplo. No acervo real, reserve uma amostra revisada por uma pessoa, incluindo casos ambíguos; compare rótulos por categoria antes de confiar no consolidado.
Deu certo quando: O exemplo devolve A com duas objeções de preço e uma de prova; B com uma de preço e duas de integração.
Passo 6: Aplique o achado a uma hipótese de mensagem
Para B, prepare uma peça que explique integrações existentes. Defina o resultado do teste, como pedidos de demonstração qualificados, e compare versões sob condições equivalentes antes de alterar o investimento.
Erro comum: Mais perguntas sobre integração não provam que citar integrações aumentará os pedidos.
No fim você tem: Uma distribuição com denominador explícito, evidência por mensagem e uma hipótese de comunicação para testar. O resultado não autoriza mudar campanhas automaticamente.
A unidade contada é mensagem, não pessoa nem venda perdida. Uma pessoa pode escrever várias vezes, e campanhas podem alcançar públicos diferentes. Preserve período, origem e unidade na apresentação; use uma consulta SQL ou planilha quando o trabalho for apenas somar dados já classificados.
Escolha algumas conclusões e volte até o documento de origem. A resposta deve indicar o que foi lido, o que ficou de fora e onde há conflito. Antes de expandir o RLM, compare essa solução com busca, leitura direta e resumo usando a mesma pergunta e a mesma exigência de evidência.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAstra profundosugerido pelo grafo2 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Astra profundo”.
- CursoIA local na práticasugerido pelo grafo3 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “IA local na prática”.
O mesmo assunto em outros cursos
- Segundo cérebro com IAPor que informação demais pode piorar a resposta da IAExaminar conexões de Por que informação demais pode piorar a resposta da IA
- Prompt Engineering para ExecutivosAprofundamento: receber a resposta no formato que o sistema lêExaminar conexões de Aprofundamento: receber a resposta no formato que o sistema lê
- Avaliar e melhorar agentesLer as siglas de uma proposta de treinamentoExaminar conexões de Ler as siglas de uma proposta de treinamento
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.