RLM: grandes acervos · Capítulo 29 de 30 · 12 min
Como montar o projeto de comparação
Monte um projeto que compare leitura direta em contexto, RAG, RLM e uma solução híbrida. Use o mesmo acervo e as mesmas perguntas, com versões e protocolo de avaliação definidos antes da medição.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: O projeto final reúne as decisões anteriores em uma pergunta de negócio delimitada. Você escolhe o acervo autorizado, prepara respostas de referência e compara leitura direta, busca, RLM e uma combinação quando fizer sentido. O caso da Veredas fornece um exemplo fictício; os resultados do seu projeto precisam vir da sua medição.
Sem essa prova, a recomendação vira opinião de quem construiu o protótipo. Com ela, vira uma medida que outra pessoa refaz. A diferença aparece no dia em que um cliente contesta um número e a consultoria precisa mostrar de onde ele saiu.
Ao terminar, você escreve a ficha de um problema com critério de sucesso fechado antes da primeira linha de código e monta quatro alternativas que respondem às mesmas perguntas sob o mesmo registro de custo, tempo e evidência. A avaliação e a recomendação ficam para o fechamento do projeto.
- Etapa 1 de 6: Escrever a ficha
Pergunta, unidade de resposta, critério de acerto e tetos, assinados antes do código
- Etapa 2 de 6: Montar as quatro alternativas
RAG, contexto longo, RLM e híbrido, com o mesmo cuidado
- Etapa 3 de 6: Fixar o registro comum
Custo, tempo, trajetória e evidência por pergunta
- Etapa 4 de 6: Rodar as 120 perguntas
Mesma ordem, mesmo corretor, mesmo teto de tempo
- Etapa 5 de 6: Ler os erros por origem
Roteador, busca, leitura ou linha de base
- Etapa 6 de 6: Recomendar em três partes
Condições, custo e evidências, com gatilho de reversão
Ver como texto
- Escrever a ficha: Pergunta, unidade de resposta, critério de acerto e tetos, assinados antes do código
- Montar as quatro alternativas: RAG, contexto longo, RLM e híbrido, com o mesmo cuidado
- Fixar o registro comum: Custo, tempo, trajetória e evidência por pergunta
- Rodar as 120 perguntas: Mesma ordem, mesmo corretor, mesmo teto de tempo
- Ler os erros por origem: Roteador, busca, leitura ou linha de base
- Recomendar em três partes: Condições, custo e evidências, com gatilho de reversão
Por que o critério vem antes da primeira linha de código
Toda avaliação confiável depende de um critério fixado antes do resultado. A equipe de pesquisa da Vetto, liderada por Arthur Kamienski, resume a exigência em três palavras: um bom teste é difícil, justo e válido. Difícil porque os sistemas bons ainda erram nele. Justo porque premia a resposta correta e só a resposta correta. Válido porque mede o que diz medir. O texto trata de benchmarks em geral e não fala de RLM, mas as três palavras servem de critério para o projeto.
No projeto da Veredas, justo quer dizer que uma resposta com o número certo e a evidência errada não conta como acerto. Válido quer dizer que as 120 perguntas se parecem com as que os clientes fazem, e não com as que o sistema responde bem. Difícil está garantido pelo próprio RAG anterior, que erra 56 das 120 perguntas.
Ver como texto
Difícil, justo e válido no projeto da Veredas
Três colunas. Cada uma traz a exigência geral de um bom teste e, abaixo de uma linha, a forma que ela toma no conjunto de 120 perguntas da Veredas.
Para garantir a validade, Helena não inventou perguntas do zero. Partiu de dois anos de e-mails de clientes, separou os pedidos que envolviam monitoramento hídrico e reescreveu cada um como pergunta fechada, com resposta que se confere no acervo. Onde a resposta dependia de julgamento técnico, como decidir se dois laudos discordam de fato ou só usam métodos diferentes, ela registrou a regra de decisão junto da referência, para que o corretor não precisasse adivinhar.
Unidade de resposta é o formato mínimo que a correção aceita, e defini-la cedo evita discussão sem fim. Na Veredas, uma resposta sem empreendimento, condicionante, situação e documento com página está incompleta, mesmo que o texto em volta esteja correto. Essa exigência favorece sistemas que guardam o rastro, e Helena a manteve de propósito: é o que o órgão ambiental cobra da consultoria quando pede a comprovação de uma condicionante.
Mudar o critério depois de ver o placar é a forma mais comum de enganar a si mesmo sem perceber. Armadilha comum: afrouxar o critério de acerto quando o sistema preferido erra por pouco, aceitando “quase certo” numa contagem. Em licenciamento, uma condicionante a menos na contagem é uma obrigação esquecida diante do órgão ambiental. Por isso Helena escreveu a ficha, assinou e datou antes de Caio rodar qualquer alternativa.
| Campo | Definição escrita por Helena |
|---|---|
| Pergunta de negócio | Quais condicionantes de monitoramento hídrico estão vencidas ou com laudos contraditórios, em quais empreendimentos e com que evidência? |
| Unidade de resposta | Empreendimento, condicionante, situação (vencida, contraditória ou em dia) e documento com página |
| Critério de acerto | Resposta igual à de referência e evidência que a sustenta; número certo com evidência errada conta como erro |
| Conjunto de avaliação | 120 perguntas: 40 de localização, 50 de agregação e 30 de cruzamento, com resposta de referência de Helena |
| Teto de custo | US$ 1,00 por pergunta em média; acima disso, a alternativa sai da disputa |
| Teto de tempo | 10 minutos por pergunta; execução interrompida conta como erro |
| Registro obrigatório | Custo, tempo, trajetória e evidência de cada resposta, no mesmo formato para as quatro alternativas |
Cenário composto da Veredas Ambiental. Tetos de custo e de tempo são decisões do projeto, não resultados.
Execução interrompida pelo teto conta como erro, e essa regra pesa mais do que parece. O artigo do RLM descreve trajetórias de custo e tempo com cauda longa: a mediana fica comparável ao modelo base e a média sobe por causa de poucas execuções muito caras. Se a execução que estoura o teto fosse simplesmente descartada, o RLM ganharia pontos justamente nas perguntas em que ele se perde.
O acervo e o conjunto de avaliação do projeto
6.400
Documentos no acervo
14 anos de processos
38
Empreendimentos
Mineração, barragens, loteamentos e uma PCH
52 milhões
Tokens no total
Cerca de 52 janelas de 1 milhão
120
Perguntas com resposta de referência
40 de localização, 50 de agregação e 30 de cruzamento
Fonte: Cenário composto da Veredas Ambiental usado em todo o curso; números ilustrativos.
Com a ficha fechada, o critério fica igual para todos. Cada alternativa responde às mesmas 120 perguntas, na mesma ordem, com o mesmo corretor e o mesmo teto de tempo. Nenhuma recebe perguntas extras para ajuste, e nenhuma pode pular uma pergunta difícil. O placar final só compara o que foi medido do mesmo jeito.
Quatro alternativas construídas com o mesmo cuidado
Caio montou quatro sistemas. O primeiro é o RAG em produção, o “buscar, depois gerar” que descende do artigo de Lewis e colegas de 2020: recupera trechos parecidos com a pergunta e entrega ao modelo. Antes de aceitá-lo como linha de base, Caio deu a ele uma rodada de ajuste, subindo de 5 para 10 o número de trechos recuperados. O placar ficou nos mesmos 64 de 120, e o registro dessa tentativa entrou no projeto.
Contexto longo numa chamada foi a segunda alternativa, e ela esbarra no tamanho antes de chegar à qualidade. As 52 janelas do acervo não cabem numa chamada, então ela só concorre em perguntas cujo material cabe em 1 milhão de tokens. O número de referência continua o do recorte da mina e da barragem: 31 de 50 em agregação, lendo cerca de 900 mil tokens por pergunta.
Por que o contexto longo fica fora da disputa geral
52
janelas de 1 milhão para o acervo
Não cabe numa chamada
900 mil
tokens no recorte em que cabe
Mina e barragem, 31 de 50 em agregação
US$ 3,60
por pergunta, só de entrada
0,9 milhão × US$ 4 no Opus 5.5
US$ 1,00
teto de custo da ficha
Acima dele, a alternativa sai da disputa
Fonte: Veredas Ambiental, cenário ilustrativo do curso
A ficha tira o contexto longo da disputa geral por outra via, antes mesmo da qualidade. Ler 900 mil tokens no Opus 5.5, a US$ 4 por milhão, custa 0,9 vezes 4, ou US$ 3,60 por pergunta só de entrada. O teto escrito na ficha é de US$ 1,00. A alternativa fica no projeto como referência de qualidade no recorte em que cabe, e o registro diz por que ela não concorre ao uso.
Terceira alternativa, o RLM otimizado na trilha de custo roda sobre o acervo inteiro, com 93 de 120, US$ 0,41 por pergunta e mediana de 1 min 50 s. A quarta é nova: um híbrido que manda as perguntas de localização ao RAG e, nas de agregação e cruzamento, usa uma busca por metadado para escolher os empreendimentos envolvidos antes de entregar ao RLM só os documentos deles.
Uma pergunta simples orientou o desenho: se o sistema consegue saber em quais empreendimentos a resposta está, por que lê os outros? Nenhuma peça do híbrido é nova em si. A mudança está em dar a cada peça o trabalho em que ela é boa. A busca escolhe o recorte, o RLM lê o recorte inteiro e o RAG continua achando documentos, como fazia antes. Cada peça continua sujeita ao próprio erro, e o registro comum mostra qual delas falhou em cada pergunta.
| Alternativa | O que faz | Onde se espera falha | Situação ao começar a avaliação |
|---|---|---|---|
| RAG em produção | Recupera 10 trechos por similaridade e gera a resposta | Contagens e cruzamentos que pedem leitura completa | 64 de 120, mesmo após o ajuste |
| Contexto longo | Coloca todo o material na janela de uma chamada | Material acima de 1 milhão de tokens; agregação longa | 31 de 50 no recorte de 900 mil tokens |
| RLM sobre o acervo | Guarda o acervo como variável e divide a leitura por código | Perguntas de localização; cauda de custo | 93 de 120, US$ 0,41, mediana de 1 min 50 s |
| Híbrido | Roteia por tipo; busca por metadado escolhe empreendimentos; RLM lê o recorte | Erro do roteador; busca que deixa um empreendimento de fora | Construído, ainda sem medição |
Cenário composto da Veredas Ambiental. Os números vêm dos capítulos anteriores do curso.
Como a Veredas construiu o híbrido sem trapacear na comparação
Olhando os rastros do RLM otimizado, Caio achou a ideia do híbrido. Em boa parte das perguntas de agregação, o modelo raiz gastava as primeiras iterações descobrindo quais empreendimentos importavam, espiando nomes e filtrando pastas por expressão regular. Esse trabalho uma busca por metadado faz em milissegundos, porque cada documento já traz empreendimento, tipo e data. Entregar ao RLM só o recorte certo reduziria as iterações e o ruído.
Roteador é o componente que decide para qual sistema cada pergunta vai, como a triagem de um pronto-socorro. Caio podia usar os rótulos que Helena escreveu nas 120 perguntas, mas isso seria trapaça: em produção ninguém rotula a pergunta do cliente. Ele usou um classificador com um modelo barato, e o erro do classificador passou a contar no placar do híbrido. Nas 120 perguntas, o classificador acertou o tipo em 114.
Busca por metadado filtra por campos exatos, como empreendimento, tipo de documento e data. A busca vetorial procura trechos de texto parecidos com a pergunta, como quem acha um livro pelo assunto e não pelo número na estante. Para escolher empreendimentos, o filtro exato ganha, porque a pergunta costuma nomear o empreendimento ou a região. Quando não nomeia, o híbrido manda ao RLM os três mais prováveis e registra a escolha, para que um erro de recorte apareça no rastro.
- Etapa 1 de 5: Classificar
Modelo barato decide: localizar, agregar ou cruzar
- Etapa 2 de 5: Localizar
Perguntas de localização vão direto ao RAG em produção
- Etapa 3 de 5: Escolher o recorte
Busca por metadado seleciona até 3 empreendimentos e o período
- Etapa 4 de 5: Ler com o RLM
dspy.RLM recebe só os documentos do recorte, com tetos de iteração e chamada
- Etapa 5 de 5: Registrar
Custo, tempo, trajetória e documento com página, no formato comum
Ver como texto
- Classificar: Modelo barato decide: localizar, agregar ou cruzar
- Localizar: Perguntas de localização vão direto ao RAG em produção
- Escolher o recorte: Busca por metadado seleciona até 3 empreendimentos e o período
- Ler com o RLM: dspy.RLM recebe só os documentos do recorte, com tetos de iteração e chamada
- Registrar: Custo, tempo, trajetória e documento com página, no formato comum
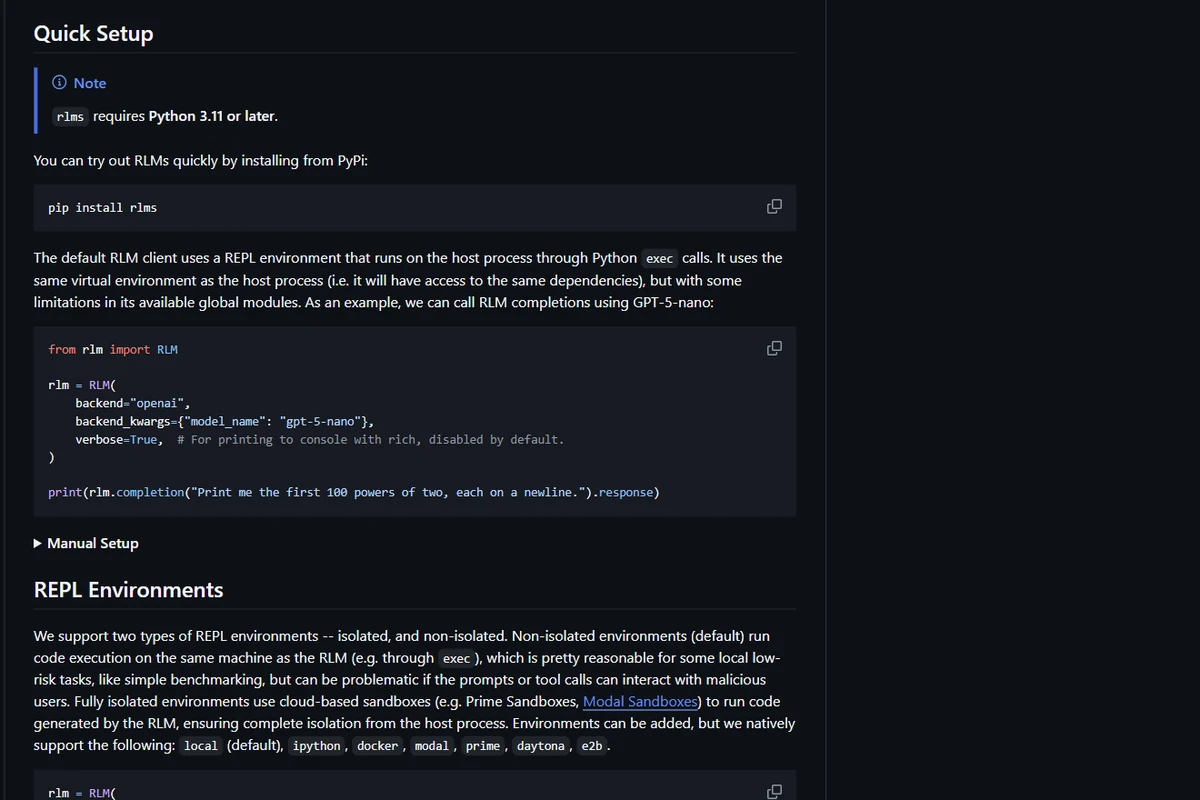
No código, o híbrido ficou curto. O trecho abaixo mostra a estrutura, com o nome atual do parâmetro de iterações no DSPy, max_iters, que substituiu max_iterations na versão 3.3.0. O sub_lm recebe um modelo mais barato para as subchamadas, como recomenda a documentação, e max_llm_calls limita quantas vezes o código pode chamar o modelo numa pergunta.
Aprofundamento de implementação. A sequência a seguir requer Python e um ambiente isolado. Você pode acompanhá-la com a equipe responsável: confira os dados de entrada, o limite de acesso e a evidência produzida, mesmo que não execute o código.
import dspy

# Modelo raiz e modelo mais barato para as subchamadas
dspy.configure(lm=dspy.LM("openai/gpt-5"))
barato = dspy.LM("openai/gpt-5-mini")

leitor = dspy.RLM(
    "context, query -> answer",
    max_iters=20,        # nome atual desde o DSPy 3.3.0
    max_llm_calls=50,    # teto de subchamadas por pergunta
    sub_lm=barato,
)

def responder(pergunta, rag, acervo, classificar):
    tipo = classificar(pergunta)  # localizar, agregar ou cruzar
    if tipo == "localizar":
        return rag(pergunta)      # o RAG em produção cuida da localização
    # a busca por metadado escolhe os empreendimentos do recorte
    ids = acervo.escolher_empreendimentos(pergunta, limite=3)
    recorte = acervo.texto_de(ids)  # só os documentos desses empreendimentos
    resultado = leitor(context=recorte, query=pergunta)
    # a trajetória guarda o código e a saída de cada passo, para auditoria
    return resultado.answer, resultado.trajectory
Cada alternativa grava o mesmo registro por pergunta: custo em dólares, tempo de parede, trajetória quando existe e a evidência citada. Helena exigiu esse formato comum porque, sem ele, a comparação vira quatro relatórios com quatro vocabulários. A execução roda em sandbox isolado, com o documento tratado como dado, nunca como instrução, conduta herdada da trilha de segurança.
Para esse registro, cada biblioteca oferece um caminho. No rlms, o RLMLogger grava cada execução em JSONL e há um visualizador local. No DSPy, o resultado traz a trajectory, com o raciocínio, o código e a saída de cada passo. Caio converteu as duas saídas para uma tabela comum com pergunta, alternativa, custo, tempo, evidência citada e acerto, que Helena corrige numa planilha sem abrir código.
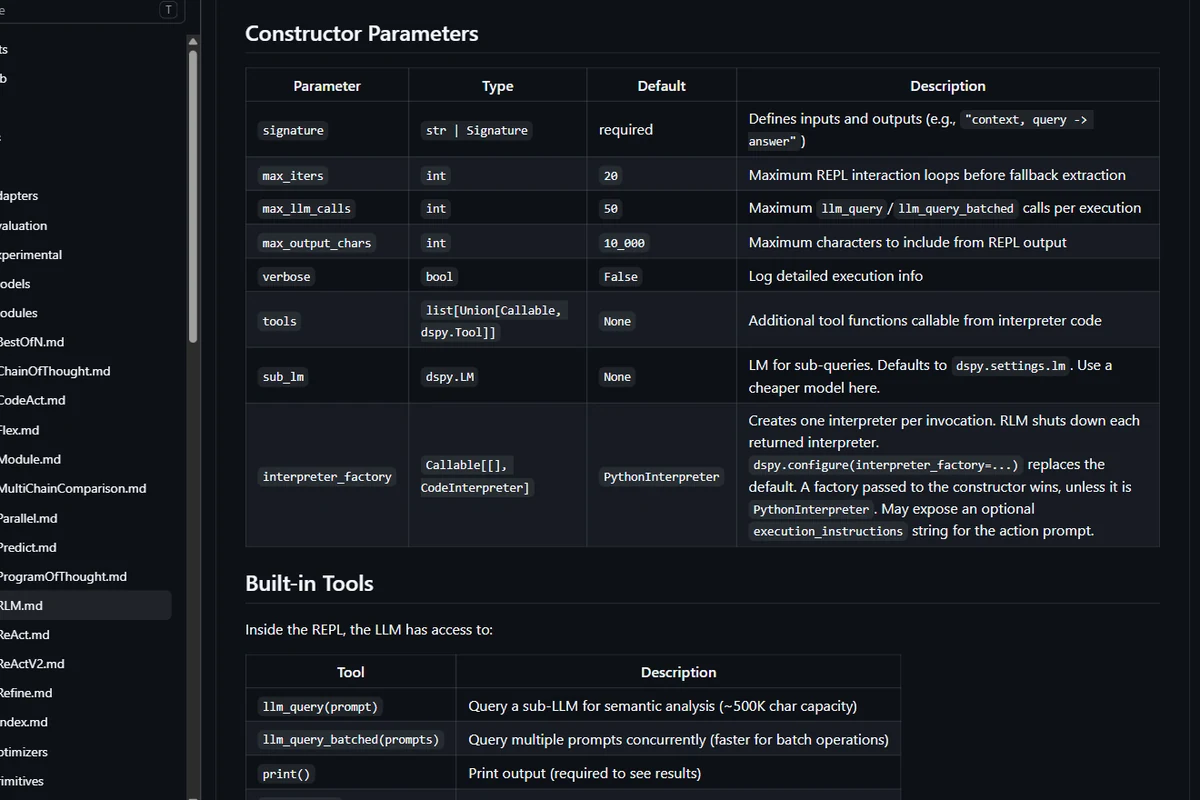
Quanto ao ambiente, o intérprete padrão do DSPy é Deno com Pyodide, um sandbox WASM. Depois da análise da Cyera sobre fugas de sandboxes Pyodide em outros produtos, Caio rodou tudo dentro de um contêiner sem acesso à rede além da API do modelo, somando o isolamento do sistema operacional ao do WASM, como a própria Cyera recomenda.
Comparação viciada e comparação justa entre as alternativas
Comparação viciada
Evitar
- Sistema novo ajustado por semanas contra o antigo intocado
- Roteador usando os rótulos escritos por Helena
- Execução interrompida descartada da conta
- Critério de acerto revisto depois do placar
Comparação da Veredas
Recomendado
- Rodada de ajuste também no RAG, registrada
- Classificador automático, com o erro dele no placar
- Execução no teto de 10 minutos conta como erro
- Ficha assinada e datada antes da primeira rodada
O cuidado com a linha de base tem apoio nos números do próprio artigo do RLM. Na Tabela 1, o Claude Code sobe de 12,0 para 62,0 no CodeQA quando o contexto vai para um arquivo, e o OpenCode sobe de 0,0 para 94,0 no BrowseComp-Plus. A mesma ferramenta, configurada de outro jeito, muda de patamar. Uma linha de base mal configurada faz qualquer alternativa nova parecer genial, e um comitê que conhece esse efeito desconfia de ganhos grandes demais.
Havia um viés que a Veredas não conseguiu eliminar, e o projeto o registrou em vez de escondê-lo. As 120 perguntas foram usadas durante a otimização de custo, então o RLM e o híbrido foram ajustados olhando para elas. Helena decidiu que a recomendação final valeria para o piloto, mas seria confirmada nas primeiras perguntas reais de clientes, que nenhum sistema viu antes. Como extensão opcional do seu projeto, separe desde o início um conjunto selado, que nenhuma otimização toca, e aplique o protocolo de Rodar o laço com conjunto selado.
Entregue a definição da tarefa, as versões das alternativas e o protocolo de avaliação antes de medir. Explique o que cada solução recebe e o que pode fazer. O próximo capítulo usa os resultados para escrever uma recomendação proporcional à evidência.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Conferir a resposta no documento certosugerido pelo grafoApresenta o conceito “RAG”, usado em “Como montar o projeto de comparação”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAstra profundosugerido pelo grafo2 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Astra profundo”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Prompt Engineering para ExecutivosTestar a IA com 20 a 50 casos reais antes de liberarExaminar conexões de Testar a IA com 20 a 50 casos reais antes de liberar
- NotebookLM para criar conteúdoCompare o Gemini Notebook com outros assistentesExaminar conexões de Compare o Gemini Notebook com outros assistentes
- Avaliar e melhorar agentesPedir evidências antes de assinarExaminar conexões de Pedir evidências antes de assinar
- Vídeo com IA: do roteiro à publicaçãoTeste Claude, ChatGPT, Gemini e Grok com o mesmo roteiroExaminar conexões de Teste Claude, ChatGPT, Gemini e Grok com o mesmo roteiro
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.