RLM: grandes acervos · Capítulo 2 de 30 · 14 min
Quanto texto cabe e quanto a IA consegue usar
Diferencie o tamanho da janela de contexto da capacidade de usar o texto com precisão. Teste quando dividir a leitura por recursão ajuda nas perguntas do seu acervo.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Exemplo: Imagine colocar uma pasta inteira sobre a mesa de alguém e esperar que todos os detalhes recebam a mesma atenção. A janela de contexto é essa mesa: o espaço disponível para instruções e material de uma chamada. No caso fictício da Veredas, aumentar esse espaço é a primeira alternativa a testar; a capacidade anunciada do modelo, sozinha, não comprova que ele encontrará e combinará o que importa.
Essa saída tem dois limites, e ignorar qualquer um deles custa caro. O primeiro é de tamanho: 52 milhões de tokens são 52 janelas cheias, e nenhum modelo aceita isso numa chamada. O segundo é de qualidade: dentro da janela, o modelo não lê tudo com a mesma atenção, e a queda aparece bem antes do limite anunciado.
Ver como texto
O acervo de 52 milhões de tokens desenhado como 52 quadrados; uma chamada de 1 milhão de tokens cobre só o primeiro
Ao terminar, o leitor distingue a janela máxima da capacidade efetiva, sabe citar as medições que separam as duas e entende a recursão pelas quatro partes que a definem: dividir, caso-base, parada e retorno. Entende também por que o Tiny Recursive Model, que ganhou manchetes em 2025, compartilha só o nome com os RLMs.
Por que caber na janela não garante que o modelo leia
Janela máxima é o número que o fornecedor publica: quantos tokens a API aceita numa chamada. Capacidade efetiva é outra medida, a partir de que tamanho o modelo começa a errar o que acertaria com menos texto. A diferença lembra a de um auditório com mil lugares e uma voz que só alcança as primeiras fileiras. Todos entram, poucos escutam.
| Fornecedor | Modelos | Janela de entrada | Saída máxima |
|---|---|---|---|
| Anthropic | Claude Fable 5.1, Opus 5.5 e Sonnet 5 | 1 milhão de tokens | 128 mil tokens |
| Anthropic | Claude Haiku 4.5 | 200 mil tokens | 64 mil tokens |
| OpenAI | GPT-6 Astra, Sol e Luna | 1,05 milhão de tokens | 128 mil tokens |
| Gemini 3.8 Flash e Gemini 3.1 Pro (prévia) | 1.048.576 tokens | 65.536 tokens |
Fonte: Páginas oficiais de modelos da Anthropic, da OpenAI e do Google, conferidas em 23 de setembro de 2026.
Medir a capacidade efetiva exige teste controlado. Em abril de 2024, a NVIDIA publicou o RULER e testou 17 modelos: só metade sustentou desempenho satisfatório a 32 mil tokens, embora todos anunciassem janelas maiores. O OOLONG mede classificação e agregação. Sua versão 2, de 5 de outubro de 2026, registra Gemini 3 Pro com 62,42% no OOLONG-synth a 128 mil tokens. O resultado depende do modelo e do recorte; 50% não é um teto geral.
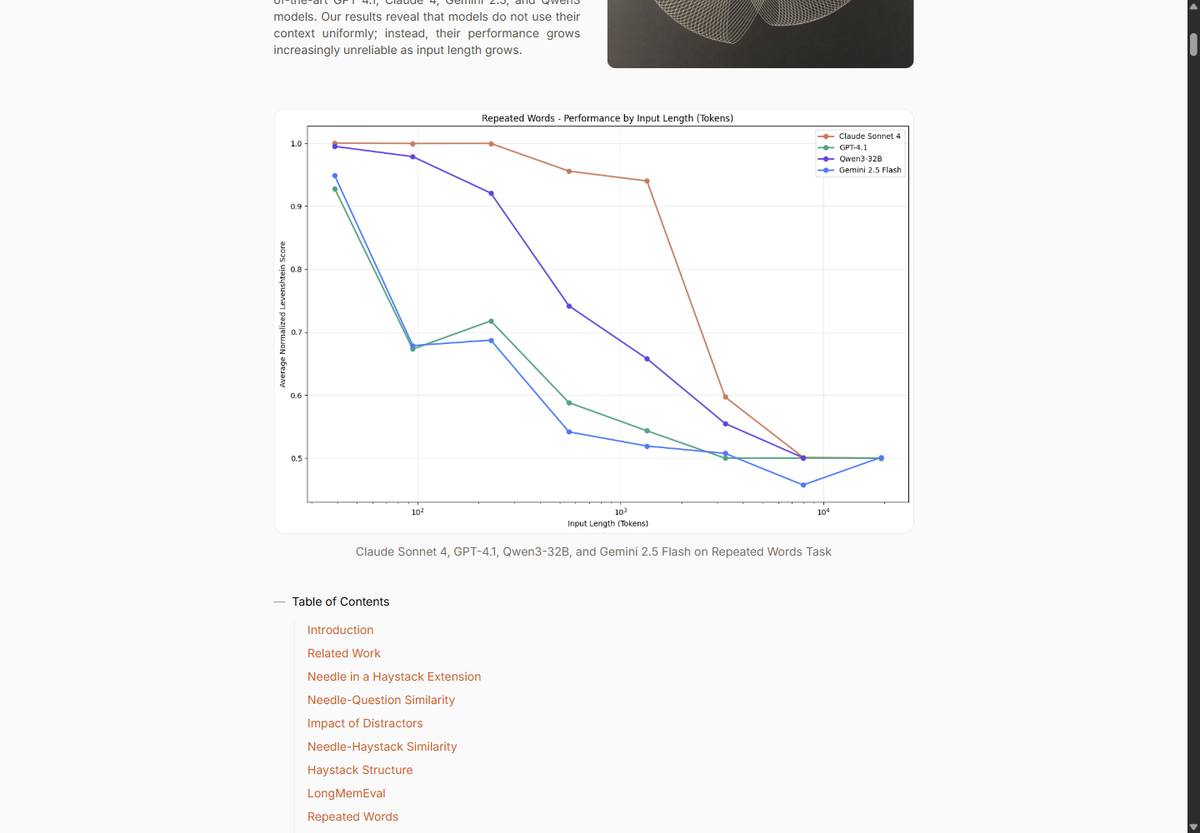
O estudo que deu nome ao fenômeno saiu em 14 de julho de 2025. Kelly Hong, Anton Troynikov e Jeff Huber, da Chroma, testaram 18 modelos de Anthropic, OpenAI, Google e Alibaba e chamaram a queda de context rot, o apodrecimento do contexto. O desempenho variou com o tamanho da entrada mesmo em testes simples, como repetir uma sequência de palavras.
O que as medições de contexto longo mostraram
18
modelos testados no Context Rot
Anthropic, OpenAI, Google e Alibaba; todos pioraram com entradas maiores
1 distrator
já reduz o acerto
Um trecho parecido com a resposta, e errado, basta para derrubar o desempenho
Metade
dos 17 modelos sustenta 32 mil tokens no RULER
Teste da NVIDIA de abril de 2024; todos anunciavam janelas maiores
62,42%
Gemini 3 Pro no OOLONG-synth
128 mil tokens; versão 2, outubro de 2026
Fonte: Chroma, Context Rot (julho de 2025); Hsieh et al., RULER (abril de 2024); Bertsch et al., OOLONG v2 (5 de outubro de 2026).
Três achados do Context Rot interessam a quem lida com acervos técnicos. Um único distrator, trecho parecido com a resposta e errado, já reduz o acerto. Prompts focados, com só o trecho relevante, superaram prompts completos em todas as famílias de modelos. E os modelos foram pior quando o texto de fundo preservava o fluxo lógico do que quando as frases estavam embaralhadas, um resultado contraintuitivo.
O experimento mais próximo do uso real usou o LongMemEval, um teste de memória de conversas longas. A mesma pergunta foi feita com cerca de 300 tokens focados, só o trecho que importava, e com cerca de 113 mil tokens completos, a conversa inteira. Os modelos responderam melhor com a versão curta. Para quem monta assistentes sobre acervos, a lição é direta: mandar tudo custa mais e rende menos.
A mesma pergunta do LongMemEval em dois tamanhos
Conversa inteira, cerca de 113 mil tokens
Mandar tudo
- Custo de entrada centenas de vezes maior
- Trechos parecidos competem com a resposta
- Respostas piores nos modelos testados
Trecho focado, cerca de 300 tokens
Mandar o que importa
- Custo de entrada mínimo
- Só o material que a pergunta exige
- Respostas melhores nos modelos testados
Esse último achado toca a Veredas diretamente. Um acervo de licenciamento é o oposto de um palheiro aleatório: laudos de um mesmo poço se repetem com pequenas diferenças, trimestre após trimestre. Cada laudo antigo é um distrator perfeito para a pergunta sobre o laudo novo. A Chroma concluiu que importa como a informação é apresentada, e recomendou praticar engenharia de contexto.
Engenharia de contexto é escolher o que entra na janela, em que ordem e com que tamanho. O RLM leva essa ideia ao extremo: em vez de uma pessoa escolher, o próprio modelo escreve o código que escolhe, pedaço por pedaço. Armadilha comum: ler a janela de 1 milhão como promessa de leitura de 1 milhão. O número informa quanto a API aceita, e nada diz sobre quanto o modelo usa bem.
A própria contagem de tokens engana quem faz conta de janela. Ela depende do tokenizador, o programa que corta o texto em tokens, e muda de um modelo para outro. A Anthropic informa que o tokenizador usado desde o Claude Opus 4.7 gera cerca de 30 por cento mais tokens para o mesmo texto. Os 52 milhões da Veredas são uma estimativa, e a mesma pasta pode pesar mais em outro modelo.
| Abordagem | O que faz com o contexto | O que foi medido |
|---|---|---|
| MemGPT (outubro de 2023) | Troca páginas entre a janela e uma memória externa, como a memória virtual de um sistema operacional | Proposta de arquitetura, sem número no resumo |
| ACON (outubro de 2025) | Comprime o histórico de agentes de longa duração com diretrizes otimizadas | Pico de tokens 26% a 54% menor, com sucesso igual ou maior |
| RLM (dezembro de 2025, versão 3 em maio de 2026) | Deixa o prompt numa variável fora da janela e lê por código | Entradas mais de uma ordem de grandeza além da janela |
Fonte: Packer et al., arXiv 2310.08560; Kang et al., arXiv 2510.00615; Zhang, Kraska e Khattab, arXiv 2512.24601 (v3, 11/05/2026).
Dividir, caso-base, parada e retorno, as quatro partes da recursão
Recursão é resolver um problema grande chamando a mesma solução sobre pedaços menores dele. A apuração de uma eleição é o exemplo mais familiar. Cada seção eleitoral conta os próprios votos, a zona soma as seções, o estado soma as zonas. Ninguém conta o país inteiro de uma vez, e o total sai da soma dos totais parciais.
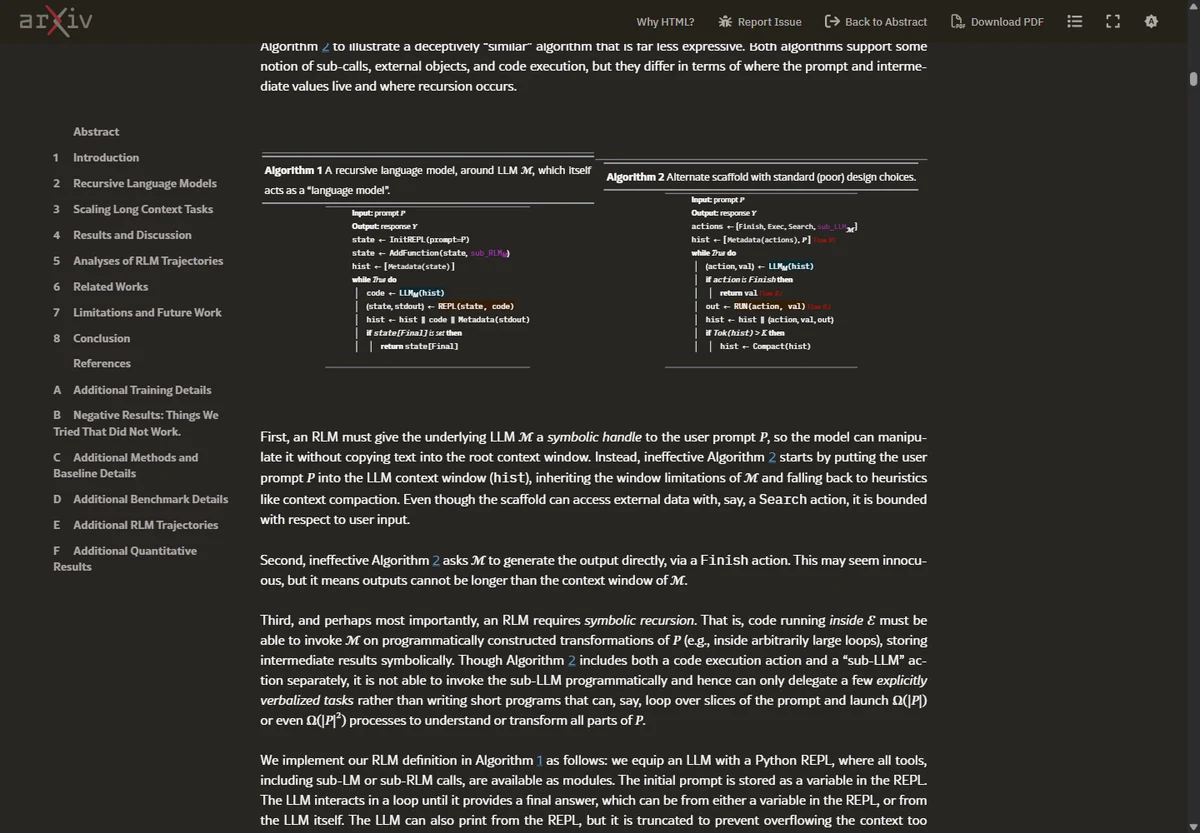
Toda recursão tem quatro partes. Dividir: partir o problema em pedaços do mesmo tipo. Caso-base: o pedaço pequeno o bastante para resolver direto, como a seção que conta a própria urna. Parada: a regra que impede a divisão de continuar para sempre. Retorno: o resultado de cada pedaço volta para quem o pediu e é combinado. Falte uma das quatro e o programa não termina ou termina errado.
- Etapa 1 de 4: Dividir
O acervo vira pedaços do mesmo tipo: empreendimentos, depois documentos
- Etapa 2 de 4: Caso-base
Um pedaço que cabe numa leitura é resolvido direto
- Etapa 3 de 4: Parada
Limite de profundidade, de chamadas ou de tempo encerra a divisão
- Etapa 4 de 4: Retorno
Cada resultado sobe e é combinado com os irmãos
Ver como texto
- Dividir: O acervo vira pedaços do mesmo tipo: empreendimentos, depois documentos
- Caso-base: Um pedaço que cabe numa leitura é resolvido direto
- Parada: Limite de profundidade, de chamadas ou de tempo encerra a divisão
- Retorno: Cada resultado sobe e é combinado com os irmãos
O código abaixo mostra as quatro partes numa contagem sem modelo de linguagem, só com Python. Ele conta quantos documentos mencionam uma condicionante hídrica vencida. A lógica é a mesma que um RLM aplica, com uma diferença: no RLM, o caso-base é uma chamada ao modelo que lê o pedaço, e não uma busca por palavra.
Aprofundamento de implementação. A sequência a seguir requer Python e um ambiente isolado. Você pode acompanhá-la com a equipe responsável: confira os dados de entrada, o limite de acesso e a evidência produzida, mesmo que não execute o código.
# Contagem recursiva sobre uma lista de documentos (sem modelo de linguagem).
# Cada documento é um texto; o caso-base lê um lote pequeno o bastante.
LOTE_MAXIMO = 50          # parada: abaixo disso não divide mais
PROFUNDIDADE_MAXIMA = 6   # parada de segurança contra divisão sem fim

def conta_vencidas(documentos, profundidade=0):
    # Caso-base: lote pequeno ou profundidade esgotada, resolve direto
    if len(documentos) <= LOTE_MAXIMO or profundidade >= PROFUNDIDADE_MAXIMA:
        return sum(1 for d in documentos
                   if 'condicionante' in d.lower() and 'vencid' in d.lower())
    # Dividir: parte a lista ao meio
    meio = len(documentos) // 2
    esquerda = conta_vencidas(documentos[:meio], profundidade + 1)
    direita = conta_vencidas(documentos[meio:], profundidade + 1)
    # Retorno: combina os dois resultados parciais
    return esquerda + direita
Com 6.400 documentos e lotes de até 50, a lista se divide sete vezes até chegar ao caso-base: 6.400 vira 3.200, depois 1.600, 800, 400, 200, 100 e 50. São 128 lotes na última camada. Por isso a parada de segurança do exemplo, fixada em seis níveis, cortaria a divisão um nível antes, com lotes de 100. Escolher a parada é uma decisão de custo, e a trilha de custo trata dela.
No RLM, duas coisas mudam em relação a esse código. O caso-base deixa de ser uma busca por palavra e passa a ser uma chamada ao modelo que lê o pedaço e responde em texto. E a divisão deixa de ser fixada pelo programador: o próprio modelo raiz escreve o código que decide como partir o acervo, depois de medir o tamanho dele. A recursão continua com as mesmas quatro partes, só que escritas pelo modelo durante a execução.
Ver como texto
Divisão recursiva de 6.400 documentos ao meio, nível a nível, até 128 lotes de 50
Recursão dentro da rede e recursão entre chamadas
Em 6 de outubro de 2025, Alexia Jolicoeur-Martineau, do Samsung SAIL Montréal, publicou o Tiny Recursive Model, ou TRM. Uma rede de 2 camadas e 7 milhões de parâmetros, treinada do zero em cerca de mil exemplos, marcou 44,6 por cento no ARC-AGI-1 e 7,8 por cento no ARC-AGI-2. O Gemini 2.5 Pro, na mesma comparação, marcou 37,0 e 4,9 por cento.
Os números correram o mundo arredondados para 45 e 8 por cento, e o nome fez muita gente juntar o TRM aos RLMs. Os dois são coisas diferentes. No TRM, a recursão acontece dentro da rede: ela repassa o próprio estado interno várias vezes antes de responder, como quem relê a mesma conta de cabeça. No RLM, a recursão acontece entre chamadas: um programa chama o modelo de linguagem várias vezes sobre pedaços de texto.
Tiny Recursive Model e RLM: o nome é comum, o mecanismo não
Tiny Recursive Model (recorrência dentro da rede)
Outra linha de pesquisa
- Rede de 7 milhões de parâmetros treinada do zero
- Repassa o estado interno várias vezes, sem texto intermediário
- Resolve quebra-cabeças como ARC-AGI, Sudoku e labirintos
- Não lê documentos longos nem chama outro modelo
RLM (recursão entre chamadas)
Assunto do curso
- Estrutura de inferência em volta de um modelo de linguagem existente
- Programa em Python chama o modelo sobre pedaços do prompt
- Resolve leitura e agregação acima da janela de contexto
- Cada chamada deixa rastro legível: código, saída e resultado
A distinção tem consequência prática. Um TRM não ajuda a Veredas a ler laudos, porque não lê texto longo; seus resultados valem para quebra-cabeças de grade. Trabalhos de 2026 derivados dele seguem na mesma linha: uma versão autorregressiva publicada em março não mostrou ganhos confiáveis. Quem cita o TRM como prova de que RLMs funcionam está somando evidências de dois mecanismos que nada têm em comum além do adjetivo.
Como a Veredas mediu o limite da janela no próprio acervo
Caio fez primeiro a conta de tamanho. Com 52 milhões de tokens e janelas de cerca de 1 milhão, o acervo inteiro equivale a 52 janelas cheias. O maior teste do artigo do RLM com GPT-5 usou de 6 a 11 milhões de tokens contra uma janela de 272 mil, entre 22 e 40 vezes a janela. O acervo da Veredas passa desse patamar, o que já pedia cautela ao ler qualquer promessa.
A formulação da promessa também mudou com o tempo. As versões 1 e 2 do artigo diziam que os RLMs processam entradas de até duas ordens de grandeza acima da janela. O texto da versão 3, de 11 de maio de 2026, recuou para mais de uma ordem de grandeza, embora o resumo na página do arXiv ainda traga a frase antiga. Cite a formulação do texto mais recente e anote a versão, o modelo e o teste.
O que a versão 3 do artigo afirma
> 10×
a janela do modelo
Texto da versão 3; o resumo do arXiv ainda diz até 100×
+26%
sobre a compactação
Resumo do histórico quando a janela enche; mediana com GPT-5
+130%
sobre o CodeAct com subchamadas
Agente que age escrevendo código; mediana com GPT-5
+13%
sobre o Claude Code
Mediana com GPT-5, custo comparável
+28,3%
do RLM-Qwen3-8B sobre o Qwen3-8B
Mediana nas quatro tarefas; versão 3, 11/05/2026
Fonte: Zhang, Kraska e Khattab, Recursive Language Models, arXiv 2512.24601, versão 3 (11/05/2026), resumo e texto.
Depois, testou o que cabia. Os dois empreendimentos com mais condicionantes hídricas, uma mina e uma barragem de rejeito, somam cerca de 900 mil tokens e entram numa janela de 1 milhão. Caio restringiu as 50 perguntas de agregação a esses dois processos, colou os documentos inteiros na chamada e comparou com a resposta de referência de Helena.
| Medida | Busca por trechos | Contexto longo (900 mil tokens) |
|---|---|---|
| Acertos em agregação, dentro dos dois empreendimentos | 21 de 50 | 31 de 50 |
| Tokens de entrada por pergunta | cerca de 6 mil (8 trechos) | cerca de 900 mil |
| Custo de entrada por pergunta a US$ 4 por milhão | US$ 0,024 | US$ 3,60 |
| Custo de entrada das 50 perguntas | US$ 1,20 | US$ 180,00 |
| Cobre os 38 empreendimentos? | Sim, mal | Não: o acervo é 52 vezes a janela |
Cenário composto da Veredas. Preço de referência: Claude Opus 5.5, US$ 4 por milhão de tokens de entrada; 0,9 × 4 = 3,60 por pergunta; 3,60 × 50 = 180; 0,006 × 4 = 0,024.
O contexto longo acertou 31 de 50, dez a mais que a busca por trechos, com 150 vezes mais tokens de entrada por pergunta. E errou 19. Helena leu os erros e achou sinais parecidos com os do Context Rot. O modelo perdia condicionantes do meio do material e confundia laudos quase iguais do mesmo ponto de coleta, que agiam como distratores.
Caio fez um teste a mais para confirmar a suspeita. Repetiu dez das perguntas erradas com os mesmos documentos em ordem inversa, do mais novo para o mais antigo. Três respostas mudaram, duas para certo e uma para errado. Um sistema que muda de resposta quando a ordem dos papéis muda não está lendo tudo com a mesma atenção, e Helena não assinaria um parecer apoiado nele.
Ficou claro para os dois que ampliar a mesa não resolvia. Para 36 dos 38 empreendimentos seria preciso dividir de qualquer jeito, e mesmo nos dois que cabiam a leitura de uma vez perdia o meio. A pergunta de Caio mudou de “como colar mais texto” para “como dividir o acervo, mandar cada pedaço a uma leitura curta e juntar os resultados sem perder a evidência”.
Compare o limite declarado do modelo com o desempenho em perguntas do seu acervo. Registre onde a resposta piora e quanto a leitura custa. A recursão passa a ser candidata quando dividir o trabalho preserva a evidência e melhora o resultado dentro do orçamento; o próximo capítulo mostra onde o material fica durante essa divisão.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- IA local: rodar um modelo de linguagem no seu computadorsugerido pelo grafoApresenta o conceito “LLM”, usado em “Quanto texto cabe e quanto a IA consegue usar”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo4 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAstra profundosugerido pelo grafo2 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “Astra profundo”.
O mesmo assunto em outros cursos
- Prompt Engineering para ExecutivosEscolher o que entra na conversa e em que ordemExaminar conexões de Escolher o que entra na conversa e em que ordem
- Custos de IA e orçamentoPrompts e contexto: reduzir tokens com qualidadeExaminar conexões de Prompts e contexto: reduzir tokens com qualidade
- RAG: IA apoiada em documentosComparar representações mais detalhadas do textoExaminar conexões de Comparar representações mais detalhadas do texto
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.