RLM: grandes acervos · Capítulo 1 de 30 · 13 min
De onde vem a informação que a IA usa
Classifique erros de um assistente de IA em informação, contexto, raciocínio ou execução. Esse diagnóstico ajuda a decidir se um modelo de linguagem recursivo, o RLM, resolve o problema.
Este capítulo faz parte do curso gratuito RLM: grandes acervos.
Um modelo de linguagem recursivo, ou RLM, usa um programa para consultar um texto longo por partes. O material fica guardado fora da conversa imediata com a IA, em uma variável: um lugar da memória que o programa consegue ler.
O modelo gera código para localizar e dividir esse material, pode delegar a análise de trechos a outras chamadas de IA e reúne os resultados para responder. A decisão do gestor é verificar se essa organização melhora a resposta com custo e limites aceitáveis, comparando com a leitura direta e a busca em documentos.
Exemplo: Antes de trocar o modelo de IA, precisamos descobrir por que uma resposta falha. Vamos acompanhar a Veredas Ambiental, uma consultoria fictícia de Belo Horizonte, e seus personagens Helena e Caio. O acervo de 6.400 documentos e os resultados apresentados ao longo dessa história são uma simulação didática, não um estudo de cliente. Nesse cenário, catorze anos de processos somam cerca de 52 milhões de tokens, os fragmentos de texto usados pelo modelo.
Helena, coordenadora técnica, responde aos clientes e assina os pareceres. Caio, engenheiro de dados, montou dois anos atrás um assistente de busca vetorial sobre esse acervo. No cenário, ele acerta perguntas como “onde está o laudo de março da PCH” e erra “quantas condicionantes vencidas temos em todos os empreendimentos”. O erro de contagem preocupa Helena porque pode chegar ao cliente sem evidência suficiente.
Ao terminar este capítulo, você saberá distinguir o que um modelo aprendeu, o que recebe na pergunta e o que consulta durante a tarefa. Também poderá classificar as falhas antes de decidir o que mudar. Começaremos pelo diagnóstico e pelas siglas que aparecem no restante do curso.
Três lugares de onde sai a resposta de um modelo de linguagem
Todo modelo de linguagem responde com o que encontra em três lugares. O primeiro são os parâmetros: os bilhões de números ajustados no treino, que guardam o que o modelo aprendeu antes de você chegar. É uma memória parecida com a de quem estudou para uma prova anos atrás: vasta, sem índice e sem data. O modelo não sabe dizer de qual livro tirou cada frase.
Em segundo lugar vem o contexto: o material que chega na chamada, como pergunta, instruções e documentos. A janela de contexto limita quantos tokens cabem nessa interação, como a área de uma mesa para espalhar papéis. O limite varia conforme o modelo e a configuração; parte do espaço também pode ser necessária para a resposta. Antes de dimensionar um projeto, confira a documentação da versão usada.
Ver como texto
Parâmetros, contexto e ferramentas contribuem para a resposta
Ferramentas formam o terceiro lugar. São funções que o modelo chama para buscar ou calcular fora de si: uma busca num índice, uma consulta a banco, um trecho de código executado. O resultado volta para o contexto e só então entra na resposta. Uma calculadora sobre a mesa ajuda quem sabe o que digitar nela; o modelo precisa decidir o que perguntar à ferramenta.
Cada lugar traz uma limitação. A informação aprendida no treino pode estar desatualizada e não fornece, por si só, a fonte de uma afirmação. O contexto ocupa espaço e afeta o custo de processamento. As ferramentas acrescentam trabalho, tempo e possíveis cobranças. Usar os parâmetros não torna a chamada gratuita: o custo depende do serviço, do processamento realizado e do contrato, inclusive das regras de cache.
| Lugar | Como a informação chega | Falha típica | Exemplo na Veredas |
|---|---|---|---|
| Parâmetros | Aprendida no treino, antes da pergunta | Resposta plausível e desatualizada, sem origem | O modelo “lembra” uma norma genérica de outorga que não vale para Minas Gerais |
| Contexto | Colada na chamada, junto com a pergunta | O trecho certo ficou fora da janela ou se perdeu no meio dela | O laudo que contradiz o anterior não estava entre os trechos enviados |
| Ferramentas | Buscada ou calculada durante a execução | A ferramenta devolve pouco, demais ou a coisa errada | A busca vetorial traz 8 trechos parecidos com a pergunta e nenhum com a data de vencimento |
Exemplos do cenário composto da Veredas Ambiental, usado em todo o curso.
Os três lugares podem contribuir para o mesmo pedido. Para acompanhar a execução, separe quatro gestos: receber a pergunta e o material; recuperar informações adicionais; usar as evidências para raciocinar; e entregar uma resposta verificável. Uma falha pode ocorrer em mais de um desses momentos.
- Etapa 1 de 4: Receber
Pergunta, instruções e documentos entram na janela de contexto
- Etapa 2 de 4: Recuperar
O que falta vem dos parâmetros ou de uma ferramenta de busca
- Etapa 3 de 4: Usar
O modelo raciocina sobre o material e escreve a resposta
- Etapa 4 de 4: Entregar
A resposta sai no formato pedido, dentro do limite de saída
Ver como texto
- Receber: Pergunta, instruções e documentos entram na janela de contexto
- Recuperar: O que falta vem dos parâmetros ou de uma ferramenta de busca
- Usar: O modelo raciocina sobre o material e escreve a resposta
- Entregar: A resposta sai no formato pedido, dentro do limite de saída
A primeira arquitetura famosa para o gesto de recuperar é o RAG, sigla de geração aumentada por recuperação. Patrick Lewis e mais onze autores do Facebook AI Research, da UCL e da NYU publicaram a proposta em maio de 2020. O modelo consulta passagens da Wikipédia indexadas por significado e escreve a resposta com elas à vista. Na época, atingiu o melhor resultado em três testes de perguntas abertas.
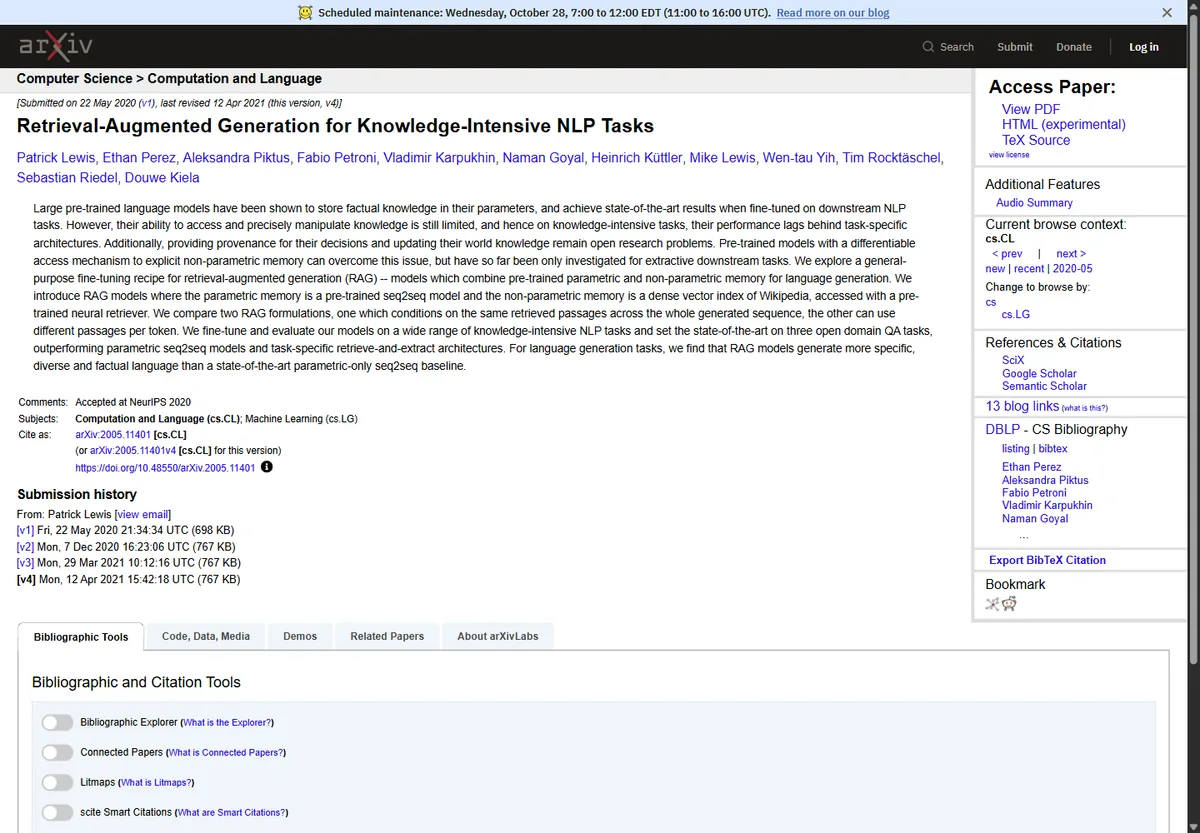
Os autores chamavam os parâmetros de memória paramétrica e o índice de memória não paramétrica. A recuperação por significado pode encontrar passagens mesmo quando elas usam palavras diferentes da pergunta. Buscar poucos trechos é útil para localizar uma evidência, mas pode ser insuficiente para uma contagem que exige cobertura ampla. Nesse caso, avalie filtros, novas buscas, consultas estruturadas ou leitura sistemática do acervo.
Os RLMs oferecem outra forma de organizar essa leitura: mantêm o material em um ambiente externo e permitem que o modelo escreva código para examiná-lo, selecionar partes e consultar outros modelos sobre elas. Os trechos e resultados necessários voltam ao contexto das chamadas. Essa organização também pode combinar busca com processamento por partes; a escolha depende da tarefa.
Onde o acervo fica em cada desenho
Recuperação de poucos trechos
Selecionar evidências
- Busca passagens relevantes por significado ou outros critérios
- O modelo recebe as passagens selecionadas
- Pode resolver uma pergunta localizada
- Para contar ocorrências, é preciso verificar a cobertura
Leitura programada com RLM
Organizar a leitura
- Mantém o acervo em um ambiente externo
- Permite examinar partes com código
- Pode consultar modelos e combinar busca com leitura
- Precisa verificar cobertura, resultado, tempo e custo
O vocabulário do curso e as siglas que parecem iguais
RLM quer dizer Recursive Language Model, modelo de linguagem recursivo. Alex L. Zhang e Omar Khattab apresentaram a ideia num post de blog em 15 de outubro de 2025. O artigo, assinado por Zhang, Tim Kraska e Khattab, os três do MIT CSAIL, saiu no arXiv em 31 de dezembro de 2025. A versão atual, a terceira, é de 11 de maio de 2026.
Pela definição do artigo, o RLM é uma estrutura de inferência montada em volta de um modelo comum. Estrutura de inferência é o programa que organiza as chamadas ao modelo na hora de responder, sem mudar os pesos dele. Por fora, a interface continua a de sempre: entra texto, sai texto. Por dentro, o prompt vira uma variável num ambiente de programação, e o modelo escreve código para ler essa variável aos pedaços.
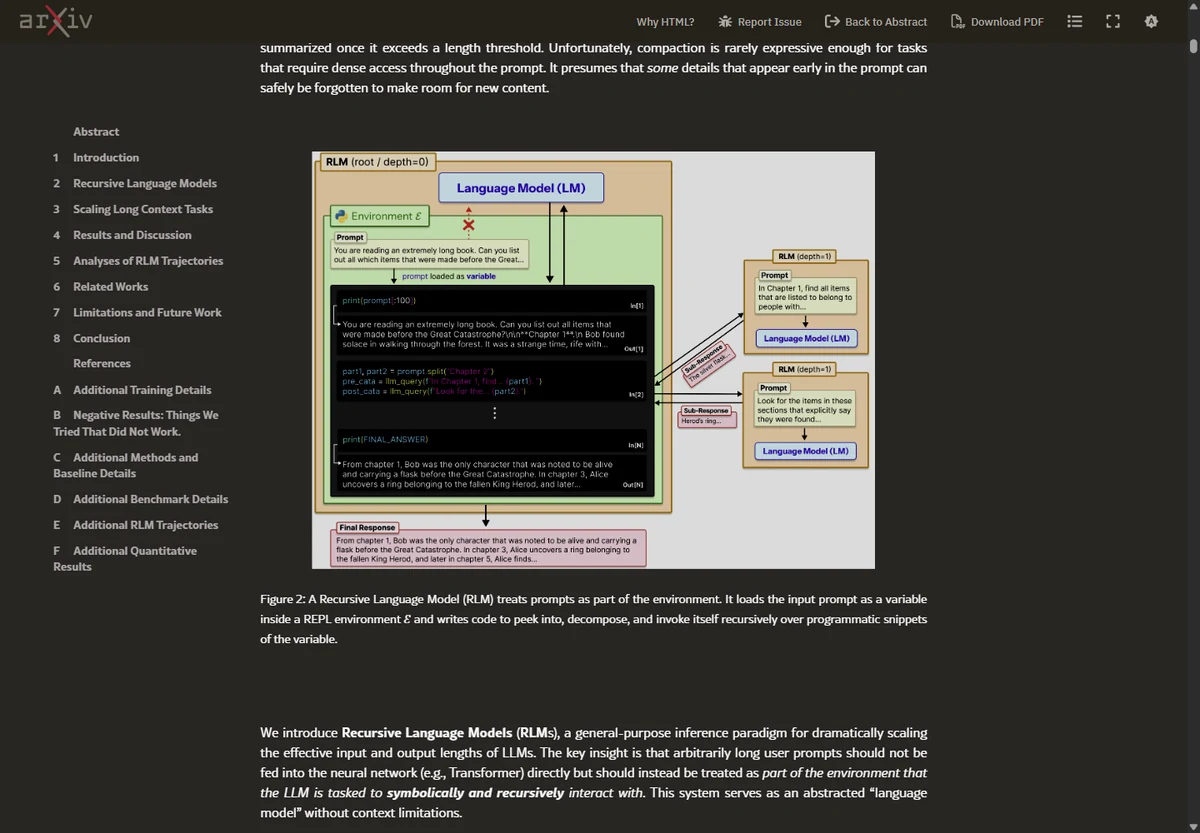
Recursivo, aqui, significa que o código escrito pelo modelo pode chamar o próprio modelo, ou uma cópia menor dele, sobre um pedaço do material. Cada chamada devolve um resultado que o código guarda e combina. A resposta final nasce dessa árvore de chamadas, e nenhuma delas precisa ler o acervo inteiro. A versão atual do artigo afirma que isso processa entradas mais de uma ordem de grandeza acima da janela do modelo.
| Termo | O que é | O que muda | Relação com o RLM |
|---|---|---|---|
| RLM (modelo de linguagem recursivo) | Estrutura de inferência em que o modelo lê o prompt por código e chama a si mesmo sobre pedaços | Como a pergunta é respondida, sem mexer nos pesos | É o assunto do curso |
| RL (aprendizado por reforço) | Método de treino que ajusta os pesos por recompensa a cada tentativa | O próprio modelo, depois do treino | Pode treinar um modelo para operar como RLM, mas é outra coisa |
| Memória persistente | Registro que sobrevive entre conversas, como notas ou banco de fatos do usuário | O que o assistente lembra na sessão seguinte | O REPL de um RLM guarda variáveis durante uma execução, e não entre sessões |
| Auto-melhoria recursiva | Sistema que reescreve as próprias regras ou ferramentas a partir do que fez | O agente muda de uma execução para outra | Um agente pode usar RLM e se automelhorar, como o Prime Agent de agosto de 2026 |
Os quatro termos aparecem juntos em anúncios e posts, mas não significam a mesma coisa. Organizar chamadas recursivas não faz o modelo aprender automaticamente com cada pergunta nem altera seus pesos. A preservação de variáveis, registros e resultados depende da implementação. Se a empresa precisa de memória entre sessões, deve projetar e avaliar essa função separadamente.
RLM designa uma abordagem, e não um produto único. O projeto de referência publica a biblioteca rlms; o DSPy oferece o módulo dspy.RLM. As implementações diferem em limites, ferramentas e isolamento. Para uma decisão de compra ou adoção, verifique a versão, os modelos compatíveis e as condições do teste, em vez de inferir capacidade a partir da sigla.
De onde vem o vocabulário, em datas
- 22 de maio de 2020Concluído
RAG de Lewis et al.
Buscar passagens num índice e gerar a resposta com elas; aceito no NeurIPS 2020.
- 12 de outubro de 2023Concluído
MemGPT
Gerencia o contexto como a memória virtual de um sistema operacional, trocando páginas entre a janela e um armazenamento externo.
- 27 de maio de 2024Concluído
THREAD
O modelo abre linhas de execução filhas sobre subtarefas; supera outros frameworks em 10 a 50 pontos absolutos com modelos menores.
- 14 de julho de 2025Concluído
Context Rot, da Chroma
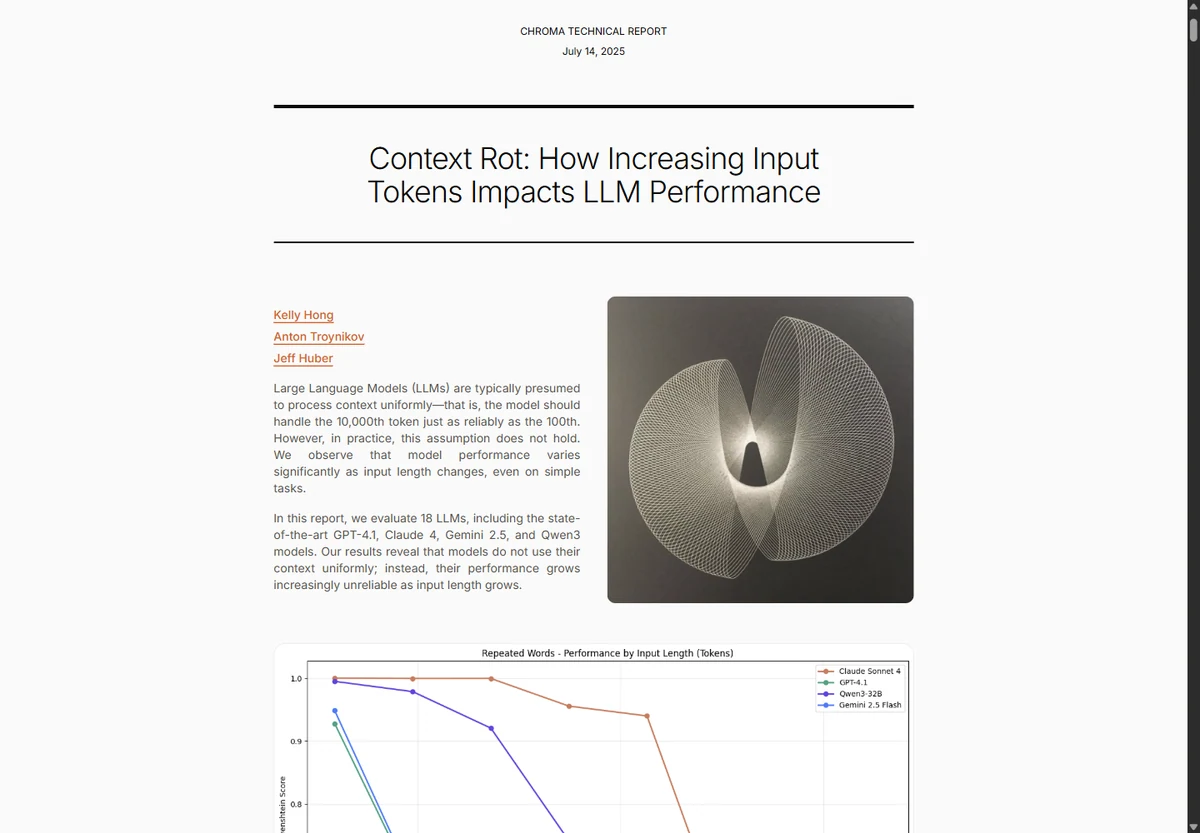
Dezoito modelos pioram à medida que a entrada cresce, mesmo em testes simples.
- 15 de outubro de 2025Concluído
Post de Alex L. Zhang
Primeira apresentação dos RLMs, com experimentos preliminares no OOLONG e no BrowseComp-Plus.
- 31 de dezembro de 2025Concluído
Artigo no arXiv, versão 1
Zhang, Kraska e Khattab, do MIT CSAIL, formalizam o método.
- 19 de janeiro de 2026Concluído
dspy.RLM no DSPy 3.1.1
Primeira implementação num framework amplo, marcada como experimental.
- 11 de maio de 2026Agora
Versão 3 do artigo
Profundidades de 0 a 3, comparação com o Claude Code e a formulação “mais de uma ordem de grandeza”.
Com as palavras no lugar, a pergunta útil passa a ser “em qual dos quatro gestos o meu sistema falha?”. Uma falha de recuperação pede investigar a busca; uma falha de interpretação pede avaliar o modelo e a forma de apresentar as evidências. Trocar por um modelo maior pode ajudar em algumas tarefas, mas não corrige, por si só, a ausência do material necessário.
Como a Veredas descobriu por que o assistente contava errado
Helena levou a Caio uma pergunta de negócio que o assistente nunca acertava: “quais condicionantes de monitoramento hídrico estão vencidas ou com laudos contraditórios, em quais empreendimentos, e com que evidência?”. Condicionante é a obrigação que o órgão ambiental impõe na licença, como medir a turbidez de um córrego a cada trimestre e entregar o laudo. Vencida quer dizer prazo passado sem laudo entregue.
Antes de trocar qualquer peça, os dois montaram um conjunto de avaliação. Helena escreveu 120 perguntas com a resposta de referência de cada uma: 40 de localização, 50 de agregação ou contagem e 30 de cruzamento entre pares de documentos. Cruzamento é comparar um documento com outro, como o laudo de 2023 com o de 2024 do mesmo poço, para achar contradição.
Ver como texto
Acertos da busca vetorial por tipo de pergunta: 36 de 40 em localização, 21 de 50 em agregação e 7 de 30 em cruzamento
Rodado sobre as 120 perguntas, o assistente de busca vetorial acertou 64. O retrato por tipo de pergunta mostrou o padrão que Helena já sentia no dia a dia: 36 de 40 em localização, 21 de 50 em agregação e 7 de 30 em cruzamento. O sistema era bom em achar e ruim em juntar.
Caio então abriu cada um dos 56 erros e perguntou em qual gesto a resposta tinha quebrado. Criou quatro rótulos. Informação: o dado não existia no índice, como laudos escaneados sem texto legível. Contexto: o dado existia, mas não chegou ao modelo. Raciocínio: o dado chegou e o modelo concluiu errado, como comparar datas em formatos diferentes. Execução: a resposta quebrou no caminho, cortada ou fora do formato.
- Etapa 1 de 4: O dado existe no índice?
Se não existe, o erro é de informação
- Etapa 2 de 4: O dado chegou ao modelo?
Se não chegou, o erro é de contexto
- Etapa 3 de 4: A conclusão bate com o material?
Se não bate, o erro é de raciocínio
- Etapa 4 de 4: A resposta saiu inteira e no formato?
Se não saiu, o erro é de execução
Ver como texto
- O dado existe no índice?: Se não existe, o erro é de informação
- O dado chegou ao modelo?: Se não chegou, o erro é de contexto
- A conclusão bate com o material?: Se não bate, o erro é de raciocínio
- A resposta saiu inteira e no formato?: Se não saiu, o erro é de execução
Com a regra escrita, o rótulo deixou de depender do palpite de quem lia o erro. Para conferir, Helena sorteou 15 dos 56 rótulos para revisar e discordou de 2. Os dois eram laudos que chegaram ao modelo pela metade, e ambos ficaram como erro de contexto.
| Tipo de pergunta | Erros | Informação | Contexto | Raciocínio | Execução |
|---|---|---|---|---|---|
| Localização (40) | 4 | 2 | 1 | 0 | 1 |
| Agregação e contagem (50) | 29 | 3 | 19 | 4 | 3 |
| Cruzamento entre pares (30) | 23 | 1 | 11 | 8 | 3 |
| Total (120) | 56 | 6 | 31 | 12 | 7 |
Cenário composto da Veredas Ambiental. Erros = perguntas menos acertos (40 − 36, 50 − 21, 30 − 7).
Trinta e um dos 56 erros, mais da metade, eram de contexto. O dado estava no acervo e no índice, e o modelo nunca o viu. A causa ficou clara quando Caio contou os documentos que cada resposta exigia. Uma pergunta de contagem sobre condicionantes hídricas em todos os empreendimentos precisava de cerca de 300 documentos. O assistente mandava ao modelo os 8 trechos mais parecidos com a pergunta.
Oito trechos não equivalem a oito documentos completos. Dividir esse número por 300 não mede a cobertura do acervo. Caio precisa verificar quais documentos relevantes chegaram à resposta, se as passagens contêm as datas necessárias e quais ficaram de fora. A busca por significado pode encontrar sinônimos, mas a estratégia de recuperação precisa atender à pergunta: localizar uma passagem e contar todas as ocorrências exigem verificações diferentes.
No cenário, os 12 erros de raciocínio pesavam mais no cruzamento. Mesmo com os dois laudos disponíveis, o modelo misturava unidades, confundia o ponto de coleta ou usava a data de emissão como data de amostragem. Aumentar o contexto, por si só, não garante resolver essas falhas. Os seis erros de informação exigiam melhorar a extração dos PDFs escaneados.
Daí sai também um teto. Se uma nova arquitetura consertasse todos os 31 erros de contexto e nenhum outro, o placar subiria de 64 para 95 acertos em 120. Esse número não promete nada; ele diz até onde vale investir na forma de expor o acervo antes de atacar raciocínio e extração. Proposta que prometa mais precisa explicar qual dos outros três tipos de erro também resolve.
O diagnóstico da Veredas, antes e depois da classificação
Leitura inicial
Antes
- “O modelo é fraco em contas”
- Plano: trocar por um modelo maior
- Nenhuma medida por tipo de pergunta
- Erros discutidos caso a caso, de memória
Leitura depois dos 56 rótulos
Depois
- 31 erros vêm de material que nunca chegou ao modelo
- Plano: mudar a forma de expor o acervo ao modelo
- Placar de 36, 21 e 7 por tipo, guardado como linha de base
- 6 erros encaminhados à extração de texto, fora do modelo
Helena decidiu manter o assistente nas perguntas de localização, em que o cenário registra 90% de acerto, e testar outras formas de recuperar e combinar evidências. Caio ficou com uma pergunta: como processar um acervo de 52 milhões de tokens quando ele excede a janela do modelo escolhido, sem perder o controle sobre o que foi consultado?
Como ler as evidências deste curso. A Veredas, seus personagens, resultados e contas formam um cenário fictício. Resultados de pesquisa aparecem com a publicação de origem; recursos de bibliotecas dependem da versão consultada. A revisão de 24 de outubro de 2026 incorpora trabalhos publicados desde agosto e mantém os textos anteriores que explicam os fundamentos.
A primeira decisão é escolher o problema certo. Classifique as falhas do seu assistente: informação ausente, trecho não recuperado, interpretação errada ou execução incompleta. Conte quantos documentos cada resposta precisa consultar. Esse diagnóstico, e não um número fixo de documentos, determina se vale testar outra forma de leitura.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Organize a página para responder à dúvida do clientesugerido pelo grafoApresenta os conceitos “Busca vetorial” e “Janela de contexto”, usados em “De onde vem a informação que a IA usa”.
- Conferir a resposta no documento certosugerido pelo grafoApresenta o conceito “RAG”, usado em “De onde vem a informação que a IA usa”.
- IA local: rodar um modelo de linguagem no seu computadorsugerido pelo grafoApresenta o conceito “LLM”, usado em “De onde vem a informação que a IA usa”.
- CursoRAG: IA apoiada em documentossugerido pelo grafo10 capítulos de “RLM: grandes acervos” usam conceitos apresentados em “RAG: IA apoiada em documentos”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- RAG: IA apoiada em documentosConferir a resposta no documento certoExaminar conexões de Conferir a resposta no documento certo
- Síntese e didática com IAMonte sua biblioteca de prompts de síntese e revisãoExaminar conexões de Monte sua biblioteca de prompts de síntese e revisão
- Autoridade temáticaEscrever respostas que fazem sentido fora da páginaExaminar conexões de Escrever respostas que fazem sentido fora da página
- IA local na práticaComo a IA usa seu pedido e seus dadosExaminar conexões de Como a IA usa seu pedido e seus dados
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.