SEO programático · ·
Escolher quais páginas devem aparecer na busca
Conferir inventário e utilidade antes da indexação; distinguir uma página acessível de uma página elegível para ser encontrada.
Este capítulo faz parte do curso gratuito SEO programático.
O gerador pode criar mais combinações do que a fonte consegue preencher. No Radar, projeto hipotético, a matriz de localidades e combustíveis é maior que a cobertura observada em uma semana da ANP. Produzir uma rota não resolve essa falta de informação.
Separe três situações: página com dado útil e atual; página temporariamente sem atualização, mas com histórico relevante; e combinação sem informação nem função para o leitor. Cada situação pode exigir uma decisão diferente de publicação ou indexação. Deixar milhares de páginas vazias para o buscador escolher não substitui esse trabalho editorial.
A política de spam do Google define doorway assim: sites ou páginas criadas para rankear em consultas específicas e similares, que levam o usuário a páginas intermediárias menos úteis que o destino final. E dá o exemplo que descreve literalmente uma matriz geográfica sem dado: múltiplos domínios ou páginas voltadas a regiões ou cidades específicas que funilam usuários. Cinco mil páginas idênticas com o nome do município trocado casam com essa definição palavra por palavra.
Ver como texto
A matriz combinatória inteira entra no gerador, um portão de inventário consulta o registro real da semana em tempo de render, e a saída se divide em página indexável com canonical próprio e página existente com noindex, com as duas URLs auditáveis do QuintoAndar anotadas embaixo.
Páginas criadas para compartilhar não precisam ser indexadas por padrão. Em 26/10/2026, a documentação de prevenção de abuso reforçou essa distinção para conteúdo gerado por usuários. Se o produto cria relatórios, listas ou resultados acessíveis por link, decida quais têm utilidade pública. Controle de indexação não protege informação confidencial; para restringir acesso é necessário um mecanismo de autenticação ou autorização apropriado.
O mercado maduro resolve isso de um jeito que você pode auditar com curl em dois minutos, sem ferramenta paga. O QuintoAndar publica no sitemap a matriz combinatória inteira (transação x cidade x bairro x rua x tipo de imóvel x filtro) e aplica noindex por página quando aquela combinação específica não tem estoque que justifique a existência dela.
Os dois comandos abaixo são o exemplo resolvido deste módulo. Rode antes de escrever qualquer linha do seu gerador: a evidência foi coletada em 19/07/2026 e o comportamento é o que você vai reproduzir no Radar.
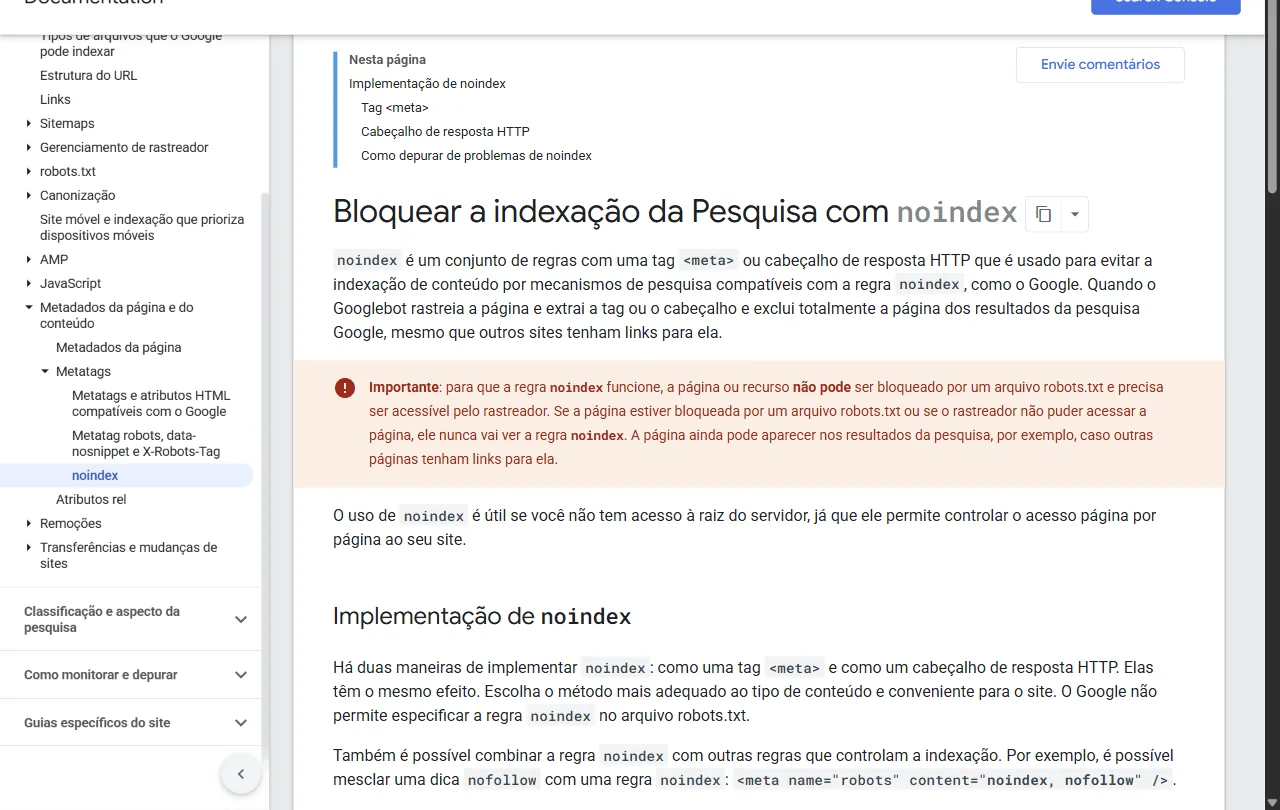
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: exemplo de diretiva e necessidade de acesso para o rastreador.
# Combinação COM inventário: canonical próprio e nenhum meta robots noindex.
curl -s -L "https://www.quintoandar.com.br/alugar/imovel/jardim-aurelia-campinas-sp-brasil/casa/2-quartos" \
  | grep -io 'name="robots" content="[^"]*"\|rel="canonical" href="[^"]*"'

# Combinação SEM inventário: mesma família de URL, mesmo template, noindex aplicado.
curl -s -L "https://www.quintoandar.com.br/alugar/imovel/jardim-jamaica-santo-andre-sp-brasil/casa/proximo-ao-metro" \
  | grep -io 'name="robots" content="[^"]*"'
# -> <meta name="robots" content="noindex">

# A matriz inteira continua declarada no sitemap, inclusive as combinações sem estoque:
curl -s https://www.quintoandar.com.br/sitemap-v2.xml | grep -o "sitemap-v2-[a-z0-9-]*" | head -20
A leitura correta dessa evidência tem três partes, e a ordem importa.
- A decisão acontece em tempo de render, contra o dado real. O template é o mesmo nos dois casos. O que muda é o registro que alimenta aquela URL naquele momento. Não existe uma lista estática de "URLs boas" mantida à mão.
- A URL existir não significa a URL ser indexável. As duas coisas vivem em camadas diferentes: a rota responde 200 para quem chega por link direto, e o
robotsdecide se ela entra no índice. - Isso é a diferença operacional entre SEO programático e doorway. A página existe porque existe estoque, não porque existe uma combinação de strings possível.
O padrão de implementação tem três partes, e falhar em qualquer uma delas derruba as outras duas.
- O registro carrega a informação de cobertura explicitamente. É o que você preparou em [Impedir que dados inválidos virem páginas](#validacao-como-gate-de-build), quando o schema deixou de validar formato e passou a validar conteúdo. Se
postosPesquisadosnão existe no registro, a rota não tem como decidir nada. - A função de metadata decide
robotsa partir do registro, com uma consulta ao dado, nunca com uma lista fixa no código. - O limiar é um número declarado e revisável, com data e motivo escritos, em vez de uma intuição espalhada por três arquivos.
// src/lib/radar/limiar.ts
// O limiar mora em UM lugar, tem data de revisão e tem motivo escrito.
// Quando alguém perguntar "por que 3 postos?", a resposta está no código.

export const LIMIAR_INDEXACAO = {
  postosMinimos: 3,
  exigeColetaNaSemana: true,
  revisadoEm: "2026-07-19",
  motivo:
    "Preço médio calculado sobre um ou dois postos descreve aqueles postos, " +
    "não o município. Abaixo de 3 postos a página não entrega o dado que promete.",
} as const;

export type RegistroPreco = {
  municipioIbge: string;
  combustivel: "gasolina-comum" | "etanol" | "diesel-s10" | "glp";
  semanaIso: string;
  precoMedio: number | null;
  postosPesquisados: number;
  temColetaNaSemana: boolean;
};

export function decidirIndexacao(registro: RegistroPreco | null): boolean {
  if (registro === null) return false;
  if (LIMIAR_INDEXACAO.exigeColetaNaSemana && !registro.temColetaNaSemana) return false;
  if (registro.precoMedio === null) return false;
  return registro.postosPesquisados >= LIMIAR_INDEXACAO.postosMinimos;
}// src/app/preco/[uf]/[municipio]/[combustivel]/page.tsx
// Next.js 16: params é uma Promise em page e em generateMetadata.
import type { Metadata } from "next";
import { buscarRegistro } from "@/lib/radar/registro";
import { decidirIndexacao } from "@/lib/radar/limiar";
type Params = { uf: string; municipio: string; combustivel: string };
const BASE = "https://radar-combustivel.exemplo.com.br";
export async function generateMetadata(
props: { params: Promise<Params> },
): Promise<Metadata> {
const { uf, municipio, combustivel } = await props.params;
const registro = await buscarRegistro(uf, municipio, combustivel);
const indexavel = decidirIndexacao(registro);
return {
title: registro?.precoMedio
? "Preço médio de " + combustivel + " em " + municipio + " (" + uf + ")"
: "Sem coleta de preço em " + municipio + " (" + uf + ") nesta semana",
alternates: {
// Canônica autorreferencial: a própria URL que responde 200.
canonical: BASE + "/preco/" + uf + "/" + municipio + "/" + combustivel,
},
robots: indexavel
? { index: true, follow: true }
: { index: false, follow: true },
};
}Repare no follow: true do ramo negativo. A página não entra no índice e continua passando link para as páginas vizinhas que têm dado. Aplicar noindex, nofollow por reflexo corta a descoberta interna do seu próprio catálogo. E jamais bloqueie no robots.txt uma URL que carrega noindex: o bloqueio impede o rastreio e, sem rastrear, o Google não vê o noindex que você aplicou.
A página com noindex não pode ser uma casca vazia. Alguém vai chegar nela por link direto, por histórico ou por compartilhamento, e essa pessoa merece uma resposta.
No Radar, a página de município sem coleta diz três coisas, nessa ordem: que não houve coleta da ANP naquela semana para aquele município, quando foi a última semana com dado (se houver), e para onde ir agora, que é a média da UF e os municípios vizinhos com coleta. Isso mantém a página útil ao usuário, honesta sobre a ausência do dado e ligada ao resto do acervo, sem pedir ao buscador que a trate como conteúdo indexável.
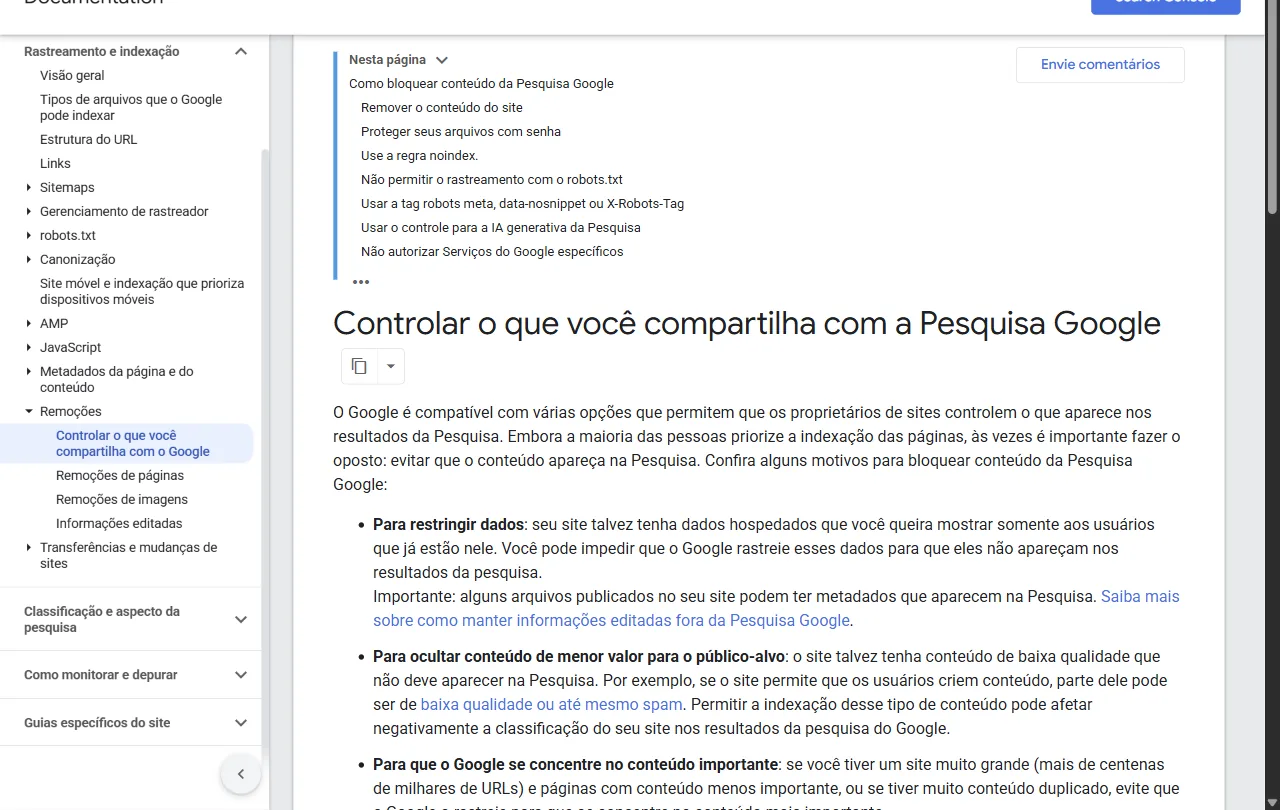
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: opções distintas para controlar acesso, indexação e exibição.
Ver como texto
Anatomia da página sem dado: um navegador mostrando os três blocos que ela precisa ter (o que falta, a última semana com dado, para onde ir agora) e, ao lado, o que precisa estar no HTML da origem, o status 200 obrigatório e o erro de bloquear a URL no robots.txt.
Canonical pertence a este módulo, e não ao de sitemap, porque ela é irmã da decisão de indexação: as duas declaram intenção sobre uma página que já existe.
A mesma documentação é explícita quanto ao status da tag: rel="canonical" é preferência e não diretiva. O texto oficial diz que nenhum desses sinais é obrigatório, e que o seu site provavelmente vai se sair bem sem especificar preferência de canônica, porque o Google identifica qual versão da URL é objetivamente a melhor para mostrar. Ela também recomenda a canônica autorreferencial na própria página canônica, que é o que o código acima faz.
A consequência para site programático é dura e vale escrever na parede: canonical não conserta duplicação. Ela declara preferência sobre um problema que continua existindo. Se duas páginas do seu gerador precisam de canonical apontando uma para a outra, a pergunta certa não é qual das duas ganha a tag. A pergunta é por que as duas foram geradas.
Ver como texto
Hierarquia declarada pelo Google para canonicalização em três degraus: redirect é sinal forte, rel=canonical é sinal forte porém preferência e não diretiva, e inclusão em sitemap é sinal fraco.
Se o seu gerador injeta noindex por JavaScript depois da hidratação, ele está construindo sobre comportamento que o Google declarou indefinido em 15/12/2025. Indefinido significa que pode funcionar hoje, falhar amanhã e você nunca saber qual das duas coisas aconteceu. Some a isso o esclarecimento de 18/12/2025, de que páginas com status HTTP diferente de 200 podem não ser enviadas para renderização: se a sua página de "sem dado" responde 404 esperando que um script depois ajuste alguma coisa, o script pode nem rodar. A decisão de indexação pertence ao servidor, no HTML da origem, antes de qualquer hidratação.
Ver como texto
Três esclarecimentos do Google em dezembro de 2025, cada um com o trecho de código que ele invalida: noindex injetado por JavaScript tem comportamento indefinido, canônica definida na hidratação não serve, e resposta com status diferente de 200 pode não ir para renderização.
Antes de subir o gerador, faça o teste do bot burro: baixe a página com curl e leia o HTML cru. O meta name="robots" e o rel="canonical" corretos precisam estar ali, no primeiro byte que chega, sem JavaScript nenhum. Se você precisa abrir o inspetor do navegador para ver a tag, o crawler pode nunca vê-la. É o mesmo comando que você usou para auditar o QuintoAndar, apontado agora para o seu próprio site.
O relatório de indexação do Search Console pode mostrar Crawled - currently not indexed: a página foi rastreada, mas ainda não está indexada. Ela pode entrar no índice depois; a documentação informa que não é necessário reenviar a URL apenas por esse estado.
O aviso não diagnostica, sozinho, duplicação ou baixa qualidade. Compare grupos de páginas, conteúdo, canonical, links internos e tempo desde a publicação. Se a amostra revelar páginas que pouco acrescentam, melhore ou consolide o conjunto. A ação deve responder à causa encontrada, e não apenas tentar fazer o rótulo desaparecer. [Acompanhar o acervo no Search Console](#medicao-gsc-e-bigquery) mostra como investigar.
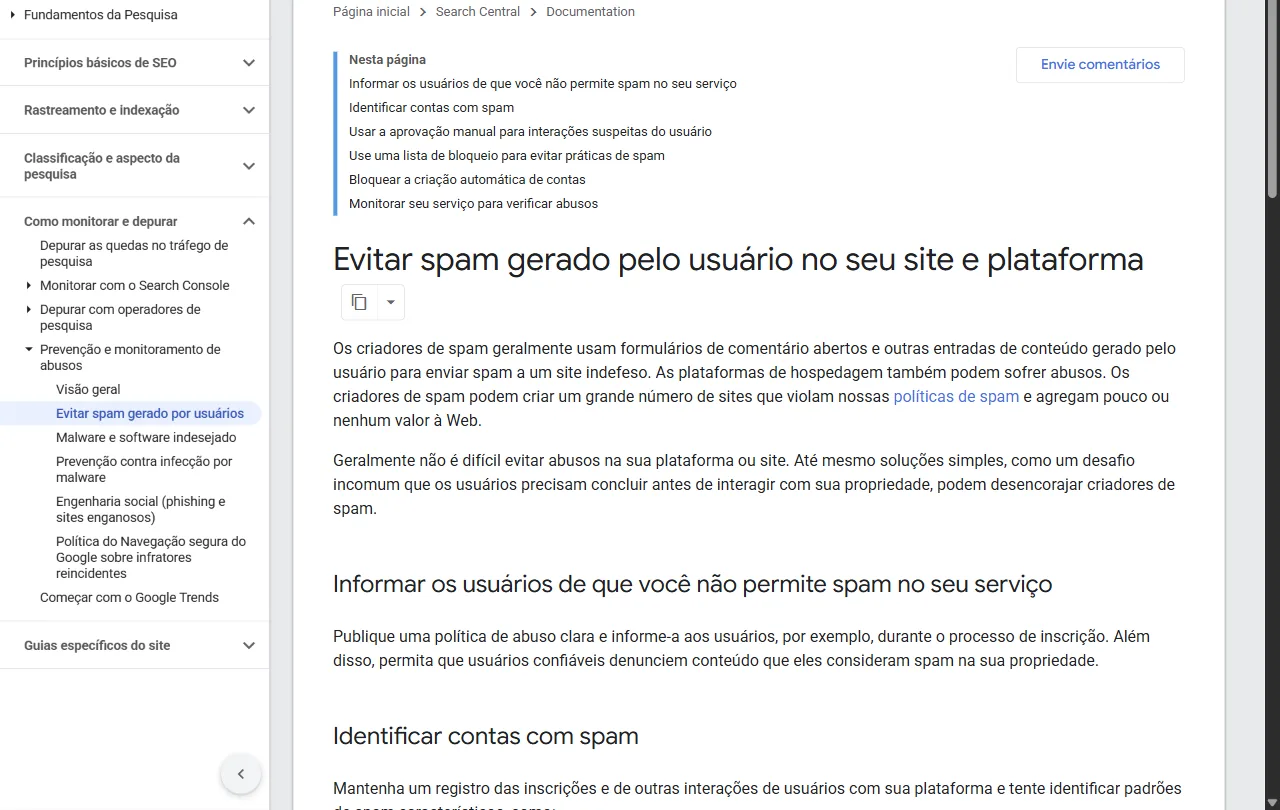
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: controles para páginas criadas por usuários e acompanhamento de abuso.
Aplique o limiar do Radar (coleta na semana e pelo menos 3 postos) a cinco casos e justifique pelo mecanismo, não pelo número. Sorriso (MT), diesel S10, 11 postos: index. Nova Bandeirantes (MT), etanol, sem coleta há 14 semanas: noindex com caminho para a média da UF. Campinas (SP), gasolina, 46 postos: index. Itaquaquecetuba (SP), GLP, 2 postos: noindex, porque o preço descreve dois postos e não o município. Barreiras (BA), etanol, exatamente 3 postos com dispersão alta: passa no limiar, e é aí que vale acrescentar ao registro um campo de dispersão, em vez de subir o corte de 3 para 5. Leve a mesma lista de casos de fronteira do seu projeto à reunião com quem constrói.
O guia abaixo é para quem aprova o lançamento de um acervo novo ou herdou um catálogo com muitas páginas rastreadas e não indexadas. Ele destrava a decisão de quantas páginas vão para o índice nesta semana, e por quê.
Guia de implementação: ligar o portão de inventário
Cinco passos para que a decisão de indexação saia do dado, e não de uma lista mantida à mão.
Passo 1: Exigir o campo de cobertura no registro
Cada registro precisa dizer se houve coleta na semana e quantos pontos sustentam o número.
Deu certo quando: O schema recusa registro sem o campo de cobertura preenchido.
Erro comum: Inferir cobertura pelo preço preenchido, sem contar quantos postos o sustentam.
Passo 2: Escrever o limiar num lugar só
O corte vive em um arquivo, com data de revisão e motivo em uma frase.
Deu certo quando: Qualquer pessoa responde "por que 3 postos?" lendo um único arquivo.
Erro comum: Espalhar o mesmo número por três arquivos e esquecer um deles na revisão.
Passo 3: Decidir robots no servidor
A função de metadata consulta o registro da rota e devolve index ou noindex no HTML da origem.
Deu certo quando: O `curl` da URL mostra a meta robots correta no HTML cru, sem JavaScript.
Erro comum: Injetar noindex por JavaScript depois da hidratação, comportamento que o Google chama de indefinido.
Passo 4: Dar à página sem dado uma resposta útil
A URL sem coleta responde 200, diz a última semana com dado e aponta para a média da UF.
Deu certo quando: Quem chega por link direto encontra caminho, e a página fica fora do índice.
Erro comum: Bloquear a URL no robots.txt, o que impede o Google de ler o noindex.
Passo 5: Publicar o número semanal de páginas indexáveis
O painel mostra quantas páginas passaram no limiar e quantas ficaram de fora nesta semana.
Deu certo quando: A diretoria recebe um número com data, e não uma impressão sobre o acervo.
Erro comum: Reenviar URLs ou pingar sitemap para tentar tirar páginas de "rastreada, mas não indexada".
No fim você tem: Um acervo em que cada página indexável tem dado que a justifica, um limiar auditável e um número semanal de páginas no índice que a diretoria consegue cobrar.
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Campo de cobertura no registro | Engenheiro de dados | 1 a 2 dias | Registro sem cobertura é recusado na validação |
| Limiar declarado | Dono do dado com o analista de SEO | 2 horas de reunião; sem custo de licença | Arquivo único com número, data e motivo |
| Robots decidido no servidor | Desenvolvedor | 1 a 2 dias | curl em duas URLs, uma com e outra sem dado |
| Página sem dado útil | Desenvolvedor e gerente de conteúdo | 1 dia | URL sem coleta responde 200 e mostra caminho |
| Número semanal no painel | Analista de SEO | Meio dia na primeira vez | Contagem com data no relatório do comitê |
Guia prático: conferir o portão de inventário nas telas do Search Console. Depois que as páginas sem dado saem com noindex ou nem nascem, duas telas mostram se o Google leu o acervo do jeito planejado: o relatório de indexação de páginas, que mostra o grupo, e a inspeção de URL, que mostra a página. O roteiro abaixo segue a ajuda oficial consultada em 01/10/2026.
Ver como texto
Página de ajuda do Search Console em português, intitulada Relatório de indexação de páginas, com a frase Saiba quais páginas do seu site o Google consegue encontrar e indexar e o botão Abrir o relatório de indexação de páginas.
Ler o relatório de indexação de páginas por grupo de template
Cinco passos, uma vez por semana nas oito primeiras semanas do lote. O filtro por sitemap só funciona bem se cada pedaço do sitemap corresponder a um grupo de páginas.
Passo 1: Troque o filtro do topo para o sitemap do grupo
O padrão é Todas as páginas conhecidas. Escolha Todas as páginas enviadas e, em seguida, o arquivo do grupo que está sendo lido.
Deu certo quando: O gráfico mostra só as páginas do grupo, separadas entre indexadas e não indexadas.
Erro comum: Ler o site inteiro e misturar o acervo programático com o blog e as páginas institucionais.
Passo 2: Separe o motivo esperado dos motivos de alerta
Excluída pela tag noindex é o portão funcionando. Rastreada, mas ainda não indexada é o sinal de que o Google leu e não viu valor suficiente.
Deu certo quando: A tabela abaixo foi preenchida com a contagem de cada motivo para o grupo.
Erro comum: Abrir chamado técnico para o noindex que o próprio portão aplicou.
Passo 3: Abra os exemplos e exporte
A lista de exemplos de cada motivo tem limite de mil linhas, mesmo quando o grupo é maior.
Deu certo quando: A planilha exportada mostra se as páginas paradas têm um traço em comum, como a mesma faixa de população.
Erro comum: Concluir que o problema atinge só as mil páginas listadas.
Passo 4: Corrija o grupo inteiro, não a página da amostra
Se o motivo for valor baixo, a correção é de template ou de dado, como no capítulo "Construir um modelo de página que responda bem".
Deu certo quando: A correção entra no template e muda todas as páginas do grupo de uma vez.
Erro comum: Reescrever à mão as dez páginas que apareceram na amostra.
Passo 5: Clique em Validar correção e marque a data
A ajuda oficial diz que a validação leva até duas semanas, e pode levar muito mais.
Deu certo quando: A validação aparece em andamento, e a data entra no registro do lote.
Erro comum: Pedir nova validação a cada dois dias e reiniciar a contagem.
No fim você tem: Uma leitura semanal por grupo, com o motivo de cada página fora do índice separado entre esperado e alerta.
| Motivo na tela | O que costuma indicar no acervo | Ação |
|---|---|---|
| Excluída pela tag noindex | O portão de inventário funcionando | Nenhuma, se a contagem bate com as páginas sem dado |
| Rastreada, mas ainda não indexada | Página lida e julgada sem valor suficiente | Rever densidade do template e dado exclusivo do grupo |
| Detectada, mas não indexada no momento | Fila de rastreio, comum em lote grande e recente | Esperar e conferir links internos para o grupo |
| Erro soft 404 | Página que responde 200 com aparência de vazia | Responder 404 de verdade quando falta o registro |
| Página alternativa com canonical adequado | Variação apontando para a página principal | Nenhuma, se a variação foi feita para isso |
| Cópia sem canonical escolhido pelo usuário | Páginas quase iguais que o Google agrupou sozinho | Fundir as páginas ou declarar a principal |
Nomes dos motivos conforme a ajuda do relatório de indexação de páginas, consultada em 01/10/2026.
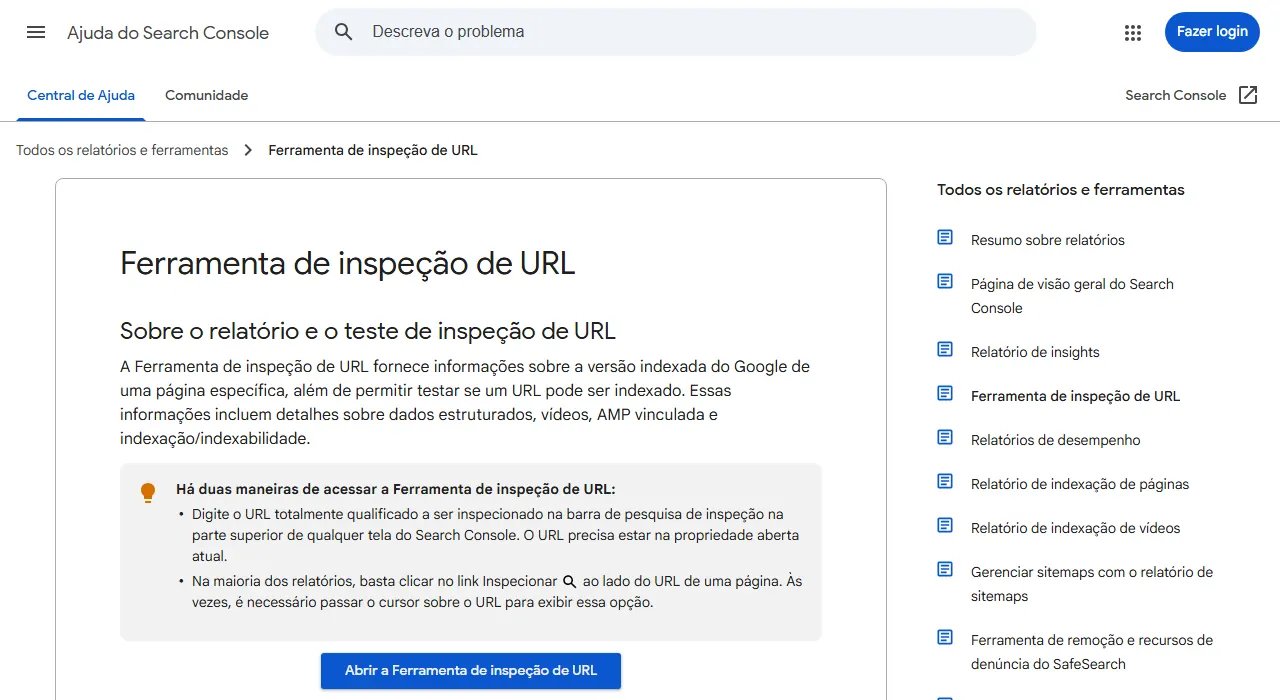
Ver como texto
Página de ajuda do Search Console em português, intitulada Ferramenta de inspeção de URL, com o quadro que explica as duas maneiras de acessar a ferramenta: pela barra de pesquisa no topo de qualquer tela ou pelo link Inspecionar ao lado de uma URL nos relatórios.
Inspecionar uma amostra de dez páginas por grupo
Quatro passos para confirmar, página a página, o que o relatório mostrou no agregado. Sorteie dez URLs do grupo: cinco indexadas e cinco fora do índice.
Passo 1: Rode Testar o URL publicado e abra Ver a página rastreada
O HTML rastreado é o que o Google leu, depois da renderização.
Deu certo quando: O dado exclusivo da página, como o preço da semana ou o estoque da loja, está no HTML rastreado.
Erro comum: Dado carregado só no navegador do visitante, que some no HTML que o Google leu.
Passo 2: Compare o canonical declarado com o escolhido pelo Google
A tela mostra os dois lado a lado na seção de indexação.
Deu certo quando: Os dois campos apontam para a mesma URL em todas as páginas da amostra.
Erro comum: O Google escolhendo a página de outra cidade como principal, sinal de páginas quase iguais.
Passo 3: Abra Melhorias e experiência
É ali que aparecem os dados estruturados detectados na página.
Deu certo quando: O tipo de dado estruturado do template aparece válido nas dez páginas.
Erro comum: Marcação válida numa página e ausente na seguinte, porque o campo vinha vazio do registro.
Passo 4: Use Solicitar indexação só para a página corrigida que importa
A ajuda informa que existe um limite diário de solicitações e indica o sitemap para muitas páginas.
Deu certo quando: As solicitações do mês cabem numa lista curta, com motivo para cada uma.
Erro comum: Gastar a cota pedindo indexação do lote inteiro, página por página.
No fim você tem: Dez provas por grupo de que o dado, o canonical e a marcação chegaram ao Google como planejado.
Peça hoje a quem constrói o arquivo do limiar e duas URLs de teste, uma com dado e outra sem. Confira com curl em até uma semana: a primeira precisa trazer canonical autorreferencial e nenhum noindex, a segunda precisa responder 200 com noindex no HTML cru. Se as duas passarem, cobre no comitê seguinte o número de páginas indexáveis da semana.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSEO e GEO para quem decide
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta os conceitos “Noindex”, “Canonical” e “Indexação”, usados em “Escolher quais páginas devem aparecer na busca”.
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “Hidratação”, “Internal linking” e “Schema.org”, usados em “Escolher quais páginas devem aparecer na busca”.
- SEO para lojas: produtos fáceis de encontrarEscolha o que deve aparecer na buscaExaminar conexões de Escolha o que deve aparecer na busca
- SEO e GEO para quem decideA base que permite ao robô ler o seu siteExaminar conexões de A base que permite ao robô ler o seu site
- Search Console para decisãoConfirme que a página está no Google antes de discutir posiçãoExaminar conexões de Confirme que a página está no Google antes de discutir posição
- Frontends com VibecodingPublicar conteúdo encontrável em vários idiomasExaminar conexões de Publicar conteúdo encontrável em vários idiomas
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.