SEO Programático · Capítulo 9 de 21 · 42 min
Medir o template contra as melhores páginas do assunto
A régua da página é a melhor resposta da web sobre o mesmo tema, e não a média interna do próprio site.
Este capítulo faz parte do curso gratuito SEO Programático. Para marcar como concluído e salvar o progresso, abra este capítulo na página do curso.
Um template raso multiplica o mesmo defeito por cinco mil páginas, e a conta chega de uma vez: o acervo inteiro recebe a nota da pior página típica. Você abre vinte páginas do gerador em vinte abas e passa os olhos. Título coerente, mesma estrutura, mesmo tom, nenhuma quebrada, nenhum campo vazio. A impressão é de trabalho bem feito.
Essa inspeção mediu só a consistência do template contra ele mesmo, e um template pode ser perfeitamente consistente e igualmente raso nas vinte páginas. Aqui entram três instrumentos: a proporção de conteúdo exclusivo por página, o teste de fusão e a reescrita que acrescenta dado em vez de texto. O caso de trabalho é o template do Radar de Preço, que ganha série de doze semanas, comparação com a média da UF e com a média nacional, número de postos pesquisados, variação semanal e faixa de preços.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
A régua está escrita, e não é interpretação de mercado. As Quality Rater Guidelines (diretrizes que orientam os avaliadores humanos contratados pelo Google), na versão pública com capa de 11 de setembro de 2025, são referenciadas pelo próprio Google dentro da documentação sobre conteúdo gerado por IA, o que torna a citação defensável.
A seção 4.6.5 descreve abuso de escala como grande volume de conteúdo não original que entrega pouco ou nenhum valor "as compared to other pages on the web on the same topic". Sublinhe a preposição: contra outras páginas da web, sobre o mesmo tópico. A média do seu site não entra na conta. Vinte páginas consistentes entre si e rasas na régua real recebem a mesma nota que uma página rasa sozinha.
A seção 4.6.6 é mais dura e vale citar literalmente: "The Lowest rating applies if all or almost all of the MC on the page (including text, images, audio, videos, etc) is copied, paraphrased, embedded, auto or AI generated, or reposted from other sources with little to no effort, little to no originality, and little to no added value for visitors to the website. Such pages should be rated Lowest, even if the page assigns credit for the content to another source." Duas consequências operacionais derrubam práticas comuns: paráfrase automática conta como cópia, e dar crédito à fonte não salva a página. Isso encerra o padrão de reescrever com IA e citar a fonte como caminho de conformidade.
Antes que isso vire caricatura: as guidelines afirmam que o uso de IA generativa por si só não determina o esforço nem a nota, e que conteúdo de baixo esforço recebe Lowest tenha sido escrito por humano ou por máquina. O eixo é esforço, originalidade e valor agregado, não autoria.
Danny Sullivan, em abril de 2025, disse a mesma coisa em outras palavras: "we don't really care how you're doing this scaled content, whether it's AI, automation, or human beings". Quando alguém traduziu isso como "então IA de boa qualidade está liberada", a resposta dele foi curta: "We didn't say that", segundo o Search Engine Journal.
O guia do Google sobre recursos de IA generativa, publicado em 15/05/2026, fechou a mesma porta para as respostas de IA. Ele chama de conteúdo commodity (o que qualquer um produziria com conhecimento comum, como "7 dicas para comprar o primeiro imóvel") o material que perde espaço nesses recursos, e enquadra variações criadas para manipular respostas de IA na política de conteúdo em escala.
O Google entrega o critério positivo pronto, na definição do que seria uma boa página de afiliado: "Examples of good affiliate pages include offering additional information about price, original product reviews, rigorous testing and ratings, navigation of products or categories, and product comparisons." Leia isso como mapa do que adicionar, e não como assunto de afiliados. Informação adicional sobre preço, comparação e navegação entre categorias são exatamente o que uma página do Radar pode carregar com dado da própria ANP, sem escrever um parágrafo a mais.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Exemplo resolvido, no estado em que o Radar chegou até aqui. A página de gasolina comum em Itu, SP tem: cabeçalho e menu, um parágrafo de abertura explicando o que é preço médio de combustível, o preço da semana, um bloco de perguntas frequentes idêntico em todas as páginas e o rodapé creditando a ANP.
Corra o dedo pelo que dessa lista muda entre Itu e Salto: o nome da cidade e um número. Todo o resto é o mesmo arquivo servido duas vezes. A intuição já diz que está ruim, mas intuição não entra em relatório e não sobrevive a discussão com cliente. O script abaixo transforma isso em proporção medida: ele baixa várias páginas do mesmo template, separa as linhas de texto visível que aparecem em mais de uma página das que aparecem em apenas uma, e conta caracteres.
// medir-densidade.mjs (Node 22+, sem dependência externa)
// uso: node medir-densidade.mjs <url1> <url2> <url3> ...
const urls = process.argv.slice(2);
if (urls.length < 2) {
console.error('Informe pelo menos 2 URLs geradas pelo mesmo template.');
process.exit(1);
}
function linhasVisiveis(html) {
return html
.replace(/<script[\s\S]*?<\/script>/gi, ' ')
.replace(/<style[\s\S]*?<\/style>/gi, ' ')
.replace(/<[^>]+>/g, '\n')
.replace(/ /g, ' ')
.split('\n')
.map((l) => l.replace(/\s+/g, ' ').trim())
.filter((l) => l.length > 2);
}
const paginas = [];
for (const url of urls) {
const resp = await fetch(url, { headers: { 'user-agent': 'auditoria-densidade/1.0' } });
if (!resp.ok) {
console.error(url + ': HTTP ' + resp.status);
continue;
}
paginas.push({ url, linhas: linhasVisiveis(await resp.text()) });
}
// em quantas páginas distintas cada linha aparece
const frequencia = new Map();
for (const p of paginas) {
for (const linha of new Set(p.linhas)) {
frequencia.set(linha, (frequencia.get(linha) ?? 0) + 1);
}
}
for (const p of paginas) {
let repetido = 0;
let exclusivo = 0;
for (const linha of p.linhas) {
if (frequencia.get(linha) === 1) exclusivo += linha.length;
else repetido += linha.length;
}
const total = repetido + exclusivo;
const densidade = total === 0 ? 0 : (exclusivo / total) * 100;
console.log(p.url);
console.log(' exclusivo: ' + exclusivo + ' car. | repetido: ' + repetido + ' car. | densidade: ' + densidade.toFixed(1) + '%');
}ANTES (template com parágrafo genérico + preço da semana)
/combustivel/sp/itu/gasolina-comum
exclusivo: 148 car. | repetido: 1.203 car. | densidade: 11,0%
/combustivel/sp/salto/gasolina-comum
exclusivo: 151 car. | repetido: 1.203 car. | densidade: 11,2%
/combustivel/sp/sorocaba/gasolina-comum
exclusivo: 149 car. | repetido: 1.203 car. | densidade: 11,0%
DEPOIS (série de 12 semanas + comparações + contagem de postos)
/combustivel/sp/itu/gasolina-comum
exclusivo: 1.042 car. | repetido: 968 car. | densidade: 51,8%
/combustivel/sp/salto/gasolina-comum
exclusivo: 1.019 car. | repetido: 968 car. | densidade: 51,3%
/combustivel/sp/sorocaba/gasolina-comum
exclusivo: 1.106 car. | repetido: 968 car. | densidade: 53,3%
Os seus números vão diferir. O que precisa se repetir é o formato:
uma proporção medida por página, registrada antes e depois de mexer
no template, e não uma impressão sobre as vinte abas abertas.Repare no que fez a densidade subir, porque é aqui que quase todo mundo erra a direção. O bloco genérico caiu de 1.203 para 968 caracteres, ou seja, o template ficou menos verboso. Encher a página com parágrafos sobre a importância do combustível no orçamento familiar aumentaria o texto e derrubaria a densidade, porque esse texto é idêntico nas 5.570 páginas e entra inteiro na coluna do repetido.
A distinção que sustenta o módulo
- Adicionar texto é escrever mais palavras sobre o assunto. O resultado é boilerplate novo, replicado em todo o catálogo, e nota pior.
- Adicionar dado é trazer para a página um número que só existe naquela combinação de município e combustível. A série das últimas doze semanas, a diferença para a média da UF e para a média nacional, quantos postos a ANP pesquisou naquela semana, a variação sobre a semana anterior, o mínimo e o máximo praticados.
Cada um desses itens existe na mesma série histórica semanal da ANP que você já ingeriu em [Escolher a fonte pública que sustenta o acervo](#fontes-brasileiras-de-dado) e normalizou em [Definir o registro que fixa o custo do projeto](#modelagem-e-normalizacao). Nenhum deles exige nova fonte, nova licença ou nova redação.
// app/combustivel/[uf]/[municipio]/[produto]/page.tsx  (Next.js 16, App Router)
import { notFound } from 'next/navigation';
import { serieSemanal, mediaUf, mediaNacional } from '@/lib/anp';

type Params = { uf: string; municipio: string; produto: string };

export default async function PaginaCombustivel({ params }: { params: Promise<Params> }) {
  const { uf, municipio, produto } = await params;

  // 12 semanas do MESMO município: a série é o dado que só existe nesta página
  const serie = await serieSemanal({ uf, municipio, produto, semanas: 12 });
  if (serie.length === 0) notFound();

  const atual = serie[serie.length - 1];
  const anterior = serie[serie.length - 2];
  const variacao = anterior
    ? ((atual.precoMedio - anterior.precoMedio) / anterior.precoMedio) * 100
    : null;

  // comparações: a mesma semana, em dois recortes maiores
  const [uf12, br12] = await Promise.all([
    mediaUf({ uf, produto, semana: atual.semana }),
    mediaNacional({ produto, semana: atual.semana }),
  ]);

  const brl = (v: number) => v.toLocaleString('pt-BR', { style: 'currency', currency: 'BRL' });
  const pp = (v: number) => (v >= 0 ? '+' : '') + v.toFixed(2).replace('.', ',') + '%';

  return (
    <article>
      <h1>{produto} em {atual.municipioNome}, {uf.toUpperCase()}</h1>

      {/* dado da semana, com a contagem que dá lastro ao número */}
      <p>
        Preço médio de {brl(atual.precoMedio)} na semana de {atual.semana},
        apurado em {atual.postosPesquisados} postos.
        Faixa praticada: {brl(atual.precoMinimo)} a {brl(atual.precoMaximo)}.
        {variacao !== null && <> Variação sobre a semana anterior: {pp(variacao)}.</>}
      </p>

      {/* comparações: informação que a página do município vizinho não tem */}
      <ul>
        <li>Média de {uf.toUpperCase()}: {brl(uf12)} ({pp(((atual.precoMedio - uf12) / uf12) * 100)} de diferença)</li>
        <li>Média nacional: {brl(br12)} ({pp(((atual.precoMedio - br12) / br12) * 100)} de diferença)</li>
      </ul>

      {/* série histórica: 12 linhas exclusivas desta combinação */}
      <table>
        <caption>Últimas 12 semanas em {atual.municipioNome}</caption>
        <tbody>
          {serie.map((s) => (
            <tr key={s.semana}>
              <th scope='row'>{s.semana}</th>
              <td>{brl(s.precoMedio)}</td>
              <td>{s.postosPesquisados} postos</td>
            </tr>
          ))}
        </tbody>
      </table>

      <p>Fonte: série histórica semanal de preços de combustíveis, ANP.</p>
    </article>
  );
}Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
O teste de fusão é a régua rápida e portátil deste curso, e vale para qualquer projeto programático, não só para o Radar. O enunciado é uma frase: se duas páginas podem ser fundidas sem perda de informação, elas não deveriam existir separadas.
Apliquei no template antigo, e a resposta foi imediata: juntando Itu e Salto numa página só, com duas linhas de tabela, nada se perde. Logo, as duas páginas eram uma tabela de duas linhas espalhada em duas URLs. Aplicando no template reescrito, a fusão passa a custar caro: seriam duas séries de doze semanas, duas contagens de postos e dois conjuntos de comparação convivendo numa página que já não responde bem à pergunta de ninguém. A fusão perde informação, portanto as páginas se justificam.
Repare que a resposta do teste mudou por causa do dado, não por causa da redação. Nenhuma reescrita de parágrafo teria virado esse veredito.
O critério de sucesso do seu gerador muda a partir daqui, e vale dizer com todas as letras. Ele deixa de ser quantas páginas foram publicadas e indexadas e passa a ser qual proporção das páginas publicadas tem dado próprio que não existe em outro lugar. Um gerador com 800 páginas de densidade alta é um acervo. O mesmo gerador com 5.570 páginas de densidade baixa é o mesmo acervo com 4.770 doorways pendurados nele.
Aqui está o coração do curso. A medição interna diz se a página tem dado próprio; ela não diz se a página é boa na régua declarada. Para isso existe só um caminho, que é comparação externa.
Faça:
- Escolha três páginas do seu gerador, em três municípios de porte diferente, sem escolher as melhores.
- Para cada uma, busque a consulta que ela pretende responder e abra as três melhores páginas da web sobre o mesmo assunto, de qualquer domínio, incluindo portal de notícia, comparador e a própria página da ANP.
- Coloque as quatro lado a lado e responda em uma linha, por escrito: o que a sua página entrega que as outras três não entregam?
- Rode o script de densidade nas suas três páginas e registre o número em algum lugar versionado, junto da data.
Critério de aprovação: se você não consegue escrever a linha do terceiro item sem usar a palavra "organizado" ou "reunido", o template ainda não sobreviveu à comparação, e nenhuma otimização de crawl, sitemap ou performance vai resolver isso. O problema está no que a página carrega.
A agência entregou 600 páginas de município com nome da cidade e preço da semana; todo o resto é idêntico. Para "engordar o conteúdo", ela propõe acrescentar 400 palavras sobre formação do preço no rodapé de todas as páginas.
Qual pedido a diretora deve fazer à agência?
O guia abaixo serve a quem aprova o template antes do lançamento ou herdou um catálogo já no ar. Ele destrava uma decisão só: o template segue para produção, volta para reescrita ou reduz o número de páginas publicadas.
Guia de implementação: reprovar o template antes do buscador
Cinco passos, feitos uma vez antes do lançamento e repetidos a cada mudança de template.
Passo 1: Sortear a amostra de páginas
Escolha dez páginas do gerador em municípios de porte diferente, sem escolher as melhores.
Deu certo quando: A lista tem cidades grandes, médias e pequenas, sorteadas e registradas com data.
Erro comum: Montar a amostra só com capitais, onde o dado é farto e a página parece boa.
Passo 2: Medir a densidade de cada página
Rode o script de densidade e registre a proporção de conteúdo exclusivo de cada URL.
Deu certo quando: Existe uma planilha versionada com a densidade por página e a data da medição.
Erro comum: Medir uma vez e nunca repetir depois de mexer no template.
Passo 3: Aplicar o teste de fusão em pares vizinhos
Sobreponha duas páginas de municípios próximos e pergunte o que se perde se virarem uma.
Deu certo quando: Cada par tem uma frase escrita dizendo qual informação só existe em cada lado.
Erro comum: Aceitar "o nome da cidade" como diferença suficiente.
Passo 4: Comparar com as três melhores páginas da web
Para três consultas, abra as três primeiras respostas de qualquer domínio e compare lado a lado.
Deu certo quando: A frase sobre o que a sua página entrega a mais não usa "organizado" nem "reunido".
Erro comum: Comparar só com concorrentes diretos e ignorar portal de notícia e fonte oficial.
Passo 5: Reescrever acrescentando dado, não texto
Traga para o template série histórica, comparações e contagens que já existem na fonte ingerida.
Deu certo quando: A densidade medida sobe e o bloco repetido encolhe na nova medição.
Erro comum: Engordar o rodapé com parágrafo genérico igual em todas as páginas.
No fim você tem: Um template aprovado com densidade medida, pares de fusão justificados por escrito e uma comparação externa datada, prontos para anexar à ata do comitê.
Quem faz, quanto custa, como conferir
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Sortear a amostra | Analista de SEO | 1 hora; sem custo de licença | Lista de dez URLs com porte do município e data |
| Medir a densidade | Desenvolvedor ou analista de SEO | 2 a 3 horas na primeira vez; minutos depois | Planilha com proporção exclusiva por página |
| Teste de fusão | Analista de SEO com o dono do dado | Meio dia | Uma frase por par sobre o que se perderia |
| Comparação externa | CMO ou gerente de conteúdo | Meio dia | Frase escrita e datada para três consultas |
| Reescrita com dado | Desenvolvedor e engenheiro de dados | 3 a 5 dias, conforme a fonte já ingerida | Nova medição com densidade maior que a anterior |
Guia prático: dados estruturados dentro do template. O dado exclusivo de cada página precisa aparecer duas vezes: no texto que o leitor vê e na marcação JSON-LD que buscadores e assistentes de IA leem. Quando a marcação nasce do mesmo registro que alimenta o texto, as duas versões nunca divergem, e o Google pede exatamente isso: dado estruturado alinhado ao conteúdo visível.
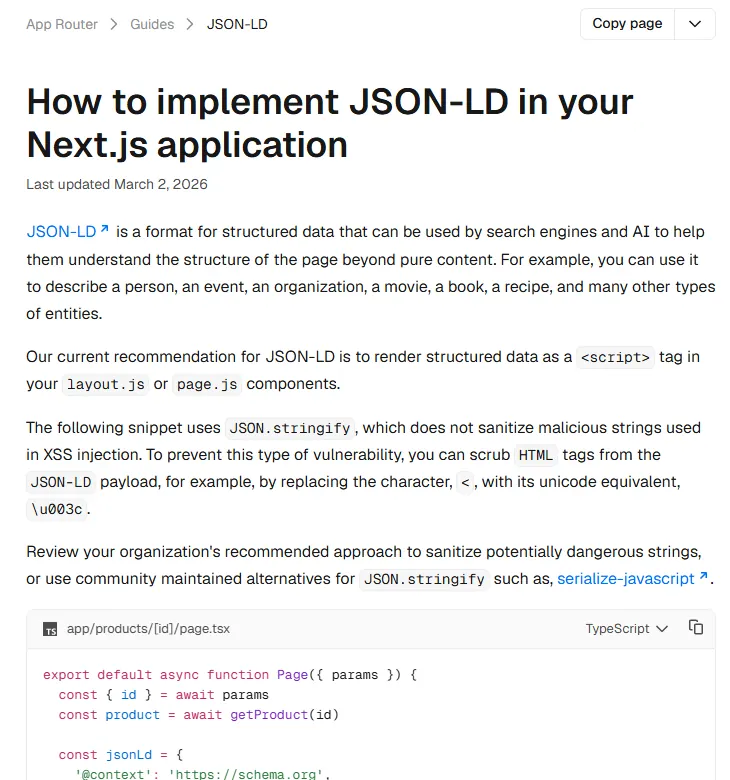
A documentação do Next.js recomenda renderizar o JSON-LD numa tag script comum dentro do page ou do layout, e avisa que JSON.stringify sozinho não protege contra injeção de código. A troca do caractere < pela sequência \u003c resolve o caso mais comum.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Quatro casos de marketing, quatro escolhas de marcação
| Caso | Tipo de schema.org | O que a documentação do Google exige ou veta |
|---|---|---|
| Páginas de cidade de negócio local | LocalBusiness por unidade, com endereço e horário reais | Estrelas de avaliação não aparecem quando a própria empresa controla as avaliações sobre si |
| Integrações e comparativos de SaaS B2B | SoftwareApplication para o produto próprio | Para o resultado avançado: name, offers.price e aggregateRating ou review |
| Catálogo de e-commerce | Product com Offer | category aceita texto ou código; validFrom, validThrough e priceValidUntil marcam a promoção |
| Glossário de infoproduto | DefinedTerm dentro de um DefinedTermSet | Sem resultado avançado próprio no Google; serve para descrever o termo a quem lê a marcação |
Fonte: Google Search Central, guias de snippet de avaliação, app de software e produto (atualizados entre 07/07 e 08/09/2026); schema.org, DefinedTerm.
// src/lib/json-ld.tsx  (Next.js 16, App Router)
// Um componente só para todos os templates do acervo.
export function JsonLd({ dados }: { dados: Record<string, unknown> }) {
  return (
    <script
      type="application/ld+json"
      dangerouslySetInnerHTML={{
        // troca < por \u003c, como pede a documentação do Next.js
        __html: JSON.stringify(dados).replace(/</g, '\\u003c'),
      }}
    />
  );
}

// app/clinica/[cidade]/page.tsx: caso das páginas de cidade
// A marcação sai do MESMO registro que preenche o texto da página.
const unidade = await unidadePorCidade(cidade); // endereço, telefone, horário
if (!unidade) notFound(); // cidade sem unidade real não vira página

<JsonLd
  dados={{
    '@context': 'https://schema.org',
    '@type': 'Dentist',
    name: `Clínica Sorriso Pleno, unidade ${unidade.bairro}`,
    address: {
      '@type': 'PostalAddress',
      streetAddress: unidade.logradouro,
      addressLocality: unidade.cidade,
      addressRegion: unidade.uf,
      postalCode: unidade.cep,
      addressCountry: 'BR',
    },
    telephone: unidade.telefone,
    openingHours: unidade.horarios, // ex.: ['Mo-Fr 08:00-19:00', 'Sa 08:00-12:00']
    // sem aggregateRating: avaliação colhida no próprio site não gera estrelas
  }}
/>
Caso 1: páginas de cidade para um negócio local com várias unidades
Seis passos para uma rede de clínicas, escolas ou oficinas que quer uma página por cidade atendida. A regra que decide tudo: só existe página onde existe unidade, equipe ou atendimento real.
Passo 1: Monte o registro a partir das unidades, não da lista de municípios
Cada linha tem endereço, telefone, horário, serviços oferecidos e um dado local, como o tempo médio de espera.
Deu certo quando: O número de páginas planejadas é igual ao número de unidades, mais as cidades com atendimento comprovado.
Erro comum: Gerar 5.570 páginas, uma por município do IBGE, com o nome da cidade trocado.
Passo 2: Defina o bloco exclusivo de cada página
Equipe da unidade, serviços que só aquela unidade faz, como chegar e perguntas reais do atendimento local.
Deu certo quando: Duas páginas sorteadas têm pelo menos três blocos de conteúdo que não se repetem.
Erro comum: Texto fixo com o nome da cidade em cinco lugares, que a medição de densidade acima reprova.
Passo 3: Gere o JSON-LD com o componente acima
Use o subtipo mais específico de LocalBusiness, como Dentist ou AutoRepair, quando ele existir no schema.org.
Deu certo quando: Endereço e horário da marcação são idênticos aos do texto visível.
Erro comum: Marcar aggregateRating com avaliações colhidas no próprio site, o que a documentação torna inelegível para estrelas.
Passo 4: Teste três páginas no Teste de pesquisa aprimorada
Uma unidade grande, uma pequena e uma com campo opcional vazio.
Deu certo quando: As três aparecem sem erro e com o mesmo tipo detectado.
Erro comum: Testar só a unidade da capital, que tem todos os campos preenchidos.
Passo 5: Confira o Perfil da Empresa de cada unidade
A documentação de recursos de IA do Google pede informações do Perfil da Empresa atualizadas.
Deu certo quando: Nome, endereço e telefone do perfil batem com a página da unidade.
Erro comum: Página nova com telefone diferente do perfil, que confunde o leitor e o buscador.
Passo 6: Publique em lote pequeno e leia o grupo em 30 dias
Use o filtro por sitemap do relatório de indexação, como no capítulo "Gerar tudo e publicar só o que tem dado".
Deu certo quando: O grupo das cidades aparece com a maior parte das páginas indexadas e com cliques em buscas com o nome da cidade.
Erro comum: Publicar as cidades sem unidade no mesmo lote e perder a leitura do que funcionou.
No fim você tem: Uma página por unidade real, com dado local no texto e na marcação, sem página de porta de entrada.
Gerente de marketing de uma rede de clínicas odontológicas com 14 unidades em três estados
Saúde, serviço local
Dor
A agência anterior publicou 600 páginas "dentista em" para cidades sem unidade. Menos de 5% foram indexadas, e o atendimento recebia ligações de cidades que a rede não cobre.
Solução
A equipe apagou as páginas sem unidade, refez 14 páginas com equipe, serviços e horário por unidade, gerou o JSON-LD do mesmo registro e alinhou os 14 perfis da empresa.
Resultado
Em 60 dias, as 14 páginas estavam indexadas e as ligações vindas de busca passaram a chegar das cidades atendidas.
Custo apurado: Uma semana de um analista de SEO e dois dias de desenvolvedor.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Rode hoje o script de densidade em dez páginas sorteadas do seu gerador e registre o número com a data. Confira em até duas semanas: depois da reescrita, a proporção de conteúdo exclusivo precisa subir em todas as dez, e a frase da comparação externa precisa existir por escrito para três consultas.
Perguntas frequentes deste capítulo
Existe um percentual mínimo de densidade que aprova a página?
Se eu citar a fonte oficial e linkar para a ANP, a página fica coberta?
E se eu reescrever o texto de cada página com IA para que fiquem diferentes entre si?
Meu inventário não tem série histórica para todos os municípios. O que faço com as páginas que ficariam rasas?
A comparação externa não é subjetiva demais para virar processo?
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Explore os conceitos e compare abordagens em outros cursos. As conexões indicam assuntos relacionados; a sequência de estudo continua no índice do curso.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Autoridade Temática e SEO de EntidadesO trecho que a IA consegue usar sozinhoExaminar conexões de O trecho que a IA consegue usar sozinho
- MCP com Chrome: Automação com IADescobrir o que a IA não vê na página que você vêExaminar conexões de Descobrir o que a IA não vê na página que você vê
- E-E-A-T e Qualidade de ConteúdoSeparar o que o Google penaliza do que ele ignora em conteúdo de IAExaminar conexões de Separar o que o Google penaliza do que ele ignora em conteúdo de IA
- GEO e Knowledge GraphPor que a máquina cita uma fonte e ignora outraExaminar conexões de Por que a máquina cita uma fonte e ignora outra