Frontends com Vibecoding · Capítulo 16 de 35 · 32 min
Publicar conteúdo encontrável em vários idiomas
Você decide como cada página é montada, preenche metadados e a cápsula de resposta, e tira todo texto do código para um catálogo por idioma.
Este capítulo faz parte do curso gratuito Frontends com Vibecoding.
Para aparecer na busca, uma página precisa ser acessível ao rastreador e oferecer conteúdo que ele consiga processar. O Google pode executar JavaScript antes de indexar; outros buscadores e assistentes têm capacidades diferentes. Entregar o texto principal no HTML inicial reduz a dependência dessa execução.
Quem escolhe a tecnologia decide como cada página será montada, confere os metadados e testa o conteúdo que o rastreador recebe. Nenhuma dessas medidas garante indexação ou citação por um assistente de IA.
Você termina sabendo conferir se uma página do site entrega título, descrição e dados estruturados que buscadores e assistentes de IA conseguem ler, e o que pedir quando faltar. Tempo de leitura: cerca de 32 minutos, e o teste gratuito do Google numa página sua, mais dez.
A geração estática prepara o HTML antes da visita e costuma servir bem a conteúdo que muda pouco. A renderização no servidor monta o HTML ao receber o pedido e pode atender páginas com dados atualizados, conforme a política de cache do projeto.
Na renderização no cliente, o navegador executa JavaScript para completar a tela. O Google faz isso em uma etapa própria de renderização, que pode ocorrer depois do rastreamento inicial e encontrar erros ou recursos bloqueados. Uma SPA não fica automaticamente fora da busca.
Astro e Next.js oferecem caminhos para entregar conteúdo pronto; a escolha depende das rotas, dos dados e da equipe. Desligar JavaScript mostra quanto a página depende dele, mas não prova o que foi indexado. Para uma URL pública, confira o HTML renderizado e os recursos carregados na ferramenta de inspeção de URL do Google Search Console.
Ver como texto
O robo diante da SPA e do HTML pronto
Sequencia em dois tempos. Primeiro, o robo de busca ou de IA pede a pagina ao servidor de uma SPA e recebe uma casca vazia mais o JavaScript que a preencheria; como a maioria dos robos nao roda esse JavaScript, nao sobra nada para indexar. Depois, o mesmo robo pede a pagina a um servidor que monta o HTML pronto, recebe o texto ja no HTML, indexa e pode citar. E a mesma diferenca que o teste de desligar o JavaScript revela em dez segundos.
Buscador e assistente só conseguem citar um endereço. Aba, filtro e página de resultado que vivem só na memória do navegador não têm endereço, e o link copiado volta para a tela inicial. Guarde esse estado na URL, com o nuqs em React, para que a combinação possa ser compartilhada. Indexação e citação ainda dependem de acesso, conteúdo e configuração da página.
Preparar a página para ser encontrada, o que se chama SEO técnico, esbarra na rolagem infinita. O rastreador não rola, o leitor de tela não alcança o rodapé e a pessoa não consegue voltar ao item 40. Links de paginação com endereço próprio tornam os resultados alcançáveis sem depender de rolar a tela. Teste também o foco, o retorno ao item e o acesso ao rodapé com teclado e leitor de tela.
A Speculation Rules API, a lista, no HTML, dos endereços que o navegador busca antes do clique, pré-carrega a ficha do produto enquanto a pessoa lê a lista. O manual a recomenda para menus e paginação. Cada endereço listado gasta dado do celular de quem talvez nunca clique, por isso liste só o destino mais provável.
Ver como texto
Dois caminhos. À esquerda, aba, filtro e rolagem infinita presos na memória do navegador: o link copiado volta à tela inicial e não sobra nada para citar. À direita, o mesmo filtro guardado no endereço, com piscina igual a sim e página 2: o rastreador lê o HTML e guarda no índice, e dali saem a resposta do buscador e o assistente de IA que cita o link. No rodapé, a paginação numerada dá endereço a cada página.
<!-- no head da página de lista: pré-carrega a ficha mais provável -->
<script type="speculationrules">
{
  "prerender": [{
    "where": { "href_matches": "/quartos/*" },
    "eagerness": "moderate"
  }]
}
</script>
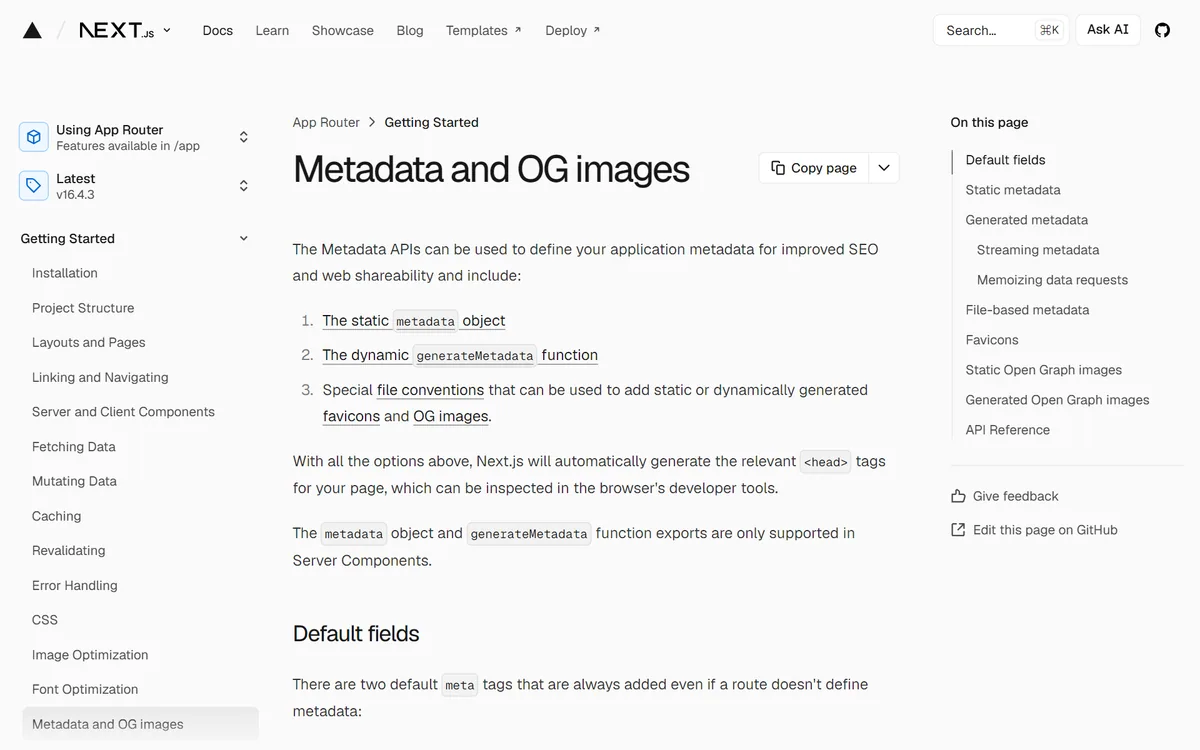
No arquivo da rota fica a função generateMetadata, o código que preenche título, descrição e endereço oficial da página. Ela devolve um objeto que o Next.js transforma nas linhas do cabeçalho, e a descrição resume o conteúdo. O Google pode gerar outro trecho para a busca; uma contagem fixa de caracteres não garante sua exibição integral.
Escolha uma URL preferida e mantenha coerentes os links internos, os redirecionamentos e o rel=canonical. Uma diferença de barra final pode produzir endereços distintos, mas não comprova exclusão automática do índice. Confira na inspeção de URL qual endereço o Google selecionou como canônico.
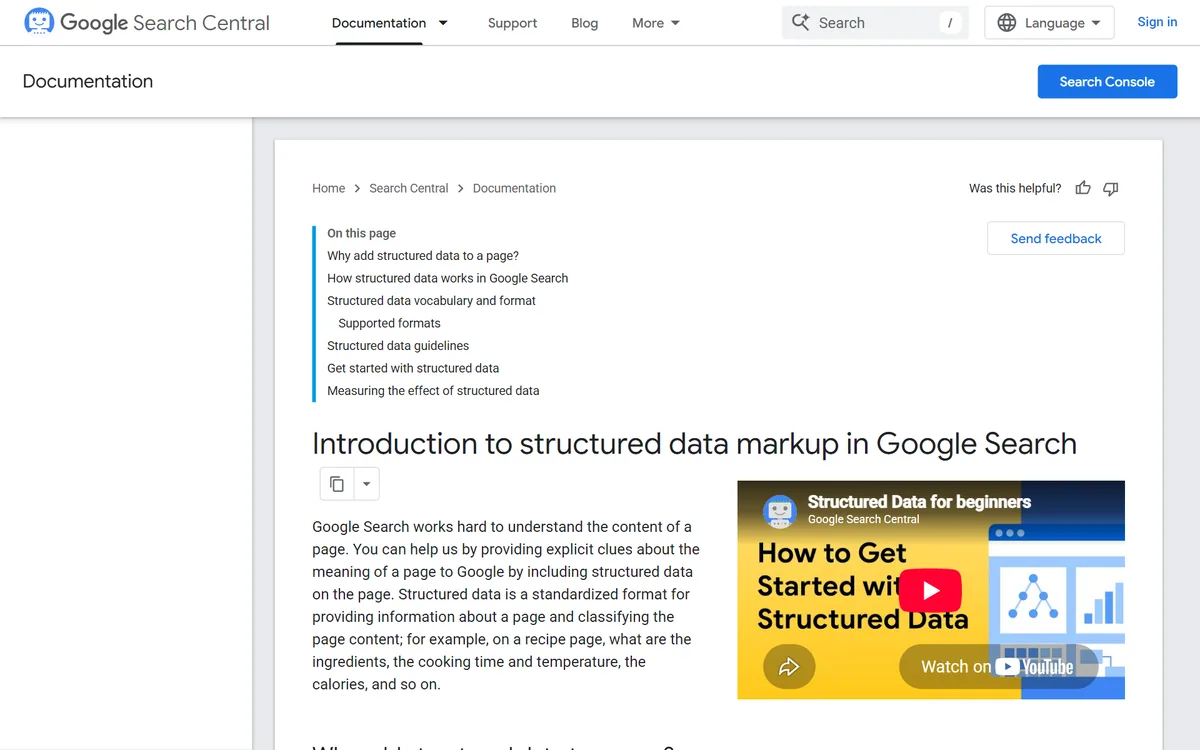
O JSON-LD, um bloco de texto dentro da página, no vocabulário schema.org, dizendo o que ela é, descreve autor, data e organização. Preencha só o que a página mostra de verdade: marcar algo que não aparece no texto visível é motivo declarado de penalidade nas diretrizes do Google.
Para facilitar a leitura, use uma cápsula de resposta: uma frase curta que responde direto à pergunta do título, logo no início da seção. Abra cada seção com a pergunta real como título e responda na primeira frase, em texto que se sustente sozinho fora da página.
Ver como texto
Esquema anatômico do HTML de uma página de artigo bem montada, com chamadas apontando cada parte. No cabeçalho do documento ficam quatro linhas: a tag title com o assunto da página, a meta description com cento e cinquenta a cento e sessenta caracteres, a link rel canonical apontando para o próprio endereço final, e a tag script de tipo application ld+json com os dados estruturados. No corpo do documento ficam três partes: um único h1 com o título visível, a cápsula de resposta logo abaixo dele respondendo a pergunta em uma frase, e os subtítulos h2 em ordem, cada um também abrindo com a resposta curta. A chamada lateral lembra que a cápsula de resposta é o trecho que o assistente extrai quase sem alteração.
Antes de publicar uma página nova, desligue o JavaScript do navegador e recarregue. Se o texto sumir da tela, ele some do índice e da resposta do assistente; troque a montagem antes de seguir adiante.
Depois escreva o título como a pergunta que a pessoa faz e responda na primeira linha, com número e condição: R$ 420 o casal, com café da manhã. É essa frase que o assistente copia, e é por ela que a pousada aparece na resposta em vez do concorrente.
Deu certo quando o texto continua na tela com o JavaScript desligado e a primeira linha de cada seção responde sozinha, fora da página.
Publicar o mesmo site em vários idiomas sem duplicar o código
A página já é encontrável e citável em um idioma, e o texto preso no código impede que ela exista nos outros sem reescrita.
Levar o produto para outro idioma é dois trabalhos: o de engenharia, feito uma vez, e o de conteúdo, repetido a cada mercado. O custo do segundo quase iguala o do primeiro, porque cada tela precisa ser reaberta à mão.
Preparar o site para receber outros idiomas tem nome, internacionalização, e é o trabalho de engenharia. Quem decide expandir estima o prazo pelo catálogo de chaves, pela formatação entregue ao navegador e pelo critério entre quatro bibliotecas.
Ver como texto
À esquerda, o bloco de engenharia, feito uma vez: catálogo de chaves, formatação pelo Intl do navegador e biblioteca escolhida. Setas levam a três blocos de conteúdo, pt-BR, en-US e o próximo mercado, cada um com as telas reabertas à mão. Embaixo, duas barras sem escala mostram que o custo do conteúdo quase iguala o da engenharia.
Quem mistura os dois trabalhos cola lógica de tradução dentro do componente, a peça de tela que se repete, e a conta aparece no segundo idioma. A saída é uma indireção simples: cada texto recebe um identificador, a chave, e o produto pede o texto por essa chave.
A tradução vive num catálogo por idioma, um pt-BR.json e um en-US.json com as mesmas chaves preenchidas, e acrescentar um idioma vira entregar mais um arquivo.
Vale uma regra barata: nunca monte frase traduzida juntando pedaços. A ordem das palavras muda de idioma para idioma. Em alemão o verbo vai para o fim, em japonês o objeto vem antes do verbo, em árabe a frase corre ao contrário. O operador de soma congela a ordem do português dentro do código, onde nenhuma tradução consegue consertá-la.
Cada chave leva a frase inteira com marcador de variável, como t("inbox", { total }), e o catálogo guarda "Você tem {total} mensagens". Quando a frase varia por quantidade, a variação entra nela mesma, no formato ICU: "{total, plural, one {# mensagem} other {# mensagens}}". O tradutor passa a controlar a frase toda, incluindo a posição da variável.
Ver como texto
Por que concatenar strings traduzidas quebra e a chave única com placeholder resolve. No caminho da concatenação, o código monta a frase com o operador de soma e congela a ordem das palavras do português dentro do próprio código, onde nenhuma tradução consegue consertá-la, produzindo texto sem sentido nos idiomas em que a ordem muda, como o alemão, o japonês e o árabe. No caminho da chave única, o código pede a frase inteira por um identificador com placeholder, e cada catálogo guarda a frase completa no próprio idioma, com o tradutor controlando a ordem e a posição da variável.
Data, número, moeda e plural têm formatação nativa em todos os navegadores relevantes, pela API Intl, a interface que o navegador expõe para formatar valores por idioma. Monte o preço à mão e você erra separador, posição do símbolo e casa decimal. O real sai R$ 1.234,56, o dólar inverte ponto e vírgula, e o iene não tem casa decimal.
O Intl.PluralRules resolve o plural: o árabe tem seis categorias, o russo quatro, o polonês três, e o navegador informa qual categoria uma quantidade ativa. A direção de leitura também sai de graça, pelo CSS. Margem e alinhamento escritos em início e fim da linha, como margin-inline-start e text-align: start, espelham o layout sozinhos em árabe e hebraico.
A biblioteca junta catálogo, roteamento por idioma e formatação, e o critério de escolha é onde a mensagem é resolvida. O Paraglide JS e o Lingui resolvem no build, a etapa que gera os arquivos do site antes de publicar. Cada chave vira uma função, o navegador recebe só o idioma pedido e nada sobra para carregar.
O next-intl segue como padrão para o Next.js, porque integra com o endereço por prefixo de idioma e funciona no servidor. O react-i18next fica para a base antiga que já o usa, porque migrar catálogo que funciona sai mais caro que o ganho.
Escreva o nome escolhido dentro do pedido ao agente, porque pedido sem nome de biblioteca volta com uma opção que ninguém no time conhece. Para o next-intl, instale, crie os arquivos de mensagem de cada idioma com as mesmas chaves, e crie o arquivo que devolve as mensagens do idioma ativo.
Mova as páginas para a pasta do idioma e acrescente o redirecionamento da raiz para o idioma padrão, para que quem chega sem escolher caia no português.
| Biblioteca | Quando a mensagem é resolvida | Para qual stack | Escolha quando |
|---|---|---|---|
| next-intl | em tempo de execução, no servidor ou no navegador | Next.js com App Router | o projeto é Next.js e usa componente de servidor |
| Paraglide JS | no build, cada chave vira uma função | TanStack Start, SvelteKit e Astro, com suporte oficial desde janeiro de 2026 | o site roda na borda de rede e cada kB conta |
| Lingui | no build, catálogo compilado | React e JavaScript puro, com formato ICU | a equipe já escreve mensagens em ICU e quer o ganho de build fora do Paraglide |
| react-i18next | em tempo de execução, no navegador | base React legada que já o usa | migrar o catálogo que funciona sai mais caro que o ganho |
Critério da edição de setembro de 2026 do manual: Paraglide e Lingui compilam no build, com overhead zero em borda de rede; react-i18next segue para bases legadas.
Antes de publicar a segunda versão, abra a mesma tela nos dois endereços de idioma e confira se preço, data e plural mudam de formato sozinhos. Se não mudarem, a chamada ainda está escrita à mão, e o texto solto precisa virar chave.
O sinal mais barato de que falta chave é o preço. Formatado à mão, um aluguel de R$ 2.500,00 sai igual em espanhol, e a frase montada por soma erra o plural.
Deu certo quando você troca o idioma no endereço e a mesma tela mostra moeda, data e plural no formato do país, sem ninguém tocar no código.
Guia prático: o template de página única chega sem metadados, e o vídeo pode virar texto encontrável
Todos os 51 templates de site medidos em 07/10/2026 são feitos com Vite, e quase todos montam a página no navegador. O que eles trazem no cabeçalho mostra o trabalho que sobra para quem publica:
| Item | Templates |
|---|---|
| Marcados como inglês (lang="en") | 35 de 51 |
| Sem meta description | 33 de 51 |
| Sem Open Graph, a capa do link compartilhado | 42 de 51 |
| Sem canonical e sem JSON-LD | 51 de 51 |
Há ainda o endereço que quebra. Trinta templates usam BrowserRouter, o roteador que cria endereços limpos como /cardapio. Num host estático sem regra de reescrita, quem abre esse link direto ou recarrega a página recebe erro 404, e o arquivo de instruções do template promete que o site sobe "sem configuração extra". No Netlify, a regra é uma linha no arquivo _redirects que entrega o index.html com status 200; no Vercel, uma reescrita no vercel.json.
O vídeo é a outra metade. A transcrição com tempo por palavra, que a edição já produz, vira três ativos encontráveis: os capítulos na descrição do YouTube, com o primeiro em 00:00, pelo menos três capítulos e cada um com 10 segundos ou mais; a transcrição publicada na página do vídeo, em HTML; e os títulos dos capítulos como subtítulos dessa página. O que estava só na fala passa a ser texto que buscador e assistente leem.
Prepare este site de página única para ser encontrado. Não mude o visual.

1. index.html: lang="pt-BR", title de até 60 caracteres, meta description
   de até 155, Open Graph com imagem de 1200x630, canonical e JSON-LD do
   tipo [LocalBusiness | ProfessionalService | Restaurant] com os dados de
   [arquivo de configuração].
2. Cada rota do roteador ganha título e descrição próprios.
3. Crie a regra de reescrita do host [Netlify | Vercel] para que abrir
   [/rota-interna] direto e recarregar não deem 404. Teste as duas coisas.
4. Página do vídeo [nome]: a partir da transcrição com tempo por palavra,
   gere os capítulos para a descrição (primeiro em 00:00, pelo menos três,
   cada um com 10 s ou mais) e publique a transcrição em HTML, com os
   títulos dos capítulos como h2.
Do template mudo à página que buscador e assistente leem
Cinco passos para o dia em que você publica um template ou um vídeo novo.
Passo 1: Leia o cabeçalho que veio no template
Abra o index.html e confira idioma, título, descrição, Open Graph, canonical e JSON-LD. Templates trazem título de outro tema e idioma errado com frequência.
Deu certo quando: Você tem a lista do que falta, item por item.
Erro comum: Confiar no título que aparece na aba sem ler o que o compartilhamento mostra.
Passo 2: Preencha os metadados com dados reais
Use o pedido do bloco de código. O JSON-LD leva nome, endereço, telefone e horário do negócio, os mesmos que estão na página e no perfil de empresa no Google.
Deu certo quando: O link colado no WhatsApp mostra título, descrição e imagem certos.
Erro comum: Deixar a imagem de compartilhamento padrão do template, com o nome de outra empresa.
Passo 3: Teste o link profundo e a recarga
Abra uma rota interna direto numa aba anônima e recarregue a página nela. Se der 404, falta a regra de reescrita do host.
Deu certo quando: Toda rota abre direto e sobrevive à recarga.
Erro comum: Testar só navegando a partir da página inicial, onde o roteador esconde o problema.
Passo 4: Transforme a transcrição em capítulos
A partir da transcrição com tempo, peça os capítulos no formato da descrição do YouTube. Confira as três regras: primeiro em 00:00, pelo menos três, cada um com 10 segundos ou mais.
Deu certo quando: Os capítulos aparecem na barra do vídeo depois de salvar a descrição.
Erro comum: Começar o primeiro capítulo em 00:05 e o YouTube ignorar todos.
Passo 5: Publique a transcrição como texto da página
Na página do vídeo, a transcrição revisada entra em HTML, com os capítulos como subtítulos. Desligue o JavaScript e recarregue para conferir que o texto continua lá.
Deu certo quando: A transcrição aparece com o JavaScript desligado.
Erro comum: Publicar a transcrição só dentro do player ou como arquivo para baixar.
No fim você tem: Um site de página única com idioma, metadados e rotas que funcionam direto, e vídeos cujo conteúdo falado virou capítulo e texto encontrável.
Guia prático: dizer a cada robô o que ele pode ler e quando a página mudou
A aula ensinou a entregar o texto pronto e a descrever a página. Falta a conversa com quem rastreia: cada empresa de IA manda robôs diferentes para buscar, para atender um pedido no chat e para treinar modelo, e cada um obedece a uma linha própria do robots.txt (o arquivo na raiz que diz o que cada robô pode ler). Você sai deste guia separando busca de treino, com data verdadeira no sitemap e um llms.txt gerado do mesmo catálogo.
Funções, casos de uso e aplicações
Funções
| Função ou recurso | O que faz | Quando usar | Referência |
|---|---|---|---|
| Regra por robô no robots.txt | Dá uma regra a cada robô pelo nome: OAI-SearchBot e Claude-SearchBot buscam, GPTBot e ClaudeBot coletam para treino | Quando a página deve aparecer na resposta do assistente sem alimentar treino de modelo | Páginas de robôs da OpenAI e da Anthropic (esta de 07/04/2026) |
| Visita pedida no chat (ChatGPT-User, Claude-User) | Abre a página quando uma pessoa pede ao assistente; não decide entrada na busca | Liberar nas páginas públicas; a OpenAI avisa que o robots.txt pode não valer para essa visita | Página de robôs da OpenAI |
| Google-Extended | Marca do robots.txt que decide se o conteúdo rastreado pelo Google treina e alimenta o Gemini; não é um robô à parte | Quando quer ficar na busca do Google e sair do treino; não muda posição na busca | Google, página atualizada em 14/07/2026 |
| lastmod no sitemap | Informa a data da última mudança relevante de cada endereço | Sempre, com a data real do conteúdo; ano novo no rodapé não conta como mudança | Google, página atualizada em 08/07/2026 |
| priority e changefreq | Campos antigos do sitemap | Pode omitir: o Google ignora os dois | Google, página atualizada em 08/07/2026 |
| llms.txt | Arquivo em Markdown na raiz: título, resumo em citação e listas de links que o assistente lê primeiro | Site com muito conteúdo; a seção Optional guarda o que pode ser pulado | llmstxt.org, versão 2 de 10/08/2026 |
| Página em .md | O mesmo conteúdo em Markdown limpo, anunciado por link rel="alternate" type="text/markdown" | Preço, dúvidas frequentes e documentação que agentes consultam muito | llmstxt.org |
Robô de busca e robô de treino têm nomes diferentes de propósito: bloquear um não bloqueia o outro.
Casos de uso
Coordenadora de marketing de uma escola de cursos livres online em Curitiba
Educação
Dor
Quer que as páginas de curso apareçam quando alguém pergunta ao ChatGPT ou ao Claude por um curso de Excel, mas não quer o conteúdo das aulas pagas usado em treino de modelo.
Solução
Pediu ao agente um robots.ts com três grupos: robôs de busca liberados nas páginas públicas, robôs de treino fora do site inteiro e a área do aluno fechada para todos. Conferiu o arquivo servido em /robots.txt antes de publicar.
Resultado do exemplo
O que observar: nos registros de acesso do servidor, depois de cerca de 24 horas, visitas do OAI-SearchBot às páginas de curso e nenhuma do GPTBot. Releia em duas semanas.
Custo estimado no exemplo: Sem custo de ferramenta; meia hora de revisão.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Sócio de uma agência de marketing digital em Recife com blog de 300 artigos
Marketing digital
Dor
O sitemap carimbava em todos os endereços a hora do último deploy, e artigos revisados não eram relidos pelo buscador antes dos intocados.
Solução
Trocou a data do sitemap pela data de revisão gravada em cada artigo, omitiu priority e changefreq e passou a gerar o llms.txt a partir da mesma lista do sitemap.
Resultado do exemplo
O que observar: no Search Console, relatório de Sitemaps e inspeção de URL, se os artigos revisados são rastreados antes dos antigos nas quatro semanas seguintes.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Na prática
Neste portal, o robots.txt sai de uma rota de servidor em src/app/robots.txt/route.ts, no lugar do objeto tipado do Next.js, porque precisa servir uma linha de preferência de uso de IA que o tipo não aceita. A lista de robôs separa busca, visita pedida e treino pelo nome. O sitemap em src/app/sitemap.ts lê a data de cada rota de src/generated/route-lastmod.json, um manifesto com a data do último commit da página; rota sem data sai sem lastmod, em vez de levar a hora do build. Na esteira, o passo "llms.txt em paridade com o sitemap" regenera o llms.txt a partir dos mesmos buckets e reprova endereço inexistente ou redirecionado.
// Crawlers IA (LLM training + realtime assistants)
const AI_BOTS = [
  "GPTBot",
  "ChatGPT-User",
  "OAI-SearchBot",
  "Googlebot",
  "Google-Extended",
  // ...
  "ClaudeBot",
  "Claude-User",
  "Claude-SearchBot",
  "PerplexityBot",
  // ...
];

// Regra Allow mais específica (mais longa) vence o Disallow
// genérico (RFC 9309).
const API_ALLOW_EXCEPTIONS = [
  "/api/mcp",
  "/api/mcp/",
  "/api/oauth/register",
  "/api/oauth/token",
];// app/robots.ts — projeto de campanha em Next.js (exemplo)
import type { MetadataRoute } from "next";
const SITE = "https://campanha.exemplo.com.br";
const FECHADO = ["/obrigado", "/api/", "/area-do-aluno/"];
export default function robots(): MetadataRoute.Robots {
return {
rules: [
// Busca dos assistentes: lê as páginas públicas
{ userAgent: ["OAI-SearchBot", "Claude-SearchBot", "PerplexityBot"], allow: "/", disallow: FECHADO },
// Visita pedida por uma pessoa no chat
{ userAgent: ["ChatGPT-User", "Claude-User"], allow: "/", disallow: FECHADO },
// Treino de modelo: fora do site inteiro
{ userAgent: ["GPTBot", "ClaudeBot", "Google-Extended"], disallow: "/" },
// Demais robôs, inclusive o Googlebot da busca
{ userAgent: "*", allow: "/", disallow: FECHADO },
],
sitemap: SITE + "/sitemap.xml",
};
}Do robots.txt genérico à conversa com cada robô
Passo 1: A finalidade de cada robô decide a regra
Escreva três linhas: quem pode buscar, quem pode abrir a pedido de uma pessoa e quem pode treinar. A mesma empresa aparece nas três com nomes diferentes.
Deu certo quando: Cada robô da lista tem uma decisão e um motivo.
Passo 2: Gere o robots.txt pelo código e leia o servido
Abra /robots.txt no navegador depois do build. Vale o arquivo servido, que pode diferir do que está no editor.
Erro comum: Bloquear /api/ inteiro e esquecer o endpoint público que o llms.txt anuncia.
Passo 3: Troque a data do sitemap pela data do conteúdo
Use a data de revisão gravada na página ou a do último commit do arquivo dela. Sem data conhecida, deixe o campo de fora.
Deu certo quando: Duas páginas que não mudaram mantêm a mesma data depois de um deploy novo.
Passo 4: Gere o llms.txt do mesmo catálogo
Uma fonte só para sitemap e llms.txt evita link morto no arquivo que o assistente lê primeiro. Ponha a conferência na esteira.
Passo 5: Depois de 24 horas, leia os registros de acesso
Filtre o log por nome de robô. A OpenAI informa que mudanças para o robô de busca levam cerca de um dia para valer.
Deu certo quando: Robô de busca presente nas páginas liberadas e ausente nas fechadas.
No fim você tem: Buscadores e assistentes leem o que você quer mostrar, e a data no sitemap passa a indicar mudança real de conteúdo.
Armadilhas
Robots, sitemap e llms.txt: o que evitar e o que pedir
Evitar
Coluna a evitar
- Bloquear GPTBot achando que sai da busca do ChatGPT: quem busca é o OAI-SearchBot
- Bloquear o robô por endereço IP, que pode impedir a leitura do próprio robots.txt
- lastmod com a hora do build em todos os endereços
- priority 1.0 em tudo, campo que o Google ignora
- llms.txt escrito à mão que envelhece com links mortos
Recomendado
Coluna recomendada
- Uma regra por finalidade: busca, visita pedida e treino
- Bloqueio pelo robots.txt, repetido em cada subdomínio
- lastmod com a data da última mudança relevante, ou nenhum
- Sitemap só com endereço e data
- llms.txt gerado da mesma lista do sitemap e conferido na esteira
Metadado é a etiqueta que o robô lê antes do texto
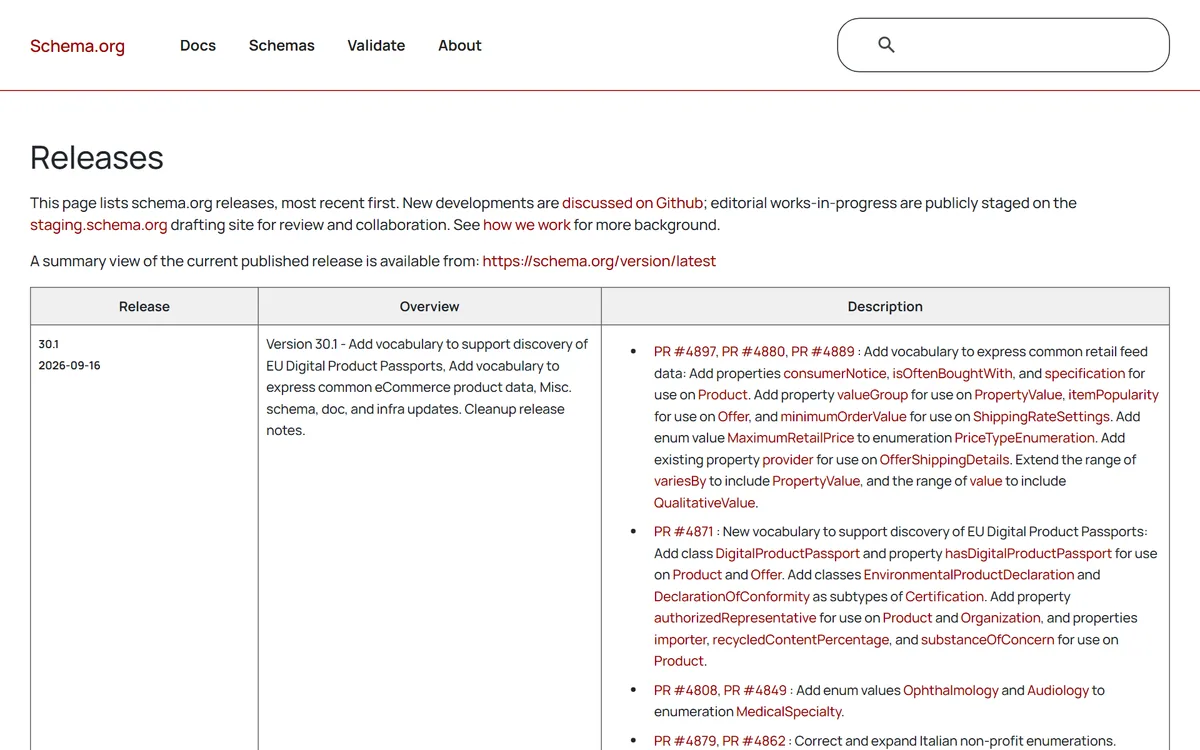
Título, descrição e imagem de compartilhamento são metadados; dados estruturados dizem, num vocabulário comum, que a página é um produto, um artigo ou uma empresa. O vocabulário mais usado é o do schema.org, que publicou a versão 30.1 em 16/09/2026 com campos novos para dados de produto de comércio eletrônico.
Ver como texto
Página Releases do schema.org com a tabela de versões. A primeira linha é a versão 30.1, de 16/09/2026, descrita como vocabulário para o Passaporte Digital de Produto da União Europeia e para dados comuns de produto de comércio eletrônico; a coluna de descrição lista propriedades novas para Product, Offer e ShippingRateSettings e a classe DigitalProductPassport.
Ver como texto
Página Metadata and OG images da documentação do Next.js, versão 16.4.3, que explica as formas de definir metadados para SEO e compartilhamento: o objeto metadata estático, a função generateMetadata e convenções de arquivo para favicons e imagens de compartilhamento, com a nota de que o Next.js gera as tags do head automaticamente.
Ver como texto
Página Introduction to structured data markup in Google Search, da documentação do Google Search Central, com o sumário (por que adicionar dados estruturados, como funcionam, vocabulário e formato, diretrizes e como medir o efeito), o texto que define dados estruturados como formato padronizado para descrever a página e um vídeo Structured Data for beginners.
Faça agora: teste os dados estruturados de uma página
Passo 1: Abra search.google.com/test/rich-results e cole o endereço de uma página de produto ou de artigo do site.
Deu certo quando: O teste roda e mostra os itens detectados.
Passo 2: Veja se aparecem itens válidos, como Produto ou Artigo.
Deu certo quando: Pelo menos um item válido, sem erro.
Erro comum: Página sem nenhum item detectado, o que significa que não há dados estruturados.
Passo 3: Abra a mesma página e confira o título na aba do navegador.
Deu certo quando: O título descreve a página, e não só o nome da empresa.
Passo 4: Compartilhe o link com você mesmo num aplicativo de mensagem.
Deu certo quando: Aparecem imagem, título e descrição corretos.
No fim você tem: Um diagnóstico de uma página: dados estruturados, título e prévia de compartilhamento, com o que pedir em cada um.
Aplicar os recursos ao projeto
Ver como texto
Do conteúdo ao resultado da busca
Um documento tem título, seções e links. Seu texto alimenta um índice que devolve trechos identificáveis; a estrutura do documento permanece disponível.
Ver como texto
Duas buscas locais. Em cima, o Fuse.js recebe o termo digitado com erro, contarto, compara com cada item da lista e dá uma nota de parecença: Contrato de aluguel fica alto, Contato comercial também, Relatório anual quase zero. A busca aproximada perdoa o erro e às vezes traz item sem relação. Embaixo, o MiniSearch consulta um índice pronto: contrato leva aos documentos 2 e 5, contratar ao 5, prazo ao 1 e ao 3. A busca por prefixo contrat acha contrato e contratar, documentos 2 e 5. Cenário ilustrativo.
| Conteúdo | Preparar | Conferir |
|---|---|---|
| Expressão matemática | HTML, CSS e fontes | Leitura e significado |
| Mensagem traduzida | Chaves e dicionários | Plural e contexto |
| Valor formatado | Idioma e unidade | Sentido no público alvo |
KaTeX e i18next tratam da apresentação e interpretação do conteúdo; busca e indexação resolvem outra etapa da consulta.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code: do zero à prática
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “Answer capsule”, “GPTBot” e “OAI-SearchBot”, usados em “Publicar conteúdo encontrável em vários idiomas”.
- Next.js: organizar as páginas de um sitesugerido pelo grafoApresenta o conceito “Next.js”, usado em “Publicar conteúdo encontrável em vários idiomas”.
- O que aparece no HTML e o que surge depoissugerido pelo grafoApresenta o conceito “HTML”, usado em “Publicar conteúdo encontrável em vários idiomas”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- SEO programáticoEscolher quais páginas devem aparecer na buscaExaminar conexões de Escolher quais páginas devem aparecer na busca
- SEO e GEO para quem decideEtapa 3: escrever o trecho que se sustenta sozinhoExaminar conexões de Etapa 3: escrever o trecho que se sustenta sozinho
- SEO e GEO para PodcastsA página do episódio que Google e IA conseguem lerExaminar conexões de A página do episódio que Google e IA conseguem ler
- MCP e Chrome: agentes de IA no navegadorO que aparece no HTML e o que surge depoisExaminar conexões de O que aparece no HTML e o que surge depois
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
Base UI
Prenda o foco num diálogo sem escrever o comportamento
Abra a janela Agendar visita, percorra os campos com Tab, feche com Esc e acompanhe no painel onde o foco está e para onde ele volta.
Pacote
Abrir no capítuloConstruir componentes, usar o registro e publicar o catálogo@base-ui/reactLucide e Iconify
Mantenha uma família de ícones coerente e nomeie cada botão
Mude tamanho, traço e cor da barra, veja o símbolo do Iconify acompanhar o Lucide e rode a auditoria de nomes acessíveis.
Pacote
Abrir no capítuloProjetar uma linguagem de ícones e ilustraçãolucide-react, @iconify/reactMotion
Testar os três sinais que autorizam o terceiro degrau
Reproduza a entrada em sequência, aperte o botão com mola e arraste o cartão; ajuste rigidez e amortecimento e veja o que muda.
Pacote
Abrir no capítuloProjetar movimento, assinatura e narrativas por rolagemmotionVidstack
Ver o que separa um player de um vídeo cru
Dê o play, troque a velocidade e ligue a legenda; o painel ao lado mostra o estado que o player publica e que a etiqueta crua esconde.
Pacote
Abrir no capítuloProjetar movimento, assinatura e narrativas por rolagem@vidstack/reactcmdk
Achar um destino entre quarenta digitando três letras
Abra a paleta, digite fat e escolha um item só pelo teclado; o painel embaixo conta o que o filtro deixou passar e quanto tempo levou.
Pacote
Abrir no capítuloConstruir formulários e estados de interaçãocmdknumber-flow
Animar indicadores que mudam ao vivo com formato pt-BR
Veja três indicadores fictícios rolarem a cada troca e compare com o número em texto puro. Pause, reinicie e observe o separador de milhar.
Pacote
Abrir no capítuloProjetar gráficos e painéis pela decisão@number-flow/reactApache ECharts
Medir o custo de desenhar 200 mil pontos com o ECharts
Troque o tipo de gráfico e o volume de pontos, leia o tempo de desenho e alterne o eixo em zero. Mude o tema do site e veja as cores refazerem.
Pacote
Abrir no capítuloProjetar gráficos e painéis pela decisãoechartsApache ECharts
Painel grande com visões coordenadas
Clique num canal para filtrar todas as visões, troque a densidade entre 6, 9 e 12 visões, alterne tema e movimento e abra a tela cheia.
Pacote
Abrir no capítuloProjetar gráficos e painéis pela decisãoechartssharp e svgo
Escolher a variante certa da imagem e conferir o teto de 150 KB
Arraste a largura da tela simulada, troque a densidade entre 1x e 2x e veja qual arquivo o navegador escolhe, quanto ele pesa e se cabe no orçamento.
Pacote
Abrir no capítuloValidar desempenho, autenticação e segurançasharp, svgoReact Flow (xyflow)
Disparar um pedido e ver o orquestrador distribuir, conferir e responder
Alterne paralelo e sequencial, ligue e desligue a verificação e use a medição real; observe o tempo de parede em cada combinação.
Pacote
Abrir no capítuloConstruir as cenas do orquestrador, do paralelismo e do robô@xyflow/reactGSAP, Web Workers e number-flow
Dividir mil tarefas entre trabalhadores reais e correr três ritmos de geração
Execute com um trabalhador, depois com quatro e oito, e compare o tempo; em seguida percorra a corrida e separe a espera inicial do ritmo.
Pacote
Abrir no capítuloConstruir as cenas do orquestrador, do paralelismo e do robôgsap, @number-flow/reactThree.js com React Three Fiber, drei, Rapier e XR
Carregar o braço robótico, ver a física trabalhar e entrar na cena com o visor
Carregue a cena pelo botão, inicie o ciclo, mostre os ângulos das juntas, troque a câmera e a velocidade; com visor, entre em realidade virtual.
Pacote
Abrir no capítuloConstruir as cenas do orquestrador, do paralelismo e do robôthree, @react-three/fiber, @react-three/drei, @react-three/rapier, @react-three/xrMotion
Ver quatro agentes em raias trocando mensagens e a revisão devolvendo um trecho
Reproduza os 60 s de modelo, percorra o tempo pelo controle e esconda as mensagens para comparar a leitura; repare no tempo de parede contra a soma.
Pacote
Abrir no capítuloEspecificar, medir e produzir as cenas da máquinamotionMediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Medir o quadro da cena e gravar seis segundos dela em vídeo
Suba as partículas, force um bloqueio de 300 ms e leia o medidor; depois grave seis segundos, veja o codec escolhido e baixe o arquivo.
Pacote
Abrir no capítuloEspecificar, medir e produzir as cenas da máquinasem pacotesigma.js, graphology com ForceAtlas2 e cosmos.gl
Ver o grafo real do curso e um grafo de milhares de nós se organizarem em aglomerados
Rode o layout no grafo real, passe o mouse pelos nós e busque uma entidade; troque para 20 mil nós e leia o medidor; depois carregue o modo massivo na placa de vídeo.
Pacote
Abrir no capítuloAnimar um grafo de conhecimento amplo em movimentosigma, graphology, graphology-layout-forceatlas2, graphology-generators, @cosmos.gl/graph