SEO Programático · Capítulo 8 de 21 · 36 min
Bloquear a publicação de registro inválido
Uma regra automática impede que registro incompleto vire página pública, o erro que só aparece depois de mil publicações.
Este capítulo faz parte do curso gratuito SEO Programático. Para marcar como concluído e salvar o progresso, abra este capítulo na página do curso.
Trezentas páginas com título quebrado custam reputação e orçamento de rastreio muito antes de alguém perceber. A cena é comum: você publica 4.000 páginas municipais numa sexta-feira. Três semanas depois, alguém manda um print: o título de uma delas está escrito "Preço da gasolina em undefined em undefined". Você abre o Search Console e são 300 páginas assim. O CSV daquela semana veio com a coluna de município vazia em parte das linhas, o template concatenou o campo vazio sem reclamar, e o Next gerou 300 rotas perfeitamente válidas com metadata quebrada.
Nenhuma dessas 300 páginas jogou exceção. Esse é o ponto. Dado ruim não quebra o build, ele atravessa o build e vira HTML publicado. E quando a falha é silenciosa e distribuída, o custo de encontrá-la cresce com o tamanho do catálogo, porque você precisa auditar a saída em vez de olhar um stack trace.
A correção estrutural é mover a checagem para a fronteira de ingestão: o único ponto por onde o dado externo entra no seu sistema. Antes dessa linha, tudo é unknown. Depois dela, tudo é um tipo que você declarou. Se algo não passa, o processo morre ali, com o número da linha e o nome do campo.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Vale olhar o repositório que hospeda este curso, porque ele exibe o padrão exato que estamos corrigindo. Onze arquivos importam Zod: src/lib/api/validation.ts, src/lib/admin-schemas.ts e as rotas de contato, newsletter e revalidate. Todos validam input de API, ou seja, o que um humano digitou num formulário ou o que um cliente HTTP enviou no corpo da requisição.
Nenhum valida conteúdo. Os 152 artigos do site vivem como literais TypeScript em cerca de 70 arquivos, e o campo de corpo é string de HTML cru, sem schema. O formulário de contato tem mais garantia de integridade do que o acervo editorial inteiro.
A distinção importa porque as duas validações protegem contra coisas diferentes. Validação de input protege o seu banco de um usuário hostil ou distraído. Validação de conteúdo protege o seu público de uma página que você mesmo publicou errado. Em site artesanal, a segunda é dispensável porque um humano leu cada página antes de publicar. Em site programático, ela é a única leitura que vai acontecer.
A fronteira de ingestão é a única função do seu sistema que aceita unknown como entrada. Todo o resto do código recebe tipos já validados. Se você tem as PrecoMunicipio espalhado pelo projeto, você não tem fronteira: tem uma asserção que mente para o compilador e não checa nada em tempo de execução.
O padrão tem três camadas, e a terceira é a que muda o resultado.
- Camada 1, schema por tipo de página. Um schema declarado por família de página, com campos obrigatórios e faixas plausíveis.
- Camada 2, validação por registro na ingestão.
safeParselinha a linha, relatório agregado do que reprovou, e falha de build conforme política declarada. - Camada 3, fonte única de verdade. Uma função validada alimenta ao mesmo tempo a geração de rotas e a emissão do sitemap.
O repositório usa Zod na versão ^4.3.6, então é com ela que vamos trabalhar. Comece pelo schema do registro do Radar. Cada campo carrega uma restrição, e cada restrição existe por um motivo que você precisa saber declarar em voz alta.
npm run ingerir          camadas 1 e 2, fora do next build
   |
   v
parse do CSV             cada linha vira objeto, ainda unknown
   |
   v
safeParse por registro   relatório agregado do que reprovou
   |
   +--> reprovados > 0   process.exit(1), o build nem começa
   |
   v
lote validado em disco   data/anp-semana-corrente.json
   |
   v
next build               camada 3, uma leitura validada só
   |
   +--> generateStaticParams()    chama paginasPublicaveis()
   |
   +--> sitemap.ts                chama paginasPublicaveis()
// src/lib/radar/schema.ts
import { z } from "zod";

export const COMBUSTIVEIS = [
  "gasolina-comum",
  "gasolina-aditivada",
  "etanol",
  "diesel-s10",
  "glp",
] as const;

export const SchemaPrecoMunicipio = z.object({
  // 7 dígitos: o código IBGE completo, com o dígito verificador.
  // Aceitar 6 dígitos deixaria passar o código truncado, que casa
  // com o município errado na hora do join.
  codigoIbge: z
    .string()
    .regex(/^[0-9]{7}$/, { error: "codigoIbge precisa ter exatamente 7 dígitos" }),

  municipio: z.string().trim().min(2, { error: "municipio vazio" }),
  uf: z.string().length(2, { error: "uf precisa ter 2 letras" }),

  combustivel: z.enum(COMBUSTIVEIS),

  // A ANP publica por semana. Data ISO no formato AAAA-MM-DD.
  semanaReferencia: z.iso.date(),

  // Faixa larga de propósito: ela não existe para adivinhar o preço
  // certo, existe para pegar erro de unidade e de separador decimal.
  // 574 (centavos) e 0.0574 (divisão errada) morrem aqui.
  precoMedio: z
    .number()
    .min(0.5, { error: "precoMedio abaixo da faixa plausível" })
    .max(30, { error: "precoMedio acima da faixa plausível" }),

  // Inteiro positivo. Zero postos pesquisados com preço preenchido
  // é contradição interna do registro.
  postosPesquisados: z.number().int().positive(),
});

export type PrecoMunicipio = z.infer<typeof SchemaPrecoMunicipio>;
Repare no que cada faixa está de fato fazendo. O min(0.5) e o max(30) não tentam saber quanto custa a gasolina. Eles existem para pegar as três formas mais comuns de o parse de planilha corromper um número: preço em centavos que virou 574, vírgula decimal lida como separador de milhar que virou 5740, e divisão por 100 aplicada duas vezes que virou 0.0574. As três atravessam qualquer checagem de tipo, porque todas são number legítimos.
O mesmo raciocínio vale para postosPesquisados. Um registro com preço médio preenchido e zero postos pesquisados é internamente contraditório: o preço saiu de onde? Esse tipo de contradição é o que separa validar tipo de validar conteúdo.
Agora a camada 2. O ponto delicado da ingestão é não parar no primeiro erro. Se o build cai na linha 3 e você conserta, ele cai na linha 47, você conserta, e ele cai na 812. Você quer o relatório inteiro numa passada só.
// scripts/ingestao/ingerir-precos.ts
import { SchemaPrecoMunicipio, type PrecoMunicipio } from "../../src/lib/radar/schema";

type Reprovacao = { linha: number; campo: string; motivo: string };

export type Relatorio = {
  aprovados: PrecoMunicipio[];
  reprovados: Reprovacao[];
};

/**
 * `brutos` são as linhas já convertidas de CSV para objetos, sem
 * nenhuma coerção de tipo. Continuam `unknown` de propósito.
 */
export function ingerir(brutos: unknown[]): Relatorio {
  const aprovados: PrecoMunicipio[] = [];
  const reprovados: Reprovacao[] = [];

  brutos.forEach((bruto, indice) => {
    const resultado = SchemaPrecoMunicipio.safeParse(bruto);

    if (resultado.success) {
      aprovados.push(resultado.data);
      return;
    }

    // Uma linha de relatório por problema, não por registro:
    // um registro pode falhar em três campos ao mesmo tempo.
    for (const issue of resultado.error.issues) {
      reprovados.push({
        linha: indice + 2, // +1 pelo índice zero, +1 pelo cabeçalho do CSV
        campo: issue.path.join(".") || "(raiz)",
        motivo: issue.message,
      });
    }
  });

  return { aprovados, reprovados };
}

/** O gate. Chamado pelo script de ingestão, antes do `next build`. */
export function aplicarGate(rel: Relatorio): void {
  if (rel.reprovados.length === 0) {
    console.log(`ingestão ok: ${rel.aprovados.length} registros validados`);
    return;
  }

  console.error(`ingestão reprovada: ${rel.reprovados.length} problemas`);
  for (const r of rel.reprovados.slice(0, 50)) {
    console.error(`  linha ${r.linha} | campo ${r.campo} | ${r.motivo}`);
  }
  if (rel.reprovados.length > 50) {
    console.error(`  ... e mais ${rel.reprovados.length - 50}`);
  }
  process.exit(1);
}
Aqui nasce o erro mais caro do módulo, e ele é conceitual antes de ser técnico. Campo ausente ou malformado e cobertura ausente parecem a mesma coisa no relatório e exigem políticas opostas.
Um registro sem código IBGE é defeito de dado: alguém quebrou o pipeline, e publicar em cima disso produz página errada. Derruba o build.
Um município que simplesmente não teve coleta de preço naquela semana não tem defeito nenhum. A ANP não pesquisa os 5.570 municípios toda semana. Isso é ausência de inventário, e é uma informação legítima sobre o mundo. Se você tratar como erro, o build cai toda semana sem motivo. Se você tratar como campo opcional e seguir em frente, o template recebe undefined, e você acabou de reinventar a página com "undefined" no título.
A saída é representar a ausência explicitamente no registro, para que ela vire decisão de indexação lá em [Gerar tudo e publicar só o que tem dado](#indexacao-seletiva-em-render) em vez de virar página vazia publicada hoje.
// src/lib/radar/schema.ts (continuação)
import { z } from "zod";

const Identificacao = {
  codigoIbge: z.string().regex(/^[0-9]{7}$/),
  municipio: z.string().trim().min(2),
  uf: z.string().length(2),
  combustivel: z.enum(COMBUSTIVEIS),
  semanaReferencia: z.iso.date(),
};

/**
 * União discriminada: a ausência de coleta vira um estado do registro,
 * com forma própria. O compilador passa a exigir que o template trate
 * o caso "sem-coleta" antes de ler `precoMedio`, porque nesse ramo o
 * campo não existe.
 */
export const SchemaRegistro = z.discriminatedUnion("cobertura", [
  z.object({
    ...Identificacao,
    cobertura: z.literal("coletado"),
    precoMedio: z.number().min(0.5).max(30),
    postosPesquisados: z.number().int().positive(),
  }),
  z.object({
    ...Identificacao,
    cobertura: z.literal("sem-coleta"),
    // Sem preço e sem postos. Não é null nem zero: os campos não existem.
    ultimaSemanaComColeta: z.iso.date().nullable(),
  }),
]);

export type Registro = z.infer<typeof SchemaRegistro>;

/** O que pode virar página indexável sai daqui, e só daqui. */
export function temInventario(r: Registro): r is Extract<Registro, { cobertura: "coletado" }> {
  return r.cobertura === "coletado";
}Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Chegamos à camada que diferencia este módulo. A falha clássica de site programático não está no schema: está no fato de que duas partes do sistema leem a mesma origem separadamente. A função que gera as rotas aplica um filtro. A função que monta o sitemap aplica outro, escrito em outro dia, por outra pessoa, com outra regra de corte. Os dois funcionam. E divergem.
O sintoma aparece semanas depois, no relatório de cobertura do Search Console, como uma leva de URLs enviadas no sitemap retornando 404, ou como páginas geradas que nunca foram anunciadas e por isso demoram a ser descobertas. Nenhum dos dois quebra o build, porque nenhum dos dois é erro de programa.
A correção não é sincronizar os dois filtros nem escrever um teste que compare as duas listas. É eliminar a segunda leitura. Uma função validada e exportada, chamada pelos dois consumidores.
// src/lib/radar/fonte.ts
import { z } from "zod";
import { SchemaRegistro, temInventario, type Registro } from "./schema";
import dadosDaSemana from "../../../data/anp-semana-corrente.json";

/** Slug ASCII: acento em path quebra canonical e sitemap. */
function slugify(nome: string): string {
  return nome
    .normalize("NFD")
    .replace(/[\u0300-\u036f]/g, "")
    .toLowerCase()
    .replace(/[^a-z0-9]+/g, "-")
    .replace(/^-|-$/g, "");
}

let cache: Registro[] | null = null;

/** Única leitura validada do lote. Tudo no projeto passa por aqui. */
export function registrosValidados(): Registro[] {
  if (cache) return cache;

  const parsed = z.array(SchemaRegistro).safeParse(dadosDaSemana);
  if (!parsed.success) {
    // Se o gate de ingestão rodou, isto nunca dispara. Se alguém
    // editou o JSON à mão pulando o gate, o build para aqui.
    throw new Error(
      `dados da semana inválidos: ${parsed.error.issues.length} problemas`,
    );
  }

  cache = parsed.data;
  return cache;
}

/** A lista canônica de páginas publicáveis. Um filtro, um lugar. */
export function paginasPublicaveis() {
  return registrosValidados()
    .filter(temInventario)
    .map((r) => ({
      uf: r.uf.toLowerCase(),
      municipio: slugify(r.municipio),
      combustivel: r.combustivel,
      atualizadoEm: r.semanaReferencia,
    }));
}

// -------------------------------------------------------------
// src/app/precos/[uf]/[municipio]/[combustivel]/page.tsx
import { paginasPublicaveis } from "@/lib/radar/fonte";

export function generateStaticParams() {
  return paginasPublicaveis().map(({ uf, municipio, combustivel }) => ({
    uf,
    municipio,
    combustivel,
  }));
}

// -------------------------------------------------------------
// src/app/sitemap.ts
import type { MetadataRoute } from "next";
import { paginasPublicaveis } from "@/lib/radar/fonte";

export default function sitemap(): MetadataRoute.Sitemap {
  return paginasPublicaveis().map((p) => ({
    url: `https://exemplo.com.br/precos/${p.uf}/${p.municipio}/${p.combustivel}`,
    lastModified: p.atualizadoEm,
  }));
}
Existe uma classe de erro que passa por qualquer schema de campo isolado: o dado presente, bem formado e implausível. Um preço de gasolina que sai de R$ 6,12 numa semana para R$ 61,20 na seguinte é number, está dentro da faixa de 0,5 a 30 se você tiver escolhido a faixa larga demais, e vai direto para a página.
Movimento de mercado é contínuo. Salto de uma ordem de grandeza numa semana é, quase sempre, erro de parse. A checagem que pega isso precisa de contexto que o registro sozinho não tem: a semana anterior. Por isso ela entra como uma segunda passada, depois do schema de campo, e não dentro dele.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
// scripts/ingestao/plausibilidade.ts
import { temInventario, type Registro } from "../../src/lib/radar/schema";

/** Fator de variação semanal acima do qual tratamos como suspeita de parse. */
const LIMITE_VARIACAO = 1.5;

function chave(r: Registro) {
  return `${r.codigoIbge}:${r.combustivel}`;
}

export function conferirPlausibilidade(
  atual: Registro[],
  anterior: Registro[],
): { chave: string; anterior: number; atual: number; fator: number }[] {
  const mapaAnterior = new Map<string, number>();
  for (const r of anterior) {
    if (temInventario(r)) mapaAnterior.set(chave(r), r.precoMedio);
  }

  const suspeitos = [];
  for (const r of atual) {
    if (!temInventario(r)) continue;

    const antes = mapaAnterior.get(chave(r));
    // Sem semana anterior não há comparação possível. Primeira coleta
    // de um município não é suspeita, é estreia.
    if (antes === undefined) continue;

    const fator = r.precoMedio / antes;
    if (fator > LIMITE_VARIACAO || fator < 1 / LIMITE_VARIACAO) {
      suspeitos.push({ chave: chave(r), anterior: antes, atual: r.precoMedio, fator });
    }
  }

  return suspeitos;
}A política de resposta precisa estar escrita, porque cada uma das três saídas custa diferente. Campo ausente ou malformado derruba o build, sem exceção: o custo de não publicar uma semana é menor que o custo de publicar dado errado. Cobertura ausente segue adiante marcada, e vira noindex em [Gerar tudo e publicar só o que tem dado](#indexacao-seletiva-em-render). Preço implausível fica no meio, e é onde você escolhe: se o número de suspeitos for pequeno, o build cai e um humano olha; se for grande, o provável é que a fonte mudou de formato, e aí quem precisa mudar é o parser, não o limite. Deixe o limiar num arquivo de configuração, versionado, para que mudá-lo seja um commit revisável em vez de uma decisão de madrugada.
Classifique com o time quatro registros da próxima carga e peça a política de cada um por escrito. Um código IBGE com seis dígitos derruba o build. Um município sem coleta de diesel na semana segue marcado e vira noindex. Um preço de 612 contra 6,08 na semana anterior vai para revisão humana. Um registro com um único posto pesquisado e preço plausível segue com aviso. Depois pergunte se generateStaticParams e o sitemap chamam a mesma função; se a resposta for "temos um teste que compara as listas", ainda existem duas leituras.
O guia abaixo é para o executivo que aprova o lançamento e para o líder técnico que monta a esteira de publicação. Ele destrava uma decisão: nenhuma página nova vai ao ar sem passar pela fronteira de ingestão, e a política para cada tipo de falha fica escrita antes da primeira carga.
Guia de implementação: instalar a trava de publicação
Cinco passos que transformam a checagem de dado em condição para publicar.
Passo 1: Declare um schema por tipo de página
O desenvolvedor escreve as regras de cada campo que o template exibe, com faixas plausíveis.
Deu certo quando: Cada campo obrigatório do template tem regra própria no schema.
Erro comum: Um schema único para todas as páginas, cheio de campos opcionais.
Passo 2: Rode a validação antes do build, num script separado
O engenheiro de dados valida linha a linha e grava o lote aprovado num arquivo local.
Deu certo quando: O relatório lista todos os problemas numa passada, com linha e campo.
Erro comum: Parar no primeiro erro e consertar um por vez.
Passo 3: Escreva a política das três saídas
O dono do projeto decide o que derruba o build, o que vira noindex e o que vai para revisão humana.
Deu certo quando: A política está num arquivo versionado, com o limiar de variação semanal.
Erro comum: Tratar ausência de coleta como erro, o que derruba o build toda semana.
Passo 4: Faça rota e sitemap lerem a mesma função
O desenvolvedor elimina a segunda leitura da origem de dado.
Deu certo quando: Nenhuma URL do sitemap devolve 404 no relatório de páginas do Search Console.
Erro comum: Sincronizar dois filtros com um teste, em vez de ter um filtro só.
Passo 5: Compare cada carga com a semana anterior
O analista de dados revisa os saltos de preço fora do limiar antes da publicação.
Deu certo quando: Salto de uma ordem de grandeza nunca chega ao HTML publicado.
Erro comum: Afrouxar o limiar para o build passar, em vez de corrigir o parser.
No fim você tem: Uma esteira em que dado defeituoso para antes do build, ausência de coleta vira decisão de indexação e o sitemap anuncia só o que existe.
Quem faz, quanto custa, como conferir
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Schema por tipo de página | Desenvolvedor | Um a dois dias; sem custo de licença (biblioteca aberta) | Campo obrigatório do template sem regra = zero |
| Validação antes do build | Engenheiro de dados | Dois dias | Relatório com linha, campo e motivo de cada problema |
| Política das três saídas | Dono do projeto com o líder técnico | Uma reunião de uma hora | Arquivo versionado com política e limiar |
| Fonte única para rota e sitemap | Desenvolvedor | Meio dia | URLs do sitemap com erro 404 no Search Console = zero |
| Plausibilidade semanal | Analista de dados | Quinze minutos por carga | Lista de suspeitos revisada antes de cada publicação |
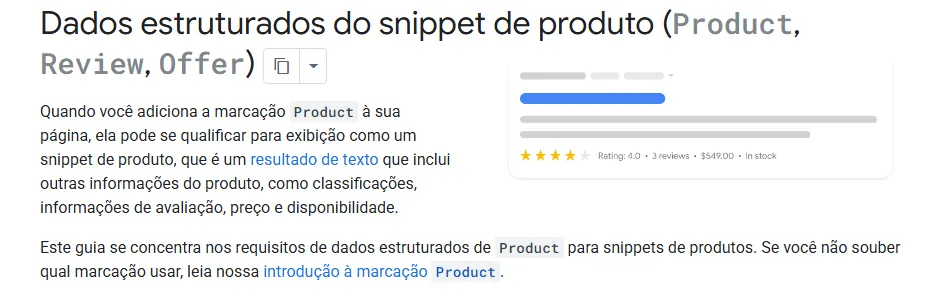
Guia prático: catálogo de e-commerce com a marcação conferida no build. Em catálogo, a página programática é a ficha de produto ou a página de categoria com filtro. O dado que importa muda toda semana: preço, estoque e promoção. Por isso a marcação Product precisa passar pela mesma trava de build que o texto.
O que mudou nos guias de produto do Google em 07/07/2026
- a propriedade category passou a aceitar texto ou código de categoria, alinhada ao Merchant Center;
- uma seção nova explica como marcar a duração de uma promoção com validFrom, validThrough e priceValidUntil.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Caso 3: catálogo de e-commerce com Product validado antes do deploy
Seis passos para a loja que gera fichas e páginas de categoria a partir do feed de produtos. A trava roda no build; o teste do Google confere a amostra.
Passo 1: Gere a marcação do mesmo feed que preenche a ficha
Nome, imagem, preço, moeda BRL, disponibilidade e category vêm do mesmo registro do texto visível.
Deu certo quando: O preço da marcação e o preço da página são o mesmo campo, lido uma vez.
Erro comum: Preço da marcação vindo de um cache antigo, diferente do preço exibido.
Passo 2: Acrescente as regras de Product à trava de build
Preço maior que zero, moeda presente, disponibilidade preenchida e imagem com endereço absoluto.
Deu certo quando: Um produto sem preço derruba o build e aparece no relatório de reprovados.
Erro comum: Publicar ficha com preço zero, que vira oferta falsa no resultado.
Passo 3: Marque a promoção com começo e fim
Use validFrom e validThrough na oferta e priceValidUntil quando o preço tiver data para acabar.
Deu certo quando: Depois do fim da promoção, a marcação volta ao preço cheio no build seguinte.
Erro comum: Promoção encerrada que continua marcada, com preço que a loja não pratica mais.
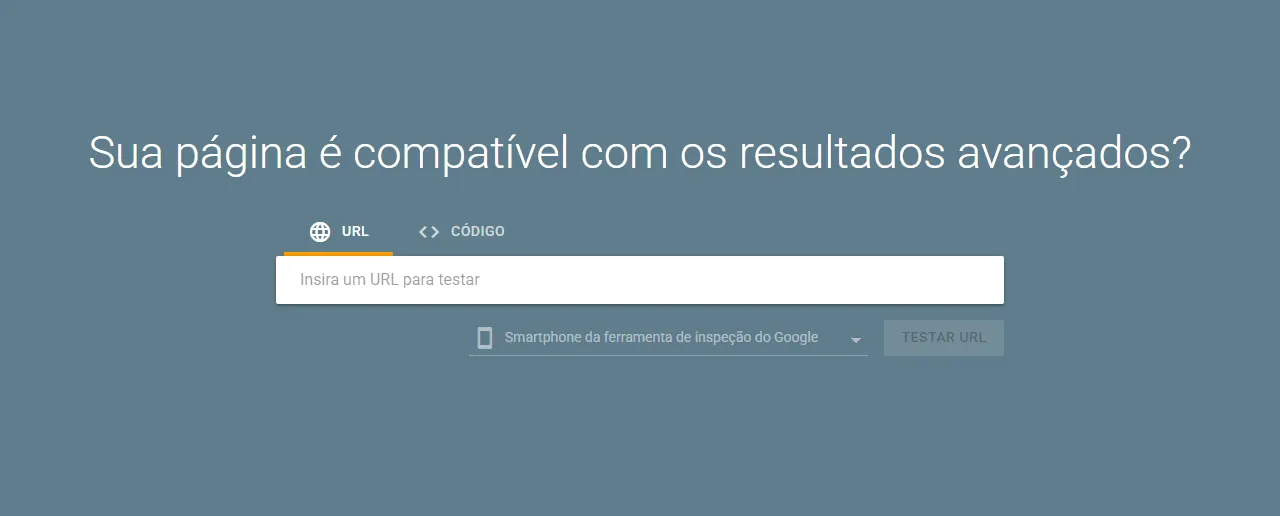
Passo 4: Rode o Teste de pesquisa aprimorada na aba Código
Cole o HTML de três fichas geradas no build: uma em estoque, uma esgotada e uma em promoção.
Deu certo quando: As três aparecem com Product válido e sem aviso crítico.
Erro comum: Testar só a ficha completa e descobrir o erro da esgotada no Search Console.
Passo 5: Não gere página para cada combinação de filtro
Cor, tamanho e ordenação viram parâmetros sem página própria, salvo quando a combinação tem procura e estoque.
Deu certo quando: O número de páginas de categoria fica perto do número de categorias reais.
Erro comum: Milhares de páginas de filtro quase iguais, o padrão que a política de conteúdo em escala descreve.
Passo 6: Confira o relatório de produtos no Search Console
Os relatórios de resultados aprimorados mostram itens válidos e com problema, por tipo.
Deu certo quando: A contagem de itens válidos acompanha o tamanho do catálogo publicado.
Erro comum: Olhar só o tráfego e perder um erro de marcação que atinge um lote inteiro.
No fim você tem: Fichas de produto com marcação que nunca diverge do preço da página, conferida no build e no teste oficial.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Antes do próximo lote, exija ver o relatório de uma carga reprovada de propósito: peça ao time que injete um código IBGE com seis dígitos e mostre o build parando. Se a carga defeituosa chegar ao ar, a trava não existe; se parar com linha e campo nomeados, autorize o lote.
Perguntas frequentes deste capítulo
Por que não usar apenas os tipos do TypeScript, já que o registro tem interface declarada?
Derrubar o build inteiro por causa de sete registros ruins em cinco mil não é exagero?
O relatório vai reprovar milhares de registros na primeira execução. Como sair disso sem desligar o gate?
Onde exatamente esse gate roda: no CI, num script separado, ou dentro do próprio build do Next?
Preciso de um schema diferente para cada tipo de página, ou um só resolve?
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Explore os conceitos e compare abordagens em outros cursos. As conexões indicam assuntos relacionados; a sequência de estudo continua no índice do curso.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Vibecoding para SEOOrquestrando Tudo: Seu Toolkit SEO CompletoExaminar conexões de Orquestrando Tudo: Seu Toolkit SEO Completo
- MCP com Chrome: Automação com IADescobrir o que a IA não vê na página que você vêExaminar conexões de Descobrir o que a IA não vê na página que você vê
- GEO Universal FrameworkEscolha o modelo por tarefa e evite orquestração desnecessáriaExaminar conexões de Escolha o modelo por tarefa e evite orquestração desnecessária
- Autoridade Temática e SEO de EntidadesO crachá da sua empresa para as máquinasExaminar conexões de O crachá da sua empresa para as máquinas