SEO programático · ·
Acompanhar o acervo no Search Console
Medir grupos de páginas e comparar períodos; reconhecer limites da interface e o custo de uma exportação para o BigQuery.
Este capítulo faz parte do curso gratuito SEO programático.
Exemplo: o Radar publica 4.000 páginas e as impressões começam a crescer. A liderança quer entender quais grupos contribuem, onde faltam dados e se duas páginas atendem à mesma consulta. O total do site não responde a essas perguntas.
Comece com filtros e comparações no Search Console. A interface limita a quantidade de linhas exibidas e pode não mostrar toda a parte menos acessada do acervo. Quando a investigação exige cruzamentos maiores, avalie exportação e BigQuery, incluindo seu custo de armazenamento e consulta no orçamento.
Ver como texto
Comparação de duas superfícies de medição. À esquerda, a interface do Search Console obriga a escolher entre a dimensão consulta e a dimensão página e corta o relatório em mil linhas. À direita, uma linha da tabela searchdata_url_impression traz url, query, is_anonymized_query, as colunas booleanas de aparência e a data, tudo junto.
O Bulk Data Export envia dados de desempenho do Search Console para tabelas do seu projeto BigQuery diariamente. Ele atende análises que exigem mais linhas, cruzamentos e retenção própria. A API também permite combinar consulta e página, mas tem limites de retorno; a vantagem da exportação está na abrangência e no histórico que passa a acumular.
No conjunto exportado, confira quatro pontos
- Consulta e URL: ajudam a localizar páginas que aparecem para a mesma pergunta. Isso sinaliza uma investigação, não comprova canibalização.
- Consultas anonimizadas: o campo
is_anonymized_queryidentifica linhas cujo texto da consulta não é revelado. Você mede a parcela de impressões que não consegue detalhar. - Aparência na busca: campos por URL permitem separar recursos, conforme a referência das tabelas.
- Retenção: depende das configurações do projeto e da expiração das partições. Guardar mais tempo também tem custo.
No Radar, a proporção anonimizada ajuda a dimensionar um ponto cego da cauda longa. Ela complementa impressões, cliques e resultados comerciais; não é, por si só, a medida mais importante do negócio.
A exportação começa a acumular a partir do dia da configuração. Não existe retroativo. A primeira carga chega em até 48 horas e traz dados dali para frente. Isso torna o Bulk Data Export a primeira coisa a ligar num projeto novo, antes de publicar a primeira página. Quem liga no dia em que precisa do histórico já perdeu o histórico. Segunda regra da mesma documentação: alterar a estrutura das três tabelas criadas pelo export quebra as exportações seguintes, então colunas derivadas moram em views, nunca em ALTER TABLE.
Ver como texto
Linha do tempo do Bulk Data Export. Antes do dia da configuração não existe dado e a perda é irreversível. Do dia da configuração em diante a série acumula todo dia, com a primeira carga chegando em até 48 horas.
# Pré-requisito: projeto Google Cloud com faturamento habilitado.
# Estime armazenamento e consultas antes de habilitar a rotina.

gcloud config set project radar-combustivel

# 1. Habilitar a BigQuery API no projeto
gcloud services enable bigquery.googleapis.com bigquerystorage.googleapis.com

# 2. Criar o dataset. O nome precisa ser prefixado com "searchconsole"
#    e a localização precisa bater com a que você informar no Search Console.
bq --location=southamerica-east1 mk \
  --dataset radar-combustivel:searchconsole_radar

# 3. Conceder os dois papéis à conta de serviço do Search Console.
#    O endereço abaixo é fixo e igual para todo mundo.
gcloud projects add-iam-policy-binding radar-combustivel \
  --member="serviceAccount:search-console-data-export@system.gserviceaccount.com" \
  --role="roles/bigquery.jobUser"

gcloud projects add-iam-policy-binding radar-combustivel \
  --member="serviceAccount:search-console-data-export@system.gserviceaccount.com" \
  --role="roles/bigquery.dataEditor"

# 4. No Search Console: Configurações > Exportação de dados em massa.
#    Informe o ID do projeto (radar-combustivel), o nome do dataset
#    (searchconsole_radar) e a localização (southamerica-east1).
#    A primeira carga chega em até 48 horas.

# 5. Expiração de partição: se você configurar, use no mínimo 14 dias.
bq update --default_partition_expiration=7776000 \
  radar-combustivel:searchconsole_radar   # 90 dias, em segundos
São três tabelas: searchdata_site_impression (agregada por propriedade), searchdata_url_impression (a que interessa aqui, com url e query na mesma linha) e ExportLog (o registro de quais cargas já chegaram, útil para saber se o dia de ontem entrou antes de rodar qualquer relatório).
Agora o exemplo resolvido que dá nome ao módulo. Você quer saber, nos últimos 28 dias, quais consultas têm mais de uma página do Radar disputando espaço, e como cada uma delas se sai. É a pergunta que a interface não aceita.
Dois cuidados que decidem se o resultado faz sentido. Primeiro, os dados vêm com chaves repetidas e sem pré-agregação, então praticamente toda consulta precisa de GROUP BY com SUM. Segundo, sum_position é uma soma de posições ponderada por impressões, e não uma posição. A forma correta de obter a posição média é SUM(sum_position) / SUM(impressions) + 1. Somar sum_position e mostrar o resultado produz um número grande e sem significado, que é o erro mais comum de quem chega a essas tabelas vindo da interface.
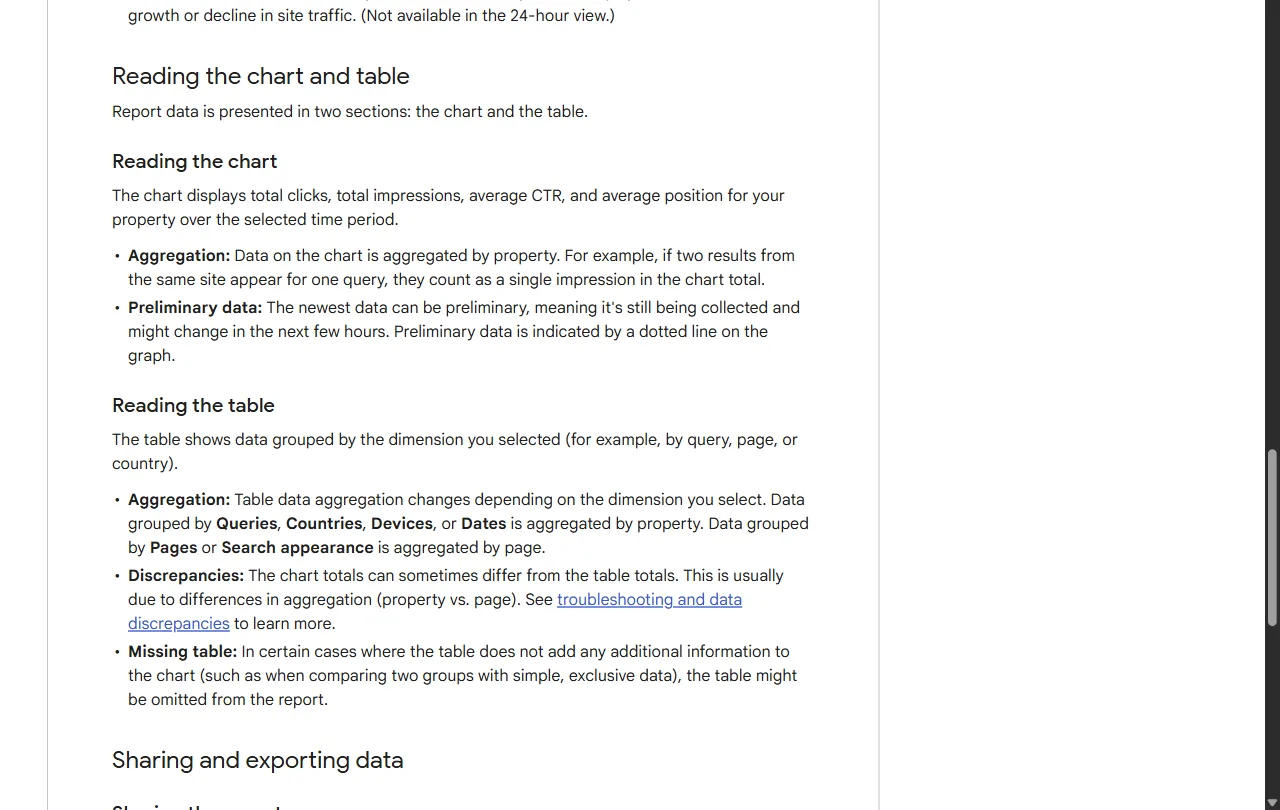
Fonte: support.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: definição dos indicadores e recursos de comparação.
-- Canibalização entre páginas geradas: quais consultas têm 2 ou mais
-- URLs do Radar competindo, e como cada URL se comporta nelas.
-- Rode no BigQuery, no dataset criado pelo Bulk Data Export.

DECLARE inicio DATE DEFAULT DATE_SUB(CURRENT_DATE(), INTERVAL 28 DAY);

WITH por_query_url AS (
  SELECT
    query,
    url,
    SUM(impressions) AS impressoes,
    SUM(clicks)      AS cliques,
    -- posição média correta: soma ponderada dividida por impressões, mais 1
    SUM(sum_position) / SUM(impressions) + 1 AS posicao_media
  FROM `radar-combustivel.searchconsole_radar.searchdata_url_impression`
  WHERE data_date >= inicio          -- filtra a partição: é o que segura o custo
    AND search_type = 'WEB'
    AND is_anonymized_query = FALSE  -- query vazia não serve para este diagnóstico
  GROUP BY query, url
),

disputadas AS (
  SELECT
    query,
    COUNT(DISTINCT url) AS paginas_disputando,
    SUM(impressoes)     AS impressoes_da_query
  FROM por_query_url
  GROUP BY query
  HAVING COUNT(DISTINCT url) >= 2
)

SELECT
  d.query,
  d.paginas_disputando,
  d.impressoes_da_query,
  p.url,
  p.impressoes,
  p.cliques,
  ROUND(p.posicao_media, 2) AS posicao_media
FROM disputadas d
JOIN por_query_url p USING (query)
ORDER BY d.impressoes_da_query DESC, p.impressoes DESC
LIMIT 500;Leia o resultado assim: consulta com duas URLs onde uma tem posição média 8 e a outra 34 costuma ser sobreposição saudável (uma página municipal e a página de UF, por exemplo). Consulta com quatro URLs municipais vizinhas, todas entre a posição 20 e a 40, é sinal de que o template não diferencia os municípios o suficiente para o buscador escolher uma. Esse é o insumo que devolve você a [Escolher quais páginas devem aparecer na busca](#indexacao-seletiva-em-render), para decidir indexação contra o inventário, e a [Construir um modelo de página que responda bem](#template-com-densidade), para medir densidade de informação por página.
-- Quanto da cauda longa está anonimizado, semana a semana.
-- is_anonymized_query = TRUE significa query rara: o campo query vem
-- como string de comprimento zero e a consulta some do seu relatório.

SELECT
  DATE_TRUNC(data_date, WEEK(MONDAY)) AS semana,
  SUM(IF(is_anonymized_query, impressions, 0)) AS impressoes_anonimizadas,
  SUM(impressions)                             AS impressoes_totais,
  ROUND(
    SUM(IF(is_anonymized_query, impressions, 0)) / SUM(impressions) * 100,
    1
  ) AS pct_anonimizado
FROM `radar-combustivel.searchconsole_radar.searchdata_url_impression`
WHERE data_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 90 DAY)
  AND search_type = 'WEB'
GROUP BY semana
ORDER BY semana;

-- Interpretação: essa porcentagem é a fatia do resultado que você NÃO vê
-- em nenhum relatório de consultas. Se ela sobe enquanto o total sobe,
-- o projeto está ganhando cauda longa. Se ela cai enquanto o total cai,
-- você está perdendo justamente o ativo que justifica o site existir.
O Google informa que a exportação exige um projeto com faturamento e que os dados estão sujeitos a custos de armazenamento e consulta, embora exista uma faixa de uso gratuito. O custo varia com volume, retenção, frequência, região e modalidade de contratação.
Antes de ligar uma rotina, peça uma estimativa para o seu caso. Depois compare a estimativa com o consumo real. Filtrar datas e colunas reduz leituras desnecessárias; configurar expiração evita guardar dados indefinidamente. Alertas de orçamento ajudam a acompanhar o gasto, mas não funcionam, por si só, como um bloqueio de cobrança.
As cotas da API desenham a arquitetura de monitoramento, e é aqui que a maioria dos pipelines nasce torta. Os limites oficiais da API, na página atualizada em 28/08/2025, são estes:
- Search Analytics: 1.200 QPM por site e por usuário, 40.000 QPM por projeto.
- URL Inspection: 600 QPM e 2.000 QPD por site.
- Demais recursos: 20 QPS e 200 QPM por usuário.
- Extração completa: 50.000 linhas por dia por tipo de busca e 25.000 linhas por resposta, paginando com
startRow.
O número que muda o projeto é o de 2.000 inspeções por dia por site. Com 20.000 páginas geradas, a varredura completa leva dez dias.
Ver como texto
Vinte mil páginas divididas por duas mil inspeções de URL por dia dão dez dias de varredura completa, desenhados como dez quadrados de calendário que se preenchem em sequência. Ao lado, a alternativa de amostragem estratificada, que usa uma fração da cota e responde todo dia.
Dois comportamentos documentados que derrubam a confiança de quem não sabe deles. Primeiro: agregação por página produz números diferentes de agregação por propriedade. São duas contabilidades distintas, não duas visões do mesmo número. Segundo: ao agrupar por página e query, o Google declara descartar parte dos dados, textualmente, "in order to be able to calculate results in a reasonable time using a reasonable amount of computing resources". A soma dos detalhes nunca fecha com o total, e isso é comportamento documentado, não bug. Se um cliente cobrar a diferença, a resposta é a documentação, não uma auditoria de código.
O relatório de indexação de páginas usa rótulos parecidos para situações opostas, e a ajuda oficial do Search Console descreve cada um.
"Discovered, currently not indexed": "The page was found by Google, but not crawled yet. Typically, Google wanted to crawl the URL but this was expected to overload the site; therefore Google rescheduled the crawl." A data do último rastreio fica vazia. É problema de capacidade e de demanda de rastreio, com tratamento técnico: tempo de resposta do servidor, poda de inventário e sinais de importância.
"Crawled, currently not indexed": "The page was crawled by Google but not indexed. It may or may not be indexed in the future; no need to resubmit this URL for crawling." O Google gastou recurso para buscar a página e decidiu que ela não merece espaço no índice. Em site programático, é o sinal mais direto de que o template produz páginas indistinguíveis entre si.
Mais três estados que aparecem em volume num projeto como o Radar. "Duplicate without user-selected canonical": a página é duplicata e o Google escolheu outra como canônica, o que se corrige declarando a canônica ou garantindo diferença substancial de conteúdo. "Alternate page with proper canonical tag": a página aponta corretamente para uma canônica indexada, e não há nada a fazer. "Page with redirect": URL não canônica que redireciona, e o destino pode ou não estar indexado.
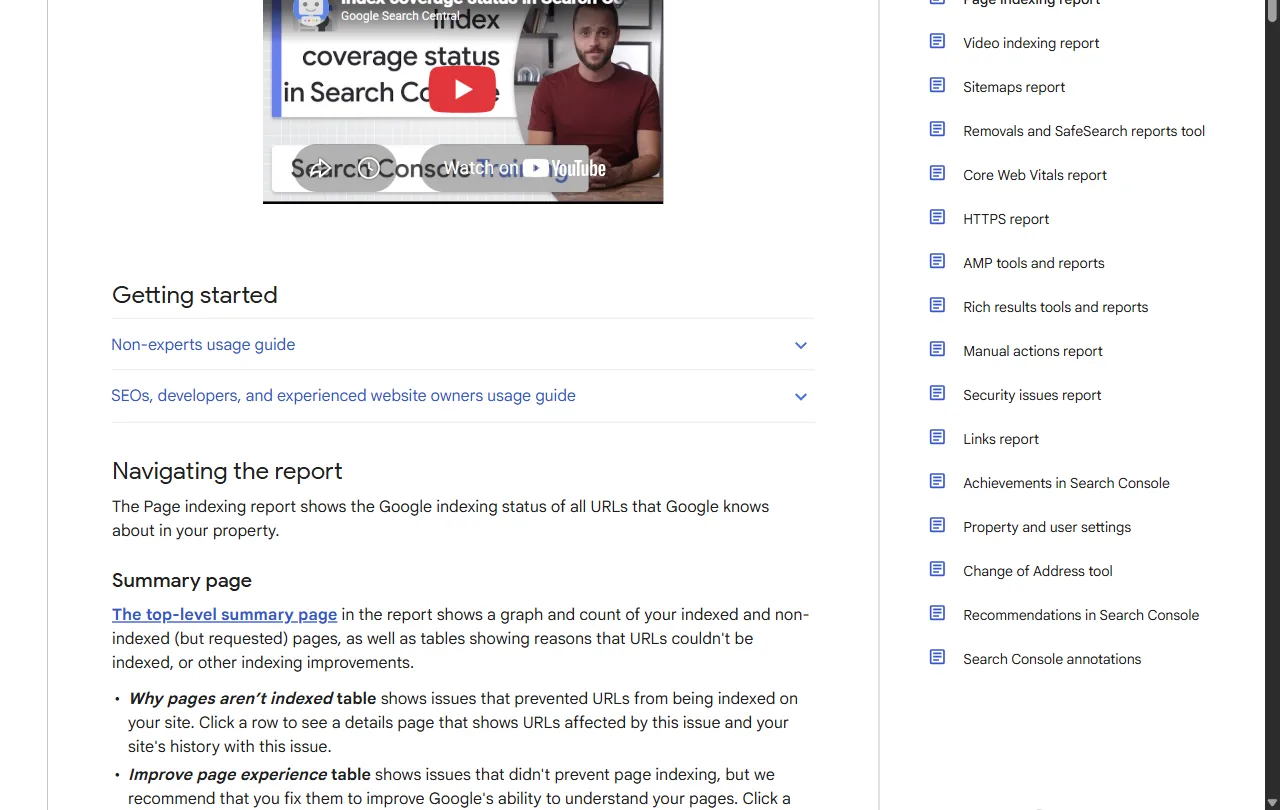
Fonte: support.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: categorias do relatório de páginas indexadas e motivos de exclusão.
Ver como texto
Árvore diagnóstica dos estados de indexação. Discovered currently not indexed leva ao ramo técnico de capacidade: tempo de resposta do servidor, poda de inventário e sinais de importância. Crawled currently not indexed leva ao ramo de valor, com a orientação oficial de não reenviar a URL.
Diante de "Crawled, currently not indexed", reenviar a URL, pingar o sitemap ou trocar links internos é ritual: nenhuma dessas ações trata o motivo do estado, e a orientação oficial é literalmente não reenviar. O que move o número é reduzir a quantidade de páginas publicadas ou aumentar a densidade de informação por página. No Radar, isso significa cortar municípios com série histórica curta demais para render texto próprio, ou trazer mais recorte por página (variação semanal, comparação com a média da UF, número de postos pesquisados).
Sobre crawl budget, a expectativa importada de material antigo atrapalha mais do que ajuda. Os limiares oficiais para o tema valer atenção, na documentação de orçamento de rastreio atualizada em 19/12/2025, são três: mais de 1 milhão de páginas com mudança semanal, ou mais de 10.000 páginas com mudança diária, ou proporção alta de URLs em "Discovered, currently not indexed".
Um site programático de 3.000 a 8.000 URLs não está no perfil oficial. Se essas URLs não indexam, a causa provável é qualidade e duplicação, e otimizar orçamento de rastreio nesse cenário gasta semanas resolvendo o problema errado. O terceiro limiar é a porta de entrada legítima: quando "Discovered" domina, o tema passa a valer.
O conceito que explica por que poda funciona é crawl demand (demanda de rastreio: quanto o Google quer revisitar o site, como a frequência com que um cliente volta à loja), determinado por fatores declarados: *perceived inventory* (duplicatas e URLs indesejadas reduzem a demanda), *popularity*, *staleness* (a frequência de recrawl acompanha mudança real de conteúdo) e eventos sitewide como migrações. Remover 1.200 páginas municipais sem inventário aumenta a demanda de rastreio das que sobraram, porque muda a percepção de inventário do site inteiro.
Novidade que data qualquer material anterior a setembro de 2026: o relatório de desempenho em IA generativa do Search Console, anunciado em 03/06/2026, foi liberado para todos os sites em 31/08/2026. Ele mostra impressões em AI Overviews e AI Mode, com filtro de página, país, dispositivo e data, mas não traz cliques nem consultas. Desde 24/09/2026 há também o tipo de busca "Web: multimodal", para buscas feitas com imagem. Como transformar isso em painel semanal por grupo de páginas é o assunto de [Medir a presença do acervo nas respostas de IA](#medir-acervo-nas-respostas-de-ia); o que vale cobrar de presença em IA fora do Google fica em [Avaliar o que favorece a presença nas respostas de IA](#visibilidade-em-motores-generativos).
Estado do Radar ao fim deste módulo. Bulk Data Export configurado e acumulando desde o primeiro dia do projeto. A consulta de canibalização rodando semanalmente sobre as páginas municipais, com a lista de consultas onde duas ou mais páginas competem. A proporção de impressões com query anonimizada calculada por semana, que é o indicador de saúde da cauda longa. E um painel de indexação por lote de publicação, agrupando as URLs pelo dia em que entraram no sitemap, para separar lote que ainda não foi rastreado de lote que foi rastreado e recusado.
Ao interpretar qualquer série que atravesse setembro de 2025, lembre do que foi visto em [Priorizar páginas pela necessidade do público](#keywords-sem-volume-confiavel): impressões antes e depois daquele corte não são comparáveis.
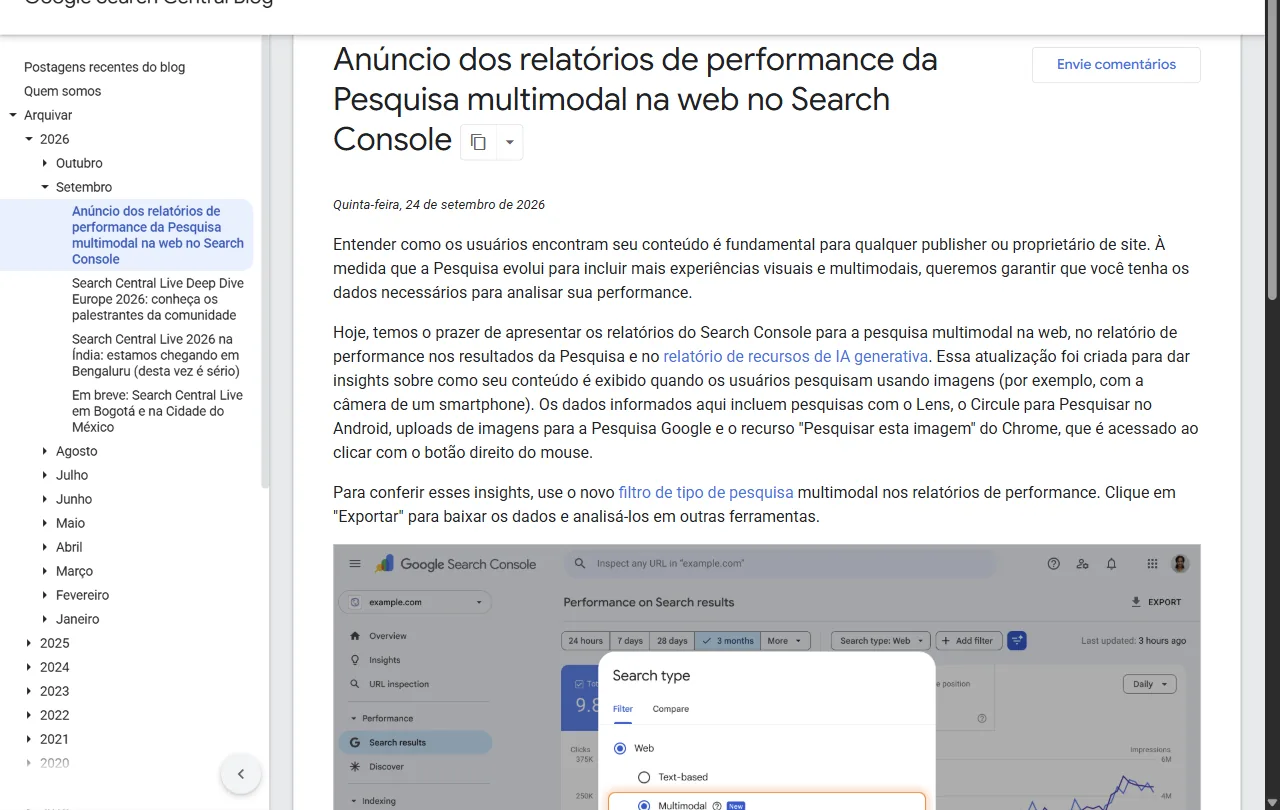
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: filtro de pesquisa multimodal anunciado em 24/09/2026.
Leve três perguntas para a próxima reunião com quem opera o acervo. Primeira: quantas URLs estão em "Crawled, currently not indexed" e quantas em "Discovered, currently not indexed", porque cada estado pede um plano diferente, e o primeiro inclui não reenviar nada. Segunda: como o painel calcula a posição média; se a resposta não for soma ponderada dividida por impressões, mais 1, o número está errado. Terceira: desde que dia o export acumula dados, porque cada mês sem ele é histórico perdido para sempre.
O guia abaixo serve ao executivo que precisa ter, em até duas semanas, uma medição que o comitê aceite sem discussão de metodologia. Ele destrava a decisão mais cara do projeto: saber se o acervo cresce na cauda longa ou só no topo que qualquer relatório já mostra.
Guia de implementação: ligar a medição da cauda longa
Cinco passos, na ordem, e o primeiro vale antes mesmo da primeira página publicada.
Passo 1: Ligue a exportação em massa do Search Console no BigQuery
Projeto no Google Cloud com faturamento habilitado, dataset com prefixo searchconsole e os dois papéis concedidos à conta de serviço do Search Console.
Deu certo quando: A tabela ExportLog mostra a primeira carga em até 48 horas.
Erro comum: Deixar para ligar quando precisar do histórico; a exportação não é retroativa.
Passo 2: Crie as duas consultas de rotina
Canibalização entre páginas irmãs e proporção semanal de impressões com consulta anonimizada, as duas filtradas por data.
Deu certo quando: As duas têm volume processado, duração e custo medidos no seu conjunto de dados.
Erro comum: Somar sum_position e apresentar como posição média.
Passo 3: Agrupe as URLs por lote de publicação
Cada página ganha a data em que entrou no sitemap, para separar lote ainda não rastreado de lote rastreado e recusado.
Deu certo quando: O painel mostra a taxa de indexação por lote, e não só o total.
Erro comum: Olhar só o número agregado de páginas indexadas.
Passo 4: Monte a amostra diária de inspeção
Sorteie algumas centenas de URLs por lote e por faixa de inventário, dentro da cota de 2.000 inspeções por dia.
Deu certo quando: A proporção indexada de cada estrato sai todo dia com intervalo de confiança.
Erro comum: Tentar varrer o catálogo inteiro e reportar dado de dez dias atrás.
Passo 5: Leve ao comitê três números fixos
Impressões totais, proporção anonimizada e taxa de indexação por lote, sempre na mesma janela de 28 dias.
Deu certo quando: A reunião discute decisão, e não como o número foi calculado.
Erro comum: Comparar séries que atravessam setembro de 2025 sem avisar a quebra.
No fim você tem: Um painel semanal de cauda longa, com histórico desde a configuração e custos acompanhados.
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Ligar a exportação | Engenheiro de dados com acesso ao Search Console | Meio dia; sem custo de licença | ExportLog com carga nas primeiras 48 horas |
| Consultas de rotina | Analista de SEO com apoio do engenheiro de dados | Um a dois dias de trabalho estimado; consultas orçadas conforme volume e região | Relatório de custo do BigQuery comparado ao orçamento aprovado |
| Agrupar por lote | Desenvolvedor que gera o sitemap | Um dia | Toda URL do painel tem data de entrada no sitemap |
| Amostra diária de inspeção | Engenheiro de dados | Dois dias; cota gratuita da API | Uso diário abaixo de 2.000 inspeções por site |
| Painel para o comitê | CMO, com o analista de SEO | Meio dia por mês | Mesmos três números, mesma janela, em todas as reuniões |
Ligue a exportação ainda esta semana, antes de qualquer outra melhoria de medição. Confira em 48 horas se a tabela ExportLog registrou a primeira carga e, em 30 dias, se o painel já mostra a proporção semanal de consultas anonimizadas nas quatro semanas completas.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSEO e GEO para quem decide
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta os conceitos “Indexação” e “Canonical”, usados em “Acompanhar o acervo no Search Console”.
- Melhore uma página a partir da dúvida do leitorsugerido pelo grafoApresenta o conceito “Long-tail”, usado em “Acompanhar o acervo no Search Console”.
- Leia o relatório sem confundir aparições, visitas e vendassugerido pelo grafoApresenta o conceito “Posição média”, usado em “Acompanhar o acervo no Search Console”.
- Search Console para decisãoExplique por que a soma da tabela não bate com o totalExaminar conexões de Explique por que a soma da tabela não bate com o total
- Python do zeroLer páginas e consultas do Search Console com PythonExaminar conexões de Ler páginas e consultas do Search Console com Python
- Google Analytics 2027Exportação para o BigQuery: analisar os eventos brutos fora do GA4Examinar conexões de Exportação para o BigQuery: analisar os eventos brutos fora do GA4
- Analytics de buscaContratar uma ferramenta com prova de utilidadeExaminar conexões de Contratar uma ferramenta com prova de utilidade
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.