SEO programático · ·
Avaliar o que favorece a presença nas respostas de IA
Separar boas práticas documentadas de hipóteses de mercado e registrar quais usos dos dados a empresa autoriza.
Este capítulo faz parte do curso gratuito SEO programático.
Antes de investir para aparecer em respostas de IA, separe três decisões: permitir acesso ao conteúdo, oferecer informação útil e medir o que aconteceu. Abrir o site para um rastreador não garante citação, e bloquear um uso não significa bloquear todos os demais. A documentação de cada plataforma é o ponto de partida.
No Radar, projeto hipotético, a liderança precisa escolher quais usos autoriza e quais evidências justificam uma melhoria editorial. Uma pergunta isolada a um assistente não mede presença da marca: formulação, contexto, momento e versão podem alterar a resposta. O acompanhamento usa amostras comparáveis; cinco tentativas podem iniciar a exploração, mas não garantem significância estatística.
O número mais vendido do mercado é o aumento de até 40% em visibilidade do paper fundacional de GEO (Aggarwal et al., KDD 2024, arXiv 2311.09735). A survey crítica de 15/07/2026 (Martinez, arXiv 2607.14035) rastreou a origem: é o aumento da métrica pawc de 19,3 para 27,2 na tática de Quotation Addition, cerca de 41% em termos relativos, medido sobre cinco documentos que já estavam colocados no contexto.
O experimento mede influência dentro de um contexto fixo. Nada no paper prova que a tática faz um documento entrar no contexto. A formulação honesta, que você pode dizer ao cliente sem se contradizer depois: táticas de GEO demonstram influência dentro do contexto, e entrar no contexto é um problema separado e não resolvido.
Ver como texto
Pipeline de nove estágios de um motor generativo, do prompt do usuário até o comportamento. Cada estágio traz a sua alavanca e a sua métrica. Os estágios 3 (retrieval) e 4 (alocação de contexto) aparecem destacados como problema em aberto: as táticas de GEO influenciam um documento que já está no contexto, e fazer o documento entrar no contexto é um problema separado que nenhuma técnica revisada resolve.
Quem pensa em ranking otimiza o estágio errado. Um motor generativo é um pipeline estocástico e parcialmente observável: a busca pode nem ser ativada, o retrieval seleciona candidatos contra uma consulta que o usuário nunca escreveu, o reranking decide a posição no contexto, e só depois vem citação, proeminência, absorção do fato e fidelidade. Otimizar "a página" sem dizer qual estágio você está atacando produz relatório bonito e resultado nulo.
A survey revisou 45 estudos entre novembro de 2023 e julho de 2026 e separou o que se reproduz do que não se reproduz. Essa separação é o ativo mais valioso do módulo, porque é ela que define o que você pode prometer.
- Etapa 1 de 7: Reprodutível: documento já no contexto altera causalmente rank, citação e uso
O que você pode dizer: vale otimizar o trecho, não a promessa.
- Etapa 2 de 7: Reprodutível: relevância query-documento e posição no contexto decidem
O que você pode dizer: trabalhe a grounding query, não o prompt.
- Etapa 3 de 7: Reprodutível: engines diferem muito entre si e variam no tempo
O que você pode dizer: proibido "otimizar para IA" no singular.
- Etapa 4 de 7: Moderadamente: evidência extraível (estatística, definição) facilita o uso
O que você pode dizer: dado com unidade e fonte ajuda.
- Etapa 5 de 7: NÃO reprodutível: efeito causal sobre descoberta orgânica
O que você pode dizer: nenhuma técnica sustenta a promessa.
- Etapa 6 de 7: NÃO reprodutível: efeito sobre tráfego e conversão
O que você pode dizer: existe um quase-experimento, só isso.
- Etapa 7 de 7: NÃO reprodutível: heurísticas genéricas, com 3 casos positivos em 54 no C-SEO Bench
O que você pode dizer: e os ganhos erodem sob competição.
Ver como texto
- Reprodutível: documento já no contexto altera causalmente rank, citação e uso: O que você pode dizer: vale otimizar o trecho, não a promessa.
- Reprodutível: relevância query-documento e posição no contexto decidem: O que você pode dizer: trabalhe a grounding query, não o prompt.
- Reprodutível: engines diferem muito entre si e variam no tempo: O que você pode dizer: proibido "otimizar para IA" no singular.
- Moderadamente: evidência extraível (estatística, definição) facilita o uso: O que você pode dizer: dado com unidade e fonte ajuda.
- NÃO reprodutível: efeito causal sobre descoberta orgânica: O que você pode dizer: nenhuma técnica sustenta a promessa.
- NÃO reprodutível: efeito sobre tráfego e conversão: O que você pode dizer: existe um quase-experimento, só isso.
- NÃO reprodutível: heurísticas genéricas, com 3 casos positivos em 54 no C-SEO Bench: O que você pode dizer: e os ganhos erodem sob competição.
A citação literal da survey, para você guardar antes de assinar qualquer proposta: *"no reviewed technique shows a stable, longitudinal, cross-platform causal effect on organic discoverability or downstream behavior"*. E o alerta contraintuitivo que evita estrago em página que já funciona: rewrites focados em citação podem degradar a performance de retrieval. Otimizar para ser citado e otimizar para ser recuperado são objetivos que podem brigar entre si. Se você reescrever as páginas do Radar em blocos curtos e citáveis e a página parar de ser recuperada, você piorou o estágio 3 para ganhar no estágio 5, e o estágio 5 nunca acontece sem o 3.
Ver como texto
Matriz de crawlers de IA por função: quatro fornecedores nas linhas (OpenAI, Anthropic, Perplexity e Google) e três colunas (treino, índice de busca e acionado pelo usuário). A coluna do índice de busca está destacada como a origem da citação e aparece riscada em vermelho, mostrando que o Disallow para todos apaga justamente essa coluna, sem desfazer o treino que já aconteceu e sem impedir o fetch acionado pelo usuário.
O erro de configuração mais caro que existe hoje mora aqui, e ele é cometido justamente por quem quis se proteger. As três funções têm consequências opostas:
- Treino:
GPTBot(OpenAI),ClaudeBot(Anthropic),Google-Extended(opt-out de treino e grounding no Google),CCBot. Bloquear aqui não desfaz o treino que já aconteceu. - Índice de busca:
OAI-SearchBot,Claude-SearchBot,PerplexityBot,Googlebot. A documentação da OpenAI é explícita: *"Sites that are opted out of OAI-SearchBot will not be shown in ChatGPT search answers"*. Bloquear aqui é escolher sair das respostas com citação. - Acionado pelo usuário:
ChatGPT-User,Claude-User,Perplexity-User. A OpenAI documenta que *"Because these actions are initiated by a user, robots.txt rules may not apply."*
A Anthropic documenta os três agentes e aceita User-agent, Disallow e Crawl-delay (página oficial de crawlers, atualizada em 07/04/2026). A Perplexity publica as faixas de IP em perplexitybot.json e perplexity-user.json, o que permite verificação por IP reverso quando alguém falsifica o user-agent.
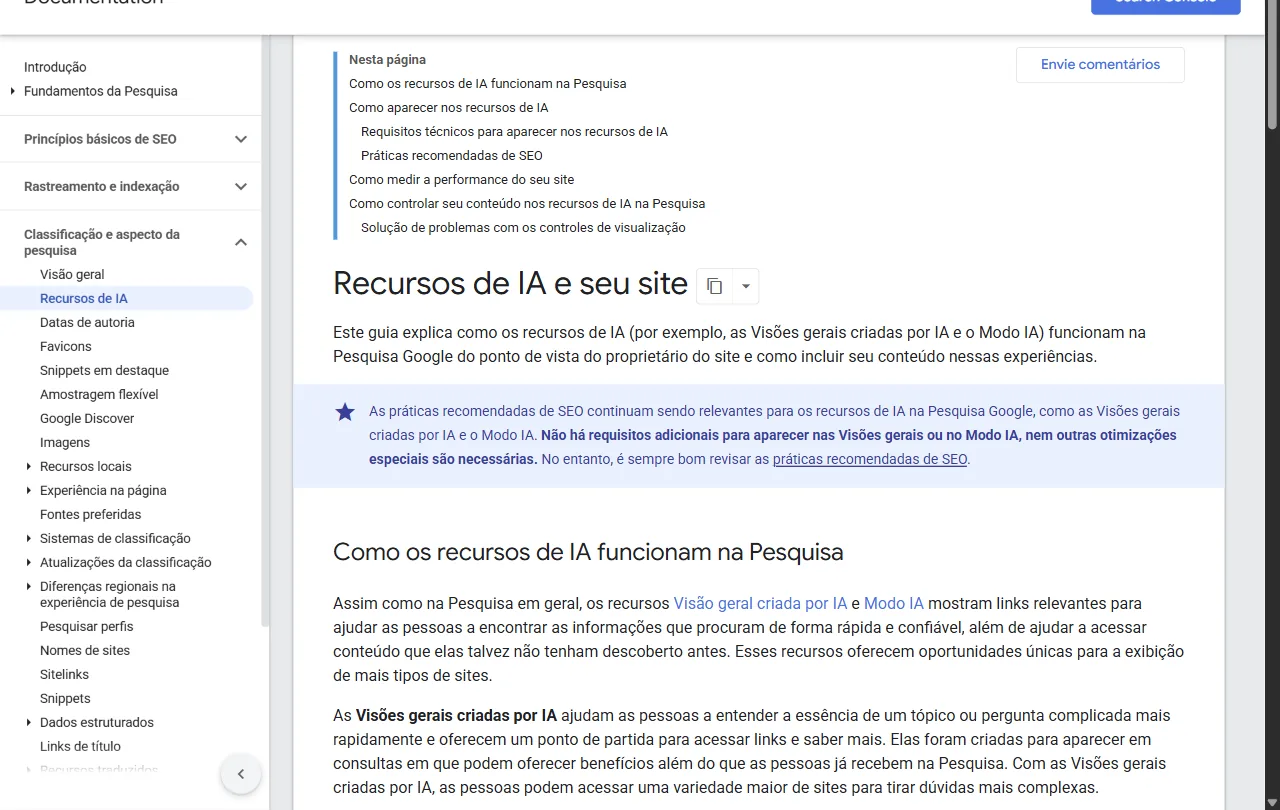
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: requisitos de elegibilidade e limites de aparição nas experiências de IA.
# robots.txt do Radar de Preço de Combustível
# Intenção declarada: "não me treine, mas me cite".
# O mecanismo (três funções distintas) é consenso documentado.
# A escolha abaixo é editorial e precisa ser aprovada pelo dono do site.

# --- treino: negado ---
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

# --- índice de busca: permitido (é daqui que vem a citação) ---
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# --- acionado pelo usuário: permitido (e pode ignorar estas regras por design) ---
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

User-agent: Perplexity-User
Allow: /

# --- buscador tradicional ---
User-agent: Googlebot
Allow: /
Disallow: /api/

# --- padrão para o resto ---
User-agent: *
Allow: /
Disallow: /api/
Crawl-delay: 2

Sitemap: https://radar-combustivel.example.br/sitemap-index.xmlTrês limites precisam estar escritos no relatório, porque o cliente vai achar que comprou um bloqueio:
-- É pedido, não controle. O cumprimento é voluntário e não impede acesso tecnicamente.
-- Agentes acionados pelo usuário podem ignorá-lo legitimamente, e a própria OpenAI documenta isso.
-- Alguns operadores desrespeitam. A Cloudflare registrou crawlers de IA operando enquanto frequentemente ignoram diretivas de robots.txt (post de 28/08/2025 sobre tráfego de crawler por propósito e indústria).
Defesa real, quando o requisito é impedir mesmo, exige bloqueio em nível de rede ou WAF com verificação por faixa de IP publicada. Vender robots.txt como proteção é o mesmo erro de vender uma placa de "não entre" como fechadura.
Dito isso, o vocabulário melhorou. A Content Signals Policy, anunciada pela Cloudflare em 24/09/2025, é a primeira vez que se separa indexar de usar como insumo de resposta. O vocabulário tem três sinais declarados no próprio robots.txt:
-- search: índice tradicional com hyperlinks e trechos curtos, excluindo resumos gerados por IA.
-- ai-input: uso em tempo real dentro de respostas generativas.
-- ai-train: treino e fine-tuning.
Quando o recurso é ativado, o padrão da Cloudflare é search=yes e ai-train=no, e mais de 3,8 milhões de domínios já operam com o robots.txt gerenciado. A sintaxe entra como cabeçalho do grupo:
User-agent: *
Content-Signal: search=yes, ai-train=no
Allow: /
Continua sendo declaração voluntária. O que mudou é que agora existe vocabulário para dizer a coisa certa. Material que não cobre isso está quase um ano atrasado.
Ver como texto
Composição das requisições a arquivos llms.txt em maio de 2026, separada em dois grupos. Quem não é motor de IA domina: ferramentas de auditoria de SEO com 21,7 por cento, bots não identificados com 14,9 por cento e crawlers gerais com 13,1 por cento. Os bots de IA aparecem no rodapé da lista: GPTBot com 4,51 por cento, bots de retrieval de IA com 1,1 por cento e ClaudeBot com 0,80 por cento. Abaixo, o dado de que 97 por cento dos arquivos não receberam nenhuma requisição no mês.
O llms.txt merece decisão, não implementação. A adoção subiu de 1,04% para 5,61% no top 10.000 entre julho de 2025 e junho de 2026 (levantamento de Casey Burridge com HTTP Archive). O consumo conta outra história: a análise de logs de 137.000 domínios feita pela Ahrefs em maio de 2026 encontrou 97% dos arquivos com zero requisições no mês, e entre as requisições existentes, ferramentas de auditoria de SEO respondem por 21,7%, bots não identificados por 14,9% e crawlers gerais por 13,1%, contra 1,1% de bots de retrieval de IA e 0,80% de ClaudeBot. O arquivo é lido majoritariamente por ferramentas de SEO checando se ele existe, o que é um ciclo de autovalidação da indústria.
A posição dos fornecedores fecha o caso. O Google diz que não usa, e a documentação foi atualizada em 15/06/2026 para afirmar explicitamente que llms.txt não é necessário para visibilidade ou ranking, com John Mueller comparando o arquivo à meta tag keywords. OpenAI e Anthropic não mencionam o arquivo em suas documentações oficiais de crawler. Alegações de que Anthropic ou Perplexity confirmaram suporte não têm primário e não devem ser repetidas.
A ironia diagnóstica revela o caso de uso legítimo: ChatGPT, Claude.ai, Gemini e os sites principais da OpenAI não têm llms.txt, enquanto as documentações técnicas de Anthropic, xAI, Perplexity, Mistral e Cohere têm. O arquivo é formato de entrega de documentação técnica a assistentes de código que buscam docs em tempo real e economizam tokens indo à página certa.
Veredito para o Radar: se o produto é uma API ou ferramenta de dev, faz sentido. Se é uma marca querendo ser citada em resposta de consumidor, o custo-benefício é próximo de zero. O Radar publica preço de combustível por município para leitor humano, então o arquivo fica de fora e a decisão vai registrada no runbook com a data e a fonte. Some a isso o mythbusting oficial do Google no guia de otimização generativa: não é preciso criar arquivos legíveis por máquina, não é preciso fatiar o conteúdo em pedaços pequenos e não é preciso escrever de forma especial para IA generativa.
Ver como texto
Duas medições de share of voice separadas por 6 pontos percentuais, 34 por cento em junho e 40 por cento em julho, cada uma com o intervalo observado em cinco execuções desenhado por cima: de 26 a 45 por cento em junho e de 31 a 52 por cento em julho. A faixa de sobreposição entre os dois intervalos mostra que a diferença não é declarável. Ao lado, a faixa de flip decisional de 9 a 28 por cento em execuções repetidas do mesmo prompt.
Medir presença em respostas de IA exige repetir observações e registrar o contexto. Uma resposta diferente pode ter várias origens:
- Geração e infraestrutura: amostragem, versão do modelo, processamento em lote e detalhes de execução podem mudar a saída. Não há base para declarar uma causa dominante em todos os serviços.
- Busca ativada ou não: uma resposta pode usar fontes recuperadas na hora ou conhecimento do modelo. Registre essa diferença quando a interface a revelar.
- Contexto: histórico, instruções, localização, idioma e data podem influenciar a resposta. O estudo *Dating the Model*, de 29/09/2026, encontrou sensibilidade à data em nove modelos e seis conjuntos de avaliação; isso demonstra um limite de reprodução, não uma taxa universal de variação em citações.
- Fonte e plataforma: índices, mecanismos de recuperação e versões mudam. Compare cada serviço em sua própria série.
- Interpretação da menção: nomear a marca, recomendá-la e citá-la como fonte são eventos diferentes. Classifique-os separadamente e revise exemplos ambíguos.
Para a liderança, a consequência é prática: uma captura isolada serve de exemplo, não de prova de crescimento. Um painel precisa declarar perguntas, repetições, datas e método de classificação.
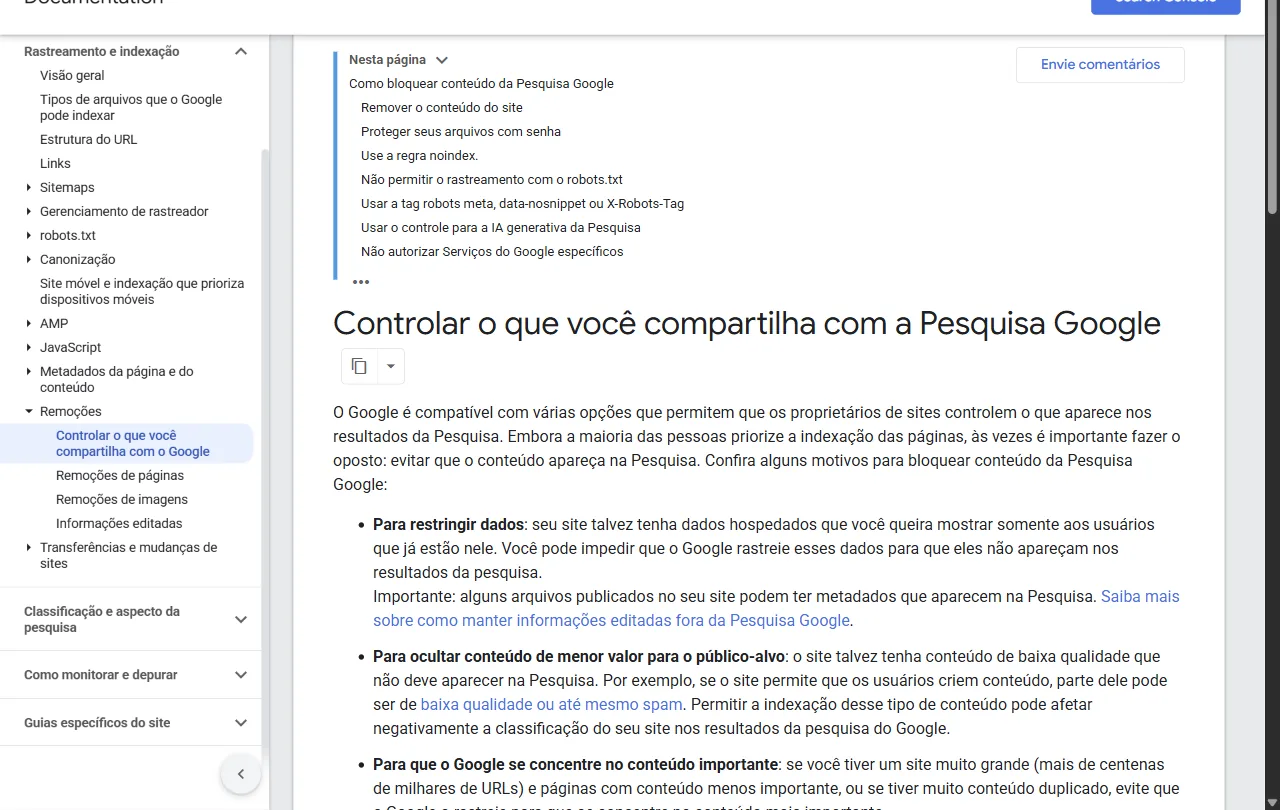
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: opções distintas para controlar acesso, indexação e exibição.
Existe uma sexta fonte de variação, e ela não depende de você: a decisão da plataforma. Em agosto de 2026 o Reddit quase sumiu das citações do ChatGPT. A Promptwatch mediu a participação caindo de 3,83% (18/07 a 07/08) para 0,52% (14 a 17/08), e a OtterlyAI registrou queda de 73,4% em 16 marcas. Nos produtos de IA do Google, a queda do Reddit foi gradual, e a OpenAI não publicou explicação.
A lição para quem aprova verba é dupla. Recomendação de presença em IA precisa ser feita por plataforma, nunca "para as IAs" no singular. E uma mudança brusca numa única engine, na mesma semana para todo o mercado, descreve a engine, não a sua página: registre o evento no diário do projeto antes de discutir causa.
// scripts/sov.mjs  ·  Node 20+, sem dependência externa.
// Agrega execuções repetidas de um conjunto FIXO de prompts e devolve
// share of voice com intervalo, mais o veredito de mudança declarável.
// uso: node scripts/sov.mjs

/** Converte "1011" em [true, false, true, true]. */
const linha = (s) => [...s].map((c) => c === "1");

/**
 * @param {boolean[][]} execucoes  execucoes[i][j] = marca citada no prompt j, execução i
 */
function shareOfVoice(execucoes) {
  const porExecucao = execucoes.map(
    (l) => (100 * l.filter(Boolean).length) / l.length,
  );
  const soma = porExecucao.reduce((a, b) => a + b, 0);
  return {
    n: porExecucao.length,
    media: soma / porExecucao.length,
    minimo: Math.min(...porExecucao),
    maximo: Math.max(...porExecucao),
  };
}

/** Mudança mínima detectável adotada como padrão, em pontos percentuais. */
const MDD_PP = 10;

function veredito(antes, depois) {
  if (antes.n < 5 || depois.n < 5) {
    return "INVALIDO: menos de 5 execucoes por prompt em pelo menos uma medicao.";
  }
  const delta = Math.abs(depois.media - antes.media);
  const sobrepoe =
    antes.minimo <= depois.maximo && depois.minimo <= antes.maximo;
  if (delta < MDD_PP || sobrepoe) {
    return `SEM MUDANCA DECLARAVEL: delta de ${delta.toFixed(1)} p.p., intervalos ${sobrepoe ? "sobrepostos" : "disjuntos"}.`;
  }
  return `MUDANCA DECLARAVEL: delta de ${delta.toFixed(1)} p.p. com intervalos disjuntos.`;
}

// 10 prompts fixos sobre preço de combustível por município, 5 execuções cada.
const junho = shareOfVoice([
  linha("1010010100"),
  linha("1110010100"),
  linha("1010011000"),
  linha("1111010110"),
  linha("1010010110"),
]);

const julho = shareOfVoice([
  linha("1110010110"),
  linha("1010011100"),
  linha("1111011110"),
  linha("1110010100"),
  linha("1111011010"),
]);

console.log("junho:", junho);
console.log("julho:", julho);
console.log(veredito(junho, julho));

// Saída:
// junho: { n: 5, media: 50, minimo: 40, maximo: 70 }
// julho: { n: 5, media: 62, minimo: 50, maximo: 80 }
// SEM MUDANCA DECLARAVEL: delta de 12.0 p.p., intervalos sobrepostos.- Etapa 1 de 8: Conjunto de prompts: 10 prompts fixos, versionados no repositório
Por quê: trocar o conjunto muda a métrica sozinho.
- Etapa 2 de 8: Execuções por prompt: 5, no mínimo, sempre
Por quê: n=1 mede ruído, não desempenho.
- Etapa 3 de 8: Relato: média mais intervalo (mínimo e máximo observados)
Por quê: média solta esconde a dispersão.
- Etapa 4 de 8: Mudança mínima detectável: 10 pontos percentuais E intervalos disjuntos
Por quê: o flip decisional vai de 9% a 28%.
- Etapa 5 de 8: Engines: reportadas separadas, nunca agregadas
Por quê: Jaccard cross-superfície abaixo de 0,2.
- Etapa 6 de 8: Sentimento: fora do painel
Por quê: vira ~6,7x mais que a menção.
- Etapa 7 de 8: Cadência: quinzenal, sempre no mesmo dia da semana
Por quê: o dado da ANP muda toda sexta-feira.
- Etapa 8 de 8: Fonte de primeira parte: Bing AI Performance e relatório de IA do Search Console
Por quê: são os únicos dados que não vêm de amostragem.
Ver como texto
- Conjunto de prompts: 10 prompts fixos, versionados no repositório: Por quê: trocar o conjunto muda a métrica sozinho.
- Execuções por prompt: 5, no mínimo, sempre: Por quê: n=1 mede ruído, não desempenho.
- Relato: média mais intervalo (mínimo e máximo observados): Por quê: média solta esconde a dispersão.
- Mudança mínima detectável: 10 pontos percentuais E intervalos disjuntos: Por quê: o flip decisional vai de 9% a 28%.
- Engines: reportadas separadas, nunca agregadas: Por quê: Jaccard cross-superfície abaixo de 0,2.
- Sentimento: fora do painel: Por quê: vira ~6,7x mais que a menção.
- Cadência: quinzenal, sempre no mesmo dia da semana: Por quê: o dado da ANP muda toda sexta-feira.
- Fonte de primeira parte: Bing AI Performance e relatório de IA do Search Console: Por quê: são os únicos dados que não vêm de amostragem.
Ative o AI Performance do Bing Webmaster Tools (preview público desde 10/02/2026) no Radar antes de contratar qualquer ferramenta paga. É a única fonte de primeira parte que conta citações: total de citações, média de páginas citadas, amostra de grounding queries e atividade por URL, ampliado em junho de 2026 com intents, tópicos, citation share e comparação.
O conceito que muda a sua cabeça é grounding query, definida pela Microsoft como as frases-chave que a IA usou ao recuperar o conteúdo referenciado nas respostas. Isso é o que a camada de retrieval enviou, não o que o usuário digitou. Você não otimiza para o prompt do usuário: otimiza para a query de grounding derivada dele. O query fan-out do Google (decompor a consulta em variantes e sintetizar) é o mesmo modelo mental, com a ressalva de que a evidência ali é de patente (US11663201B2) e não de documentação de produto, então trate como modelo mental e não como fato operacional.
No Google, o equivalente de primeira parte chegou mais tarde e mais magro: o relatório de desempenho em IA generativa do Search Console, liberado para todos os sites em 31/08/2026, mostra impressões em AI Overviews e AI Mode, sem cliques e sem consultas. Como transformá-lo em painel semanal por grupo de páginas está em [Medir a presença do acervo nas respostas de IA](#medir-acervo-nas-respostas-de-ia).
Um dado da Ahrefs de 02/03/2026, sobre 863.000 palavras-chave e 4 milhões de URLs, reposiciona toda a estratégia programática: apenas 38% das páginas citadas em AI Overviews apareciam no top 10 orgânico da mesma consulta, com 31,2% vindo das posições 11 a 100 e 31,0% de além da posição 100. O estudo da mesma casa em julho de 2025 encontrava 76% no top 10, e o fan-out é apontado como parte da explicação. A implicação para o Radar é direta: a página de Campinas não precisa rankear no top 10 de "preço da gasolina", precisa ser a melhor resposta de uma subconsulta específica. Isso justifica granularidade apenas quando cada página responde a uma subconsulta com dado que as outras não têm, o que é exatamente o gate de [Decidir se o projeto de páginas merece investimento](#gate-do-dado-proprio).
Sobre CTR, apresente ao cliente como controvérsia aberta, porque as métricas em disputa são diferentes. A Pew mediu clique em resultado tradicional em 8% das visitas com resumo de IA contra 15% sem, e clique dentro do resumo em 1% (dados de março de 2025). A Ahrefs mediu -58,0% de CTR na posição 1 comparando dezembro de 2023 com dezembro de 2025. O Google, em agosto de 2025, afirmou pela voz de Liz Reid que o volume total de cliques orgânicos permanece relativamente estável e que a qualidade média do clique subiu, sem publicar os dados. E o dado que quase ninguém cita: o CTR caiu também nas consultas sem AI Overview, de 0,076 para 0,039. Atribuir tudo aos resumos é erro de leitura.
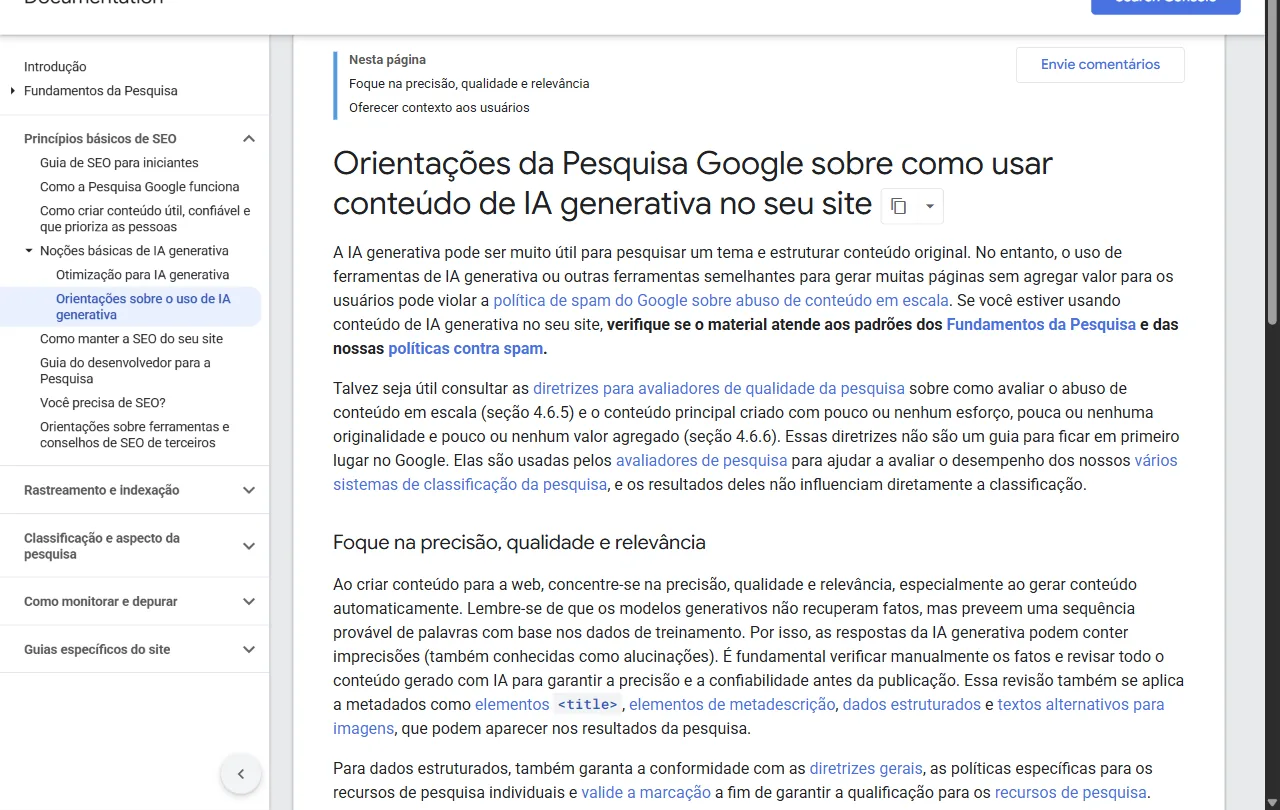
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: orientação para conferir precisão, relevância e conteúdo gerado.
A avaliação da PwC publicada em 07/05/2026 (arXiv 2605.06635) mediu acurácia factual de citação entre 39% e 77% nos modelos de fronteira e entre 24% e 51% nos open-source. O achado que assusta: quando a profundidade de busca vai de 2 para 150 tool calls, a acurácia factual cai cerca de 42% enquanto as métricas de superfície (link funciona, tópico é relevante) permanecem estáveis. Traduzindo para o Radar: o motor pode citar a sua página de Campinas e atribuir a ela um preço que você nunca publicou. Isso abre uma segunda frente de monitoramento, de fidelidade e não apenas de presença, e é a única métrica desta aula que tem consequência jurídica de verdade quando o dado é preço.
Antes de aprovar o próximo relatório de visibilidade em IA, faça quatro perguntas a quem o assina. Quantas execuções por prompt sustentam cada número, e qual é o intervalo? Qual robô foi bloqueado no robots.txt, e em qual das três funções ele está? Qual estágio do pipeline a tática vendida ataca, e com que evidência fora de um contexto fixo? Se a proposta inclui llms.txt, o produto é documentação técnica para assistentes de código ou site de consumidor? Resposta vaga em qualquer uma delas devolve o relatório para refazer.
O guia abaixo serve ao CMO que precisa separar investimento com mecanismo de promessa sem fonte antes de renovar contrato com agência ou ferramenta. Ele destrava a decisão de quanto gastar em GEO e com que régua cobrar o resultado.
Guia de implementação: montar a medição honesta de presença em IA
Seis passos, e nenhum deles exige ferramenta paga para começar.
Passo 1: Classifique cada robô de IA pela função
Treino, índice de busca e acionado pelo usuário recebem decisões separadas, aprovadas pelo dono do site.
Deu certo quando: O robots.txt tem um comentário por grupo dizendo a intenção e quem aprovou.
Erro comum: Bloquear OAI-SearchBot querendo evitar treino e sair das respostas com citação.
Passo 2: Ative as duas fontes de primeira parte
AI Performance no Bing Webmaster Tools e relatório de IA generativa no Search Console, na mesma semana.
Deu certo quando: Os dois relatórios mostram dados do site e entram no painel mensal.
Erro comum: Contratar ferramenta de monitoramento antes de olhar o que é gratuito.
Passo 3: Escreva o protocolo de medição por prompt
Dez prompts fixos e versionados, cinco execuções cada, mudança mínima de 10 pontos com intervalos disjuntos.
Deu certo quando: O protocolo está datado e aprovado antes da primeira coleta.
Erro comum: Trocar prompts entre medições e chamar a diferença de resultado.
Passo 4: Reporte cada engine separada e mantenha o diário de eventos
Mudanças de plataforma, como a queda do Reddit no ChatGPT em agosto de 2026, entram no diário com data.
Deu certo quando: Toda variação brusca do painel tem evento de plataforma verificado ou é tratada como ruído.
Erro comum: Somar engines numa média única de visibilidade.
Passo 5: Confira a fidelidade das citações
Uma amostra mensal de respostas que citam o site é conferida contra o dado publicado.
Deu certo quando: Cada citação da amostra tem o número conferido e o erro registrado.
Erro comum: Medir só presença e ignorar citação com dado errado.
Passo 6: Registre no runbook a decisão sobre llms.txt
Documentação técnica para assistentes de código justifica o arquivo; site de consumidor não.
Deu certo quando: A decisão tem data, fonte e responsável.
Erro comum: Publicar o arquivo porque o concorrente publicou.
No fim você tem: Um painel de presença em IA com intervalo, separado por engine, ancorado em fontes de primeira parte e defensável diante do conselho.
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Classificar robôs por função | Analista de SEO, com aprovação do CMO | Meio dia; sem custo de licença | robots.txt comentado por função e aprovado por escrito |
| Ativar fontes de primeira parte | Analista de SEO | Duas horas; ferramentas gratuitas | Bing AI Performance e relatório de IA do Search Console com dados do site |
| Protocolo por prompt | Analista de SEO com apoio de dados | Um dia para escrever; meio dia por coleta quinzenal | Protocolo datado no repositório antes da primeira coleta |
| Engines separadas e diário | Analista de SEO | Uma hora por semana | Nenhuma média entre engines no painel; diário com eventos datados |
| Fidelidade das citações | Analista de conteúdo, com o dono do dado | Meio dia por mês | Amostra mensal conferida e erros registrados |
| Decisão sobre llms.txt | CMO | Uma hora | Registro no runbook com data e fonte |
Guia prático: glossário de infoproduto para busca e respostas de IA. Escola on-line, curso e mentoria costumam ter um vocabulário próprio, e o glossário é o acervo programático mais barato que existe: uma página por termo, gerada do material das aulas. Ele funciona quando cada termo tem definição curta no topo, exemplo do próprio curso e ligação para a aula que aprofunda.
A página do Google sobre recursos de IA diz que não há arquivo, marcação ou schema especial para aparecer em AI Overviews ou no Modo IA. A marcação DefinedTerm descreve o termo para quem lê dados estruturados, mas não substitui a definição no texto.
Caso 4: glossário de infoproduto gerado do material das aulas
Seis passos para a equipe de conteúdo de uma escola on-line. O registro é a lista de termos que já aparecem nas aulas, com o trecho em que cada um é explicado.
Passo 1: Extraia os termos das transcrições e apostilas
Fique com os termos que o aluno pergunta no suporte ou na comunidade, não com toda palavra técnica.
Deu certo quando: Cada termo tem pelo menos uma aula que o explica e uma dúvida real de aluno.
Erro comum: Gerar mil termos de uma lista da internet, sem aula própria por trás.
Passo 2: Escreva a definição em até duas frases no topo
A definição responde à pergunta "o que é" antes de qualquer contexto, com o exemplo vindo do curso.
Deu certo quando: Lida sozinha, a primeira frase já serve como resposta completa.
Erro comum: Abrir com história ou propaganda do curso e empurrar a definição para o fim.
Passo 3: Acrescente o que só a escola tem
Exemplo resolvido da aula, erro comum dos alunos e a ligação para o módulo que aprofunda.
Deu certo quando: Duas páginas de termo sorteadas não podem ser fundidas sem perda.
Erro comum: Definição reescrita por IA a partir de outros glossários, sem nada do curso.
Passo 4: Marque cada termo com DefinedTerm e o glossário com DefinedTermSet
name e description saem do mesmo campo da definição visível; inDefinedTermSet aponta para a página do glossário.
Deu certo quando: A marcação passa no validador do schema.org sem erro.
Erro comum: Esperar resultado avançado do Google, que não existe para esse tipo.
Passo 5: Não crie página para cada variação de pergunta
"O que é", "para que serve" e "como funciona" do mesmo termo cabem numa página só.
Deu certo quando: Existe uma página por termo, com as variações respondidas em seções.
Erro comum: Três páginas quase iguais por termo, o padrão de conteúdo em escala que o Google pune.
Passo 6: Meça presença em IA pelo grupo do glossário
Use o painel por grupo de páginas do capítulo "Medir a presença do acervo nas respostas de IA".
Deu certo quando: O grupo do glossário aparece com citações e com cliques para as aulas ligadas.
Erro comum: Medir só o tráfego do glossário e ignorar a inscrição no curso, que é a etapa que paga o projeto.
No fim você tem: Um glossário que nasce das aulas, responde no topo e leva o leitor para a etapa seguinte do funil.
Coordenadora de conteúdo de uma escola on-line de finanças pessoais com 6 cursos
Infoproduto e educação on-line
Dor
O blog tinha 40 artigos longos e nenhuma página que respondesse em uma frase ao que é um termo como "marcação a mercado", dúvida frequente no suporte.
Solução
A equipe tirou 180 termos das transcrições, escreveu definição de duas frases com exemplo da aula, ligou cada termo ao módulo correspondente e marcou o glossário com DefinedTerm.
Resultado do exemplo
Em 90 dias, o glossário respondia por um terço das visitas orgânicas e era a origem mais frequente de quem abria a página de inscrição a partir da busca.
Custo estimado no exemplo: Três semanas de uma redatora, com revisão do professor de cada curso.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Peça hoje a quem opera o acervo o robots.txt atual e confira, grupo a grupo, se algum robô de índice de busca está bloqueado. Em 15 dias, exija o protocolo de medição aprovado e a primeira coleta com cinco execuções por prompt e intervalo declarado; sem isso, nenhum número de visibilidade entra na apresentação ao conselho.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSEO e GEO para quem decide
- Consulte um termo e veja como usá-losugerido pelo grafoApresenta os conceitos “Content-Signal”, “ClaudeBot” e “OAI-SearchBot”, usados em “Avaliar o que favorece a presença nas respostas de IA”.
- Organize a página para responder à dúvida do clientesugerido pelo grafoApresenta o conceito “llms.txt”, usado em “Avaliar o que favorece a presença nas respostas de IA”.
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta o conceito “Robots.txt”, usado em “Avaliar o que favorece a presença nas respostas de IA”.
- SEO e GEO para quem decideEtapa 2: abrir o site aos robôs certosExaminar conexões de Etapa 2: abrir o site aos robôs certos
- Digital PR e reputaçãoSaber como cada IA escolhe as fontes que citaExaminar conexões de Saber como cada IA escolhe as fontes que cita
- Gestão de Projetos GEOO que a equipe controla: robôs, página e a primeira semanaExaminar conexões de O que a equipe controla: robôs, página e a primeira semana
- GEO e Knowledge GraphO site feito por IA que o robô de IA não lêExaminar conexões de O site feito por IA que o robô de IA não lê
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.