Vídeo com IA: Claude Code, Codex e ElevenLabs · Capítulo 13 de 25 · 26 min
Gerar storyboard e miniaturas com gpt-image no lugar do Sora
Gere quadros-chave e miniaturas pela Image API com a mesma personagem em todas as cenas do vídeo e migre o gpt-image-1 antes de ele sair do ar em 23/10/2026.
Este capítulo faz parte do curso gratuito Vídeo com IA: Claude Code, Codex e ElevenLabs.
Desde que o Sora e a Videos API saíram do ar em 24/09/2026 (o mapa do que mudou está na aula 1), o que a OpenAI oferece para vídeo é imagem: o gpt-image-2.5-flare e o gpt-image-2.5-sunburst, lançados em 08/09/2026, servem para o storyboard (a sequência de quadros-chave na ordem do roteiro), para o quadro-chave (a imagem que define como uma cena deve parecer, como o esboço do ilustrador antes de animar) e para a miniatura. E há um segundo prazo: o gpt-image-1 sai do ar em 23/10/2026, a 11 dias de 12/10/2026.
Gerar imagem é a parte fácil. O que custa caro é a personagem mudar de rosto entre o quadro 2 e o quadro 5, porque aí o storyboard não serve de referência para o modelo de vídeo e você paga para gerar tudo de novo. A própria documentação admite que a consistência de personagem pode falhar. Com uma folha de personagem como primeira referência em cada quadro, a identidade se mantém e o custo de cada imagem fica registrado.
Nesta aula você gera a folha da personagem e um quadro por cena a partir do cenas.json da aula 12, corrige quadros fora de identidade, monta a miniatura, migra o gpt-image-1 e fecha um rascunho animado com narração que o Claude revisa.
Gerar a folha de personagem e os quadros com referência
Os dois modelos 2.5 respondem em POST /v1/images/generations (gerar do zero) e POST /v1/images/edits (editar a partir de imagens de referência, várias de uma vez, com máscara opcional de canal alfa). O flare é o rápido do dia a dia; o sunburst tem precisão de edição. Os tamanhos recomendados são 1024x1024, 1536x1024 e 1024x1536, e a API aceita medida livre em múltiplos de 16, com proporção entre 1:3 e 3:1, borda de até 3840 px e de 655.360 a 8.294.400 pixels. Por isso o 16:9 exato é 1536x864 e o 9:16 é 864x1536; 1920x1080 falha, porque 1080 não é múltiplo de 16. A qualidade vai de low a max, e escreva-a sempre: sem quality explícito, os modelos 2.5 respondem em low onde o gpt-image-1 respondia em high. O background: "transparent" exige PNG ou WebP. O movimento não sai daqui: ele vem dos modelos comparados na aula 19, e o storyboard serve de referência para eles.
Dentro do Codex, a skill $imagegen usa o gpt-image-2 e consome a cota do plano de 3 a 5 vezes mais rápido que uma interação comum: na tabela de créditos de 12/10/2026, cada milhão de tokens de imagem gerada custa 750 créditos do plano. Para lote, gere pela API com OPENAI_API_KEY.
A consistência tem duas metades. A primeira é texto: a mesma descrição física, a mesma luz e a mesma paleta em todos os prompts. A segunda é imagem: uma folha de personagem (a personagem em três ângulos sobre fundo neutro) que entra como primeira referência em toda chamada de edição. Peça "sem texto, sem logotipos" em todos os quadros, porque texto dentro da imagem ainda sai impreciso; o título entra depois, no Remotion ou no HyperFrames. A técnica de marcar o que a edição deve preservar é a mesma da aula sobre editar uma imagem preservando as escolhas aprovadas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Quadro gerado do zero ou com a folha de personagem
Gerar cada quadro do zero
Coluna a evitar
- Rosto, cabelo e idade mudam de uma cena para outra
- Descrição física reescrita a cada prompt, com pequenas variações
- Correção feita quadro a quadro, pagando saída de novo
- Storyboard que não serve de referência ao modelo de vídeo
Editar com a folha como primeira referência
Coluna recomendada
- A mesma Rafa em todas as cenas, ancorada na mesma imagem
- Descrição física fixa numa constante repetida em todo prompt
- Só o quadro fora de identidade volta, pelo sunburst
- Quadros prontos para guiar o movimento nas aulas 20 e 21
Desenhar o storyboard em seis painéis com continuidade
Seis painéis cobrem um corte de 60 segundos sem sobra: abertura, ingrediente, ação principal, montagem, finalização e prato servido. O que faz deles um storyboard, e não seis imagens soltas, é o fio que passa de um painel ao outro. Escreva no prompt_quadro de cada cena o que ela herda da anterior: a mesma luz da janela à esquerda, o mesmo avental, o objeto que estava na mão e a direção do olhar. Se o painel 3 termina com a frigideira à direita, o painel 4 começa com ela no mesmo lugar.
Antes do lote, prove a identidade com uma sequência curta no espírito do plano-sequência de transformação, técnica recorrente no acervo de prompts de vídeo do Vibehub Academy consultado em 12/10/2026: quatro quadros com a personagem parada, rosto e corpo sempre visíveis e em foco, a câmera dando a volta em passos iguais (frente, três quartos, perfil, três quartos do outro lado) e só o figurino trocando. Se o rosto muda quando a roupa muda, a folha ainda não segura a identidade; reforce a descrição física antes dos seis painéis.
Desde 06/10/2026, a Decisions API, em beta, faz a triagem barata dessa identidade: uma pergunta predicate ao gpt-6-luna ("a pessoa da segunda imagem é a mesma da primeira?"), com a folha e o quadro em base64, devolve uma probabilidade de 0 a 1 por US$ 0,10 por milhão de tokens de entrada, sem cobrança de saída. Escolha um limiar, como 0,8, e mande para o sunburst o quadro que ficar abaixo antes da revisão do Claude. Está pronto quando os seis painéis, lidos em ordem, contam a receita sem legenda e a mesma Rafa aparece em todos.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Quadros com a mesma personagem, em Python e em curl
Python
# scripts/storyboard_consistente.py - roda na raiz video-ia; folha de personagem + um quadro por cena, custo por imagem em CSV
# pip install openai ; OPENAI_API_KEY no ambiente (nunca no código)
import base64, csv, json, os
from openai import OpenAI

client = OpenAI()
MODELO = os.environ.get("MODEL_IMAGE", "gpt-image-2.5-flare")  # id no .env, não no código
os.makedirs("storyboard", exist_ok=True)
os.makedirs("custos", exist_ok=True)

# Metade da consistência é texto: a mesma descrição física em TODOS os prompts
PERSONAGEM = ("Rafa, cozinheira brasileira de 35 anos, cabelo cacheado preso, "
              "avental de linho azul-cobalto, brincos de argola dourados")
CENARIO = ("cozinha clara em Recife, azulejos brancos com desenho português azul-cobalto, "
           "bancada de madeira clara, luz natural de janela à esquerda, paleta quente")
REGRAS = "fotografia editorial de culinária, sem texto, sem logotipos"

# Preços por 1M de tokens em 12/10/2026 (iguais no flare e no sunburst; sem cache pelos endpoints /v1/images)
US_TEXTO_IN, US_IMAGEM_IN, US_IMAGEM_OUT = 5 / 1e6, 8 / 1e6, 30 / 1e6

def custo(u):
    """Não há preço fixo por imagem: o custo sai do usage de cada resposta."""
    det = getattr(u, "input_tokens_details", None)
    img_in = (getattr(det, "image_tokens", 0) or 0) if det else 0
    return (u.input_tokens - img_in) * US_TEXTO_IN + img_in * US_IMAGEM_IN + u.output_tokens * US_IMAGEM_OUT

def salvar(resp, caminho, planilha):
    with open(caminho, "wb") as f:
        f.write(base64.b64decode(resp.data[0].b64_json))
    u = resp.usage
    planilha.writerow([caminho, u.input_tokens, u.output_tokens, f"{custo(u):.4f}"])
    print(caminho, f"US$ {custo(u):.4f}")

FOLHA = "storyboard/personagem.png"
cenas = json.load(open("storyboard/cenas.json", encoding="utf-8"))["cenas"]

with open("custos/imagens.csv", "a", newline="", encoding="utf-8") as f_csv:
    planilha = csv.writer(f_csv)

    # 1) Folha de personagem: três ângulos, fundo neutro; aprove antes do lote
    if not os.path.exists(FOLHA):  # idempotente: não paga duas vezes
        r = client.images.generate(
            model=MODELO, size="1024x1024", quality="high", output_format="png",
            prompt=f"Folha de personagem: {PERSONAGEM}, de frente, de perfil e de três quartos, "
                   f"fundo cinza neutro. {REGRAS}.")
        salvar(r, FOLHA, planilha)

    # 2) Um quadro por cena, sempre com a folha como PRIMEIRA referência
    for c in cenas:
        destino = f"storyboard/q{c['id']:02d}.png"
        if os.path.exists(destino):
            continue
        with open(FOLHA, "rb") as ref:
            r = client.images.edit(
                model=MODELO,
                image=[ref],
                prompt=("Mantenha a pessoa da imagem de referência: mesmo rosto, cabelo, avental e brincos. "
                        f"{PERSONAGEM}. {c['prompt_quadro']}. {CENARIO}. {REGRAS}."),
                size="864x1536",    # 9:16 em múltiplos de 16; o 16:9 é "1536x864"
                quality="medium",   # low para rascunho; high, xhigh ou max só na peça final
                output_format="png",
            )
        salvar(r, destino, planilha)
Rodar de novo pula a folha e os quadros que já existem, no mesmo espírito do pipeline idempotente da aula 23. Apague só o quadro que quer refazer.
curl
#!/usr/bin/env bash
# scripts/refazer_quadro.sh - corrige um quadro fora de identidade e gera a miniatura 16:9
# uso (na raiz video-ia): bash scripts/refazer_quadro.sh storyboard/q04.png "Rafa enrola o bolo de rolo na bancada, close nas mãos"
set -euo pipefail
QUADRO="$1"; INSTRUCAO="$2"

# 1) A folha de personagem vai como PRIMEIRA referência; o quadro ruim, como segunda
curl -s https://api.openai.com/v1/images/edits \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F model="gpt-image-2.5-sunburst" \
  -F "image[]=@storyboard/personagem.png" \
  -F "image[]=@$QUADRO" \
  -F prompt="Refaça a segunda imagem com a mesma pessoa da primeira (rosto, cabelo, avental, brincos). $INSTRUCAO. Mesma luz e paleta. Sem texto, sem logotipos." \
  -F size="864x1536" \
  -F quality="high" \
  | tee /tmp/resposta.json | jq -r '.data[0].b64_json' | base64 --decode > "${QUADRO%.png}_v2.png"
jq '.usage' /tmp/resposta.json   # tokens de entrada e saída: é daqui que sai o custo

# 2) Miniatura do vídeo longo: 16:9 exato em múltiplo de 16, terço direito vazio para o título
curl -s https://api.openai.com/v1/images/edits \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -F model="gpt-image-2.5-sunburst" \
  -F "image[]=@storyboard/personagem.png" \
  -F "image[]=@marca/paleta.png" \
  -F prompt="Miniatura de YouTube 16:9 com a mesma pessoa da primeira imagem servindo cartola numa mesa clara. Aplique a paleta da segunda imagem. Deixe o terço direito vazio para o título. Não adicione texto." \
  -F size="1536x864" \
  -F quality="high" \
  | jq -r '.data[0].b64_json' | base64 --decode > storyboard/thumb.png
Use curl quando o quadro errado é um só e você quer corrigir na hora. A ordem das referências importa: a folha de personagem vem sempre primeiro, e o prompt diz qual imagem manda em quê.
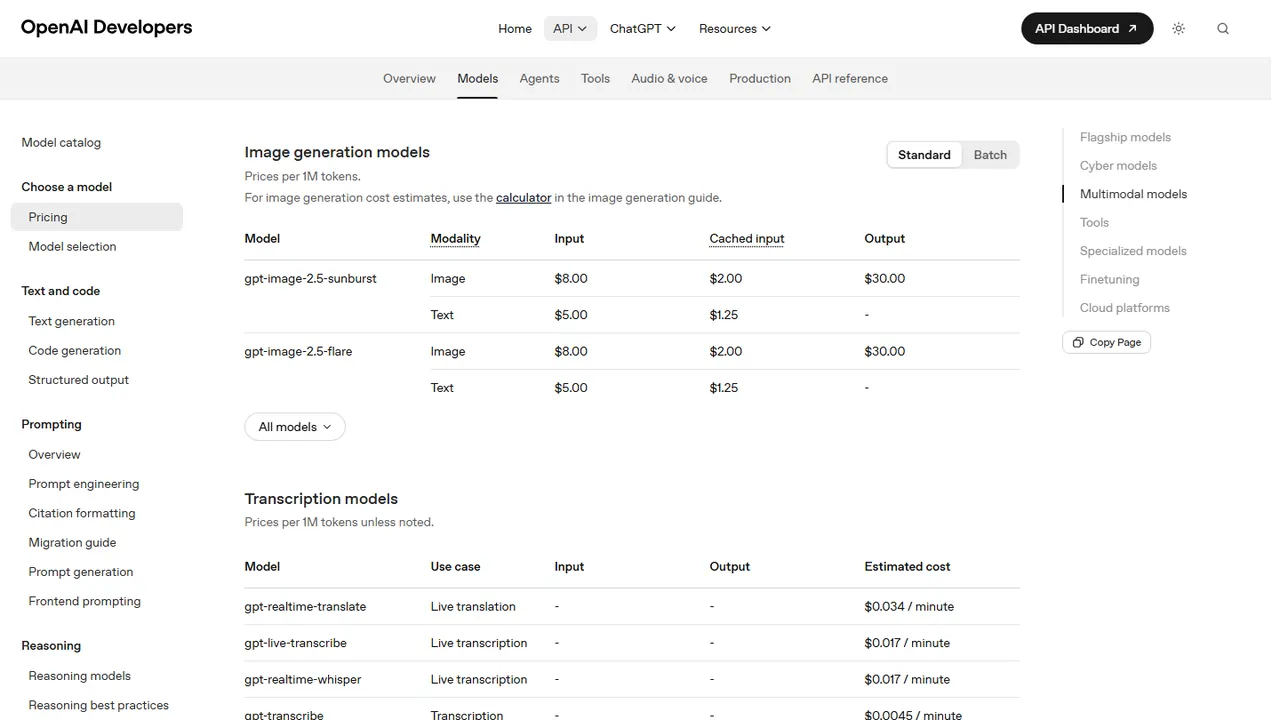
Não existe preço fixo por imagem nos modelos 2.5. Os dois cobram por token, com os mesmos valores do gpt-image-2: em 12/10/2026, US$ 8 por milhão de tokens de imagem na entrada, US$ 30 por milhão na saída e US$ 5 por milhão de tokens de texto. O preço de cache (US$ 1,25 por milhão de texto e US$ 2 de imagem) só vale para imagens geradas pela Responses API; pelos endpoints /v1/images, os únicos que a página do flare lista ao lado do Batch, vale o preço de tabela. O campo usage (os tokens de entrada e saída que a própria resposta informa) é a única fonte do custo real, e por isso os dois exemplos o gravam. No Batch, tudo sai pela metade; vale a pena quando o volume passa de dezenas de imagens por semana, como mostra a aula sobre o desconto de lote.
Para rascunho de enquadramento, use flare com quality="low" ou "medium"; para a miniatura ou um quadro que vai servir de referência ao modelo de vídeo, sunburst com "high" ou "xhigh". Se a personagem mudou em um quadro, refaça só ele pelo /v1/images/edits com a folha na frente; se mudou em todos, o prompt base está vago, e reescrever a descrição física sai mais barato que corrigir quadro a quadro. Acima de 2560x1440 o resultado é experimental. Em qualquer tamanho, um prompt complexo pode levar até 2 minutos, e a organização pode precisar passar pela verificação da OpenAI antes do primeiro uso dos modelos GPT Image.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Limites e prazos da API de imagem em outubro de 2026
clock Respeitar o limite de imagens por minuto
Desde 06/10/2026, a API tem três níveis de uso em vez de cinco: Build, Launch e Grow. No gpt-image-2.5-flare, eles aceitam 20, 150 e 250 imagens por minuto. Um storyboard de seis cenas cabe num minuto do nível Build; um lote de 40 quadros, não. Quando o tráfego sobe rápido demais, a resposta é um erro 429 com o código slow_down; quando o serviço está cheio, um 503 com server_is_overloaded. Os dois podem trazer o cabeçalho Retry-After, com os segundos de espera.
Repetir na hora piora, porque cada tentativa conta no mesmo minuto. Leia o Retry-After, espere esse tempo e tente de novo, no máximo três vezes; sem o cabeçalho, espere 2, 4 e 8 segundos. Se o lote passa do limite do seu nível, divida em blocos de 20 por minuto ou mande pelo Batch, pela metade do preço, quando o prazo permitir. Está certo quando um lote de 40 termina sem quadro faltando e o log mostra as esperas, não as falhas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
# scripts/gerar_com_espera.py - espera o tempo que a API pede em vez de repetir às cegas
import time
from openai import OpenAI, APIStatusError

client = OpenAI(max_retries=0)  # quem decide quando repetir é o laço abaixo

def com_espera(chamada, tentativas=3):
    for n in range(tentativas + 1):
        try:
            return chamada()
        except APIStatusError as erro:
            if erro.status_code not in (429, 503) or n == tentativas:
                raise
            cabecalho = erro.response.headers.get("retry-after")
            espera = float(cabecalho) if cabecalho else 2 ** (n + 1)  # 2, 4 e 8 s sem cabeçalho
            print(f"{erro.status_code}: esperando {espera:.0f} s (tentativa {n + 1})")
            time.sleep(espera)

# Uso no storyboard_consistente.py, com a qualidade sempre escrita:
# r = com_espera(lambda: client.images.edit(model=MODELO, image=[ref], prompt=p,
#                                          size="864x1536", quality="medium", output_format="png"))
workflow Migrar o gpt-image-1 antes de 23/10/2026
O gpt-image-1 sai do ar em 23/10/2026; o gpt-image-1-mini, o gpt-image-1.5 e o chatgpt-image-latest saem em 01/12/2026. O substituto indicado é a família 2.5. A troca é pequena se o id mora no .env, e trabalhosa se está espalhado pelo código. Ao trocar o id, fixe quality no código: integradores relataram em outubro de 2026 que a mesma requisição sem esse campo saía em high no gpt-image-1 e sai em low no flare e no sunburst. O script abaixo acha cada ocorrência, troca o id, aponta as chamadas sem qualidade e faz um teste em low, que já revela erro de verificação da organização antes do lote de verdade. Aproveite a troca para rever os tamanhos: a família 2.5 aceita medidas livres em múltiplos de 16, então quadros que antes saíam em 1536x1024 e eram cortados podem nascer em 1536x864.
Prazos dos modelos de imagem da OpenAI
- 08/09/2026Concluído
gpt-image-2.5 lançado
Flare (rápido) e Sunburst (edição), com qualidades xhigh e max.
- 12/10/2026Agora
Hoje: migre o código
Os ids antigos ainda respondem, e o primeiro prazo está a 11 dias.
- 23/10/2026Previsto
gpt-image-1 sai do ar
Chamadas com esse id passam a falhar.
- 01/12/2026Previsto
gpt-image-1-mini, 1.5 e chatgpt-image-latest saem
Mesmo destino: flare ou sunburst.
#!/usr/bin/env bash
# scripts/migrar_gpt_image_1.sh - gpt-image-1 sai em 23/10/2026; -mini, 1.5 e chatgpt-image-latest em 01/12/2026
set -euo pipefail
PADRAO='gpt-image-1(\.5|-mini)?|chatgpt-image-latest'

# 1) Onde os ids antigos aparecem (código, .env, workflows de CI)
grep -rnE "$PADRAO" --include='*.py' --include='*.ts' --include='*.js' --include='*.json' \
  --include='*.yml' --include='*.yaml' --include='.env*' . || echo "Nenhum id antigo encontrado"

# 2) Troca pelo flare, com cópia .bak de cada arquivo alterado (revise o diff antes de apagar)
grep -rlE "$PADRAO" --include='*.py' --include='*.ts' --include='*.js' --include='.env*' . \
  | xargs -r sed -i.bak -E "s/$PADRAO/gpt-image-2.5-flare/g"

# 3) Daqui em diante, o id mora só no .env
grep -q '^MODEL_IMAGE=' .env 2>/dev/null || echo 'MODEL_IMAGE=gpt-image-2.5-flare' >> .env

# 4) Sem quality explícito, a família 2.5 responde em low: liste os arquivos que não dizem a qualidade
grep -rlE 'gpt-image-2\.5' --include='*.py' --include='*.ts' --include='*.js' . | xargs -r grep -L 'quality' || true

# 5) Teste barato: confirma acesso, verificação da organização e formato da resposta
curl -s https://api.openai.com/v1/images/generations \
  -H "Authorization: Bearer $OPENAI_API_KEY" -H "Content-Type: application/json" \
  -d '{"model":"gpt-image-2.5-flare","prompt":"Panela de barro sobre mesa de madeira, luz natural, sem texto","size":"1024x1024","quality":"low"}' \
  | jq '{erro: .error.message, usage: .usage, tem_imagem: (.data[0].b64_json != null)}'
Montar o rascunho animado e revisar os quadros
Com os quadros prontos, um slideshow com a narração mostra o ritmo antes de qualquer gasto com movimento. O script abaixo lê a duração de cada cena no cenas.json e monta a lista de entrada do FFmpeg; os filtros e o ffprobe são os da aula 4. Os quadros 864x1536 sobem para 1080x1920 sem distorção, porque a proporção é a mesma. A narração vem da aula 15; enquanto ela não existe, use qualquer MP3 de teste em audio/narracao.mp3.
A revisão dos quadros aplica a rubrica de QA visual da aula 11, com um item a mais para o storyboard: a personagem difere de outro quadro em cabelo, roupa ou idade aparente. Passe os quadros em 864x1536, nunca em 4K: nos modelos Claude 4.7 e posteriores, o quadro 864x1536 entra inteiro por cerca de 1.700 tokens visuais (o pedaço de imagem que o modelo cobra como entrada), enquanto o 4K é reduzido para 2576x1449 e custa 4.784, quase o triplo, sem ganho para comparar cabelo, roupa e rosto da personagem.
#!/usr/bin/env bash
# scripts/slideshow.sh - quadros + narração, com a duração de cada cena vinda do cenas.json
set -euo pipefail
mkdir -p renders
LISTA=storyboard/lista.txt; : > "$LISTA"

# Lista do concat do FFmpeg: um arquivo e uma duração por cena (caminhos relativos à lista)
jq -r '.cenas[] | "\(.id) \(.duracao_s)"' storyboard/cenas.json | while read -r ID DUR; do
  printf "file 'q%02d.png'\nduration %s\n" "$ID" "$DUR" >> "$LISTA"
done
# O concat ignora a duração do último item se ele não se repetir no fim
tail -n 2 "$LISTA" | head -n 1 >> "$LISTA"

ffmpeg -y -f concat -safe 0 -i "$LISTA" -i audio/narracao.mp3 \
  -vf "scale=1080:1920,format=yuv420p" -r 30 -c:v libx264 -crf 20 \
  -c:a aac -b:a 192k -shortest -movflags +faststart renders/rascunho_storyboard_9x16.mp4

# Duração do vídeo deve ficar a até 0,5 s da narração
ffprobe -v error -show_entries format=duration -of csv=p=0 renders/rascunho_storyboard_9x16.mp4
ffprobe -v error -show_entries format=duration -of csv=p=0 audio/narracao.mp3
Feche o storyboard do Projeto 1 em oito passos
Rode numa sessão do Codex com network_access = true e aprovação on-request, porque estes passos chamam API paga.
Passo 1: Prepare o cenas.json
Cada cena precisa de `prompt_quadro` com personagem, ação, luz, o que herda do painel anterior e "sem texto, sem logotipos".
Deu certo quando: `jq '.cenas | length'` devolve o número de cenas.
Erro comum: Prompt sem a descrição física: os quadros saem com pessoas diferentes.
Passo 2: Gere e aprove a folha de personagem
Uma imagem `1024x1024` em `high`, com três ângulos e fundo neutro.
Deu certo quando: `storyboard/personagem.png` existe e você aprova a aparência.
Erro comum: Pedir o nome da marca escrito na imagem; o texto sai ilegível.
Passo 3: Gere os quadros com a folha como referência
Rode `python scripts/storyboard_consistente.py`.
Deu certo quando: `q01.png` a `q06.png` e uma linha de custo por imagem em `custos/imagens.csv`.
Erro comum: Usar `size="1920x1080"`; 1080 não é múltiplo de 16.
Passo 4: Corrija o quadro fora de identidade
`bash scripts/refazer_quadro.sh` com o sunburst e a folha na frente.
Deu certo quando: O quadro refeito mantém cabelo, avental e paleta.
Erro comum: Mandar só o quadro ruim, sem a folha; o modelo inventa outra pessoa.
Passo 5: Gere a miniatura
`1536x864`, `quality="high"`, terço direito vazio.
Deu certo quando: `thumb.png` com espaço livre para o título.
Erro comum: Usar `max` em rascunho e pagar saída cara sem necessidade.
Passo 6: Migre o gpt-image-1
Rode `bash scripts/migrar_gpt_image_1.sh` e revise o diff.
Deu certo quando: O `grep` não acha mais ids antigos e o teste devolve `tem_imagem: true`.
Erro comum: Trocar só o id e não escrever `quality`: o quadro sai em low.
Passo 7: Monte o rascunho animado
`bash scripts/slideshow.sh` com a narração.
Deu certo quando: As duas durações do `ffprobe` diferem no máximo 0,5 s.
Erro comum: Esquecer `yuv420p`; o MP4 não abre no celular.
Passo 8: Revise com o Claude e some o custo
Aplique a rubrica da aula 11 aos quadros e some a coluna de custo do CSV.
Deu certo quando: Tabela quadro, problema e gravidade, e o total em dólar anotado.
Erro comum: Mandar PNG em 4K, que custa quase o triplo em tokens visuais sem ganho para a revisão.
No fim você tem: Pasta storyboard/ com quadros aprovados da mesma personagem, miniatura, rascunho 9:16 com narração e custo somado por imagem.
Guia prático: miniatura no formato do YouTube, variações e quadros leves
A aula gerou a folha de personagem, os quadros e uma miniatura. Este guia leva a miniatura até o upload: três variações num pedido só, tamanho que o gpt-image entrega fora da faixa experimental, conversão para JPG abaixo do teto de 2 MB do celular e quadros de rascunho em WebP comprimido, para o acervo não pesar no repositório.
Funções, casos de uso e aplicações
Funções
Parâmetros do gpt-image 2.5 além do tamanho e da qualidade
| Função ou recurso | O que faz | Quando usar | Desde |
|---|---|---|---|
| n | Gera várias imagens no mesmo pedido; o padrão é uma | Três variações de miniatura para comparar antes de publicar | Referência de 12/10/2026 |
| partial_images (0 a 3) com streaming | Envia prévias parciais enquanto a imagem final é gerada | Conferir o enquadramento sem esperar até dois minutos por um prompt complexo | Referência de 12/10/2026 |
| output_format WebP ou JPEG com output_compression (0 a 100) | Entrega o arquivo já comprimido | Quadros de rascunho e galerias, que não precisam de PNG | Referência de 12/10/2026 |
| background: "transparent" | Fundo transparente, só em PNG ou WebP | Recorte da Rafa para sobrepor no Remotion ou no HyperFrames | Referência de 12/10/2026 |
| mask na Image API e input_image_mask na Responses API | Máscara com canal alfa, no mesmo formato e tamanho da primeira imagem, abaixo de 50 MB; o modelo se guia pelo prompt e trata o contorno como orientação | Trocar só o prato da mesa e manter a personagem | Referência de 12/10/2026 |
| Ferramenta image_generation com previous_response_id | Edição em várias rodadas na Responses API, com revised_prompt na saída | Ajustar a miniatura em conversa e guardar o prompt reescrito no log | 08/09/2026 |
| GPT Image 2.5 nos Flows da ElevenLabs | Gera o quadro no mesmo painel da voz, com aspect_ratio (padrão 16:9) e resolution 1K, 2K ou 4K | Equipe que monta a peça no app, sem script | 21/09/2026 |
Fonte: OpenAI, Image generation e changelog da API; ElevenLabs, changelog de 21/09/2026
Casos de uso
Carla, social media de uma rede de escolas de idiomas em Curitiba
Educação
Dor
Cada miniatura do canal leva uma tarde no editor de imagem e sai uma só, sem alternativa para comparar.
Solução
Um pedido ao sunburst com n=3, a folha da professora-personagem como primeira referência e o terço direito vazio; o título entra depois, no editor, sobre o JPG.
Resultado
Compare a taxa de cliques das miniaturas no YouTube Studio depois de duas semanas de cada vídeo no ar e guarde no log qual prompt gerou a vencedora.
Custo apurado: Cada pedido de miniatura cobra três saídas em high; o valor exato vem do campo usage da resposta.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Diego, designer de um instituto de cursos técnicos em Goiânia
Marketing digital
Dor
O mascote do instituto aparece em todos os vídeos de campanha, mas cada recorte é feito à mão a partir de um PNG com fundo.
Solução
Recortes gerados com background: "transparent" em WebP, a partir da folha do mascote, e sobrepostos na composição Remotion.
Resultado
Observe o tamanho da pasta de recortes e o tempo de montagem de cada peça nas próximas quatro campanhas.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Na prática
A Central de Ajuda do YouTube, na versão de 12/10/2026, recomenda 3840x2160 para a miniatura de vídeo, com largura mínima de 640 px, em JPG ou PNG, e limita o arquivo a 2 MB no envio pelo celular e 50 MB pelo computador. Como o gpt-image trata como experimental o que passa de 2560x1440, o script gera nesse tamanho (múltiplo de 16 e em 16:9 exato) e converte para JPG com o FFmpeg, que mantém o arquivo leve sem perder o que importa numa tela de celular.
# scripts/miniaturas.py - rode na raiz video-ia; OPENAI_API_KEY no ambiente
import base64, os, subprocess
from openai import OpenAI

client = OpenAI()
os.makedirs("storyboard/miniaturas", exist_ok=True)

with open("storyboard/personagem.png", "rb") as folha, open("marca/paleta.png", "rb") as paleta:
    r = client.images.edit(
        model="gpt-image-2.5-sunburst",
        image=[folha, paleta],                 # a folha vem sempre primeiro
        prompt=("Miniatura de YouTube 16:9 com a mesma pessoa da primeira imagem segurando "
                "um prato de cartola, expressão de surpresa, paleta da segunda imagem, "
                "terço direito vazio para o título. Sem texto, sem logotipos."),
        size="2560x1440",                     # 16:9 em múltiplos de 16, fora da faixa experimental
        quality="high",
        n=3,                                  # três variações no mesmo pedido
        output_format="png",
    )

for i, img in enumerate(r.data, 1):
    png = f"storyboard/miniaturas/v{i}.png"
    with open(png, "wb") as f:
        f.write(base64.b64decode(img.b64_json))
    jpg = png.replace(".png", ".jpg")
    # JPG de qualidade alta; o YouTube aceita JPG ou PNG, não WebP
    subprocess.run(["ffmpeg", "-v", "error", "-y", "-i", png, "-q:v", "3", jpg], check=True)
    kb = os.path.getsize(jpg) // 1024
    print(jpg, kb, "KB", "(acima de 2 MB não sobe pelo celular)" if kb > 2048 else "")

print("usage:", r.usage) # o custo sai daqui, como na aula# Nos quadros de rascunho, troque o output_format="png" por:
# output_format="webp", output_compression=80,
# e grave com a extensão .webp. O PNG fica só para a peça final.
# Para o slideshow da aula, o FFmpeg lê WebP do mesmo jeito (file 'q01.webp').Da folha de personagem à miniatura publicada
Passo 1: Confira a folha aprovada e a paleta
storyboard/personagem.png e marca/paleta.png existem.
Deu certo quando: As duas imagens abrem e a folha é a versão aprovada na aula.
Erro comum: Usar um quadro do storyboard como referência no lugar da folha.
Passo 2: Gere as três variações
python scripts/miniaturas.py numa sessão com o perfil de API.
Deu certo quando: Três JPG em storyboard/miniaturas/ e o usage impresso.
Erro comum: Pedir n=10 em max e pagar saída que ninguém vai olhar.
Passo 3: Escolha e aplique o título fora do modelo
O texto entra no editor ou no Remotion, sobre o terço vazio.
Deu certo quando: Título legível numa tela de celular a um braço de distância.
Erro comum: Pedir o título dentro da imagem gerada.
Passo 4: Suba o JPG e registre o prompt
Envie pelo YouTube Studio e anote no log qual variação foi publicada.
Deu certo quando: O arquivo sobe sem erro de tamanho e o log tem prompt, data e usage.
Erro comum: Tentar subir o PNG de vários MB pelo celular.
No fim você tem: Miniatura publicada a partir da mesma Rafa do storyboard, com custo e prompt registrados.
Armadilhas
Comece pelo formato que o YouTube aceita
Gere em 2560x1440, publique em JPG e guarde o PNG fora do repositório.
- O YouTube aceita JPG ou PNG; WebP fica para o site e os rascunhos.
- No YouTube, a miniatura sobe até 2 MB pelo celular e até 50 MB pelo computador.
- Acima de 2560x1440 o gpt-image é experimental: o 4K pode sair irregular.
- A máscara só orienta: o modelo segue o prompt e pode sair do contorno.
- PNG de miniatura e de quadro fica em armazenamento de objetos, fora do git.
O teste: Abra o JPG no celular: se o rosto e o prato se leem em três segundos, serve.
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
Na Cozinha da Rafa, o corte 9:16 de 60 segundos sobre cartola (banana frita com queijo coalho) tem seis cenas e é um dos dois cortes da semana. A folha de personagem fixa a Rafa de avental de linho azul-cobalto e brincos de argola. Saem seis quadros 864x1536 em medium com referência; um volta pelo sunburst porque a mão apareceu com seis dedos, e a miniatura 16:9 serve ao vídeo longo da semana. O valor exato vem do custos/imagens.csv, já que cada imagem gasta um número diferente de tokens de saída. A revisão pela rubrica da aula 11 aponta um azulejo com letras ilegíveis no quadro 3, refeito antes do slideshow.
Gere a folha, os quadros e o rascunho do seu primeiro vídeo agora. Está pronto quando a mesma personagem aparece em todos os quadros, nenhum id gpt-image-1 sobra no repositório, o rascunho tem a duração da narração com no máximo 0,5 s de diferença e o custos/imagens.csv mostra o total em dólar do storyboard.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code CLI: Programação com IA
- CursoAstra profundosugerido pelo grafoA quinta parte do Astra planeja o vídeo e edita o material bruto com o modelo dirigindo a ferramenta. O curso de vídeo com IA aprofunda esse trabalho com Claude Code, Codex e ElevenLabs, do roteiro à publicação. O grafo já sugeria esta ordem pela regra de entrada da trilha; com a ordem anterior curada, ela passa a ser declarada (Etapa 4, wave 3).
- CursoSetup Completo: do zero ao Claude Codesugerido pelo grafo7 capítulos de “Vídeo com IA: Claude Code, Codex e ElevenLabs” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code”.
Depois, siga para
- CursoFrontends com Vibecodingsugerido pelo grafo21 capítulos de “Frontends com Vibecoding” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoDo Agile ao Agentic Operating Modelsugerido pelo grafo5 capítulos de “Do Agile ao Agentic Operating Model” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoAgentes de IA Autônomos: Do Conceito à Produçãosugerido pelo grafo7 capítulos de “Agentes de IA Autônomos: Do Conceito à Produção” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoLLM FinOps: o custo da IA para quem assina o orçamentosugerido pelo grafo4 capítulos de “LLM FinOps: o custo da IA para quem assina o orçamento” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
O mesmo assunto em outros cursos
- Frontends com VibecodingConstruir as cenas do orquestrador, do paralelismo e do robôExaminar conexões de Construir as cenas do orquestrador, do paralelismo e do robô
- GEO para Educação Financeira Sub-18A Origem do Dinheiro -- A Viagem no Tempo de AlexExaminar conexões de A Origem do Dinheiro -- A Viagem no Tempo de Alex
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
MediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Grave a cena em tempo real e veja os quadros que se perdem
Suba as partículas, force um bloqueio de 300 ms e grave seis segundos; compare com o render quadro a quadro desta aula.
Pacote
Abrir no capítuloMontar vídeo em HTML com HyperFrames e escolher entre ele e o Remotionsem pacoteMotion
Ver agentes em paralelo trocando mensagens numa linha do tempo
Reproduza a cena, percorra o tempo pelo controle e compare o tempo de parede com a soma das barras de cada agente.
Pacote
Abrir no capítuloParalelizar cenas com subagentes sem estourar o limite das APIsmotionReact (sem dependência extra), com as APIs do Veo e do fal.ai
Prompt de vídeo em cinco camadas, pronto para a API
Escolha plano, câmera, luz, ação e áudio e copie o prompt e o JSON para o Veo ou para o fal.ai.
Pacote
Abrir no capítuloEscrever prompt de vídeo em cinco camadas e manter o personagem consistentereactReact (sem dependência extra), com o comando para o FFmpeg
Corte o vídeo apagando palavras da transcrição
Aperte as palavras para removê-las, ligue a remoção de pausas e copie o comando FFmpeg e a legenda SRT gerados.
Pacote
Abrir no capítuloRemover pausas e reenquadrar o vídeo de 16:9 para 9:16 com legenda por palavrareactReact (sem dependência extra)
Quanto custa cada etapa do seu pipeline de vídeo
Troque a ferramenta de cada etapa e o percentual de b-roll e veja qual etapa pesa no custo por minuto e por vídeo.
Pacote
Abrir no capítuloOrquestrar o pipeline com etapas idempotentes e teto de gastoreact