Vídeo com IA: Claude Code, Codex e ElevenLabs · Capítulo 15 de 25 · 27 min
Narrar em português com Eleven v4 por API e usar o Flash no volume
Gere a locução do roteiro pela API da ElevenLabs com Eleven v4 e tags de áudio e corrija a pronúncia antes de pagar por um lote de vídeos inteiro no Flash v2.5.
Este capítulo faz parte do curso gratuito Vídeo com IA: Claude Code, Codex e ElevenLabs.
Baixar uma narração pelo painel da ElevenLabs resolve um vídeo. Três vídeos por semana, com cortes verticais e versões de teste, pedem outra coisa: um script que receba o roteiro, chame a API, salve o áudio com nome previsível e registre quanto custou. Sem isso, cada locução vira um download manual sem histórico de modelo, de voz e de preço.
Improvisar cobra a conta no lote. Um ingrediente lido errado e repetido em vinte arquivos obriga a refazer tudo, e um orçamento calculado com o preço de lançamento do Eleven v4, que valeu até 12/10/2026, estoura no mês seguinte.
Nesta aula você gera a locução por API com o Eleven v4, o modelo mais expressivo da ElevenLabs, e com o Flash v2.5, o modelo rápido para volume. Antes do lote, faz uma amostra curta, corrige a pronúncia, ouve o resultado e só então libera a produção com o custo anotado.
Escolha o modelo pela expressão, pelo volume e pelo preço
Pela API, a porta entre programas vista na aula 01, o seu script entrega texto e recebe áudio. Quem escreve e roda o script é o Claude Code ou o Codex; quem produz a voz é a ElevenLabs. Por isso a escolha que importa aqui é a do modelo, e ela depende de três perguntas: a peça precisa de emoção, de volume ou de resposta imediata?
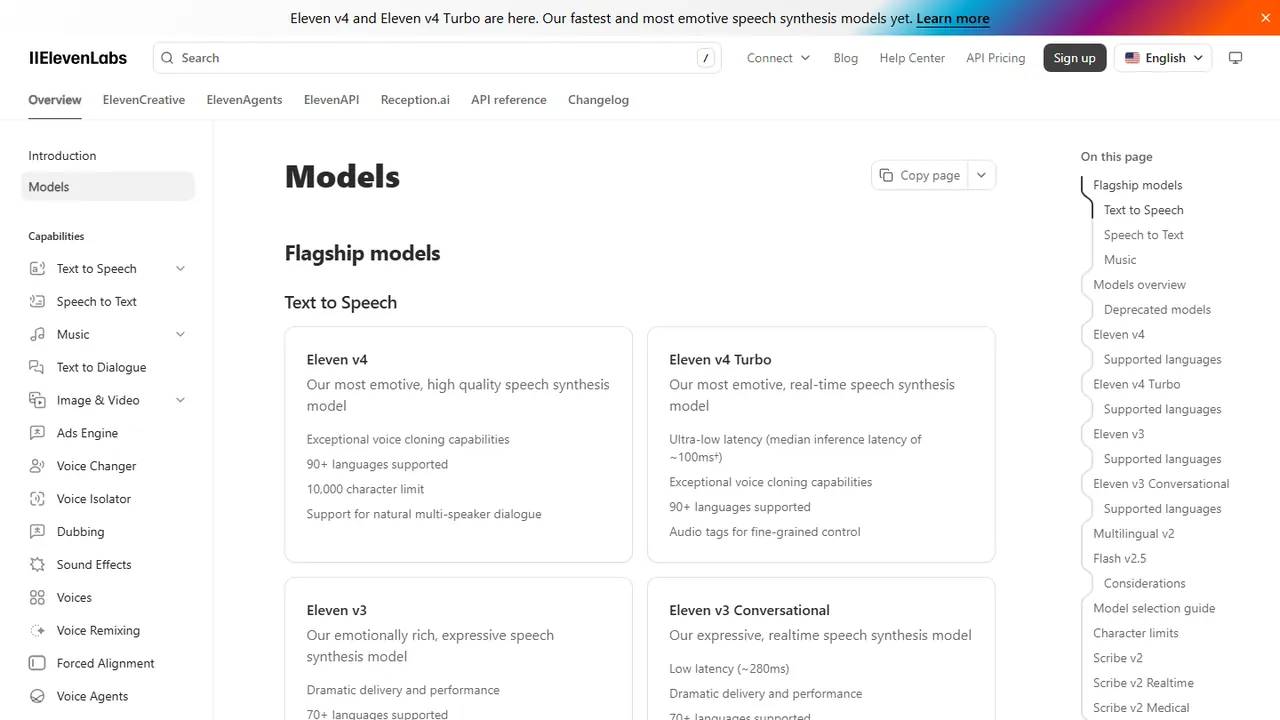
O Eleven v4 (eleven_v4) e o Eleven v4 Turbo (eleven_v4_turbo) saíram em 28/09/2026 e entram por duas portas. Na Text to Speech, a rota clássica POST /v1/text-to-speech/{voice_id}, o eleven_v4 fala com uma voz e aceita até 10.000 caracteres por geração; é a chamada que os exemplos oficiais da ElevenLabs usam desde 05/10/2026. Na Text to Dialogue, a rota POST /v1/text-to-dialogue que recebe uma lista de falas com a voz de cada uma, o mesmo modelo faz diálogo entre vozes com até 2.000 caracteres somados por pedido; o v4 Turbo também atende pelo WebSocket dessa API, para uso em tempo real. O Multilingual v2 segue como model_id padrão da Text to Speech quando você não informa outro, e o Flash v2.5 continua nessa rota para o volume. Esta aula usa a Text to Dialogue na primeira locução porque a receita tem convidado; para uma voz só, a Text to Speech com eleven_v4 é a chamada mais curta.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Modelos de voz para narração em pt-BR em 12/10/2026
| Modelo e rota | Capacidade e limite | Preço de lista na API |
|---|---|---|
| eleven_v4, pela Text to Speech ou pela Text to Dialogue | Mais de 90 idiomas; até 10.000 caracteres na Text to Speech e até 2.000 somados por pedido na Text to Dialogue; não é tempo real | US$ 0,08 por mil caracteres (lançamento a US$ 0,022 encerrado em 12/10/2026) |
| eleven_v4_turbo, pelas mesmas rotas e pelo WebSocket da Text to Dialogue | Mais de 90 idiomas, cerca de 100 ms de latência mediana | US$ 0,04 por mil caracteres (lançamento a US$ 0,011 encerrado em 12/10/2026) |
| eleven_flash_v2_5, pela Text to Speech | 32 idiomas, 40.000 caracteres, cerca de 75 ms | US$ 0,04 por mil caracteres |
| eleven_multilingual_v2, padrão da Text to Speech | 29 idiomas, 10.000 caracteres, narração longa e estável | US$ 0,08 por mil caracteres |
Os modelos eleven_turbo_v2 e eleven_turbo_v2_5 estão obsoletos: ainda aparecem na documentação, mas a indicação é trocar pelo eleven_flash_v2 e pelo eleven_flash_v2_5, equivalentes e mais rápidos. O eleven_flash_v2 fala só inglês. Os 10.000 caracteres do cartão do eleven_v4 valem na Text to Speech; na Text to Dialogue, a soma dos textos de inputs[] fica em até 2.000 por pedido para a geração não parar no meio. A página de planos ainda anunciava, em 12/10/2026, créditos extras do v4 nos apps web e móvel por duas semanas; isso não vale para a API.
Fonte: ElevenLabs, página de modelos, página do Eleven v4 e tabela de preços da API, 12/10/2026
Expressão no v4 vem de tags de áudio: instruções entre colchetes, sempre em inglês, como a rubrica que o diretor escreve no roteiro de teatro. Os exemplos oficiais incluem [curious], [excited], [whispers], [sighs] e [laughs]; no v4 também dá para empilhar ([excited, happy]) ou descrever em linguagem natural. A própria página do v4 avisa que o modelo ainda não segue todas as tags com perfeição, então trate cada tag como pedido, não como garantia.
Três coisas do hábito antigo não funcionam no v4. Ele não aceita SSML, a marcação em XML que outras vozes usam para pausa e ênfase; não tem os controles Style e Speed, só Stability (quanto a leitura varia de uma vez para outra) e Similarity (quão perto fica da voz original); e a tag <break> não funciona nem no v3 nem no v4. Pausa sai de pontuação, de reticências e das tags [pause] e [long pause], mostradas mais adiante nesta aula.
Se a peça é a abertura de um vídeo, com emoção e humor, use o eleven_v4. Se é um lote de blocos informativos, com texto longo e preço menor, teste o eleven_flash_v2_5 com a mesma voz antes de trocar, porque a diferença de qualidade não é presumida. Se a voz foi clonada e usada no v3, gere uma amostra no v4 antes de migrar o canal: a documentação registra que a mesma voz pode soar diferente no modelo novo.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Gere a primeira locução por API
O SDK é a biblioteca oficial que embala as chamadas HTTP, como um controle remoto que já sabe os botões da API. A versão Python adotada aqui é a 2.71.0, de 05/10/2026 (pip install elevenlabs); fique na linha 2.x, porque a 3.0.0-alpha.1, publicada em 08/09/2026, renomeia partes do SDK e ainda não é estável. Em TypeScript, o pacote é @elevenlabs/elevenlabs-js. A chave fica na variável ELEVENLABS_API_KEY, preparada na aula 03, e o mesmo cuidado vale no repositório: chave de API guardada em Secrets, nunca no código.
O primeiro bloco prepara a pasta, instala o SDK, lista as vozes da conta e cria uma amostra de laboratório. O voice_id é o identificador da voz na sua conta; o id do modelo é outra coisa, e misturar os dois é o erro mais comum do primeiro dia. Se a voz ainda não existe, a aula 16 mostra como criá-la com consentimento.
#!/usr/bin/env bash
# scripts/preparar_voz.sh: rode na raiz do projeto video-ia.
set -euo pipefail
: "$ELEVENLABS_API_KEY"   # variável de ambiente configurada na aula 03; falha cedo se faltar

python -m venv .venv
source .venv/bin/activate          # no Windows (Git Bash): source .venv/Scripts/activate
python -m pip install "elevenlabs==2.71.0"
mkdir -p roteiro audio logs

# Lista as vozes da conta: copie só o voice_id da voz autorizada.
python - <<'PY'
from elevenlabs.client import ElevenLabs
for voz in ElevenLabs().voices.search().voices:
    print(f"{voz.voice_id}\t{voz.name}")
PY

read -rp "voice_id da voz autorizada: " ELEVENLABS_VOICE_ID
export ELEVENLABS_VOICE_ID

# Amostra curta com o que costuma sair errado: números, medidas e nomes.
cat > roteiro/amostra.txt <<'TXT'
[excited] Hoje tem bolo de rolo na Cozinha da Rafa!
Separe duzentos gramas de manteiga... e quatro ovos em temperatura ambiente.
[whispers] O segredo é a mise en place.
TXT
echo "Amostra pronta em roteiro/amostra.txt"
A mesma chamada aparece abaixo em Python, TypeScript e curl. As três mandam o roteiro para a Text to Dialogue com model_id igual a eleven_v4 e language_code igual a pt, o código de idioma ISO 639-1 que o TTS usa. Guarde esse detalhe: a transcrição da aula 17 aceita pt ou por, e a dublagem pede a etiqueta com região, como pt-BR; use em cada serviço o formato que ele documenta.
Locução com eleven_v4 pela Text to Dialogue
Python
O script divide o roteiro em pedidos de até 2.000 caracteres sem cortar frase, estima o custo pelo preço de lista, pede autorização, grava primeiro num arquivo temporário e só promove o MP3 quando o último trecho termina. Uso: python scripts/narrar_v4.py roteiro/amostra.txt audio/amostra_v4.mp3.
# scripts/narrar_v4.py: narração com Eleven v4 pela Text to Dialogue (SDK 2.71.0).
import json
import os
import re
import sys
from pathlib import Path

from elevenlabs import DialogueInput
from elevenlabs.client import ElevenLabs

LIMITE_PEDIDO = 2_000   # a Text to Dialogue pede até 2.000 caracteres somados por pedido
PRECO_LISTA = 0.08      # US$ por mil caracteres; o lançamento a US$ 0,022 terminou em 12/10/2026


def dividir(texto: str, limite: int) -> list[str]:
    """Quebra o roteiro em pedidos de até "limite" caracteres, sem cortar frase."""
    pedidos, atual = [], ""
    for frase in re.split(r"(?<=[.!?…])\s+|\n{2,}", texto):
        frase = frase.strip()
        if not frase:
            continue
        if len(frase) > limite:
            raise SystemExit(f"Frase com {len(frase)} caracteres: quebre-a no roteiro.")
        if atual and len(atual) + 1 + len(frase) > limite:
            pedidos.append(atual)
            atual = frase
        else:
            atual = f"{atual} {frase}".strip()
    if atual:
        pedidos.append(atual)
    return pedidos


entrada, saida = Path(sys.argv[1]), Path(sys.argv[2])
texto = entrada.read_text(encoding="utf-8").strip()

# Dicionário local de locução: a troca de grafia acontece no texto, antes do
# envio, e a legenda sai do roteiro original. Ex.: {"mise en place": "mizanplás"}
dic_path = Path("config/pronuncia.json")
if dic_path.exists():
    for grafia, leitura in json.loads(dic_path.read_text(encoding="utf-8")).items():
        texto = texto.replace(grafia, leitura)

if saida.exists():
    raise SystemExit(f"{saida} já existe. Ouça antes de gerar de novo.")

pedidos = dividir(texto, LIMITE_PEDIDO)
estimativa = len(texto) / 1000 * PRECO_LISTA
print(f"{len(texto)} caracteres em {len(pedidos)} pedido(s); estimativa pelo preço de lista: US$ {estimativa:.4f}")
if input("Autoriza a geração paga? Digite SIM: ").strip() != "SIM":
    raise SystemExit("Cancelado.")

cliente = ElevenLabs()  # lê ELEVENLABS_API_KEY do ambiente
voz = os.environ["ELEVENLABS_VOICE_ID"]
saida.parent.mkdir(parents=True, exist_ok=True)
temporario = saida.with_suffix(".part")

# Um pedido por trecho, na ordem. Quadros de MP3 do mesmo formato podem ser
# emendados em sequência; para WAV ou PCM, junte com o concat do FFmpeg.
with temporario.open("wb") as arquivo:
    for trecho in pedidos:
        audio = cliente.text_to_dialogue.convert(
            model_id="eleven_v4",
            language_code="pt",
            inputs=[DialogueInput(text=trecho, voice_id=voz)],
            output_format="mp3_44100_128",   # padrão documentado
        )
        for bloco in audio:
            if bloco:
                arquivo.write(bloco)
if temporario.stat().st_size == 0:
    raise RuntimeError("A API devolveu áudio vazio.")
temporario.replace(saida)

Path("logs").mkdir(exist_ok=True)
Path(f"logs/{saida.stem}.json").write_text(json.dumps({
    "modelo": "eleven_v4",
    "voice_id": voz,
    "caracteres": len(texto),
    "pedidos": len(pedidos),
    "estimativa_usd_lista": round(estimativa, 4),
    "arquivo": str(saida),
}, ensure_ascii=False, indent=2), encoding="utf-8")
print(f"Áudio salvo em {saida}")
TypeScript
Em Node 20 ou mais novo, instale com npm i @elevenlabs/elevenlabs-js e rode com npx tsx scripts/narrar-v4.ts na raiz video-ia. Os nomes dos campos seguem o padrão camelCase do SDK de TypeScript.
// scripts/narrar-v4.ts: a mesma narração com o SDK oficial de TypeScript.
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
import { createWriteStream, existsSync } from "node:fs";
import { readFile, rename } from "node:fs/promises";
import { Readable } from "node:stream";
import { pipeline } from "node:stream/promises";

const ENTRADA = "roteiro/amostra.txt";
const SAIDA = "audio/amostra_v4.mp3";
const voiceId = process.env.ELEVENLABS_VOICE_ID;
if (!voiceId) throw new Error("Defina ELEVENLABS_VOICE_ID no ambiente.");
if (existsSync(SAIDA)) throw new Error(SAIDA + " já existe. Ouça antes de gerar de novo.");

const texto = (await readFile(ENTRADA, "utf8")).trim();
// A Text to Dialogue pede até 2.000 caracteres somados por pedido; acima disso, divida como no script Python.
if (texto.length > 2_000) throw new Error("Acima de 2.000 caracteres: divida o roteiro em pedidos menores.");
console.log("Estimativa pelo preço de lista: US$ " + ((texto.length / 1000) * 0.08).toFixed(4));

const client = new ElevenLabsClient(); // lê ELEVENLABS_API_KEY do ambiente
const audio = await client.textToDialogue.convert({
  modelId: "eleven_v4",
  languageCode: "pt",
  outputFormat: "mp3_44100_128",
  inputs: [{ text: texto, voiceId }],
});

// Grava num arquivo temporário e só renomeia quando o fluxo termina.
const temporario = SAIDA + ".part";
await pipeline(Readable.fromWeb(audio as any), createWriteStream(temporario));
await rename(temporario, SAIDA);
console.log("Áudio salvo em " + SAIDA);
curl
Pela API direta, o pedido é um JSON. Com dois itens em inputs, a mesma rota gera um diálogo entre duas vozes, útil para receita com convidado.
#!/usr/bin/env bash
set -euo pipefail
: "$ELEVENLABS_API_KEY"   # falha cedo se a chave não estiver no ambiente

# VOZ_RAFA e VOZ_CONVIDADO são voice_id da sua conta.
mkdir -p logs
cat > logs/pedido_v4.json <<'JSON'
{
  "model_id": "eleven_v4",
  "language_code": "pt",
  "inputs": [
    { "text": "[curious] Você já provou bolo de rolo de verdade?", "voice_id": "VOZ_RAFA" },
    { "text": "[laughs] Só o de padaria... e não é a mesma coisa.", "voice_id": "VOZ_CONVIDADO" }
  ]
}
JSON

curl --fail-with-body -sS -X POST \
  "https://api.elevenlabs.io/v1/text-to-dialogue?output_format=mp3_44100_128" \
  -H "xi-api-key: $ELEVENLABS_API_KEY" \
  -H "Content-Type: application/json" \
  --data @logs/pedido_v4.json \
  -o audio/dialogo_v4.mp3

# Confirma que o arquivo é áudio de verdade, não um JSON de erro salvo como .mp3.
ffprobe -v error -show_entries format=duration:stream=codec_name \
  -of default=noprint_wrappers=1 audio/dialogo_v4.mp3
Primeira locução por API em sete passos
Siga na ordem; cada passo tem um sinal de acerto que você confere antes do próximo.
Passo 1: Confirme a voz e o direito de uso
Copie o voice_id da listagem do primeiro bloco, não o nome visível da voz.
Deu certo quando: O voice_id corresponde à voz autorizada e aparece em ELEVENLABS_VOICE_ID.
Erro comum: Colar o nome da voz ou o id do modelo no lugar do voice_id.
Passo 2: Monte uma amostra com o que costuma sair errado
Inclua medidas, números, nomes próprios e termos estrangeiros do canal.
Deu certo quando: A amostra tem menos de 400 caracteres e cobre os casos difíceis.
Erro comum: Gerar o roteiro inteiro antes de ouvir uma frase.
Passo 3: Escreva números por extenso e use tags em inglês
O Flash v2.5 ainda erra moeda e número; no v4, a tag orienta a interpretação.
Deu certo quando: O texto fala “duzentos gramas”, não “200 g”, e as tags estão entre colchetes.
Erro comum: Usar <break>, SSML ou tags em português como [animado].
Passo 4: Leia a estimativa e autorize uma chamada
O script calcula pelo preço de lista de US$ 0,08 por mil caracteres.
Deu certo quando: Modelo, caracteres e estimativa aparecem antes do envio.
Erro comum: Orçar o mês com o preço de lançamento, que terminou em 12/10/2026.
Passo 5: Gere e inspecione o arquivo com ffprobe
Use o ffprobe da aula 04 para ler codec e duração do arquivo gerado.
Deu certo quando: O ffprobe mostra codec mp3 e uma duração coerente com o texto.
Erro comum: Tratar um arquivo presente no disco como prova de sucesso.
Passo 6: Ouça e compare com o roteiro
Uma pessoa ouve números, nomes, pausas e emoção.
Deu certo quando: A amostra é aprovada por escrito, com o nome de quem ouviu.
Erro comum: Presumir que o agente de código ouviu a locução; ele lê texto, não escuta áudio.
Passo 7: Libere o lote e registre o custo
Rode o mesmo script para os demais roteiros, um arquivo por bloco.
Deu certo quando: Cada MP3 tem um JSON irmão em logs/ com modelo, voz e estimativa.
Erro comum: Comparar vozes diferentes e atribuir toda a diferença ao modelo.
No fim você tem: Uma locução aprovada em MP3, com o registro de modelo, voz e custo estimado.
Roteiro longo e ritmo no Eleven v4
link Dê continuidade entre os blocos de um roteiro longo
Quando o roteiro passa de 2.000 caracteres na Text to Dialogue, cada bloco vira um pedido separado, e um pedido que nasce sem contexto recomeça o tom do zero: a emenda entre o bloco 1 e o bloco 2 soa como outra pessoa entrando na sala. Desde 28/09/2026, a Text to Dialogue aceita previous_text e future_text, com até 100 caracteres cada, e previous_request_ids e next_request_ids, com até três ids cada; a Text to Speech tem os mesmos campos com os nomes previous_text e next_text. Envie em cada pedido o fim do bloco anterior e o começo do seguinte, e o id devolvido pelo pedido anterior, que vem no cabeçalho request-id da resposta.
O trecho abaixo substitui o laço de envio do scripts/narrar_v4.py. Se o seu SDK não expuser with_raw_response, mande só os dois textos: eles já resolvem a maior parte da emenda. Deu certo quando a transição entre blocos passa na audição sem mudança de ritmo; o erro comum é colar o bloco inteiro em previous_text, que a API rejeita por tamanho. Decida assim: roteiro de um bloco só, nada a fazer; dois ou mais blocos, continuidade sempre, porque ela não custa caracteres extras na cobrança.
# Substitui o laço "for trecho in pedidos" do scripts/narrar_v4.py.
anteriores: list[str] = []          # ids dos pedidos já gerados (cabeçalho request-id)
with temporario.open("wb") as arquivo:
    for i, trecho in enumerate(pedidos):
        anterior = pedidos[i - 1][-100:] if i else None                    # até 100 caracteres
        seguinte = pedidos[i + 1][:100] if i + 1 < len(pedidos) else None   # até 100 caracteres
        resposta = cliente.text_to_dialogue.with_raw_response.convert(
            model_id="eleven_v4",
            language_code="pt",
            inputs=[DialogueInput(text=trecho, voice_id=voz)],
            output_format="mp3_44100_128",
            previous_text=anterior,
            future_text=seguinte,
            previous_request_ids=anteriores[-3:] or None,                   # até três ids
        )
        for bloco in resposta.data:
            if bloco:
                arquivo.write(bloco)
        id_pedido = resposta.headers.get("request-id")
        if id_pedido:
            anteriores.append(id_pedido)
print(f"{len(pedidos)} pedido(s) encadeados; ids em logs/{saida.stem}.json")Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
clock Peça pausa e ritmo com tags, não com SSML
No v4, pausa e ritmo são tags de áudio como as de emoção. O blog oficial de 30/09/2026 lista [pause] para uma pausa curta, [long pause] para uma pausa longa e [slowly] para uma leitura mais lenta, válidas no v4, no v4 Turbo e no v3; empilhe com vírgula, use uma tag por oração e lembre que a emoção de uma tag segue até a próxima. Onde antes havia <break time="1s"/>, escreva [pause]; onde a leitura corre, [slowly]. Para pronúncia, o <phoneme> do SSML também não existe no v4: escreva o IPA entre barras no próprio texto, e as regras de alias do dicionário da conta continuam valendo para nomes e termos.
Deu certo quando a amostra respeita a pausa sem ler a tag em voz alta. O erro comum é tag em português, como [pausa], que o modelo ignora ou pronuncia. O v4 ainda pode acrescentar um som não roteirizado, como uma respiração ou um riso curto; se isso aparecer no lote, reduza as tags de reação e gere outra amostra antes de culpar a voz.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Escreva o roteiro para ser ouvido, não lido
Tudo o que a voz pode ler de dois jeitos deve ser escrito do jeito certo antes do envio.
- Números, medidas e preços por extenso: “duzentos gramas”, não “200 g”.
- Tags em inglês e entre colchetes, como [excited] ou [whispers].
- Pausa com pontuação, reticências, [pause] e [long pause]; <break> e SSML não funcionam no v4.
- Termo estrangeiro no dicionário de pronúncia, não improvisado a cada roteiro.
O teste: Leia o roteiro em voz alta: se você hesitou, a voz sintética também vai hesitar.
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
Corrija a pronúncia antes de produzir o lote
O dicionário de pronúncia é uma lista de trocas que a API aplica antes de falar, como a cola que o locutor deixa colada no microfone. Na rota de Text to Speech, usada pelo Flash, você cria o dicionário uma vez na conta com regras de alias (troque “mise en place” por “mizanplás”) e passa a referência em cada pedido pelo campo pronunciation_dictionary_locators. No v4, a FAQ oficial confirma que as regras de alias do dicionário continuam controlando como nomes e termos são falados; o que não existe é o <phoneme> do SSML, que vira IPA entre barras no texto. Este curso mantém, para o v4, a troca no próprio texto como alternativa que você enxerga no roteiro: o scripts/narrar_v4.py aplica o mesmo config/pronuncia.json antes do envio, e a legenda continua com a grafia correta porque sai do roteiro original.
Se um nome sair errado, corrija a grafia de locução e gere outra amostra curta, nunca o lote. Se a API devolver erro, guarde a mensagem sem a chave e passe ao agente para diagnóstico; não repita automaticamente uma geração paga. Para entender por que esse cuidado pesa no orçamento, vale ler sobre os custos de IA que não são token.
#!/usr/bin/env bash
# scripts/criar_dicionario.sh: cria o dicionário uma vez e guarda id e versão em config/dicionario.json.
# Rode na raiz video-ia.
set -euo pipefail
: "$ELEVENLABS_API_KEY"

curl --fail-with-body -sS -X POST \
  "https://api.elevenlabs.io/v1/pronunciation-dictionaries/add-from-rules" \
  -H "xi-api-key: $ELEVENLABS_API_KEY" \
  -H "Content-Type: application/json" \
  --data '{
    "name": "cozinha-da-rafa",
    "rules": [
      { "type": "alias", "string_to_replace": "mise en place", "alias": "mizanplás" },
      { "type": "alias", "string_to_replace": "sous vide", "alias": "su vide" },
      { "type": "alias", "string_to_replace": "ElevenLabs", "alias": "Íleven Lébs" }
    ]
  }' \
  -o config/dicionario.json

# A resposta traz o id e a version_id que o pedido de voz precisa citar.
python -c "import json; d=json.load(open('config/dicionario.json')); print(d['id'], d['version_id'])"

# A mesma lista vira o config/pronuncia.json local usado pelo script do v4.
cat > config/pronuncia.json <<'JSON'
{ "mise en place": "mizanplás", "sous vide": "su vide", "ElevenLabs": "Íleven Lébs" }
JSON# scripts/lote_flash.py: narra todos os roteiro/bloco_*.txt com Flash v2.5.
# Uso, na raiz video-ia: python scripts/lote_flash.py
import json
import os
from pathlib import Path
from elevenlabs import PronunciationDictionaryVersionLocator
from elevenlabs.client import ElevenLabs
PRECO_FLASH = 0.04 # US$ por mil caracteres em 12/10/2026
LIMITE = 40_000 # caracteres por pedido no eleven_flash_v2_5
dic = json.loads(Path("config/dicionario.json").read_text(encoding="utf-8"))
localizador = [PronunciationDictionaryVersionLocator(pronunciation_dictionary_id=dic["id"], version_id=dic["version_id"])]
roteiros = sorted(Path("roteiro").glob("bloco_*.txt"))
pendentes = [r for r in roteiros if not Path(f"audio/{r.stem}_flash.mp3").exists()]
total = sum(len(r.read_text(encoding="utf-8")) for r in pendentes)
print(f"{len(pendentes)} blocos, {total} caracteres, estimativa US$ {total / 1000 * PRECO_FLASH:.4f}")
if not pendentes or input("Autoriza o lote? Digite SIM: ").strip() != "SIM":
raise SystemExit("Nada a fazer ou lote cancelado.")
cliente = ElevenLabs()
for roteiro in pendentes:
texto = roteiro.read_text(encoding="utf-8").strip()
if len(texto) > LIMITE:
print(f"PULADO {roteiro.name}: acima de {LIMITE} caracteres")
continue
audio = cliente.text_to_speech.convert(
voice_id=os.environ["ELEVENLABS_VOICE_ID"],
model_id="eleven_flash_v2_5", # explícito: o padrão da rota é o Multilingual v2
language_code="pt",
text=texto,
output_format="mp3_44100_128",
pronunciation_dictionary_locators=localizador,
)
destino = Path(f"audio/{roteiro.stem}_flash.mp3")
temporario = destino.with_suffix(".part")
with temporario.open("wb") as arquivo:
for bloco in audio:
if bloco:
arquivo.write(bloco)
temporario.replace(destino) # pulado na próxima rodada: o lote é retomável
print(f"OK {destino}")Valide a amostra e libere o lote
Na Cozinha da Rafa, canal de receitas de Recife com três vídeos por semana (um longo 16:9 e dois cortes 9:16), a abertura de cada vídeo longo sai no eleven_v4, com [excited] na primeira frase, e os blocos de modo de preparo saem no Flash v2.5 depois de uma comparação com a mesma voz. Um vídeo longo de oito minutos tem perto de 7.200 caracteres de roteiro, na conta de cerca de 900 caracteres por minuto de fala usada neste curso, o que no v4 vira quatro pedidos de até 2.000 caracteres. Pelo preço de lista de 12/10/2026, isso dá cerca de US$ 0,58 no v4 e US$ 0,29 no Flash; o número real fica no painel de consumo, e o JSON de cada arquivo guarda a estimativa para comparar.
O prompt abaixo entrega a tarefa inteira ao Claude Code, com os limites desta aula escritos como regra.
Guia prático: narração com legenda pronta, custo real e leitura repetível
A aula grava a narração e estima o custo. Este guia tira mais da mesma chamada: a rota com timestamps devolve o tempo de cada caractere, e dele sai o SRT sem pagar uma transcrição; o cabeçalho character-cost troca a estimativa do log pelo número cobrado; e a semente (seed) ajuda a refazer só uma frase com leitura parecida.
Funções, casos de uso e aplicações
Funções
Campos da Text to Speech que a aula não usou
| Função ou recurso | O que faz | Quando usar | Desde |
|---|---|---|---|
| POST /v1/text-to-speech/{voice_id}/with-timestamps | Devolve o áudio em base64 e o alignment, com início e fim de cada caractere do texto enviado | Legenda direto da narração sintética, sem chamar o Scribe | Referência de 12/10/2026 |
| Cabeçalho character-cost (com with_raw_response) | Informa quantos caracteres o pedido custou; vem junto com request-id | Gravar no log o custo cobrado ao lado da estimativa | Referência de 12/10/2026 |
| seed (0 a 4.294.967.295) | Pede saída repetível na base do melhor esforço, sem garantia | Refazer uma frase sem mudar demais a leitura das vizinhas | Referência de 12/10/2026 |
| apply_text_normalization (auto, on, off) | Com on, a API sempre reescreve números e símbolos por extenso antes de falar | Lote do Flash com preço, data e medida no texto | Referência de 12/10/2026 |
| pronunciation_dictionary_locators com até três dicionários | Aplica os dicionários na ordem em que vêm | Dicionário da marca primeiro, dicionário do episódio depois | Referência de 12/10/2026 |
| settings.similarity na Text to Dialogue (0 a 1, padrão 0,75) | Ajusta quão perto a fala fica da voz original no diálogo | Convidado com voz clonada que soa distante da gravação | 28/09/2026 |
| enable_logging=false | Modo sem retenção, só no Enterprise; desliga o histórico e a costura entre pedidos | Roteiro sob sigilo de cliente | Referência de 12/10/2026 |
Fonte: ElevenLabs, referência Create speech with timing, introdução da API e changelog de 28/09/2026
Casos de uso
Juliana, coordenadora de produção de uma edtech de preparatório para concursos em Brasília
Educação
Dor
As videoaulas curtas são narradas a partir de um texto pronto, mas a equipe ainda transcreve cada áudio para fazer a legenda e paga duas vezes pelo mesmo conteúdo.
Solução
Narração pela rota com timestamps no Flash v2.5: o mesmo pedido entrega o MP3 e o tempo de cada caractere, e o script monta o SRT de 42 caracteres por linha.
Resultado
Compare, no fim do mês, o gasto de transcrição antes e depois e confira em dez aulas se a legenda acompanha a fala do início ao fim.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Henrique, analista de mídia de um e-commerce de cosméticos em Salvador
Marketing digital
Dor
Os anúncios testam várias aberturas narradas, e o custo por variação sai de uma planilha de estimativas que nunca bate com o painel.
Solução
Cada variação grava character-cost e request-id no log; a semente fixa permite refazer só a frase reprovada.
Resultado
Some o character-cost do mês e compare com o painel de consumo da ElevenLabs; a diferença deve ficar perto de zero.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Na prática
O script lê um bloco do roteiro, narra no Flash v2.5 pela rota com timestamps e escreve três arquivos: o MP3 em audio/, o SRT em legendas/ e o log em logs/ com o custo cobrado. A legenda usa o alignment, que segue o texto enviado; o normalized_alignment segue o texto já reescrito pela normalização e mostraria "duzentos" onde o roteiro tem "200".
# Uso, na raiz video-ia: python scripts/narrar_com_legenda.py roteiro/bloco_01.txt
import base64, json, os, sys
from pathlib import Path
from elevenlabs.client import ElevenLabs

entrada = Path(sys.argv[1]); nome = entrada.stem
texto = entrada.read_text(encoding="utf-8").strip()
SEMENTE = 20261012

resp = ElevenLabs().text_to_speech.with_raw_response.convert_with_timestamps(
    voice_id=os.environ["ELEVENLABS_VOICE_ID"],
    model_id="eleven_flash_v2_5",
    language_code="pt",
    text=texto,
    seed=SEMENTE,                       # leitura parecida ao refazer (melhor esforço)
    apply_text_normalization="on",      # números e símbolos por extenso antes de falar
    output_format="mp3_44100_128",
)
dados = resp.data
for pasta in ("audio", "legendas", "logs"):
    Path(pasta).mkdir(exist_ok=True)
Path(f"audio/{nome}_flash.mp3").write_bytes(base64.b64decode(dados.audio_base_64))

# Caracteres -> palavras: a palavra vai do primeiro ao último caractere
al, palavras, atual = dados.alignment, [], ""
for ch, t0, t1 in zip(al.characters, al.character_start_times_seconds, al.character_end_times_seconds):
    if ch.isspace():
        if atual:
            palavras.append((atual, ini, fim)); atual = ""
        continue
    if not atual:
        ini = t0
    atual += ch; fim = t1
if atual:
    palavras.append((atual, ini, fim))

def ts(s):
    ms = round(s * 1000); h, ms = divmod(ms, 3600000); m, ms = divmod(ms, 60000); s2, ms = divmod(ms, 1000)
    return f"{h:02}:{m:02}:{s2:02},{ms:03}"

blocos, bloco = [], []
for p in palavras:                       # até 42 caracteres por legenda
    if bloco and len(" ".join(x[0] for x in bloco + [p])) > 42:
        blocos.append(bloco); bloco = []
    bloco.append(p)
if bloco:
    blocos.append(bloco)
with open(f"legendas/{nome}.srt", "w", encoding="utf-8") as srt:
    for i, b in enumerate(blocos, 1):
        srt.write(f"{i}\n{ts(b[0][1])} --> {ts(b[-1][2])}\n{' '.join(x[0] for x in b)}\n\n")

custo = resp.headers.get("character-cost")
Path(f"logs/{nome}_flash.json").write_text(json.dumps({
    "modelo": "eleven_flash_v2_5", "seed": SEMENTE, "caracteres_cobrados": custo,
    "request_id": resp.headers.get("request-id"), "legendas": len(blocos),
}, ensure_ascii=False, indent=2), encoding="utf-8")
print(f"{len(palavras)} palavras, {len(blocos)} legendas, character-cost {custo}")
Da narração à legenda sincronizada em quatro passos
Passo 1: Escolha um bloco curto do roteiro
Comece por roteiro/bloco_01.txt, com números e um termo do dicionário.
Deu certo quando: O bloco tem menos de mil caracteres.
Erro comum: Testar a legenda no roteiro inteiro e pagar o lote antes de ouvir.
Passo 2: Rode o script e confira os três arquivos
python scripts/narrar_com_legenda.py roteiro/bloco_01.txt.
Deu certo quando: MP3, SRT e log existem e o log traz caracteres_cobrados.
Erro comum: Ler None no custo e não perceber que o SDK não expôs o cabeçalho.
Passo 3: Queime a legenda numa cópia de revisão
Use o filtro subtitles da aula 4 sobre o rascunho do storyboard.
Deu certo quando: A legenda entra e sai junto com a fala do início ao fim.
Erro comum: Usar o normalized_alignment e ver a grafia mudar na tela.
Passo 4: Refaça só a frase reprovada
Corrija o texto do bloco e rode de novo com a mesma semente.
Deu certo quando: A nova leitura combina com as vizinhas na audição.
Erro comum: Esperar que a semente devolva um áudio idêntico: é melhor esforço.
No fim você tem: Narração, legenda e custo cobrado saem do mesmo pedido, sem uma transcrição paga só para legendar.
Armadilhas
Legenda e custo da narração: o que evitar e o que fazer
Evite
Coluna a evitar
- Transcrever com o Scribe um áudio que você mesmo gerou a partir de texto
- Montar a legenda pelo normalized_alignment
- Somar estimativas e chamar de custo do mês
- Contar com a semente para áudio idêntico
- Mandar language_code para o eleven_multilingual_v2, que não aceita o campo
Prefira
Coluna recomendada
- Rota com timestamps no próprio pedido da narração
- alignment, que segue a grafia do roteiro
- character-cost e request-id gravados em logs/
- Semente para aproximar a leitura e audição humana para aprovar
- Testar o alignment no modelo que você vai usar antes do lote
Glossário rápido
TTS (texto para fala)
Serviço que recebe texto e devolve áudio falado, como um locutor que lê o roteiro que você entrega.
Eleven v4
Modelo de voz da ElevenLabs lançado em 28/09/2026 (id eleven_v4), com mais de 90 idiomas, aceito pela Text to Speech (uma voz, até 10.000 caracteres) e pela Text to Dialogue (várias vozes, até 2.000 caracteres somados por pedido).
Text to Dialogue API
Rota POST /v1/text-to-dialogue, que recebe uma lista de falas com a voz de cada uma; com um item vira narração, com dois vira diálogo.
Flash v2.5
Modelo rápido e barato da ElevenLabs (eleven_flash_v2_5), com 32 idiomas e 40.000 caracteres por pedido, indicado para produção em volume.
tag de áudio
Instrução entre colchetes e em inglês, como [curious] ou [whispers], que orienta a interpretação, como a rubrica de uma peça de teatro.
Stability
Ajuste que define quanto a voz varia de uma leitura para outra, como a margem de improviso dada a um locutor.
dicionário de pronúncia
Lista de trocas de grafia que a API aplica antes de falar, como a cola de pronúncia que o locutor deixa no estúdio.
voice_id
Identificador de uma voz da sua conta; não confunda com o id do modelo, que define o motor de síntese.
previous_text e future_text
Campos de até 100 caracteres com o fim do bloco anterior e o começo do seguinte, enviados em cada pedido para que a voz mantenha tom e ritmo nas emendas.
previous_request_ids
Lista de até três ids de pedidos anteriores (cabeçalho request-id da resposta) que liga um bloco ao áudio já gerado, como a claquete que diz de onde a cena continua.
output_format
Formato do áudio devolvido; o padrão é mp3_44100_128, o MP3 de 192 kbps exige plano Creator ou superior e o PCM de 44,1 kHz exige Pro ou superior.
Gere agora a amostra de três frases no eleven_v4, ouça e corrija a pronúncia no config/pronuncia.json até a frase sair certa. Está pronto quando você tem um MP3 aprovado por uma pessoa, um JSON em logs/ com modelo, voz e estimativa pelo preço de lista e um dicionário de pronúncia que o lote do Flash também usa.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code CLI: Programação com IA
- CursoAstra profundosugerido pelo grafoA quinta parte do Astra planeja o vídeo e edita o material bruto com o modelo dirigindo a ferramenta. O curso de vídeo com IA aprofunda esse trabalho com Claude Code, Codex e ElevenLabs, do roteiro à publicação. O grafo já sugeria esta ordem pela regra de entrada da trilha; com a ordem anterior curada, ela passa a ser declarada (Etapa 4, wave 3).
- CursoSetup Completo: do zero ao Claude Codesugerido pelo grafo7 capítulos de “Vídeo com IA: Claude Code, Codex e ElevenLabs” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code”.
Depois, siga para
- CursoFrontends com Vibecodingsugerido pelo grafo21 capítulos de “Frontends com Vibecoding” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoDo Agile ao Agentic Operating Modelsugerido pelo grafo5 capítulos de “Do Agile ao Agentic Operating Model” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoAgentes de IA Autônomos: Do Conceito à Produçãosugerido pelo grafo7 capítulos de “Agentes de IA Autônomos: Do Conceito à Produção” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoLLM FinOps: o custo da IA para quem assina o orçamentosugerido pelo grafo4 capítulos de “LLM FinOps: o custo da IA para quem assina o orçamento” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Saúde Mental para Autistas em IAQual assistente aguenta ser prótese de função executivaExaminar conexões de Qual assistente aguenta ser prótese de função executiva
- Astra profundoGovernar a esteira: gerar uma vez e multiplicar com cota zeroExaminar conexões de Governar a esteira: gerar uma vez e multiplicar com cota zero
- Vibecoding para SEOO Manifesto Vibecoding: Programe sem ProgramarExaminar conexões de O Manifesto Vibecoding: Programe sem Programar
- Prompt Engineering para ExecutivosEscolher entre Claude e OpenAI pelo custo de cada tarefa aceitaExaminar conexões de Escolher entre Claude e OpenAI pelo custo de cada tarefa aceita
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
MediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Grave a cena em tempo real e veja os quadros que se perdem
Suba as partículas, force um bloqueio de 300 ms e grave seis segundos; compare com o render quadro a quadro desta aula.
Pacote
Abrir no capítuloMontar vídeo em HTML com HyperFrames e escolher entre ele e o Remotionsem pacoteMotion
Ver agentes em paralelo trocando mensagens numa linha do tempo
Reproduza a cena, percorra o tempo pelo controle e compare o tempo de parede com a soma das barras de cada agente.
Pacote
Abrir no capítuloParalelizar cenas com subagentes sem estourar o limite das APIsmotionReact (sem dependência extra), com as APIs do Veo e do fal.ai
Prompt de vídeo em cinco camadas, pronto para a API
Escolha plano, câmera, luz, ação e áudio e copie o prompt e o JSON para o Veo ou para o fal.ai.
Pacote
Abrir no capítuloEscrever prompt de vídeo em cinco camadas e manter o personagem consistentereactReact (sem dependência extra), com o comando para o FFmpeg
Corte o vídeo apagando palavras da transcrição
Aperte as palavras para removê-las, ligue a remoção de pausas e copie o comando FFmpeg e a legenda SRT gerados.
Pacote
Abrir no capítuloRemover pausas e reenquadrar o vídeo de 16:9 para 9:16 com legenda por palavrareactReact (sem dependência extra)
Quanto custa cada etapa do seu pipeline de vídeo
Troque a ferramenta de cada etapa e o percentual de b-roll e veja qual etapa pesa no custo por minuto e por vídeo.
Pacote
Abrir no capítuloOrquestrar o pipeline com etapas idempotentes e teto de gastoreact