Vídeo com IA: Claude Code, Codex e ElevenLabs · Capítulo 17 de 25 · 27 min
Transcrever com Scribe v2 e cortar o vídeo pela palavra falada
Transcreva o bruto com Scribe v2 e o tempo exato de cada palavra e gere a legenda SRT e uma lista de cortes revisada que o FFmpeg executa sem perder sincronia.
Este capítulo faz parte do curso gratuito Vídeo com IA: Claude Code, Codex e ElevenLabs.
Uma transcrição comum diz o que foi falado. Para editar vídeo, isso não basta: você precisa saber em que segundo cada palavra começa e termina, porque é esse número que diz ao FFmpeg onde cortar e à legenda quando aparecer. Sem o tempo por palavra, tirar uma pausa ou um “é, é” vira trabalho de ouvido, quadro a quadro, num editor visual.
Na prática, o custo de não ter esse dado aparece duas vezes. Primeiro no tempo de edição de cada vídeo; depois na legenda, que sai dessincronizada assim que o vídeo é cortado, porque os tempos do SRT original não valem mais para a versão editada.
Nesta aula você transcreve o bruto com o Scribe v2, o transcritor da ElevenLabs que marca o segundo exato de cada palavra, gera a legenda SRT e uma lista de cortes que uma pessoa aprova antes de o FFmpeg executar. A mesma lista reajusta os tempos da legenda, e o vídeo editado sai sincronizado.
Escolha o Scribe v2 e os parâmetros que preservam o tempo
STT, a sigla para fala em texto, é o escrivão que também anota o relógio. Na ElevenLabs, o modelo de lote é o scribe_v2; o scribe_v2_realtime atende transmissão ao vivo, com cerca de 150 ms, e o scribe_v2_medical atende áudio clínico. O scribe_v1 está descontinuado. A skill editar-videos-claude, vista na aula 08, ainda traz scribe_v1 como padrão no transcrever.py; rode com --modelo scribe_v2 e compare um trecho, porque o preparar_corte.py dela foi calibrado com o modelo antigo.
O endpoint é POST https://api.elevenlabs.io/v1/speech-to-text, em multipart, e aceita áudio, vídeo (MP4, MOV, MKV, WebM) ou um source_url. Os parâmetros que importam para edição são timestamps_granularity=word, language_code=por (o Scribe aceita o código de duas letras pt ou o de três letras por; o TTS aceita só o de duas), tag_audio_events para marcar risos e aplausos e diarize com num_speakers quando houver mais de uma voz. A resposta traz a lista words[], e é dela que sai tudo nesta aula.
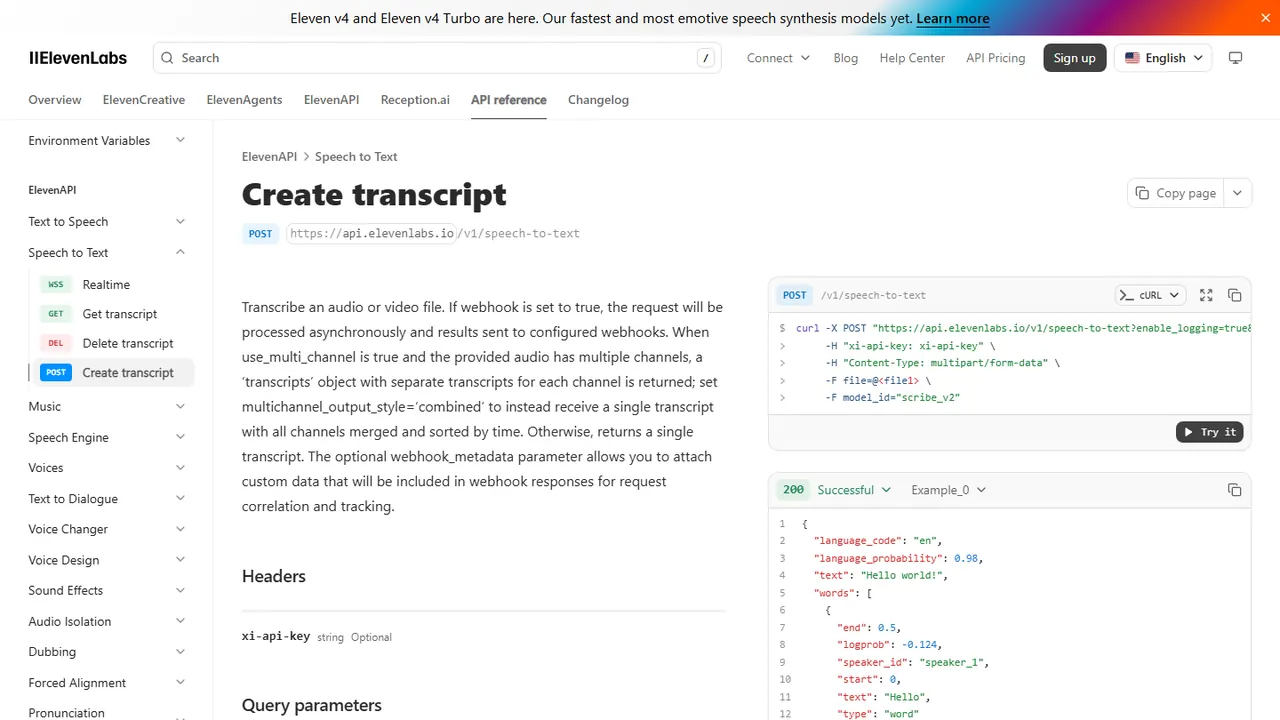
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
O que cada item de words[] traz para a edição
| Campo | O que traz | Uso no corte e na legenda |
|---|---|---|
| text | A palavra, o espaço ou o evento, como (risos) | Texto da legenda e busca de repetições |
| type | word, spacing ou audio_event | Filtrar só as palavras antes de medir pausas |
| start e end | Início e fim em segundos | Pausas, intervalos de corte e tempos do SRT |
| speaker_id | Quem falou, com diarize ligado | Separar entrevistador e convidado |
| logprob | Confiança do modelo na palavra | Apontar palavras para conferir no áudio |
Fonte: ElevenLabs, referência da API Speech to Text, 09/10/2026
Quanto custa e até onde vai o Scribe v2
US$ 0,22
preço base do Scribe v2
por hora de áudio, em 12/10/2026
+20%
adicional dos keyterms
US$ 0,05 por hora no lote; acima de 100 termos, mínimo de 20 s por pedido
+30%
adicional da edição de transcrição
US$ 0,07 por hora no lote, mínimo de 10 s por pedido, desde 28/09/2026
32
falantes separados na diarização
por arquivo, em mais de 90 idiomas
Fonte: ElevenLabs, preços da API, referência Create transcript e guia de edição de transcrição, 12/10/2026
Transcreva o bruto com tempo por palavra
O primeiro passo é uma cópia de trabalho leve do áudio: mono, 16 kHz, MP3 de 64 kbps, o mesmo preparo da skill editar-videos-claude. O bruto fica intacto. A referência da API aceita arquivos abaixo de 5 GB e a página de capacidades cita 3 GB; fique abaixo de 3 GB e você não precisa escolher entre as duas.
As três versões abaixo fazem a mesma transcrição. A de Python já pede o SRT pronto ao servidor pelo additional_formats, que aceita srt, txt, docx, pdf, html e segmented_json, com opções como max_characters_per_line e segment_on_silence_longer_than_s. Comece sem keyterms; se nomes do canal saírem errados, aprove o adicional e transcreva de novo.
Transcrição com scribe_v2 e tempo por palavra
Python
Grava a resposta inteira em transcricoes/bruto.json e o SRT gerado pelo servidor em legendas/bruto.srt. Uso, na raiz video-ia: python scripts/transcrever.py audio/bruto.mp3.
# scripts/transcrever.py: Scribe v2 com tempo por palavra e SRT pelo additional_formats.
import base64
import json
import sys
from pathlib import Path

from elevenlabs.client import ElevenLabs

audio = Path(sys.argv[1])
destino = Path("transcricoes/bruto.json")
if destino.exists():
    raise SystemExit("Já existe transcrição. Revise antes de pagar outra chamada.")
Path("transcricoes").mkdir(exist_ok=True)
Path("legendas").mkdir(exist_ok=True)

cliente = ElevenLabs()  # ELEVENLABS_API_KEY no ambiente
with audio.open("rb") as arquivo:
    r = cliente.speech_to_text.convert(
        file=arquivo,
        model_id="scribe_v2",
        language_code="por",                 # Scribe aceita ISO 639-1 (pt) ou ISO 639-3 (por)
        timestamps_granularity="word",
        tag_audio_events=True,
        diarize=True,                        # entrevista: separa quem falou
        num_speakers=2,
        # keyterms=["Cozinha da Rafa", "bolo de rolo"],   # +20% (US$ 0,05/h); só se errar nomes
        additional_formats=[{
            "format": "srt",
            "max_characters_per_line": 42,
            "include_speakers": False,
            "segment_on_silence_longer_than_s": 0.6,
            "max_segment_duration_s": 4.0,
        }],
    )

dados = r.dict()
destino.write_text(json.dumps(dados, ensure_ascii=False, indent=2, default=str), encoding="utf-8")

srt = r.additional_formats[0]
conteudo = srt.content
if srt.is_base_64_encoded:                    # no SDK Python o campo JSON is_base64_encoded vira is_base_64_encoded
    conteudo = base64.b64decode(conteudo).decode("utf-8")
Path("legendas/bruto.srt").write_text(conteudo, encoding="utf-8")

palavras = [w for w in dados["words"] if w["type"] == "word"]
print(f"{len(palavras)} palavras; última termina em {palavras[-1]['end']:.2f} s")
TypeScript
O SDK de TypeScript devolve os campos em camelCase (speakerId); text, type, start e end, os únicos que o script de corte lê, têm o mesmo nome nas duas linguagens.
// scripts/transcrever.ts: npx tsx scripts/transcrever.ts audio/bruto.mp3
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
import { existsSync } from "node:fs";
import { mkdir, readFile, writeFile } from "node:fs/promises";

const caminho = process.argv[2];
if (!caminho) throw new Error("Informe o arquivo de áudio.");
if (existsSync("transcricoes/bruto.json")) throw new Error("Transcrição já existe; revise antes de pagar outra.");

const client = new ElevenLabsClient(); // ELEVENLABS_API_KEY no ambiente
const audio = new Blob([await readFile(caminho)], { type: "audio/mpeg" });

const resposta = await client.speechToText.convert({
  file: audio,
  modelId: "scribe_v2",
  languageCode: "por",
  timestampsGranularity: "word",
  tagAudioEvents: true,
  diarize: false, // um falante só: vídeo de receita narrado pela Rafa
});

await mkdir("transcricoes", { recursive: true });
await writeFile("transcricoes/bruto.json", JSON.stringify(resposta, null, 2), "utf8");

const palavras = (resposta as { words: { type: string; end: number }[] }).words.filter((w) => w.type === "word");
console.log(palavras.length + " palavras; fim em " + palavras.at(-1)?.end.toFixed(2) + " s");
curl
Pela API direta, com a extração do áudio no mesmo script. O ffprobe mostra a duração para você estimar o custo antes da chamada.
#!/usr/bin/env bash
set -euo pipefail
: "$ELEVENLABS_API_KEY"
mkdir -p audio transcricoes
[ -e transcricoes/bruto.json ] && { echo "Transcrição já existe."; exit 1; }

# Cópia leve para transcrever: mono, 16 kHz, MP3 64 kbps. O bruto não muda.
ffmpeg -nostdin -v error -y -i midia/raw/bruto.mp4 -vn -ac 1 -ar 16000 -b:a 64k audio/bruto.mp3
SEG=$(ffprobe -v error -show_entries format=duration -of csv=p=0 audio/bruto.mp3)
python -c "s=float('$SEG'); print(f'{s/60:.1f} min, estimativa US$ {s/3600*0.22:.4f}')"
read -rp "Autoriza a transcrição? Digite SIM: " OK; [ "$OK" = "SIM" ] || exit 1

curl --fail-with-body -sS -X POST "https://api.elevenlabs.io/v1/speech-to-text" \
  -H "xi-api-key: $ELEVENLABS_API_KEY" \
  -F "file=@audio/bruto.mp3;type=audio/mpeg" \
  -F "model_id=scribe_v2" \
  -F "language_code=por" \
  -F "timestamps_granularity=word" \
  -F "tag_audio_events=true" \
  -F "diarize=false" \
  -o transcricoes/bruto.json.part

# Só promove se a resposta tiver words[]; erro HTTP salvo como .json não segue.
python -c "import json,sys; d=json.load(open('transcricoes/bruto.json.part',encoding='utf-8')); sys.exit(0 if isinstance(d.get('words'),list) else 1)"
mv transcricoes/bruto.json.part transcricoes/bruto.json
echo "Transcrição salva em transcricoes/bruto.json"
Transforme as palavras em lista de cortes e legenda
Com o transcricoes/bruto.json em mãos, o corte vira conta. Uma pausa é o intervalo entre o end de uma palavra e o start da seguinte; uma repetição é a mesma palavra dita duas vezes em sequência; um retake é a frase recomeçada, que aparece como a mesma sequência de três palavras dita de novo poucos segundos depois. Deixe o no_verbatim desligado nesta etapa: ligado, ele apaga do texto hesitações e falsos começos, e o corte precisa enxergá-los porque eles continuam no áudio. O script abaixo, salvo em scripts/, trabalha em duas etapas: propor escreve edicao/cortes.json com todos os candidatos marcados como não aprovados; você abre o arquivo, ouve cada trecho e muda para true o que deve sair; executar corta e reajusta a legenda.
Os limiares de 0,6 s de pausa, 0,15 s de respiro e 42 caracteres por linha são escolhas do curso, não limites do Scribe, e o propor aceita outros pelas opções --pausa-max e --respiro. Se o vídeo é calmo, aumente o respiro; se é um corte 9:16 para Reels, encurte. O FFmpeg recebe um filtro só, com trim e atrim para cada trecho mantido e concat no fim, e reencoda uma vez; a aula 04 explica por que cortar com cópia direta erraria o ponto exato.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
# scripts/cortar_por_palavra.py (rode na raiz video-ia)
#   python scripts/cortar_por_palavra.py propor    -> edicao/cortes.json (tudo com aprovado=false)
#   (você ouve cada candidato e marca "aprovado": true no que deve sair)
#   python scripts/cortar_por_palavra.py executar  -> renders/cortado.mp4, legendas/cortado.srt
#                                                     e legendas/palavras_cortado.json
#   O propor aceita --pausa-max e --respiro; a aula 22 usa outros valores na montagem final.
import argparse
import json
import subprocess
from pathlib import Path

BRUTO = "midia/raw/bruto.mp4"
TRANSCRICAO = Path("transcricoes/bruto.json")
CORTES = Path("edicao/cortes.json")
LINHA = 42         # caracteres por bloco de legenda

parser = argparse.ArgumentParser()
parser.add_argument("modo", choices=["propor", "executar"])
parser.add_argument("--pausa-max", type=float, default=0.6,
                    help="pausa acima disso vira candidata (escolha do curso)")
parser.add_argument("--respiro", type=float, default=0.15,
                    help="parte da pausa que fica, para a fala não colar")
args = parser.parse_args()
PAUSA_MAX, RESPIRO = args.pausa_max, args.respiro

dados = json.loads(TRANSCRICAO.read_text(encoding="utf-8"))
palavras = [w for w in dados["words"] if w["type"] == "word"]

def limpa(t):
    return t.strip(" .,!?;:").lower()

def ts(seg):
    ms = round(seg * 1000)
    h, ms = divmod(ms, 3_600_000)
    m, ms = divmod(ms, 60_000)
    s, ms = divmod(ms, 1000)
    return f"{h:02}:{m:02}:{s:02},{ms:03}"

def duracao(caminho):
    saida = subprocess.run(["ffprobe", "-v", "error", "-show_entries", "format=duration",
                            "-of", "csv=p=0", caminho], capture_output=True, text=True, check=True)
    return float(saida.stdout)

if args.modo == "propor":
    cortes = []
    for a, b in zip(palavras, palavras[1:]):
        if b["start"] - a["end"] > PAUSA_MAX:
            cortes.append({"tipo": "pausa", "inicio": round(a["end"] + RESPIRO, 3),
                           "fim": round(b["start"] - 0.05, 3), "contexto": f"{a['text']} ... {b['text']}"})
        if limpa(a["text"]) and limpa(a["text"]) == limpa(b["text"]):
            cortes.append({"tipo": "repeticao", "inicio": a["start"], "fim": b["start"],
                           "contexto": f"{a['text']} {b['text']}"})
    # Retake: a mesma sequência de três palavras recomeça logo adiante (frase refeita).
    chaves = [limpa(w["text"]) for w in palavras]
    for i in range(len(palavras) - 3):
        trio = chaves[i:i + 3]
        for j in range(i + 3, min(i + 15, len(palavras) - 2)):
            if all(trio) and chaves[j:j + 3] == trio:
                cortes.append({"tipo": "retake", "inicio": palavras[i]["start"], "fim": palavras[j]["start"],
                               "contexto": " ".join(w["text"] for w in palavras[i:j + 3])})
                break
    cortes.sort(key=lambda c: c["inicio"])
    for c in cortes:
        c["aprovado"] = False
        print(f"{c['tipo']:10} {ts(c['inicio'])} -> {ts(c['fim'])}  {c['contexto']}")
    CORTES.parent.mkdir(exist_ok=True)
    CORTES.write_text(json.dumps(cortes, ensure_ascii=False, indent=2), encoding="utf-8")
    print(f"{len(cortes)} candidatos em {CORTES}, nenhum aprovado ainda.")

elif args.modo == "executar":
    aprovados = sorted((c for c in json.loads(CORTES.read_text(encoding="utf-8"))
                        if c["aprovado"]), key=lambda c: c["inicio"])
    unidos = []                                   # junta cortes que se sobrepõem
    for c in aprovados:
        if unidos and c["inicio"] <= unidos[-1][1]:
            unidos[-1][1] = max(unidos[-1][1], c["fim"])
        else:
            unidos.append([c["inicio"], c["fim"]])

    total, cursor, trechos = duracao(BRUTO), 0.0, []
    for ini, fim in unidos:                       # trechos mantidos = complemento dos cortes
        if ini - cursor > 0.04:
            trechos.append((cursor, ini))
        cursor = fim
    if total - cursor > 0.04:
        trechos.append((cursor, total))

    partes = [f"[0:v]trim=start={a:.3f}:end={b:.3f},setpts=PTS-STARTPTS[v{i}];"
              f"[0:a]atrim=start={a:.3f}:end={b:.3f},asetpts=PTS-STARTPTS[a{i}];"
              for i, (a, b) in enumerate(trechos)]
    rotulos = "".join(f"[v{i}][a{i}]" for i in range(len(trechos)))
    filtro = "".join(partes) + f"{rotulos}concat=n={len(trechos)}:v=1:a=1[v][a]"
    Path("renders").mkdir(exist_ok=True)
    subprocess.run(["ffmpeg", "-nostdin", "-y", "-i", BRUTO, "-filter_complex", filtro,
                    "-map", "[v]", "-map", "[a]", "-c:v", "libx264", "-crf", "20",
                    "-c:a", "aac", "-b:a", "192k", "renders/cortado.mp4"], check=True)

    def removido_antes(t):
        return sum(min(fim, t) - ini for ini, fim in unidos if ini < t)

    mantidas = [{"text": w["text"], "start": w["start"] - removido_antes(w["start"]),
                 "end": w["end"] - removido_antes(w["end"])}
                for w in palavras
                if not any(ini <= w["start"] and w["end"] <= fim for ini, fim in unidos)]

    blocos, atual = [], []
    for w in mantidas:
        frase = " ".join(x["text"] for x in atual + [w])
        if atual and (len(frase) > LINHA or w["start"] - atual[-1]["end"] > 0.5):
            blocos.append(atual)
            atual = []
        atual.append(w)
    if atual:
        blocos.append(atual)
    Path("legendas").mkdir(exist_ok=True)
    with Path("legendas/cortado.srt").open("w", encoding="utf-8") as srt:
        for i, b in enumerate(blocos, 1):
            srt.write(f"{i}\n{ts(b[0]['start'])} --> {ts(b[-1]['end'])}\n{' '.join(x['text'] for x in b)}\n\n")
    Path("legendas/palavras_cortado.json").write_text(json.dumps(
        [{"text": w["text"], "startMs": round(w["start"] * 1000), "endMs": round(w["end"] * 1000)} for w in mantidas],
        ensure_ascii=False, indent=2), encoding="utf-8")
    print(f"{total:.1f} s -> {total - sum(f - i for i, f in unidos):.1f} s; legenda reajustada.")
O vídeo abaixo mostra o mesmo raciocínio na tela: as palavras do Scribe aparecem com o tempo de cada uma, as pausas longas e a repetição são marcadas e somem, e a linha do tempo encolhe sem que a fala perca o sincronismo. Observe que a palavra seguinte a um corte começa com um pequeno respiro, e não colada na anterior.
Para revisar, compare as durações com ffprobe e gere uma cópia com a legenda queimada pelos comandos da aula 04; para o Claude conferir a legenda, extraia quadros do início, do meio e do fim, como na aula 11, porque ele lê imagens, não vídeo.
Carregando a vídeo-aula: Corte por transcrição
Do bruto ao vídeo cortado: passos, segundo texto e prova
Siga os oito passos
Do bruto ao vídeo cortado e legendado em oito passos
O corte só acontece no passo 7; até lá, tudo é leitura e revisão.
Passo 1: Extraia uma cópia leve do áudio e preserve o bruto
Mono, 16 kHz, MP3 de 64 kbps, só para transcrever.
Deu certo quando: midia/raw/bruto.mp4 continua com a mesma data e o mesmo tamanho.
Erro comum: Substituir o áudio original pela cópia mono de transcrição.
Passo 2: Transcreva com scribe_v2 e language_code por
Peça timestamps_granularity igual a word e eventos sonoros.
Deu certo quando: O transcricoes/bruto.json tem words[] com start e end em cada palavra.
Erro comum: Ficar no padrão antigo scribe_v1 ou ligar no_verbatim, que apaga do texto os falsos começos.
Passo 3: Confira nomes e termos do canal
Procure as palavras de logprob baixo e os nomes de receita.
Deu certo quando: O texto corresponde ao que foi dito.
Erro comum: Reescrever o texto e perder a correspondência com o áudio.
Passo 4: Rode o propor e leia a lista de candidatos
Pausas, repetições e retakes aparecem com o tempo e o contexto.
Deu certo quando: edicao/cortes.json existe e todos os itens estão com aprovado false.
Erro comum: Aprovar tudo de uma vez sem ouvir.
Passo 5: Ouça cada candidato e aprove o que sai
Uma pausa para mostrar a textura da massa pode ser parte da explicação.
Deu certo quando: Só os cortes ouvidos estão com aprovado true.
Erro comum: Considerar toda pausa acima de 0,6 s descartável.
Passo 6: Confira o fps real do bruto
O ffprobe mostra r_frame_rate; 30000/1001 é 29,97.
Deu certo quando: Você sabe o fps e não arredonda nenhum tempo por conta própria.
Erro comum: Tratar 29,97 como 30 e acumular atraso na legenda.
Passo 7: Execute o corte e a legenda reajustada
Um filtro com trim, atrim e concat, reencodado uma vez.
Deu certo quando: renders/cortado.mp4 e legendas/cortado.srt saem da mesma lista.
Erro comum: Reaproveitar o SRT do bruto no vídeo cortado.
Passo 8: Revise início, meio e fim da cópia legendada
Assista à cópia de revisão e confira os quadros do início, do meio e do fim.
Deu certo quando: A legenda acompanha a fala do primeiro ao último minuto.
Erro comum: Conferir só a primeira frase.
No fim você tem: Um vídeo cortado, uma legenda SRT sincronizada e um JSON por palavra para legenda animada.
Peça um segundo texto com transcript_edit
Desde 28/09/2026, o Scribe v2 aceita transcript_edit: uma instrução em linguagem natural, de até 2.000 caracteres, que pede uma segunda versão do texto já reescrita, como “transforme em descrição de vídeo com lista de ingredientes e capítulos”. O resultado vem no campo edited_transcript, ao lado do texto original, e o recurso é experimental. Custa 30% a mais sobre a transcrição, com mínimo de 10 segundos cobrados por pedido, e não combina com entity_detection, entity_redaction nem use_multi_channel.
A regra que importa para esta aula: os tempos por palavra e os falantes continuam descrevendo o texto original. O edited_transcript não tem relógio, então o corte e a legenda usam words[] e a descrição e os capítulos usam o texto editado. Deu certo quando a descrição sai pronta para colar e o transcricoes/bruto.json continua intacto; o erro comum é cortar pelo texto editado e ver a legenda sair do lugar. Decida assim: precisa de descrição, resumo ou capítulos, segunda chamada com transcript_edit só no áudio já aprovado; precisa de corte, nunca. O script abaixo faz a segunda chamada e grava o texto editado em publicacao/descricao.md.
# scripts/descrever.py: segunda chamada ao Scribe, só para o texto de publicação.
# Uso, na raiz video-ia: python scripts/descrever.py audio/bruto.mp3
import sys
from pathlib import Path

from elevenlabs.client import ElevenLabs

audio = Path(sys.argv[1])
destino = Path("publicacao/descricao.md")
if destino.exists():
    raise SystemExit("Descrição já existe. Revise antes de pagar outra chamada.")
destino.parent.mkdir(exist_ok=True)

INSTRUCAO = (
    "Escreva em português do Brasil uma descrição de vídeo do YouTube com três parágrafos, "
    "uma lista de ingredientes com quantidades ditas na fala e uma lista de capítulos "
    "com o tema de cada etapa da receita. Não invente quantidades nem etapas."
)
print("Edição de transcrição: +30% sobre a base, mínimo de 10 s por pedido.")
if input("Autoriza a chamada paga? Digite SIM: ").strip() != "SIM":
    raise SystemExit("Cancelado.")

cliente = ElevenLabs()
with audio.open("rb") as arquivo:
    r = cliente.speech_to_text.convert(
        file=arquivo,
        model_id="scribe_v2",
        language_code="por",
        transcript_edit=INSTRUCAO,       # incompatível com entity_detection, entity_redaction e use_multi_channel
        diarize=False,
    )

# Os tempos de r.words continuam no texto original; aqui só o texto editado interessa.
editado = getattr(r, "edited_transcript", None)
if not editado:
    raise SystemExit("A resposta não trouxe edited_transcript; nada foi gravado.")
destino.write_text(editado, encoding="utf-8")
print(f"Descrição em {destino}. O corte segue usando transcricoes/bruto.json.")Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Prove o corte com quatro sentidos
O agente de código não assiste ao vídeo, e o método do curso Vibe Viral, do Vibehub Academy, consultado em 12/10/2026, descreve como ele edita mesmo assim, em quatro sentidos que este curso adota em palavras próprias. Ouvidos: a transcrição com tempo por palavra, que é o words[] desta aula. Olhos: quadros amostrados do vídeo para achar o rosto, decidir o enquadramento e ler a luz, como na aula 11. Mãos: a edição inteira escrita como código e renderizada, que aqui é o filtro do FFmpeg. Revisão: o resultado é retranscrito e cada trecho conferido contra o original, e é essa retranscrição que prova que nenhuma palavra sumiu no corte.
Os números que a página publica dão a escala: um Reels de 45 segundos virou 33 segundos com 17 planos, e cada Reels consome de 30 a 60 minutos de máquina. A regra para o erro de fala é a mesma do estúdio: se a pessoa errou a frase três vezes, fica a melhor tentativa, não a última. Deu certo quando a retranscrição do renders/cortado.mp4 tem as mesmas palavras do original menos as dos cortes aprovados; o erro comum é confiar na duração final como prova. O script abaixo faz a segunda transcrição e compara, antes de a montagem da aula 22 receber o arquivo.
Os quatro sentidos do agente que edita sem assistir
Cada sentido tem um arquivo que o prova; sem o arquivo, o passo não aconteceu.
Passo 1: Ouvidos: transcreva com tempo por palavra
O transcricoes/bruto.json com words[] é a única forma de o agente saber quando cada palavra foi dita.
Deu certo quando: Cada palavra tem start e end, e os nomes do canal estão certos.
Erro comum: Transcrever sem tempo e tentar cortar por frase.
Passo 2: Olhos: amostre quadros do bruto
Quadros a cada poucos segundos mostram o rosto, a luz e o que está na tela.
Deu certo quando: O agente descreve o enquadramento certo para o 9:16 sem cortar a cabeça.
Erro comum: Pedir que o agente assista ao vídeo inteiro: ele lê imagens, não vídeo.
Passo 3: Mãos: escreva a edição como código
A lista de cortes aprovada vira um filtro do FFmpeg, reencodado uma vez.
Deu certo quando: renders/cortado.mp4 e legendas/cortado.srt saem do mesmo comando.
Erro comum: Cortar à mão num editor e perder a correspondência com a lista.
Passo 4: Revisão: retranscreva o resultado e compare
Uma segunda transcrição do vídeo cortado, conferida palavra a palavra com o original menos os cortes.
Deu certo quando: A comparação não encontra palavra ausente nem repetida; a melhor tentativa de cada frase ficou.
Erro comum: Usar a duração final como prova de que o corte não comeu fala.
No fim você tem: Um vídeo cortado com prova por escrito de que nenhuma palavra fora dos cortes aprovados se perdeu.
# scripts/provar_corte.py: a revisão do agente é uma segunda transcrição, não a duração.
# Uso, na raiz video-ia: python scripts/provar_corte.py
import json
from pathlib import Path

from elevenlabs.client import ElevenLabs

def limpa(t):
    return t.strip(" .,!?;:").lower()

esperadas = [limpa(w["text"]) for w in json.loads(
    Path("legendas/palavras_cortado.json").read_text(encoding="utf-8"))]

cliente = ElevenLabs()
with Path("renders/cortado.mp4").open("rb") as arquivo:   # o Scribe aceita MP4 direto
    r = cliente.speech_to_text.convert(file=arquivo, model_id="scribe_v2",
                                       language_code="por", timestamps_granularity="word")
obtidas = [limpa(w.text) for w in r.words if w.type == "word"]

faltam = sorted(set(esperadas) - set(obtidas))
sobram = sorted(set(obtidas) - set(esperadas))
print(f"esperadas {len(esperadas)}, obtidas {len(obtidas)}")
print("faltam:", faltam[:20] or "nenhuma")
print("sobram:", sobram[:20] or "nenhuma")
Path("edicao/prova_corte.json").write_text(json.dumps(
    {"esperadas": len(esperadas), "obtidas": len(obtidas), "faltam": faltam, "sobram": sobram},
    ensure_ascii=False, indent=2), encoding="utf-8")
if faltam:
    raise SystemExit("Há palavra fora dos cortes aprovados que sumiu: ouça os trechos antes de seguir.")
Revise o corte e entregue os dados para a montagem
Se o objetivo é a legenda que destaca a palavra falada, típica de Reels que seguram a atenção nos primeiros segundos, guarde o legendas/palavras_cortado.json com startMs e endMs, porque um SRT de frases não tem o tempo de cada palavra; a animação dessa legenda é assunto da aula 22. Se houver dois falantes relevantes, ligue a diarização e confira a atribuição; se nomes importantes saírem errados, avalie keyterms antes de transcrever de novo, lembrando que acima de 100 termos cada pedido cobra no mínimo 20 segundos; se o vídeo for cortado outra vez, recalcule pela lista ou transcreva a versão nova, nunca reaproveite o SRT antigo. Entre 01/09 e 12/10/2026 nenhum concorrente lançou transcritor novo (a OpenAI não publicou novidade de transcrição e o Whisper aberto segue no large-v3-turbo), então o Scribe v2 continua a referência deste curso.
Na Cozinha da Rafa, o vídeo longo de quinta-feira tem 14 minutos de bruto. A transcrição custa cerca de US$ 0,05 (14 ÷ 60 × US$ 0,22), o propor lista 38 candidatos e Rafa aprova 31: mantém a pausa em que mostra a massa do bolo de rolo enrolando, porque ali o silêncio ensina. O mesmo JSON por palavra alimenta depois a montagem em camadas, no estilo de vídeo montado com profundidade, e os cortes 9:16 saem da mesma lista.
Guia prático: alinhar o roteiro, ocultar dado pessoal e transcrever em segundo plano
A aula transcreve o bruto para cortar. Três situações pedem outra ferramenta. Se você já tem o texto (o roteiro da narração), o alinhamento forçado devolve o tempo de cada palavra com a grafia certa. Na fala que traz telefone ou CPF, a transcrição troca o dado por uma etiqueta. E o bruto longo vai por webhook, que entrega o resultado sem o script esperar.
Funções, casos de uso e aplicações
Funções
Recursos de transcrição e alinhamento que a aula não usou
| Função ou recurso | O que faz | Quando usar | Desde |
|---|---|---|---|
| POST /v1/forced-alignment | Recebe áudio e o texto que você já tem e devolve início, fim e loss (perda) de cada palavra; arquivo abaixo de 1 GB, sem diarização | Narração gerada ou gravada a partir do roteiro | Referência de 12/10/2026 |
| entity_detection e entity_redaction com entity_redaction_mode | Detecta categorias como pii, phi e pci e troca o trecho por {REDACTED} ou pela etiqueta do tipo | Depoimento em que a pessoa fala telefone, e-mail ou documento | Referência de 12/10/2026 |
| webhook=true com webhook_id e webhook_metadata | O pedido volta na hora e o texto chega depois por webhook; metadados em JSON de até 16 KB e dois níveis | Bruto de uma hora ou fila de vários vídeos | Referência de 12/10/2026 |
| seed e temperature (0 a 2) | Repetibilidade na base do melhor esforço; temperatura alta dá saída mais variada | Comparar duas transcrições do mesmo arquivo, como na prova do corte | Referência de 12/10/2026 |
| use_multi_channel (até cinco canais) | Transcreve um falante por canal; cada canal é cobrado pela duração inteira | Podcast gravado com um microfone por pessoa | Referência de 12/10/2026 |
| source_url | Transcreve arquivo hospedado ou vídeo do YouTube e do TikTok; cloud_storage_url está obsoleto | Live já publicada que virou corte | Referência de 12/10/2026 |
| Voice Isolator (POST /v1/audio-isolation) | Separa a fala do ruído e da música, a US$ 0,12 por minuto | Bruto gravado na cozinha com exaustor ligado, antes do Scribe | Preço de 12/10/2026 |
Fonte: ElevenLabs, referências Create forced alignment, Create transcript e Audio isolation; preços da API, 12/10/2026
Casos de uso
Fernanda, coordenadora de um curso técnico de enfermagem a distância em Natal
Educação
Dor
Os depoimentos de alunos usados na captação têm nomes de pacientes e telefones ditos de passagem, e a revisão manual do texto atrasa a publicação.
Solução
Transcrição com entity_detection e entity_redaction em pii e phi, modo entity_type; a legenda sai com a etiqueta, e o trecho de áudio correspondente vai para a lista de cortes.
Resultado
Confira, depoimento a depoimento, se cada etiqueta na legenda corresponde a um corte aprovado no áudio; a revisão humana ainda confere o resultado.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
André, produtor de uma empresa de webinars B2B em São Paulo
Marketing digital
Dor
Webinars de 90 minutos deixam o script de transcrição esperando e, quando a conexão cai, a transcrição se perde.
Solução
Pedido com webhook=true e webhook_metadata com o id do webinar; o receptor grava o JSON só se ele ainda não existe.
Resultado
Observe no log quantas transcrições chegam sem nenhuma nova tentativa e quanto tempo passa entre o envio e o aviso.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Na prática
Na Cozinha da Rafa, a narração do vídeo longo sai do roteiro/roteiro.md. Em vez de transcrever o audio/narracao.mp3 e corrigir a grafia de "bolo de rolo" e "mise en place", o script alinha o próprio roteiro ao áudio. Antes, tira as tags de áudio do v4 (como [excited]) e os títulos em markdown, que não foram falados. A perda (loss, o quanto o áudio deixa de confirmar a palavra) aponta as palavras puladas ou lidas diferente.
# Uso, na raiz video-ia: python scripts/alinhar_roteiro.py audio/narracao.mp3 roteiro/roteiro.md
import json, re, sys
from pathlib import Path
from elevenlabs.client import ElevenLabs

audio, roteiro = Path(sys.argv[1]), Path(sys.argv[2])
linhas = roteiro.read_text(encoding="utf-8").splitlines()
texto = " ".join(l for l in linhas if not l.lstrip().startswith("#"))   # títulos não são falados
texto = re.sub(r"\[[^\]]+\]", " ", texto)                                # tags do v4 também não
texto = re.sub(r"\s+", " ", texto).strip()

with audio.open("rb") as f:
    r = ElevenLabs().forced_alignment.create(file=f, text=texto)

palavras = [{"text": w.text, "startMs": round(w.start * 1000), "endMs": round(w.end * 1000),
             "loss": round(w.loss, 3)} for w in r.words]
Path("legendas").mkdir(exist_ok=True)
Path("legendas/palavras_roteiro.json").write_text(
    json.dumps(palavras, ensure_ascii=False, indent=2), encoding="utf-8")

print(f"{len(palavras)} palavras, perda média {r.loss:.3f}")
for p in sorted(palavras, key=lambda p: p["loss"], reverse=True)[:10]:
    print(f"{p['startMs'] / 1000:7.2f} s  {p['text']:<22} perda {p['loss']}")
Legenda com a grafia do roteiro em quatro passos
Passo 1: Confirme que o áudio veio do roteiro
Narração da aula 15 ou leitura gravada do mesmo texto.
Deu certo quando: O roteiro/roteiro.md é a versão que foi narrada.
Erro comum: Alinhar um roteiro editado depois da gravação.
Passo 2: Rode o alinhamento
python scripts/alinhar_roteiro.py audio/narracao.mp3 roteiro/roteiro.md.
Deu certo quando: legendas/palavras_roteiro.json existe, com startMs e endMs.
Erro comum: Deixar as tags [pause] e [excited] no texto enviado.
Passo 3: Ouça as dez palavras de maior perda
Vá ao segundo indicado e compare com o roteiro.
Deu certo quando: Cada palavra suspeita foi falada ou foi corrigida no roteiro.
Erro comum: Ignorar a lista e publicar legenda de palavra que não foi dita.
Passo 4: Entregue o JSON à legenda animada
O formato é o mesmo do palavras_cortado.json da aula.
Deu certo quando: A legenda da aula 22 lê o arquivo sem conversão.
Erro comum: Usar o alinhamento num bruto com entrevista: ele não separa falantes.
No fim você tem: Tempo por palavra com a grafia do roteiro e uma lista curta de trechos para ouvir.
Armadilhas
Transcrever, alinhar ou ocultar: o que evitar e o que fazer
Evite
Coluna a evitar
- Transcrever e corrigir à mão um áudio que já tem roteiro
- Achar que a etiqueta na legenda tira o dado do áudio
- Ligar use_multi_channel num arquivo estéreo comum
- Esperar o pedido síncrono de um bruto de uma hora
- Ligar entity_redaction junto do transcript_edit da aula
Prefira
Coluna recomendada
- Alinhamento forçado com o roteiro limpo de tags e títulos
- Etiqueta no texto e corte aprovado no trecho de áudio
- Multicanal só com um microfone por pessoa, sabendo que cada canal é cobrado
- webhook=true e receptor que grava só o que falta
- Duas chamadas separadas: uma para ocultar, outra para a descrição
Glossário rápido
STT (fala para texto)
Serviço que transforma áudio em texto, como um escrivão que anota o que foi dito.
Scribe v2
Transcritor da ElevenLabs (scribe_v2) que marca o segundo exato de cada palavra, com mais de 90 idiomas e diarização de até 32 falantes.
timestamp por palavra
Início e fim, em segundos, de cada palavra falada; é a ponte entre o texto e a linha do tempo do vídeo.
diarização
Separação de quem falou o quê, como etiquetar as falas de um diálogo com o nome de cada pessoa.
keyterms
Lista de até 1.000 termos, cada um com menos de 50 caracteres e no máximo cinco palavras, que o Scribe deve reconhecer, como nomes de marca e de receita; custa 20% a mais (US$ 0,05 por hora no lote) e, acima de 100 termos, cada pedido cobra no mínimo 20 segundos.
transcript_edit
Instrução em linguagem natural, de até 2.000 caracteres, que pede ao Scribe uma segunda versão do texto já reescrita; custa 30% a mais, com mínimo de 10 segundos por pedido, desde 28/09/2026.
edited_transcript
Campo da resposta com o texto reescrito pelo transcript_edit; não tem tempos por palavra, que continuam descrevendo o texto original.
SRT
Arquivo de legenda em texto com blocos numerados, cada um com início, fim e frase; traz frases, não palavras.
lista de cortes
Arquivo com os intervalos a remover do bruto, cada um aprovado por uma pessoa antes de o FFmpeg executar.
timestamps_granularity
Parâmetro do Scribe que define se o tempo vem por palavra (word) ou por caractere (character).
additional_formats
Parâmetro do Scribe que pede ao servidor arquivos extras, como SRT, TXT ou DOCX, junto com o JSON.
respiro
Pedaço da pausa que fica depois do corte para a fala não soar colada; na aula, 0,15 s.
Transcreva agora um bruto seu de dois a três minutos, rode o propor e aprove os cortes ouvindo cada um. Está pronto quando o transcricoes/bruto.json original está guardado, a lista de cortes tem só itens aprovados por você, o vídeo cortado e a legenda reajustada saem do mesmo comando e a cópia de revisão mostra a legenda no lugar no início, no meio e no fim.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code CLI: Programação com IA
- CursoAstra profundosugerido pelo grafoA quinta parte do Astra planeja o vídeo e edita o material bruto com o modelo dirigindo a ferramenta. O curso de vídeo com IA aprofunda esse trabalho com Claude Code, Codex e ElevenLabs, do roteiro à publicação. O grafo já sugeria esta ordem pela regra de entrada da trilha; com a ordem anterior curada, ela passa a ser declarada (Etapa 4, wave 3).
- CursoSetup Completo: do zero ao Claude Codesugerido pelo grafo7 capítulos de “Vídeo com IA: Claude Code, Codex e ElevenLabs” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code”.
Depois, siga para
- CursoFrontends com Vibecodingsugerido pelo grafo21 capítulos de “Frontends com Vibecoding” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoDo Agile ao Agentic Operating Modelsugerido pelo grafo5 capítulos de “Do Agile ao Agentic Operating Model” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoAgentes de IA Autônomos: Do Conceito à Produçãosugerido pelo grafo7 capítulos de “Agentes de IA Autônomos: Do Conceito à Produção” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoLLM FinOps: o custo da IA para quem assina o orçamentosugerido pelo grafo4 capítulos de “LLM FinOps: o custo da IA para quem assina o orçamento” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- SEO e GEO para PodcastsPublique o episódio com transcrição e capítulos revisadosExaminar conexões de Publique o episódio com transcrição e capítulos revisados
- Frontends com VibecodingConstruir profundidade e dirigir a montagem de vídeoExaminar conexões de Construir profundidade e dirigir a montagem de vídeo
- Astra profundoMontar um filme a partir do material disponívelExaminar conexões de Montar um filme a partir do material disponível
- Escrever bem com IACaçar os tiques de máquina e o jargãoExaminar conexões de Caçar os tiques de máquina e o jargão
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
MediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Grave a cena em tempo real e veja os quadros que se perdem
Suba as partículas, force um bloqueio de 300 ms e grave seis segundos; compare com o render quadro a quadro desta aula.
Pacote
Abrir no capítuloMontar vídeo em HTML com HyperFrames e escolher entre ele e o Remotionsem pacoteMotion
Ver agentes em paralelo trocando mensagens numa linha do tempo
Reproduza a cena, percorra o tempo pelo controle e compare o tempo de parede com a soma das barras de cada agente.
Pacote
Abrir no capítuloParalelizar cenas com subagentes sem estourar o limite das APIsmotionReact (sem dependência extra), com as APIs do Veo e do fal.ai
Prompt de vídeo em cinco camadas, pronto para a API
Escolha plano, câmera, luz, ação e áudio e copie o prompt e o JSON para o Veo ou para o fal.ai.
Pacote
Abrir no capítuloEscrever prompt de vídeo em cinco camadas e manter o personagem consistentereactReact (sem dependência extra), com o comando para o FFmpeg
Corte o vídeo apagando palavras da transcrição
Aperte as palavras para removê-las, ligue a remoção de pausas e copie o comando FFmpeg e a legenda SRT gerados.
Pacote
Abrir no capítuloRemover pausas e reenquadrar o vídeo de 16:9 para 9:16 com legenda por palavrareactReact (sem dependência extra)
Quanto custa cada etapa do seu pipeline de vídeo
Troque a ferramenta de cada etapa e o percentual de b-roll e veja qual etapa pesa no custo por minuto e por vídeo.
Pacote
Abrir no capítuloOrquestrar o pipeline com etapas idempotentes e teto de gastoreact