Frontends com Vibecoding · Capítulo 27 de 35 · 24 min
Calcular custo por tarefa e definir governança
Você mede o custo por tarefa concluída, guarda um plano B testado e cobra da tela com IA os cinco sinais que ela precisa mostrar a quem usa.
Este capítulo faz parte do curso gratuito Frontends com Vibecoding.
O tamanho do pedido pode mudar a faixa de cobrança. Na tabela da API xAI consultada em 26 de outubro de 2026, o Grok 4.6 tem tarifas diferentes a partir de 200 mil tokens de contexto. Promoções, uso de ferramentas e geração de imagens também podem acrescentar custos.
Antes de aprovar o orçamento, registre o modelo, a modalidade de uso, a data da consulta e a regra de cada cobrança. Defina um limite por tarefa e acompanhe o consumo durante a execução. A assinatura do aplicativo e os créditos de API precisam de contas separadas.
Ao terminar, você sabe quanto custa cada tarefa concluída nos modelos que a empresa usa e tem um plano B para quando um deles for aposentado ou mudar de preço. Tempo de leitura: cerca de 24 minutos, e o inventário dos modelos em uso, mais 15.
Os preços citados aqui são de 15/08/2026. Os de outubro, inclusive o do Gemini 3.8 Flash, que passou a atender as chamadas do 3.7 Flash, estão no bloco "O que mudou de agosto a outubro de 2026", mais adiante.
Uma promoção só ajuda o orçamento quando você conhece seu prazo. Para praticar a conta, imagine uma tarifa de US$ 0,75 de entrada e US$ 3,75 de saída por milhão de tokens, os pedaços de texto usados como unidade de cobrança. Se um contrato dobrasse esses valores ao fim da promoção, a mesma quantidade de tokens passaria a custar o dobro. Estes valores são um exemplo, não uma cotação de um modelo.
No envio em lote, as solicitações entram numa fila e podem levar mais tempo. Confira se o modelo oferece esse modo, qual é o desconto e o prazo de processamento. Um lote de descrições de produtos pode aceitar essa espera; uma resposta durante a compra pode exigir atendimento imediato.
Ver como texto
Exemplo de orçamento por milhão de tokens: tarifa promocional de 0,75 dólar de entrada e 3,75 de saída; um desconto de lote de 50% reduziria esses valores à metade; o fim de uma promoção que dobrasse a tarifa elevaria os valores para 1,50 e 7,50. Não representa a cotação de um modelo.
Na tabela global do Grok 4.6, a entrada custa US$ 2 e a saída US$ 6 por milhão de tokens abaixo de 200 mil tokens de contexto. Na faixa de contexto longo, a partir de 200 mil, as tarifas são US$ 4 e US$ 12. Cache e região têm regras próprias, que também precisam entrar na estimativa.
Um agente pode enviar partes do histórico novamente a cada solicitação. Por isso, acompanhe o tamanho do contexto efetivamente enviado, inclusive o que vier de ferramentas. Um alerta antes da mudança de faixa dá tempo para resumir o histórico ou dividir a tarefa. Não presuma que o total da conversa corresponde ao tamanho de cada requisição.
Ver como texto
Grok 4.6: abaixo de 200 mil tokens de contexto, tarifas globais de 2 dólares para entrada e 6 para saída por milhão de tokens. A partir de 200 mil, 4 e 12 dólares. Acompanhe o contexto enviado e confira também cache, região e ferramentas.
Duas cobranças ficam fora do preço por token. A primeira é a imagem. No Google, o modelo gemini-3.1-flash-image, o Nano Banana 2, cobra US$ 0,50 por milhão de tokens de entrada. A saída em texto custa US$ 3,00 por milhão e a saída em imagem custa US$ 60,00.
A saída em imagem custa 20 vezes a saída em texto, e o envio em lote corta os dois pela metade. A tabela publica o valor por peça: US$ 0,0336 por imagem de 1K no lote, ou 100 imagens de fundo por pouco mais de três dólares. Orce imagem por peça, nunca pela tarifa de token.
Ver como texto
Como a mesma chamada ao modelo de imagem do Google produz duas linhas de fatura diferentes. À esquerda, a entrada: texto e imagem enviados custam 0,50 dólar por milhão de tokens. No centro, o modelo gemini-3.1-flash-image, conhecido como Nano Banana 2. À direita, duas saídas com preços distintos na coluna padrão da tabela: a saída em texto custa 3,00 dólares por milhão de tokens e a saída em imagem custa 60,00 dólares por milhão de tokens, ou seja, vinte vezes mais dentro do mesmo modelo. Abaixo, a faixa do envio em lote registra que os dois valores de saída caem pela metade, para 1,50 dólar em texto e 30,00 dólares em imagem, e que a tabela oficial publica também o equivalente por imagem em cada resolução, por exemplo 0,0336 dólar por imagem de 1K no lote. A conclusão de orçamento é que geração de imagem precisa de linha própria, separada da geração de texto.
Ferramentas podem ter cobrança adicional aos tokens. Na tabela da API xAI consultada em 26 de outubro de 2026, busca na web e execução de código custam US$ 5 por mil chamadas. A busca no X distingue publicações e perfis: US$ 5 por mil publicações e US$ 10 por mil perfis. Confira a unidade cobrada em cada ferramenta.
Defina um teto de consumo e de chamadas por tarefa. Acompanhe o que foi executado e pare o fluxo quando atingir o limite. Um limite de chamadas complementa o limite de gasto, porque ferramentas e saídas podem ter preços diferentes.
Mantenha o nome do modelo em uma configuração central e acompanhe os avisos de descontinuação do fornecedor. Teste o substituto antes da migração; mudar o nome na configuração não garante que a integração continue compatível.
Ver como texto
Duas travas que a tabela de preço não mostra. A primeira é um contador no código que para as chamadas de ferramenta num número fixo, como 50, porque cada busca ou execução custa US$ 5 por mil. A segunda é o nome do modelo guardado numa única variável: espalhado pelo código, o desligamento do modelo vira migração de emergência; num só lugar, vira troca de dez minutos.
Antes de aprovar um lote grande, confira se a tarefa aceita espera e se o modelo oferece desconto nessa modalidade. Faça uma amostra para estimar custo, prazo e qualidade.
Configure alertas antes de mudanças de faixa e limites de gasto e de ferramentas. Registre o modelo usado e teste a alternativa prevista no plano de continuidade.
Medir quanto custa cada entrega e o que sua tela precisa mostrar
A tabela de preço revela desconto com prazo e cobrança fora do token, e a conta que decide é o custo por tarefa concluída, com plano B testado.
No Claude Opus 5, subir do esforço alto para o máximo leva o custo de uma tarefa de US$ 10,41 para US$ 17,79. São 71% de aumento pelo mesmo modelo. Custo por tarefa concluída, não o preço de tabela, decide o orçamento.
Quem paga a conta de vibecoding ou compra produto com IA precisa de três hábitos por escrito. Meça o custo por tarefa, teste um modelo substituto e exija cinco sinais na tela de qualquer produto com IA.
Ver como texto
Custo por tarefa concluída: o preço por token multiplicado pelos tokens que o serviço gasta e pelas idas e vindas até fechar. É essa conta que chega na fatura. No Claude Opus 5, subir do esforço alto para o máximo leva a tarefa de US$ 10,41 para US$ 17,79, 71% a mais.
O preço por token, que é a fatia de texto cobrada como item de nota fiscal, engana sozinho. Ele não diz quantos tokens o serviço gasta nem quantas idas e vindas leva até fechar. Custo por tarefa concluída soma as duas coisas numa conta só, e é ela que chega na fatura.
Na medição independente da Artificial Analysis, o Claude Opus 5 no esforço máximo custa US$ 17,79 por tarefa. O Claude Fable 5 custa US$ 22,30 na mesma medição, 25% a mais. Nenhuma tabela de preço por token antecipa essa distância, porque nenhuma delas conta idas e vindas.
Dentro do mesmo modelo, um botão chamado nível de esforço decide quanto ele pensa antes de responder, como o modo econômico do ar-condicionado. No Opus 5, subir do esforço alto para o máximo leva o custo de US$ 10,41 para US$ 17,79, e o tempo de 25,7 para 36,2 minutos.
São 71% de aumento por um único botão, com a tarefa terminando mais devagar. Deixe o esforço alto como padrão do dia a dia e ligue o máximo só na tarefa que já resistiu a uma tentativa.
Ver como texto
Escada de custo por tarefa concluída, com a altura de cada degrau proporcional ao valor em dólares, segundo a medição independente da Artificial Analysis no benchmark privado AA-Briefcase, apurada em 15 de agosto de 2026. Primeiro degrau, o mais baixo: Claude Opus 5 em esforço alto, 10 dólares e 41 centavos por tarefa, ou 47 por cento do máximo, com 25,7 minutos de relógio. Segundo degrau: o mesmo Opus 5 em esforço extra alto, 14 dólares e 26 centavos, ou 64 por cento do máximo, com 34,3 minutos. Terceiro degrau: o mesmo Opus 5 em esforço máximo, 17 dólares e 79 centavos, com 36,2 minutos. Quarto e mais alto degrau: trocar de modelo para o Claude Fable 5, 22 dólares e 30 centavos por tarefa, com tempo não publicado nessa tabela. Os três primeiros degraus são o mesmo modelo com o botão de esforço em posições diferentes.
A disponibilidade de um modelo pode mudar. Mantenha um plano de continuidade com o modelo principal, uma alternativa testada e a pessoa responsável pela troca. Confira os avisos oficiais de descontinuação e a compatibilidade da integração.
O plano cabe em um ROTEAMENTO.md, um arquivo com uma linha por tipo de trabalho. Para tarefas interativas, compare o tempo até a primeira resposta útil. Para tarefas que podem esperar, avalie o processamento em lote. Em decisões difíceis, aumente o esforço quando um teste demonstrar ganho suficiente para justificar o custo.
Registre o resultado da comparação, a data e os limites do teste. Reveja a alternativa quando houver mudança de modelo, preço ou comportamento que afete o trabalho.
Ver como texto
O ROTEAMENTO.md em quatro linhas, uma por tipo de trabalho: o que você espera na tela vai para o modelo mais rápido e barato em esforço baixo; o que pode esperar horas vai para o envio em lote, que custa metade; arquitetura ou migração grande vai para o modelo mais caro em esforço máximo, com 36,2 minutos reservados; o resto fica no modelo do meio em esforço alto.
A terceira frente é a tela do produto com IA, comprado ou construído. O manual de frontend consolida cinco padrões de Agent UX (a interface de um programa que age sozinho, como o painel do piloto automático). São eles: plano visível antes da execução, uso de ferramentas exposto, memória exibida, acompanhamento multietapa e rota clara de recuperação de erro.
Os cinco resolvem o mesmo problema: um agente que age no escuro perde a confiança de quem usa no primeiro erro. Exija os cinco em qualquer produto em que o agente escreve, envia ou apaga algo em seu nome. Um chat que só responde perguntas dispensa o plano e o acompanhamento, e os outros três continuam valendo.
Quando o produto não oferece os cinco, o plano B é o mais simples. O agente escreve o plano em texto antes de agir e pede um "ok" seu, e cada ação vira uma linha de registro visível. A armadilha mais comum é o relógio girando sozinho: ninguém sabe o que está sendo feito, e o cancelamento chega tarde.
| Padrão | Como aparece na tela | Sem ele |
|---|---|---|
| Plano visível antes da execução | Lista numerada do que o agente vai fazer, com botão de aprovar antes do primeiro passo | A ação errada já aconteceu quando você lê |
| Uso de ferramentas exposto | Linha do tipo "consultou o cadastro" ou "abriu a planilha" a cada chamada | Você não sabe de onde saiu a resposta |
| Memória exibida | Painel com o que o agente guardou sobre você, editável e apagável | Ele repete um dado velho e você não descobre |
| Acompanhamento multietapa | Lista com "passo 3 de 7" e o que já foi concluído | Só um relógio girando, sem ideia do tempo |
| Rota clara de recuperação de erro | Mensagem que diz o que falhou e botões de tentar de novo, pular ou desfazer | O erro trava a tarefa inteira |
Fonte: Manual de referência Recursos de frontend moderno, edição setembro de 2026, seção 24
Um agente que responde aos contatos do site precisa mostrar o plano antes de enviar, numa frase do tipo "vou mandar 40 mensagens a estes contatos". Precisa mostrar também a ferramenta que consultou e o que guardou sobre cada pessoa. Sem esses sinais, a mensagem errada sai para 40 pessoas antes de você ler a primeira linha.
Meça uma tarefa sua em esforço alto e em máximo antes de fixar o padrão. Escreva o ROTEAMENTO.md com uma linha por tipo de tarefa e teste o substituto uma vez por mês. Abra a tela do seu produto com IA e marque os cinco padrões; o que faltar vira pedido para quem constrói ou pergunta para quem vende.
Guia prático: montar o custo de uma entrega de vídeo antes de prometer volume
Vídeo editado por agente parece custar só a assinatura, e a conta real tem quatro parcelas. O curso de edição estudado em 07/10/2026 mostra cada uma com número.
A primeira é a transcrição, paga por tempo de áudio num serviço externo; no teste do material, 85 segundos de fala saíram transcritos em 3 segundos. O preço muda, então confira na página pública de preços da ElevenLabs no dia em que montar a conta. A segunda é o tempo de máquina. O vídeo de 25 minutos do autor levou cerca de 5 horas de computador ligado. O render 4K de um vídeo de 11 minutos levou 13 minutos num notebook de 16 GB, e cada processo de render em 4K ocupa cerca de 5 GB de memória: três ao mesmo tempo esgotaram a memória da máquina. O material pede também 30 GB livres em disco.
A terceira é a assinatura do agente, com a janela de uso que ela permite. A quarta, que quase ninguém soma, são as suas horas de revisão: assistir inteiro, anotar e conferir o checklist. Com essas quatro parcelas na mesa, você sabe quantos vídeos por semana uma máquina entrega antes de prometer volume a um cliente.
Conta de uma entrega de vídeo: [nome do vídeo]

Duração do bruto: [minutos]
Transcrição: [minutos de áudio] x [preço por hora da página do dia] / 60 = [valor]
Máquina: [horas de computador ocupado], [GB de memória por render] x [renders ao mesmo tempo]
Assinatura: [valor mensal] / [entregas no mês] = [valor por entrega]
Imagens geradas: [quantidade] x [preço por imagem do dia] = [valor]
Revisão humana: [horas] x [valor da sua hora] = [valor]

Custo por entrega: [soma]
Entregas por semana nesta máquina: [horas disponíveis] / [horas de máquina por vídeo]
Da primeira entrega à promessa de volume
Cinco passos. A conta vem da sua entrega medida, não da média de outra pessoa.
Passo 1: Meça uma entrega inteira
Anote a hora de início e de fim de cada etapa num vídeo real: transcrição, edição, render e revisão. Use a mesma duração de bruto que você vai vender.
Deu certo quando: Você tem as horas de máquina e as suas horas de uma entrega real.
Erro comum: Medir com um teste de 40 segundos e projetar para vídeo de 25 minutos.
Passo 2: Confira os preços na página do dia
Abra a página pública de preços do serviço de transcrição e a do gerador de imagens, se usar. Anote o valor e a data no modelo de conta.
Deu certo quando: Cada preço da conta tem fonte e data.
Erro comum: Usar o preço que alguém citou num vídeo de meses atrás.
Passo 3: Descubra o teto da sua máquina
Veja quanta memória livre sobra com um render rodando. Com cerca de 5 GB por render 4K, uma máquina de 16 GB comporta poucos ao mesmo tempo. Rode um de cada vez até medir.
Deu certo quando: Você sabe quantos renders cabem juntos sem esgotar a memória nem o disco.
Erro comum: Abrir vários renders em paralelo para ganhar tempo e perder todos.
Passo 4: Preencha a conta do bloco acima
Some as parcelas e divida as horas disponíveis da semana pelas horas de máquina por vídeo. Esse é o volume que uma máquina entrega.
Deu certo quando: Você tem custo por entrega e entregas por semana, os dois com número.
Erro comum: Deixar a sua revisão fora da conta, como se fosse de graça.
Passo 5: Prometa com folga
Ofereça ao cliente um volume abaixo do teto calculado e um prazo que inclui uma rodada de ajuste. Refaça a conta quando mudar a duração do vídeo ou o preço de um serviço.
Deu certo quando: O volume prometido cabe na semana mesmo com uma entrega refeita.
Erro comum: Vender o teto da máquina e descobrir que um ajuste atrasa todos os outros.
No fim você tem: Um custo por entrega e um volume semanal medidos na sua máquina, com preços datados, antes de qualquer promessa.
O que mudou de agosto a outubro de 2026
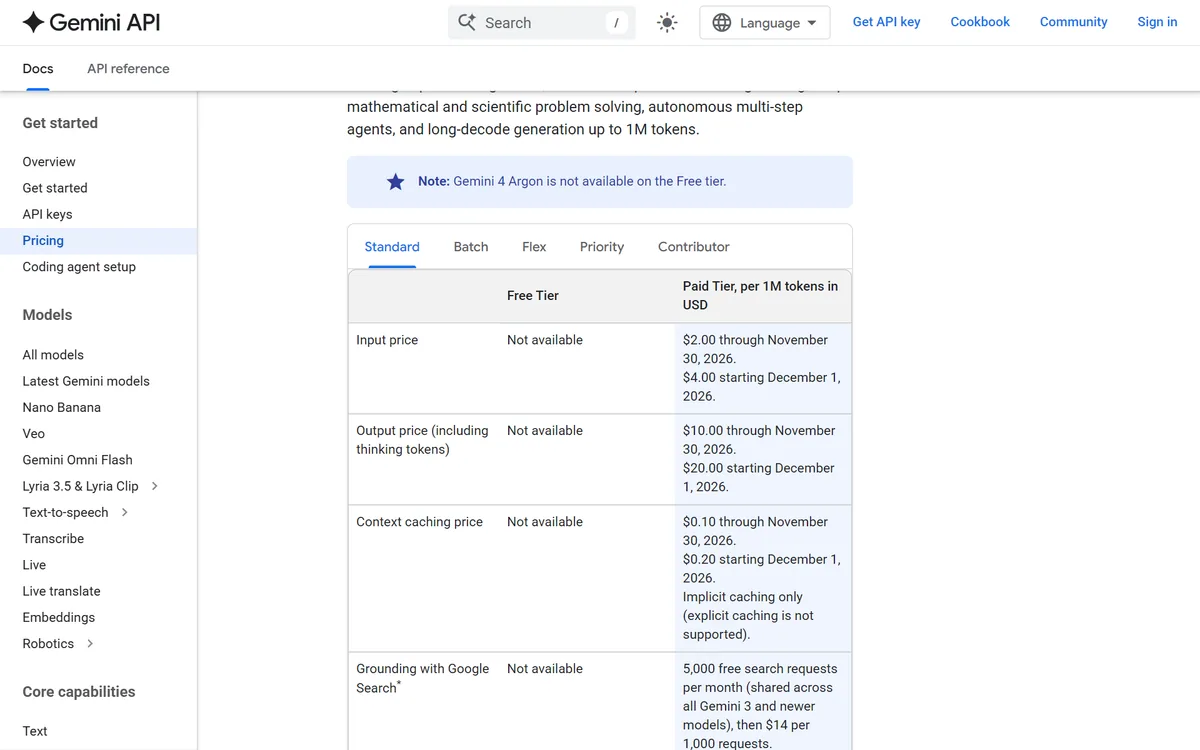
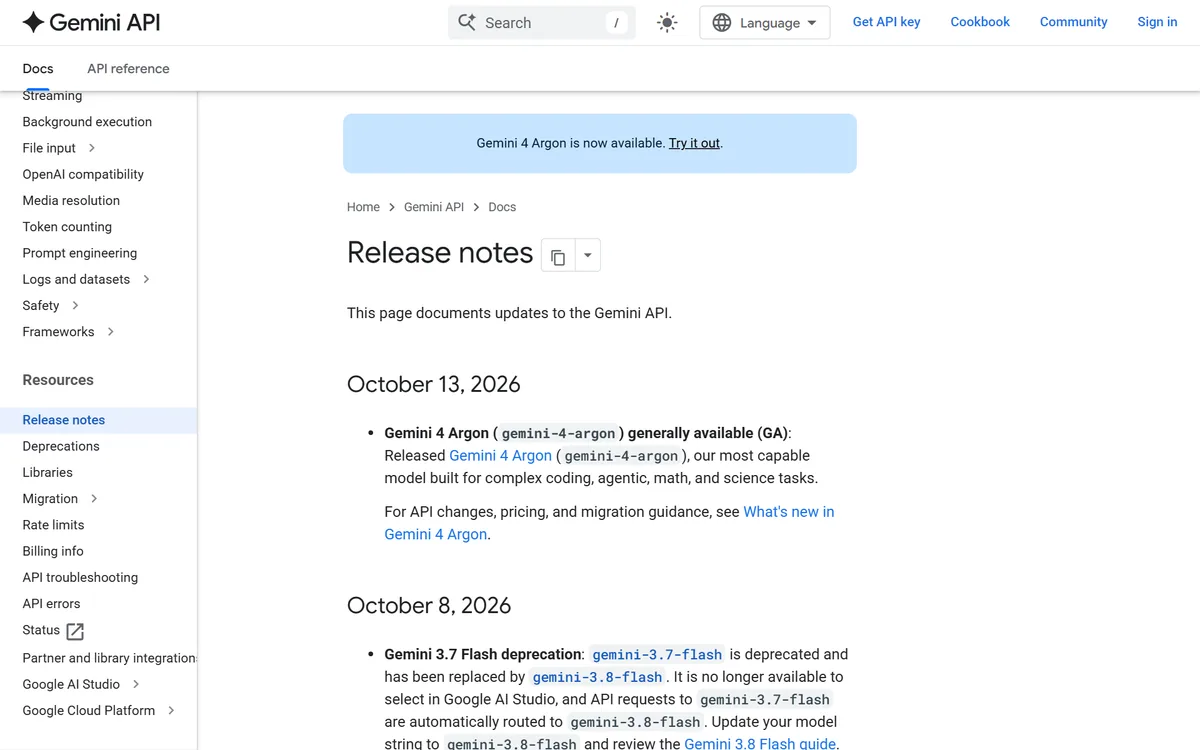
O Google tornou o Gemini 4 Argon disponível em 13/10/2026. A tabela oficial cobra US$ 2 por milhão de tokens de entrada e US$ 10 de saída até 30/11/2026, e o dobro a partir de 01/12/2026. Desde 08/10/2026, as chamadas ao Gemini 3.7 Flash, descontinuado, vão para o 3.8 Flash, que na página de preços de 24/10/2026 cobra o mesmo do exemplo central: US$ 0,75 de entrada e US$ 3,75 de saída por milhão de tokens até 31/12/2026, o dobro a partir de 2027 e metade no lote. Preço com data para dobrar e troca automática de modelo são os dois riscos a vigiar.
Ver como texto
Página de preços da API do Gemini com a nota de que o Gemini 4 Argon não está disponível no nível gratuito e a tabela do nível pago, por milhão de tokens em dólares: preço de entrada de US$ 2 até 30 de novembro de 2026 e US$ 4 a partir de 1º de dezembro de 2026; preço de saída, incluindo tokens de raciocínio, de US$ 10 até 30 de novembro e US$ 20 a partir de 1º de dezembro; cache de contexto de US$ 0,10 e depois US$ 0,20.
Ver como texto
Página de notas de versão da API do Gemini com duas entradas. Em 13 de outubro de 2026, o Gemini 4 Argon, modelo gemini-4-argon, ficou disponível para uso geral, descrito como o modelo mais capaz para programação, agentes, matemática e ciência. Em 8 de outubro de 2026, o gemini-3.7-flash foi descontinuado e substituído pelo gemini-3.8-flash, com as chamadas ao modelo antigo redirecionadas automaticamente.
Ver como texto
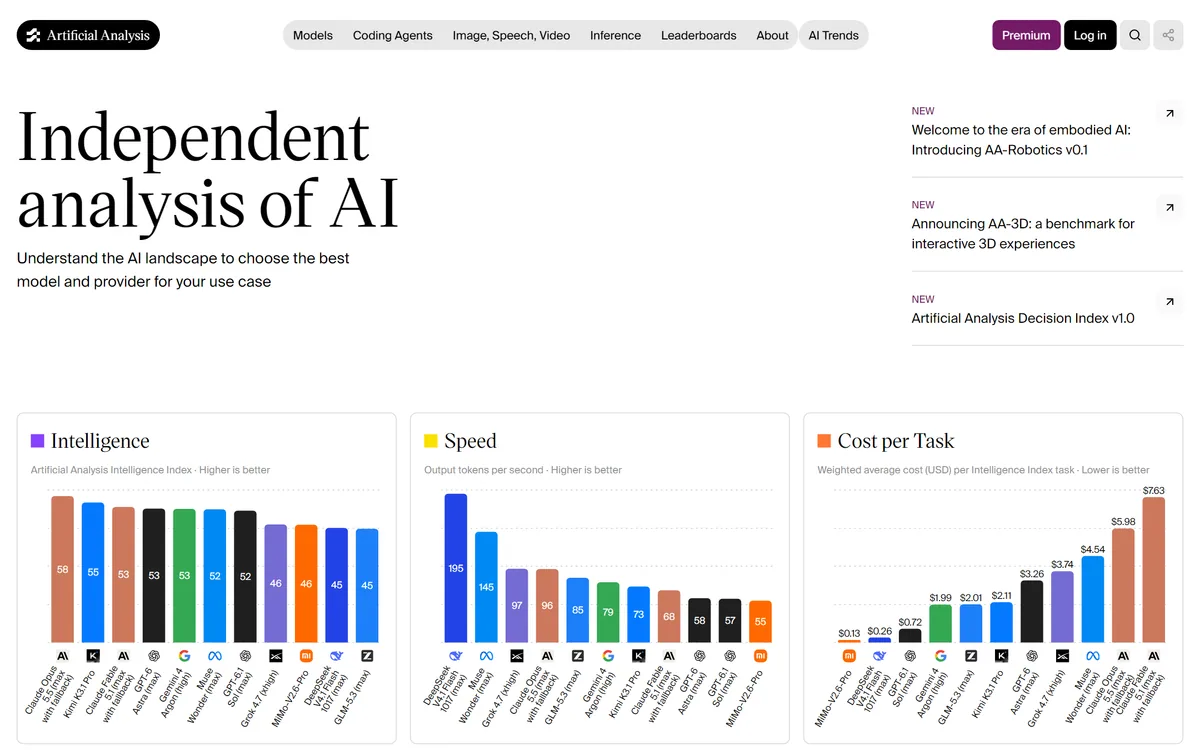
Página inicial da Artificial Analysis com três gráficos de barras. Inteligência: Claude Opus 5.5 com 58 pontos, seguido de Kimi K3.1 Pro com 55 e de Claude Fable 5.1, GPT-6 Astra e Gemini 4 Argon com 53. Velocidade em tokens de saída por segundo. Custo por tarefa, média ponderada em dólares por tarefa do índice: GPT-6.1 Sol a US$ 0,72, Gemini 4 Argon a US$ 1,99, GPT-6 Astra a US$ 3,26, Claude Opus 5.5 a US$ 5,98 e Claude Fable 5.1 a US$ 7,63.
| Modelo | Índice de inteligência | Custo por tarefa (US$) |
|---|---|---|
| Claude Opus 5.5 | 58 | 5,98 |
| GPT-6 Astra | 53 | 3,26 |
| Gemini 4 Argon | 53 | 1,99 |
| GPT-6.1 Sol | 52 | 0,72 |
O custo do Gemini 4 Argon reflete o preço de lançamento, válido até 30/11/2026.
Fonte: Artificial Analysis, gráficos da página inicial, consultados em 24/10/2026.
Faça agora: inventário de modelos e plano B
Passo 1: Liste onde a empresa usa modelo de IA por API e o nome exato do modelo em cada uso.
Deu certo quando: Uma tabela com sistema, modelo e responsável, como "atendimento, gemini-3.7-flash, Ana".
Passo 2: Para cada modelo, abra a página de notas de versão do fornecedor e procure aviso de descontinuação.
Deu certo quando: Cada linha com "ativo" ou a data de desligamento.
Erro comum: Modelo já redirecionado em silêncio para outro, como o 3.7 Flash em 08/10/2026.
Passo 3: Anote toda data de mudança de preço na agenda do responsável, com 30 dias de antecedência.
Deu certo quando: Um lembrete criado para antes de 01/12/2026, se a empresa usa o Gemini 4 Argon.
Passo 4: Defina um modelo substituto para cada uso e peça um teste com cinco tarefas reais.
Deu certo quando: Um plano B testado, com taxa de acerto e custo anotados.
No fim você tem: Um inventário de modelos com data de risco e um substituto testado para cada uso.
Governança mínima de modelos de IA
Custo
0/2Continuidade
0/3Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code: do zero à prática
- Calcular o custo por tarefa e escolher o modelo pelo resultadosugerido pelo grafoApresenta o conceito “Custo por tarefa”, usado em “Calcular custo por tarefa e definir governança”.
- CursoSíntese e didática com IAsugerido pelo grafoDepois de escolher a informação essencial e desenhar hierarquia, gráficos e fluxos compreensíveis, o aluno pode aplicar esses critérios às interfaces do curso de frontend. A ponte conecta clareza da mensagem, acessibilidade e decisões de apresentação.
- CursoNode.js: JavaScript no Servidorsugerido pelo grafo9 capítulos de “Frontends com Vibecoding” usam conceitos apresentados em “Node.js: JavaScript no Servidor”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Astra profundoCalcular o custo por tarefa e escolher o modelo pelo resultadoExaminar conexões de Calcular o custo por tarefa e escolher o modelo pelo resultado
- Prompt Engineering para ExecutivosCalcular quanto custa cada tarefa antes de aprovar o orçamentoExaminar conexões de Calcular quanto custa cada tarefa antes de aprovar o orçamento
- Custos de IA e orçamentoAlém dos tokens: ferramentas e infraestruturaExaminar conexões de Além dos tokens: ferramentas e infraestrutura
- MCP para quem decideQuanto o catálogo de ferramentas cobra em cada conversaExaminar conexões de Quanto o catálogo de ferramentas cobra em cada conversa
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
Base UI
Prenda o foco num diálogo sem escrever o comportamento
Abra a janela Agendar visita, percorra os campos com Tab, feche com Esc e acompanhe no painel onde o foco está e para onde ele volta.
Pacote
Abrir no capítuloConstruir componentes, usar o registro e publicar o catálogo@base-ui/reactLucide e Iconify
Mantenha uma família de ícones coerente e nomeie cada botão
Mude tamanho, traço e cor da barra, veja o símbolo do Iconify acompanhar o Lucide e rode a auditoria de nomes acessíveis.
Pacote
Abrir no capítuloProjetar uma linguagem de ícones e ilustraçãolucide-react, @iconify/reactMotion
Testar os três sinais que autorizam o terceiro degrau
Reproduza a entrada em sequência, aperte o botão com mola e arraste o cartão; ajuste rigidez e amortecimento e veja o que muda.
Pacote
Abrir no capítuloProjetar movimento, assinatura e narrativas por rolagemmotionVidstack
Ver o que separa um player de um vídeo cru
Dê o play, troque a velocidade e ligue a legenda; o painel ao lado mostra o estado que o player publica e que a etiqueta crua esconde.
Pacote
Abrir no capítuloProjetar movimento, assinatura e narrativas por rolagem@vidstack/reactcmdk
Achar um destino entre quarenta digitando três letras
Abra a paleta, digite fat e escolha um item só pelo teclado; o painel embaixo conta o que o filtro deixou passar e quanto tempo levou.
Pacote
Abrir no capítuloConstruir formulários e estados de interaçãocmdknumber-flow
Animar indicadores que mudam ao vivo com formato pt-BR
Veja três indicadores fictícios rolarem a cada troca e compare com o número em texto puro. Pause, reinicie e observe o separador de milhar.
Pacote
Abrir no capítuloProjetar gráficos e painéis pela decisão@number-flow/reactApache ECharts
Medir o custo de desenhar 200 mil pontos com o ECharts
Troque o tipo de gráfico e o volume de pontos, leia o tempo de desenho e alterne o eixo em zero. Mude o tema do site e veja as cores refazerem.
Pacote
Abrir no capítuloProjetar gráficos e painéis pela decisãoechartsApache ECharts
Painel grande com visões coordenadas
Clique num canal para filtrar todas as visões, troque a densidade entre 6, 9 e 12 visões, alterne tema e movimento e abra a tela cheia.
Pacote
Abrir no capítuloProjetar gráficos e painéis pela decisãoechartssharp e svgo
Escolher a variante certa da imagem e conferir o teto de 150 KB
Arraste a largura da tela simulada, troque a densidade entre 1x e 2x e veja qual arquivo o navegador escolhe, quanto ele pesa e se cabe no orçamento.
Pacote
Abrir no capítuloValidar desempenho, autenticação e segurançasharp, svgoReact Flow (xyflow)
Disparar um pedido e ver o orquestrador distribuir, conferir e responder
Alterne paralelo e sequencial, ligue e desligue a verificação e use a medição real; observe o tempo de parede em cada combinação.
Pacote
Abrir no capítuloConstruir as cenas do orquestrador, do paralelismo e do robô@xyflow/reactGSAP, Web Workers e number-flow
Dividir mil tarefas entre trabalhadores reais e correr três ritmos de geração
Execute com um trabalhador, depois com quatro e oito, e compare o tempo; em seguida percorra a corrida e separe a espera inicial do ritmo.
Pacote
Abrir no capítuloConstruir as cenas do orquestrador, do paralelismo e do robôgsap, @number-flow/reactThree.js com React Three Fiber, drei, Rapier e XR
Carregar o braço robótico, ver a física trabalhar e entrar na cena com o visor
Carregue a cena pelo botão, inicie o ciclo, mostre os ângulos das juntas, troque a câmera e a velocidade; com visor, entre em realidade virtual.
Pacote
Abrir no capítuloConstruir as cenas do orquestrador, do paralelismo e do robôthree, @react-three/fiber, @react-three/drei, @react-three/rapier, @react-three/xrMotion
Ver quatro agentes em raias trocando mensagens e a revisão devolvendo um trecho
Reproduza os 60 s de modelo, percorra o tempo pelo controle e esconda as mensagens para comparar a leitura; repare no tempo de parede contra a soma.
Pacote
Abrir no capítuloEspecificar, medir e produzir as cenas da máquinamotionMediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Medir o quadro da cena e gravar seis segundos dela em vídeo
Suba as partículas, force um bloqueio de 300 ms e leia o medidor; depois grave seis segundos, veja o codec escolhido e baixe o arquivo.
Pacote
Abrir no capítuloEspecificar, medir e produzir as cenas da máquinasem pacotesigma.js, graphology com ForceAtlas2 e cosmos.gl
Ver o grafo real do curso e um grafo de milhares de nós se organizarem em aglomerados
Rode o layout no grafo real, passe o mouse pelos nós e busque uma entidade; troque para 20 mil nós e leia o medidor; depois carregue o modo massivo na placa de vídeo.
Pacote
Abrir no capítuloAnimar um grafo de conhecimento amplo em movimentosigma, graphology, graphology-layout-forceatlas2, graphology-generators, @cosmos.gl/graph