Astra profundo · Capítulo 29 de 31 · 42 min
Calcular custo e escolher modelos por resultado
Você sai com uma planilha de comparação e uma regra de escolha de modelo para as tarefas do Aurora.
Este capítulo faz parte do curso gratuito Astra profundo.
O Estúdio Aurora, caso fictício, usa IA para revisar propostas, organizar dados e construir experiências visuais. Essas tarefas exigem trabalhos diferentes, então uma escolha única de modelo pode desperdiçar oportunidades de economia ou qualidade. Você vai calcular exemplos de custo e montar uma comparação que considere o resultado aceito, incluindo revisão e novas tentativas.
Separe preço por token, custo por execução e consumo de assinatura. O preço por token entra na conta de API; a execução soma os componentes efetivamente utilizados. Uma assinatura ChatGPT ou Codex tem condições próprias de uso. A planilha desta aula trabalha com estimativas em dólares dos Estados Unidos para API, sem converter porcentagens de cota em dinheiro.
Simulação Standard: 100 mil de entrada e dez mil de saída
| Modelo | Entrada por milhão | Saída por milhão | Total estimado |
|---|---|---|---|
| GPT-6 Astra | US$ 10 | US$ 50 | US$ 1,50 |
| GPT-6.1 Sol | US$ 2 | US$ 10 | US$ 0,30 |
| GPT-6 Luna | US$ 0,10 | US$ 0,50 | US$ 0,015 |
Consumo hipotético idêntico, sem cache, ferramentas, repetições ou adicionais regionais.
Fonte: Preços da API OpenAI, consulta em 01/10/2026 (GPT-6.1 Sol lançado em 29/09/2026; GPT-6 Luna em 22/09/2026).
Há uma regra específica para contexto longo: acima de 272 mil tokens de entrada, Astra dobra a tarifa de entrada e aplica uma vez e meia à saída na requisição inteira. Na simulação com 300 mil de entrada e vinte mil de saída, a conta é US$ 6 mais US$ 1,50, totalizando US$ 7,50. A [ficha do modelo](https://developers.openai.com/api/docs/models/gpt-6-astra) documenta essa faixa.
Aprofunde as decisões desta aula
Como o preço por token chega ao custo da execução?
Na tabela Standard consultada em 01/10/2026, Astra custa US$ 10 por milhão de tokens de entrada, US$ 1 para leitura de cache, US$ 12,50 para escrita de cache e US$ 50 de saída. A [página de preços da OpenAI](https://developers.openai.com/api/docs/pricing) apresenta as categorias separadamente. Para aprender a conta, comece sem cache e sem custos de ferramentas. Resolva o primeiro exemplo com 100 mil tokens de entrada e dez mil de saída. A entrada do Astra custa US$ 1 e a saída, US$ 0,50: total de US$ 1,50. Mantendo o consumo idêntico, GPT-6.1 Sol custa US$ 0,30 e GPT-6 Luna, US$ 0,015. A tabela mostra uma simulação de preço, não uma medição de qualidade ou produtividade.
Como considerar contexto longo, cache e qualidade da entrega?
O cache muda a composição da cobrança quando partes da entrada são reaproveitadas. Registre separadamente entrada comum, leitura e escrita, usando os valores retornados pelo fluxo de faturamento. Uma instrução estável pode favorecer reutilização; uma entrada maior não se torna gratuita por ter sido enviada antes. A planilha deve refletir o que foi efetivamente cobrado. Compare agora o resultado. Use o mesmo briefing, arquivos e critérios para dois modelos, guardando todas as saídas. No Aurora, escolha uma proposta de oficina e um ajuste de layout. Anote aceitação, minutos de revisão e quantidade de tentativas. Se um resultado exige menos correções, esse ganho pode compensar o preço maior por chamada. Defina critérios de aceitação antes de comparar: adequação ao público na proposta e conclusão da jornada no layout. Benchmarks ajudam a selecionar candidatos; registre a versão do índice ao consultar a [Artificial Analysis](https://artificialanalysis.ai/models/gpt-6-astra).
Custo por peça aprovada
Em marketing, a medida útil não é o preço por token, e sim quanto custa cada peça que foi ao ar. Uma requisição com a ferramenta de imagem na API Responses cobra duas contas: os tokens do modelo principal (o Astra, que planeja) e os tokens do modelo de imagem (que renderiza). As duas aparecem no campo usage da resposta.
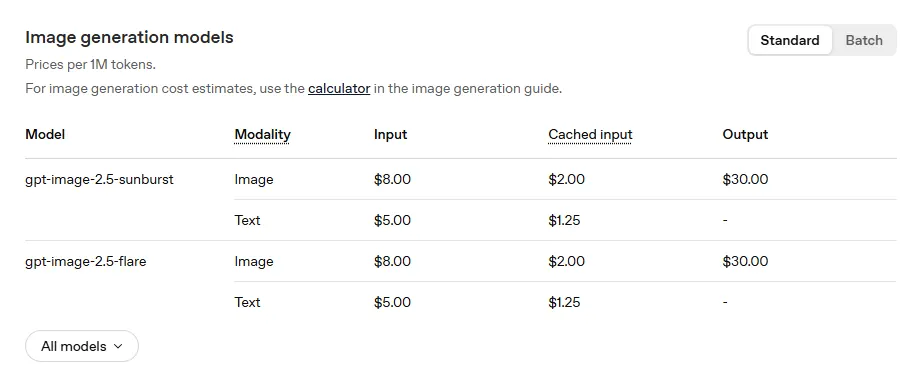
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
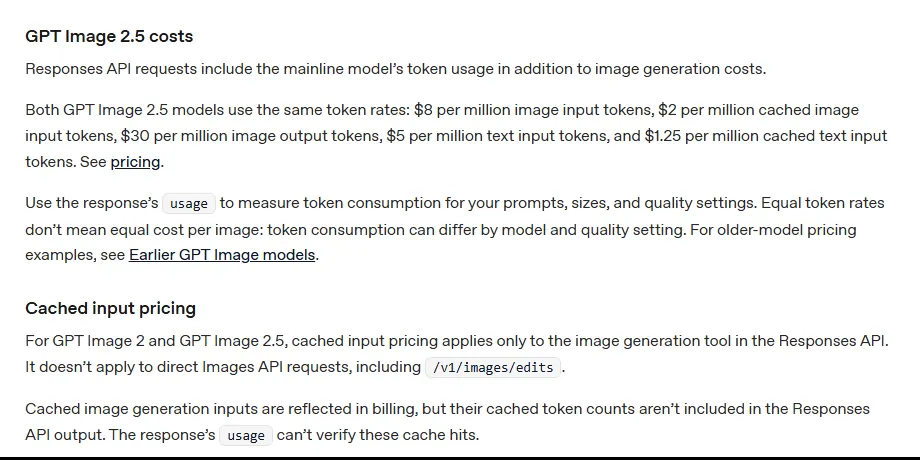
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Passo a passo: planilha de custo por peça
Use os dados das aulas de criativo e de variações. Reserve 20 minutos.
Passo 1: Registre o usage de cada chamada
Crie colunas para tokens de texto do Astra (entrada, cache, saída) e tokens de imagem (entrada, saída) por chamada.
Deu certo quando: Cada peça tem uma linha com todas as chamadas que a produziram, inclusive rascunhos descartados.
Erro comum: Contar só a chamada final; os rascunhos em Flare também entram na conta.
Passo 2: Aplique as tarifas com data
Astra: US$ 10 entrada, US$ 1 cache, US$ 50 saída por milhão. GPT Image 2.5: US$ 30 por milhão de tokens de imagem gerados, US$ 8 de imagem de entrada, US$ 5 de texto. Cite a data da consulta.
Deu certo quando: A planilha mostra o custo de cada chamada em dólares.
Passo 3: Some os extras que costumam faltar
Streaming com partial_images cobra 100 tokens de saída de imagem a mais por imagem parcial. Endpoints regionais têm acréscimo de 10% nos modelos lançados a partir de 05/03/2026.
Deu certo quando: O total bate com o valor do painel de faturamento no fim do mês.
Passo 4: Divida pelo número de peças aprovadas
Custo total do lote dividido pelas peças que foram ao ar. Compare com o custo de uma peça feita em estúdio ou por freelancer.
Deu certo quando: Um número por peça aprovada, que entra no cálculo de custo por resultado da campanha.
Passo 5: Teste um modelo mais barato no planejamento
Repita a ficha de peça com o GPT-6.1 Sol (US$ 2 e US$ 10 por milhão) e compare a taxa de aprovação. Se for igual, mantenha o Astra só para campanhas novas.
Deu certo quando: Uma regra escrita: qual modelo planeja, qual renderiza e em que qualidade.
No fim você tem: Planilha com custo por peça aprovada e uma regra de escolha de modelo por tipo de tarefa.
Quando usar Fast e Ultrafast
O modo Ultrafast vale para produção de criativos?
O Ultrafast, liberado em 29/09/2026 para o Astra (service_tier ultrafast), reduz o tempo entre tokens gerados e tem tarifa própria. Ele ajuda quando alguém espera a resposta ao vivo, como numa reunião de aprovação. Para lotes noturnos de variações, o processamento padrão ou em lote custa menos. Desde 30/07/2026, o antigo processamento Priority se chama Fast mode.
Compare modelos pelo custo da entrega que passou na sua revisão. A equipe da OpenAI comparou Astra e GPT-6.1 Sol no mesmo trabalho e encontrou diferenças de custo e cobertura. Esse resultado depende da tarefa examinada. Para marketing, repita o mesmo briefing, arquivos, ferramentas e critérios de aceite antes de escolher a configuração.
Registre modelo, esforço, tempo, correções e origem do consumo em cada tentativa. Na API, anote também o modo de processamento e as tarifas de ferramentas. Na assinatura, use os limites e créditos exibidos na conta; a calculadora Standard desta página não mede esse consumo nem a tarifa Ultrafast.
Entregue uma planilha com cálculos e uma decisão por categoria. A equipe do Aurora poderá reservar Astra para tarefas exigentes e escolher alternativas para transformações simples, conforme qualidade aceita e retrabalho medidos no piloto.
Faça agora: monte a comparação
Use 30 minutos para calcular dois cenários e desenhar um piloto pequeno.
Passo 1: Monte a conta curta
Calcule entrada e saída separadas no exemplo de 100 mil e dez mil tokens.
Deu certo quando: O total do Astra chega a US$ 1,50.
Passo 2: Aplique a faixa longa
Recalcule 300 mil de entrada e vinte mil de saída com a tarifa da requisição inteira.
Deu certo quando: O total estimado chega a US$ 7,50.
Passo 3: Defina a avaliação
Escolha uma proposta e um ajuste visual com materiais e critérios iguais para os candidatos.
Deu certo quando: A comparação mede tarefas concretas.
Passo 4: Registre a decisão
Inclua tentativas, revisão humana e resultado aceito para recomendar um modelo por categoria.
Deu certo quando: A recomendação mostra o que justifica a escolha.
No fim você tem: Planilha de custos e protocolo de comparação aplicável às tarefas do Aurora.
Preço por token e custo por resultado são medidas diferentes. A faixa longa altera a tarifa da requisição inteira. A escolha do modelo acompanha qualidade aceita e retrabalho.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoEscrever bem com IAsugerido pelo grafoAs primeiras aulas do Astra pedem um briefing com referências e dirigem cada iteração por texto. O curso de escrita ensina a decidir o que pedir, dar contexto e conferir a saída, que é a base dessas aulas. Ordem decidida quando o Astra ganhou uma página por aula (Etapa 4, wave 3), para que as 31 aulas mostrem o que estudar antes.
- CursoNode.js: JavaScript no Servidorsugerido pelo grafo4 capítulos de “Astra profundo” usam conceitos apresentados em “Node.js: JavaScript no Servidor”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Software e IA para executivosEscolher entre buscar, treinar ou rotear antes de pagar a contaExaminar conexões de Escolher entre buscar, treinar ou rotear antes de pagar a conta
- Prompt Engineering para ExecutivosCalcular o custo de uma iniciativa de IA pela tabela de preçosExaminar conexões de Calcular o custo de uma iniciativa de IA pela tabela de preços
- LLM FinOps: o custo da IA para quem assina o orçamentoModelo caro para tudo é desperdício aprovadoExaminar conexões de Modelo caro para tudo é desperdício aprovado
- Vídeo com IA: Claude Code, Codex e ElevenLabsConfigurar o Codex com GPT-6 Astra num sandbox que pede aprovaçãoExaminar conexões de Configurar o Codex com GPT-6 Astra num sandbox que pede aprovação
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.