Vídeo com IA: Claude Code, Codex e ElevenLabs · Capítulo 19 de 25 · 22 min
Escolher o modelo de vídeo certo para cada peça
Monte uma tabela de decisão com preço por segundo e prazo de cada modelo de vídeo e deixe o Claude Code consultá-la antes de gastar o primeiro centavo em API.
Este capítulo faz parte do curso gratuito Vídeo com IA: Claude Code, Codex e ElevenLabs.
Em outubro de 2026 há mais de quinze modelos de vídeo com API aberta, e o preço por segundo gerado vai de US$ 0,02 a US$ 1,50. A diferença entre um b-roll gerado de panela fervendo e a cena de abertura do vídeo não está no prompt, está no modelo escolhido. Usar o mais caro em tudo multiplica o custo da semana por cinco ou dez sem ganho que o público perceba.
Sem uma tabela de decisão, cada cena vira uma escolha no improviso, o agente chama o modelo que viu por último e a fatura chega antes da revisão. Esta aula entrega essa tabela em dois formatos: um arquivo que os scripts leem (config/modelos.toml) e uma seção curta no CLAUDE.md que o Claude Code lê antes de qualquer chamada paga. Você também calcula o custo de uma lista de cenas antes de enviar o primeiro pedido.
Separar o que está disponível do que ainda é anúncio
O inventário do que saiu do ar em setembro e outubro está na aula 1, o mapa do vídeo com IA. Para escolher modelo, valem três consequências. A OpenAI não tem mais API de vídeo, então nenhum script deste curso chama /v1/videos. No Gemini API, os ids de prévia do Veo 3.1 saem em 22/10/2026, e o projeto usa o id GA (identificador em disponibilidade geral, com prazo publicado) da Gemini Enterprise Agent Platform do Google Cloud (o antigo Vertex AI), veo-3.1-fast-generate-001, ou o substituto oficial gemini-omni-1.1-flash, que é GA no Gemini API e ainda Preview na Agent Platform (lá, gemini-omni-1.1-flash-preview). E o id GA da Agent Platform pode ser aposentado a partir de 17/11/2026, sem data fixa.
Do outro lado ficam os anúncios. O Kling 4.0 Flash abriu para assinantes Ultra anual em 28/09/2026 e o anúncio oficial saiu em 30/09, com clipes de 3 a 30 s e até 15 referências, mas em 12/10/2026 a API continua sem id nem preço: o projeto continua em kling-v3 e kling-v3-omni. O Utopai X aparece em 2º no placar e não tem API pública. Veo 4, Sora 3 e Runway Gen-5 não têm anúncio oficial.
Datas que mudam a escolha de modelo
- 30/09/2026Concluído
Kling 4.0 anunciado
Flash em acesso antecipado desde 28/09; sem id de API nem preço; siga no kling-v3.
- 01/10/2026Concluído
Grok Imagine 1.5 Lite na Runway
US$ 0,03 por segundo em 720p, de 1 a 15 s, sem referências.
- 07/10/2026Concluído
Vidu Q4 Preview ganha API
Id viduq4-preview; o preço de lançamento diverge entre as fontes.
- 12/10/2026Agora
Retrato de preços desta aula
Data que vai no cabeçalho do modelos.toml.
- 22/10/2026Previsto
Veo 3.1 preview sai do Gemini API
Use o id GA da Agent Platform ou gemini-omni-1.1-flash.
- 26/10/2026Previsto
Rotas de geração /v1 da LTX deixam de responder
Texto, imagem e áudio para vídeo, retake e extend passam para /v2; o upload segue em /v1/upload.
- 31/10/2026Previsto
HeyGen v1 e v2 saem
Avatar só por POST /v3/videos.
- 17/11/2026Previsto
Veo GA da Agent Platform pode sair
A partir desta data, sem dia marcado; revise o TOML.
Ler o placar e o preço com a data do retrato
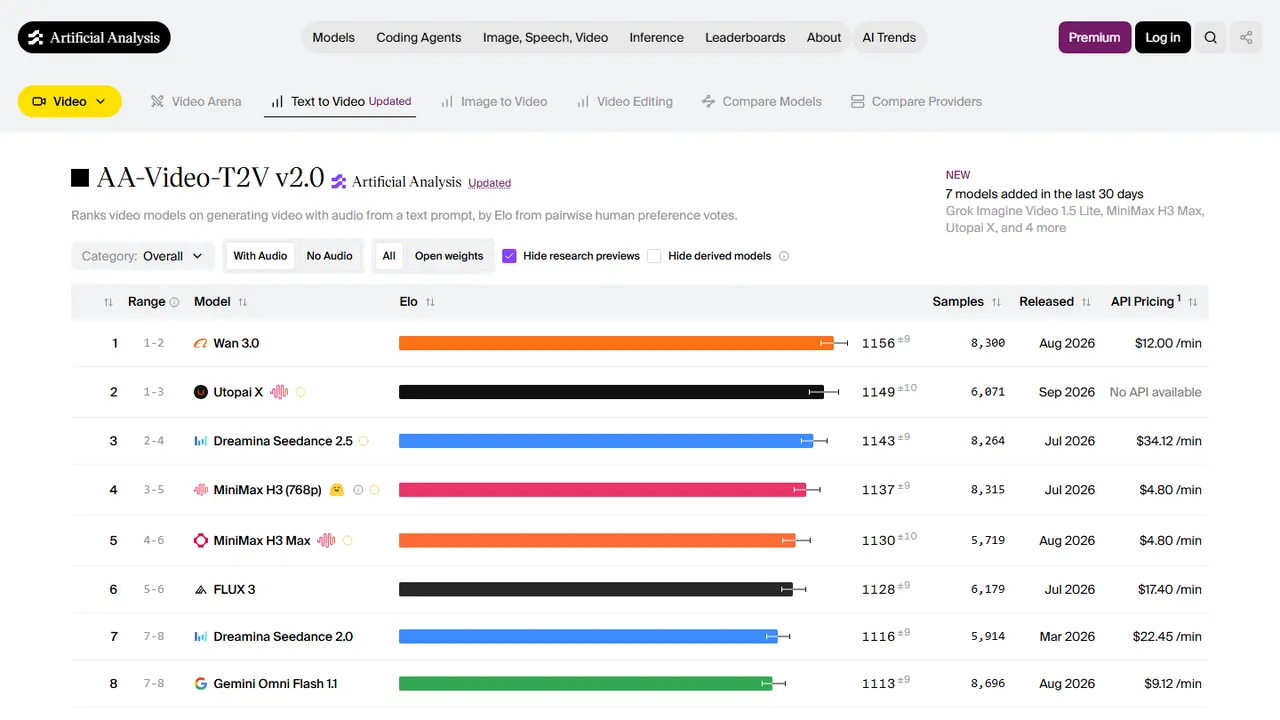
O placar Elo funciona como um campeonato de pontos corridos: em cada partida, pessoas votam às cegas em qual de dois vídeos ficou melhor, e o modelo sobe quando vence quem está acima dele. O AA-Video-T2V v2.0, da Artificial Analysis, julga texto para vídeo com áudio em 1080p, estreou em 30/09/2026 e passou de 68 mil votos. Ele serve para comparar modelos entre si, e não prevê como o seu prato vai sair. O Arena (arena.ai) usa outra escala: lá, o gemini-omni-1.1-flash estava em 1º, com 1516 pontos, em 21/09/2026.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Placar AA-Video-T2V v2.0, texto para vídeo com áudio, retrato de 12/10/2026
| Posição | Modelo | Elo |
|---|---|---|
| 1º | Wan 3.0 | 1156 |
| 2º | Utopai X (sem API pública) | 1149 |
| 3º | Seedance 2.5 | 1143 |
| 4º | MiniMax H3 768p | 1137 |
| 5º | MiniMax H3 Max | 1130 |
| 6º | FLUX 3 | 1128 |
| 7º | Seedance 2.0 | 1116 |
| 8º | Gemini Omni Flash 1.1 | 1113 |
| Referência | Kling 3.0 Omni Pro | 1015 |
No placar de imagem para vídeo (AA-Video-I2V v1.0) a ordem muda: MiniMax H3 Max 1195, H3 1181, Vidu Q4 Preview 1179 (com API desde 07/10/2026), Gemini Omni Flash 1178.
Diferenças de 10 a 20 pontos entre o 3º e o 8º lugar raramente aparecem num b-roll gerado de 6 s; a diferença de preço aparece em toda fatura. Por isso a pergunta útil é qual o modelo mais barato que passa na sua revisão de quadros, e a figura abaixo mostra quanto custa cada segundo na resolução de entrega, em 09/10/2026. O mesmo raciocínio aparece no curso de LLM FinOps em modelo caro para tudo é desperdício aprovado, e a armadilha do placar sem preço está em benchmark sem custo declarado não é evidência.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Montar a tabela de decisão por tipo de peça
Uma tabela de decisão é uma lista curta de "se a peça é deste tipo, use este modelo", como o cardápio fixo de um restaurante, que poupa a escolha a cada pedido. Os critérios são preço por segundo na resolução de entrega, duração aceita por geração, áudio nativo, número de referências, 9:16 nativo e prazo de saída. Os limites que mais pesam: o Veo 3.1 gera clipes de 4, 6 ou 8 s a 24 fps, com 1080p e 4K só em 8 s e até 3 imagens de referência, e na Agent Platform o 4K existe só no Standard (veo-3.1-generate-001), não no Fast; o Omni gera de 3 a 10 s com áudio e não aceita negative_prompt; o gen4.5 da Runway vai de 2 a 10 s, sem áudio documentado; o MiniMax H3 Max vai de 5 a 15 s em 480p ou 768p, com áudio estéreo; o Seedance 2.5 vai de 4 a 30 s com fala sincronizada; o aleph2 edita gravação real de 2 a 30 s até 1080p.
Modelo padrão por tipo de peça, preços por segundo em 09/10/2026
| Tipo de peça | Padrão e preço | Reserva e cuidado |
|---|---|---|
| B-roll gerado (3 a 8 s, sem rosto) | MiniMax-H3-Max, US$ 0,08 em 768p | grok_imagine_1_5_lite, US$ 0,03 em 720p; gemini-omni-1.1-flash ou wan3.0-video, cerca de US$ 0,10 em 720p; Wan2.2-TI2V-5B local sem tarifa |
| Produto (plano de abertura, 1080p) | veo-3.1-fast-generate-001, US$ 0,12 em 1080p (US$ 0,96 por 8 s) | gen4.5 por imagem, US$ 0,12; 1080p do Veo só em 8 s |
| Anúncio 9:16 com fala | veo-3.1-fast-generate-001 em 9:16, US$ 0,96 por 8 s | kling-v3-omni, US$ 0,140 em 1080p com áudio; Seedance 2.5 na Replicate, US$ 0,2312 em 720p |
| Avatar falando | HeyGen v3, Avatar III Digital Twin a US$ 0,60 por minuto | mirage-avatar-x, US$ 0,15 em blocos de 6 s; só com consentimento por escrito |
| Explicativo (diagrama, texto na tela) | Sem modelo de vídeo: montagem em HyperFrames ou Remotion | Um b-roll gerado pontual; texto na tela entra na montagem |
| Edição de vídeo gravado | aleph2, US$ 0,28 com mínimo de US$ 0,56 | Até 30 s por tarefa; peça para manter pessoa, roupa e movimento. Reserva: Wan 3.0, 1º no AA-Video-Editing |
Preços de tabela do Gemini API, Runway, Kling, MiniMax, Replicate, HeyGen e Mirage consultados em 09/10/2026; Wan 3.0 e Grok Imagine Lite em 12/10/2026. O preço da Agent Platform pode diferir do Gemini API.
Quatro decisões resolvem a maioria das cenas. Se a cena não mostra rosto e dura até 10 s, use MiniMax-H3-Max ou gemini-omni-1.1-flash e guarde o Veo para o plano de produto. Se a cena é a abertura 9:16 com fala, use veo-3.1-fast-generate-001 com 8 s ou kling-v3-omni em 1080p. Se você já tem a gravação e só quer trocar o fundo, não gere do zero: edite com aleph2 e escreva "Keep the person, clothing, camera motion and timing exactly the same". Se o volume passa de 20 clipes por semana e há GPU própria, teste o Wan2.2-TI2V-5B local (Apache 2.0, cerca de 720p a 24 fps) para b-roll gerado e pague API só no produto.
Reserva de b-roll e custo da lista de cenas
Pôr o Wan 3.0 e o Grok Imagine Lite na reserva
Dois modelos entram no TOML nesta revisão. O Wan 3.0 (wan3.0-video, na Model Studio da Alibaba Cloud) está em 1º no AA-Video-T2V e no AA-Video-Editing, gera até 30 s de uma vez e custa US$ 0,10 por segundo em 720p; pedido que falha não é cobrado. A tabela da Alibaba mostra esse valor com um desconto por tempo limitado e sem data de fim: orce com folga e confira a página antes de cada semana de produção. Desde 01/10/2026, a Runway vende o Grok Imagine 1.5 Lite (grok_imagine_1_5_lite) a US$ 0,03 por segundo em 720p, de 1 a 15 s, sem referência de imagem nem de áudio: é o b-roll mais barato do curso.
Seedance 2.5 e Grok Imagine também têm o maior acervo de prompts testados: 131 e 60 dos 309 prompts de vídeo da biblioteca do Vibehub Academy, e a aula 20 mostra como escrever para cada um. Se a cena não tem rosto nem referência, faça o rascunho no Grok Imagine Lite em 480p e só suba de modelo no que for aprovado. O Vidu Q4 Preview fica fora do TOML até o preço sair na doc oficial: as fontes divergem entre US$ 0,014 e 0,045 por segundo. Está certo quando custo.py aceita 20 s em wan30_alibaba e recusa 20 s em runway_grok_lite.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
A tabela vira o arquivo abaixo. Id e preço moram na configuração, nunca chumbados no script: quando sair o id do Kling 4.0, só o TOML muda.
# config/modelos.toml
# Retrato de preços e limites consultado em 2026-10-12 (fontes no rodapé da aula 19).
# Valores em US$ por segundo de vídeo gerado, na resolução indicada.
# Revisar em 2026-10-22 (Veo preview sai do Gemini API) e em 2026-11-17 (Veo GA na Agent Platform, "a partir de").
retrato = "2026-10-12"

[veo31_fast_vertex]
id = "veo-3.1-fast-generate-001"        # id GA da Agent Platform (o antigo Vertex AI); o preview do Gemini API sai em 2026-10-22
provedor = "vertex"                     # chave do script: o SDK ainda chama a Agent Platform de vertexai
preco = { "720p" = 0.10, "1080p" = 0.12 }   # vídeo com áudio; o id Fast não gera 4K
duracoes = [4, 6, 8]                    # só esses três valores
so_8s_em = ["1080p"]                    # 1080p só existe em clipes de 8 s
audio = true
negative_prompt = true
referencias_imagem = 3
pode_sair_a_partir_de = "2026-11-17"    # "or later": não é data fixa
uso = ["produto", "anuncio_9x16"]

[veo31_standard_vertex]
id = "veo-3.1-generate-001"
provedor = "vertex"
preco = { "720p" = 0.40, "1080p" = 0.40, "4k" = 0.60 }   # vídeo com áudio; 4K só neste id
duracoes = [4, 6, 8]
so_8s_em = ["1080p", "4k"]
audio = true
negative_prompt = true
referencias_imagem = 3
pode_sair_a_partir_de = "2026-11-17"
uso = ["abertura"]

[omni11_flash]
id = "gemini-omni-1.1-flash"            # GA no Gemini API; na Agent Platform é gemini-omni-1.1-flash-preview (Preview)
provedor = "gemini"
preco = { "360p" = 0.034, "720p" = 0.10, "1080p" = 0.152, "4k" = 0.304 }
# tokens de saída por segundo x US$ 17,50 por 1M: 1.931 (360p), 5.792 (720p), 8.688 (1080p), 17.376 (4K)
duracao_min = 3
duracao_max = 10                        # cada extensão soma até 10 s; teto de 40 s
audio = true
negative_prompt = false                 # negativos vão escritos no corpo do prompt
uso = ["broll"]

[runway_gen45]
id = "gen4.5"
provedor = "runway"
preco = { "720p" = 0.12 }               # 1 crédito = US$ 0,01
duracao_min = 2
duracao_max = 10
audio = false                           # áudio nativo não consta na doc da API
negative_prompt = false
uso = ["produto"]

[runway_aleph2]
id = "aleph2"
provedor = "runway"
preco = { "1080p" = 0.28 }
minimo_usd = 0.56                       # mínimo de 56 créditos por tarefa
duracao_min = 2
duracao_max = 30                        # edita gravação real; até 5 imagens como quadros-chave
uso = ["edicao"]

[runway_seedance25]
id = "seedance2_5"
provedor = "runway"
preco = { "480p" = 0.20, "720p" = 0.30, "1080p" = 0.68 }
minimo_usd = 0.80                       # mínimo por tarefa
draft = true                            # prévia 480p promovível a 1080p em 7 dias; as duas são cobradas
duracao_min = 4
duracao_max = 30
audio = true
negative_prompt = false
uso = ["anuncio_9x16"]

[replicate_seedance25]
id = "bytedance/seedance-2.5"
provedor = "replicate"
preco = { "480p" = 0.1028, "720p" = 0.2312 }
duracao_min = 4
duracao_max = 30
audio = true
negative_prompt = false
uso = ["broll", "anuncio_9x16"]

[fal_kling_v3_pro]
id = "fal-ai/kling-video/v3/pro/text-to-video"
provedor = "fal"
preco = { "padrao" = 0.168 }            # página do modelo: 0,112 sem áudio e 0,168 com áudio; rode get_pricing antes
audio = true
negative_prompt = false
uso = ["anuncio_9x16"]

[minimax_h3_max]
id = "MiniMax-H3-Max"
provedor = "minimax"
preco = { "480p" = 0.05, "768p" = 0.08 }
duracao_min = 5
duracao_max = 15
audio = true
negative_prompt = false
referencias_gratis = 2                  # 9 imagens no máximo; da 3a em diante, US$ 0,074 cada
preco_referencia_extra = 0.074          # no MiniMax-H3 (sem Max) são 5 grátis e US$ 0,04 a partir da 6a
uso = ["broll"]

[mirage_avatar_x]
id = "mirage-avatar-x"
provedor = "mirage"
preco = { "720p" = 0.15 }
bloco_s = 6                             # cobrança arredondada em blocos de 6 s
duracao_min = 1
duracao_max = 60
uso = ["avatar"]                        # só com consentimento por escrito da pessoa

[wan30_alibaba]
id = "wan3.0-video"                     # Model Studio da Alibaba Cloud; 1º no AA-Video-T2V e no AA-Video-Editing
provedor = "alibaba"                    # fora do gerar_video.py da aula 21; a Runway revende como wan3 pelo mesmo preço em créditos
preco = { "480p" = 0.05, "720p" = 0.10, "1080p" = 0.20 }   # desconto por tempo limitado, sem data de fim na tabela
duracao_max = 30                        # até 30 s numa geração
falha_cobrada = false                   # pedido que falha não é cobrado
uso = ["broll", "edicao"]

[runway_grok_lite]
id = "grok_imagine_1_5_lite"            # Runway, desde 2026-10-01; o mais barato do curso
provedor = "runway"                     # texto para vídeo: envie por /v1/text_to_video, como o seedance_rascunho.sh
preco = { "480p" = 0.02, "720p" = 0.03, "1080p" = 0.14 }   # 1080p por upscale
duracao_min = 1
duracao_max = 15
referencias_imagem = 0                  # não aceita referência de imagem nem de áudio
uso = ["broll"]

[wan22_local]
id = "Wan2.2-TI2V-5B"
provedor = "local"
preco = { "720p" = 0.0 }                # sem tarifa; o custo é a sua GPU (Apache 2.0)
audio = false
uso = ["broll"]
Calcular o custo da lista de cenas
O custo de uma cena é a duração vezes o preço por segundo na resolução pedida, somado ao mínimo por tarefa (valor cobrado mesmo em clipe curto, como a taxa mínima de um táxi), às referências cobradas e, no modo rascunho do Seedance na Runway, à prévia em 480p, que também é paga. Nenhum fabricante publica custo por minuto de vídeo final: a conta é sua e precisa ser feita antes do envio. O curso de prompt avançado mostra a mesma disciplina em calcular o custo de uma iniciativa pela tabela pública.
A lista de cenas fica em storyboard/cenas_video.json, com uma entrada por cena: {"id": "c01", "tipo": "produto", "modelo": "veo31_fast_vertex", "duracao_s": 8, "resolucao": "1080p"}. O script lê as duas pontas, recusa duração ou resolução que o modelo não aceita e para quando o total passa do teto.
"""custo.py: estima o custo de storyboard/cenas_video.json com os preços de config/modelos.toml.

Uso:  python scripts/custo.py               (teto lido de TETO_VIDEO_USD)
      python scripts/custo.py --teto 1      (teste do teto)
Sai com código 1 se alguma cena tiver aviso (modelo desligado, duração ou resolução
inválida) ou se o total passar do teto. Nenhuma API é chamada aqui.
Requer Python 3.11 ou mais novo (tomllib); o curso padroniza em 3.12.
"""
import argparse
import datetime as dt
import json
import math
import os
import sys
import tomllib

ap = argparse.ArgumentParser()
ap.add_argument("--teto", type=float, default=float(os.environ.get("TETO_VIDEO_USD", "999")))
ap.add_argument("--hoje", default=dt.date.today().isoformat(), help="data de referência AAAA-MM-DD")
args = ap.parse_args()
hoje = dt.date.fromisoformat(args.hoje)

with open("config/modelos.toml", "rb") as f:
    modelos = tomllib.load(f)
with open("storyboard/cenas_video.json", encoding="utf-8") as f:
    cenas = json.load(f)["cenas"]


def avisos_da_cena(c: dict, m: dict) -> list[str]:
    """Tudo o que impede a cena de ser gerada como está escrita."""
    av = []
    d, res = c["duracao_s"], c["resolucao"]
    if m.get("desliga_em") and dt.date.fromisoformat(m["desliga_em"]) <= hoje:
        av.append(f"{m['id']} foi desligado em {m['desliga_em']}")
    if "duracoes" in m and d not in m["duracoes"]:
        av.append(f"{d} s não é aceito por {m['id']} (aceita {m['duracoes']})")
    if "duracao_min" in m and not (m["duracao_min"] <= d <= m["duracao_max"]):
        av.append(f"{d} s fora da faixa de {m['duracao_min']} a {m['duracao_max']} s")
    if res in m.get("so_8s_em", []) and d != 8:
        av.append(f"{res} em {m['id']} só existe em clipes de 8 s")
    if res not in m["preco"]:
        av.append(f"{m['id']} não tem preço em {res} (tem {list(m['preco'])})")
    return av


def custo_da_cena(c: dict, m: dict) -> float:
    d = c["duracao_s"]
    if m.get("bloco_s"):                                   # Mirage cobra em blocos de 6 s
        d = math.ceil(d / m["bloco_s"]) * m["bloco_s"]
    minimo = m.get("minimo_usd", 0.0)
    custo = max(d * m["preco"][c["resolucao"]], minimo)    # mínimo por tarefa (Runway)
    if m.get("draft") and c.get("rascunho_antes"):         # prévia 480p + final: as duas pagam
        custo += max(d * m["preco"]["480p"], minimo)
    extras = c.get("referencias_imagem", 0) - m.get("referencias_gratis", 0)
    custo += max(0, extras) * m.get("preco_referencia_extra", 0.0)
    return round(custo, 4)


total, problemas = 0.0, []
print(f"{'cena':<6}{'modelo':<42}{'s':>4}{'res':>8}{'US$':>8}")
for c in cenas:
    m = modelos.get(c["modelo"])
    if m is None:
        problemas.append(f"cena {c['id']}: '{c['modelo']}' não existe em modelos.toml")
        continue
    av = avisos_da_cena(c, m)
    if av:
        problemas += [f"cena {c['id']}: {a}" for a in av]
        continue
    custo = custo_da_cena(c, m)
    total += custo
    print(f"{c['id']:<6}{m['id']:<42}{c['duracao_s']:>4}{c['resolucao']:>8}{custo:>8.2f}")
    # aviso de prazo próximo: não reprova, só lembra de revisar
    sai = m.get("pode_sair_a_partir_de")
    if sai and (dt.date.fromisoformat(sai) - hoje).days <= 45:
        print(f"      lembrete: {m['id']} pode sair a partir de {sai}")

print(f"{'TOTAL':<60}{total:>8.2f}  (teto {args.teto:.2f})")
for p in problemas:
    print("AVISO:", p, file=sys.stderr)
if total > args.teto:
    print("teto excedido", file=sys.stderr)
if problemas or total > args.teto:
    sys.exit(1)
Um segundo script procura no projeto ids que já saíram ou saem antes de novembro. Rode antes de cada semana de produção, porque script antigo copiado de outro projeto é o caminho mais comum para um id morto voltar.
#!/usr/bin/env bash
# checar_ids.sh: procura ids e rotas desligados (ou que saem antes de 01/11/2026)
# no .env, nos scripts e na configuração do projeto.
# Uso: bash scripts/checar_ids.sh    (sai com código 1 se achar algum)
set -euo pipefail

PROIBIDOS=(
  "sora-2" "/v1/videos"                                   # OpenAI: desligados em 24/09/2026
  "veo-3.1-generate-preview" "veo-3.1-fast-generate-preview"
  "veo-3.1-lite-generate-preview" "gemini-omni-flash-preview"   # Gemini API: saem em 22/10/2026
  "gen3a_turbo" "gen4_aleph"                              # Runway: desligados em 30/07/2026
  "api.ltx.io/v1/text-to-video" "api.ltx.io/v1/image-to-video"
  "api.ltx.io/v1/audio-to-video" "api.ltx.io/v1/retake"
  "api.ltx.io/v1/extend"                                  # LTX: geração /v1 morre em 26/10/2026; /v1/upload continua
  "heygen.com/v1/" "heygen.com/v2/"                       # HeyGen: v1 e v2 saem em 31/10/2026
  "scribe_v1" "eleven_turbo_v2"                           # ElevenLabs: descontinuados
)

achou=0
for id in "${PROIBIDOS[@]}"; do
  # -F: texto literal; ignora esta própria lista e as pastas midia/, renders/, node_modules/ e .venv/
  if grep -rnF --include="*.py" --include="*.ts" --include="*.sh" --include="*.toml" \
       --include="*.json" --include=".env" --exclude="checar_ids.sh" --exclude-dir="midia" \
       --exclude-dir="renders" --exclude-dir="node_modules" --exclude-dir=".venv" -- "$id" . ; then
    echo "ERRO: '$id' ainda aparece no projeto" >&2
    achou=1
  fi
done

[ "$achou" -eq 0 ] && echo "OK: nenhum id desligado ou com prazo vencido"
exit "$achou"
Deixar a tabela de decisão pronta no projeto
Python 3.12 instalado e o projeto da aula 3 aberto no terminal.
Passo 1: Crie config/modelos.toml com o bloco desta aula
Deu certo quando: python -c "import tomllib;print(len(tomllib.load(open('config/modelos.toml','rb'))))" imprime 14.
Erro comum: Python abaixo de 3.11 não tem tomllib; padronize o projeto em 3.12.
Passo 2: Escreva storyboard/cenas_video.json com as cenas do próximo vídeo
Uma entrada por cena: id, tipo, chave do modelo no TOML, duração e resolução.
Deu certo quando: jq '.cenas|length' storyboard/cenas_video.json devolve o número de cenas.
Erro comum: Pedir 1080p em 6 s no Veo ou 4K no Fast; 1080p só existe em 8 s e o 4K só no Standard.
Passo 3: Rode python scripts/custo.py e leia o custo de cada cena
Deu certo quando: A saída termina numa linha TOTAL e não há nenhuma linha AVISO.
Erro comum: Somar só o preço por segundo e esquecer o mínimo por tarefa da Runway.
Passo 4: Fixe o teto da semana no .env com TETO_VIDEO_USD
Deu certo quando: Com python scripts/custo.py --teto 1 o script mostra teto excedido e sai com código 1.
Erro comum: Combinar o teto só no chat; o agente não lê conversa de sessões antigas.
Passo 5: Rode bash scripts/checar_ids.sh
Deu certo quando: A saída é OK: nenhum id desligado ou com prazo vencido.
Erro comum: Um veo-3.1-fast-generate-preview esquecido em script antigo, que para de responder em 22/10/2026.
Passo 6: Cole o prompt desta aula no Claude Code
Deu certo quando: O CLAUDE.md ganha a seção Modelos de vídeo e logs/tabela-decisao.md traz a saída dos dois scripts.
Erro comum: Deixar o agente completar preço de memória; o prompt manda citar só o que está no TOML.
Passo 7: Marque a revisão do TOML em 22/10/2026 e 17/11/2026
Deu certo quando: grep retrato config/modelos.toml mostra 2026-10-12 e a agenda tem as duas datas.
Erro comum: Copiar preço convertido em reais de blog; os fabricantes publicam em dólar.
No fim você tem: Um projeto que sabe, antes de qualquer envio, qual modelo cada cena usa e quanto a semana vai custar.
Guia prático: segunda opinião de custo antes da semana de produção
A tabela de decisão da aula envelhece em semanas. Este guia acrescenta uma conferência barata: o roteador de modelos da Runway, um serviço que escolhe o modelo por custo, latência ou qualidade, responde em modo de simulação qual modelo usaria em cada cena e quanto custaria, sem gerar nem cobrar. Você sai com o logs/router-vs-toml.md, que mostra onde o config/modelos.toml ficou caro, e com o critério para trocar uma linha do TOML só depois de um rascunho aprovado.
Funções, casos de uso e aplicações
Funções
Recursos que ajudam a revisar a escolha de modelo
| Função ou recurso | O que faz | Quando usar | Data |
|---|---|---|---|
| Model Router da Runway (configId) | Configuração salva no painel que escolhe o modelo por custo, latência ou qualidade, com lista de permitidos e bloqueados e teto de créditos por modalidade | Segunda opinião sobre a tabela de decisão, sem trocar o código de envio | 23/07/2026 |
| dryRun: true em /v1/generate/video | Devolve o modelo escolhido e o custo estimado em créditos sem gerar, guardar nem cobrar | Antes de cada semana de produção, cena a cena, ao lado do custo.py | 23/07/2026 |
| Wan 3.0 na Runway (wan3) | O mesmo Wan 3.0 cobrado em créditos: 5, 10 ou 20 por segundo em 480p, 720p e 1080p, com o crédito a US$ 0,01 | Quando a conta da Alibaba Cloud não existe ou a cota acabou; em 720p o preço empata com a tabela da Alibaba | 26/08/2026 |
| Resolução do gemini-omni-1.1-flash | 360p, 720p (padrão), 1080p e 4K; os dois últimos saem por upscaling, a ampliação da imagem depois de gerada | Para entrega em 1080p, compare com um modelo que gera 1080p nativo antes de pagar o take | 27/08/2026 |
| veo-3.1-lite-generate-preview | O Veo mais barato do Gemini API, em prévia desde 31/03/2026; sai junto com os outros previews do Veo 3.1 | Nunca como padrão do TOML; se aparecer em script antigo, troque pelo gemini-omni-1.1-flash | Sai em 22/10/2026 |
| Enhance Frame Rate da Runway (enhance_frame_rate) | Converte o vídeo para até 120 quadros por segundo, inclusive variantes NTSC, com entradas de até 300 s, a um crédito a cada 2 s | Quando um clipe gerado a 24 quadros por segundo entra no mesmo corte de uma gravação a 30 ou 60 | 17/09/2026 |
Créditos da Runway a US$ 0,01 cada, pela tabela de preços da API em 12/10/2026.
Casos de uso
Júlia, produtora de conteúdo de uma escola de idiomas em Curitiba
Educação
Dor
A tabela de decisão foi montada em setembro e ninguém sabe se o b-roll de 12 cenas por semana ainda sai pelo modelo mais barato que passa na revisão.
Solução
Roda o dry-run do roteador com preferência por custo nas 12 cenas, compara com o custo.py e gera um rascunho de 480p só nas cenas em que o roteador aponta modelo mais barato.
Resultado
Observar na sexta-feira, em logs/router-vs-toml.md, quantas cenas divergem; o TOML só muda depois que o rascunho da cena divergente passa na revisão de quadros.
Custo apurado: O dry-run não é cobrado; cada rascunho de conferência custa o de uma cena em 480p.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Agência de marketing digital em Belo Horizonte com quatro clientes de varejo
Marketing digital
Dor
O cliente não abriu conta na Alibaba Cloud, e o Wan 3.0 é a reserva de b-roll do TOML.
Solução
Cria a chave runway_wan3 no modelos.toml, com id = "wan3", provedor = "runway" e preço de 0,10 em 720p, na mesma conta Runway que já paga o gen4.5.
Resultado
No fechamento do mês, conferir se a fatura de créditos da Runway bate com a soma de custos/custos.csv para as cenas em wan3.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Na prática
Crie no Developer Portal da Runway um roteador com preferência por custo, permita só os modelos que já estão no seu TOML e ponha o teto de créditos de vídeo no valor da cena mais cara aceitável. O script abaixo manda cada cena de storyboard/cenas_video.json em modo de simulação e grava a comparação. No endpoint do roteador, a proporção vai em aspectRatio (por exemplo, 9:16); o ratio em pixels fica nos endpoints diretos.
"""router_segunda_opiniao.py: pergunta ao Model Router da Runway, em dryRun, qual modelo
e qual custo ele escolheria para cada cena, e compara com config/modelos.toml.
Uso (na raiz video-ia): RUNWAY_ROUTER_ID=<configId> python scripts/router_segunda_opiniao.py"""
import json
import os
import tomllib
from pathlib import Path

import requests

URL = "https://api.dev.runwayml.com/v1/generate/video"
CAB = {"Authorization": "Bearer " + os.environ["RUNWAYML_API_SECRET"],
       "X-Runway-Version": "2024-11-06", "Content-Type": "application/json"}
modelos = tomllib.loads(Path("config/modelos.toml").read_text(encoding="utf-8"))
cenas = json.loads(Path("storyboard/cenas_video.json").read_text(encoding="utf-8"))["cenas"]

linhas = ["| cena | TOML | US$ TOML | roteador | US$ roteador |", "|---|---|---|---|---|"]
for c in cenas:
    m = modelos[c["modelo"]]
    us_toml = max(c["duracao_s"] * m["preco"][c["resolucao"]], m.get("minimo_usd", 0.0))
    txt = Path(f"storyboard/prompts/{c['id']}.txt")      # prompt montado na aula 20
    corpo = {"configId": os.environ["RUNWAY_ROUTER_ID"], "dryRun": True,  # não gera nem cobra
             "input": {"promptText": txt.read_text(encoding="utf-8")[:1000] if txt.exists() else c["tipo"],
                       "aspectRatio": c.get("proporcao", "16:9"), "duration": c["duracao_s"]}}
    r = requests.post(URL, headers=CAB, json=corpo, timeout=60)
    if r.status_code != 200:                              # sem modelo elegível também cai aqui
        linhas.append(f"| {c['id']} | {m['id']} | {us_toml:.2f} | erro {r.status_code} | - |")
        continue
    rota = r.json().get("routing", {})
    us_rot = float(rota.get("estimatedCost", 0)) * 0.01   # créditos a US$ 0,01
    linhas.append(f"| {c['id']} | {m['id']} | {us_toml:.2f} | {rota.get('model', '?')} | {us_rot:.2f} |")

Path("logs").mkdir(exist_ok=True)
Path("logs/router-vs-toml.md").write_text("\n".join(linhas) + "\n", encoding="utf-8")
print("\n".join(linhas))
Usar o roteador como conferência da tabela de decisão
Passo 1: Crie o roteador com preferência por custo e só os modelos do seu TOML
Lista de permitidos com gen4.5, seedance2_5, wan3 e o que mais você já revisou.
Deu certo quando: O painel mostra um configId estável, que vai para o .env como RUNWAY_ROUTER_ID.
Erro comum: Deixar entrar automaticamente todo modelo novo; o roteador passaria a escolher o que você nunca revisou.
Passo 2: Rode o script com o storyboard/cenas_video.json da semana
Deu certo quando: O logs/router-vs-toml.md tem uma linha por cena e nenhuma cobrança aparece no painel.
Erro comum: Apagar o dryRun; a mesma chamada sem ele gera e cobra.
Passo 3: Gere um rascunho barato só nas cenas em que o roteador sai mais barato
Use o mesmo prompt e o modelo indicado, em 480p ou 360p.
Deu certo quando: O rascunho passa na rubrica de quadros da aula 11.
Passo 4: Atualize o TOML e rode custo.py e checar_ids.sh
Deu certo quando: O TOTAL cai e as duas saídas ficam limpas.
Erro comum: Trocar o TOML sem rascunho aprovado, só pelo número.
No fim você tem: Uma revisão semanal da tabela de decisão que custa só os rascunhos que você escolheu gerar.
Armadilhas
Roteador como dono da decisão ou como segunda opinião
Evitar
Coluna a evitar
- Mandar o take final pelo roteador e descobrir depois qual modelo rodou
- Ler 1080p do Omni como nativo; ali é ampliação
- Contar o preço do Wan 3.0 da Alibaba como fixo, sem ver o desconto temporário
- Guardar veo-3.1-lite-generate-preview como reserva barata
Recomendado
Coluna recomendada
- dryRun para comparar e envio direto pelo id fixado no TOML para o take
- Rascunho em 360p ou 480p antes de decidir a resolução de entrega
- Ter wan3 na Runway como segunda rota do mesmo modelo
- Rodar checar_ids.sh com o Lite na lista de ids que saem em 22/10/2026
Na Cozinha da Rafa, o vídeo longo da semana é o bolo de rolo, com cinco cenas geradas e a Rafa só em gravação real. A tabela de decisão gravou: abertura de produto em veo-3.1-fast-generate-001 9:16 com 8 s (US$ 0,96), massa espalhada em MiniMax-H3-Max 768p com 6 s (US$ 0,48), massa enrolada em Seedance 2.5 na Replicate com 5 s em 720p (US$ 1,16), cafezinho em Kling 3.0 Pro na fal com 5 s e áudio (US$ 0,84) e fatia no prato em gen4.5 a partir de foto, com 5 s (US$ 0,60). O custo.py imprime TOTAL 4,04 com teto de US$ 5,00. Com as cinco cenas no Veo 3.1 Standard em 1080p e 8 s, o total iria a US$ 16,00, mais de três vezes o teto.
Glossário rápido
placar Elo
Ranking montado por votos cegos entre pares de vídeos; o número sobe quando o modelo vence quem está acima dele, como num campeonato de pontos corridos.
preço por segundo
Valor cobrado por segundo de vídeo gerado, na resolução pedida; é a unidade que permite comparar fornecedores diferentes.
id GA
Identificador de modelo em disponibilidade geral, com prazo de aposentadoria publicado, ao contrário do id de prévia, que pode sair em semanas.
mínimo por tarefa
Valor cobrado mesmo quando o clipe é curto; na Runway, US$ 0,80 no Seedance 2.5 e US$ 0,56 no Aleph 2.
modo rascunho
Geração barata em 480p que pode ser promovida a 1080p depois; no Seedance 2.5 da Runway as duas gerações são cobradas.
modelos.toml
Arquivo de configuração do projeto com id, preço, durações e prazos de cada modelo de vídeo, lido pelos scripts e pelo Claude Code.
Monte hoje o modelos.toml e o cenas_video.json do seu próximo vídeo e rode os dois scripts antes de abrir qualquer painel de fornecedor. Está pronto quando custo.py termina em TOTAL abaixo do teto, checar_ids.sh responde OK e o CLAUDE.md manda o agente consultar o TOML antes de qualquer chamada paga. A aula 20 escreve o prompt de cada uma dessas cenas.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code CLI: Programação com IA
- Veja o que o Claude Code faz antes de instalarsugerido pelo grafoApresenta o conceito “Claude Code”, usado em “Escolher o modelo de vídeo certo para cada peça”.
- CursoAstra profundosugerido pelo grafoA quinta parte do Astra planeja o vídeo e edita o material bruto com o modelo dirigindo a ferramenta. O curso de vídeo com IA aprofunda esse trabalho com Claude Code, Codex e ElevenLabs, do roteiro à publicação. O grafo já sugeria esta ordem pela regra de entrada da trilha; com a ordem anterior curada, ela passa a ser declarada (Etapa 4, wave 3).
- CursoSetup Completo: do zero ao Claude Codesugerido pelo grafo7 capítulos de “Vídeo com IA: Claude Code, Codex e ElevenLabs” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code”.
Depois, siga para
- CursoFrontends com Vibecodingsugerido pelo grafo21 capítulos de “Frontends com Vibecoding” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoDo Agile ao Agentic Operating Modelsugerido pelo grafo5 capítulos de “Do Agile ao Agentic Operating Model” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoAgentes de IA Autônomos: Do Conceito à Produçãosugerido pelo grafo7 capítulos de “Agentes de IA Autônomos: Do Conceito à Produção” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoLLM FinOps: o custo da IA para quem assina o orçamentosugerido pelo grafo4 capítulos de “LLM FinOps: o custo da IA para quem assina o orçamento” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
O mesmo assunto em outros cursos
- Frontends com VibecodingConstruir profundidade e dirigir a montagem de vídeoExaminar conexões de Construir profundidade e dirigir a montagem de vídeo
- Prompt Engineering para ExecutivosEscrever o relatório de uma página para a diretoriaExaminar conexões de Escrever o relatório de uma página para a diretoria
- LLM FinOps: o custo da IA para quem assina o orçamentoModelo caro para tudo é desperdício aprovadoExaminar conexões de Modelo caro para tudo é desperdício aprovado
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
MediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Grave a cena em tempo real e veja os quadros que se perdem
Suba as partículas, force um bloqueio de 300 ms e grave seis segundos; compare com o render quadro a quadro desta aula.
Pacote
Abrir no capítuloMontar vídeo em HTML com HyperFrames e escolher entre ele e o Remotionsem pacoteMotion
Ver agentes em paralelo trocando mensagens numa linha do tempo
Reproduza a cena, percorra o tempo pelo controle e compare o tempo de parede com a soma das barras de cada agente.
Pacote
Abrir no capítuloParalelizar cenas com subagentes sem estourar o limite das APIsmotionReact (sem dependência extra), com as APIs do Veo e do fal.ai
Prompt de vídeo em cinco camadas, pronto para a API
Escolha plano, câmera, luz, ação e áudio e copie o prompt e o JSON para o Veo ou para o fal.ai.
Pacote
Abrir no capítuloEscrever prompt de vídeo em cinco camadas e manter o personagem consistentereactReact (sem dependência extra), com o comando para o FFmpeg
Corte o vídeo apagando palavras da transcrição
Aperte as palavras para removê-las, ligue a remoção de pausas e copie o comando FFmpeg e a legenda SRT gerados.
Pacote
Abrir no capítuloRemover pausas e reenquadrar o vídeo de 16:9 para 9:16 com legenda por palavrareactReact (sem dependência extra)
Quanto custa cada etapa do seu pipeline de vídeo
Troque a ferramenta de cada etapa e o percentual de b-roll e veja qual etapa pesa no custo por minuto e por vídeo.
Pacote
Abrir no capítuloOrquestrar o pipeline com etapas idempotentes e teto de gastoreact