SEO programático · ·
Priorizar páginas pela necessidade do público
Combinar perguntas reais, cobertura dos dados e sinais de demanda quando estimativas de volume de busca são insuficientes.
Este capítulo faz parte do curso gratuito SEO programático.
Estimativas de volume de busca ajudam, mas podem ser amplas demais para ordenar oportunidades próximas. No exemplo do Radar de Preço de Combustível, duas combinações de localidade e produto podem aparecer na mesma faixa de volume e atender necessidades muito diferentes.
A prioridade precisa combinar demanda observada, qualidade dos dados disponíveis, importância para o negócio e custo de manutenção. Este capítulo mostra como chegar a um primeiro lote sem tratar uma faixa estimada como uma medida exata.
Ver como texto
Comparação em duas colunas: com o parâmetro num=100 ativo, uma requisição trazia cem resultados; depois de setembro de 2025 foram necessárias dez requisições paginadas, o que multiplicou o custo de rastreio por dez e apagou as impressões que os rastreadores geravam nas posições 50 a 100 do Search Console.
O evento está documentado na análise de Tyler Gargula, da agência Locomotive, publicada em 15/09/2025. O parâmetro &num=100 permitia recuperar cem resultados numa única requisição, e era assim que praticamente todo rastreador de posição do mercado montava o top 100. Ele foi desativado.
A cadeia de consequências vale mais do que qualquer número isolado, porque é ela que explica o que você observa
- Rastreadores perderam eficiência de dez para um. Dez requisições paginadas onde antes bastava uma. Isso subiu custo de infraestrutura, e o repasse apareceu no preço das suítes e na profundidade de rastreio oferecida nos planos mais baratos.
- O Search Console ficou mais honesto e pareceu pior. As impressões que aqueles rastreadores geravam nas posições 50 a 100 simplesmente deixaram de existir. Cliques ficaram estáveis, porque nunca vieram dali.
Ver como texto
Cálculo da posição média ponderada: quinhentas impressões geradas por rastreadores na posição 67 somadas a cem impressões reais na posição 8 produzem média declarada de 57,2; removidas as impressões artificiais, a média real que sempre existiu é 8,0, marcada num eixo de posição de 1 a 100.
Repare no que a figura acima significa para um relatório: um site que viu a posição média cair de 57,2 para 8,0 em setembro de 2025 não melhorou nada. Ele parou de contar impressões que nunca tiveram um humano do outro lado. E a recíproca também vale: um site cujas impressões despencaram naquele intervalo pode não ter perdido absolutamente nada de tráfego real.
A terceira consequência é a que muda o seu método de trabalho: toda série histórica de impressões anterior a setembro de 2025 ficou incomparável com a posterior. Qualquer análise ano contra ano que atravesse essa data está errada por construção, e nenhum ajuste estatístico conserta, porque a mudança não foi de nível e sim de definição do que estava sendo contado.
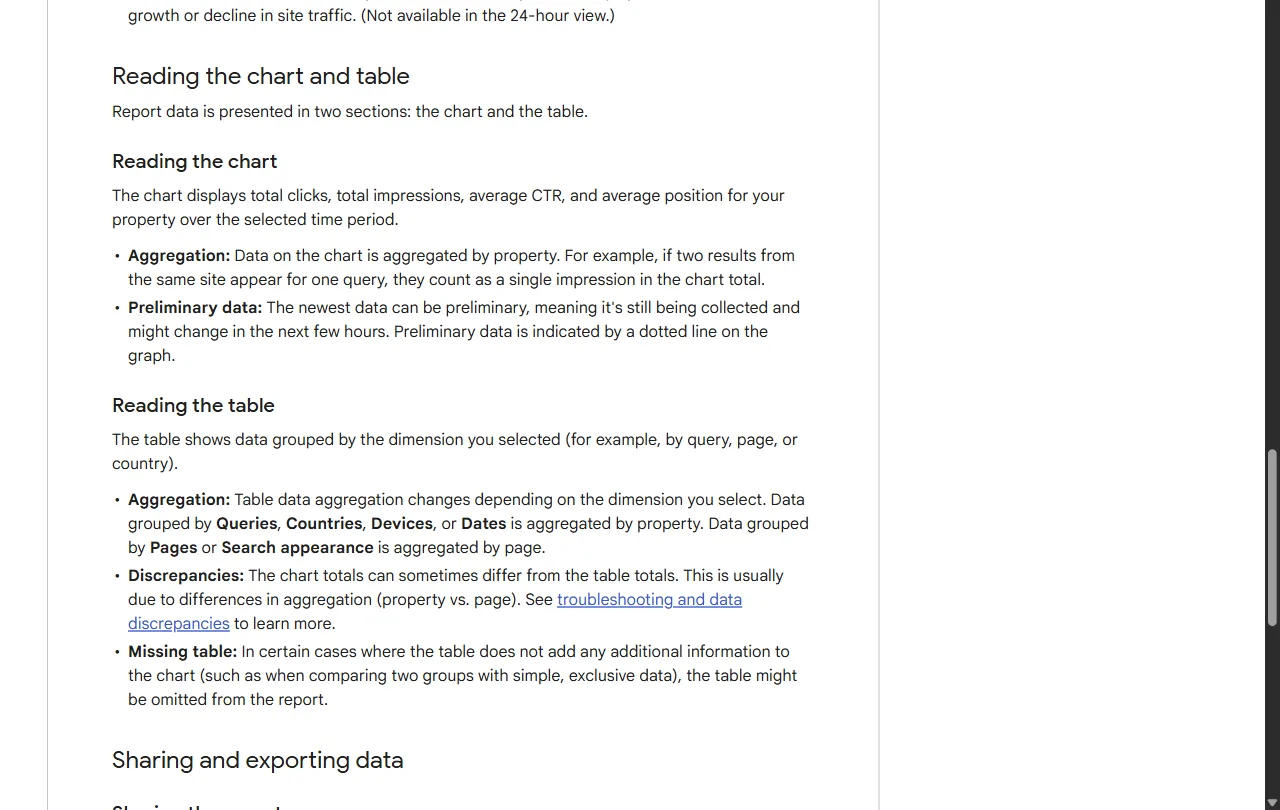
Fonte: support.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: definição dos indicadores e recursos de comparação.
Circulam dois percentuais associados a esse evento, na casa de 87,7 por cento de sites com queda de impressões e 77,6 por cento com queda em contagem de palavras-chave. Não use esses números. Não há estudo primário acessível que os sustente, e um número que ninguém consegue reabrir não pode entrar num relatório de cliente. O mecanismo está documentado e é suficiente para o argumento. Quando faltar o número, escreva o mecanismo.
Com a série de impressões partida ao meio e o volume declarado agrupado em faixas, sobra a pergunta prática: como escolher os primeiros municípios do Radar?
Antes de responder, vale registrar o que ainda existe do lado do Google. O KeywordPlanIdeaService.GenerateKeywordIdeas continua ativo e é a única fonte de volume declarada pelo próprio Google. Três características dele definem como você o usa:
- O volume vem agrupado em faixas para contas sem gasto ativo relevante, que é a situação de qualquer projeto novo.
- Os serviços de keyword planning têm rate limit mais agressivo que os demais serviços da API.
- O próprio Google recomenda cachear, porque as métricas históricas atualizam mensalmente. Consultar de novo no mesmo mês devolve o mesmo dado e gasta cota à toa.
# GenerateKeywordIdeas via REST, com a versão FIXADA no path (v24).
# Requer: OAuth2 access token, developer token aprovado e o id da conta sem hifens.
# Geo target 1001773 = Campinas, SP. Language 1014 = português.

curl -sS -X POST \
  "https://googleads.googleapis.com/v24/customers/${CUSTOMER_ID}:generateKeywordIdeas" \
  -H "Authorization: Bearer ${ACCESS_TOKEN}" \
  -H "developer-token: ${DEVELOPER_TOKEN}" \
  -H "login-customer-id: ${MANAGER_ID}" \
  -H "Content-Type: application/json" \
  -d '{
    "language": "languageConstants/1014",
    "geoTargetConstants": ["geoTargetConstants/1001773"],
    "keywordPlanNetwork": "GOOGLE_SEARCH",
    "keywordSeed": {
      "keywords": ["preco gasolina campinas", "gasolina mais barata campinas"]
    }
  }' \
  | tee cache/kwideas_campinas_2026-07.json

# O `tee` no fim não é enfeite: as métricas históricas atualizam uma vez por mês.
# Reconsultar dentro do mesmo mês devolve o mesmo dado e queima rate limit.Desde janeiro de 2026 a Google Ads API entrou em ciclo de release mensal, e cada versão maior vive cerca de um ano. Em julho de 2026 a página oficial de desativação listava v24, v23 e v22; em 26/09/2026 já lista v25, v24 e v23. Como a versão vai no path da URL, todo código que você escrever hoje quebra dentro de doze meses. A postura correta tem duas partes: fixe a versão de propósito, nunca por acidente de copiar e colar, e abra o evento de migração no calendário no mesmo dia em que escrever a integração. Descobrir o sunset pelo erro em produção é o caminho caro.
Agora o critério de priorização. Com volume declarado em faixas, agrupar consultas por semelhança de texto virou adivinhação: "preço gasolina campinas" e "gasolina mais barata campinas" são textualmente diferentes e podem ou não ser a mesma intenção. O buscador já respondeu essa pergunta, e a resposta está pública na própria SERP.
O padrão que substitui a similaridade textual é o clustering por sobreposição de SERP: duas consultas pertencem ao mesmo agrupamento quando compartilham pelo menos N URLs no top 10. A definição não depende de nenhum volume declarado, e reflete diretamente como o buscador interpreta a intenção por trás das duas consultas.
Ver como texto
Duas consultas com seus dez primeiros resultados desenhados como conjuntos sobrepostos: cada uma tem seis URLs exclusivas e as duas compartilham quatro. Numa régua de zero a dez URLs compartilhadas, o limiar de corte está em três, então o valor quatro cai na faixa que manda servir as duas consultas com uma única página.
Exemplo resolvido, com o lote do Radar. Você coletou o top 10 de seis consultas em três municípios e quer saber quantas páginas realmente precisa criar. O código abaixo roda em Python puro, sem dependência externa, e é o mesmo que você vai apontar para o arquivo real de SERPs depois.
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: filtro de pesquisa multimodal anunciado em 24/09/2026.
# clusteriza.py - agrupa consultas por sobreposição de SERP.
# Roda com Python 3 puro. Substitua SERPS pelo JSON que você coletou.

LIMIAR = 3  # número mínimo de URLs compartilhadas no top 10

SERPS = {
    "preco gasolina campinas": [
        "anp.gov.br/a", "g1.com/b", "precodoscombustiveis/c",
        "campinas.sp/d", "blog1/e", "blog2/f",
        "forum/g", "news/h", "loja/i", "mapa/j",
    ],
    "gasolina mais barata campinas": [
        "anp.gov.br/a", "g1.com/b", "precodoscombustiveis/c",
        "campinas.sp/d", "app1/k", "app2/l",
        "reddit/m", "video/n", "loja2/o", "mapa2/p",
    ],
    "preco etanol campinas": [
        "anp.gov.br/etanol", "g1.com/etanol", "etanolhoje/x",
        "campinas.sp/d", "blog3/y", "blog4/z",
        "forum2/q", "news2/r", "loja3/s", "mapa3/t",
    ],
}


def sobreposicao(a, b):
    return len(set(SERPS[a]) & set(SERPS[b]))


def agrupar(consultas, limiar):
    grupos = []
    for consulta in consultas:
        destino = None
        for grupo in grupos:
            if all(sobreposicao(consulta, membro) >= limiar for membro in grupo):
                destino = grupo
                break
        if destino is None:
            grupos.append([consulta])
        else:
            destino.append(consulta)
    return grupos


if __name__ == "__main__":
    consultas = list(SERPS)
    for a in consultas:
        for b in consultas:
            if a < b:
                print(f"{sobreposicao(a, b)} URLs em comum: {a!r} x {b!r}")
    print()
    for i, grupo in enumerate(agrupar(consultas, LIMIAR), start=1):
        print(f"pagina {i}: {grupo}")
A saída mostra 4 URLs em comum entre "preco gasolina campinas" e "gasolina mais barata campinas", e apenas 1 entre qualquer uma delas e "preco etanol campinas". Com o limiar em 3, o resultado são duas páginas, não três: uma para gasolina em Campinas, que atende as duas primeiras consultas, e outra para etanol em Campinas.
Repare no que acabou de acontecer. Você tomou uma decisão de arquitetura de URL, aquela que no Radar define se a rota é /[municipio]/[combustivel] ou algo mais granular, sem consultar volume de busca uma única vez. O critério foi o comportamento observado do buscador. E ele funciona igual em conta nova e em conta com gasto milionário.
Repita o mesmo cálculo com limiar 2, 3 e 4 antes de fixar o valor. Limiar 4 ou 5 produz agrupamentos pequenos e muitas páginas quase idênticas, que é justamente o padrão que a política de doorway descreve. Limiar 2 funde intenções que o buscador trata como distintas, e você perde cobertura. O número que você escolher precisa estar escrito no repositório junto do script, porque daqui a seis meses ninguém lembra por que eram três.
Falta o número que decide a arquitetura do projeto, e ele é o entregável deste módulo. A pergunta de compra mudou: em vez de "qual suíte eu assino", ela virou "quanto custa monitorar N páginas geradas". Nenhuma suíte responde isso por você, porque a resposta depende do seu N e da sua cadência.
A referência de preço vem da tabela oficial do DataForSEO, conferida em 26/09/2026: fila Standard a US$ 0,0006 por página de resultados com dez posições, ou US$ 0,60 por mil SERPs (SERP: a página de resultados que o buscador devolve para uma consulta).
# custo_monitoramento.py - dimensiona o projeto antes de escrever a primeira rota.

CUSTO_POR_SERP = 0.0006  # Valor histórico ilustrativo; substitua pela cotação vigente.
SEMANAS_POR_MES = 4


def custo_mensal(paginas, verificacoes_por_semana=1):
    serps = paginas * verificacoes_por_semana * SEMANAS_POR_MES
    return serps, serps * CUSTO_POR_SERP


for paginas in (500, 5_000, 20_000, 5_570):
    serps, usd = custo_mensal(paginas)
    print(f"{paginas:>6} paginas -> {serps:>7} SERPs/mes -> US$ {usd:,.2f}")

# 500 paginas ->    2000 SERPs/mes -> US$ 1,20
# 5.000 paginas ->  20000 SERPs/mes -> US$ 12,00
# 20.000 paginas -> 80000 SERPs/mes -> US$ 48,00
# 5.570 páginas -> 22280 consultas/mês -> US$ 13,37 (lote hipotético, não contagem territorial atual)Ver como texto
Tabela de quatro faixas relacionando páginas monitoradas, SERPs consultadas por mês e custo mensal na fila Standard do DataForSEO: 500 páginas custam 1,20 dólar, 5.000 páginas custam 12 dólares, 5.570 páginas custam 13,37 dólares e 20.000 páginas custam 48 dólares, com uma verificação por semana.
Cinco mil páginas verificadas uma vez por semana são 20.000 SERPs por mês, algo em torno de US$ 12. Esse número muda a conversa. Ele não é o gargalo do projeto, o que significa que a restrição real está em outro lugar: na cobertura de coleta da ANP, na densidade de informação de cada página, na capacidade de manter o dado fresco toda sexta-feira. Descobrir isso antes de escrever a primeira rota vale mais do que qualquer estimativa de tráfego.
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: perguntas de autoavaliação sobre originalidade, fontes e utilidade.
Não confunda custo de monitoramento com custo de coleta de dado. O cálculo acima cobre a verificação de posição das suas páginas, que é observabilidade. A coleta que alimenta o Radar (série histórica da ANP mais base de localidades do IBGE) é gratuita e oficial. Projetos que misturam as duas contas costumam concluir que o SEO programático é caro quando o que ficou caro foi comprar dado que já estava disponível de graça.
Etapa do Radar neste módulo: definir o recorte de lançamento. Em vez de publicar os localidades do cadastro nacional de uma vez, o primeiro lote sai por dois filtros combinados. Primeiro, cobertura real de coleta da ANP: municípios em que a série semanal tem histórico contínuo suficiente para a página ter algo a dizer. Segundo, agrupamento por sobreposição de SERP: rodar o clusteriza.py sobre uma amostra de consultas dos municípios sobreviventes para confirmar se a rota é por combustível ou se combustíveis diferentes compartilham SERP no seu recorte. Ao lado disso, o custo mensal calculado. Ao final você tem três números escritos: quantas páginas, quantas SERPs por mês, quantos dólares.
A agência apresenta o gráfico do Search Console: as impressões despencaram em poucos dias de setembro de 2025 e nunca voltaram ao patamar anterior. Os cliques, no mesmo gráfico, seguiram praticamente lineares. A posição média saiu de 57 para 9 no mesmo intervalo.
Qual é a leitura correta antes de aprovar qualquer ação corretiva?
O guia abaixo é para quem decide o recorte de lançamento e para o analista que vai executá-lo. Ele destrava uma decisão: quantas páginas o primeiro lote terá, por qual critério foram escolhidas e quanto custa acompanhá-las por mês.
Guia de implementação: priorizar o primeiro lote sem volume de busca
Cinco passos que trocam a planilha de volume por critérios que o buscador e a sua fonte de dado confirmam.
Passo 1: Filtre pela cobertura real da fonte
O analista de dados lista os registros com histórico contínuo suficiente para a página ter algo a dizer.
Deu certo quando: Cada página candidata tem dado recente e série com pelo menos algumas semanas.
Erro comum: Partir da lista completa de municípios e decidir depois o que fazer com páginas vazias.
Passo 2: Colete o top 10 de uma amostra de consultas
O analista de SEO coleta os resultados de consultas representativas de cada tipo de página.
Deu certo quando: Existe um arquivo com as dez URLs de cada consulta, datado.
Erro comum: Usar volume em faixas do Keyword Planner como critério de ordenação.
Passo 3: Agrupe por sobreposição de resultados
O analista roda o agrupamento com limiares 2, 3 e 4 e compara quantas páginas cada um produz.
Deu certo quando: O limiar escolhido está escrito ao lado do script, com a razão da escolha.
Erro comum: Escolher o limiar que gera mais páginas, o que reproduz o padrão de doorway.
Passo 4: Calcule o custo mensal de monitoramento
O analista multiplica páginas, verificações por semana e quatro semanas pelo preço por consulta do fornecedor.
Deu certo quando: O custo aparece em uma linha da proposta, separado do custo de coleta de dado.
Erro comum: Somar monitoramento e compra de dado, e concluir que o projeto é caro.
Passo 5: Congele comparações que atravessam setembro de 2025
O CMO define que relatórios de impressões só comparam períodos do mesmo lado da mudança.
Deu certo quando: Nenhum relatório compara impressões de antes e depois de setembro de 2025.
Erro comum: Ler a queda de impressões daquele mês como penalização.
No fim você tem: Três números escritos para o comitê: quantas páginas entram no primeiro lote, por qual critério e quanto custa acompanhá-las por mês.
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Cobertura da fonte | Analista de dados | Um a dois dias; sem custo de licença | Lista de registros com data da última coleta |
| Coleta do top 10 | Analista de SEO | Um dia; custo por consulta do fornecedor de SERP | Arquivo datado com dez URLs por consulta |
| Agrupamento por sobreposição | Analista de SEO | Meio dia; sem custo de licença (script próprio) | Número de páginas para os limiares 2, 3 e 4 lado a lado |
| Custo de monitoramento | Analista de SEO com o CMO | Uma hora | Linha de custo mensal separada da coleta de dado |
| Regra de comparação | CMO | Uma hora para escrever a regra | Relatórios sem comparação de impressões através de setembro de 2025 |
Peça ao time, em até duas semanas, uma página com três números: páginas do primeiro lote, SERPs monitoradas por mês e custo mensal em dólares, com o limiar de agrupamento declarado. Confira que nenhum dos três números depende de volume de busca; se depender, devolva a proposta.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSEO e GEO para quem decide
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta o conceito “SERP”, usado em “Priorizar páginas pela necessidade do público”.
- Leia o relatório sem confundir aparições, visitas e vendassugerido pelo grafoApresenta o conceito “Posição média”, usado em “Priorizar páginas pela necessidade do público”.
- Sete princípios para separar novidade real de SEO reembaladosugerido pelo grafoApresenta o conceito “SEO”, usado em “Priorizar páginas pela necessidade do público”.
- Analytics de buscaInterpretar o Search Console e investigar quedasExaminar conexões de Interpretar o Search Console e investigar quedas
- SEO e GEO para quem decideQuando duas páginas suas disputam a mesma buscaExaminar conexões de Quando duas páginas suas disputam a mesma busca
- Search Console para decisãoDescubra por que o tráfego caiu, da causa mais barata à mais caraExaminar conexões de Descubra por que o tráfego caiu, da causa mais barata à mais cara
- CRO: Otimização de Conversão e ExperimentaçãoCRO quando o topo do funil encolheuExaminar conexões de CRO quando o topo do funil encolheu
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.