Dados com Python para quem decide
Revisado em
Letramento em dados para executivos: saiba quando a pergunta pede Python e quando a planilha basta, peça a análise a um assistente de IA (Claude, ChatGPT ou Gemini no Colab) e confira cada número, reconheça gráfico enganoso e saiba o que exigir do time em APIs, SQL, relatórios automáticos e pipelines. Tudo roda no navegador, com tarefa prática e resultado esperado em cada capítulo. Atualizado em outubro de 2026, com pandas 3.1, Polars 2.0 e DuckDB 2.0.
Trilha 1Onde Python entra
Quando a planilha basta e o que muda com um notebook no navegador.
Planilha, BI ou Python: quem resolve cada pergunta
Saiba quando a planilha basta, quando o painel de BI resolve e quando a pergunta pede Python, com a pilha de dados de outubro de 2026.
Ao fim deste capítulo você olha para uma demanda de análise e diz se ela cabe na planilha, no painel de BI ou num notebook Python. Essa triagem define quanto tempo o time gasta e se o número levado à reunião pode ser refeito na semana seguinte com a mesma regra.
As bibliotecas e a pilha de dados de 2026
O capítulo 1 em vídeo: por que Python domina a ciência de dados, as seis bibliotecas do ecossistema, o fluxo da coleta à automação, as versões de pandas, Polars, DuckDB e Python no início de outubro de 2026, a ferramenta de cada tarefa de marketing e a montagem do ambiente local.
Transcrição
0:00Olá, pessoal! Vamos mergulhar direto nesta nossa análise de abertura do primeiro capítulo do curso Dados com Python.
0:07Se a rotina de quem trabalha com marketing digital por aí envolve passar o dia exportando planilhas de campanha, brigando com o GA4 ou extraindo dados sem parar do Search Console, bom, a gente sabe que chega uma hora que a planilha convencional não dá mais conta do recado, né?
0:20A ideia aqui é ser superprático. Sem ilusões, vamos olhar para o cenário técnico real e focar exatamente no que a gente precisa para começar a analisar essas informações com eficiência e, acima de tudo, segurança. O nosso mapa de hoje é bem direto.
0:35A gente passa pelo ecossistema, vê como o fluxo funciona na prática, dá uma olhada na pilha de dados exata de outubro de 2026, entende qual ferramenta usar em cada situação e fecha montando o nosso ambiente local.
0:48Então, vamos começar pela fundação do nosso trabalho e entender o porquê dessa tecnologia ter engolido o mercado. A verdade é que o Python domina a ciência de dados por um motivo muito simples.
0:59Ele entrega o ecossistema mais completo que existe para manipular, analisar e visualizar dados. Pensa assim, não é uma ferramenta só tentando fazer tudo e sendo mediana em tudo.
1:09É um conjunto de peças conectadas, onde cada uma é especialista em uma parte do processo. E olha só como essas seis bibliotecas principais se encaixam perfeitamente. A fundação de tudo é o NumPy, com aqueles arrays super eficientes e operações vetorizadas.
1:23Aí, construído bem em cima dele, vem o nosso querido Pandas, que é onde a gente lida com dados em tabela. muito parecido com a lógica das planilhas de marketing que a gente já conhece.
1:31Para a parte visual, o Matplotlib é a biblioteca tradicional para fazer os gráficos clássicos. E assim como pandas usam NumPy de base, o Seaborn roda em cima do Matplotlib para criar gráficos estatísticos bem complexos com quase nada de código.
1:44Para fechar o pacote, a gente tem a Requests, que é vital para bater em APIs e puxar dados da web, e a SQLAlchemy, que faz toda aquela ponte pesada com os bancos de dados SQL. Legal, ferramentas apresentadas, mas como elas fluem de um arquivo bruto até o painel final?
2:00O que é fascinante aqui é a fluidez. É um movimento muito natural. O trabalho nasce lá na coleta, tipo puxando os dados de uma API ou abrindo um CSV pesado. Imediatamente entra a limpeza, que é aquele momento de arrumar tipo de coluna, tratar dados faltando e limpar duplicatas.
2:16Com o dado limpinho, a gente pula para análise, que é explorar padrão, cruzar informação. Aí vem a visualização para traduzir isso em gráficos. e o grande pulo do gato, a automação, que é quando a gente transforma tudo isso num fluxo que roda sozinho.
2:32E calma, não precisa decorar toda a biblioteca agora, tá? O importante é sacar que tem uma ferramenta perfeita para cada um desses momentos. E para a gente não ficar na teoria, vamos trazer para os números exatos que estão rodando agora, em outubro de 2026.
2:46Essas aqui são as versões que a gente vai instalar no ambiente. O Pandas, por exemplo, virou a chave para a série 3 lá em 21 de janeiro E agora, em setembro, chegou numa versão estável super madura, a 3.0.6.
2:58O Polars está na 1.44, mas já com uma prévia da 2.0 circulando forte. O DuckDB, que é aquele banco analítico que roda direto dentro do Python, está na 1.5.6, com a versão 2.0 prometida já para a segunda metade de outubro.
3:13E tudo isso opera com extrema estabilidade sobre o Python 3.14. Ter essas versões exatas em mente é o que garante que nosso código não vai quebrar do nada. Agora, como a gente pega todo esse software e resolve nossos problemas diários de marketing?
3:27Vamos ver na prática. Essa tabela é praticamente um atalho de sobrevivência. Se você tem uma planilha de campanha ou um export do GA4 e do Search Console com até alguns milhões de linhas, vai de Pandas.
3:39Ele é o padrão absoluto da indústria, todo o tutorial usa e a IA gera código perfeito para ele. Mas e se pintar aquele arquivo gigantesco, cheio de logs e eventos brutos que derruba o computador?
3:50Aí a ferramenta é o Polars, porque ele processa tudo em paralelo. Agora, digamos que precisa cruzar um CSV com um parquet usando SQL, mas não quer o trabalho de subir um banco de dados. O DuckDB é surreal para isso.
4:03Ele lê direto dos arquivos e já te devolve no formato de DataFrame. E claro, se os dados já estão morando lá no BigQuery, manda um SQL direto no BigQuery e usa o Pandas só no finzinho. Deixa o peso do processamento lá no servidor, não na sua máquina.
4:17Entendendo a ferramenta certa, a gente entra na fase crítica. Montar o computador de um jeito seguro para não ter dor de cabeça depois. A nossa fundação tem uma regra muito clara agora.
4:27O sinal de que deu certo no terminal é ver o Python 3.11, 3.12, 3.13 ou 3.14. O Pandas 3 exige isso. A grande armadilha silenciosa que pega muita gente é tentar usar o Python 3.10. Se a gente faz isso, o sistema instala uma versão velha do Pandas sem dar nenhum alerta vermelho de compatibilidade.
4:46E aí, a confusão já está armada. O segundo passo é o isolamento, que é inegociável. Acerto absoluto, ambiente virtual ativo, mostrando o nome ali na frente no terminal, separando bonitinho as coisas de cada cliente.
4:59A armadilha é dar mole e instalar a biblioteca direto no núcleo do sistema operacional. Fazer isso é basicamente implorar para quebrar a análise de um projeto antigo na hora que você for atualizar um pacote para um projeto novo.
5:11E já pegando esse gancho, a gente trava as versões. O acerto é usar o arquivo requirements.txt com um número exato, tipo pandas 3.0.6 ou polars 1.44 cravados lá. A armadilha é deixar essas versões soltas.
5:28Acredite, se a versão não estiver fixa, um script que entregou o relatório perfeito na terça-feira pode simplesmente explodir na quinta por causa de alguma atualização automática de fundo que ninguém viu.
5:39E para fechar essa configuração com chave de ouro, o teste de realidade. Leu aquele CSV exportado do GA4? O texto tem que bater como str, e os números como int64 ou float64.
5:51E aqui vai uma armadilha clássica do nosso cenário no Brasil, as benditas vírgulas decimais. A máquina muitas vezes lê número com vírgula como puro texto, destruindo toda a sua matemática.
6:01Tem que forçar a configuração decimal para vírgula logo no momento da leitura, para o ambiente processar tudo de forma impecável. E para a gente fechar esse nosso papo inicial, deixe um alerta super importante.
6:11Muito código antigo que a gente acha em tutorial vai quebrar no Pandas 3. Aquela clássica atribuição encadeada simplesmente não altera mais a tabela, e as colunas de texto não são mais tratadas como tipo object.
6:22O ecossistema inteiro evoluiu, está muito mais robusto, e a gente precisa evoluir junto. É exatamente por isso que no nosso próximo passo, no capítulo de limpeza e preparação de dados, a gente vai focar em como navegar por isso sem quebrar nada.
6:34A fundação está montada e o trabalho de verdade está pronto para começar. Mas fica aqui a reflexão. As rotinas e os relatórios atuais das equipes de marketing estão realmente prontos para sobreviver a essa evolução do código?
O ecossistema de dados Python, em conversa
Dois apresentadores percorrem o capítulo 1: por que Python domina os dados, as seis bibliotecas, o fluxo da coleta à automação, a pilha do início de outubro de 2026, a ferramenta de cada tarefa de marketing, a montagem do ambiente local e o alerta sobre código antigo no pandas 3.
Transcrição
0:00Imagina a seguinte cena, que, bom, muito provavelmente é a realidade diária de quem trabalha com marketing digital hoje. A pessoa acorda, senta na frente do computador, com aquela caneca de café na mão, e começa a via cruzes.
0:14Nossa, a clássica rotina da manhã, né? Exato. Ela abre o painel do Google Analytics 4, vai até a aba de relatórios, seleciona um período bem específico e clica em exportar. Logo depois, abre o Search Console, ajusta os filtros, repete todo o processo e faz o download de mais um arquivo.
0:32E não para por aí, porque ainda tem os dados de mídia paga. Com certeza. Tem que buscar os relatórios das plataformas de anúncios para só então tentar juntar tudo isso com as planilhas internas de controle de campanha.
0:43O resultado, lá para o final da manhã, é um arquivo gigantesco. Um arquivo tão pesado que faz a ventoinha do computador girar no máximo e a tela pedir socorro a cada nova linha que alguém tenta inserir.
0:54A máquina sofre demais, o cursor fica lá girando sem parar. Sim, a produtividade simplesmente desaparece. É um cenário muito desgastante. Quem atua no marketing tem um domínio incrível sobre a lógica das campanhas, sabe exatamente o que precisa analisar, mas esbarra no limite da tecnologia.
1:12Pois é. Tentar usar editores de planilhas tradicionais para absolutamente todas as etapas da análise hoje em dia é complicado. O volume de informações que o marketing gera é absurdo.
1:23Lembra muito aquela ideia de tentar cortar a grama de um estádio de futebol inteiro usando só uma tesourinha escolar. Essa analogia é perfeita. O trabalho até avança nos primeiros centímetros. A pessoa consegue aparar um pedacinho ali perto da trave, mas o esforço logo fica insustentável.
1:39Sim, ninguém aguenta fazer isso toda semana. E o nosso objetivo nesse mergulho de hoje é justamente ajudar quem vive essa dor a deixar essa tesourinha de lado. Vamos abrir as portas de um galpão cheio de ferramentas motorizadas e entender o ecossistema de dados do Python.
1:55Uma baita evolução. Mas antes de olhar para as ferramentas em si, surge uma dúvida básica. Por que logo o Python? Por que essa linguagem virou a protagonista absoluta em ciência de dados e não outra tecnologia qualquer?
2:08A resposta para isso, que inclusive há razão que o nosso material de base destaca, é o ecossistema. O Python virou a linguagem dominante simplesmente porque construiu o ecossistema mais completo de bibliotecas para manipular, analisar e visualizar dados.
2:22Entendi. Então não é só a linguagem pura. Exato. A linguagem é só a base. O diferencial é ter esse conjunto gigantesco de bibliotecas. E o texto apresenta seis peças fundamentais que formam a espinha dorsal desse ecossistema. A começar pelo NumPy.
2:39NumPy. O que ele faz exatamente nos bastidores? O NumPy atua como a base de tudo. Ele fornece arrays eficientes e operações matemáticas vetorizadas. Operações vetorizadas? Como assim?
2:52É, imagina que, numa planilha normal, o computador calcula o custo de uma campanha célula por célula, descendo a coluna devagar. Com a operação vetorizada do NumPy, o computador olha para a coluna inteira como um bloco único.
3:06Ele aplica a matemática de uma vez só, de forma super veloz. Isso soa muito eficiente, claro. Mas, sendo bem pragmático, quem analisa a campanha não passa o dia olhando para matrizes matemáticas.
3:18A gente vive no mundo das tabelas, com cabeçalhos, datas, nomes de campanha. Como esse poder matemático vira uma tabela legível? É aí que entra a segunda ferramenta da nossa lista, o Pandas. O Pandas foi construído justamente sobre o NumPy.
3:34Ah, então ele usa aquele motor rápido. Isso. Ele aproveita a base do NumPy, mas permite trabalhar com dados em tabela. Exatamente como nas planilhas que a pessoa já está acostumada a usar no dia a dia.
3:45Legal. Então o Pandas é onde a pessoa realmente vai colocar a mão na massa. Mas, bom, depois de cruzar as exportações do GA4 com os custos e chegar num resultado, tem que apresentar isso. Ninguém manda uma tabela crua para a diretoria. Jamais, né?
3:59E para essa parte de gráficos, a gente tem o Matplotlib. É a terceira biblioteca e a mais tradicional de todas para visualização. Gráficos de linha, de barra... Exatamente. Linha, barra, gráficos de dispersão.
4:12o Matplotlib desenha tudo isso, dando controle total. Mas e se a pessoa quiser algo mais direto? Porque, às vezes, a gente só precisa de um gráfico rápido, bem construído, sem ter que configurar linha por linha do visual.
4:25Para esses casos, o ecossistema oferece o Seaborn. Ele foi construído sobre o Matplotlib, mas o foco dele é fazer gráficos estatísticos bonitos com bem menos código. Bem mais prático. Muito mais.
4:36E além de visualizar, a gente precisa lembrar de como esses dados chegam até o computador. Pois é. No marketing, a gente consome muita API de plataforma de anúncios. Não é só arquivo baixado na mão. Perfeito. E é por isso que a quinta biblioteca é a Requests.
4:51Ela é usada especificamente para consumir APIs e coletar dados da web. E se o dado estiver num banco da empresa? Aí entra a sexta biblioteca, o SQLAlchemy. A função dele é ligar o Python a bancos de dados SQL. Peraí.
5:06NumPy, Pandas, Matplotlib, Seaborn, Requests e SQLAlchemy. É muito nome. Bate aquele leve pânico de quem está começando. Eu imagino. A pessoa tem que sentar, pegar um caderno e decorar todas essas seis ferramentas de uma vez só antes de conseguir montar o próximo relatório da semana.
5:26Não, de jeito nenhum. A dica que o texto nos dá traz um alívio enorme. Ninguém precisa decorar tudo agora. Ufa. O importante, de verdade, é só saber que existe uma ferramenta específica para cada etapa. Você aprende a usar sob demanda.
5:39E não é que falamos em etapas? Como é esse fluxo na prática? Como é a linha do tempo de um projeto de dados? O fluxo típico passa por cinco fases. Começa na coleta, que é puxar os dados de APIs, arquivos CSV, Excel, web scraping ou bancos de dados.
5:55Depois vem a limpeza. Ah, a limpeza. Tratar valores ausentes. Remover duplicatas. Sim, a clássica dor de cabeça do marketing. Corrigir tipos de dados que vieram errados. E, com a casa limpa, a gente vai para a terceira etapa, que é a análise.
6:12Explorar padrões, calcular estatísticas e agrupar os dados. E aí entra a parte dos gráficos. Exato, a visualização, para criar os gráficos e comunicar as descobertas. E, para fechar, a automação. Transformar tudo isso num pipeline repetível.
6:28Dá para materializar isso num exemplo prático, tipo um pipeline simples em Pandas? Claro. Um pipeline simples em Pandas faz o seguinte. Primeiro, ele lê um arquivo CSV. Depois, ele tira as linhas vazias.
6:43Na sequência, puxa um resumo de estatísticas desses dados limpos. E, por fim, gera um gráfico de barras. É como uma linha de montagem industrial. O dado entra bruto como matéria-prima, passa pela lavagem e triagem na limpeza e sair do outro lado como um produto pronto, que é o gráfico.
7:00Exatamente. Esse é o fluxo eterno, mas as ferramentas que operam essa fábrica evoluem. E o cenário atual dessas tecnologias exatas, agora em outubro de 2023, mostra isso muito bem. Sim, os números do texto posicionam bem esse momento.
7:16O Python estável atual é a versão 3.14. Isso. E o Pandas chegou à série 3 no dia 21 de janeiro de 2026. A versão estável neste mês de setembro é a 3.0.6. E a gente vê uns nomes novos aparecendo também.
7:32O Polars, que está na versão 1.44 e já conta com a prévia da versão 2.0. E o DuckDB, que é um banco analítico que roda direto dentro do Python. Ele está na versão 1.5.6, com a 2.0 prevista para a segunda metade de outubro. É um ecossistema superaquecido.
7:50Mas me tira uma dúvida. Com esses nomes novos aparecendo, como o profissional de marketing sabe quando usar o clássico Pandas e quando recorrer ao Polars ou ao DuckDB para lidar com as exportações diárias? Tudo se resume ao tamanho e à natureza do problema.
8:06O Pandas é ideal para planilhas de campanha e exports do GA4 ou do Search Console de até alguns milhões de linhas. E o motivo é que o Pandas é o padrão dos tutoriais, das bibliotecas de gráficos e é o que a inteligência artificial escreve com mais facilidade.
8:22É a ferramenta do dia a dia, então. Mas e quando o arquivo é muito grande e deixa o notebook lento? Um log bruto, por exemplo? Aí o Polars é a escolha certa. O motivo é que o Polars processa os dados em paralelo e carrega apenas o que a consulta realmente precisa, aliviando a memória da máquina.
8:39Faz muito sentido. E o DuckDB? O DuckDB é perfeito para cruzar arquivos CSV e Parquet usando linguagem SQL, sem precisar subir um banco de dados tradicional. O motivo é que ele lê o arquivo direto do seu computador e já devolve um DataFrame pronto no Python.
8:56Facilita muito não depender de um servidor externo só para cruzar tabelas pesadas. Mas e quando o dado já está num servidor? Tipo aqueles exports automáticos do GA4 que caem direto no BigQuery. Bom, para dados que já estão no BigQuery, o ideal é usar SQL no próprio BigQuery e deixar o Pandas apenas para o momento final.
9:15Para não trazer aquele peso todo para o computador local. Exatamente. O motivo é estratégico. O peso do processamento fica lá no servidor e o Python no seu computador só recebe o resumo dos dados. Eu gosto de como essa divisão resolve as coisas.
9:29Cada tarefa tem o seu veículo apropriado. A bicicleta para o percurso rápido, o caminhão para a carga pesada. Mas antes de rodar qualquer coisa, a gente precisa preparar o nosso próprio computador, certo? Como é a montagem do ambiente local?
9:43É um passo a passo essencial para evitar dor de cabeça semanal. Primeiro, conferir a versão do Python. O Pandas 3 exige a versão 3.11 ou mais nova. Então tem que ver na tela se é 3.11, 12, 13 ou 14. Isso mesmo.
9:59A armadilha aqui é tentar instalar o Pandas 3 num Python 3.10. O sistema simplesmente instala uma versão antiga e não avisa de forma clara. Que perigo. A pessoa acha que está na versão nova e não está. Exato.
10:11O segundo passo é criar um ambiente virtual isolado para cada projeto ou cliente. O nome do ambiente vai aparecer no terminal. E se a pessoa ignorar isso e instalar tudo no ambiente global? A armadilha de instalar tudo direto no Python do sistema é você atualizar o Pandas para um projeto e acabar quebrando o projeto de outro cliente, que usava uma versão anterior.
10:31Entendi. E para não quebrar de uma semana para outra? Aí vem o terceiro passo. Instalar as bibliotecas principais e fixar as versões exatas no arquivo requirements.txt
10:44requirements.txt Certo A armadilha de não fixar a versão é o seu relatório rodar na semana seguinte com uma versão atualizada automaticamente e o resultado dos números mudar completamente É o terror de qualquer profissional de marketing ver o resultado da campanha mudar por causa de atualização do sistema E qual é o último passo?
11:04Por fim, testar a configuração lendo um CSV real exportado do GA4 ou do Search Console É a hora de conferir os tipos de dados, o que nos leva à grande armadilha do marketing no Brasil. Deixa eu adivinhar. Os números com vírgula.
11:19Isso. Números com vírgula decimal sendo lidos pelo sistema como se fossem texto. Nossa, o desespero de ver um cálculo de orçamento inteiro dá errado, só porque o arquivo leu a vírgula do dinheiro como se fosse uma palavra. Pois é.
11:32E a solução na leitura é configurar o comando para entender o decimal com vírgula e o milhar com ponto. O resultado final é um ambiente isolado, lendo ferramentas de marketing corretamente.
11:43E esse detalhe do decimal com vírgula salva literalmente semanas de trabalho? Bom, com o ambiente pronto e os dados sendo lidos do jeito certo, tem um último aviso que o material traz, não é? Especialmente para quem costuma pesquisar soluções na internet.
11:57Sim, um alerta crítico. Muita atenção ao copiar código de tutoriais antigos na internet, porque eles podem quebrar no Pandas 3. O que mudou? Mudanças bem estruturais. A atribuição encadeada deixou de alterar a tabela e as colunas de texto não são mais do tipo object.
12:13Fica o aviso, então, para tomar cuidado com códigos defasados. E para quem vai colocar a mão na massa, o capítulo Limpeza e Preparação de Dados traz o roteiro de migração para essas mudanças. E o próximo capítulo trata especificamente de Jupyter e ambientes.
12:27Então, a conversa continua por lá. Com certeza. Um grande abraço e até a próxima. Até lá.
Python é uma linguagem de programação gratuita, muito usada em análise de dados. Painel de BI (business intelligence), como Power BI ou Looker Studio, é o painel de gráficos que se atualiza sozinho. Python não substitui a planilha nem o painel. Ele entra quando aparece um destes quatro sinais: o arquivo passa do limite do Excel (1.048.576 linhas por aba), a mesma conta se repete toda semana, a resposta exige cruzar três ou mais fontes, ou alguém precisa auditar como o número foi feito. Fora desses casos, a planilha costuma ser mais rápida e mais fácil de revisar.
Qual ferramenta responde a qual pergunta
| Situação | Planilha | Painel de BI | Notebook Python |
|---|---|---|---|
| Conta pontual com alguns milhares de linhas | Melhor escolha | Exagero | Exagero |
| Indicador acompanhado todo dia pela diretoria | Frágil | Melhor escolha | Alimenta o painel |
| Cruzar mídia, CRM e vendas com regras de negócio | Trava e erra | Depende do modelo de dados | Melhor escolha |
| Arquivo com milhões de linhas | Não abre | Depende da fonte | Melhor escolha |
| Investigação nova, sem formato definido | Limitada | Lenta para mudar | Melhor escolha |
Fonte: Limite de linhas: especificações do Microsoft Excel. Demais linhas: critério editorial do curso.
Sinais de que a planilha chegou ao limite
Rotina de hoje
Hoje
- Três pessoas exportam e colam dados toda segunda
- Fórmula PROCV quebra quando muda a ordem das colunas
- Ninguém sabe refazer o número do mês passado
- O arquivo demora minutos para abrir
Com um notebook
Com Python
- Um script lê os três exports e junta pela chave
- A junção usa o nome da coluna, não a posição
- O notebook guarda a regra e refaz o número em segundos
- Bibliotecas de dados processam milhões de linhas
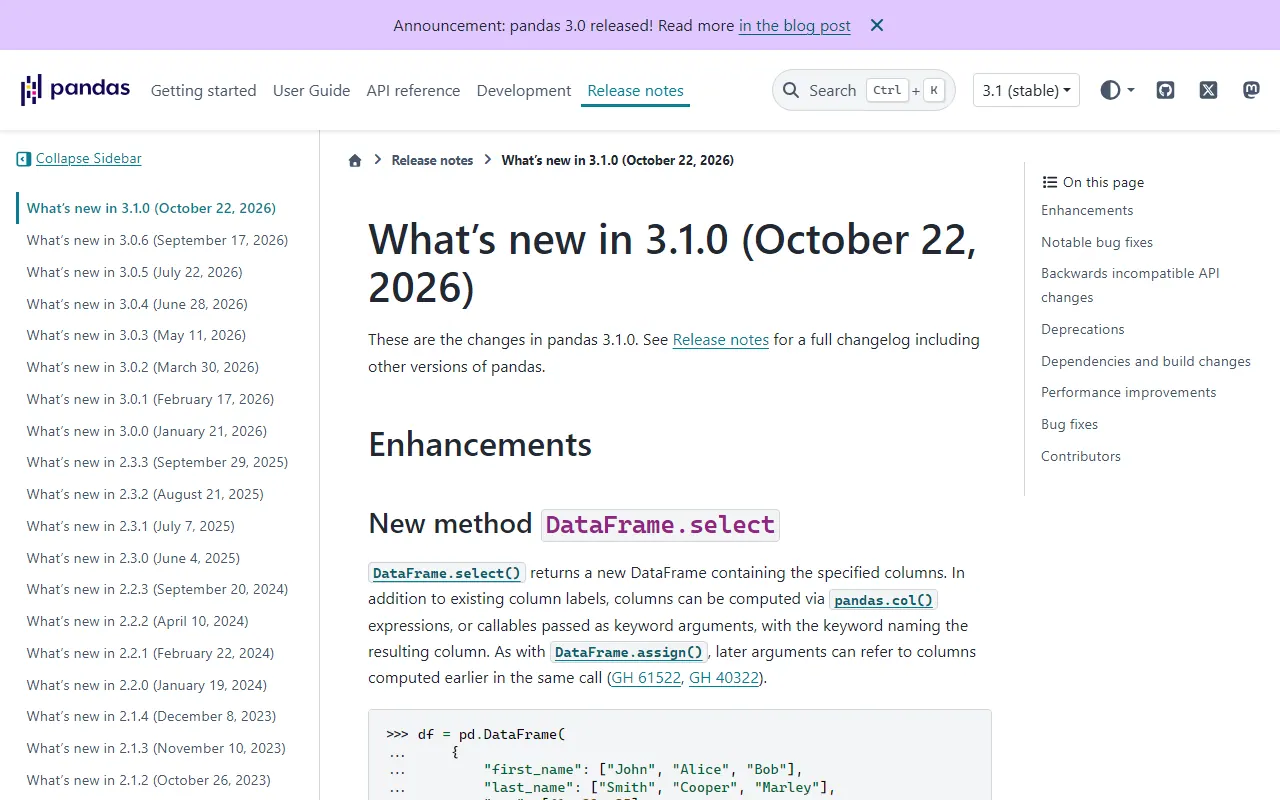
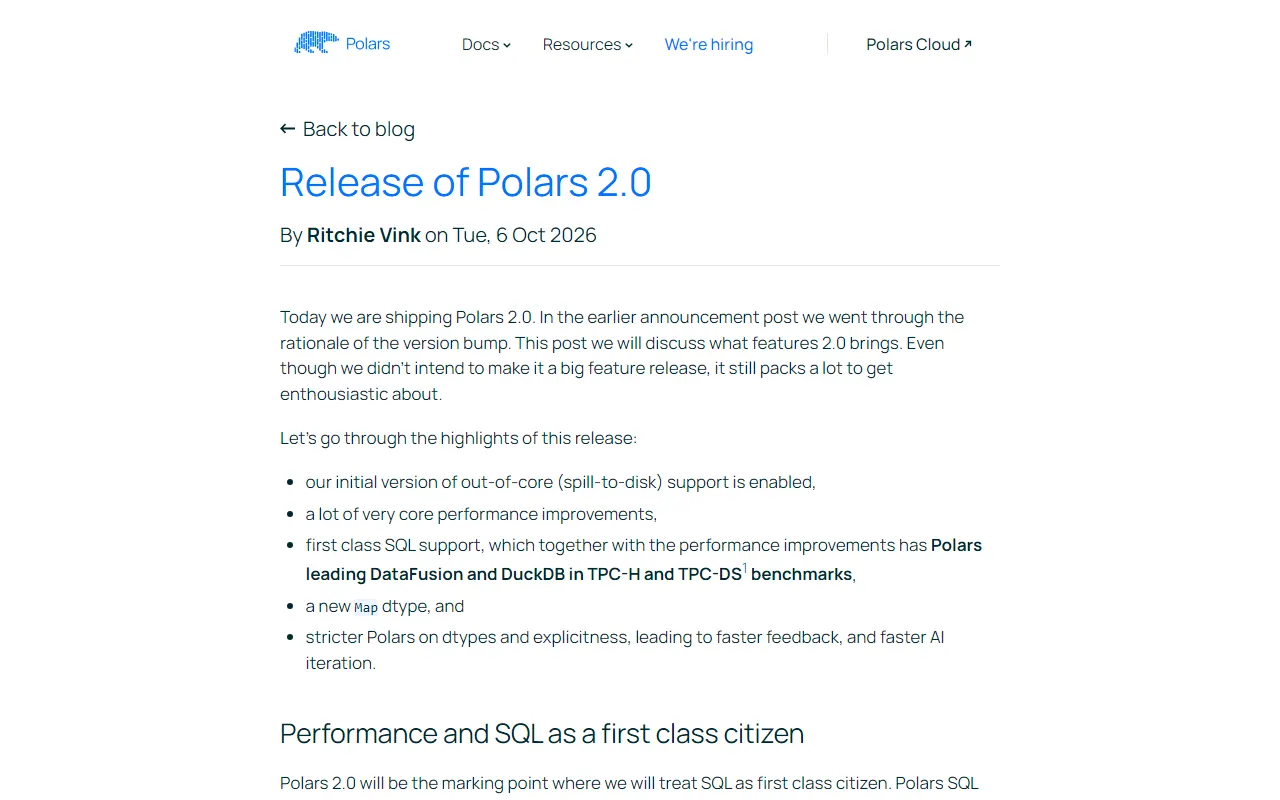
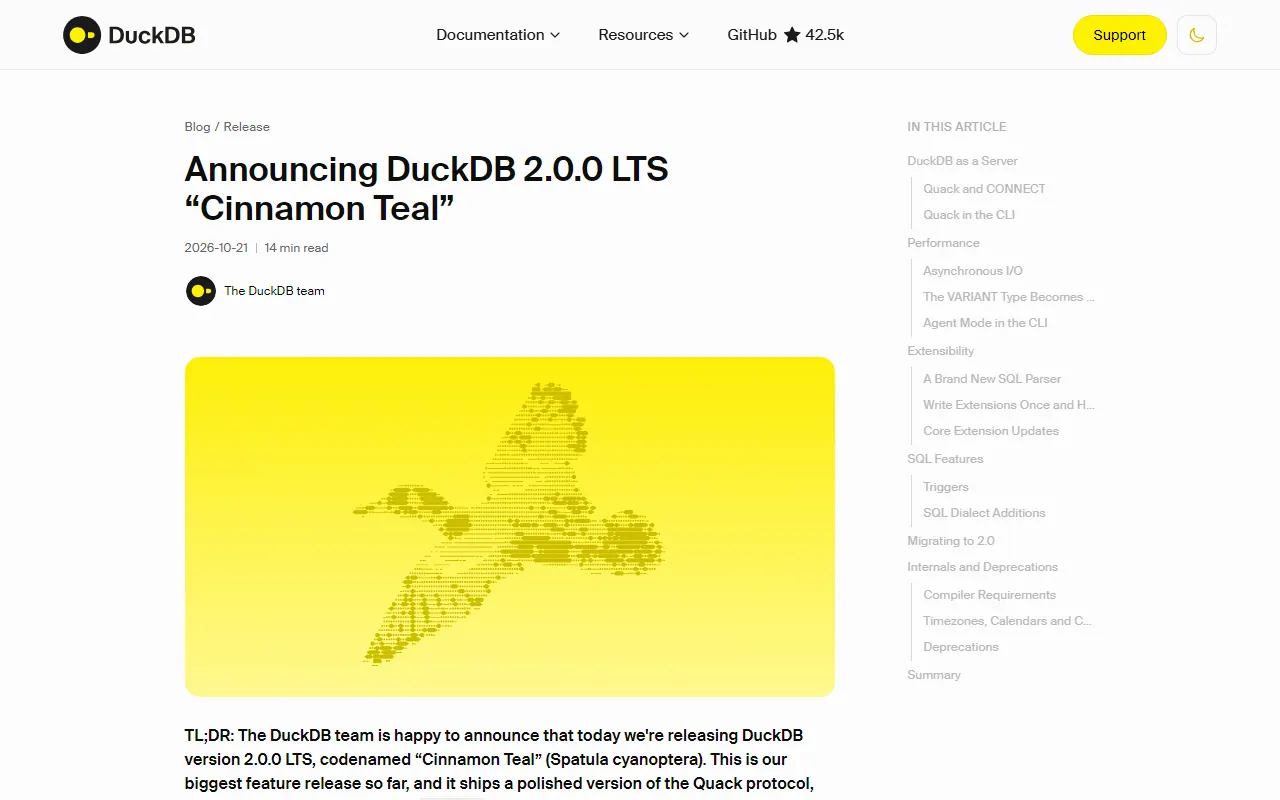
Biblioteca é um pacote de funções prontas que o Python carrega para uma tarefa, e CSV é o arquivo de texto simples que sai de quase todo export. Quatro bibliotecas fazem quase todo o trabalho que você vai encomendar. O pandas lê e transforma tabelas; o Polars faz o mesmo com mais velocidade em arquivos grandes; o DuckDB permite perguntar em SQL direto sobre arquivos; o Matplotlib desenha os gráficos. pandas, Polars e DuckDB lançaram versões novas em outubro de 2026, e isso afeta você por um motivo prático: código antigo pode dar resultado diferente na versão nova.
A pilha de dados em outubro de 2026
pandas 3.1
Lançado em 22/10/2026
Leitura de CSV em um só núcleo duas a três vezes mais rápida que na 3.0, segundo a nota oficial
Polars 2.0
Lançado em 06/10/2026
Processa por partes e usa o disco quando a memória chega a cerca de 80%
DuckDB 2.0
Lançado em 21/10/2026
Versão de suporte longo, até pelo menos outubro de 2027
Python 3.15
Lançado em 09/10/2026
pandas 3.0.6 foi a primeira versão compatível
Fonte: Notas oficiais de pandas, Polars, DuckDB e Python, consultadas em 24/10/2026.
Quem faz o trabalho pesado em cada caso de marketing
| Tarefa | Ferramenta | Por quê |
|---|---|---|
| Export de campanha, GA4 ou Search Console até alguns milhões de linhas | pandas | É o padrão dos tutoriais, dos gráficos e do código que a IA escreve |
| Arquivo grande de eventos que deixa o notebook lento | Polars | Processa em paralelo e só carrega o que a consulta precisa |
| Cruzar CSVs com SQL sem subir banco de dados | DuckDB | Lê o arquivo direto e devolve uma tabela pronta |
| Dados que já estão no BigQuery | SQL no BigQuery e pandas no fim | O peso fica no servidor; o notebook recebe só o resumo |
Tarefa: triagem de três demandas da sua semana
Passo 1: Liste três pedidos de análise que chegaram até você
Pode ser relatório de campanha, fechamento de vendas ou previsão de estoque.
Deu certo quando: Três linhas escritas, cada uma com quem pediu e para qual decisão.
Passo 2: Anote volume, frequência e número de fontes
Quantas linhas, a cada quanto tempo e de quantos sistemas vêm os dados.
Deu certo quando: Cada demanda tem três números ao lado.
Erro comum: Chutar o volume. Abra o arquivo ou pergunte a quem exporta.
Passo 3: Classifique pela tabela deste capítulo
Planilha, painel de BI ou notebook.
Deu certo quando: Cada demanda tem uma ferramenta e um motivo de uma frase.
Passo 4: Leve uma das demandas de notebook para os próximos capítulos
Ela vira o seu caso de estudo do curso.
Deu certo quando: Você sabe qual arquivo vai usar a partir do capítulo 3.
No fim você tem: Uma tabela de três linhas com demanda, ferramenta escolhida e motivo, pronta para discutir com o time.
Para quem quer instalar no próprio computador (opcional)
Preciso instalar algo para fazer o curso?
Não. Todos os exercícios rodam no Google Colab, no navegador. A instalação local só vale se os dados não puderem sair da máquina da empresa.
Qual versão do Python usar?
O pandas 3 exige Python 3.11 ou mais novo. O Python 3.15 saiu em 09/10/2026 e o pandas 3.0.6 foi a primeira versão compatível com ele. Antes de atualizar, confira se as demais bibliotecas do projeto já aceitam a versão.
Como montar o ambiente local?
Crie um ambiente isolado por projeto (python -m venv .venv), instale pandas, polars, duckdb, matplotlib e openpyxl, e grave as versões com pip freeze > requirements.txt. Sem versão gravada, o relatório da semana seguinte pode rodar com outra biblioteca e mudar o resultado.
Código de tutorial antigo funciona no pandas 3?
Nem sempre. A atribuição encadeada (df["col"][filtro] = valor) deixou de alterar a tabela, e colunas de texto mudaram de tipo. O capítulo 5 mostra o que conferir.
Antes de seguir para o capítulo 2
Critério de pronto
0/4A seguir: capítulo 2, Notebook sem instalar nada: Colab e Jupyter (22 min).
Use Concluir e continuar para registrar seu progresso. Avançar a leitura não marca a conclusão.
Notebook sem instalar nada: Colab e Jupyter
Abra um notebook no navegador, rode as primeiras células e aprenda a dizer se um notebook recebido do time pode ser repetido por outra pessoa.
Uma tabela em Python, lida com olhos de planilha
Traduza os comandos do pandas para gestos de planilha e leia um export de verdade em três comandos que mostram linhas, tipos e resumo.
Média, mediana e o número que engana
Questione a média antes de aceitá-la: compare com a mediana, encontre o valor atípico e peça o resumo que mostra a distribuição.
Dado sujo: o erro silencioso que vira decisão errada
Reconheça os defeitos mais comuns de um export, exija que o que estiver errado seja separado e devolvido, e saiba o que o pandas 3 mudou no código antigo.
Pedir a análise a um assistente de IA e conferir cada número
Use Claude, ChatGPT ou o Gemini no Colab para a primeira leitura de um arquivo, com um pedido pronto e quatro conferências que pegam os erros mais comuns.
Cortes por canal, mês e cliente sem duplicar receita
Peça tabelas dinâmicas e segmentações em pandas e confira o cruzamento de bases para que a mesma venda não seja contada duas vezes.
Escolher o gráfico pela pergunta
Associe cada pergunta de negócio a um tipo de gráfico, conheça as galerias de Matplotlib e seaborn e peça à IA o gráfico já especificado.
Gráfico enganoso e gráfico que leva à decisão
Reconheça eixo cortado, média de taxas, período escolhido a dedo e cor sem legenda, e monte o gráfico de ROAS com a linha de equilíbrio que o financeiro reconhece.
Dados que chegam sozinhos: APIs do GA4 e do Search Console
Entenda o que é uma API em linguagem de negócio, o que o time precisa para ligar GA4 e Search Console ao notebook e como conferir o número que chega.
Dados abertos e coleta em sites: o que copiar e o que evitar
Use dados públicos do IBGE e do portal dados.gov.br no seu notebook e saiba quando copiar informações de um site (web scraping) respeita as regras dele: robots.txt, termos de uso e LGPD.
SQL para quem decide: o que pedir ao banco e ao time
Leia uma consulta SQL como uma frase em português, entenda quando usar DuckDB e BigQuery e encomende consultas com período, colunas e custo sob controle.
O relatório que se escreve sozinho: o que automatizar e como revisar
Decida quais relatórios merecem automação, peça o script a um assistente de IA com regras e teste, e confira a entrega antes de agendar.
Do protótipo ao pipeline: o que aprovar e o que exigir do time
Entenda as etapas de um pipeline de dados, as perguntas a fazer antes de agendar uma rotina e quando o time precisa de um orquestrador como Airflow, Prefect ou Dagster.