SEO programático · ·
Organizar os dados para evitar erros e retrabalho
Definir identificadores estáveis, campos obrigatórios e regras de atualização; medir o custo antes de escolher a infraestrutura.
Este capítulo faz parte do curso gratuito SEO programático.
Uma página publicada com o preço do município errado custa reputação, e o mesmo erro repetido em escala custa o acervo. O ponto de partida é banal: você baixou a série da ANP e a lista de municípios do IBGE, e as duas trazem "São Paulo". Ao cruzar por nome, o casamento falha em silêncio: a ANP entrega o município em caixa alta, às vezes com a sigla da UF colada no fim, e o cadastro do IBGE contém localidades com nomes repetidos em estados diferentes. Depois de resolver isso na marra, aparece o segundo sintoma: o build, que levava segundos, começa a levar minutos, e piora a cada lote de dados que entra.
Os dois problemas têm a mesma raiz. O esquema do registro e o lugar onde ele mora definem o teto do projeto, e as duas decisões são tomadas antes de existir qualquer página. Fechar as duas agora sai barato; corrigir depois de mil páginas publicadas exige migração, redirecionamento e retrabalho de quem constrói.
Ver como texto
Entidade RegistroPreco do Radar de Preço de Combustível, com os campos separados em identidade, exibição, medição e histórico. Os três campos de identidade formam a chave composta código IBGE mais combustível mais semana, que resolve para exatamente uma URL.
A pergunta que organiza o esquema é sempre a mesma: qual conjunto mínimo de campos identifica um registro sem ambiguidade? No Radar, é código IBGE do município, tipo de combustível e semana de referência. Nome de município não entra na chave porque não é único no país, e nem estável na grafia entre fontes.
Tudo o mais no registro cai em três papéis. Campos de exibição existem para o leitor (nome acentuado, sigla da UF). Campos de medição são o motivo da página existir (preço médio, número de postos pesquisados). O histórico é o que dá profundidade e justifica a visita recorrente. Se você não consegue apontar qual campo é o dado que só existe naquela página, o problema é anterior ao esquema, e [Decidir se o projeto de páginas merece investimento](#gate-do-dado-proprio) já respondeu.
// src/lib/radar/tipos.ts
// Esquema do registro do Radar. Um registro = uma página.

export type Combustivel =
  | "gasolina-comum"
  | "gasolina-aditivada"
  | "etanol-hidratado"
  | "diesel-s10"
  | "glp-p13";

export interface PontoSerie {
  semana: string;      // ISO week, ex.: "2026-W28"
  precoMedio: number;  // em reais
}

export interface RegistroPreco {
  // --- identidade: forma a chave, nunca muda de grafia ---
  codigoIbge: string;         // 7 dígitos, string para preservar zero à esquerda
  combustivel: Combustivel;
  semanaReferencia: string;   // ISO week

  // --- exibição: para o leitor, acentuado ---
  municipio: string;
  uf: string;                 // 2 letras

  // --- medição: o dado que só existe nesta página ---
  precoMedio: number;
  postosPesquisados: number;

  // --- proveniência e histórico ---
  fonte: string;              // URL do arquivo da ANP usado
  serie: PontoSerie[];
}

/** Chave de unicidade. Duas linhas com a mesma chave são a mesma linha. */
export function chaveRegistro(r: RegistroPreco): string {
  return [r.codigoIbge, r.combustivel, r.semanaReferencia].join(":");
}

/** Slug da página: só identidade estável, sempre ASCII. */
export function slugPagina(r: RegistroPreco): string {
  return `${r.codigoIbge}-${r.combustivel}`;
}Nome de lugar não é chave. O código IBGE de 7 dígitos é a chave canônica de município no Brasil, e todo dado que entra no acervo é traduzido para ele na fronteira de ingestão. Nome acentuado existe no registro apenas para exibição, nunca para casar duas fontes nem para compor URL.
Só que a ANP não entrega código IBGE. Ela entrega nome de município e sigla de UF em texto, e é aí que a normalização deixa de ser detalhe e vira infraestrutura. Três diferenças quebram o casamento por string, e é preciso tratar as três:
Acento. "São Paulo" contra "SAO PAULO" são strings distintas. A normalização Unicode NFD decompõe a letra acentuada em letra base mais sinal diacrítico, e aí basta remover a faixa de combining marks.
Caixa e pontuação. Caixa alta, hífen no lugar de espaço, apóstrofo em nomes como "Santa Bárbara d'Oeste".
Sufixo de UF. Vários extratos da ANP trazem o município já com a sigla colada, no formato "SAO PAULO - SP" ou "SAO PAULO (SP)". Se você não remover o sufixo antes de comparar, nenhum casamento acontece.
A UF entra na chave de normalização por um motivo específico: existem homônimos entre estados. Comparar só o nome faz "Bom Jesus" de um estado casar com "Bom Jesus" de outro, e o erro só aparece depois que a página estiver publicada com o preço do município errado.
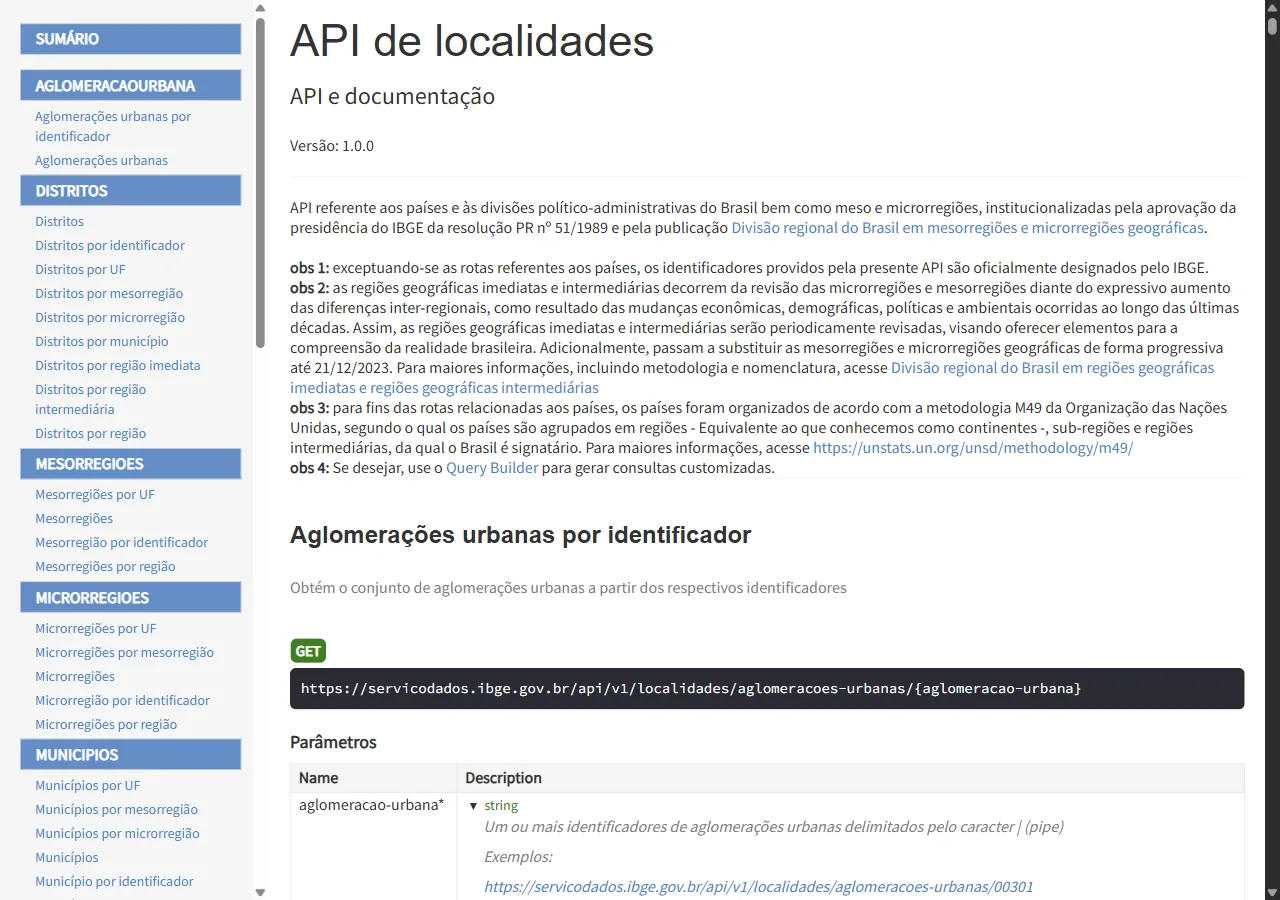
Fonte: servicodados.ibge.gov.br · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: organização das localidades e rotas de consulta.
Ver como texto
Três grafias que a ANP entrega para o mesmo município passam pelas quatro regras de normalização, viram uma única chave de comparação com a UF anexada e resolvem para o código IBGE 3550308.
// scripts/normaliza-municipio.mjs
// Exemplo resolvido: constrói o índice do IBGE e casa um nome vindo da ANP.
// Roda com: node scripts/normaliza-municipio.mjs

/** Remove acentos via decomposição Unicode. */
const semAcento = (s) => s.normalize("NFD").replace(/[\u0300-\u036f]/g, "");

/** Chave de comparação: ASCII, minúscula, sem sufixo de UF, com UF anexada. */
export function chaveNome(nome, uf) {
  const base = semAcento(String(nome))
    .toLowerCase()
    .replace(/\s*\(([a-z]{2})\)\s*$/, "")   // "sao paulo (sp)"
    .replace(/\s*-\s*[a-z]{2}\s*$/, "")      // "sao paulo - sp"
    .replace(/[^a-z0-9]+/g, " ")             // apóstrofo, ponto, hífen interno
    .trim()
    .replace(/\s+/g, "-");
  return base + "--" + String(uf).toLowerCase();
}

const URL_IBGE =
  "https://servicodados.ibge.gov.br/api/v1/localidades/municipios";

/** A UF vive em dois caminhos diferentes no payload; tente os dois. */
function ufDoMunicipio(m) {
  return (
    m.microrregiao?.mesorregiao?.UF?.sigla ??
    m["regiao-imediata"]?.["regiao-intermediaria"]?.UF?.sigla ??
    null
  );
}

const municipios = await fetch(URL_IBGE).then((r) => r.json());

const indice = new Map();
let semUf = 0;
for (const m of municipios) {
  const uf = ufDoMunicipio(m);
  if (!uf) { semUf++; continue; }
  indice.set(chaveNome(m.nome, uf), String(m.id));
}

console.log("municípios indexados:", indice.size, "| sem UF resolvida:", semUf);

// Três grafias que a ANP produz para o mesmo município:
for (const bruto of ["SAO PAULO", "SAO PAULO - SP", "São Paulo (SP)"]) {
  console.log(bruto, "->", indice.get(chaveNome(bruto, "SP")) ?? "NAO CASOU");
}
// Esperado: as três linhas resolvem para 3550308.- Etapa 1 de 7: Entradas: CSV semanal da ANP e lista de municípios do IBGE
O CSV traz nome + UF em texto; a lista do IBGE traz id de 7 dígitos + nome.
- Etapa 2 de 7: Constrói o índice a partir da lista do IBGE
chaveNome -> codigoIbge
- Etapa 3 de 7: Normaliza o CSV da ANP
E segue para o casamento com o índice.
- Etapa 4 de 7: Casa por chaveNome
Cada linha normalizada é procurada no índice.
- Etapa 5 de 7: Casou: registro com codigoIbge
Não casou: vai para o relatório de rejeitados (nunca descarte em silêncio).
- Etapa 6 de 7: Grava por chaveRegistro
Só os registros que casaram.
- Etapa 7 de 7: Acervo do Radar
Ver como texto
- Entradas: CSV semanal da ANP e lista de municípios do IBGE: O CSV traz nome + UF em texto; a lista do IBGE traz id de 7 dígitos + nome.
- Constrói o índice a partir da lista do IBGE: chaveNome -> codigoIbge
- Normaliza o CSV da ANP: E segue para o casamento com o índice.
- Casa por chaveNome: Cada linha normalizada é procurada no índice.
- Casou: registro com codigoIbge: Não casou: vai para o relatório de rejeitados (nunca descarte em silêncio).
- Grava por chaveRegistro: Só os registros que casaram.
- Acervo do Radar
Registro que não casou nunca vira página, e nunca some sem deixar rastro. Grave a lista de rejeitados em arquivo à parte e olhe para ela antes de cada publicação: é ali que aparecem grafias novas da fonte, município desmembrado e mudança de layout do CSV. Uma taxa de rejeição que sobe de repente é o primeiro sinal de que a fonte mudou.
Quando o projeto cruza três ou mais bases federais (IBGE mais ANP mais DATASUS, por exemplo), reescrever esse normalizador por fonte deixa de compensar. A Base dos Dados mantém um datalake público no BigQuery com as tabelas já tratadas e com as chaves de município harmonizadas entre bases, o que elimina justamente a parte cara. Você consulta com o seu próprio projeto Google Cloud; a documentação de acesso e o pacote oficial estão no bloco de fontes ao fim do capítulo.
Definido o registro, falta a segunda decisão: onde ele mora. E aqui o exemplo mais útil está no repositório que hospeda este próprio curso, medido no worktree.
Este repositório carrega 152 artigos embutidos como literais TypeScript, distribuídos em cerca de 70 arquivos src/lib/articles-*.ts, somando 3.093.537 bytes. O src/lib/articles.ts sozinho tem 633 KB e 5.449 linhas. As rotas públicas são 235 arquivos page.tsx escritos à mão em src/app.
O veredito precisa ser dito sem eufemismo: este repositório é um site artesanal de 235 rotas, e não um site programático. Ele entra no curso como o exemplo nomeado do padrão que não escala, e é útil exatamente por ser evidência local, reproduzível por quem estiver com o worktree aberto.
Ver como texto
Comparação medida neste repositório: 3,0 MB de conteúdo em literais TypeScript, fatiados em cerca de 70 arquivos, atravessam o type-check a cada build, enquanto o mesmo conteúdo em JSON lido por slug entrega ao processo apenas o arquivo da página pedida.
Importar grandes conjuntos como literais de código pode aumentar o trabalho do compilador e do empacotador. O efeito depende do formato, dos tipos e do caminho de importação; meça tempo, memória e tamanho antes de atribuir a lentidão a uma causa. Separar dados de código também permite escolher ciclos de atualização diferentes. A alternativa pode ser um arquivo lido no servidor, armazenamento de objetos ou banco de dados, conforme o volume e o padrão de consulta.
São três regimes, e cada um paga o custo em lugar diferente.
Arquivos (MDX e similares). O custo cai no build, em parse e compilação por arquivo. Teto prático de centenas a poucos milhares de páginas. Vale quando o conteúdo é escrito por gente, com prosa longa e formatação rica.
JSON ou dados estruturados. O custo cai no build ou em runtime, dependendo de como você lê. Teto de dezenas de milhares, com uma condição que é a decisão inteira: o dado precisa ser carregado sob demanda por slug, um arquivo por página. Um índice único carregado inteiro reproduz o antipadrão dos literais, só que em outra extensão de arquivo.
Banco de dados. O custo cai em runtime, mitigado por cache. É o único caminho para centenas de milhares de páginas, e é o regime em que a atualização do dado deixa de exigir deploy.
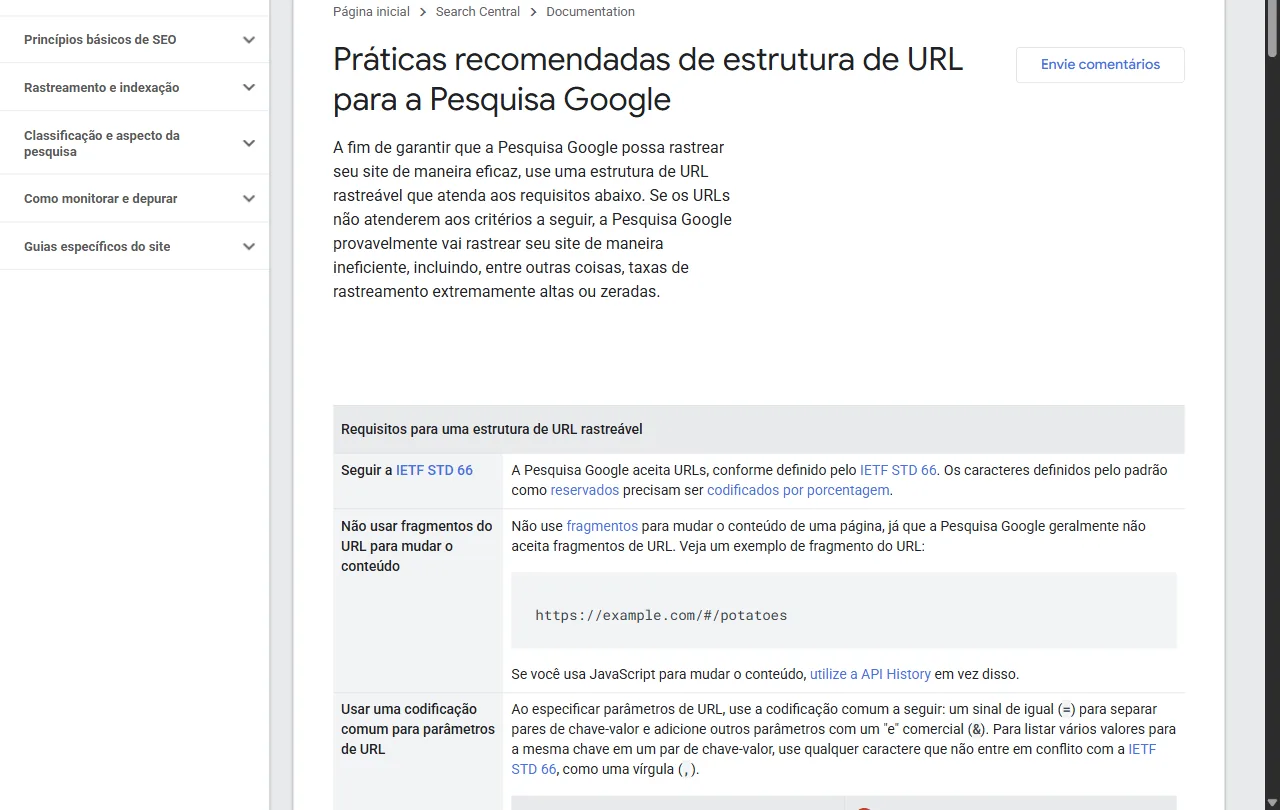
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: exemplos de endereços descritivos e separação de palavras.
Ver como texto
Curva de custo de build por número de páginas nos três regimes de armazenamento: arquivos disparam cedo, JSON lido por slug sustenta dezenas de milhares e banco com cache mantém a curva quase plana. Duas linhas verticais tracejadas marcam os pontos de troca de regime.
Se o tempo de geração ultrapassa o limite do projeto, compare três caminhos: reduzir o lote gerado antecipadamente, ler dados por registro ou usar armazenamento e cache adequados à consulta. Banco de dados pode ser uma opção, mas não decorre automaticamente da quantidade de páginas. Registre tempo, memória, frequência de atualização e custo para justificar a escolha.
// src/lib/radar/acervo.mjs
// Leitura sob demanda: o processo toca um arquivo, não o acervo inteiro.
import { readFile, writeFile, mkdir } from "node:fs/promises";
import { dirname } from "node:path";

const DIR = "dados/registros";

/** Grava um registro por slug. Idempotente: reescreve o mesmo caminho. */
export async function gravarRegistro(slug, registro) {
  const caminho = `${DIR}/${slug}.json`;
  await mkdir(dirname(caminho), { recursive: true });
  await writeFile(caminho, JSON.stringify(registro, null, 2), "utf8");
  return caminho;
}

/** Lê um registro por slug. Ausência é resposta válida, não exceção. */
export async function lerRegistro(slug) {
  try {
    const bruto = await readFile(`${DIR}/${slug}.json`, "utf8");
    return JSON.parse(bruto);
  } catch (erro) {
    if (erro.code === "ENOENT") return null;
    throw erro;
  }
}

// Demonstração executável:
const exemplo = {
  codigoIbge: "3550308",
  combustivel: "gasolina-comum",
  semanaReferencia: "2026-W28",
  municipio: "São Paulo",
  uf: "SP",
  precoMedio: 0,
  postosPesquisados: 0,
  fonte: "preencher com a URL do CSV da ANP usado",
  serie: [],
};
const slug = `${exemplo.codigoIbge}-${exemplo.combustivel}`;
console.log("gravado em:", await gravarRegistro(slug, exemplo));
console.log("lido:", (await lerRegistro(slug))?.municipio);
console.log("inexistente:", await lerRegistro("0000000-inexistente")); // nullDuas armadilhas de vocabulário atrapalham a busca por documentação. "Content collections" não é API oficial do Next.js. É um padrão de bibliotecas de terceiros (Contentlayer e sucessores), então procurar por isso na documentação do framework não devolve nada, e material que trata o recurso como nativo está descrevendo outra coisa. E JSON não é automaticamente o regime leve: o que separa dezenas de milhares de páginas viáveis de um build travado é ler por slug em vez de importar um índice único.
No projeto da sua empresa, verifique o que já está disponível antes de acrescentar infraestrutura. Um banco instalado não significa capacidade ociosa gratuita: permissões, manutenção, cópias de segurança e consultas também custam. Para o piloto, escolha a solução mais simples que cumpra os requisitos e registre o sinal mensurável que exigirá mudança.
Estado do artefato ao final deste módulo. O Radar deixa de ser uma página escrita à mão e passa a ter acervo.
Entregue:
- O arquivo de tipos com
RegistroPreco,chaveRegistroeslugPagina, com os campos que a ANP e o IBGE de fato fornecem. - O script de normalização rodando contra a API de localidades do IBGE, imprimindo quantos municípios foram indexados.
- O acervo materializado no regime que você escolheu, com o código IBGE já resolvido em todos os registros.
- Um arquivo de rejeitados, ainda que vazio, com a contagem de linhas da ANP que não casaram.
- Uma linha escrita, no README do projeto, declarando o regime escolhido e o número de páginas em que você vai trocar de regime. Escrever o gatilho antes de precisar dele é o que impede a decisão de virar inércia.
Como conferir: pegue um município cujo nome se repete em outro estado, confirme que os dois registros existem com códigos IBGE diferentes, e que os dois slugs são distintos e ASCII.
Leve quatro perguntas à próxima reunião com quem constrói. Se alguém propuser municipio + uf como chave, peça dois problemas que só aparecem depois da publicação. Para um projeto de 40 mil páginas com atualização diária, peça o regime escolhido e qual das duas variáveis do critério de corte decidiu. Pergunte por que um único JSON importado pela página não resolve o custo dos literais. Feche pedindo que apontem no esquema o campo que é o dado exclusivo da página, aquele que [Decidir se o projeto de páginas merece investimento](#gate-do-dado-proprio) exige.
O guia abaixo serve ao executivo que aprova o projeto e ao líder técnico que vai executá-lo. Ele destrava uma decisão só: qual regime de armazenamento o acervo usa agora e em que número de páginas ele troca de regime, com dono e data registrados.
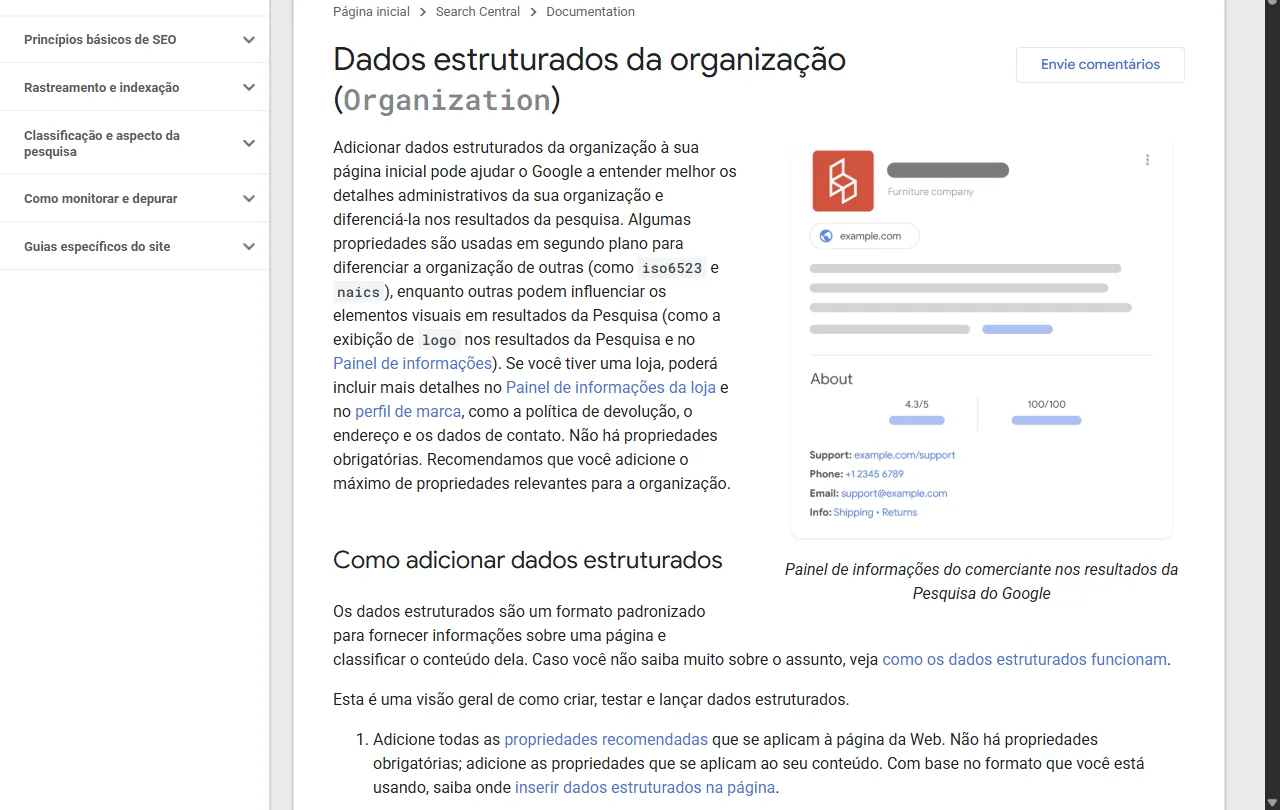
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: propriedades que identificam uma organização.
Guia de implementação: fixar o registro e o regime do acervo
Cinco passos que levam do arquivo bruto a um acervo com chave canônica e gatilho de troca escrito.
Passo 1: Nomeie a chave de unicidade do registro
O líder técnico lista o conjunto mínimo de campos que identifica um registro sem ambiguidade; no Radar, código IBGE, combustível e semana.
Deu certo quando: Duas linhas com a mesma chave são, comprovadamente, a mesma linha.
Erro comum: Usar nome de município na chave, que se repete entre estados e muda de grafia entre fontes.
Passo 2: Traduza toda fonte para o código canônico na entrada
O engenheiro de dados escreve o normalizador que converte nome e UF da fonte para o código IBGE antes de gravar.
Deu certo quando: Um município homônimo aparece em dois registros com códigos diferentes.
Erro comum: Descartar em silêncio as linhas que não casaram, em vez de gravá-las num relatório de rejeitados.
Passo 3: Escolha o regime pelo critério de corte
Com o número de páginas e o tempo de build tolerado, o time decide entre arquivos, JSON lido por página e banco.
Deu certo quando: A decisão cita as duas variáveis do critério, e não só o número de páginas.
Erro comum: Adotar JSON com um índice único carregado inteiro, que repete o custo dos literais em outra extensão.
Passo 4: Escreva o gatilho de troca de regime
O dono do projeto registra no documento do projeto o número de páginas em que o regime muda.
Deu certo quando: O gatilho tem número, dono e data de revisão.
Erro comum: Deixar a troca para quando o build travar, momento em que a migração vira urgência.
Passo 5: Acompanhe a taxa de rejeição a cada carga
O analista de dados olha a contagem de rejeitados antes de cada publicação.
Deu certo quando: Uma alta repentina na rejeição dispara revisão da fonte antes de qualquer página nova.
Erro comum: Tratar o arquivo de rejeitados como log técnico que ninguém lê.
No fim você tem: Um esquema com chave canônica, um normalizador com relatório de rejeitados e o regime do acervo decidido com gatilho de troca escrito.
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Chave de unicidade | Líder técnico com o dono do dado | Meio dia de reunião e revisão | Esquema escrito com os campos de identidade separados dos de exibição |
| Normalizador na entrada | Engenheiro de dados | Dois a três dias; sem custo de licença (API do IBGE aberta) | Três grafias da mesma cidade resolvem para o mesmo código |
| Escolha do regime | Líder técnico e desenvolvedor | Um dia de medição do build | Documento cita número de páginas e tempo de build tolerado |
| Gatilho de troca | Dono do projeto (CMO ou diretor de produto) | Uma hora | Número de páginas, dono e data de revisão registrados |
| Taxa de rejeição | Analista de dados | Quinze minutos por carga | Contagem de rejeitados anexada a cada publicação |
Guia prático: comparativos e integrações para SaaS B2B. Em software B2B, o acervo programático mais comum tem dois formatos: "produto + integração" (como CRM com um ERP) e "produto contra concorrente". Os dois só se sustentam se o registro tiver dado que o time de produto conhece e o concorrente não publica: o que a integração sincroniza, em que direção, com qual limite e em que plano.
Para o produto próprio, o Google aceita marcação SoftwareApplication. O resultado avançado exige nome, preço da oferta (zero para gratuito) e uma nota agregada ou uma avaliação, segundo a página atualizada em 08/09/2026.
Caso 2: páginas de integração e de comparação para um SaaS B2B
Seis passos para o time de marketing de produto, com apoio de quem mantém as integrações. O registro é a tabela de integrações do produto, não uma lista de palavras-chave.
Passo 1: Exporte o registro de integrações do próprio produto
Uma linha por integração ativa: nome, campos sincronizados, direção, frequência, plano exigido e data de lançamento.
Deu certo quando: Cada página planejada corresponde a uma integração que um cliente consegue ligar hoje.
Erro comum: Criar página para integração "em breve", que vira promessa sem produto.
Passo 2: Normalize os nomes dos parceiros
Grafia oficial de cada parceiro, um identificador ASCII para o endereço e a categoria do parceiro.
Deu certo quando: Não existem duas páginas para o mesmo parceiro com grafias diferentes.
Erro comum: "RD Station" e "RDStation" gerando duas páginas quase iguais.
Passo 3: Escreva o bloco exclusivo a partir do registro
Tabela de campos sincronizados, passo de ativação com prints do próprio produto e limites conhecidos.
Deu certo quando: Um cliente consegue ativar a integração lendo só a página.
Erro comum: Texto genérico sobre "automatizar processos" repetido em todas as integrações.
Passo 4: Para comparativos, use só dado verificável e datado
Preço público, recurso presente ou ausente, com a data da consulta e o link da página do concorrente.
Deu certo quando: Cada linha da comparação tem fonte e data, e o jurídico aprovou o modelo.
Erro comum: Afirmar defeito do concorrente sem fonte, risco tratado em "Avaliar riscos de uso dos dados e de reputação".
Passo 5: Marque o produto próprio com SoftwareApplication
Só inclua aggregateRating se a nota vier de uma fonte que o leitor consiga ver na página.
Deu certo quando: O Teste de pesquisa aprimorada detecta o tipo, sem erro, nas páginas da amostra.
Erro comum: Marcar o concorrente como se fosse o produto da página.
Passo 6: Meça por grupo: integrações e comparativos separados
Um sitemap para cada formato permite ler os dois no relatório de indexação e no de desempenho.
Deu certo quando: Você sabe qual dos dois formatos traz demonstrações agendadas.
Erro comum: Somar os dois e não saber qual formato pagar no próximo trimestre.
No fim você tem: Um acervo de integrações e comparativos que nasce da tabela do produto e se atualiza junto com ele.
Antes de aprovar a primeira carga, peça ao time o esquema com a chave nomeada e o número de páginas em que o regime muda, os dois por escrito. Confira em cinco minutos: escolha um município cujo nome existe em outro estado e exija ver dois registros com códigos IBGE diferentes; se aparecer um só, a carga não sai.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- Vibecoding para SEORotina semanal: as ferramentas trabalhando juntasExaminar conexões de Rotina semanal: as ferramentas trabalhando juntas
- Software e IA para executivosEm que momento a página fica pronta, e quanto custaExaminar conexões de Em que momento a página fica pronta, e quanto custa
- Frontends com VibecodingInvestigar uma stack e priorizar atualizaçõesExaminar conexões de Investigar uma stack e priorizar atualizações
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.