Avaliar e melhorar agentes · ·
Famílias de treinamento: recompensas e infraestrutura
Aprofundamento sobre famílias de treinamento por reforço e suas necessidades de infraestrutura. Entenda RLHF, recompensas verificáveis e atualização de pesos antes de avaliar uma proposta técnica.
Este capítulo faz parte do curso gratuito Avaliar e melhorar agentes.
Neste aprofundamento, pesos são os parâmetros aprendidos pelo modelo. Durante um treinamento por reforço, respostas recebem sinais de avaliação e um algoritmo modifica esses parâmetros. Na execução comum, o modelo usa os pesos existentes para responder; uma nova tentativa, sozinha, não é uma nova etapa de treino.
Ver como texto
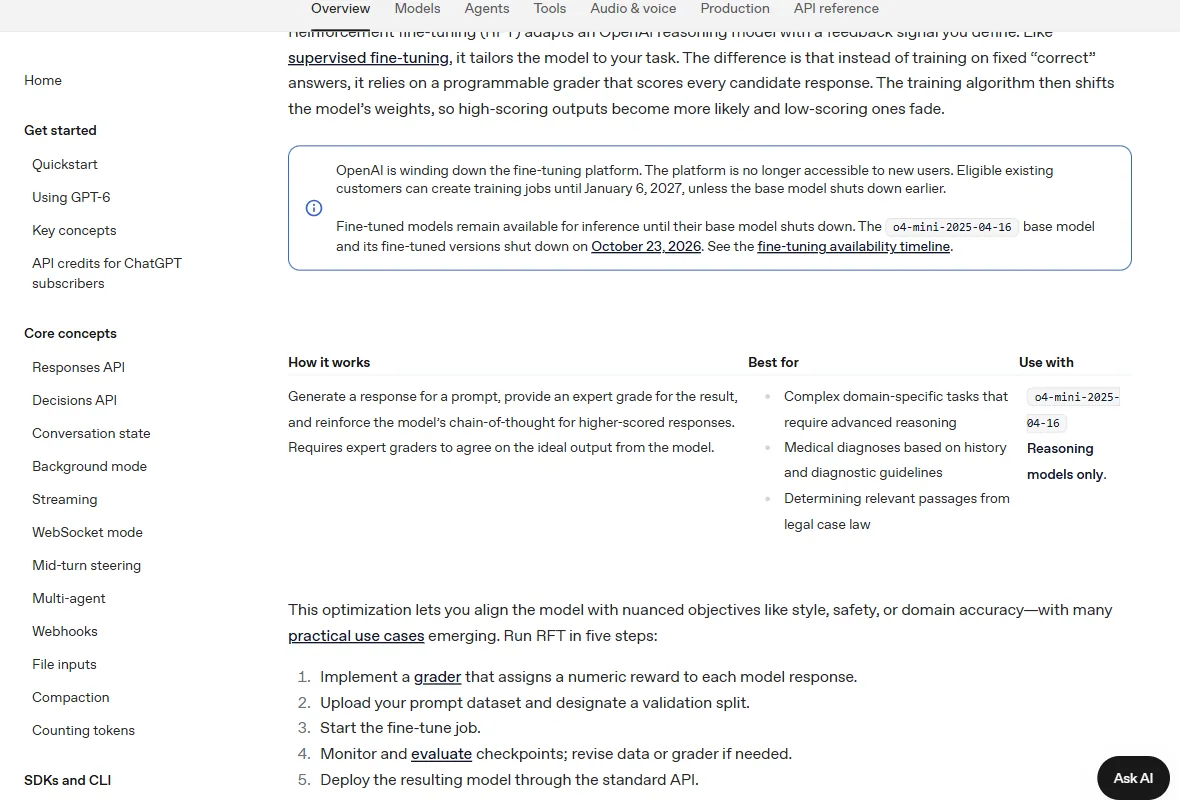
Guia de reinforcement fine-tuning da OpenAI com a descrição do processo e aviso sobre disponibilidade da plataforma.
Esta aula é opcional e nenhuma decisão do curso depende dela. As 21 aulas anteriores fecham o curso executivo por inteiro: quem parou lá já sabe classificar o incidente, escolher a régua, vetar a métrica frágil, orçar o piloto e definir quem assina. O apêndice existe para quem vai sentar com o time que implanta e precisa reconhecer, numa proposta técnica, qual família de algoritmo está em jogo e o que ela cobra de infraestrutura.
RLHF usa feedback humano, direta ou indiretamente, na formação do sinal de recompensa. RLVR usa recompensas verificáveis, como o resultado de uma checagem definida. Essas siglas descrevem aspectos do treinamento; não são certificados de correção ou segurança.
Ver como texto
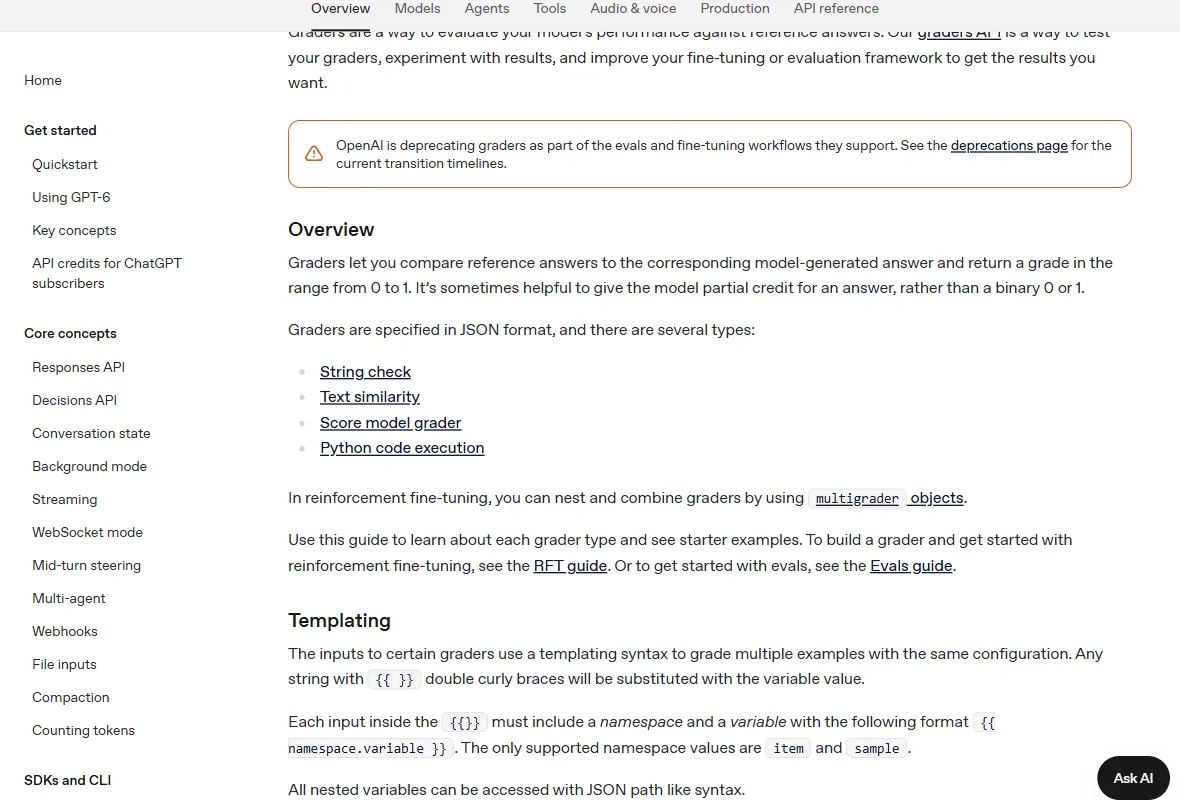
Documentação da OpenAI sobre graders, os avaliadores usados para atribuir notas às respostas.
Exemplo: um modelo produz várias soluções para problemas com respostas conhecidas. Um verificador pontua as soluções e o treinamento altera os pesos. Depois, problemas reservados medem se houve melhoria além dos exemplos usados. Se a equipe apenas selecionou a melhor resposta sem atualizar pesos, realizou seleção de candidatos.
Ver como texto
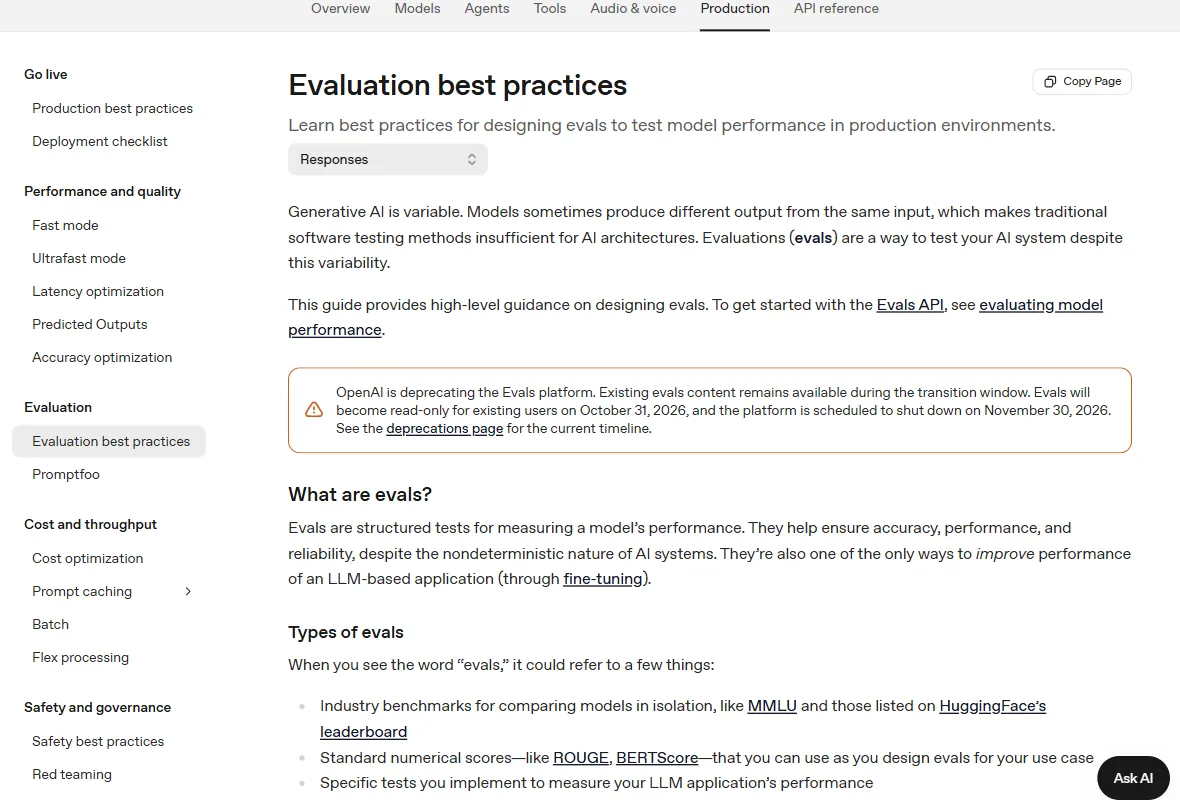
Guia da OpenAI de boas práticas de avaliação de sistemas de IA, com etapas e critérios para comparar resultados.
De onde vem o vocabulário
Todo o campo herdou a notação do processo de decisão de Markov. O agente observa um estado, escolhe uma ação, recebe uma recompensa e chega a um novo estado. Em código, o estado é o repositório mais o resultado da última execução de testes mais o custo já gasto; a ação é editar, rodar ou reverter; a recompensa é o que o verificador devolve. Nada aqui exige teoria de controle: o valor prático dessa moldura é obrigar quem projeta a responder, para cada eixo, o que exatamente entra no estado e o que exatamente conta como recompensa.
Ver como texto
O ciclo do processo de decisão de Markov em anel: o estado atual gera uma ação, a ação produz recompensa e transita para um novo estado, que reinicia o ciclo
Antes da recompensa verificável, o padrão era treinar contra preferência humana. O pipeline clássico, ao estilo do InstructGPT, tem três estágios: pré-treino do modelo base, ajuste fino supervisionado sobre demonstrações e, por último, um modelo de recompensa treinado a partir de comparações humanas entre pares de saídas, contra o qual a política é otimizada por PPO com penalidade de divergência de KL.
A ferramenta estatística do terceiro estágio é a perda de Bradley-Terry. Dado um par de respostas, uma escolhida e uma rejeitada, o modelo de recompensa tem que atribuir valor maior à escolhida, e a perda pune a inversão dessa ordem.
Ver como texto
Pipeline histórico de aprendizado por reforço com feedback humano em três estágios encadeados: pré-treino do modelo base, ajuste fino supervisionado e modelo de recompensa otimizado por PPO
import torch
import torch.nn.functional as F


def perda_bradley_terry(recompensa_escolhida, recompensa_rejeitada):
    """Perda de Bradley-Terry para treinar um modelo de recompensa.

    Maximiza a probabilidade de a resposta ESCOLHIDA receber valor maior que
    a REJEITADA. Equivale a menos log da sigmoide da diferença.
    """
    return -F.logsigmoid(recompensa_escolhida - recompensa_rejeitada).mean()


# Dados sintéticos: o modelo tem que separar as boas das ruins.
escolhidas = torch.tensor([2.1, 1.8, 3.0])
rejeitadas = torch.tensor([0.4, 1.1, 0.9])

perda = perda_bradley_terry(escolhidas, rejeitadas)
print(f"perda = {perda.item():.4f}")   # cai conforme a margem cresce

# Leitura: se a rejeitada pontuar acima da escolhida, a perda dispara e o
# gradiente empurra o modelo a corrigir a ordenação. Note o que está sendo
# aprendido aqui: a opinião do anotador, com todos os vieses dele embutidos.
Em tarefas de código, o modelo de recompensa é substituível por execução. O teste roda, passa ou não passa, e o veredito custa segundos de CPU em vez de minutos de atenção humana. É esse o giro que a recompensa verificável faz, e é dele que saem as quatro famílias que uma proposta técnica pode estar usando.
Ver como texto
Comparação de três otimizadores de política: PPO mantém uma rede crítica separada, GRPO estima a vantagem pela média do grupo sem crítico e virou a linha de base de comparação em 2026, e DPO otimiza pares de preferência sem modelo de recompensa
| Família | De onde vem o sinal | O que exige de infraestrutura | Onde está em 2026 |
|---|---|---|---|
| RLVR | Execução de um verificador determinístico: teste, checagem de tipo, restrição satisfeita | Ambiente isolado por rollout, suíte de testes confiável e bloqueio de escrita sobre o avaliador | É o regime, não o algoritmo. Combina com qualquer um dos três otimizadores abaixo |
| PPO | Recompensa aprendida ou verificável, com rede crítica estimando a linha de base | Duas redes ocupando memória de GPU ao mesmo tempo | Ainda em uso e origem do vocabulário. Custa mais memória que as alternativas |
| GRPO | Verificador, com a média do grupo de amostras servindo de linha de base | Mais amostras por prompt e nenhuma rede crítica. O custo migra da GPU para o ambiente | É contra ele que todo método novo do período se compara, o que na prática o define como linha de base do mercado |
| DPO | Pares de preferência já rotulados, sem modelo de nota intermediário | Nenhuma execução. Só o conjunto de pares e uma passada de treino | Polimento de estilo e convenção, depois que a correção funcional já foi resolvida |
A leitura de 2024 classificava GRPO como técnica em amadurecimento. Ela envelheceu: desde a onda de modelos de raciocínio aberto de 2025, GRPO virou a linha de base de comparação padrão em recompensa verificável, e é assim que aparece nos trabalhos de 2026 listados abaixo.
Fonte: Elaboração própria a partir das fontes citadas nesta aula, 24/07/2026
Ver como texto
Normalização de vantagem no GRPO: um grupo de amostras recebe recompensas do verificador, subtrai a média do grupo e divide pelo desvio, produzindo vantagens positivas e negativas relativas, e o grupo homogêneo zera a vantagem
import statistics


def vantagens_do_grupo(recompensas: list[float]) -> list[float]:
    """Vantagem normalizada dentro do grupo, sem rede crítica.

    A linha de base é a própria média das amostras irmãs do mesmo prompt.
    """
    media = statistics.mean(recompensas)
    desvio = statistics.pstdev(recompensas) or 1e-8   # evita divisão por zero
    return [(r - media) / desvio for r in recompensas]


def passo_grpo(prompt, politica, verificador, tamanho_do_grupo: int = 8):
    amostras = [politica.amostrar(prompt) for _ in range(tamanho_do_grupo)]
    recompensas = [verificador(a) for a in amostras]   # o sinal bruto do RLVR
    vantagens = vantagens_do_grupo(recompensas)

    # Grupo homogêneo, todas passam ou todas falham: não há o que aprender.
    # Monitore a FRAÇÃO de passos descartados por aqui. Ela subindo é o
    # primeiro sinal de que o verificador ficou fácil ou difícil demais.
    if all(v == 0.0 for v in vantagens):
        return None

    return list(zip(amostras, vantagens))
O que mudou entre maio e julho de 2026
O eixo da pesquisa saiu do algoritmo de atualização e foi para a topologia do rollout. O trabalho mais direto nessa direção observou que PPO, RLOO e GRPO herdaram do treino por preferência humana uma suposição que não vale mais: a de que cada trajetória precisa começar do estado inicial. Ambientes de agente são determinísticos, permitem tirar retrato do estado e permitem retomar de qualquer ponto intermediário. O BPO, Branching Policy Optimization, tira retrato em pontos de decisão de alta entropia, bifurca ações alternativas a partir dali e calcula vantagem por passo comparando irmãos.
Dois outros trabalhos do período tratam do mesmo ponto cego, cada um por um lado. O OC-GRPO ataca o penhasco de aprendizado do RLVR, a situação em que todos os rollouts de um grupo falham, a variância dentro do grupo colapsa e o gradiente fica identicamente zero. Ele gera rollouts guiados com informação privilegiada no prompt e depois corrige o objetivo para reconduzir a atualização ao problema original. O ECPO vai na direção oposta e mostra que crédito mais denso pode sair pela culatra.
Do lado da infraestrutura de treino, o que os laboratórios abertos publicaram no período é convergente: a camada que viabiliza o pós-treino em escala é o motor de rollout assíncrono, não o otimizador. A Z.ai declara ter construído o slime como condição para o pós-treino do GLM-5, e no GLM-5.2 descreve a mesma camada com rollout de caixa branca, rollout de caixa preta, trajetória compacta e fluxo de subagente, além de destilação on-policy paralela para fundir mais de dez modelos especialistas no modelo final.
Circula uma leitura, atribuída ao relatório do DeepSeek-V4, de que a destilação on-policy substituiu o aprendizado por reforço no pós-treino, restando ao GRPO apenas a fase de treino dos especialistas. É a afirmação mais interessante do período e a menos confirmada: ela vem de cobertura secundária e não foi encontrada na leitura do relatório. Não vira slide, não vira justificativa de arquitetura e não vira argumento em reunião sem alguém do time ter lido o documento original.
A conta que justifica treinar a política
Elevar a taxa de acerto de uma única amostra tem retorno composto sobre a conta de amostragem. Para atingir uma confiabilidade-alvo com uma política cuja chance de acerto por amostra é p, o número mínimo de amostras n satisfaz a desigualdade que o código abaixo resolve. A palavra que importa é mínimo: como n é inteiro e a desigualdade é de maior ou igual, o resultado é sempre o teto da divisão, jamais o piso.
import math


def prob_de_acerto_em_k(taxa_de_acerto: float, k: int) -> float:
    """Chance de ao menos uma entre k amostras passar em todos os testes.

    Ressalva do estimador: a fórmula supõe amostras independentes e uma taxa
    de acerto conhecida sem erro. Estimar essa taxa a partir de uma única
    rodada de amostragem produz um número otimista; o estimador não enviesado
    usa a contagem combinatória sobre as n amostras efetivamente geradas.
    """
    if not 0.0 <= taxa_de_acerto <= 1.0:
        raise ValueError("taxa de acerto fora do intervalo de 0 a 1")
    return 1.0 - (1.0 - taxa_de_acerto) ** k


def amostras_necessarias(taxa_de_acerto: float, alvo: float = 0.99) -> int:
    """Menor n inteiro com 1 - (1 - p)^n >= alvo.

    n >= log(1 - alvo) / log(1 - p), e o resultado é o TETO dessa divisão.
    Arredondar para baixo devolve um n que NÃO satisfaz a desigualdade.
    """
    if taxa_de_acerto <= 0.0:
        raise ValueError("com taxa de acerto zero nenhum n resolve")
    if taxa_de_acerto >= 1.0:
        return 1
    exato = math.log(1.0 - alvo) / math.log(1.0 - taxa_de_acerto)
    return math.ceil(exato)


# Conferência com alvo de 0,99:
#   p = 0,20  ->  exato 20,64  ->  21 amostras
#   p = 0,25  ->  exato 16,01  ->  17 amostras
#   p = 0,40  ->  exato  9,02  ->  10 amostras
#   p = 0,45  ->  exato  7,70  ->   8 amostras
#   p = 0,60  ->  exato  5,03  ->   6 amostras
#
# Dobrar p de 0,20 para 0,40 corta 52% da conta, de 21 para 10 amostras.
# A versão anterior deste curso publicava 9, 5 e "corte de 57%", porque
# arredondava 9,02 para 9 e 5,03 para 5. Com 9 amostras a 0,40 de taxa de
# acerto, a confiabilidade obtida é 0,9899, abaixo do alvo declarado.| Taxa de acerto de uma amostra | Resultado exato da divisão | Amostras necessárias | Leitura |
|---|---|---|---|
| 0,20 | 20,64 | 21 | Ponto de partida comum de um agente sem treino específico na base de código |
| 0,25 | 16,01 | 17 | Primeiro valor do exercício antigo. Arredondado para baixo daria 16, e 16 não atinge a meta |
| 0,40 | 9,02 | 10 | Dobrar a taxa de acerto corta 52% da conta, de 21 para 10 amostras |
| 0,45 | 7,70 | 8 | Segundo valor do exercício antigo |
| 0,60 | 5,03 | 6 | Triplicar a taxa de acerto corta 71% da conta, de 21 para 6 amostras |
Todas as linhas usam o teto da divisão de log(1 menos 0,99) por log(1 menos a taxa de acerto). Nenhum valor desta tabela pode ser arredondado para baixo: 9,02 vira 10, não 9.
Fonte: Cálculo próprio a partir da desigualdade de compressão de busca, conferido em 24/07/2026
Ver como texto
Curva de compressão de busca: para um alvo de 99 por cento de confiabilidade, o número de amostras necessárias cai de 21 para 10 e depois para 6 conforme a taxa de acerto de uma amostra sobe de 0,20 para 0,40 e 0,60
Auditoria de uma proposta técnica de treino, antes de aprovar orçamento
Identificar a família e o custo que ela traz
0/3Sinais de saúde que precisam estar no painel desde o dia 1
0/3Números que a proposta cita
0/2Três perguntas para testar a decisão antes da próxima reunião: (1) Uma proposta promete o mesmo resultado do GRPO sem aumentar o número de amostras por prompt e sem manter rede crítica: qual pergunta você faz antes de acreditar? (2) O treino roda há duas semanas, a recompensa média não se move e ninguém instrumentou a fração de passos descartados: você manda parar ou manda instrumentar primeiro? (3) O fornecedor apresenta um ganho de 3,9 pontos medido em benchmark de matemática como evidência para um agente de correção de bugs: você aceita o número, pede a medição no seu domínio ou recusa a proposta?
Peça ao time técnico que identifique a família de algoritmo da proposta em uma linha, com a infraestrutura que ela exige, e compare com a tabela das quatro famílias. Resposta que não caiba na tabela volta com pedido de documentação antes de qualquer orçamento de computação.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafoO Setup ensina permissões, contexto do projeto e escolha de modelo por custo. Essa preparação sustenta os exercícios de comparação de assistentes, criação do gerador de UTM e regras de projeto no curso de aprendizado por reforço e vibecoding.
- CursoAstra profundosugerido pelo grafo4 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Astra profundo”.
- CursoLetramento em IA para Executivossugerido pelo grafo5 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Letramento em IA para Executivos”.
- CursoVídeo com IA: do roteiro à publicaçãosugerido pelo grafo2 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Vídeo com IA: do roteiro à publicação”.
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.