Avaliar e melhorar agentes · ·
Conferir a passagem do piloto para o uso real
Prepare observação, interrupção e retorno à versão anterior.
Este capítulo faz parte do curso gratuito Avaliar e melhorar agentes.
Ver como texto
Arquitetura ponta a ponta do agente com recompensa verificável: incidente e telemetria alimentam a geração de hipótese, que aplica o patch em ambiente isolado, o verificador executa os testes ocultos, a função de recompensa mede com penalidade de integridade, a política aprende e o orquestrador fecha o ciclo devolvendo métricas de produção
- Etapa 1 de 6: 1. Hipótese
Parte de dado de incidente. Armadilha: hipótese vaga, sem evidência quantitativa
- Etapa 2 de 6: 2. Aplicação isolada
Ramo próprio e ambiente descartável. Armadilha: sandbox que fala com a rede
- Etapa 3 de 6: 3. Verificação
Testes ocultos, segurança e regressão. Armadilha: medir só o que o agente enxerga
- Etapa 4 de 6: 4. Score
Recompensa com integridade primeiro. Armadilha: peso alto no que é fácil de farmar
- Etapa 5 de 6: 5. Atualização
Política aprende e ajusta a busca. Armadilha: temperatura fixa do início ao fim
- Etapa 6 de 6: 6. Parada
Ganho marginal ou teto de gasto. Armadilha: parar pelo relógio, não pela recompensa
Ver como texto
- 1. Hipótese: Parte de dado de incidente. Armadilha: hipótese vaga, sem evidência quantitativa
- 2. Aplicação isolada: Ramo próprio e ambiente descartável. Armadilha: sandbox que fala com a rede
- 3. Verificação: Testes ocultos, segurança e regressão. Armadilha: medir só o que o agente enxerga
- 4. Score: Recompensa com integridade primeiro. Armadilha: peso alto no que é fácil de farmar
- 5. Atualização: Política aprende e ajusta a busca. Armadilha: temperatura fixa do início ao fim
- 6. Parada: Ganho marginal ou teto de gasto. Armadilha: parar pelo relógio, não pela recompensa
Um piloto usa um conjunto limitado de casos. A operação real pode trazer dados e volumes diferentes. Antes de ampliar, defina quem acompanha erros, onde eles são registrados e como voltar à configuração anterior. A aprovação precisa corresponder à versão que será usada.
Ver como texto
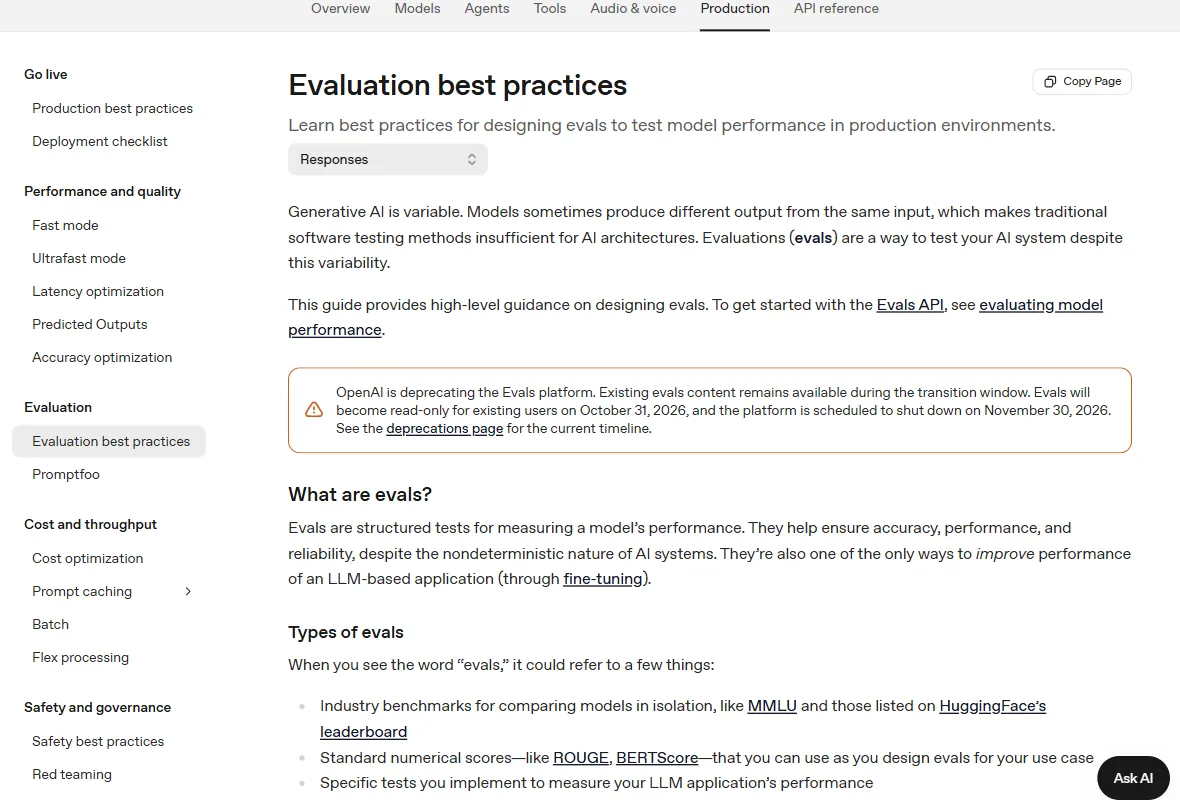
Guia da OpenAI de boas práticas de avaliação de sistemas de IA, com etapas e critérios para comparar resultados.
Esta aula é opcional. Ela reúne o painel mínimo, as métricas obrigatórias e o checklist de promoção que o time precisa ter pronto antes de tirar o piloto do ambiente isolado. Fecha com a conta de infraestrutura que costuma ser esquecida no orçamento, porque ela não está na GPU.
| Métrica | O que mede | Meta de referência |
|---|---|---|
| Taxa de acerto na primeira tentativa | Solução correta já na primeira resposta, sem repetição | Sobe contra a linha de base medida antes de começar |
| Cobertura por amostras | Correção em k amostras, ou seja, quanto de busca a política ainda precisa | Sobe sem inflar o custo por tarefa resolvida |
| Taxa de regressão | Testes que estavam verdes e a mudança quebrou | Zero por iteração. É bloqueante, não informativa |
| Latência p95 | Cauda de latência sob carga real, não em bancada | Igual ou abaixo do objetivo de serviço, e igual pontua como atingido |
| Custo por tarefa resolvida | Gasto por incidente efetivamente fechado, contando as tentativas que falharam | Cai a cada iteração, medido em moeda e não em tokens |
| Taxa de fraude detectada | Edições do avaliador, de configuração de integração contínua ou de caminho proibido | Zero. Um único caso barra a promoção e abre investigação |
| Desempenho em teste retido | Tarefas novas, que o agente nunca viu em treino nem em ajuste | Sem queda contra o desempenho de treino |
A meta de latência foi reescrita para deixar explícito que atingir o objetivo de serviço pontua como atingido. A versão anterior definia a meta assim e implementava uma função que devolvia zero exatamente no ponto da meta.
Fonte: Painel do projeto final do curso anterior, revisado em 24/07/2026
Ver como texto
Exemplo ilustrativo de painel de métricas do agente, com números fictícios: cobertura por número de amostras, distribuição de latência contra a meta de serviço, custo por execução ao longo das iterações e a faixa de sinais de guarda que barram a promoção
Separe o ciclo de execução do ciclo de treinamento. Executar, medir e selecionar uma resposta pode acontecer numa tarefa. Reunir exemplos, atualizar pesos e liberar uma nova versão exige outro processo, com avaliação e autorização próprias. Dados coletados na operação não devem entrar automaticamente no treino sem essa decisão.
Ver como texto
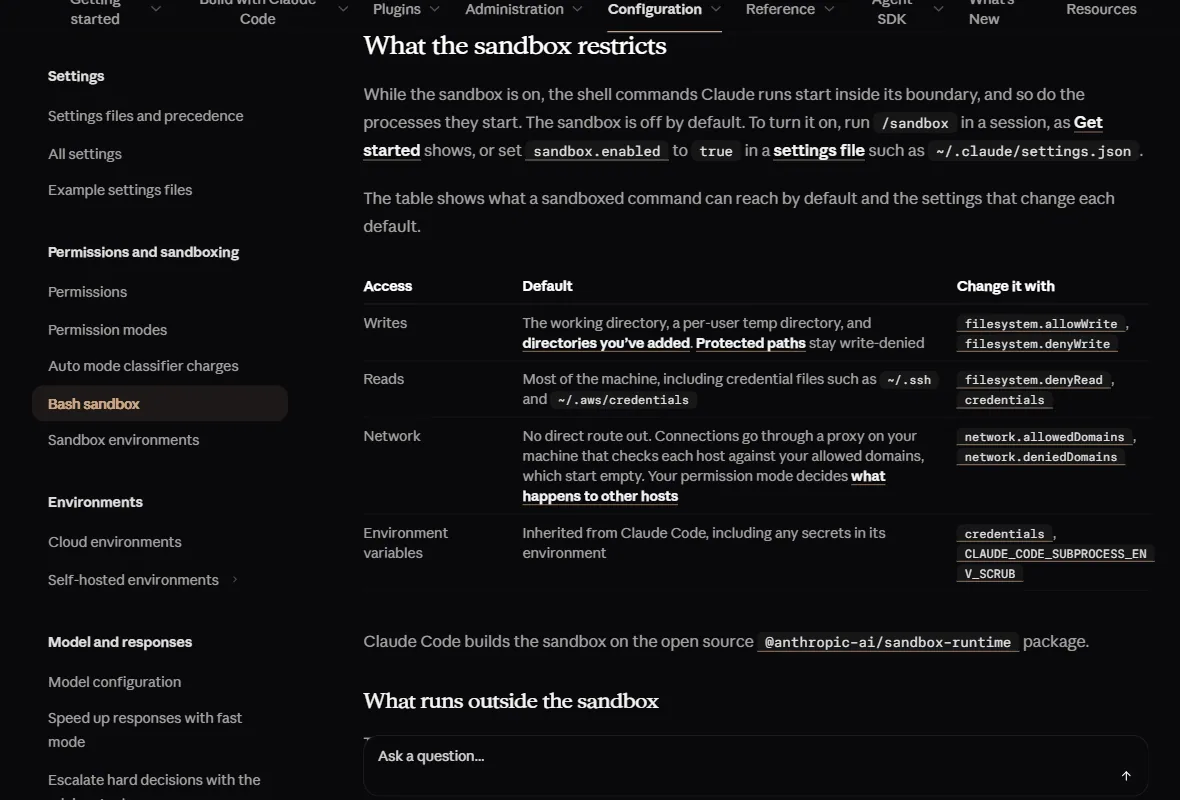
Documentação do sandbox do Claude Code com restrições de acesso e o que pode executar fora do isolamento.
Exemplo: a nova versão falha em nomes com acento, um caso pouco representado no piloto. A equipe interrompe sua ampliação, volta à versão anterior e acrescenta exemplos à avaliação. Só depois decide se a correção é de código, instrução, dados ou treinamento.
Ver como texto
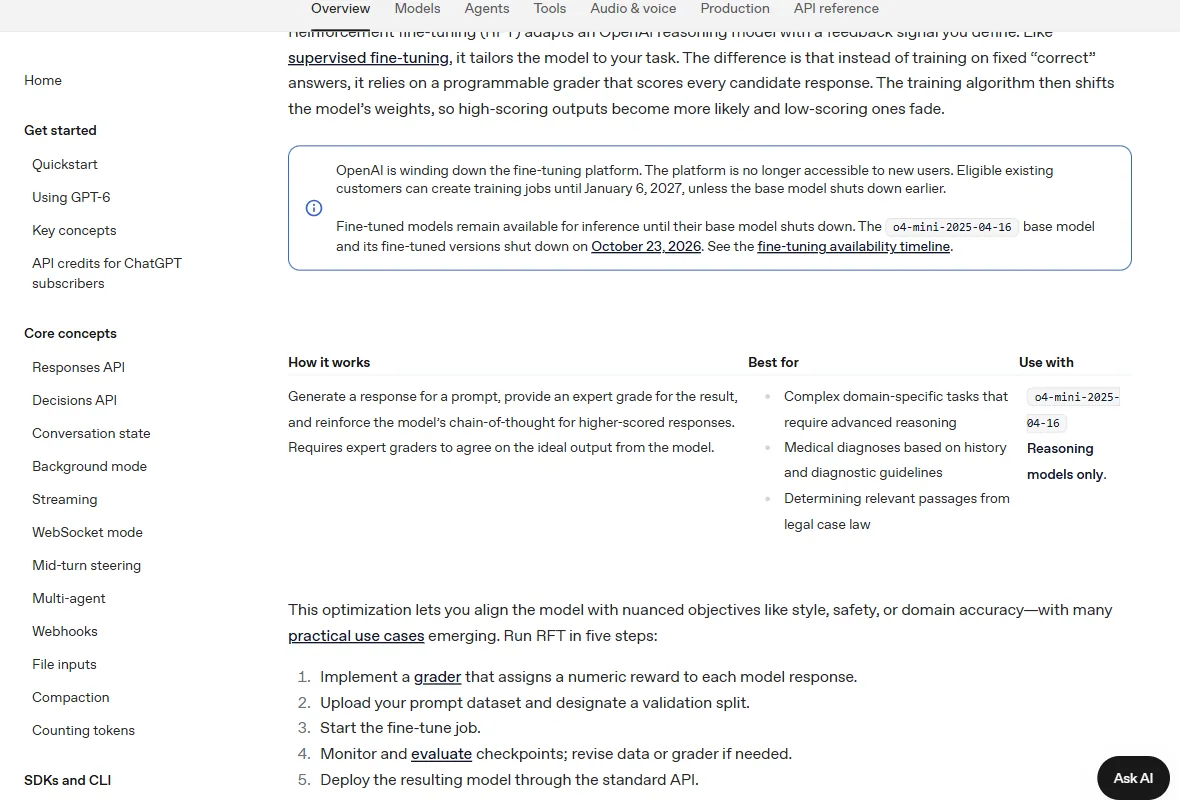
Guia de reinforcement fine-tuning da OpenAI com a descrição do processo e aviso sobre disponibilidade da plataforma.
Ver como texto
A recompensa controla o fluxo: a faixa de score decide entre aprovar, corrigir, reenviar ou escalar, formando uma árvore de decisão de quatro saídas
# Portões de qualidade e teto de gasto, versionados junto ao código.
# A ordem importa: camada barata primeiro, camada cara só para o que sobrou.
quality_gates:
  - name: sintaxe
    stage: 0
    verifier: parser
    blocking: true            # falhou aqui, nem sobe de camada

  - name: tipos
    stage: 1
    verifier: type_checker
    blocking: true

  - name: testes
    stage: 2
    verifier: pytest
    min_pass_rate: 1.0        # todos os testes verdes
    blocking: true

  - name: semantica
    stage: 3
    verifier: llm_judge       # camada cara, só chega aqui o que passou
    min_score: 6.0            # escala de 0 a 10
    blocking: false           # gera alerta, não trava a entrega

finops:
  teto_por_execucao_usd: 2.50 # desligamento automático ao atingir
  route:
    "1-2": local              # tarefa trivial não vai para modelo de fronteira
    "3": intermediate
    "4-5": frontier
  semantic_cache:
    similarity_threshold: 0.92
    store_sensitive: false    # dado sensível nunca entra no cache
  idle_worker_shutdown_s: 300
spot_instances: trueMarque como bloqueante só a camada determinística: sintaxe, tipos e testes. A camada de juiz por modelo de linguagem costuma ser não bloqueante, porque travar a entrega em um julgamento probabilístico transfere para o modelo uma decisão que é de política interna. Ela emite alerta e alimenta o laço de melhoria.
Uma execução pode gerar candidatos e selecionar o melhor sem alterar pesos. Para transformar esses registros em treinamento, a equipe ainda precisa selecionar e revisar exemplos, definir o método de atualização e avaliar a nova versão. Tentativas rejeitadas também custam coleta e revisão; não são rótulos confiáveis por definição.
Ver como texto
Ciclo de auto-melhoria: a política atual gera vários candidatos, o verificador atribui recompensas, os candidatos ranqueados viram um conjunto de pares de preferência e a destilação produz a política seguinte, que reinicia o anel
def laco_de_auto_melhoria(politica, tarefas, verificador, destilador,
                          k=8, max_rodadas=20, paciencia=3):
    """Converte tentativas verificadas em preferências e reafina a política."""
    melhor_recompensa, sem_ganho = 0.0, 0

    for rodada in range(max_rodadas):
        preferencias = []
        for tarefa in tarefas:
            # 1. Temperatura alta no início, baixa perto da solução.
            temperatura = agenda_de_temperatura(rodada, max_rodadas)
            candidatos = politica.amostrar(tarefa.prompt, n=k,
                                           temperatura=temperatura)

            # 2. O verificador pontua cada candidato.
            pontuados = [(c, verificador.rodar(tarefa, c)) for c in candidatos]
            pontuados.sort(key=lambda x: x[1], reverse=True)

            # 3. Par de preferência só com margem clara entre melhor e pior.
            melhor, pior = pontuados[0], pontuados[-1]
            if melhor[1] - pior[1] >= 0.3:
                preferencias.append({
                    prompt: tarefa.prompt,
                    escolhido: melhor[0], "rejeitado": pior[0],
                    margem: melhor[1] - pior[1],
                })

            # 4. Persistir os quatro artefatos ANTES de seguir. Rodada cortada
            #    por orçamento sem registro perde os pares já coletados.
            persistir_artefatos(tarefa, melhor, verificador)

        politica = destilador.atualizar(politica, preferencias)

        # Parada pela recompensa, nunca pelo relógio.
        recompensa_media = avaliar(politica, tarefas, verificador)
        if recompensa_media - melhor_recompensa < 0.01:
            sem_ganho += 1
            if sem_ganho >= paciencia:
                break
        else:
            melhor_recompensa, sem_ganho = recompensa_media, 0

    return politica
Os quatro artefatos persistidos por iteração, que tornam o laço auditável
- Prompt de entrada: a tarefa exata que originou a geração, com a versão do repositório.
- Patch resultante: o diff que o agente propôs, mesmo quando reprovado.
- Saída bruta do verificador: log de teste, pilha de erro e relatório de cobertura, sem resumo.
- Estrutura da recompensa: como o veredito virou número, componente por componente.
Onde o dinheiro do treino realmente vai
Aqui está o dado mais executivo de infraestrutura do período, e o que mais surpreende quem orça o piloto olhando para o preço da GPU. Um estudo comparativo de quatro substratos de execução encontrou variação de até 110 vezes na latência de partida a frio entre eles, com um espalhamento de 1,8 vez nas horas de trabalhador projetadas para um milhão de trajetórias. A conta que traduz isso em dinheiro é aritmética simples: 1 segundo a mais por execução, multiplicado por um milhão de execuções, são 278 horas adicionais.
A leitura para quem vai implantar é direta. Se a geração de execuções domina o tempo de treino, e a latência de partida a frio do substrato varia duas ordens de grandeza, então a escolha do substrato de execução move mais o orçamento do que a escolha do otimizador. Meça a partida a frio do seu ambiente antes de discutir algoritmo.
O outro lado dessa moeda é que o ambiente deixou de ser algo que cada empresa constrói do zero. Ele virou item de catálogo.
As condições comerciais variam por produto. Lote, cache, execução gerenciada e localização dos dados podem ter cobranças próprias. Registre cada item na mesma data e na unidade apresentada pelo fornecedor, sem transportar descontos ou limites de uma oferta para outra. A estimativa deve incluir execução, armazenamento e revisão humana.
Toda tabela de preço citada aqui foi consultada em 24/07/2026 e vale para aquela data. Preço de modelo muda com aviso curto e às vezes com data marcada para subir. Reconsulte a tabela oficial na véspera de qualquer publicação, apresentação a conselho ou fechamento de orçamento, e registre a data da consulta ao lado do número.
Para calibrar a escala de quem faz isso de verdade: o pós-treino de um modelo de pesos abertos lançado em julho de 2026 declarou mais de 30 milhões de execuções de RL assíncrono. Esse é o volume que a infraestrutura de rollout precisa sustentar num laboratório de fronteira, e é a referência contra a qual o número do seu piloto deve ser lido antes de alguém prometer resultado equivalente.
Checklist de promoção a produção, oito itens bloqueantes
O que precisa estar verde antes de sair do ambiente isolado
0/8Duas medições que economizam mais que qualquer otimização de algoritmo
0/2Guia prático: instalar o laço de recompensa medida no repositório
Seis passos na ordem em que as falhas custam mais caro quando aparecem tarde.
Passo 1: Isole o ambiente de execução
Sem rede e sem histórico do repositório; na auditoria da Cursor, o mesmo agente caiu de 87,1% para 73,0% quando perdeu esse acesso.
Deu certo quando: O agente não alcança respostas prontas fora da tarefa.
Erro comum: Medir com a rede aberta e promover com o número inflado.
Passo 2: Fixe o arranjo por escrito
Modelo, nível de esforço, número de tentativas, ferramentas e contexto.
Deu certo quando: Arquivo de configuração versionado junto do resultado.
Erro comum: Trocar uma variável do arranjo entre duas medições.
Passo 3: Separe o lote retido em repositório próprio
Acesso só para quem guarda a régua.
Deu certo quando: O agente falha ao tentar ler o lote.
Erro comum: Guardar o lote numa pasta que o agente lê.
Passo 4: Grave trajetórias em registro imutável
Cada comando e cada arquivo tocado, com hora.
Deu certo quando: Qualquer entrega pode ser reconstituída passo a passo.
Erro comum: Registro que o próprio operador consegue apagar.
Passo 5: Imponha o teto por execução no orquestrador
O orquestrador corta a execução antes de o teto estourar.
Deu certo quando: Nenhuma execução passa do teto no mês.
Erro comum: Teto só no painel, sem corte automático.
Passo 6: Publique o painel de sete métricas
Semanal, com linha de base marcada.
Deu certo quando: Comitê lê o painel sem pedir explicação.
Erro comum: Painel que mostra só as métricas que subiram.
No fim você tem: Um laço que o time consegue auditar e o comitê consegue ler antes de promover o piloto a produção.
Três perguntas para testar a decisão antes da próxima reunião: (1) O piloto está com sete das sete métricas subindo e um único caso de fraude detectado no mês: você promove com ressalva, adia a promoção ou abre investigação antes de qualquer decisão? (2) O time quer trocar o otimizador para ganhar 4 pontos e ainda não mediu a latência de partida a frio do ambiente: você aprova a troca ou exige a medição primeiro? (3) O orçamento do piloto foi aprovado com a tabela de preços de julho e a apresentação ao conselho é em setembro: você reapresenta o mesmo número ou reconsulta a tabela antes?
Instale o laço pelos seis passos do guia e promova o piloto só quando os oito itens bloqueantes estiverem verdes. Guarde o painel de sete métricas da semana da promoção como linha de base de produção. Trinta dias depois, confira se alguma métrica caiu abaixo dela.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- Calcular o custo por tarefa e escolher o modelo pelo resultadosugerido pelo grafoApresenta o conceito “Custo por tarefa”, usado em “Conferir a passagem do piloto para o uso real”.
- Escolha as duas tarefas da sua agenda que merecem um pilotosugerido pelo grafoApresenta o conceito “Teste limitado”, usado em “Conferir a passagem do piloto para o uso real”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafoO Setup ensina permissões, contexto do projeto e escolha de modelo por custo. Essa preparação sustenta os exercícios de comparação de assistentes, criação do gerador de UTM e regras de projeto no curso de aprendizado por reforço e vibecoding.
- CursoAstra profundosugerido pelo grafo4 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Astra profundo”.
- RLM: grandes acervosO que muda quando um agente melhoraExaminar conexões de O que muda quando um agente melhora
- Modelo de trabalho com agentes de IAComo começar e revisar o plano de 90 dias?Examinar conexões de Como começar e revisar o plano de 90 dias?
- Frontends com VibecodingSupervisionar o modelo que opera o computadorExaminar conexões de Supervisionar o modelo que opera o computador
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.