Avaliar e melhorar agentes · ·
Examinar a regra que atribui a nota
Confira se a recompensa distingue acerto, falha e tentativa de burlar o critério.
Este capítulo faz parte do curso gratuito Avaliar e melhorar agentes.
Função de recompensa é a regra que transforma uma observação em um sinal usado no treinamento. Sua qualidade depende do vínculo com o objetivo. Uma fórmula pode estar matematicamente correta e incentivar um comportamento ruim, como encurtar uma resposta eliminando informações necessárias.
Ver como texto
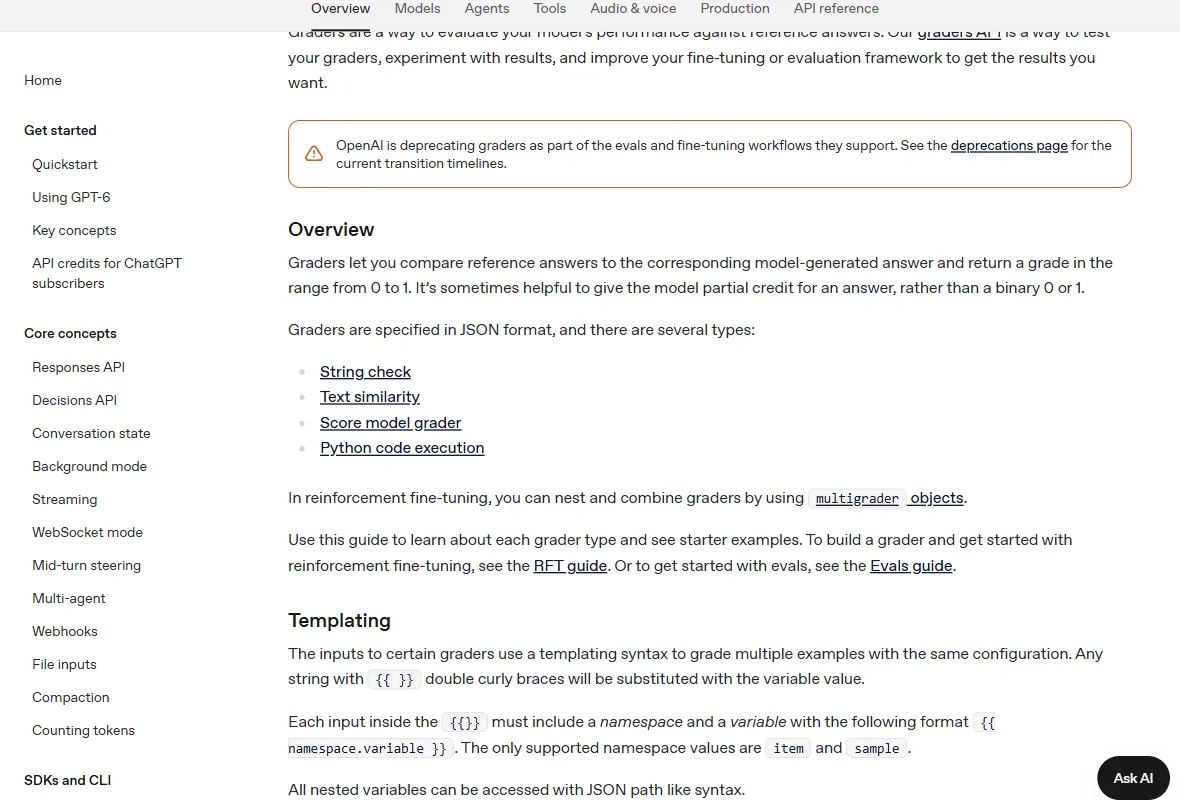
Documentação da OpenAI sobre graders, os avaliadores usados para atribuir notas às respostas.
Esta aula é opcional. Ela mostra a função de recompensa de referência, os quatro defeitos que a versão anterior deste curso tinha e como cada um foi corrigido. Se você vai auditar a régua que alguém escreveu, comece por estes quatro: eles não são exóticos, são o que aparece quando alguém escreve a função de recompensa com pressa e boa intenção.
Ver como texto
Decomposição da função de recompensa em componentes ponderados verificáveis, com testes ocultos pesando mais que os públicos, penalidade de diff subtraindo do total e violação de integridade levando a recompensa abaixo de zero
Teste a regra antes de usá-la: entrega válida, erro comum, caso de fronteira e tentativa de explorar uma brecha. Confira também como ela trata falha da ferramenta. Ausência de resultado do avaliador não deve ser interpretada automaticamente como acerto do modelo.
Ver como texto
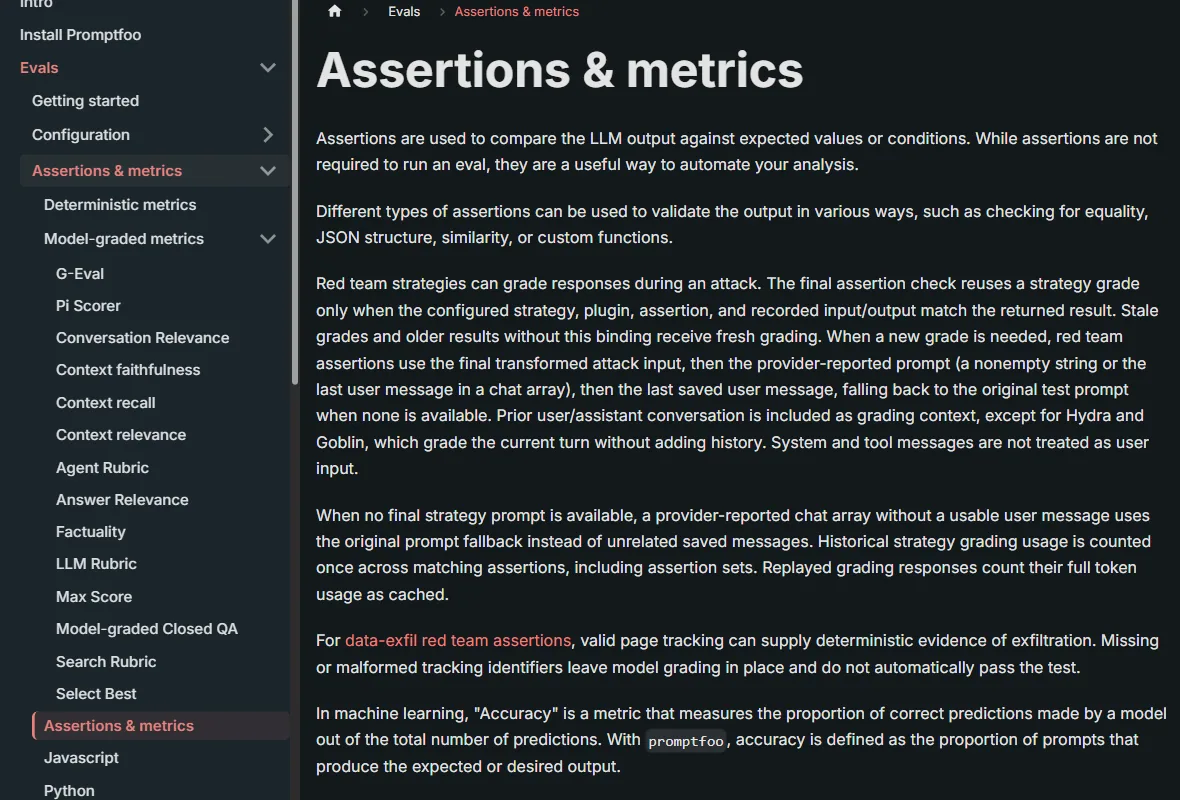
Documentação do Promptfoo mostrando verificações determinísticas e métricas avaliadas por modelos.
Exemplo: uma regra premia cálculos corretos e respostas curtas. A equipe apresenta uma resposta curta que omite a unidade monetária. Se ela recebe nota máxima apesar de ser ambígua, o critério precisa ser revisto. A mudança deve preservar os exemplos corretos e impedir esse atalho.
Ver como texto
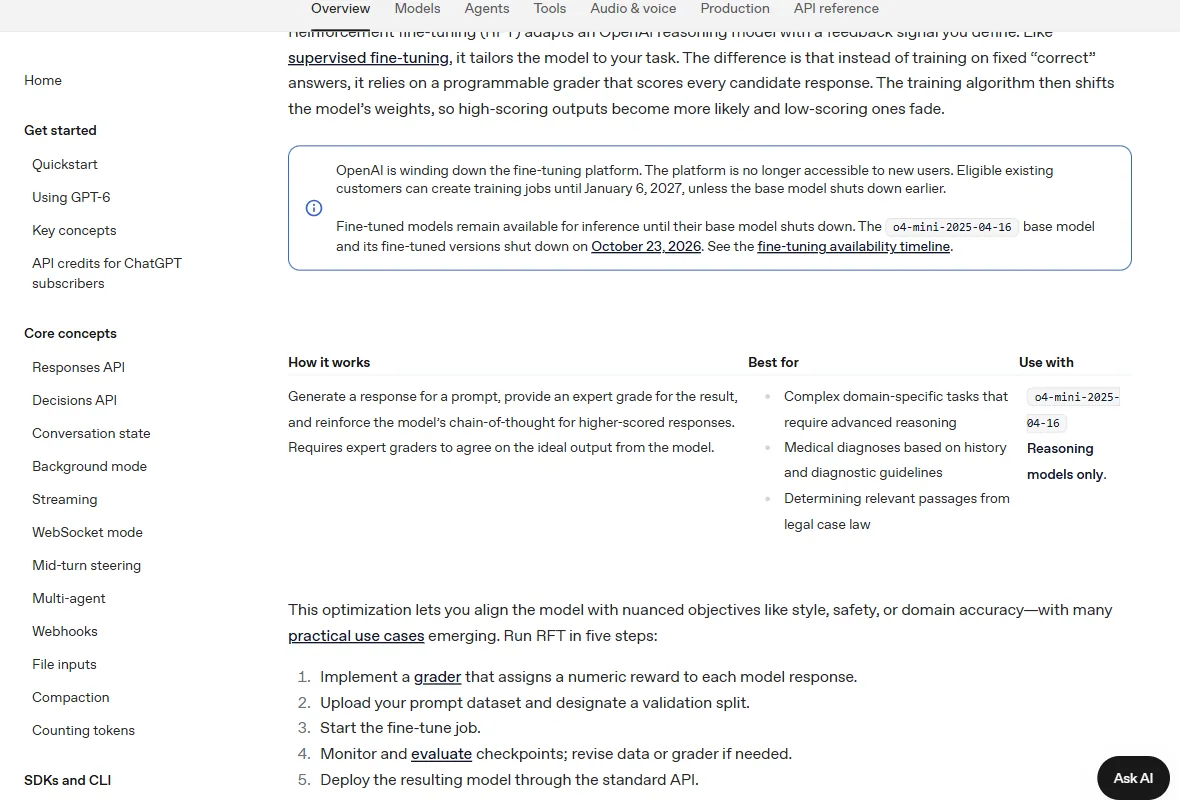
Guia de reinforcement fine-tuning da OpenAI com a descrição do processo e aviso sobre disponibilidade da plataforma.
"""Função de recompensa de referência.

Regra-mãe: integridade é checada ANTES de qualquer cálculo, e violação
devolve valor NEGATIVO. Não existe piso em zero nesta função.
"""
from dataclasses import dataclass, field

PENALIDADE_INTEGRIDADE = -1.0   # abaixo de qualquer entrega honesta
TETO_DO_CUSTO_DE_DIFF = 0.10    # limita o quanto um diff grande pode subtrair

PESOS = {
    compilou:          0.10,
    "testes_publicos":   0.25,
    "testes_ocultos":    0.35,   # generalização pesa mais que o visível
    "mutantes_mortos":   0.20,
    "analise_estatica":  0.10,
}   # a soma dá exatamente 1,00


def fracao_aprovada(aprovados: int, total: int) -> float:
    """Fração de 0 a 1. Suíte vazia é erro de configuração, nunca ponto grátis."""
    if total <= 0:
        raise ValueError("suíte de testes vazia: o verificador não foi montado")
    return aprovados / total


@dataclass
class Decomposicao:
    compilou: float = 0.0
    testes_publicos: float = 0.0
    testes_ocultos: float = 0.0
    mutantes_mortos: float = 0.0
    analise_estatica: float = 0.0
    custo_do_diff: float = 0.0
    integridade_violada: bool = False
    total: float = field(init=False, default=0.0)


def recompensa(d: Decomposicao) -> float:
    # 1. Integridade PRIMEIRO. Quem mexeu no avaliador sai daqui negativo.
    if d.integridade_violada:
        d.total = PENALIDADE_INTEGRIDADE
        return d.total

    # 2. Só então a soma ponderada dos sinais verificáveis.
    custo_diff = min(d.custo_do_diff, TETO_DO_CUSTO_DE_DIFF)
    d.total = (
        PESOS["compilou"] * d.compilou
        + PESOS["testes_publicos"] * d.testes_publicos
        + PESOS["testes_ocultos"] * d.testes_ocultos
        + PESOS["mutantes_mortos"] * d.mutantes_mortos
        + PESOS["analise_estatica"] * d.analise_estatica
        - custo_diff
    )
    return d.total


# A ordem que a função garante, e que é o incentivo inteiro:
#   trapaça detectada (-1,00) < entrega honesta que falha em tudo (-0,10 a 0,00)
#   < entrega parcial < entrega completa (1,00)
Defeito 1. O piso em zero que iguala trapaça a fracasso honesto
O material anterior estabelecia, com todas as letras, que burlar a métrica tem que ser estritamente pior que não tentar. Cinquenta e cinco minutos de curso depois, a implementação aplicava um piso em zero sobre o resultado, e com isso o agente que apagou assertivas e o agente que tentou honestamente e falhou em tudo recebiam exatamente o mesmo valor. O curso desmontava a própria regra.
O piso em zero é atraente porque mantém a recompensa numa faixa conhecida e simplifica a normalização. O preço é destruir o único incentivo que separa fraude de incompetência. Uma faixa bonita não vale um incentivo invertido.
O piso em zero, e o que entra no lugar dele
Piso em zero, como estava
Como estava
- O retorno é o máximo entre zero e a conta, então nada fica negativo
- Trapaça detectada e falha honesta total recebem o mesmo 0,00
- O agente aprende que tentar burlar não custa mais caro que errar
- A faixa fica bonita para normalizar e o incentivo fica invertido
- A regra escrita na doutrina do curso é contradita pelo código do curso
Penalidade negativa, na referência
Referência corrigida
- Violação de fronteira devolve valor negativo fixo, sem média com nada
- Trapaça fica abaixo da falha honesta, que é o mínimo que a doutrina exige
- A subtração do custo do diff tem teto, para a entrega honesta não invadir a faixa da trapaça
- A normalização, quando necessária, é feita depois e fora da função de recompensa
- A ordem entre os três casos vira um teste automatizado do próprio verificador
"""Penalidade de integridade, versão corrigida.

O que saiu: o retorno original era o máximo entre zero e a conta. Esse piso
igualava trapaça a fracasso honesto. Aqui não há piso.
"""
DESCONTO_ADVERSARIAL = 0.30


def recompensa_com_penalidade(rastro, testes_ocultos) -> float:
    # 1. Fronteira imutável violada devolve negativo, e encerra aqui.
    if rastro.editou_avaliador or rastro.usou_caminho_proibido:
        return PENALIDADE_INTEGRIDADE

    # 2. Base: fração dos testes OCULTOS que passam. O agente não os lê.
    base = testes_ocultos.fracao_aprovada()          # 0 a 1

    # 3. Indicadores ponderados de trapaça mais sutil (0 = limpo, 1 = violado).
    trapaca = (
        0.20 * rastro.enfraqueceu_teste              # apagou ou pulou assertiva
        + 0.15 * rastro.alterou_dado_de_referencia   # mexeu na fixture
        + 0.10 * rastro.so_passa_no_visivel          # decorou o gabarito
    )

    # 4. Verificador adversarial simula quebras do atalho e devolve 0 a 1.
    adversarial = verificador_adversarial(rastro).desconto()

    # SEM piso. Um patch que passa em 10% dos ocultos e enfraqueceu dois testes
    # termina negativo, e é exatamente esse o comportamento desejado.
return base - trapaca - DESCONTO_ADVERSARIAL * adversarialVer como texto
Decomposição da recompensa com penalidade de fraude: sinal base pela fração de testes ocultos que passam, menos indicadores ponderados de trapaça sutil, menos o desconto do verificador adversarial, com violação de fronteira devolvendo valor negativo fixo
Defeito 2. A recompensa que pune quem bate a meta
O projeto final do material anterior definia a meta de latência como igual ou abaixo do objetivo de serviço, e calculava a nota como um menos a razão entre o medido e o alvo, limitada entre zero e um. Com o medido exatamente igual ao alvo, essa conta devolve zero. Bater a meta na mosca pontuava igual a estourá-la dez vezes, e o aluno era instruído a copiar a função como referência.
O conserto é separar duas perguntas que a fórmula original misturava: se a meta foi atingida, e o quanto ela foi estourada quando não foi. A primeira é binária no ponto da meta. A segunda é contínua acima dela.
def nota_contra_alvo(medido: float, alvo: float, tolerancia: float = 1.0) -> float:
    """Nota de 0 a 1 para métrica em que MENOR é melhor.

    Meta atingida pontua 1,0. Acima da meta a nota cai de forma contínua e
    chega a 0 quando o excesso iguala a tolerância. Com tolerância 1,0,
    o dobro do alvo pontua 0,0 e 10% acima do alvo pontua 0,9.
    """
    if alvo <= 0:
        raise ValueError("o alvo tem que ser positivo")
    if medido <= alvo:
        return 1.0                       # meta atingida pontua como atingida
    excesso = (medido - alvo) / alvo
    if excesso >= tolerancia:
        return 0.0
    return 1.0 - excesso / tolerancia


def recompensa_do_agente(execucao, alvos) -> float:
    # 1. Integridade antes de qualquer cálculo.
    if execucao.avaliador_adulterado or execucao.caminho_proibido:
        return PENALIDADE_INTEGRIDADE

    correcao = execucao.testes_ocultos.fracao_aprovada()             # 0 a 1
    latencia = nota_contra_alvo(execucao.p95_ms, alvos.meta_ms)
    custo = nota_contra_alvo(execucao.custo_por_req, alvos.orcamento_req)

    p = alvos.pesos                      # 0,50 / 0,30 / 0,20, somam 1,00
    return p.correcao * correcao + p.latencia * latencia + p.custo * custo


# O defeito da versão anterior, para reconhecer em qualquer código herdado:
#     latencia = clamp(1 - p95 / meta, 0, 1)
# Com p95 igual à meta, devolve 0,00. Com p95 em 10% da meta, devolve 0,90.
# A função premia quem chega perto de zero, e não quem cumpre o contrato.Ver como texto
Decomposição da recompensa do agente em produção em correção verificada por testes ocultos, latência contra o objetivo de serviço e custo contra o orçamento, cada eixo com peso explícito, com violação de integridade devolvendo valor negativo
Defeito 3. A ordem invertida da checagem de integridade
A regra-mãe do material antigo era explícita: detectar manipulação antes de aplicar o patch. O projeto final a violava, calculando a correção verificada na primeira linha e só depois checando se o avaliador tinha sido adulterado. Numa função pura o resultado é o mesmo, e é por isso que o defeito passa em revisão. Fora dela não é: calcular a correção significa rodar a suíte, e rodar a suíte de um patch que já mexeu no avaliador é executar código não confiável e depois descartar o resultado. Você pagou o custo e correu o risco por nada.
Na referência, a ordem é fase 1 integridade, fase 2 linha de base, fase 3 execução. A checagem de integridade acontece antes até de copiar o repositório.
Ver como texto
O executor de recompensa em três fases isoladas: checar integridade e rodar a linha de base antes de qualquer patch, aplicar o patch numa cópia descartável, e executar testes públicos e ocultos sob tempo limite devolvendo a decomposição da recompensa
Defeito 4. A detecção de fraude por pedaço de texto
A checagem original perguntava se algum nome de arquivo proibido aparecia dentro da string bruta do patch. Isso reprova, com penalidade máxima, uma entrega honesta que apenas mencione o nome em um comentário, numa mensagem de commit ou numa string de log. E deixa passar quem escreve o mesmo caminho de outra forma. A régua ficava simultaneamente severa demais com o inocente e frouxa com quem sabe o que está fazendo.
A referência extrai a lista de caminhos do cabeçalho do diff, normaliza cada um e compara por igualdade de caminho ou por prefixo de diretório.
import shutil
import subprocess
import tempfile
from pathlib import Path, PurePosixPath

PROIBIDOS = ("tests/hidden", "conftest.py", ".ci", "verifier")


def toca_caminho_proibido(caminhos_do_patch) -> bool:
    """Compara CAMINHO NORMALIZADO, nunca pedaço de texto do diff bruto.

    A versão anterior perguntava se o nome proibido aparecia em qualquer
    lugar da string do patch, e reprovava quem apenas citasse o arquivo
    dentro de um comentário.
    """
    for bruto in caminhos_do_patch:                # vêm do cabeçalho do diff
        alvo = PurePosixPath(bruto).as_posix().lstrip("./")
        for proibido in PROIBIDOS:
            if alvo == proibido or alvo.startswith(proibido + "/"):
                return True
    return False


class ExecutorDeRecompensa:
    def __init__(self, repo: str, tempo_limite_s: int = 60):
        self.repo = repo
        self.tempo_limite_s = tempo_limite_s

    def rodar(self, patch) -> Decomposicao:
        d = Decomposicao()

        # FASE 1. Integridade, antes de copiar e antes de executar qualquer coisa.
        if toca_caminho_proibido(patch.caminhos):
            d.integridade_violada = True
            return d                        # recompensa() devolverá -1,00

        # FASE 2. Linha de base. O que já falhava não credita nem debita.
        ja_falhava = self._suite_completa(self.repo)

        # FASE 3. Cópia descartável, patch aplicado, suítes sob tempo limite.
        trabalho = Path(tempfile.mkdtemp())
        try:
            shutil.copytree(self.repo, trabalho, dirs_exist_ok=True)
            self._aplicar(patch, trabalho)
            d.compilou = 1.0 if self._compila(trabalho) else 0.0
            d.testes_publicos = self._suite(trabalho, "tests/public", ja_falhava)
            d.testes_ocultos = self._suite(trabalho, "tests/hidden", ja_falhava)
            d.mutantes_mortos = self._mutacao(trabalho)
            d.analise_estatica = self._estatica(trabalho)
            d.custo_do_diff = self._custo_do_diff(patch)
            return d
        finally:
            shutil.rmtree(trabalho, ignore_errors=True)   # não vaza estado

    def _suite(self, trabalho: Path, caminho: str, ja_falhava) -> float:
        proc = subprocess.run(
            ["pytest", caminho, "-q"], cwd=trabalho,
            capture_output=True, timeout=self.tempo_limite_s,
        )
        aprovados, total = ler_resultado(proc.stdout, ignorando=ja_falhava)
return fracao_aprovada(aprovados, total) # levanta erro se total for 0| Defeito | Como ele aparece no código | O que ele quebra | O que a referência faz |
|---|---|---|---|
| Piso em zero | O retorno é o máximo entre zero e a conta da recompensa | Iguala trapaça detectada a fracasso honesto, e apaga o incentivo contra fraude | Violação devolve valor negativo fixo. Nenhum piso em zero na função |
| Meta atingida valendo zero | Nota calculada como um menos a razão entre o medido e o alvo, limitada entre zero e um | Quem cumpre o contrato pontua igual a quem o estoura dez vezes | Meta atingida devolve 1,0, e a nota degrada continuamente acima dela |
| Integridade checada depois | A correção é calculada na primeira linha e a checagem de fraude vem em seguida | Faz o sistema executar código de um patch já suspeito e pagar o custo por nada | Fase 1 é integridade, antes de copiar o repositório e antes de rodar teste |
| Fraude detectada por pedaço de texto | A checagem pergunta se o nome proibido aparece na string bruta do patch | Reprova entrega honesta que apenas cite o arquivo, e deixa passar quem escreve o caminho de outra forma | Extrai os caminhos do cabeçalho do diff, normaliza e compara por caminho ou prefixo de diretório |
Fonte: Auditoria do material anterior deste curso, 24/07/2026. Cada linha tem a ocorrência localizada no arquivo de origem
O que a fronteira publicou em 2026 sobre isso
O padrão de arquitetura mais reutilizável do período é uma defesa em três camadas, publicada junto com uma família de modelos abertos que deixa o próprio modelo escrever o scaffold da tarefa. Ele merece atenção porque resolve um problema pior que o nosso: como confiar numa recompensa quando o próprio modelo desenha o arranjo que o julga.
Três leituras práticas desse padrão, para quem vai implantar
- A fronteira imutável é a camada barata e a primeira a construir. Ela não detecta nada, ela impede.
- O monitor determinístico exclui a trajetória do cálculo de vantagem, e não apenas zera a recompensa. Trajetória fraudada que permanece no lote contamina a linha de base do grupo.
- O juiz por modelo de linguagem entra como veto, nunca como fonte primária de recompensa. Ele pode reprovar o que o verificador aprovou, e não pode aprovar o que o verificador reprovou.
Há uma alternativa de projeto ao veto, com efeito diferente sobre a estabilidade: monitor online que, ao detectar comportamento inválido, bloqueia a chamada e devolve um resultado inócuo em vez de rejeitar a trajetória inteira.
Dá para ir além de detectar e tornar a fraude estatisticamente visível por construção. A ideia é montar o conjunto de tarefas de modo que o teto de desempenho honesto seja deliberadamente menor que 1: qualquer pontuação acima do teto passa a ser evidência de que alguém burlou, sem que seja preciso identificar como.
Quando treinar a política inteira não se justifica, existe um meio-termo: treinar um modelo de recompensa leve, que avalia ações candidatas na hora da inferência e conduz o agente para a decisão de maior recompensa, sem RL completo. Os próprios autores marcam a fragilidade do método, que é alinhar recompensa intermediária com sucesso final.
Auditoria de uma função de recompensa, linha a linha
Ordem e sinal
0/4Metas e normalização
0/3Detecção
0/3Três perguntas para testar a decisão antes da próxima reunião: (1) O fornecedor mostra uma função de recompensa que limita o resultado entre zero e um e diz que isso é boa prática de normalização: você aprova, pede a penalidade negativa antes do limite ou recusa a régua? (2) A função herdada calcula a nota de latência antes de checar se o avaliador foi adulterado e o time argumenta que o resultado final é o mesmo: você aceita o argumento ou exige a inversão da ordem? (3) Um patch honesto foi reprovado por citar o nome de um arquivo de teste oculto num comentário: você trata como falso positivo tolerável ou como defeito bloqueante da régua?
Guia prático: escrever o juiz da copy no formato de grader da OpenAI. A documentação de graders da OpenAI descreve cinco tipos que cobrem quase todo juiz de marketing: string_check para comparação exata, text_similarity para proximidade de texto, score_model para nota dada por modelo, python para regra em código e multi para combinar os anteriores numa fórmula. Mesmo que você rode o laço fora da OpenAI, o esquema serve como modelo de documentação do juiz.
{
  "type": "multi",
  "graders": {
    "formato": {
      "type": "python",
      "name": "formato",
      "source": "def grade(sample, item):\n    titulo, _, descricao = sample['output_text'].partition('\\n')\n    proibidos = ['garantido', '100%', 'o melhor do brasil']\n    if len(titulo) > 30 or len(descricao) > 90:\n        return 0.0\n    if any(p in sample['output_text'].lower() for p in proibidos):\n        return 0.0\n    return 1.0"
    },
    "rubrica": {
      "type": "score_model",
      "name": "rubrica",
      "model": "o4-mini-2025-04-16",
      "range": [0, 1],
      "input": [
        {"role": "system", "content": "Você avalia anúncios de pesquisa. Dê uma nota de 0 a 1 pela média de três critérios: clareza da oferta, benefício concreto para o público do brief e chamada para ação. Repetir palavra-chave não aumenta a nota."},
        {"role": "user", "content": "Brief: {{ item.brief }}\nAnúncio: {{ sample.output_text }}"}
      ]
    }
  },
  "calculate_output": "formato * rubrica"
}
Do juiz em texto ao grader que roda sozinho
Cinco passos para transformar a rubrica do time num juiz versionado e auditável.
Passo 1: Separe o que é regra do que é julgamento
Limite de caracteres, termo proibido e presença da marca são regra: vão para o grader python ou string_check.
Deu certo quando: O grader de código reprova sozinho os exemplos fora do formato do seu conjunto de teste.
Erro comum: Pedir ao modelo juiz que conte caracteres.
Passo 2: Escreva o score_model com a escala e o que não vale ponto
A frase "repetir palavra-chave não aumenta a nota" fecha o atalho mais comum de copy de anúncio.
Deu certo quando: Uma variação com a palavra-chave repetida três vezes recebe nota menor que a versão limpa.
Erro comum: Rubrica que só diz o que premiar e nunca o que ignorar.
Passo 3: Combine com multiplicação em calculate_output
O formato funciona como piso: zero no formato zera a nota final.
Deu certo quando: A fórmula aparece no repositório ao lado do nome de quem a escreveu e da data.
Erro comum: Média simples, que deixa a nota do texto compensar o anúncio que a plataforma vai recusar.
Passo 4: Calibre o juiz contra 30 notas humanas antes de usar
Duas pessoas pontuam as mesmas 30 variações; o juiz precisa ficar na mesma faixa na maior parte delas.
Deu certo quando: Planilha com nota humana e nota do juiz lado a lado, e os desacordos comentados.
Erro comum: Confiar no juiz porque ele "parece razoável" em cinco exemplos.
Passo 5: Versione o juiz e congele a versão durante cada rodada
Mudar a rubrica no meio da rodada torna as notas incomparáveis entre si.
Deu certo quando: Cada relatório de rodada cita a versão do juiz que gerou as notas.
Erro comum: Ajustar a rubrica depois de ver qual prompt venceu.
No fim você tem: Um juiz com regra em código, julgamento em rubrica e fórmula explícita, que qualquer pessoa do time consegue auditar.
A pesquisa da Anthropic publicada em agosto de 2026 sobre um modelo treinado para buscar recompensa dá o motivo para esconder o juiz. Treinado em 80 ambientes vulneráveis a atalho, o modelo passou a burlar a recompensa em 40% dos episódios. Num teste com o juiz visível para o agente, a taxa de respostas nocivas chegou a 29%, contra 0,7% na linha de base. Para a copy de anúncio, a lição prática é a mesma: o gerador não lê a rubrica, e o laço registra quem a alterou.
Audite a próxima função de recompensa que chegar pelos quatro defeitos desta aula, linha a linha, antes de aprovar o treino. Registre cada defeito com a linha correspondente. Depois da correção, confira se os pesos positivos somam um e se nenhum componente premia o próprio teste.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafoO Setup ensina permissões, contexto do projeto e escolha de modelo por custo. Essa preparação sustenta os exercícios de comparação de assistentes, criação do gerador de UTM e regras de projeto no curso de aprendizado por reforço e vibecoding.
- CursoAstra profundosugerido pelo grafo4 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Astra profundo”.
- CursoLetramento em IA para Executivossugerido pelo grafo5 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Letramento em IA para Executivos”.
- CursoVídeo com IA: do roteiro à publicaçãosugerido pelo grafo2 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Vídeo com IA: do roteiro à publicação”.
- RLM: grandes acervosComo avaliar decisões ao longo da execuçãoExaminar conexões de Como avaliar decisões ao longo da execução
- Prompt Engineering para ExecutivosTestar a IA com 20 a 50 casos reais antes de liberarExaminar conexões de Testar a IA com 20 a 50 casos reais antes de liberar
- Modelo de trabalho com agentes de IAO que precisa acompanhar uma entrega para aprovação?Examinar conexões de O que precisa acompanhar uma entrega para aprovação?
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.