Autoridade Temática e SEO de Entidades · Capítulo 10 de 19 · 102 min
O crachá da sua empresa para as máquinas
Schema como camada de compreensão e não de aparência, com identificadores registrados no centro e o recorte de markup do cluster.
Este capítulo faz parte do curso gratuito Autoridade Temática e SEO de Entidades.
Como declarar significado sem transformar Schema.org em maquiagem técnica? Projetar uma camada de JSON-LD fiel ao conteúdo, conectada por identificadores estáveis e validada após o deploy.
Ao final você será capaz de
- Classificar qualquer tipo de dado estruturado como camada de aparência ou de compreensão, com data de verificação declarada.
- Escolher tipos e propriedades a partir da função real de cada página, priorizando identificadores registrados antes de listas de perfis sociais.
- Usar @id e relações para conectar Organization, Person, WebSite e conteúdo num único grafo que amarre a pillar e os satélites do seu cluster.
- Diferenciar validade sintática, elegibilidade e exibição efetiva.
Dados estruturados são etiquetas de significado inseridas no código para declarar, de forma padronizada, fatos que a página já mostra às pessoas.
Um leitor reconhece título, autor, empresa e data pela aparência e pelo contexto. Uma máquina precisa de marcações explícitas para interpretar com mais segurança qual trecho representa cada elemento.
Schema.org fornece um vocabulário compartilhado. JSON-LD é uma forma comum de escrever esse vocabulário em um bloco separado no código. O dado estruturado descreve a página; ele não deve inventar prêmio, avaliação, autoria, endereço ou relação ausente do conteúdo visível.
Identificadores estáveis permitem que diferentes blocos apontem para a mesma pessoa ou organização. Em vez de recriar o autor em cada artigo, a página referência o identificador canônico da pessoa, que por sua vez se relaciona à organização.
Etiqueta de encomenda
Uma caixa pode ter texto decorativo, mas a transportadora depende de campos previsíveis como remetente, destinatário e código. Dados estruturados transformam partes da página em campos padronizados sem substituir o conteúdo da caixa.
O que você precisa ter em mãos antes de começar. Três coisas: fatos canônicos sobre pessoas, organizações e conteúdos; a capacidade de comparar o código com o que está visível na página; e a consciência de que validação técnica não garante exibição especial em buscadores.
Glossário rápido
Schema.org
Vocabulário de tipos e propriedades usado para descrever coisas na web. Ex.: Person, Organization, Article, author e datePublished.
JSON-LD
Formato em que dados estruturados podem ser declarados em JSON dentro da página. Ex.: Um bloco descreve o artigo e referência seu autor.
Tipo
Categoria da entidade descrita. Ex.: Organization para empresa e Person para indivíduo.
Propriedade
Campo que informa um atributo ou relação. Ex.: name, url, logo, author e worksFor.
@id
Identificador usado para referenciar a mesma entidade em diferentes blocos. Ex.: https://empresa.com/#organization.
- Etapa 1 de 5: Escolha a página
Comece por uma página canônica e identifique sua função.
- Etapa 2 de 5: Liste fatos visíveis
Registre apenas o que o visitante consegue confirmar na página.
- Etapa 3 de 5: Selecione tipo e propriedades
Use o tipo mais específico sustentado pelo conteúdo.
- Etapa 4 de 5: Conecte identificadores
Reutilize @id para pessoa, organização e artigo.
- Etapa 5 de 5: Valide e monitore
Teste sintaxe, correspondência visual e comportamento após publicação.
O passo a passo com exemplo preenchido
| Passo | O que fazer | Exemplo |
|---|---|---|
| Escolha a página | Comece por uma página canônica e identifique sua função. | Página institucional da organização. |
| Liste fatos visíveis | Registre apenas o que o visitante consegue confirmar na página. | Nome, URL, logo, descrição e perfis oficiais. |
| Selecione tipo e propriedades | Use o tipo mais específico sustentado pelo conteúdo. | Organization com name, url, logo e sameAs. |
| Conecte identificadores | Reutilize @id para pessoa, organização e artigo. | O author do Article aponta para #person, e worksFor aponta para #organization. |
| Valide e monitore | Teste sintaxe, correspondência visual e comportamento após publicação. | Ferramenta de validação, inspeção de URL e auditoria quando fatos mudarem. |
Exemplo resolvido, consultoria com vinte especialistas
Os blocos eram tecnicamente válidos em isolamento, porém não formavam um grafo coerente e repetiam dados divergentes.
Consultoria com vinte especialistas
Exemplo resolvido do capítulo
Dor
Artigos exibiam nome do autor, mas o código declarava apenas a organização; algumas páginas criavam uma pessoa diferente para o mesmo especialista.
Solução
A organização recebeu um @id único em todo o site. Cada especialista recebeu página e identificador próprios. Artigos passaram a referenciar o @id do autor em vez de duplicar seus fatos. Propriedades sem suporte visível foram removidas e a validação entrou no processo de publicação.
Resultado
Os blocos passaram a descrever um grafo consistente de artigos, autores e organização, fiel ao conteúdo exibido.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Entradas usadas no exemplo
| Insumo levado para a mesa |
|---|
| Registro canônico de organização e especialistas. |
| URLs das páginas institucionais e perfis de autor. |
| Conteúdo visível de artigos, serviços e casos. |
| Requisitos das documentações oficiais para cada tipo usado. |
Como ler o resultado. Validade sintática é apenas uma camada. Qualidade exige verdade, correspondência visual, conexão por identificadores e manutenção quando a realidade muda.
Autoavaliação: você consegue fazer isto sozinho?
Marque só o que você já consegue executar sem ajuda
0/4A dor que traz você até aqui costuma ter este formato. Imagine a cena, hipotética mas familiar. Numa mesma semana, Diego, head de conteúdo de uma fintech de crédito, recebe duas provocações que parecem opostas. Na segunda, um fornecedor liga oferecendo "um schema especial para IA", com preço de projeto e nenhuma fonte primária. Na quinta, o time de dev pede autorização para arrancar todo o FAQPage do site, porque o rich result de FAQ acabou e a marcação virou, segundo eles, código morto. Diego não quer decidir no chute nem contratar consultoria para cada dúvida dessas. Ele precisa de um critério único que sirva para os dois pedidos. As duas coisas se resolvem com a mesma distinção conceitual.
Existem dois usos possíveis para o mesmo JSON-LD. Schema de aparência existe para disparar um recurso visual na página de resultados, e o sucesso dele se mede em CTR. Schema de compreensão existe para dizer ao parser qual entidade é qual e como as suas páginas se relacionam, e o sucesso dele se mede na entidade certa sendo recuperada e citada. Quando o Google poda uma feature, o primeiro uso morre e o segundo continua intacto, porque a marcação segue sendo lida.
A etiqueta de remessa e o adesivo de campanha
No galpão de logística, cada caixa carrega dois papéis colados. A etiqueta de remessa traz CNPJ, destino e código de barras, e é ela que faz qualquer transportadora rotear a caixa até o lugar certo. O adesivo bonito da promoção chama atenção na esteira, mas some quando a campanha acaba. Schema de aparência é o adesivo, vistoso enquanto a feature dura. Schema de compreensão é a etiqueta, some da vista mas continua fazendo a caixa chegar. Arrancar a etiqueta porque o adesivo saiu de linha é jogar fora o roteamento junto com a decoração. Uma caixa sem etiqueta obriga o centro de distribuição a abri-la para descobrir conteúdo, origem e destino; uma etiqueta falsa manda a caixa para o endereço errado e queima a confiança no processo inteiro.
Schema de aparência é o adesivo de campanha e schema de compreensão é a etiqueta de remessa. A etiqueta reduz ambiguidade quando descreve o que realmente existe, e nenhuma etiqueta melhora o produto dentro da caixa.
Vale desenhar essa diferença antes de qualquer decisão de remoção, porque ela muda a métrica, o risco e o exemplo típico de cada lado. Repare especialmente na linha de risco: no schema de aparência o risco é a feature sumir, e no schema de compreensão o risco é você publicar um dado errado sobre a sua própria entidade.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
A poda não foi um episódio isolado. Em 12/06/2025 o Google descontinuou sete tipos de uma vez (Book Actions, Course Info, Claim Review, Estimated Salary, Learning Vídeo, Special Announcement e Vehicle Listing), com o Special Announcement saindo de fato em 31/07/2025. Em novembro de 2025 o banner de descontinuação de Book Actions foi retirado, confirmando que aquele tipo segue suportado. A lista se move nos dois sentidos.
O caso mais didático é o FAQPage. O Google encerrou o rich result de FAQ a partir de 07/05/2026, com banner datado de 08/05/2026, removeu o relatório do Search Console e o Teste de Resultados Aprimorados em junho de 2026, e os dados na API do Search Console saem em agosto de 2026. O tipo FAQPage continua válido no vocabulário e o Google segue lendo a marcação. Sumiu o acordeão, permaneceu o par pergunta e resposta explicitado para quem consome a página.
Arrancar todo o FAQPage do site por causa do fim do rich result é uma reação de pânico que custa dinheiro duas vezes: você paga o desenvolvimento da remoção e perde a explicitação de pares pergunta e resposta que continua sendo consumida. Remova pelo motivo certo (a marcação está errada ou descreve conteúdo que não existe na página), nunca porque o pixel foi embora.
Esse capítulo ganhou um exemplo datado enquanto o mercado ainda discutia o assunto. Em 07/05/2026 o Google removeu o resultado aprimorado de FAQ da Busca, mas confirmou que o tipo FAQPage continua válido no schema.org e segue sendo lido para entender a página (Search Engine Journal, 10/05/2026, verificado em 19/07/2026). A retirada foi faseada, e vale registrar o calendário certo para não datar errado o próprio diagnóstico: o resultado aprimorado saiu em 07/05/2026, o relatório do Search Console e o Teste de Resultados Aprimorados saíram em junho de 2026, e os dados na API do Search Console saem em agosto de 2026, ou seja, ainda não tinham saído quando este capítulo foi verificado, em 20/07/2026. É a distinção deste capítulo acontecendo ao vivo: morreu o pixel na SERP e a marcação seguiu sendo lida. Quem arrancou o FAQPage inteiro em maio pagou duas vezes e ainda entregou ao parser uma página com menos estrutura para compreender.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Essa matriz tem prazo de validade e eu preferi imprimir a data dentro dela justamente por isso. Qualquer lista fixa de "tipos que importam" nasce vencida, inclusive esta. O que você leva deste capítulo é o protocolo que regenera a lista em quinze minutos, sempre que precisar.
  TIPO CANDIDATO
       |
       v
  [1] Abre a página oficial do tipo em developers.google.com
       |
       +--> Tem banner de descontinuação?  --SIM--> status VERMELHO
       |                                            tira do backlog
       |                                            de aparência
      NÃO
       |
       v
  [2] O tipo ainda gera resultado aprimorado na galeria oficial?
       |
       +--NÃO--> status AMARELO: marcação lida, sem aparência
       |          mantém só se ajudar a compreensão
      SIM
       |
       v
  [3] Confere o release log do schema.org: propriedade depreciada?
       |
       +--SIM--> troca a propriedade ANTES de publicar
       |
      NÃO
       |
       v
  [4] Registra TIPO + STATUS + DATA DA CONSULTA na planilha
       |
       v
REVALIDA NA PRÓXIMA SPRINT. LISTA SEM DATA É LISTA VENCIDA.Resolvida a questão da aparência, sobra a segunda parte da sua dor: o fornecedor que vende um schema especial para busca generativa. Essa venda tem uma resposta curta e uma fonte primária, o que a torna uma das poucas discussões deste mercado com desfecho limpo.
Não existe schema especial para IA. O guia oficial do Google sobre otimização para recursos generativos, assinado por John Mueller, publicado em 15/05/2026 e atualizado em 10/07/2026, diz literalmente: "Structured data isn't required for generative AI search, and there's no special schema.org markup you need to add" (Google Search Central, "Optimizing for generative AI", https://developers.google.com/search/docs/fundamentals/ai-optimization-guide, consultado em 24/07/2026). Dados estruturados, portanto, não são requisito de busca generativa, e a afirmação está na fonte primária, com data. Na mesma página, a recomendação é manter dados estruturados como parte da estratégia geral de SEO, pela elegibilidade a rich results. Se alguém vende um vocabulário proprietário para ser citado por IA, peça a fonte primária. Ela não existe.
Faltava, até pouco tempo atrás, uma medição do efeito real de adicionar JSON-LD sobre citações em IA. Ela chegou em 11/05/2026, num estudo causal da Ahrefs que rastreou 1.885 páginas que adicionaram JSON-LD entre agosto de 2025 e março de 2026, pareadas contra cerca de 4.000 páginas de controle, com testes t, diferenças em diferenças e estudos de evento. Os três resultados aparecem na figura a seguir: Google AI Mode, ChatGPT e Google AI Overviews.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Leia esse estudo com cuidado antes de usá-lo como argumento. Ele mede o efeito de adicionar JSON-LD em páginas que já eram citadas, e não o efeito de ter schema desde sempre. A conclusão defensável é que dados estruturados não funcionam como alavanca de citação em IA. A conclusão indefensável, e que você vai ver circulando por aí, é que schema prejudica citação.
Com a camada de aparência arrumada e a promessa de IA desmontada, sobra o que realmente rende: identidade de entidade. A documentação de Organization structured data, com atualização registrada em 15/04/2026, declara que o recurso ajuda o Google a desambiguar a sua organização de outras nos resultados, e suporta um conjunto de identificadores registrados: iso6523Code (com prefixos ICD como 0060 para DUNS, 0088 para GLN e 0199 para LEI), duns, leiCode, naics, globalLocationNumber, taxID e vatID. Para empresa brasileira, taxID é onde o CNPJ entra.
Identificador registrado vem antes de sameAs, sempre. Um CNPJ, um LEI ou um DUNS é verificável de fora do seu site, num registro que você não controla, o que é exatamente o que dá força ao sinal. Sobre sameAs, a redação da documentação oficial é deliberadamente modesta: fala em URL de página em outro site com informação adicional sobre a organização, como um perfil em rede social ou site de avaliação. Em nenhum momento promete alimentar Knowledge Panel. Trinta perfis sociais em sameAs não compensam a ausência de um identificador registrado.
Essa prioridade tem uma estrutura de dependência que vale ver desenhada. Cada camada só faz sentido se a de baixo estiver resolvida: presença em base pública sem consistência de nome e endereço vira ruído, e sameAs bem montado sem identificador registrado é uma pilha de links sem âncora.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Agora o recorte deste curso. Schema é um assunto grande e existe capítulo dedicado a ele em outros treinamentos da casa. Para structured data e JSON-LD em profundidade, incluindo a fronteira entre schema legítimo e schema spam, leia o capítulo "Structured Data e JSON-LD: A Camada de Entendimento", em /educacao/geo-knowledge-graph. Para acesso, renderização e implantação técnica da marcação, leia o capítulo "Etapa 2: Estruturação técnica (acesso, renderização e dados estruturados)", em /educacao/seo-geo. Para conectar a sua entidade ao Wikidata, leia o capítulo "Integrando Wikidata ao Seu Site", em /educacao/wikidata-wikipedia. Aqui a fatia é uma só: o markup do cluster, ou seja, usar about, mentions, isPartOf e hasPart para dizer que a sua pillar e os seus satélites formam um conjunto.
Um bloco JSON-LD por página, com @graph, e todo nó com @id absoluto e estável. O @id é o que permite que a pillar diga "eu falo sobre aquela entidade ali" e que o satélite diga "eu sou parte daquela pillar ali" sem repetir a definição inteira em cada página. Sem @id, cada página carrega quatro objetos que o parser não consegue costurar entre si.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
O bloco abaixo é o entregável deste capítulo em forma de esqueleto. Repare numa escolha deliberada: todos os placeholders gritam a palavra SUBSTITUA e nenhum deles se parece com um valor plausível. Placeholder plausível (um CNPJ inventado, um Q do Wikidata que existe e é de outra entidade) é a forma mais comum de o aluno publicar markup mentiroso sem perceber.
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://SEU-DOMINIO/#organizacao",
      "name": "SUBSTITUA_nome_fantasia",
      "legalName": "SUBSTITUA_razao_social",
      "url": "https://SEU-DOMINIO/",
      "taxID": "SUBSTITUA_cnpj_real_ou_apague_esta_linha",
      "sameAs": [
        "SUBSTITUA_url_do_seu_item_no_wikidata_ou_apague"
      ]
    },
    {
      "@type": "Thing",
      "@id": "https://SEU-DOMINIO/#entidade-tema",
      "name": "SUBSTITUA_nome_do_tema_do_cluster",
      "sameAs": "SUBSTITUA_url_wikipedia_ou_wikidata_do_tema_ou_apague"
    },
    {
      "@type": "WebPage",
      "@id": "https://SEU-DOMINIO/guia/#pagina",
      "url": "https://SEU-DOMINIO/guia/",
      "name": "SUBSTITUA_titulo_da_pillar",
      "about": { "@id": "https://SEU-DOMINIO/#entidade-tema" },
      "hasPart": [
        { "@id": "https://SEU-DOMINIO/guia/subtema-a/#pagina" },
        { "@id": "https://SEU-DOMINIO/guia/subtema-b/#pagina" }
      ],
      "publisher": { "@id": "https://SEU-DOMINIO/#organizacao" }
    },
    {
      "@type": "WebPage",
      "@id": "https://SEU-DOMINIO/guia/subtema-a/#pagina",
      "url": "https://SEU-DOMINIO/guia/subtema-a/",
      "name": "SUBSTITUA_titulo_do_satelite_a",
      "isPartOf": { "@id": "https://SEU-DOMINIO/guia/#pagina" },
      "about": { "@id": "https://SEU-DOMINIO/#entidade-tema" }
    },
    {
      "@type": "WebPage",
      "@id": "https://SEU-DOMINIO/guia/subtema-b/#pagina",
      "url": "https://SEU-DOMINIO/guia/subtema-b/",
      "name": "SUBSTITUA_titulo_do_satelite_b",
      "isPartOf": { "@id": "https://SEU-DOMINIO/guia/#pagina" },
      "about": { "@id": "https://SEU-DOMINIO/#entidade-tema" }
    }
  ]
}
Cada propriedade acima está ali por um motivo específico, e você deve conseguir defender todas em uma linha
- @id: identificador estável do nó, o que permite referenciar sem redefinir.
- legalName: razão social, que desambigua de homônimos comerciais.
- taxID: CNPJ, âncora verificável num registro público que você não controla.
- sameAs: aponta para propriedades que você controla ou que são autoritativas, nunca para trinta perfis.
- about: declara qual entidade a página descreve, ligando pillar e satélites ao mesmo tema.
- hasPart e isPartOf: declaram a relação de conjunto entre pillar e satélites, nas duas direções.
- publisher: liga o conteúdo à organização responsável, que é onde os identificadores moram.
+----------------------------------------------------------+
| Teste de resultados aprimorados     seu-dominio/guia/     |
+----------------------------------------------------------+
| Itens detectados                                          |
|                                                           |
|  [ok]  Organization ................ 1 item válido        |
|        + legalName, taxID, sameAs (2)                     |
|                                                           |
|  [ok]  WebPage (pillar) ............ 1 item válido        |
|        + about    -> #entidade-tema                       |
|        + hasPart  -> 2 referências                        |
|                                                           |
|  [!]   FAQPage ..................... 1 item válido        |
|        Não elegível para resultado aprimorado             |
|        (a marcação continua sendo lida)                   |
|                                                           |
|  [x]   WebPage (satélite 2) ........ 1 erro               |
|        isPartOf -> @id que não existe no grafo            |
+----------------------------------------------------------+
| LEITURA: "válido" não quer dizer "vai aparecer", e
| "sem rich result" não quer dizer "inútil". O único
| item que exige ação aqui é o [x].
+----------------------------------------------------------+
# Rode isto na esteira de deploy, com o bloco salvo em cluster.jsonld.
# Falhou qualquer um dos três, o deploy não sobe.

# 1) o JSON parseia?
python -m json.tool cluster.jsonld > /dev/null && echo 'JSON válido'

# 2) sobrou placeholder? qualquer saída aqui é defeito de publicação
grep -n 'SUBSTITUA' cluster.jsonld && echo 'BLOQUEIA O DEPLOY' || echo 'sem placeholder'

# 3) todo @id referenciado existe como @id declarado no grafo?
python - <<'PY'
import json
grafo = json.load(open('cluster.jsonld'))['@graph']
declarados = {no['@id'] for no in grafo if '@id' in no}
refs = set()

def anda(obj):
    if isinstance(obj, dict):
        if list(obj.keys()) == ['@id']:
            refs.add(obj['@id'])
        for valor in obj.values():
            anda(valor)
    elif isinstance(obj, list):
        for valor in obj:
            anda(valor)

for no in grafo:
    for chave, valor in no.items():
        if chave != '@id':
            anda(valor)

print('ORFAOS:', refs - declarados or 'nenhum')
PY
Placeholder publicado em produção é o defeito mais grave deste capítulo, e o mais comum. Um taxID de exemplo faz você declarar oficialmente o CNPJ de outra empresa. Um sameAs apontando para um item do Wikidata que não é o seu faz você declarar ser outra entidade. Se o valor real não existe ainda, apague a propriedade inteira. Propriedade ausente não gera dano, propriedade errada gera.
Seis armadilhas concentram quase todo o markup de cluster que reprova em auditoria. A lista logo abaixo traz cada uma delas, com o motivo de reprovação.
- Marcar com FAQPage um acordeão que o usuário não vê na página, esperando que o rich result volte.
- Repetir a definição completa de Organization em todas as páginas em vez de referenciar por @id.
- Colocar em sameAs qualquer perfil onde a marca já apareceu, incluindo diretórios que ninguém mantém.
- Usar about apontando para uma string de palavra-chave em vez de um nó com @id.
- Manter GraphicNovel depois da depreciação em favor de SequentialArt na release 29.4 do schema.org, de 08/12/2025.
- Criar item no Wikidata sem notabilidade só para ter o que colocar em sameAs, o que termina em deleção.
Acompanhe o release log do schema.org com a mesma disciplina com que acompanha a documentação do Google. Entre 24/03/2025 (release 29.0) e 19/03/2026 (release 30.0) entraram companyRegistration, legalAddress e legalRepresentative em Organization na 29.2, GraphicNovel foi depreciado em favor de SequentialArt na 29.4, e a 30.0 trouxe anotações de equivalência para GS1, Dublin Core e Open Graph. A 30.0, de 19/03/2026, segue sendo a release corrente: nenhum lançamento novo saiu entre maio e julho de 2026 (release log do schema.org, consultado em 24/07/2026). Esse último ponto sinaliza a direção do vocabulário: o schema.org está se posicionando como camada de tradução entre grafos, e já não apenas como dicionário de SERP.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Exercício prático
- 01Escolha um cluster real do seu site: uma pillar e dois satélites publicados.
- 02Rode o protocolo de verificação de status para todos os tipos de schema que já existem nessas três páginas, e monte a planilha com tipo, status, data da consulta e URL da fonte.
- 03Escreva um único bloco JSON-LD com @graph contendo Organization com ao menos um identificador registrado real, a entidade do tema, a pillar com about e hasPart, e os dois satélites com isPartOf.
- 04Justifique cada propriedade incluída em uma linha, e liste o que você descartou e por quê.
- 05Rode os três testes de esteira do bloco bash deste capítulo e cole o resultado.
Critérios de sucesso
- A planilha de status tem data de consulta e URL de fonte oficial em toda linha, sem exceção.
- O JSON parseia e nenhum @id referenciado ficou órfão.
- A busca por SUBSTITUA no arquivo final retorna zero resultados.
- Toda propriedade cujo valor real você não possui foi apagada, em vez de preenchida com valor plausível.
- O identificador registrado declarado em Organization confere com o registro público correspondente, verificado por você e não pelo validador.
Schema é uma declaração verificável
Dados estruturados oferecem pistas explícitas sobre o que uma página descreve. Em JSON-LD, a organização pode declarar nome, URL, logo, identificadores e perfis oficiais; uma página de perfil pode descrever uma pessoa; um artigo pode apontar para o autor e para a página principal; breadcrumbs podem representar a posição na arquitetura.
O código não deve conter uma versão mais ambiciosa da empresa do que o conteúdo visível. Se o JSON-LD declara fundador, certificação, avaliação ou serviço que a página não apresenta de forma verdadeira, o problema deixou de ser técnico e passou a ser de qualidade ou engano.
Três testes são distintos: sintaxe válida, aderência às diretrizes e resultado exibido. Uma marcação pode ser válida e ainda não ser elegível a uma aparência específica. Mesmo quando é elegível, o Google decide se e quando mostra um rich result. Dados estruturados ajudam compreensão; não compram exposição.
Matriz página → entidade → marcação
| Página | Entidade principal | Tipos úteis | Relação crítica |
|---|---|---|---|
| Home ou Sobre | Organização | Organization + WebSite | Organization.url, logo, identifiers e perfis oficiais coerentes. |
| Perfil do especialista | Pessoa | ProfilePage + Person | mainEntity aponta para Person; Person se relaciona à organização e às credenciais visíveis. |
| Artigo ou guia | Obra editorial | Article ou BlogPosting + BreadcrumbList | author referência o mesmo @id do especialista canônico. |
| Caso documentado | Caso e organização envolvida | Article, CreativeWork ou tipo específico aplicável | A marcação representa apenas fatos e resultados visíveis, com contexto. |
| Glossário | Conjunto de termos | DefinedTermSet + DefinedTerm | Cada termo pertence ao conjunto e possui definição visível. |
| Produto ou serviço | Oferta | Product, SoftwareApplication, Service ou subtipo aplicável | Oferta, provedor e propriedades correspondem ao conteúdo e às diretrizes da superfície. |
Template mínimo de Organization com @id estável
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://example.com/#organization",
  "name": "Empresa Exemplo",
  "legalName": "Empresa Exemplo Tecnologia Ltda.",
  "url": "https://example.com/",
  "logo": {
    "@type": "ImageObject",
    "url": "https://example.com/logo.png"
  },
  "description": "Descrição factual também visível na página.",
  "foundingDate": "2020",
  "address": {
    "@type": "PostalAddress",
    "addressLocality": "Goiânia",
    "addressRegion": "GO",
    "addressCountry": "BR"
  }
}
Template didático: substitua todos os exemplos por fatos reais, remova propriedades sem comprovação e conecte o mesmo @id nas demais páginas. Não publique URLs ou dados fictícios.
O gate técnico em cinco passos
1. Inventariar
Mapeie templates, tipos de página, entidades e marcações já emitidas. Exemplo: Descobrir dois plugins criando Organization com @ids diferentes.
2. Especificar
Defina tipo principal, propriedades, fonte de cada campo e relações canônicas. Exemplo: Cargo vem do registro de RH aprovado para publicação.
3. Implementar
Gere JSON-LD no template correto e mantenha identificadores estáveis. Exemplo: O mesmo Person @id aparece em ProfilePage e author de artigos.
4. Validar
Teste sintaxe, diretrizes e aderência ao conteúdo visível. Exemplo: Rich Results Test para recursos suportados e Schema Markup Validator para vocabulário.
5. Observar
Após deploy, verifique URL, logs, Search Console e regressões de template. Exemplo: Confirmar que renderização dinâmica não duplicou ou removeu o JSON-LD.
O critério de aceite deve ser precisão e legibilidade técnica. Rich result e Knowledge Panel são resultados condicionais, não promessas de implementação.
CIO / CTO e marketing
Revisão de arquitetura antes do go-live
Dor
O novo site está visualmente pronto, mas diferentes componentes emitem Organization, Person e Article com nomes, URLs e autores incompatíveis.
Solução
Eliminar duplicações, definir @ids, corrigir fontes dos campos, validar amostra por template e criar teste de regressão.
Resultado
Especificação de schema por template, relatório de validação e critérios de go-live.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Anatomia da rotina: migração do site institucional
| Elemento da rotina | Conteúdo |
|---|---|
| Decisão em jogo | Bloquear ou liberar o lançamento e definir o mínimo técnico para a primeira versão. |
| Insumo necessário | Inventário de templates, registro canônico, schemas atuais, canonicals, redirects e resultados de validação. |
| Validação humana antes de publicar | Marketing confirma conteúdo; técnico valida renderização; jurídico revisa alegações; responsável editorial aprova fatos. |
| Métrica de acompanhamento | Erros por template, entidades duplicadas, páginas aderentes à especificação e regressões após deploy. |
Exercício: audite três templates
Tempo estimado: 20 min
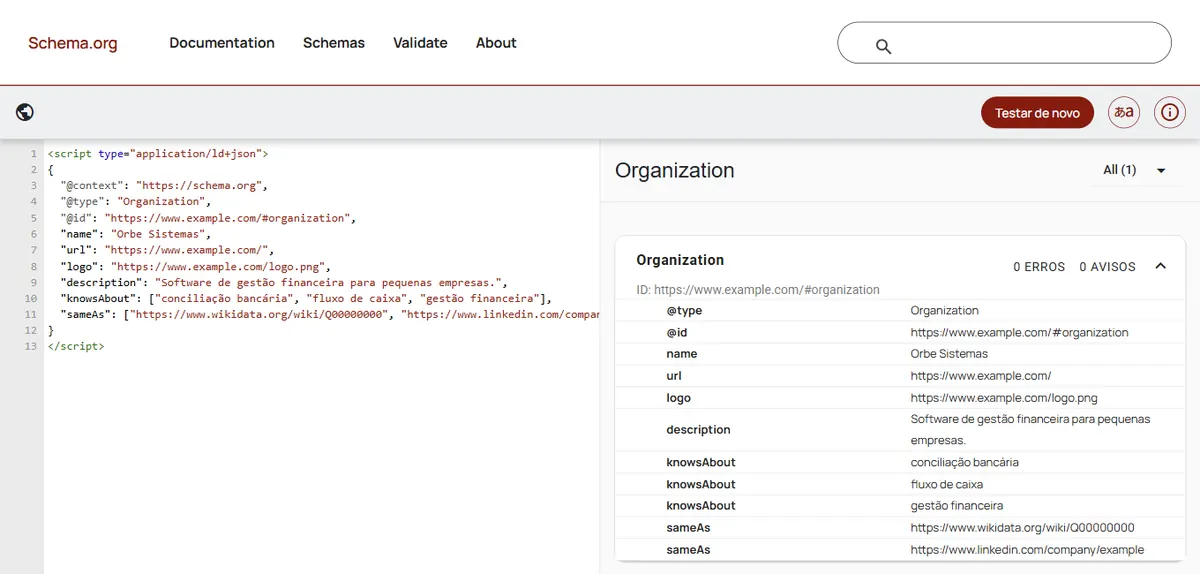
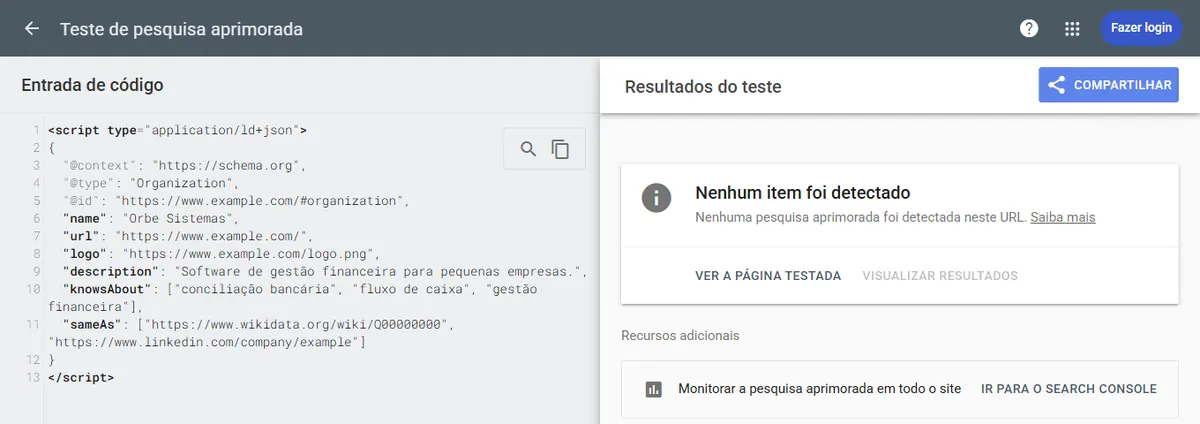
0/5Guia prático: validar o mesmo bloco Organization em duas ferramentas e entender por que elas respondem coisas diferentes. O Schema Markup Validator, mantido pelo schema.org, confere o vocabulário. O Teste de pesquisa aprimorada, do Google, mostra o que a Busca reconhece para recursos de pesquisa. Uma marcação pode passar limpa na primeira e não aparecer na segunda, e isso não é erro.
Organization validada, publicada e conferida na página renderizada
Sete passos. Rode primeiro com o trecho de código e depois com a URL publicada.
Passo 1: Escreva o JSON-LD da Organization com @id fixo
Campos mínimos: @id (por exemplo, a URL do site seguida de #organization), name, url, logo, description, sameAs e, se fizer sentido, knowsAbout com os temas do território.
Deu certo quando: O mesmo @id aparece no publisher de todas as páginas, sem repetir a ficha inteira.
Erro comum: Colocar em sameAs perfis que não são da empresa ou que ninguém mantém.
Passo 2: No validator.schema.org, escolha Snippet de código, cole o bloco e clique em Testar
O painel da direita lista cada propriedade lida, com o valor interpretado.
Deu certo quando: 0 erros e 0 avisos, e cada valor de knowsAbout e sameAs aparece numa linha própria.
Erro comum: Ver 0 erros e não conferir a lista: uma vírgula fora do lugar pode transformar duas URLs de sameAs numa só.
Passo 3: No Teste de pesquisa aprimorada, aba Código, cole o mesmo bloco e teste
O teste lista só os tipos que geram recurso de pesquisa no Google e os erros que impedem esse recurso.
Deu certo quando: Ou o item aparece sem erro, ou a mensagem é "Nenhum item foi detectado", sem erro de sintaxe.
Erro comum: Ler "Nenhum item foi detectado" como marcação inválida e apagar um bloco que o validador aprovou.
Passo 4: Teste a URL publicada, não só o trecho
Na aba URL, rode com o rastreador de smartphone e abra Ver a página testada, HTML renderizado, para achar o JSON-LD.
Deu certo quando: O bloco aparece no HTML renderizado, igual ao que você colou.
Erro comum: JSON-LD injetado por script que o rastreador não executa a tempo, ou duplicado por um plugin.
Passo 5: No Search Console, use Inspeção de URL, Testar URL publicada
Confirma que a página está indexável e mostra os dados estruturados detectados na versão rastreada.
Deu certo quando: Página indexável e a mesma leitura do teste anterior.
Erro comum: Esquecer que a correção só vale para o Google depois do novo rastreamento.
Passo 6: Registre a versão do schema.org usada na revisão
A release 30.1, de 16/09/2026, trouxe vocabulário de produto e passaporte digital de produto da União Europeia, sem mudança em Organization ou Person.
Deu certo quando: A especificação de schema do site traz a data e a versão da última revisão.
Erro comum: Revisar a marcação inteira a cada release sem ler o que mudou.
Passo 7: Repita por template, não por página
Uma URL de amostra por template (início, artigo, pilar, produto) já cobre o site quando o JSON-LD sai do mesmo componente.
Deu certo quando: Planilha com template, URL de amostra, resultado nas duas ferramentas e data.
Erro comum: Validar uma página à mão e não perceber que outro template gera a Organization com outro @id.
No fim você tem: Um bloco Organization com vocabulário validado, presente no HTML que o Google rastreia e conferido por template, com data e versão registradas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
As duas capturas acima usam exatamente o mesmo código. O validador do schema.org leu as onze propriedades; o teste do Google não listou item algum. Para o trabalho de entidade, a leitura que importa é a do validador somada à presença do bloco no HTML renderizado. O teste do Google entra quando o tipo gera recurso de pesquisa, como Product, Article ou Event.
Escola de cursos livres de marketing com três unidades
Educação, SEO local e conteúdo
Dor
Cada unidade tinha uma Organization diferente, criada por plugins distintos, e o time apagou o bloco da página inicial ao ver "Nenhum item foi detectado" no teste do Google.
Solução
A equipe definiu um @id para a escola e um para cada unidade, ligou as unidades à escola por parentOrganization, validou o trecho no Schema Markup Validator e conferiu o HTML renderizado de quatro templates.
Resultado
Uma única entidade principal em todas as páginas, três unidades ligadas a ela e uma planilha de validação que a agência passou a repetir a cada mudança de tema do site.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Especificação verificável de dados estruturados por template, na forma de uma matriz de schema para três templates com fontes, @ids e critérios de aceite.
Aprofundamento
A partir daqui o capítulo sai do "como fazer" e entra no "por que funciona". Se você só precisa executar, o material acima já basta.
A pergunta que quase ninguém faz em voz alta
Se a informação já está escrita na página, por que adicionar dados estruturados?
Porque texto visível foi escrito para leitura humana e pode permitir várias interpretações. Dados estruturados usam vocabulário padronizado para declarar o tipo da entidade, suas propriedades e relações, sempre refletindo o conteúdo que o visitante consegue verificar.
Por que as pessoas se perdem exatamente aqui
O código parece técnico e incentiva dois atalhos: delegar significado inteiramente ao desenvolvimento ou marcar tudo na esperança de ganhar destaque. O trabalho começa pela modelagem factual; o código apenas expressa essa modelagem em formato legível por máquina.
- Etapa 1 de 5: Escolha a entidade principal
Cada página precisa declarar com clareza qual objeto descreve.
- Etapa 2 de 5: Selecione o tipo específico
Tipos mais precisos reduzem ambiguidade quando correspondem ao conteúdo real.
- Etapa 3 de 5: Mapeie propriedades para fontes
O código não deve criar fatos ausentes ou sem dono.
- Etapa 4 de 5: Conecte com identificadores
Relações consistentes permitem reconhecer a mesma entidade entre páginas.
- Etapa 5 de 5: Valide significado e sintaxe
Código válido pode representar um fato errado, e código correto conceitualmente pode conter erro de sintaxe.
A cadeia causal com o que observar em cada etapa
| Etapa | Por quê | O que observar | Exemplo |
|---|---|---|---|
| Escolha a entidade principal | Cada página precisa declarar com clareza qual objeto descreve. | Pergunte qual coisa possui os atributos centrais do conteúdo. | Uma página institucional descreve Organization; uma página de artigo descreve Article e seu autor. |
| Selecione o tipo específico | Tipos mais precisos reduzem ambiguidade quando correspondem ao conteúdo real. | Compare os tipos disponíveis com a função visível da página. | Um estudo editorial pode usar Article; uma página comercial não deve fingir ser curso ou notícia. |
| Mapeie propriedades para fontes | O código não deve criar fatos ausentes ou sem dono. | Para cada propriedade, indique campo do CMS, texto visível e fonte canônica. | author aponta ao registro da pessoa; dateModified vem da data real de revisão editorial. |
| Conecte com identificadores | Relações consistentes permitem reconhecer a mesma entidade entre páginas. | Defina URLs canônicas e identificadores estáveis reutilizados. | O mesmo identificador da organização aparece em artigo, produto e página institucional. |
| Valide significado e sintaxe | Código válido pode representar um fato errado, e código correto conceitualmente pode conter erro de sintaxe. | Faça revisão editorial, técnica e teste automatizado. | O teste confirma JSON válido; a área responsável confirma cargo, nome e relação declarados. |
Caso longitudinal, Episódio 7 · descobrir que um código válido descrevia a entidade errada
Quem está na sala: CIO com engenharia, SEO, conteúdo, produto e jurídico
A reunião: Revisão técnica após uma auditoria encontrar o produto marcado como organização e avaliações internas publicadas como se fossem avaliações de clientes.
O que estava sobre a mesa e como a decisão foi construída
| Dado bruto apresentado | Raciocínio aplicado |
|---|---|
| Quatro templates usam o mesmo bloco genérico de marcação. | Reutilizar o mesmo bloco reduz custo técnico, mas apaga diferenças semânticas entre os templates. |
| O identificador da organização muda entre páginas com e sem barra final. | Identificadores inconsistentes fragmentam a referência da mesma entidade. |
| Campos de autor ficam vazios em artigos antigos. | Propriedades sem conteúdo visível ou fonte confiável devem ser removidas, mesmo que passem no validador. |
| O template comercial inclui propriedades de avaliação sem fonte pública verificável. | A especificação precisa declarar origem e regra de preenchimento para impedir divergência futura. |
Orbe Sistemas
Empresa-modelo do curso, cenário hipotético
Dor
Quatro templates usam o mesmo bloco genérico de marcação. O identificador da organização muda entre páginas com e sem barra final. Campos de autor ficam vazios em artigos antigos. O template comercial inclui propriedades de avaliação sem fonte pública verificável.
Solução
Reutilizar o mesmo bloco reduz custo técnico, mas apaga diferenças semânticas entre os templates. Identificadores inconsistentes fragmentam a referência da mesma entidade. Propriedades sem conteúdo visível ou fonte confiável devem ser removidas, mesmo que passem no validador. A especificação precisa declarar origem e regra de preenchimento para impedir divergência futura.
Resultado
Criar matriz por template, padronizar identificadores, remover propriedades não sustentadas e tornar autor obrigatório nos artigos revisados. Registro: Especificação com template, entidade principal, tipo, propriedade, fonte do campo, obrigatoriedade, identificador, regra, validação e dono.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
O que ainda pode dar errado. A correção manual pode desaparecer na próxima mudança do CMS. As regras precisam estar no componente, na documentação e nos testes de integração.
Três erros comuns e como corrigir
| Erro | Sintoma | Correção |
|---|---|---|
| Adicionar propriedades porque a ferramenta aceita. | O código contém fatos que o usuário não vê ou que nenhuma área confirma. | Exija correspondência com conteúdo visível, fonte canônica e responsabilidade de atualização. |
| Usar um único esquema em todos os templates. | Produto, artigo, pessoa e organização recebem o mesmo tipo genérico. | Modele primeiro a entidade e a função de cada template; compartilhe apenas identificadores e propriedades realmente comuns. |
| Considerar validação sintática como aprovação final. | O teste fica verde enquanto o significado permanece incorreto. | Separe validação técnica, factual e editorial com responsáveis diferentes. |
Matriz de dados estruturados por template
Traduzir modelagem factual em requisitos implementáveis, testáveis e sustentáveis pelo CMS.
Documento montado
Comece com três templates prioritários. Desenhe um exemplo preenchido a partir de conteúdo real, revise com o dono factual e só depois converta em requisito de código e teste.
O que você digitar fica salvo neste navegador. Nada é enviado para servidor algum.
Critérios de aceite do artefato
O artefato só está pronto quando todas as linhas abaixo forem verdadeiras
0/4Ensine para provar que entendeu
Explique para um desenvolvedor por que o validador verde não basta para aprovar uma marcação.
O validador confirma formato e compatibilidade, mas pode aceitar um fato incorreto ou uma entidade mal classificada. A aprovação exige verificar se tipo, propriedades e relações correspondem ao conteúdo visível e às fontes canônicas.
Sinais de que a explicação ainda não está pronta. A resposta promete resultado de busca garantido; o aluno não menciona conteúdo visível; identificador e fonte do campo são ignorados. Qualquer um dos três devolve o aluno ao material antes de seguir.
1. Dado um tipo qualquer de dado estruturado, qual é a sequência de passos que você roda para classificá-lo como ativo, lido sem aparência ou descontinuado, e onde você registra a data da consulta? 2. Por que taxID vem antes de sameAs na ordem de prioridade, e o que exatamente a documentação oficial promete e não promete sobre sameAs? 3. No seu bloco JSON-LD, o que acontece se um satélite declarar isPartOf apontando para um @id que não existe no grafo, e como isso é detectado antes do deploy? E a autoavaliação executiva: (a) Cada marcação representa o conteúdo visível e usa uma fonte de verdade identificada. (b) Entidades recorrentes utilizam @ids estáveis e relações coerentes. (c) Diferencio sintaxe válida, aderência às diretrizes, elegibilidade e exibição.
Perguntas frequentes deste capítulo
Preciso saber programar para decidir o schema?
Schema garante rich result ou Knowledge Panel?
Posso marcar uma informação que está apenas no código?
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Faça a máquina reconhecer quem é a sua empresasugerido pelo grafoApresenta os conceitos “sameAs”, “JSON-LD” e “Schema.org”, usados em “O crachá da sua empresa para as máquinas”.
- Diagnostique em que etapa a busca perde a sua páginasugerido pelo grafoApresenta os conceitos “Rich result”, “Dados estruturados” e “Renderização”, usados em “O crachá da sua empresa para as máquinas”.
- Registre a empresa como entidade que o Google reconhecesugerido pelo grafoApresenta o conceito “Entidade”, usado em “O crachá da sua empresa para as máquinas”.
- CursoGEO e Knowledge Graphsugerido pelo grafo2 capítulos de “Autoridade Temática e SEO de Entidades” usam conceitos apresentados em “GEO e Knowledge Graph”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- E-E-A-T e Qualidade de ConteúdoCobrar a marcação de autoria que o Google realmente lêExaminar conexões de Cobrar a marcação de autoria que o Google realmente lê
- GEO Universal FrameworkRegistre a empresa como entidade que o Google reconheceExaminar conexões de Registre a empresa como entidade que o Google reconhece
- SEO e GEO para Personal BrandsEntity SEO: Person, ProfilePage, sameAs e ConsistênciaExaminar conexões de Entity SEO: Person, ProfilePage, sameAs e Consistência
- Wikidata e Wikipedia para GEOIntegrando Wikidata ao Seu SiteExaminar conexões de Integrando Wikidata ao Seu Site
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.