Wikidata e Wikipedia: fontes e identidade pública
Uma empresa encontra duas datas de fundação na internet. Qual delas está sustentada por uma fonte? Em 12 capítulos, aprenda a distinguir entidades, conferir informações e preparar correções transparentes, sem precisar programar.
O que você vai aprender
Abra uma fonte, encontre o trecho que comprova o fato e escreva uma correção curta. Você vai praticar com uma empresa fictícia, conferir consultas e responder a perguntas com explicação.
Pré-requisitos
- Nenhum conhecimento de programação
- Interesse em conferir informações públicas
- Disposição para abrir e comparar fontes
- Um caso real da sua organização para reflexão
Percurso de aprendizagem
1. Conferir fontes e projetos
Distinguir artigo, declaração e referência antes de avaliar um fato.
A Aurora Software, empresa fictícia deste curso, foi fundada em 2018 e lançou seu primeiro produto em 2020. Uma página confunde essas datas. Sua primeira tarefa é separar os dois acontecimentos e mostrar qual documento comprova cada um.
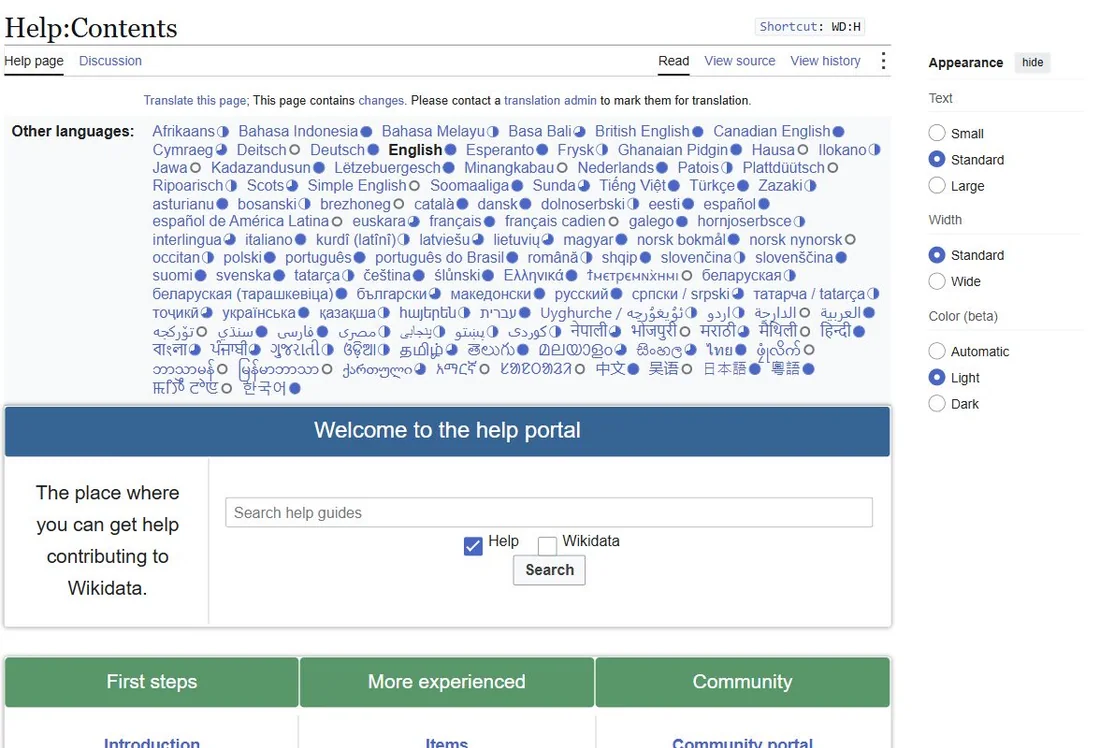
Captura de 24/10/2026 · Fonte: wikidata.org · Ampliar imagem
Ver como texto
Menu de ajuda e tipos de informação
A Wikipedia explica assuntos em artigos. O Wikidata organiza informações em campos, como data de fundação e sede. Cada pessoa, organização ou assunto tem um item. Um fato registrado nesse item é chamado declaração e pode ter uma referência: a fonte que permite conferir a informação.
Vídeo e podcast foram produzidos em 02/10/2026. Ao aplicar seus exemplos, confira a fonte citada: ter uma página no Wikidata não demonstra que uma IA usou essa página na resposta.
Wikipedia e Wikidata: texto para pessoas, dados para máquinas
O capítulo 1 em vídeo: a diferença entre a Wikipedia e o Wikidata, por que buscadores, assistentes de IA e conjuntos de treino dependem dos dois, a tabela de diferenças estruturais, o papel da licença CC0, a regra prática de conferir a Wikipedia e o QID, o que mudou em 2026 e o caso da agência B2B, cenário ilustrativo do curso.
Transcrição
0:00Olá e boas-vindas a esta videoaula de abertura. Vamos direto ao ponto, mergulhando na base do que sustenta a visibilidade na era da inteligência artificial. Para quem cuida da reputação de uma marca, de uma empresa ou de uma figura pública, entender o que os assistentes de IA dizem sobre essas entidades é o movimento mais vital que existe. O foco aqui recai sobre os fundamentos do primeiro capítulo do nosso estudo sobre otimização para motores generativos, ou GEO, explorando as engrenagens conjuntas do Wikidata, e da Wikipedia.
0:31É o ponto de partida exato para quem nunca editou nenhuma dessas plataformas, mas precisa navegar por esse ecossistema com muita precisão e segurança. Para começar, a gente precisa olhar para esses dois projetos da Wikimedia Foundation.
0:44Eles formam simplesmente a infraestrutura semântica aberta mais utilizada da web. De um lado, a gente tem a Wikipedia, que é uma enciclopédia colaborativa organizada em texto corrido.
0:54Ela responde a perguntas como quem, o que, quando e por que em linguagem natural, cobrindo mais de 300 idiomas. Do outro lado, entra a Wikidata, atuando como um banco de dados estruturado, multilíngue e totalmente legível por máquina.
1:09O detalhe é que o Wikidata responde às mesmas perguntas da Wikipedia, mas através de declarações formais. Pensa em três caixinhas interligadas, a tripla sujeito, predicado e objeto. É exatamente assim que os dados ganham estrutura.
1:23E por que é tão crucial estudar os dois juntos? A resposta está na forma como a tecnologia moderna consome informação. Buscadores e assistentes de IA bebem da Wikipedia e do Wikidata como fontes primárias de verdade.
1:36Além disso, aqueles Knowledge Panels que vemos nas buscas são massivamente alimentados por propriedades como o sameAs no Wikidata e pelas Infoboxes da Wikipedia. Tem mais. Os grandes modelos de linguagem leram praticamente a enciclopédia inteira.
1:51Isso acontece porque os conjuntos de treino mais importantes da IA, como Common Crawl, C4, The Pile e Dolma, contêm dumps completos da Wikipedia. Para fechar, o Wikidata ainda oferece um endpoint SPARQL público, uma ferramenta fantástica para consultas federadas que permite fazer auditorias minuciosas de entidades.
2:11É justamente por causa de toda essa integração profunda que chegamos a uma premissa inegável. Editar a Wikipedia sem entender o Wikidata é perder metade da oportunidade de GEO. Tentar gerenciar a presença de uma marca olhando apenas para os artigos em texto e ignorar os dados estruturados significa, na prática, fechar os olhos para a forma como a inteligência artificial realmente mapeia e compreende o nosso mundo.
2:35Para entender melhor, vamos comparar as diferenças estruturais essenciais entre os projetos. No formato, a Wikipedia usa a linguagem natural. Já o Wikidata trabalha com dados estruturados em RDF. A unidade básica na Wikipedia é o artigo, enquanto no Wikidata a gente fala de um item, com aquele código Q, e uma propriedade, com o código P.
2:55As fontes na enciclopédia são aquelas citações in-line no rodapé. No banco de dados, exige-se referência por declaração específica. O público também muda. Humanos leem a Wikipedia, mas tanto humanos quanto máquinas leem o Wikidata.
3:08Na verificabilidade, a Wikipedia pede fontes secundárias confiáveis, enquanto o Wikidata pede fontes verificáveis por declaração. A notabilidade na enciclopédia exige cobertura significativa em fontes independentes, mas o Wikidata adota um critério mais amplo, aceitando praticamente qualquer coisa identificável.
3:25E, por fim, a licença, que é a grande chave. A Wikipedia usa CC BY-SA 4.0, e o Wikidata opera em CC0. Vamos aprofundar essa questão da licença CC0, porque a consequência estratégica disso é gigantesca. CC0 significa domínio público.
3:43Dados em domínio público permitem o uso sem nenhuma necessidade de atribuição. Ou seja, qualquer empresa de tecnologia pode ingerir o Wikidata inteiro sem dar crédito. E isso explica brilhantemente por que tantos assistentes conversacionais adotaram o Wikidata como a sua camada de entidades. Editar um único item por lá não atualiza só uma página. Alimenta dezenas de sistemas de forma simultânea.
4:07Trazendo tudo isso para a prática da gestão de reputação, existe uma regra direta para descobrir o que os assistentes de IA vão considerar como verdade sobre um nome. Do lado esquerdo, a gente precisa verificar exatamente o que a Wikipedia diz em texto.
4:19Em paralelo, do lado direito, é fundamental rodar uma consulta pelo respectivo QID no query.wikidata.org, caso ele exista. A união do que esses dois sistemas dizem forma a base principal do que os modelos de linguagem acreditam ser a realidade.
4:35E vale lembrar que esse ecossistema segue em movimento, com mudanças técnicas e de políticas documentadas ao longo de 2026 e 2027. Começando em março de 2026, a Wikipedia em inglês implementou uma diretriz contra a geração ou reescrita de texto utilizando grandes modelos de linguagem, abrindo exceções apenas para a revisão de texto próprio e para a tradução.
4:57Em 15 de setembro de 2026, o snapshot mensal completo do Wikidata tornou-se gratuito no Wikimedia Enterprise. Na infraestrutura técnica de consultas, os novos endpoints no QLever abrem para a comunidade até 1º de novembro de 2026.
5:12Esse movimento faz parte da migração do serviço de consultas que sai do Blazegraph com a transição completa prevista para 30 de junho de 2027. Essas não são as únicas atualizações.
5:23O ecossistema passou a contar com um servidor MCP público e um banco de vetores do Wikidata, uma arquitetura pensada exatamente para que agentes de IA consigam consultar o grafo com mais eficiência. Em paralelo, o comportamento de edição gerou reações.
5:37Registrou-se uma alta na criação de itens promocionais. Por conta disso, existe uma proposta em andamento para incluir novos avisos na própria tela de criação de um novo item.
5:45Para materializar o impacto prático dessas dinâmicas, vamos analisar o caso de uma agência B2B em São Paulo, um cenário ilustrativo criado para o curso. O problema começou quando o pacote antigo da agência focava apenas na criação de itens no Wikidata.
5:59O resultado foi que parte dos itens acabou apagada. A solução estratégica foi trocar esse pacote de criação por uma auditoria de entidade. A agência passou a avaliar se já existia um QID, a garantir que as propriedades tivessem referência, validar a presença de sameAs no site oficial e mapear uma lista das fontes que faltam.
6:18O foco passou a ser gerar a fonte independente exigida, garantindo que itens novos só entrem com notabilidade documentada. E assim chegamos à estrutura fundamental de todo esse cenário. É a combinação exata entre o texto corrido e os dados estruturados que alimenta continuamente os grandes modelos de linguagem e os Knowledge Graphs em toda a web.
6:38Tudo isso ocorre através do alcance poderoso da licença CC0, que distribui informações vitais em domínio público sem necessidade de atribuição. Encerramos aqui nossa aula. Até a próxima!
Na simulação da Aurora, a equipe lê primeiro o trecho que contém a data e abre sua referência. Um documento sobre o lançamento do produto sustenta 2020 para esse evento; não sustenta a fundação da empresa. O diagnóstico registra essa diferença antes de discutir onde editar. O mesmo cuidado vale para um artigo narrativo e para um campo estruturado.
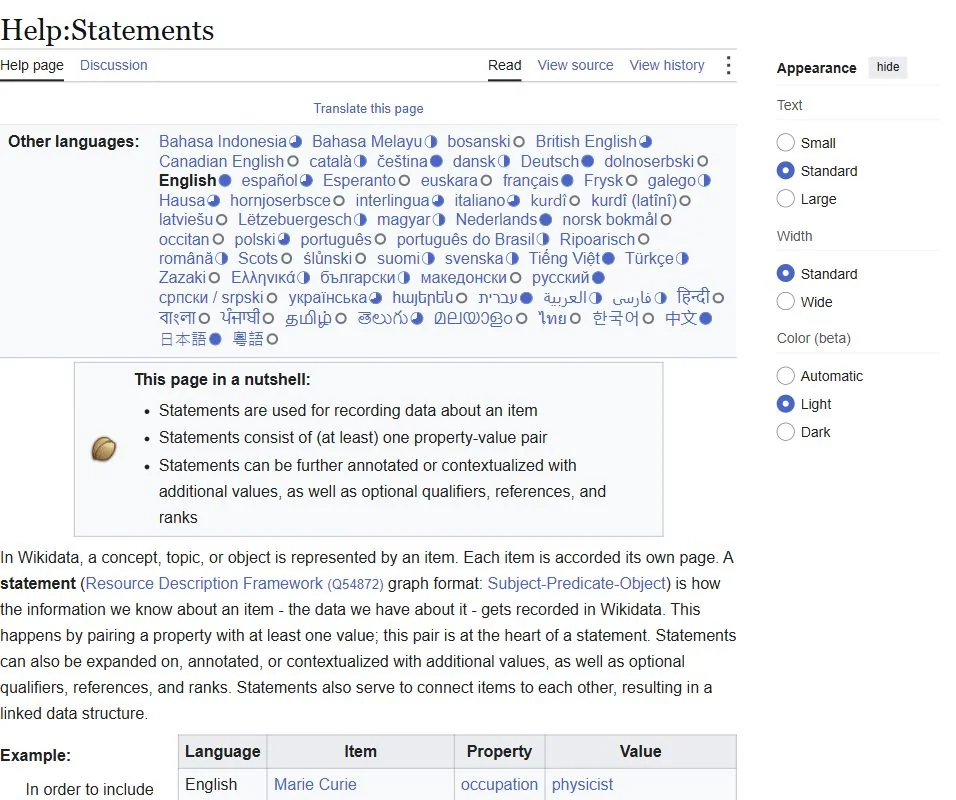
Captura de 24/10/2026 · Fonte: wikidata.org · Ampliar imagem
Ver como texto
Diagrama de declaração, propriedade e valor
No podcast, acompanhe a diferença entre consultar uma informação e contribuir com uma correção.
Fundamentos de Wikidata e Wikipedia, em conversa
Dois apresentadores percorrem o capítulo 1: a tripla sujeito-predicado-objeto, os Knowledge Panels alimentados por sameAs e infoboxes, a Wikipedia dentro dos conjuntos de treino, a tabela de diferenças linha a linha, a licença CC0, as mudanças de 2026 e a agência que trocou a criação de itens por auditoria de entidade, cenário ilustrativo do curso.
Transcrição
0:00Imagina tentar ajustar a forma como uma marca é percebida, sabe? Por um assistente de inteligência artificial. Alguém passa horas mudando um texto enciclopédico e aí descobre que a inteligência artificial, na verdade, está lendo um banco de dados oculto e estruturado.
0:15Nossa, sim. Isso muda tudo. Pois é. Então, para quem cuida da reputação de uma empresa ou gerencia a própria imagem no mercado, entender esse mecanismo é fundamental. A nossa missão nesse mergulho de hoje é ir direto ao ponto.
0:30Vamos explorar os fundamentos do primeiro capítulo do curso Wikidata e Wikipedia para GEO. Essa sigla GEO significa Otimização para Motores Generativos. Começar por esse cenário é perfeito.
0:45Olha, para entender o que os assistentes de IA dizem sobre uma marca ou pessoa, a gente precisa olhar para os dois projetos centrais mantidos pela Wikimedia Foundation. Eles costumam ser confundidos, mas... Muito confundidos, né? Demais.
0:58Só que eles operam de maneiras completamente distintas. Sabe, de um lado, a gente tem a Wikipedia. Ela é uma enciclopédia colaborativa, escrita em linguagem natural. Aquela página clássica de texto corrido. Exato.
1:11O conteúdo é organizado em artigos textuais, disponíveis em mais de 300 idiomas. E, na prática, a Wikipedia responde às perguntas de quem, o que, quando e por quê. Tudo em texto corrido, feito para a leitura humana.
1:24É a interface que qualquer pessoa reconhece de imediato ao fazer uma busca. Mas, hum, e a outra ponta dessa dinâmica? Onde entra a parte desenhada para as máquinas? Aí é que entra o Wikidata. O Wikidata é um banco de dados estruturado, também multilíngue, mas a diferença técnica primária dele é ser legível por máquina.
1:46Tá, e como ele responde aquelas mesmas perguntas? Ele responde as mesmíssimas perguntas que a Wikipedia, mas faz isso utilizando uma estrutura muito específica, chamada de triplas, sujeito, predicado e objeto.
1:59Vamos detalhar como essa mecânica funciona na prática, porque ler um texto humano é tranquilo, mas como uma máquina interpreta essa tripla de sujeito, predicado e objeto? Então, imagina que em vez de ler um parágrafo inteiro explicando que uma determinada pessoa fundou uma empresa num ano específico, a máquina lê uma declaração dividida cirurgicamente em três partes.
2:20Certo. O sujeito é a entidade principal da qual a gente está falando. O predicado é a relação, a característica ou a ação. E o objeto é o valor dessa relação. O Wikidata descreve as entidades assim, por meio dessas declarações formais.
2:37Ah, entendi. É uma maneira de entregar a informação já mastigada, né? Exatamente. Entrega pronto, para que um sistema de computador consiga processar sem nenhuma margem para a ambiguidade.
2:47É tipo comparar a leitura de uma biografia num livro com uma ficha cadastral dessa pessoa, onde cada informação tem a sua coluna específica. Mas isso levanta um ponto essencial. Por que a gente precisa estudar Wikipedia e Wikidata em conjunto?
3:02Qual é o peso prático de unir o texto com a ficha? O peso prático é o ecossistema que consome esses dados. Esses dois projetos formam a espinha dorsal do que a gente chama de Knowledge Graph do Google. Que é gigantesco.
3:14Sim, e também são a base para o treinamento de modelos de linguagem, os LLMs. Se a gente olhar para os buscadores e assistentes atuais, a lista de sistemas que usam os dois como fonte primária de verdade sobre entidades inclui nomes como Google, Bing, Apple, Amazon, ChatGPT, Gemini e Perplexity.
3:35Fica muito claro que ignorar essa dupla não é uma opção para quem trabalha com presença digital. E como é que essa integração se materializa na tela de quem faz uma busca comum? Um dos exemplos mais visíveis são os Knowledge Panels do Google.
3:48Sabe aquelas caixas de informação consolidadas que aparecem do lado ou no topo das buscas? Sim, chamam muito a atenção na página. Exato. Esses painéis são fortemente alimentados por dois elementos. Primeiro, pela propriedade chamada sameAs do Wikidata, que serve basicamente para conectar as pontas e indicar que uma entidade é a mesma em diferentes plataformas.
4:09E segundo, pelas infoboxes, que são aquelas caixas de informação resumida que ficam no canto dos artigos da Wikipedia. Tem um detalhe fascinante sobre o peso da Wikipedia no treinamento das inteligências artificiais.
4:21Conjuntos de treinos gigantescos que servem de matéria-prima para os LLMs contêm a Wikipedia inteira. A gente está falando de datasets como Common Crawl, C4, The Pile e Dolma. Todos eles leem tudo, né? Integralmente.
4:35A consequência de a Wikipedia estar dentro desses conjuntos de treino é que cada LLM moderno já leu a página da Wikipedia de uma entidade. Claro, caso ela exista. É bem isso. E olha, enquanto a Wikipedia treina a compreensão de linguagem, o Wikidata entra como uma ferramenta estrutural.
4:52O Wikidata expõe um endpoint público chamado SPARQL. Tá, e o que ele faz exatamente? O grande diferencial desse endpoint público é que ele permite realizar consultas federadas em grafo. É o lugar ideal para auditar as conexões de uma entidade.
5:06Vamos fazer uma pausa para esclarecer esse conceito para quem nos acompanha. O que significa, na prática, fazer uma consulta federada em grafo nesse endpoint SPARQL? Imagina um bibliotecário digital extremamente avançado.
5:20Em vez de simplesmente buscar pelo título de um livro, a consulta em grafo permite cruzar múltiplas relações simultaneamente. Nossa, cruzando várias propriedades ao mesmo tempo.
5:30Sim. Você pode pedir, por exemplo, uma lista de todas as empresas de software fundadas em uma cidade específica, que tenham executivos formados em uma determinada universidade. O SPARQL permite extrair essas conexões exatas.
5:46Isso é ideal para fazer auditoria de entidades, né? Exatamente. Ideal para entender profundamente como os dados de uma marca estão interligados. E isso amarra com perfeição a frase central do material.
5:57Editar a Wikipedia sem compreender o Wikidata é perder metade da oportunidade de GEO. Essa compreensão técnica dupla é inegociável. Com certeza. Para aprofundar essa visão, a gente pode comparar estruturalmente os dois projetos, alternando cada linha da tabela de diferenças, começando pelo formato e pela unidade básica.
6:16Bom, no formato, a diferença consolida o que a gente falou. Na Wikipedia, temos o texto em linguagem natural. No Wikidata, os dados estruturados usam o formato RDF. E sobre a unidade básica de organização, na Wikipedia, a unidade central é simplesmente o artigo.
6:33Enquanto no Wikidata, a unidade é dividida. A unidade principal é o item, que é sempre identificado pela letra Q, e ele é acompanhado pela propriedade, identificada pela letra P. Então, Q e P organizam tudo por lá. E sobre as fontes?
6:48Porque aí a diferença começa a ficar mais estratégica. Na Wikipedia, a exigência é pelas citações in-line, aquelas notas de rodapé no meio do texto corrido. Isso. Já no Wikidata, a exigência é ter referências por declaração.
7:01E essa exigência se conecta direto ao público de cada projeto. O público da Wikipedia é o leitor humano, que consome o artigo e checa a citação no rodapé. Faz sentido. E o público do Wikidata? O público engloba humanos e máquinas.
7:16A máquina não lê um parágrafo inteiro, né? Ela lê a declaração isolada, processa o dado estruturado e confere a referência ligada especificamente àquela declaração. O que nos leva às regras de aceitação. Começando pela política de verificabilidade.
7:30A Wikipedia exige fontes secundárias confiáveis. E o Wikidata exige fontes verificáveis por declaração. Certo, e a partir da verificabilidade, a gente entra no critério de notabilidade, que é onde ocorre um distanciamento brutal entre os projetos.
7:44A enciclopédia exige uma cobertura significativa em fontes independentes para garantir a notabilidade. Já a Wikidata tem um critério de notabilidade vastamente mais amplo. Basta ser qualquer coisa identificável. Pera, pausa aqui. Qualquer coisa identificável.
8:00Deixa eu ver se entendi o impacto. A Wikipedia exige um histórico robusto na mídia, mas Wikidata aceita qualquer coisa identificável. Como isso muda o jogo para quem trabalha com reputação digital?
8:11Muda de forma drástica, porque a barreira de entrada no banco de dados estruturado é muito mais permeável do que na enciclopédia textual. Essa flexibilidade permite mapear entidades no grafo de forma muito mais ampla, desde que haja verificação por declaração.
8:27É uma ponte temática perfeita para a gente falar da última linha da tabela, as licenças. Esse é talvez o ponto mais crítico. A Wikipedia usa licença CC BY-SA 4.0, mas o Wikidata usa CC0. E essa escolha técnica muda tudo.
8:43A licença CC0 significa domínio público. A gente precisa destrinchar esse peso. Domínio público significa uso sem atribuição. Ou seja, a informação flui sem barreiras que exijam a citação de origem a todo momento.
8:58É exatamente por causa desse uso sem atribuição que o Wikidata se torna a camada de entidades de sistemas gigantescos. O Google, o Apple Maps, a Siri, a Alexa e o DuckDuckGo usam isso. São muitos sistemas downstream. Sim, são muitos sistemas downstream.
9:13Os assistentes conversacionais conseguem puxar os dados direto para o usuário porque não tem complexidade jurídica travando o reuso. A conclusão lógica é impressionante. Quem cria ou edita um item alimenta simultaneamente dezenas de sistemas downstream.
9:27Um ajuste no Wikidata irradia para todo mundo. É por isso que o material traz uma regra prática para quem quer saber o que a IA pensa sobre uma marca. E qual é a regra? Em vez de perguntar direto ao ChatGPT, o caminho ideal é fazer duas coisas em paralelo.
9:43Perguntar o que a Wikipedia diz sobre o nome e buscar o QID no endereço query.wikidata.org, caso esse QID exista. Essa combinação oferece uma aproximação razoável do que os LLMs acreditam ser verdade. Incrível!
10:00Agora, puxando o assunto para as novidades do material, a gente tem fatos recentes apontados sobre o ano de 2026. Vamos listar isso de forma independente, começando pela infraestrutura de acesso. Houve uma migração importante no serviço de consultas.
10:15O back-end do query.wikidata.org sai do Blazegraph e vai para o QLever. Os endpoints novos abrem para a comunidade até 1º de novembro de 2026, com a migração completa prevista para 30 de junho de 2027.
10:31E além da infraestrutura, tem a questão do fornecimento de dados. Desde 15 de setembro de 2026, o Wikimedia Enterprise passou a entregar um snapshot mensal completo do Wikidata em uma conta gratuita. Também temos iniciativas focadas em IA.
10:47A Wikimedia Deutschland mantém um servidor MCP público e um banco de vetores do Wikidata desenhados para agentes de IA consultarem o grafo. Entrando nas pressões comunitárias, a equipe do Wikidata registrou uma alta na criação de itens promocionais.
11:02Por conta disso, existe uma proposta de avisos e confirmação na tela de criação de itens. E finalizando a lista, tem a diretriz da Wikipedia em inglês. Desde março de 2026, é proibido gerar ou reescrever texto de artigo utilizando o LLM, havendo exceções apenas para a tradução e para a revisão de texto próprio.
11:22Quero trazer um exemplo prático para materializar isso. E eu faço questão de alertar em voz alta e com toda clareza que este é um cenário ilustrativo criado para o curso. Perfeito. A protagonista do cenário é a gerente de SEO de uma agência B2B em São Paulo que atende uma carteira de clientes de SaaS, que são os softwares vendidos como serviço.
11:43E qual era o problema lá? A agência tinha um pacote antigo de SEO que vendia a criação de itens no Wikidata para clientes que não tinham cobertura em fontes independentes.
11:52A consequência foi que parte dos itens acabou apagada e a agência virou alvo de patrulha. A virada de chave nesse cenário ilustrativo é a solução adotada. A agência trocou a criação indiscriminada por uma auditoria de entidade.
12:06E essa auditoria envolve passos claros. Mapear o QID existente, garantir propriedades com referência, adicionar o sameAs no site oficial e levantar uma lista de fontes que faltam. A regra mudou. Item novo só entra quando há notabilidade documentada.
12:22E o saldo é muito positivo. O cliente ganha um plano verificável, a agência para de queimar contas e o trabalho de digital PR ganha um objetivo certeiro. Que é gerar o tipo de fonte que a Wikipedia e o Wikidata aceitam, né?
12:35Exato. Gerar fontes aceitáveis constrói a presença real. Chegamos ao momento de fazer um apanhado exato do que precisa ficar retido. Para quem cuida de marca, a diferença crucial é entre a Wikipedia, que é texto corrido, e o Wikidata, que são os dados estruturados.
12:51E por que isso importa? Porque os dois projetos juntos são os motores, os insumos críticos que alimentam os modelos de linguagem e os Knowledge Graphs atuais. Eles definem a estrutura da IA. E o papel da licença CC0 amarra tudo.
13:06É por ser domínio público que ela garante a propagação rápida e sem atrito desses dados pela web. Entender essa dinâmica muda a visão técnica. Esse foi o nosso mergulho nos fundamentos de hoje. Um abraço e até a próxima.
Notoriedade é o critério usado para decidir quais assuntos cabem no projeto. As regras da Wikipedia e do Wikidata são diferentes. Para avaliar a Aurora, separe documentos da própria empresa de textos publicados por autores independentes; essa diferença será usada nos próximos capítulos.
Concentre o trabalho no fato que você consegue conferir: qual data aparece, qual evento ela representa e qual fonte a sustenta. Se a informação estiver errada em um canal da empresa, corrija ali. Em outro projeto, prepare a evidência para avaliação.
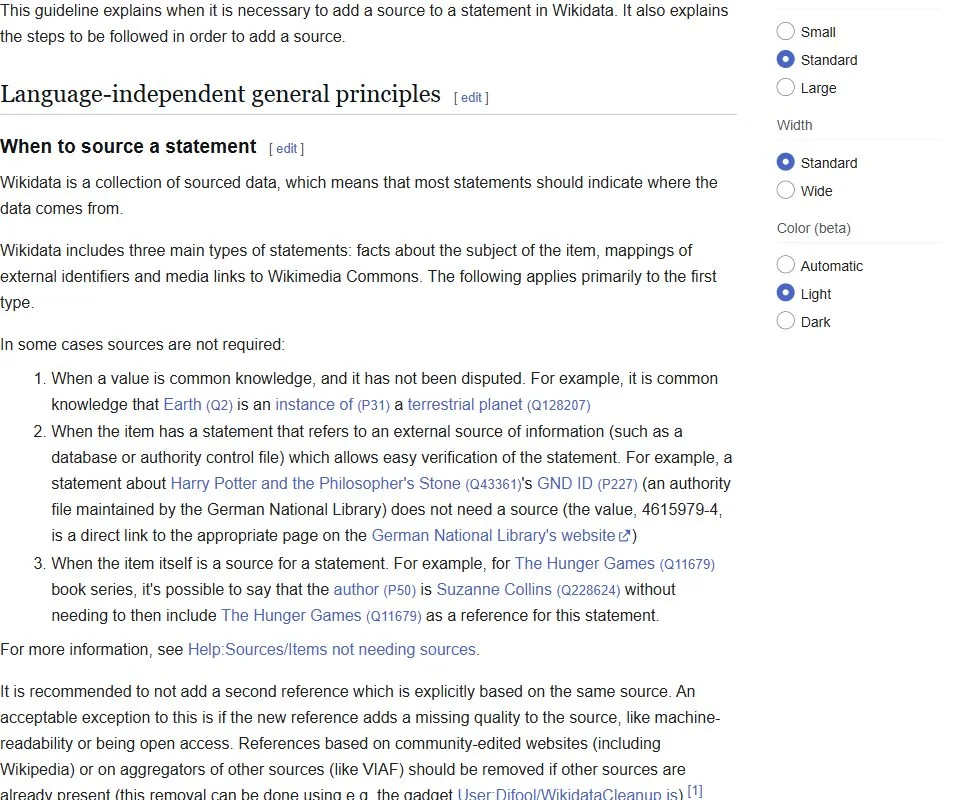
Captura de 24/10/2026 · Fonte: wikidata.org · Ampliar imagem
Ver como texto
Quando adicionar referências e como localizar a fonte
A ficha deve registrar: empresa, fato, documento, trecho e data da consulta. No exemplo, 2018 fica ligado à fundação; 2020, ao lançamento. Quando o documento não responder à pergunta, anote a informação que ainda falta.
Separe o fato da fonte
Use uma ficha simples para registrar a conferência.
Passo 1: Escolha uma afirmação.
Na simulação, a página diz que a Aurora foi fundada em 2020.
Deu certo quando: A ficha contém uma frase para conferir.
Passo 2: Localize o evento no documento.
O documento informa fundação em 2018 e lançamento do produto em 2020. Escreva cada data ao lado do acontecimento.
Deu certo quando: As duas datas ficam ligadas a eventos diferentes.
Passo 3: Escreva a correção.
Proponha apenas a frase sobre a fundação, indicando o documento e seu trecho.
Deu certo quando: Outra pessoa entende por que a data deve ser 2018.
No fim você tem: Guarde a ficha com a fonte e a data consultada.
Um documento diz que a empresa foi fundada em 2018 e lançou um produto em 2020. Qual data corresponde à fundação?
Percurso de aprendizagem
2. Avaliar identidade e alcance
Separar identidade comprovada de expectativa sobre respostas de IA.
Percurso de aprendizagem
3. Contribuir com responsabilidade
Preparar evidências e respeitar as regras de cada comunidade.
Percurso de aprendizagem
4. Consultar, integrar e acompanhar
Examinar dados, ligar a identidade correta e observar mudanças.
Perguntas frequentes
Como conferir um painel de conhecimento do Google?
Posso criar meu próprio item no Wikidata ou isso é considerado autopromoção?
Qual a diferença prática entre Wikidata e Google Knowledge Graph?
Como saber se uma resposta de IA usou o Wikidata?
Posso contratar uma agência para criar artigo na Wikipedia sobre minha empresa?
Como acompanhar uma correção?
Alexandre Caramaschi
Chief Strategy Officer da Nuvini (Nasdaq: NVNI), Founder da Brasil GEO, cofundador da NAIA e cofundador da AI Brasil. Foi CMO da Semantix, empresa brasileira de dados e IA listada na Nasdaq. É pioneiro em Generative Engine Optimization e no conceito de Business-to-Agent no mercado brasileiro.
Este curso reúne fontes públicas e situações didáticas para avaliar identidade e qualidade da informação. As contribuições seguem as regras de cada projeto, e seus efeitos em produtos externos precisam ser observados sem presumir propagação automática. Para dúvidas, entre em contato pelo WhatsApp ou LinkedIn.