SEO programático · ·
Ferramentas de SEO programático: dá para auditar sem pagar?
É possível começar com ferramentas gratuitas quando o site disponibiliza seus arquivos públicos. O robots.txt pode indicar o sitemap, que lista endereços e ajuda a reconhecer a organização do acervo. A inspeção de algumas páginas permite conferir conteúdo e diretivas de indexação, mas não prova presença no Google, tráfego ou receita. No exemplo histórico do QuintoAndar, consultado em 19/07/2026, o sitemap de cidade listava 82 URLs e o de rua, 23.436; esses números descrevem apenas aquele recorte e aquela data.
Este capítulo faz parte do curso gratuito SEO programático.
O acervo público de um concorrente permite investigar tipos de página, organização e cobertura aparente. O sitemap funciona como um mapa de endereços; ele não revela sozinho tráfego, custo ou receita.
Use a investigação para formular perguntas e escolher amostras de páginas. Os exemplos datados a seguir são registros de observação, não descrições garantidas do estado atual desses sites. Antes de usar um caso para aprovar investimento, repita a consulta e registre o que encontrou.
O corte que separa fato de folclore é sempre a mesma pergunta: eu consigo verificar isso agora, com uma requisição? Da Zapier, por exemplo, a estrutura /apps/[App1]/integrations/[App2] é fato: você abre a URL e ela está lá. Já os números de tráfego que acompanham esse case (as "9 milhões de visitas orgânicas") são estimativa de Ahrefs ou Similarweb, republicada por agências que vendem serviço de SEO programático. Estrutura se verifica, tráfego de terceiro se estima. Não misture os dois na mesma frase quando estiver falando com um cliente.
Para conferir uma descrição de arquitetura, procure evidências no próprio site. Quando estão disponíveis, três documentos ajudam: o robots.txt pode indicar o endereço do sitemap; o sitemap apresenta URLs declaradas e pistas de organização; e o HTML de uma página revela conteúdo e algumas diretivas de indexação. Esses arquivos nem sempre existem ou cobrem todo o acervo.
Uma página acessível e sem noindex não está necessariamente indexada. A auditoria a seguir lê o que o site declara; a presença efetiva no índice exige outra verificação. São quatro comandos para uma amostra pequena de arquivos públicos.
Ver como texto
Auditoria em quatro comandos curl. O primeiro, no robots.txt, revela onde mora o índice de sitemap. O segundo, no índice, revela a taxonomia escrita nos nomes das partições. O terceiro conta as ocorrências de loc dentro de uma partição e revela a cardinalidade de cada eixo. O quarto lê o HTML de uma URL profunda e revela se aquela página gerada está indexável.
O exemplo resolvido é o QuintoAndar, escolhido porque a evidência é primária, o site é brasileiro e você pode repetir cada comando agora e comparar com o que está escrito aqui. Todos os números abaixo foram medidos em 19 de julho de 2026. Se você rodar em outra data e o número tiver mudado, o número mudou, o método não.
Começo pelos dois primeiros comandos. O grep -i no robots.txt não é enfeite: muitos sites declaram o sitemap em capitalização inconsistente.
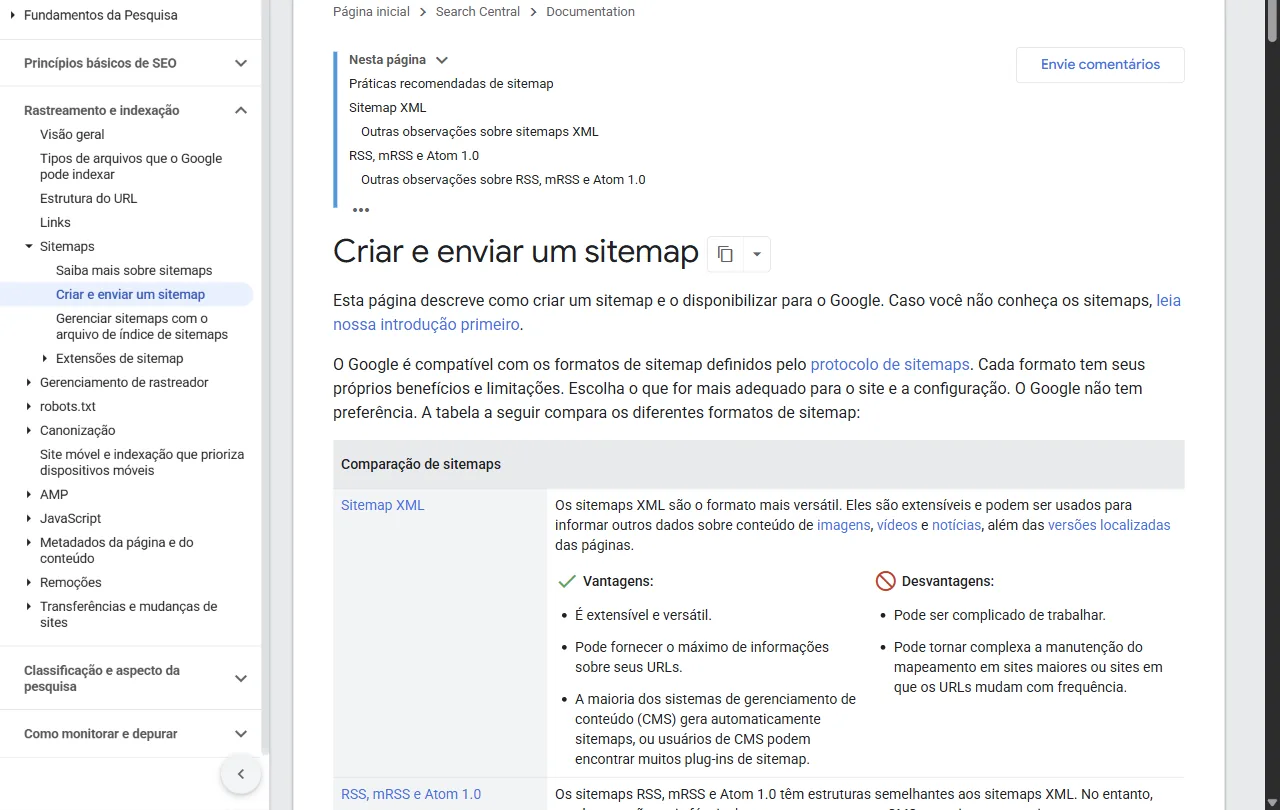
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: exemplos de sitemap e orientações sobre atualização.
# 1) Onde este site declara o índice de sitemap?
curl -s https://www.quintoandar.com.br/robots.txt | grep -i sitemap
# saída em 19/07/2026:
# Sitemap: https://www.quintoandar.com.br/sitemap-v2.xml

# 2) Quais partições existem dentro do índice?
#    -o imprime só o trecho casado, sort -u tira as repetições de "-part-0001" etc.
curl -s https://www.quintoandar.com.br/sitemap-v2.xml \
  | grep -o 'sitemap-v2-[a-z0-9-]*' \
  | sort -u
# 57 sitemaps declarados no índice, lastmod 2026-07-18
A saída do segundo comando é o achado do módulo, porque a taxonomia inteira está escrita nos nomes dos arquivos. Sem nenhuma engenharia reversa, aparecem quatro eixos combinados:
- transação: as famílias
alugarecomprar, com o mesmo conjunto replicado nas duas. - granularidade geográfica:
city,neighborhood,street. - tipo de imóvel: o sufixo
housetype. - filtro: o sufixo
filter, que no nível da URL vira coisas como2-quartosouproximo-ao-metro.
Além desses, há famílias com ciclo de vida próprio: condos, listings, places, regions, hierarchy e neighborhood-guide. Uma partição como sitemap-v2-partition-alugar-imovel-neighborhood-housetype-filter é, portanto, a leitura literal de uma combinação dos quatro eixos.
Ver como texto
Anatomia do nome de uma partição de sitemap do QuintoAndar. O nome sitemap-v2-partition-alugar-imovel-neighborhood-housetype-filter-part-0000 se decompõe em dois trechos estruturais, a versão do índice e a marca de camada gerada, quatro eixos da taxonomia, transação, geografia, tipo de imóvel e filtro, e um sufixo de fatia do arquivo.
# 3) Qual o tamanho real de cada eixo? Conte as ocorrências de <loc>.
base=https://www.quintoandar.com.br

curl -s "$base/sitemap-v2-partition-alugar-imovel-city-part-0000.xml"  | grep -c '<loc>'
# 82

curl -s "$base/sitemap-v2-condo-neighborhood-pages-part-0000.xml"      | grep -c '<loc>'
# 2040

curl -s "$base/sitemap-v2-partition-alugar-imovel-neighborhood-housetype-filter-part-0000.xml" | grep -c '<loc>'
# 17473

curl -s "$base/sitemap-v2-partition-alugar-imovel-street-part-0000.xml" | grep -c '<loc>'
# 23436

curl -s "$base/sitemap-v2-manual-search-part-0000.xml"                  | grep -c '<loc>'
# 50000 <- teto do protocolo, não é o tamanho real da famíliaVer como texto
Contagem de ocorrências de loc por partição do sitemap do QuintoAndar, medida em 19 de julho de 2026: 82 na partição de cidade, 2.040 na de condomínio por bairro, 17.473 na de bairro com tipo e filtro, 23.436 na de rua e 50.000 na de busca manual, que bateu no teto do protocolo. As barras usam escala logarítmica.
Leia a progressão antes de ler qualquer número isolado. 82 cidades na base geram 23.436 páginas de rua. Isso é explosão combinatória, e é intencional: o site desce a granularidade geográfica até onde ainda existe estoque para sustentar a página. Repare também no que a contagem de 50.000 não diz. Ela bate exatamente no limite de URLs por arquivo do protocolo de sitemap, então significa apenas "este arquivo está cheio". O tamanho real daquela família só sai somando as demais partes (part-0001, part-0002) e é por isso que a família custom-search-pages aparece dividida em três partes.
O detalhe de maturidade que quase ninguém nota nesse índice são as famílias `manual-search` e `custom-search-pages`. Elas existem separadas das partições automáticas porque são uma camada curada, gerenciada por outro ciclo, convivendo com a camada gerada. Isso responde antecipadamente a uma dúvida que vai aparecer no seu projeto: gerar em escala e curar à mão convivem como duas camadas do mesmo catálogo, em vez de competirem, e a separação no sitemap é o que permite medir, revalidar e podar cada uma no seu próprio ritmo.
# 4) A página gerada está indexável? Procure meta robots no HTML da origem.
#    -L segue redirect; sem ele você pode estar lendo o HTML errado.
curl -s -L "https://www.quintoandar.com.br/alugar/imovel/jardim-jamaica-santo-andre-sp-brasil/casa/proximo-ao-metro" \
  | grep -io 'name="robots" content="[^"]*"'
# name="robots" content="noindex"

curl -s -L "https://www.quintoandar.com.br/alugar/imovel/jardim-aurelia-campinas-sp-brasil/casa/2-quartos" \
  | grep -io 'name="robots" content="[^"]*"'
# (sem saída: não há meta robots noindex; a página traz canonical próprio)Registre esse resultado como observação de auditoria, não como conclusão. O que você mediu é que duas URLs da mesma família, geradas pelo mesmo template, têm status de indexação diferente. Isso já é suficiente para derrubar a leitura ingênua de que "estar no sitemap" e "estar no índice do buscador" são a mesma coisa. Qual é o critério que decide um caso e outro, e como implementar esse critério no seu próprio projeto, é o assunto inteiro de [Escolher quais páginas devem aparecer na busca](#indexacao-seletiva-em-render). Resista a explicar agora: auditoria boa separa o que foi medido do que foi inferido.
Ver como texto
Comparação de dois índices de sitemap. À esquerda, um índice com 57 partições nomeadas por eixo e uma camada curada separada, do qual se extraem os eixos, a cardinalidade e a fronteira entre gerado e curado. À direita, um índice com um único arquivo de nome opaco, do qual só se extrai a lista de URLs.
Rode o método em mais de um site antes de concluir qualquer coisa, porque o resultado negativo também é informação. Nas verificações de 19/07/2026:
- vagas.com.br declara sitemap em
https://www.vagas.com.br/sitemap.xml, e/vagas-de-desenvolvedorresponde 200, o que confirma o padrão de uma página por cargo. - OLX, Zap Imóveis e Reclame Aqui não declaram sitemap no robots.txt de
www.
O segundo caso exige cuidado de linguagem. Não declarar no robots.txt não prova que o site não tem sitemap, porque ele pode estar submetido apenas pelo Search Console. O que esse resultado prova é outra coisa, e é útil: qualquer afirmação sobre o volume de páginas desses sites, sua ou de terceiro, está sem lastro verificável. "Não consegui medir" é uma conclusão honesta e defensável. "Eles têm 2 milhões de páginas" sem fonte, não.
Fonte: support.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: categorias do relatório de páginas indexadas e motivos de exclusão.
Duas fronteiras deste módulo, para você não confundir escopo. Primeira: todo case que você citar precisa da data em que foi verificado, porque a taxa de apodrecimento é alta. O exemplo /delivery/sao-paulo-sp/pizza do iFood circula há anos em material brasileiro e responde 404 hoje; quem o repetiu não conferiu. Se você não verificou na data, não cite. Segunda: este módulo lê sitemap e HTML público de forma manual e pontual, para entender arquitetura. Extração automatizada, volume, fronteira entre conteúdo deslogado e logado e o que os termos de uso podem proibir são tema de [Avaliar riscos de uso dos dados e de reputação](#risco-juridico-e-de-marca), e a resposta lá não é a mesma para todos os casos.
Aplicação no Radar de Preço de Combustível. O entregável deste módulo tem duas partes: o relatório de auditoria de um site programático de referência (use o QuintoAndar ou escolha outro e rode os quatro comandos) e o desenho da taxonomia do Radar com estimativa de cardinalidade por eixo.
O Radar tem três eixos candidatos: UF, município e tipo de combustível. A tentação é multiplicar os três e anunciar o total. Não faça isso. Município e UF não são eixos independentes (todo município pertence a exatamente uma UF), e a cobertura da pesquisa da ANP é desigual: a série semanal não cobre todos os municípios brasileiros, e os combustíveis pesquisados variam por praça. Multiplicar produziria uma matriz cheia de páginas sem dado, que é exatamente o defeito que [Decidir se o projeto de páginas merece investimento](#gate-do-dado-proprio) mandou você evitar.
O caminho correto é medir a cardinalidade contra o inventário, do mesmo jeito que você acabou de medir a do QuintoAndar contando <loc>. Baixe uma semana da série histórica da ANP e conte os valores distintos e as combinações que de fato existem no arquivo.
# Cardinalidade medida, não estimada. Ajuste os índices de coluna ao layout
# do CSV que você baixou da série histórica de preços da ANP.
# O separador da série é ponto e vírgula; -F define isso no awk.

# quantos municípios distintos aparecem na semana?
awk -F';' 'NR>1 {print $3}' precos_semana.csv | sort -u | wc -l

# quais produtos (combustíveis) existem de verdade nesta semana?
awk -F';' 'NR>1 {print $5}' precos_semana.csv | sort -u

# a combinação que vira URL: municipio + UF + produto, contada de fato
awk -F';' 'NR>1 {print $3"|"$2"|"$5}' precos_semana.csv | sort -u | wc -l

# quantos municipios da UF de SP a pesquisa cobriu nesta semana?
# (compare esse número com o total de municípios de SP na API de
#  localidades do IBGE: a diferença é a sua taxa de cobertura real)
awk -F';' 'NR>1 && $2=="SP" {print $3}' precos_semana.csv | sort -u | wc -l
O relatório de auditoria fecha o módulo e é curto de propósito. Cinco itens, no formato que você usaria para entregar a um cliente:
- onde mora o índice e quantos sitemaps ele declara.
- os eixos da taxonomia, extraídos dos nomes das partições, e não da sua interpretação das URLs.
- a cardinalidade por eixo, com a contagem de
<loc>e a data da medição, marcando quais partições bateram no teto de 50.000. - existe camada curada separada da gerada? Se sim, quais famílias.
- duas URLs profundas da mesma família com o status de meta robots de cada uma.
Ao lado dele, a proposta de particionamento do Radar: quais eixos entram, qual a cardinalidade medida de cada um, e como você pretende fatiar isso em arquivos de sitemap. O número que você escrever aqui vai ser cobrado no apêndice técnico [Apêndice: apresentar endereços e atualizações ao buscador](#sitemap-index-e-lastmod), quando o particionamento sair do papel.
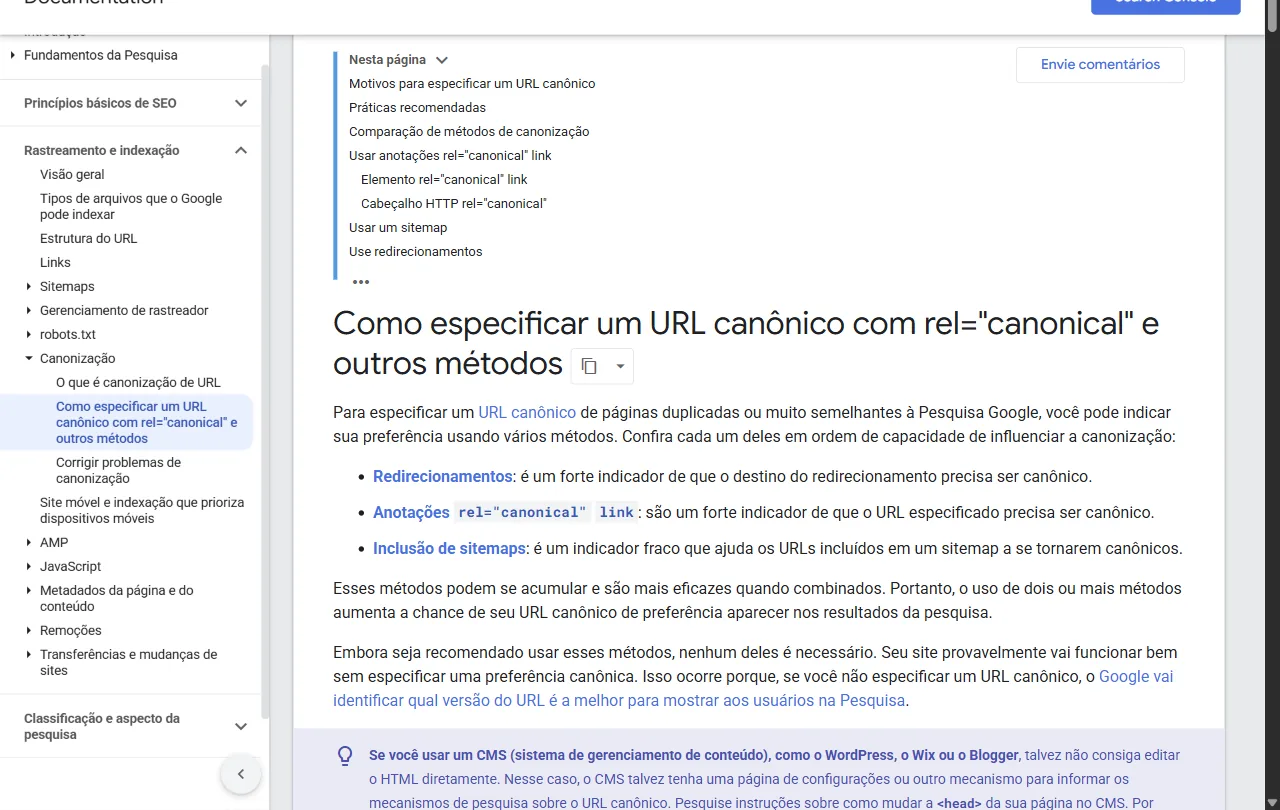
Fonte: developers.google.com · Captura em 29/10/2026 · trecho de página pública
Ver como texto
Captura da documentação oficial: métodos de consolidação e limites do sinal de URL preferida.
Aplique o método a um caso hipotético. Um índice declara as partições part-servicos-uf, part-servicos-uf-cidade, part-servicos-uf-cidade-especialidade, part-servicos-uf-cidade-especialidade-convenio e curadoria-editorial. Escreva a matriz de eixos, diga qual partição você contaria primeiro para estimar o catálogo e por quê. Depois redija a frase que iria ao relatório de um site que não declara sitemap no robots.txt, sem afirmar volume que você não mediu.
O guia a seguir é para o executivo que recebeu uma proposta ancorada no sucesso de um concorrente e quer conferir o tamanho real da operação antes de aprovar. Ele destrava a decisão de usar ou descartar o concorrente como referência de escopo, com evidência datada que qualquer pessoa pode repetir.
Guia de implementação: auditar a arquitetura de um concorrente
Cinco passos, feitos por uma pessoa em um dia, trocam o case de agência por medição própria.
Passo 1: Escolha dois ou três sites de referência
Prefira quem opera no mesmo setor e publica em português, com catálogo parecido com o seu.
Deu certo quando: A lista tem nome, domínio e o motivo de cada escolha em uma linha.
Erro comum: Escolher o case famoso da apresentação da agência sem conferir se ele ainda existe.
Passo 2: Localize o índice de sitemap no robots.txt
O primeiro comando do módulo responde onde mora o mapa do site.
Deu certo quando: Você tem a URL do índice e a data da leitura.
Erro comum: Concluir que o site não tem sitemap porque o robots.txt não o declara.
Passo 3: Extraia os eixos e conte a cardinalidade
Os nomes das partições dão a taxonomia; a contagem de URLs dá o tamanho de cada eixo.
Deu certo quando: Cada eixo tem contagem e data, e as partições que bateram em 50.000 estão marcadas.
Erro comum: Somar partições cheias e anunciar o total como número de páginas indexadas.
Passo 4: Teste duas URLs profundas da mesma família
O quarto comando mostra se a página gerada foi liberada ou barrada para o índice.
Deu certo quando: O relatório registra o status de indexação de cada URL testada.
Erro comum: Explicar o critério do concorrente como fato quando você só observou o efeito.
Passo 5: Entregue o relatório de cinco itens
Índice, eixos, cardinalidade, camada curada e teste de indexação, cada um com data.
Deu certo quando: Outra pessoa repete os comandos e chega aos mesmos números na mesma semana.
Erro comum: Misturar estimativa de tráfego de ferramenta de terceiro com a estrutura medida.
No fim você tem: Um relatório datado da arquitetura de quem já opera em escala, que serve de régua para a proposta que está na mesa.
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Escolher referências | CMO com o analista de SEO | 30 minutos | Lista com domínio e motivo de cada site |
| Localizar o índice | Analista de SEO ou desenvolvedor | 15 minutos por site; sem custo de licença | URL do índice registrada com data |
| Eixos e cardinalidade | Analista de SEO | 2 a 3 horas por site | Contagem por eixo e partições cheias marcadas |
| Teste de indexação | Analista de SEO | 30 minutos | Status de duas URLs da mesma família |
| Relatório de cinco itens | Analista de SEO, revisado pelo CMO | Meio dia | Comandos repetíveis por outra pessoa com o mesmo resultado |
Peça ao time, nesta semana, o relatório de cinco itens de um concorrente citado na proposta que está na sua mesa. Confira pela data e pela reprodução: se os números não vierem datados ou se outra pessoa não chegar ao mesmo resultado com os mesmos comandos, a referência não sustenta o escopo pedido.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSEO e GEO para quem decide
- Entenda por que sua página aparece ou some do Googlesugerido pelo grafoApresenta os conceitos “Robots.txt” e “Indexação”, usados em “Investigar o acervo público de um concorrente”.
- Sete princípios para separar novidade real de SEO reembaladosugerido pelo grafoApresenta o conceito “SEO”, usado em “Investigar o acervo público de um concorrente”.
- Python do zeroConferir títulos e descrições das páginas de um sitemapExaminar conexões de Conferir títulos e descrições das páginas de um sitemap
- SEO para lojas: produtos fáceis de encontrarComo os produtos chegam à buscaExaminar conexões de Como os produtos chegam à busca
- Search Console para decisãoConfirme que a página está no Google antes de discutir posiçãoExaminar conexões de Confirme que a página está no Google antes de discutir posição
- Vibecoding para SEORotina semanal: as ferramentas trabalhando juntasExaminar conexões de Rotina semanal: as ferramentas trabalhando juntas
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.