Como avaliar um teste de memória antes de escolher a ferramenta
Leia o teste antes do número e monte a sua prova antes de escolher a ferramenta.
Este capítulo faz parte do curso gratuito Segundo cérebro com IA.
Que prova você exigiria antes de aprovar a proposta de um fornecedor de memória? Esta aula vem antes da escolha da ferramenta porque a prova define a escolha. Você lê o placar do fornecedor com quatro perguntas (quem mediu, em qual prova, contra quem e em que conversa) e decide a troca por uma prova sua, lida com margem de erro. Sem essas respostas, o placar descreve a conversa do fornecedor, e a decisão de contratar fica apoiada na propaganda.
Tenha à mão o número que o fornecedor mostrou, a tabela do artigo de onde ele saiu e 20 perguntas reais do seu balcão com a resposta certa. Pular as perguntas custa caro depois da assinatura: em 2025, o mesmo sistema de memória, o Zep, apareceu com quatro placares diferentes na mesma prova, todos publicados por empresas que vendem memória.
Ver como texto
Um sistema de memória com quatro placares no mesmo teste, cada um com quem publicou
Quatro barras para o mesmo sistema, o Zep, no teste LoCoMo, em 2025, cada uma com quem publicou. Mem0, artigo de 28 de abril: 65,99%. Zep, blog de 6 de maio, primeira versão: 84%. Mem0, issue de 8 de maio: 58,44%. Zep, versão corrigida: 75,14%. No quadro de baixo: todos publicados por empresas que vendem memória.
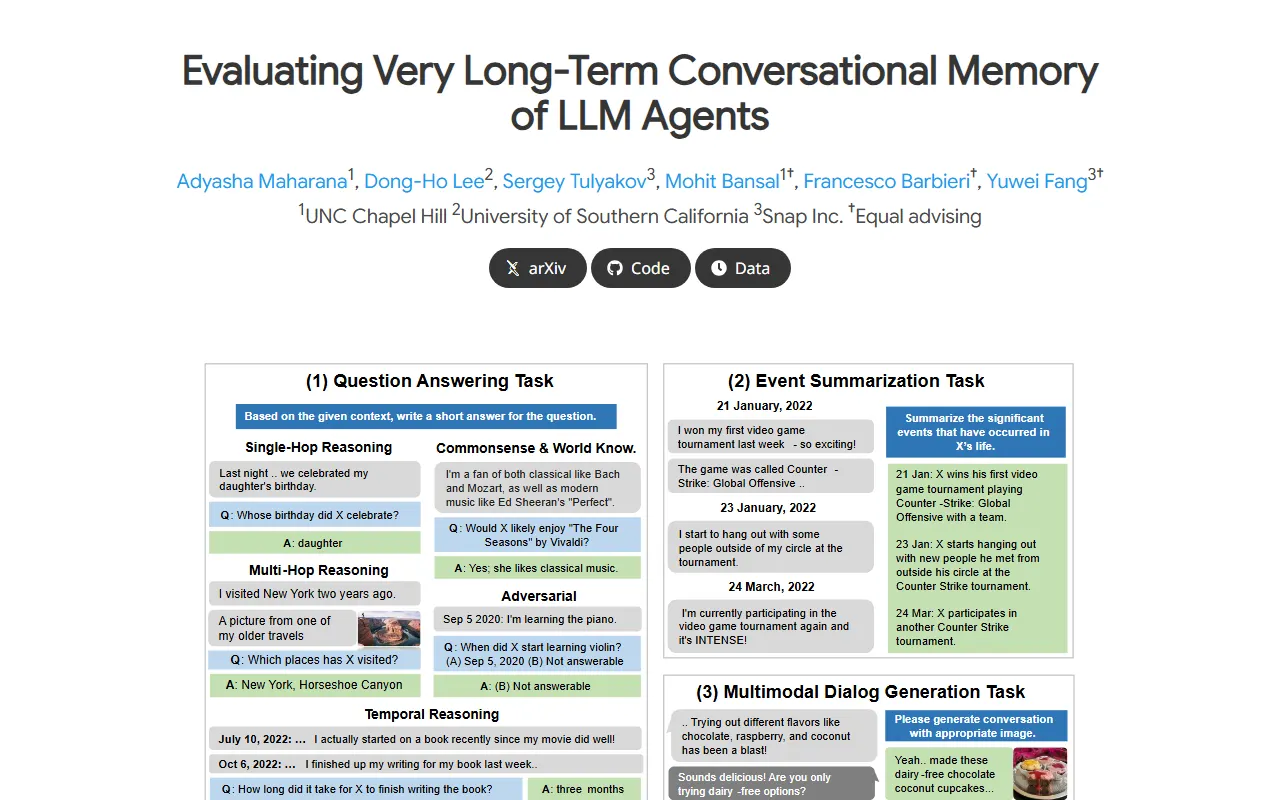
Os quatro placares saíram no LoCoMo, um benchmark (prova padronizada, com perguntas de resposta conhecida, que dá nota ao agente, como exame de direção). O episódio é de 2025 e não vale como classificação atual de nenhuma das duas ferramentas; ele serve de lição sobre como um número nasce.
Ver como texto
Página do projeto LoCoMo, prova pública que mede a memória de agentes em conversas muito longas.
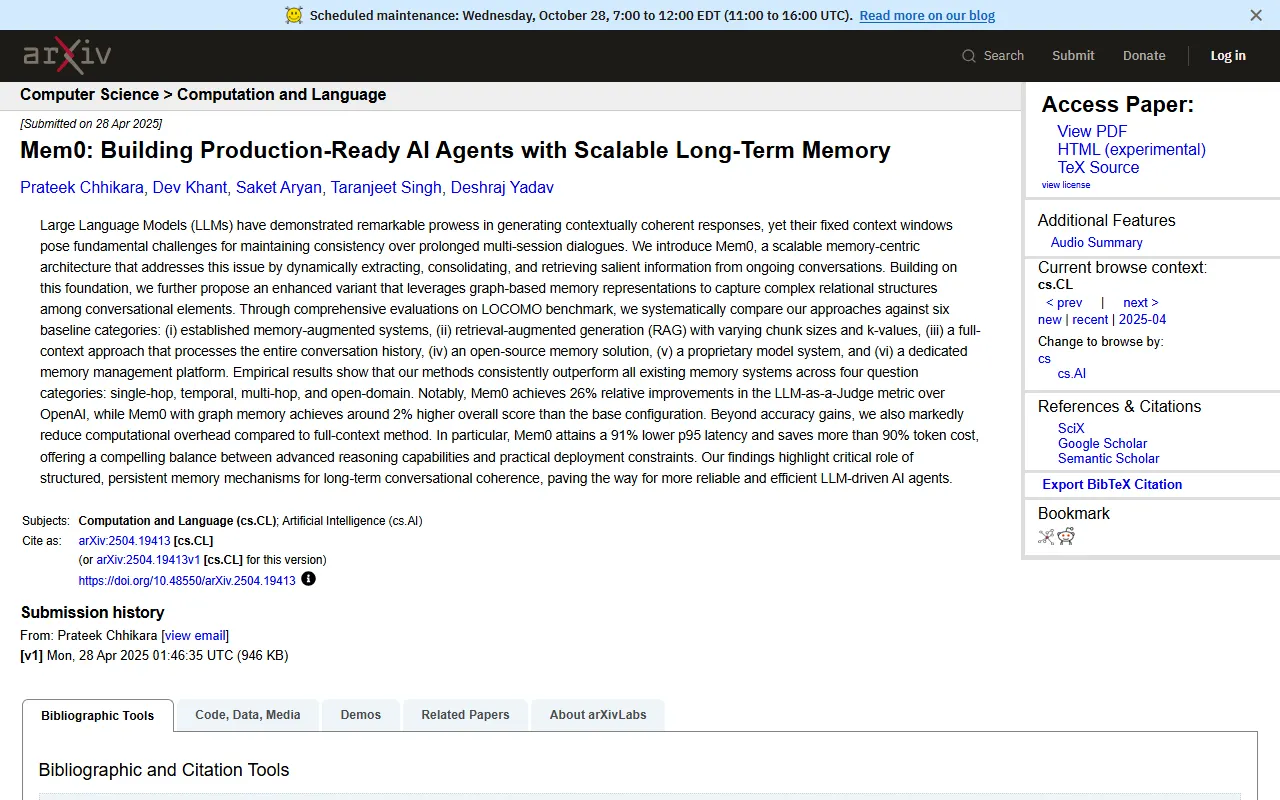
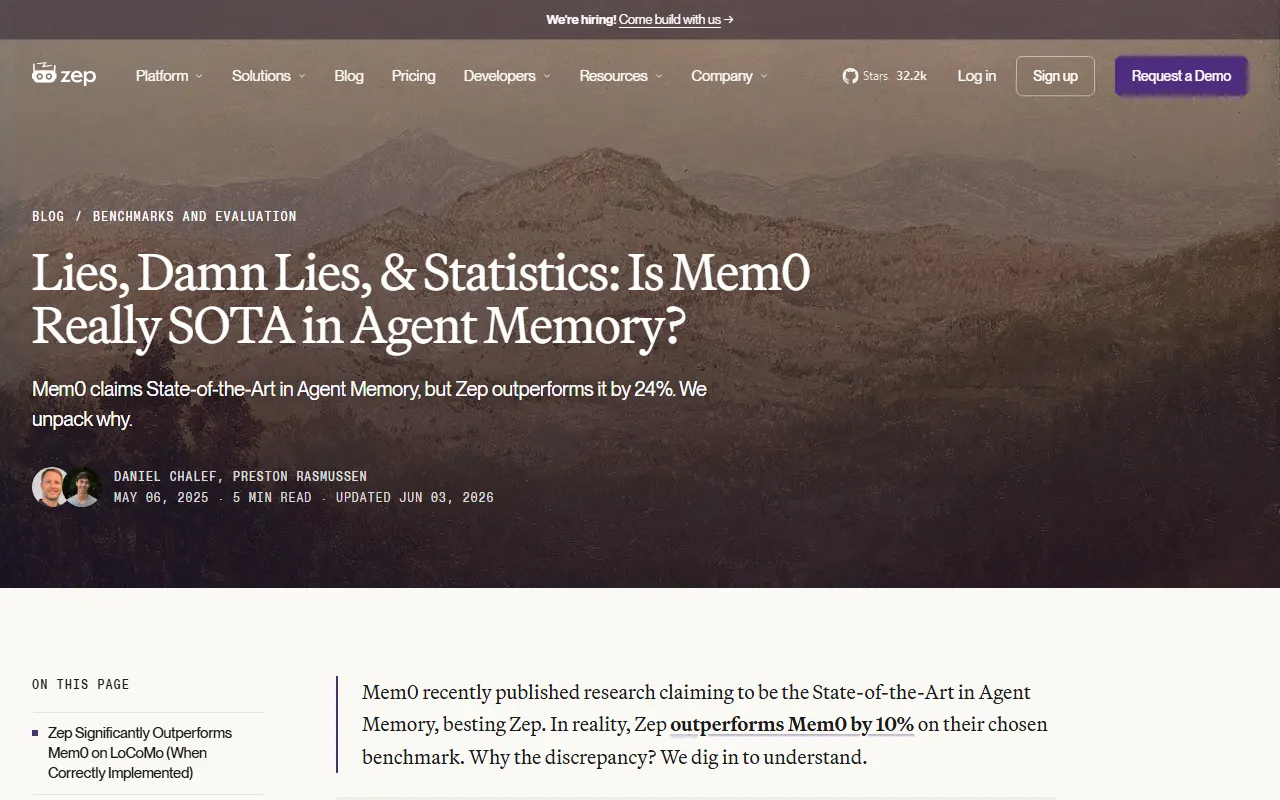
Em abril de 2025, a Mem0 publicou um artigo em que o Zep, concorrente, marcava 65,99. A Zep respondeu que o sistema tinha sido configurado errado e anunciou 84, depois corrigido para 75,14 por erro de conta; o diretor de tecnologia da Mem0 refez a conta e chegou a 58,44.
Ver como texto
Página do artigo da Mem0 no arXiv, que apresenta a memória da empresa e compara o resultado com o de concorrentes no LoCoMo.
Ver como texto
Post do blog da Zep que contesta o placar publicado pela Mem0 e refaz a comparação no LoCoMo.
Por que o mesmo sistema de memória tem quatro placares?
O mesmo sistema tem quatro placares porque cada empresa montou a prova do concorrente com a configuração que ela mesma escolheu. Quem vende conhece a própria configuração, e a do concorrente fica nas mãos de quem quer vencer; uma conta errada muda o resultado em vários pontos. E cada prova imita um tipo de conversa: a de conversas curtas favorece quem põe tudo na mesa do modelo, e a de fatos que mudam de data favorece quem guarda datas.
| Prova | O que mede | Tamanho |
|---|---|---|
| LongMemEval | Cinco habilidades, como perceber que um fato mudou e dizer “não sei” | 500 perguntas escritas à mão |
| LoCoMo | Memória de conversas muito longas | Cerca de 600 turnos, em até 32 sessões |
| MemBench | Memória de fatos e memória de reflexão | Cenários em que o agente conversa ou só observa |
Das três, o LongMemEval é a mais parecida com um negócio de clientes que voltam, porque pergunta por fatos que mudaram entre conversas. Nenhuma das três mede se o agente usa a memória sem ser perguntado: num estudo da Universidade de Kyoto aceito no EMNLP 2026, com 40 usuários por quatro meses, o sistema que acertava 78,8% quando perguntado usou só 7,9% desses fatos quando o assunto voltou sem pergunta.
Que quatro perguntas fazer ao número do fornecedor
Pergunte quem mediu, em qual prova, contra quem e em que tipo de conversa. No exemplo do curso, um fornecedor abre a apresentação com “+18,5% de acerto”, número que a Zep publicou no LongMemEval. Quem mediu foi a própria Zep; a prova foi a versão curta, com conversas de cerca de 115 mil tokens; o adversário foi a conversa inteira na frente do modelo, com um modelo só, o gpt-4o.
A quarta pergunta muda a leitura. Na tabela da própria Zep, os 18,5% são ganho relativo sobre uma subida de 60,2% para 71,2% de acerto, ou seja, 11 pontos percentuais. Pense na ocupação subindo de 50% para 60%: são 10 pontos percentuais a mais e, em relação ao começo, 20% a mais. Os dois números contam o mesmo ganho, e o maior costuma ir para o anúncio.
Ver como texto
Quatro perguntas mostram que o ganho de 18,5% são 11 pontos
No alto, o número anunciado pela Zep: mais 18,5%, igual a 11 pontos, de 60,2% para 71,2%. Abaixo, quatro perguntas com as respostas. Quem mediu? A própria Zep. Em qual prova? LongMemEval, versão curta. Contra quem? A conversa inteira no modelo. Em que tipo de conversa? Ganha em preferências, perde no que o assistente disse.
Na mesma tabela, a Zep mostra onde a ferramenta ganha e onde perde, e esse detalhe raramente chega ao slide de vendas.
O resultado do Zep no LongMemEval por inteiro, pela conta da própria Zep
+11,0 pontos
de 60,2% para 71,2% de acerto
com o gpt-4o, contra a conversa inteira no modelo
2,58 s
tempo de resposta, contra 28,9 s com a conversa inteira
mesma medição da Zep
80,4%
acerto sobre o que o assistente disse, contra 94,6% com a conversa inteira
com o gpt-4o; onde a ferramenta perde
56,7%
acerto em preferências do usuário, contra 20,0% com a conversa inteira
com o gpt-4o; onde a ferramenta mais ganha
O painel mostra por que um número sozinho engana: a mesma ferramenta ganha muito num tipo de pergunta e perde em outro. O placar também envelhece. Em 2026, criadores de outros sistemas publicaram placares próprios acima de 90% no mesmo LongMemEval, com modelos mais novos, e um número medido com o gpt-4o não disputa com um medido com modelo de outra geração. As provas também mudam de objeto: o LongMemEval-V2, publicado em maio de 2026, mede a memória de agentes que navegam na web, com 451 perguntas, e não o histórico de conversa com clientes. Compare dois resultados só quando a tarefa, a versão da prova, o modelo que responde, quem dá a nota e os recursos usados forem os mesmos.
Leve as quatro perguntas a qualquer número que um vendedor mostrar. Quem conhece o próprio teste responde em poucos minutos, com a tabela do artigo aberta; quem desconversa já deu a resposta. O curso “GEO e Knowledge Graph” ensina como pegar número inventado no relatório do fornecedor.
| O que você vê | O que perguntar | O que fazer |
|---|---|---|
| Só a porcentagem de ganho | De quanto para quanto, em pontos | Peça os dois números da comparação |
| O nome de uma prova | O que ela mede e o tamanho da conversa | Compare com as conversas do seu balcão |
| Um adversário vencido | Quem configurou o adversário | Peça o resultado com o adversário configurado pelo dono dele |
| Um modelo de IA só | Qual modelo e quantas rodadas | Peça o resultado com o modelo que você usa |
| Só o acerto | Quanto texto e quanto custo por resposta | Peça custo e tempo ao lado do acerto |
| Nenhum teste seu | Como a ferramenta erra nas suas perguntas | Rode a sua prova |
Só a última linha dá um número que vale para a sua operação, porque mede a conversa do seu cliente. As mesmas perguntas, feitas a quem vende agentes de código, estão no curso “Reinforcement Learning para Vibecoding: do prompt ao loop verificável”, em sete perguntas ao fornecedor antes de assinar, com duas que valem aqui: quanto custa cada resposta certa e qual é o teto de gasto.
Como montar a prova da pousada e ler a margem de erro
Monte a prova com 20 perguntas reais, itens de resposta sim ou não e três rodadas por pergunta, e leia o resultado como faixa, e não como número exato. Com 20 perguntas, a sorte do dia mexe muito no resultado, como uma semana cheia que não prova que a temporada mudou. A faixa mostra onde o acerto de verdade provavelmente está; se as faixas de duas opções se sobrepõem, a diferença entre elas pode ser sorte.
Três trabalhos sustentam o método. Pesquisadores de Bristol e Oxford mostraram na ICML 2025 que, com poucas dezenas de perguntas, a margem de erro do jeito usual sai estreita demais, e recomendam a conta de Wilson. Em 2026, a Maritaca AI e o Jusbrasil, que desenvolvem e usam os modelos avaliados, mostraram em conversas reais em português que itens de sim ou não fazem juízes diferentes concordarem. E a prova τ-bench, de 2024, criou a regra de contar acerto só quando a tarefa passa em todas as rodadas.
Muitos placares usam um modelo juiz, uma IA que dá nota à resposta de outra, como o fiscal de uma prova. Ele opina, mas não executa nem confere a planilha; por isso a sua prova troca a nota dele por itens de sim ou não e pela conferência do estado final, que qualquer pessoa da equipe repete.
A prova da pousada com margem de erro
Passo 1: Junte 20 perguntas reais e guarde-as com quem atende o balcão
Do WhatsApp, do telefone e das correções do balcão, com recados que não perguntam, como “chego no horário de sempre”.
Erro comum: O erro mais comum é mandar as perguntas ao fornecedor antes da prova. Ele afina a ferramenta para elas; mande só uma amostra e guarde o resto.
Passo 2: Escreva para cada pergunta de dois a quatro itens de resposta sim ou não
Por exemplo: citou a diária de R$ 480? Ofereceu o quarto 3?
Deu certo quando: Duas pessoas que corrigem a mesma resposta chegam à mesma contagem.
Passo 3: Confira o estado final quando a pergunta gera uma ação
A reserva ficou com o preço certo na planilha, e não só na frase da resposta.
Passo 4: Rode cada pergunta três vezes em cada opção
Mesmas perguntas, mesma ordem.
Deu certo quando: Você tem, por opção, quantas das 20 passaram nas três rodadas.
Erro comum: Contar a melhor das três. Agente acerta às vezes; conta como acerto só o que passou nas três.
Passo 5: Leia cada resultado como faixa, na tabela abaixo
Deu certo quando: Você vê se as faixas das opções se sobrepõem.
Passo 6: Compare pergunta a pergunta
Conte em quantas só a opção nova acertou e em quantas só a atual acertou.
Deu certo quando: Deu certo quando a decisão sai dessa contagem e das faixas, e não do número maior.
No fim você tem: Uma tabela com os acertos em três rodadas, a faixa de cada opção e a contagem pergunta a pergunta, repetida todo mês e a cada versão nova da ferramenta ou do modelo.
O curso “Prompt Engineering para Executivos” leva a mesma ideia a 20 a 50 tarefas, no capítulo que monta a primeira suíte de avaliação. O passo 5 usa a tabela abaixo, calculada pela conta de Wilson.
| Acertos na prova | Faixa provável do acerto | O que a faixa diz |
|---|---|---|
| 20 de 20 | De 84% a 100% | Nem a nota máxima garante acerto sempre |
| 17 de 20 | De 64% a 95% | Cobre quase toda a faixa de 14 |
| 14 de 20 | De 48% a 86% | Cobre quase toda a faixa de 17 |
| 43 de 50 | De 74% a 93% | Mais perguntas estreitam a faixa |
Conta de Wilson com 95% de confiança, a recomendada para provas com poucas dezenas de perguntas.
Na tabela, 17 contra 14 parece vitória clara, mas as faixas quase se cobrem, e com 20 perguntas a diferença ainda pode ser sorte. Se as faixas se sobrepõem e as perguntas em que só a nova acertou não passam claramente das em que só a atual acertou, trate como empate prático: não troque e fique com a mais barata. Se precisa decidir entre opções próximas, aumente a prova para 50 perguntas antes de trocar. Se a faixa da nova fica inteira acima da faixa da atual, troque.
Está pronto quando você tem, para cada opção, os acertos nas três rodadas, a faixa e a contagem pergunta a pergunta, e a decisão de trocar ou ficar saiu dessa tabela. Quando a prova precisar rodar sozinha a cada mudança, o curso “RAG em produção” mostra o conjunto de perguntas com resposta conhecida e como medir cada etapa. Com a prova pronta, abra “Qual ferramenta de memória serve para o agente da pousada” e leve as 20 perguntas para a entrevista com cada candidata.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoMCP para quem decidesugerido pelo grafo3 capítulos de “Segundo cérebro com IA” usam conceitos apresentados em “MCP para quem decide”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo2 capítulos de “Segundo cérebro com IA” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAgentes de IA autônomos: como delegar e acompanharsugerido pelo grafo2 capítulos de “Segundo cérebro com IA” usam conceitos apresentados em “Agentes de IA autônomos: como delegar e acompanhar”.
- Avaliar e melhorar agentesConferir a entrega antes de aceitar uma notaExaminar conexões de Conferir a entrega antes de aceitar uma nota
- Escrever bem com IACompare ferramentas com a mesma amostraExaminar conexões de Compare ferramentas com a mesma amostra
- Vídeo com IA: do roteiro à publicaçãoTeste Claude, ChatGPT, Gemini e Grok com o mesmo roteiroExaminar conexões de Teste Claude, ChatGPT, Gemini e Grok com o mesmo roteiro
- Modelo de trabalho com agentes de IAO que os testes mostram e o que deixam de fora?Examinar conexões de O que os testes mostram e o que deixam de fora?
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.