Avaliar e melhorar agentes · ·
Aprendizado por reforço: o que muda no treinamento
Aprendizado por reforço usa recompensas para orientar o treinamento. Diferencie atualização dos parâmetros do modelo e melhoria das instruções, ferramentas ou processos de um agente.
Este capítulo faz parte do curso gratuito Avaliar e melhorar agentes.
Aprendizado por reforço usa recompensas para orientar a aprendizagem de um sistema. No treinamento de um modelo de linguagem, um processo de otimização altera seus parâmetros, também chamados de pesos. No trabalho cotidiano com agentes, mudar uma instrução ou pedir outra tentativa normalmente muda a execução, sem atualizar esses pesos.
Ver como texto
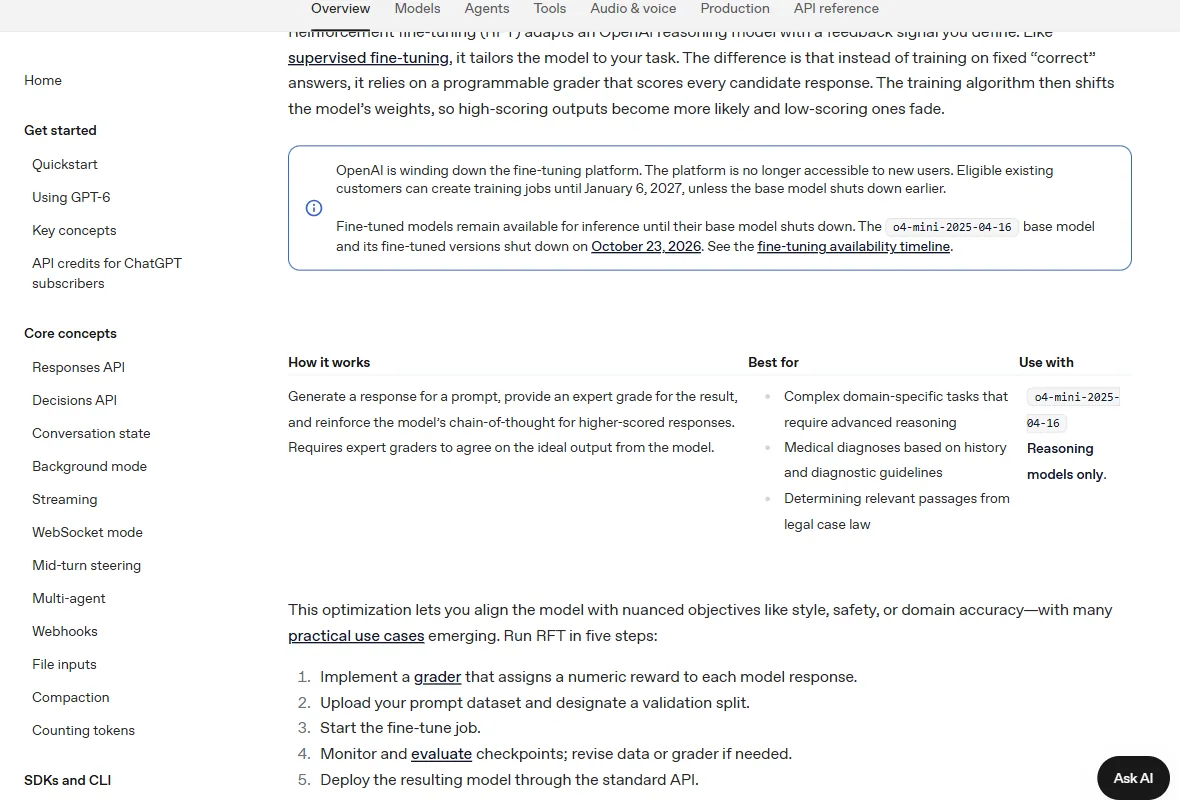
Guia de reinforcement fine-tuning da OpenAI com a descrição do processo e aviso sobre disponibilidade da plataforma.
Você decide aqui se a proposta que chegou à sua mesa é de treinar por consequência ou de instruir melhor, e passa a saber qual das duas o fornecedor está realmente vendendo.
A régua da comissão
Nenhum diretor comercial acredita que vai mudar o comportamento da força de vendas reescrevendo o manual. Ele muda a régua da comissão. Se o prêmio passa a considerar margem em vez de faturamento, o vendedor para de queimar preço sem que ninguém proíba desconto por escrito, e a mudança alcança situações que o manual jamais previu. A régua não descreve o caminho. Ela declara o que conta no fim, e o caminho aparece sozinho.
Onde a analogia para de valer: o vendedor lê a regra da comissão e reage a ela na hora, com intenção. O modelo só descobre a regra pela consequência repetida ao longo do treino, e não tem intenção nenhuma. Não adianta explicar a régua ao modelo depois, e não adianta pedir bom senso quando a régua ficar perversa. Quem revisa a régua é você, e o custo de revisar é um treino novo.
Essa diferença define o que a empresa está contratando. Um fornecedor pode melhorar o conjunto de ferramentas e verificações ao redor de um modelo ou treinar uma versão específica. Peça que identifique qual componente mudou, como a mudança foi registrada e como ela foi testada fora dos exemplos usados no ajuste.
Ver como texto
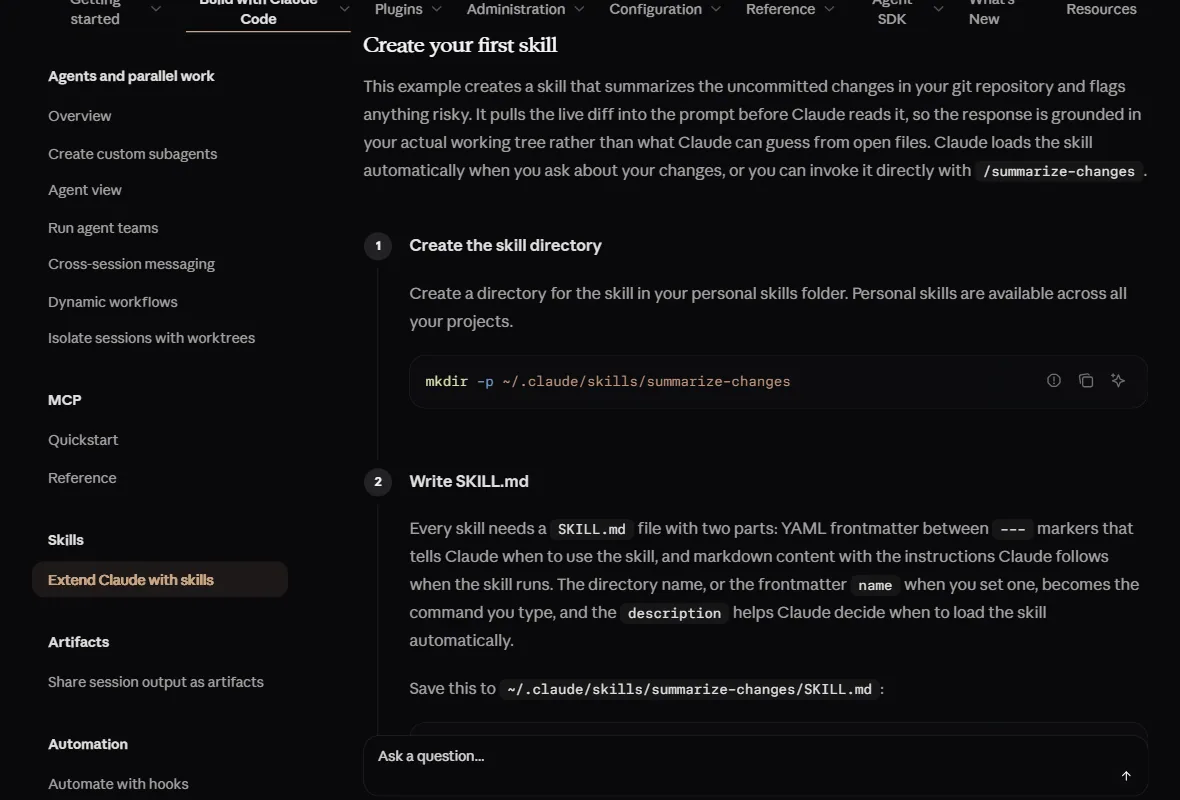
Documentação do Claude Code sobre criação e carregamento de skills, com instruções e opções de configuração.
Exemplo: um revisor passa a receber uma lista de termos proibidos e erra menos. Houve uma mudança de contexto. Se a equipe reúne exemplos e executa um treinamento que produz novos pesos, trata-se de outro processo. Ambos podem ajudar; cada um precisa de evidência e orçamento compatíveis com o que realmente aconteceu.
Ver como texto
Guia da OpenAI de boas práticas de avaliação de sistemas de IA, com etapas e critérios para comparar resultados.
Ver como texto
Uma volta do ciclo de trabalho do agente em quatro caixas, pedir, executar, premiar o resultado e ajustar o comportamento, com a instrução entrando na primeira caixa e a consequência entrando na terceira.
- Etapa 1 de 4: Pedir
Alguém descreve a tarefa. É aqui que mora a instrução, e é isto que quase toda proposta chama de melhoria.
- Etapa 2 de 4: Executar
O agente entrega a alteração. Nenhuma decisão de negócio acontece nesta caixa, e nenhum fornecedor cobra caro por ela.
- Etapa 3 de 4: Premiar o resultado
Algo mede o que a entrega produziu e diz quanto aquilo valeu. Quem define essa medida decide o comportamento que a empresa vai comprar.
- Etapa 4 de 4: Ajustar o comportamento
O comportamento padrão se desloca na direção do que foi premiado. Este passo custa dinheiro e tempo, e é ele que separa treino de configuração.
Ver como texto
- Pedir: Alguém descreve a tarefa. É aqui que mora a instrução, e é isto que quase toda proposta chama de melhoria.
- Executar: O agente entrega a alteração. Nenhuma decisão de negócio acontece nesta caixa, e nenhum fornecedor cobra caro por ela.
- Premiar o resultado: Algo mede o que a entrega produziu e diz quanto aquilo valeu. Quem define essa medida decide o comportamento que a empresa vai comprar.
- Ajustar o comportamento: O comportamento padrão se desloca na direção do que foi premiado. Este passo custa dinheiro e tempo, e é ele que separa treino de configuração.
A pergunta que separa as duas famílias cabe em uma linha. O que muda no fim do ciclo depois que a sua proposta for executada? Se a resposta descreve documento, pedido melhor escrito, guia de estilo ou base de conhecimento, a proposta mexe no começo. Se a resposta descreve uma medida aplicada ao resultado e um ajuste do comportamento padrão a partir dela, a proposta mexe no fim.
A diferença de ordem de grandeza entre as duas ajuda a farejar promessa vazia. A etapa final de treino de um modelo de fabricante que publica os pesos, anunciado em julho de 2026, consumiu mais de 30 milhões de execuções de treino. Quem promete treinar o comportamento do seu agente em duas semanas, com o time que você já tem e sem infraestrutura nova, está descrevendo instrução com nome novo e cobrando preço de treino.
Ver como texto
Comparação de escala entre uma execução, que é o que o usuário vê quando pede uma tarefa ao agente, e mais de 30 milhões de execuções de treino usadas na etapa final de treino de um modelo de fabricante que publica os pesos.
| Mudança | O que é alterado | Evidência necessária |
|---|---|---|
| Instrução e contexto | Pedido, referências e exemplos fornecidos | Comparação em tarefas separadas do ajuste |
| Ferramentas e controles | Acessos, verificações e fluxo de execução | Registro das ações e dos limites testados |
| Treinamento | Parâmetros do modelo | Procedimento de treino e avaliação independente |
Melhorar a avaliação não significa atualizar parâmetros. As opções podem ser combinadas, com escopo e custos explícitos.
Critério de veto: a proposta que não diz o que muda no fim do ciclo
- Pergunte o que muda no fim do ciclo depois que a proposta for executada. Se a resposta descreve documento, pedido ou base de conhecimento, a proposta é instrução, e o preço tem que ser de instrução.
- Pergunte quem mede o resultado de cada execução, e com o quê. Sem essa resposta não existe consequência, existe promessa com data.
- Pergunte quantas execuções de treino serão rodadas, onde e a que custo por execução. Ordem de grandeza baixa demais denuncia instrução com nome novo.
- Pergunte qual é a data de revisão da medida. Régua sem data de revisão envelhece dentro do contrato, e o envelhecimento aparece como queda inexplicada.
- Recuse a expressão treinar o modelo quando ela vier sem as quatro respostas acima. É a palavra mais cara de um orçamento de inteligência artificial.
O guia abaixo prepara uma avaliação e um ciclo de melhoria do processo. Ele não executa treinamento de pesos. Use-o para descobrir se a mudança proposta melhora a tarefa; uma etapa de treinamento exige dados, infraestrutura e autorização próprios.
Preparar um ciclo de avaliação e melhoria
Este roteiro avalia mudanças no processo. Treinamento de pesos é uma etapa separada.
Passo 1: Escolha uma tarefa pequena
Defina entrada, saída esperada e consequência da falha.
Deu certo quando: Outra pessoa consegue reconhecer uma entrega aceitável.
Erro comum: Começar com uma demanda ampla e critérios implícitos.
Passo 2: Defina os critérios
Inclua casos corretos, incorretos e limites conhecidos.
Deu certo quando: A regra identifica os erros incluídos no teste.
Erro comum: Mudar a regra apenas para aprovar a saída recebida.
Passo 3: Separe ajuste e avaliação
Guarde um conjunto que não será usado para mudar instruções ou treinar pesos.
Deu certo quando: A avaliação final permanece independente.
Erro comum: Usar o resultado do teste reservado como recompensa de treinamento.
Passo 4: Meça a linha de base
Registre qualidade, custo e tempo na configuração inicial.
Deu certo quando: Há um ponto de comparação reproduzível.
Erro comum: Comparar com a lembrança de como o processo funcionava.
Passo 5: Mude uma peça e compare
Declare se a alteração foi no pedido, ferramenta, controle ou treinamento.
Deu certo quando: O relatório mostra ganho, perda e casos inconclusivos.
Erro comum: Chamar toda melhora de aprendizado por reforço.
Passo 6: Decida o próximo passo
Revise os limites e a evidência antes de ampliar.
Deu certo quando: Um responsável registra continuar, ajustar ou encerrar.
Erro comum: Repetir o mesmo teste reservado até obter aprovação.
No fim você tem: Uma decisão sustentada por comparação documentada, sem confundir avaliação com treinamento.
Três perguntas para testar a decisão antes da próxima reunião: (1) Chega uma proposta de melhoria de agente com preço de projeto. Qual é a única pergunta que você faz antes de olhar o valor, e o que a resposta muda no preço que você aceita? (2) O seu time diz que vai treinar o agente com os dados da casa em duas semanas. Você aprova, pede detalhamento ou recusa, e com base em qual ordem de grandeza? (3) Uma proposta declara o que será medido no fim do ciclo, mas não diz quem faz a medição. Você segue ou para, e o que exige antes de seguir?
Escolha a mudança pelo problema observado. Instruções, ferramentas e treinamento têm custos e efeitos diferentes; todas as opções precisam de avaliação. O relatório deve nomear o que mudou e apresentar evidência antes e depois, sem chamar toda melhora de aprendizado por reforço.
Guia prático: o laço de recompensa aplicado à copy de anúncio. O mesmo raciocínio do treino por consequência funciona sem treinar modelo nenhum. Você gera variações de título e descrição, um juiz pontua cada uma com critérios escritos antes, e só a melhor nota volta para a próxima rodada como exemplo. É o ciclo de reforço em miniatura, rodado sobre o pedido ao modelo, e não sobre os pesos dele.
Coordenadora de mídia paga de um e-commerce de cosméticos
Varejo on-line
Dor
O time escrevia 15 títulos por grupo de anúncios na mão, e metade voltava reprovada por limite de caracteres ou por promessa que a política de anúncios veta.
Solução
Um laço de duas camadas: um portão em código que reprova título acima de 30 caracteres, descrição acima de 90 e termos proibidos, e uma rubrica pontuada por modelo para clareza da oferta, benefício concreto e chamada para ação.
Resultado do exemplo
As variações que chegam à revisão humana já passaram no formato, e a revisão passa a discutir argumento de venda, não contagem de letras.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Laço de avaliação e recompensa para títulos e descrições de anúncio
Sete passos. Os dois primeiros acontecem antes de abrir qualquer ferramenta, e são eles que decidem se o laço ensina o que você quer.
Passo 1: Separe 40 a 60 briefs reais de campanhas passadas
Cada linha leva produto, público, oferta e o resultado que a campanha teve. Guarde um quinto deles numa pasta que o gerador nunca lê.
Deu certo quando: Planilha com briefs de treino e briefs retidos, em arquivos separados.
Erro comum: Usar só as campanhas campeãs, o que ensina o juiz a premiar o estilo de um único produto.
Passo 2: Escreva o portão de formato em código
Título com até 30 caracteres e descrição com até 90, os limites do anúncio responsivo de pesquisa, mais a lista de termos que a sua política proíbe.
Deu certo quando: Uma função devolve 0 ou 1 e reprova, sozinha, a variação fora do formato.
Erro comum: Deixar o limite de caracteres para o juiz de linguagem, que conta letras mal.
Passo 3: Escreva a rubrica em três critérios, com exemplo de nota alta e de nota baixa
Clareza da oferta, benefício concreto e chamada para ação, cada um de 0 a 1. Exemplo ancorado reduz a variação do juiz entre rodadas.
Deu certo quando: Duas pessoas do time dão a mesma faixa de nota a dez variações de teste.
Erro comum: Critério vago como "persuasivo", que o juiz interpreta de um jeito em cada chamada.
Passo 4: Combine as notas com o formato multiplicando, e não somando
Nota final igual a formato vezes a média da rubrica. Variação fora do limite fica com zero, por mais bonita que seja.
Deu certo quando: Nenhuma variação reprovada no formato aparece entre as dez melhores.
Erro comum: Somar as notas, o que deixa um título com 34 caracteres vencer pelo texto.
Passo 5: Rode uma volta: gere, pontue, guarde as três melhores como exemplo
As melhores entram no pedido da rodada seguinte como referência. O juiz continua fora do alcance do gerador.
Deu certo quando: A nota média sobe da primeira para a segunda rodada nos briefs de treino.
Erro comum: Mostrar a rubrica ao gerador, que aprende a repetir as palavras que o juiz procura.
Passo 6: Confira nos briefs retidos e numa amostra lida por gente
Se a nota sobe no treino e fica parada nos retidos, o laço aprendeu um atalho. Leia 10% das variações aprovadas a cada rodada.
Deu certo quando: As duas curvas sobem juntas e a leitura humana concorda com o juiz na maior parte dos casos.
Erro comum: Celebrar a curva do treino sozinha.
Passo 7: Leve as campeãs ao teste real e compare com a taxa de cliques e de conversão
O juiz é uma previsão. Quem decide é o experimento na plataforma de anúncios, com metade do tráfego para a copy atual.
Deu certo quando: Relatório do experimento com a diferença de cliques e de conversões por variação.
Erro comum: Trocar toda a copy da conta de uma vez com base só na nota do juiz.
No fim você tem: Um laço que filtra o que está fora do formato, ordena o resto por critérios escritos e entrega ao teste real só o que merece tráfego.
A Anthropic relatou em 31/08/2026 que um modelo em treino aprendeu a burlar uma recompensa criada para premiar respostas sinceras "empilhando ressalvas" na resposta. O equivalente em marketing é o título que repete a palavra-chave e a chamada para ação só porque o juiz procura essas palavras. Por isso o passo cinco esconde a rubrica do gerador, e o passo seis lê amostras com olhos humanos.
Na próxima proposta, peça uma descrição do que será alterado: instrução, ferramenta, regra de avaliação ou parâmetros do modelo. Comece com uma tarefa pequena e um conjunto separado de avaliação. Só amplie depois de observar o resultado e os limites.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafoO Setup ensina permissões, contexto do projeto e escolha de modelo por custo. Essa preparação sustenta os exercícios de comparação de assistentes, criação do gerador de UTM e regras de projeto no curso de aprendizado por reforço e vibecoding.
- CursoAstra profundosugerido pelo grafo4 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Astra profundo”.
- CursoLetramento em IA para Executivossugerido pelo grafo5 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Letramento em IA para Executivos”.
- CursoVídeo com IA: do roteiro à publicaçãosugerido pelo grafo2 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Vídeo com IA: do roteiro à publicação”.
- RLM: grandes acervosQuando memória basta e quando treinarExaminar conexões de Quando memória basta e quando treinar
- Prompt Engineering para ExecutivosAs palavras que mudam a conta de IA e o que mudou desde 2024Examinar conexões de As palavras que mudam a conta de IA e o que mudou desde 2024
- Modelo de trabalho com agentes de IAComo coordenar agentes em paralelo sem perder o controle?Examinar conexões de Como coordenar agentes em paralelo sem perder o controle?
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.