Avaliar e melhorar agentes · ·
Conferir a entrega antes de aceitar uma nota
Escolha evidências que correspondam ao resultado esperado.
Este capítulo faz parte do curso gratuito Avaliar e melhorar agentes.
Uma nota resume uma avaliação, mas só faz sentido quando você conhece a pergunta que ela responde. Um texto convincente pode receber boa nota e ainda conter um número errado. Para código, uma explicação pode parecer correta enquanto a função falha ao executar.
Ver como texto
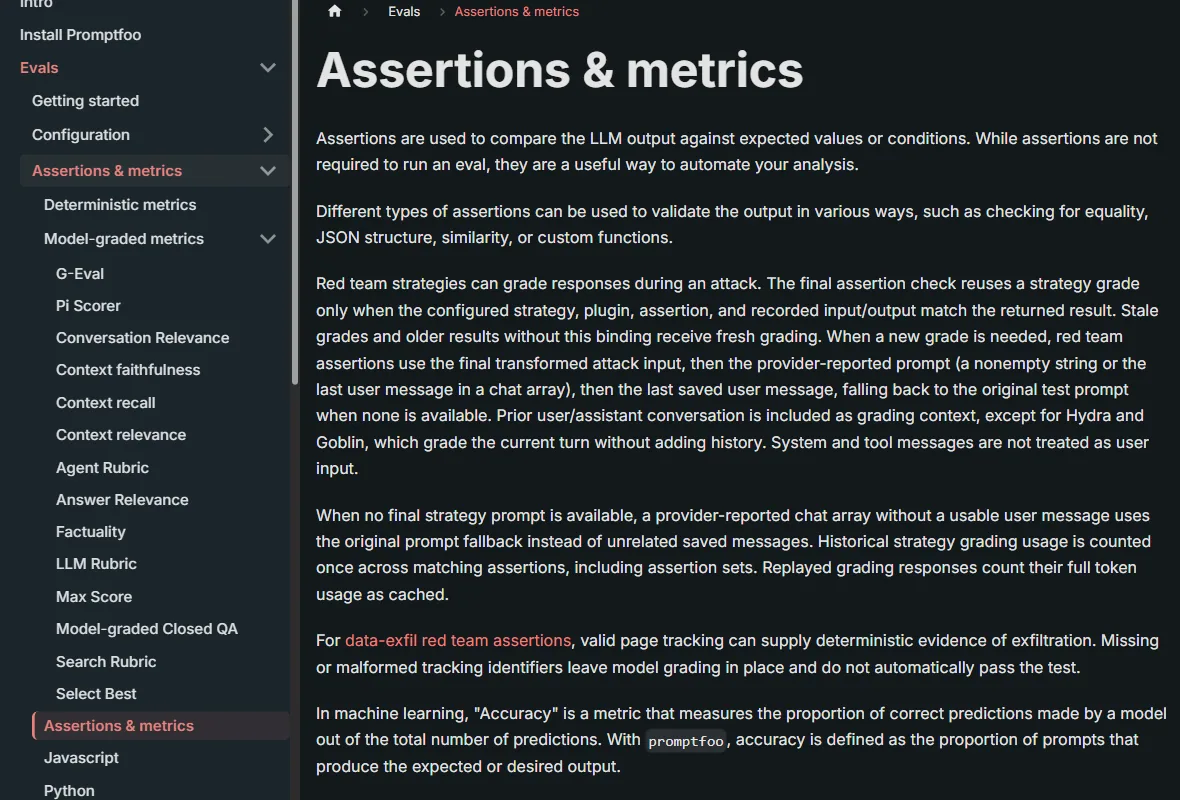
Documentação do Promptfoo mostrando verificações determinísticas e métricas avaliadas por modelos.
Você decide aqui o que perguntar quando um fornecedor mostrar um gráfico de melhoria: quem julgou aquele resultado, com o quê, e o que você faz se a resposta for evasiva. Por que isso toca receita e risco: o número que abre a proposta é o mesmo número que fecha o contrato e o mesmo que vai ao conselho no trimestre seguinte. Se ele veio de julgamento, ele muda de valor conforme quem julga, e ninguém consegue reconstruir a conta depois. A decisão que cabe a você: qual evidência a sua empresa passa a aceitar como prova de que um agente melhorou. O que dá para delegar: rodar a medição e montar o dossiê. O que não dá: dizer o que conta como prova suficiente antes de o dinheiro sair.
A prova com a questão que ninguém viu antes
Todo mundo conhece o candidato que estuda pelas provas dos anos anteriores. Ele decora o padrão, reconhece o enunciado no dia e vai bem. A banca que quer saber quem de fato aprendeu troca as questões e observa o que acontece com as notas. A queda que aparece nesse dia diz menos sobre a turma e mais sobre o que a nota anterior estava medindo, que era a prova, e não o aluno.
Onde a analogia para de valer: o candidato humano que decora a prova antiga ao menos aprendeu algo transferível no caminho. O agente pode aprender a assinatura do teste sem aprender nada do problema, e a queda só aparece quando o teste muda.
Use verificações diretas quando o requisito permitir: formato, cálculo ou comportamento observável. Para aspectos que exigem julgamento, como clareza, descreva a rubrica, isto é, os critérios usados para atribuir a nota. Avaliadores humanos e modelos também podem discordar; registre como essa discordância será resolvida.
Ver como texto
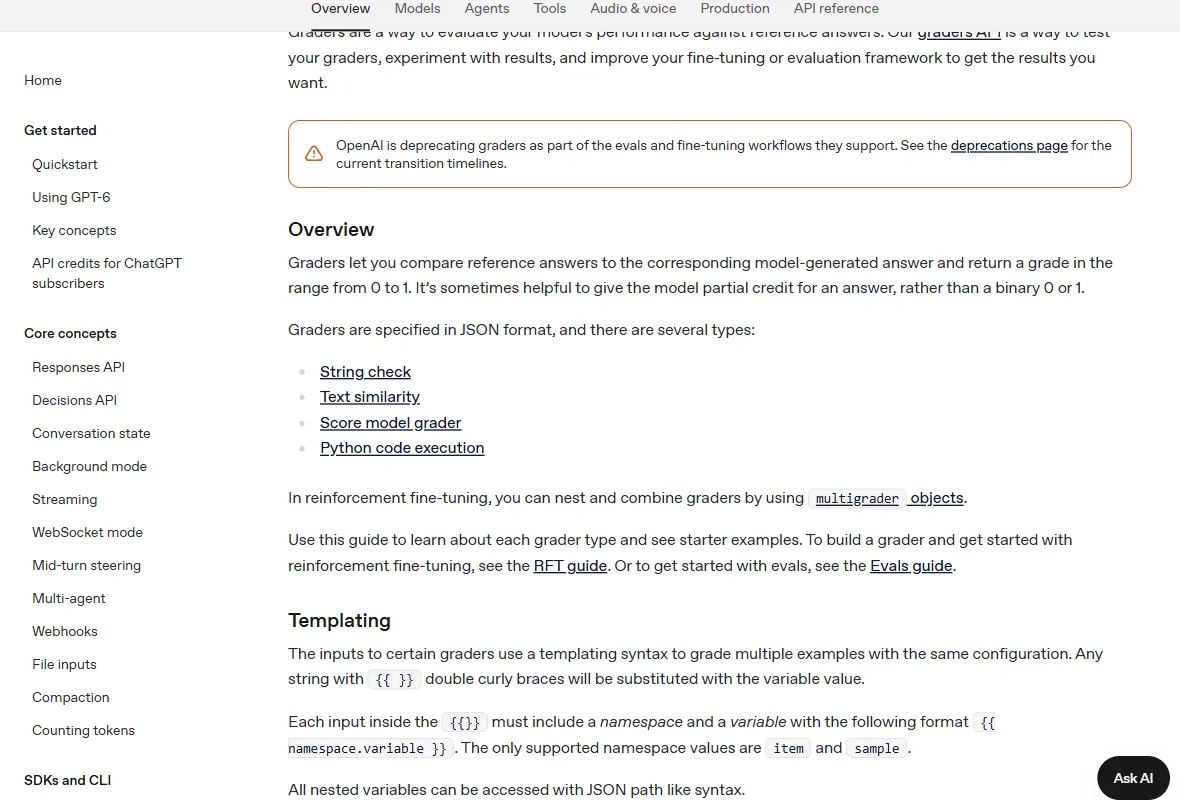
Documentação da OpenAI sobre graders, os avaliadores usados para atribuir notas às respostas.
Exemplo: o agente cria um desconto de dez por cento em um produto de R$ 200. O resultado esperado é R$ 180. A aprovação combina essa conta com casos de preço vazio e desconto inválido. A frase “o cálculo está correto” escrita pelo próprio agente não substitui executar esses exemplos.
Ver como texto
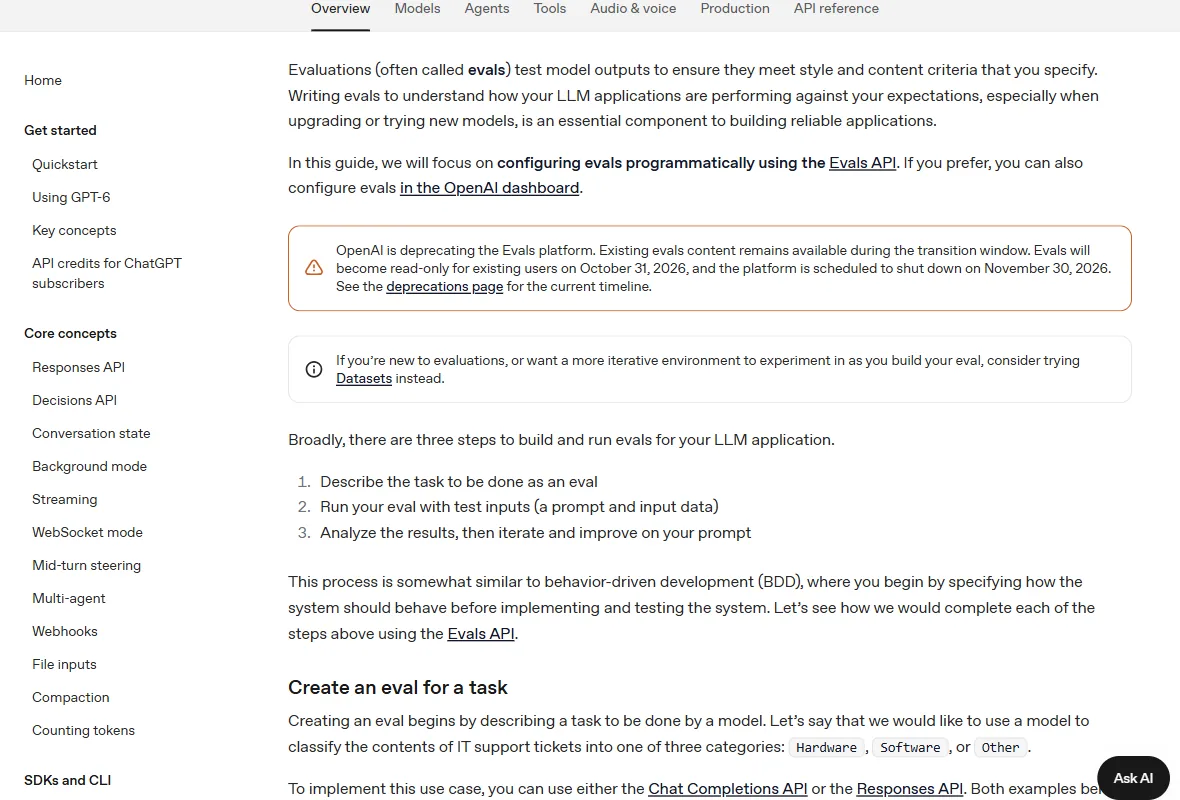
Documentação da OpenAI sobre configuração e execução de avaliações, com exemplos de tarefas e resultados.
As duas famílias de juiz, e o que cada uma consegue sustentar
Juiz por nota: alguém, ou outro modelo, atribui pontuação
O que você recusa como prova
- A pontuação existe e ninguém consegue refazer a conta a partir de evidência
- Dois avaliadores diante do mesmo material chegam a números diferentes
- O número sobe quando quem avalia trabalha para quem entrega
- Cobre gosto, estilo e intenção, que é justamente a parte impossível de executar
- Repetir a medição daqui a três meses exige o mesmo avaliador, com o mesmo humor
Juiz por execução: o trabalho roda e o resultado fica registrado
O que você aceita como prova
- Passou ou não passou, com registro que outra pessoa abre sozinha
- Repetir a medição no seu ambiente devolve o mesmo resultado
- Funciona sem a opinião de ninguém, inclusive sem a sua
- Cobre exatamente o que foi escrito, então o que ficou de fora precisa estar declarado
- Serve de anexo contratual, porque tem data, ambiente e resultado observado
Ver como texto
Todo número de melhoria de agente atravessa quatro pontos antes de virar gráfico: quem rodou a medição, em que ambiente, contra qual teste e quem julgou o resultado. Em cada um deles o número muda sem que o modelo mude.
| Condição | O que manter equivalente |
|---|---|
| Trabalho | Mesmos casos e critérios de aceitação |
| Acesso | Mesmas informações e ferramentas permitidas |
| Orçamento | Tempo, tentativas e gasto documentados |
| Conferência | Mesmo procedimento e responsável independente |
Diferenças precisam ser declaradas antes de interpretar uma vantagem.
Dois fornecedores podem estar rodando exatamente o mesmo modelo por baixo e chegar a números diferentes, sem que nenhum dos dois esteja mentindo. O que muda entre eles é o sistema que executa o modelo: quanto contexto ele carrega, quantas tentativas ele faz, quais ferramentas pode chamar e o que consegue consultar durante a execução. Comparar dois números medidos em arranjos diferentes compara os arranjos. Quando você pedir comparação, exija o arranjo fixado por escrito antes da medição, e exija que os dois fornecedores rodem no mesmo.
Placares públicos ajudam a conhecer capacidades, mas cada número depende do ambiente e do procedimento de medição. Compare somente resultados com tarefa, acesso a ferramentas, orçamento de execução e critério de sucesso compatíveis. Para comprar, acrescente uma avaliação com exemplos representativos da sua operação.
| Modelo | Número | Quem mediu | Como ler |
|---|---|---|---|
| Claude Opus 5.5 | 66,4% | Anthropic, lançamento de 22/09/2026 | Execução do próprio fabricante, fora do ranking público |
| GPT-6 Astra | 58,2% | Placar público agregado, 25/09/2026 | Primeiro lugar entre as execuções ranqueadas |
| Claude Fable 5.1 | 57,9% | Placar público agregado, 25/09/2026 | Empate técnico com o primeiro colocado |
| Grok 4.7 | 37,6% | Placar público agregado, 25/09/2026 | Sexto lugar; o fabricante divulgou 38,0% |
Compare só dentro da mesma coluna de medição. Misturar a linha do fabricante com as do placar público compara arranjos em vez de modelos.
Fonte: Anthropic (22/09/2026) e CodingFleet, placar do Terminal-Bench 4.0 (25/09/2026)
As duas perguntas que abrem qualquer reunião de resultado
Preencha com o número que chegou à sua mesa esta semana e envie antes da próxima reunião. O objetivo é obter as duas respostas por escrito, com anexo, e não convencer ninguém de nada.
Documento montado
PEDIDO DE PROCEDÊNCIA DE RESULTADO

Fornecedor ............ [FORNECEDOR E PRODUTO]
Número apresentado .... [O NÚMERO APRESENTADO, COM A PALAVRA USADA NO SLIDE]
Apresentado em ........ [DATA E CONTEXTO DA APRESENTAÇÃO]

Antes de este número entrar em qualquer decisão de contrato, preciso de duas
respostas por escrito, com o artefato anexado.

1. QUEM JULGOU ESTE RESULTADO, E COM O QUE?
   Se foi uma pessoa ou outro modelo atribuindo pontuação, quero o critério
   escrito e a amostra avaliada. Se foi execução, quero o registro de execução,
   com data e ambiente.

2. QUEM RODOU A MEDIÇÃO, EM QUE AMBIENTE E CONTRA QUAL TESTE?
   Quero saber se o ambiente tinha acesso a internet e a histórico do projeto,
   e se o conjunto de tarefas já era conhecido pela ferramenta antes da medição.

CONDIÇÃO DE ACEITE
Sem as duas respostas com anexo em cinco dias úteis, o número entra na pauta
com a etiqueta de estimativa do fornecedor e perde o status de resultado
medido. A comparação com qualquer concorrente fica suspensa até que os dois
tenham rodado no mesmo arranjo.
O que você digitar fica salvo neste navegador. Nada é enviado para servidor algum.
Três perguntas para testar a decisão antes da próxima reunião: (1) O gráfico do fornecedor sobe e a única fonte da medição é o próprio fornecedor. Qual é a sua primeira pergunta, e o que você faz se a resposta demorar mais de cinco dias úteis? (2) Seu time propõe comparar duas ferramentas usando o número que cada fabricante publica no próprio site. Você aprova, aprova com condição ou recusa, e qual é a condição? (3) Um número de melhoria chega sem dizer quem julgou o resultado. Em que ponto da sua agenda de decisão ele ainda pode entrar, e a partir de que ponto ele fica de fora?
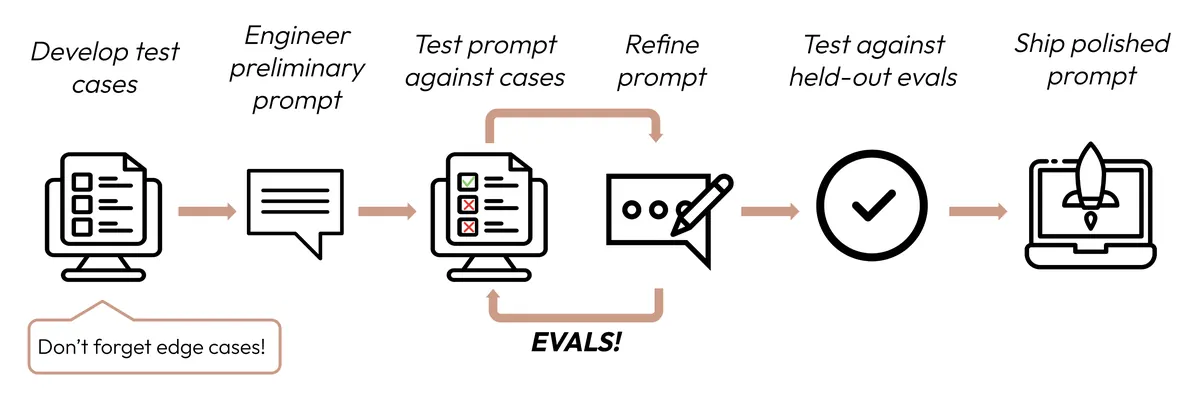
Guia prático: teste A/B de prompts com métrica, antes de gastar verba. A prova executada desta aula vale também para o pedido que gera anúncio, e-mail ou página. Dois prompts disputam os mesmos briefs, com o mesmo modelo e a mesma temperatura, e só o prompt muda. A documentação da Anthropic resume o ciclo numa figura: casos de teste primeiro, prompt depois, rodadas de correção e uma prova final com casos guardados.
Ver como texto
Fluxograma em seis etapas: desenvolver casos de teste, escrever o prompt inicial, testar contra os casos, refinar o prompt em ciclo de avaliações, testar contra avaliações retidas e publicar o prompt final
Teste A/B de dois prompts de anúncio, do brief ao veredito
Seis passos com uma ferramenta de código aberto, o Promptfoo, que a própria OpenAI indicou como destino de quem usava o Evals.
Passo 1: Monte um arquivo briefs.csv com 40 a 60 linhas
Colunas produto, público e oferta. Inclua casos difíceis: oferta sem desconto, produto de nome longo, público regulado.
Deu certo quando: Arquivo aberto sem erro numa planilha e revisado por quem conhece a conta.
Erro comum: Testar só com os três produtos mais vendidos.
Passo 2: Escreva os dois prompts em arquivos separados e mude uma coisa só
O prompt A pede benefício; o B pede prova social. Se mudar tom e tamanho ao mesmo tempo, o resultado não diz qual mudança pesou.
Deu certo quando: Diferença entre os arquivos cabe em uma ou duas frases.
Erro comum: Comparar o prompt novo com o antigo escrito às pressas.
Passo 3: Declare as métricas no arquivo de configuração
Uma regra em JavaScript para o limite de caracteres e uma rubrica llm-rubric com nota mínima de 0,7, com o modelo juiz fixado em temperatura zero.
Deu certo quando: O comando de validação do Promptfoo aprova o arquivo sem aviso.
Erro comum: Juiz igual ao modelo gerador, que tende a gostar do próprio texto.
Passo 4: Rode cada prompt duas vezes antes de comparar
A diferença entre duas rodadas do mesmo prompt mostra o ruído da medição.
Deu certo quando: Você sabe quantos pontos de taxa de aprovação a medição oscila sozinha.
Erro comum: Declarar vencedor por uma diferença menor que o próprio ruído.
Passo 5: Compare taxa de aprovação, nota média e custo por resposta
A tela de resultado põe as saídas lado a lado, com passou ou falhou por caso e o custo total de cada prompt.
Deu certo quando: Planilha com as três colunas por prompt e os casos em que os dois discordam.
Erro comum: Olhar só a nota média e ignorar o caso que reprovou nos dois.
Passo 6: Leve o vencedor ao experimento real com metade do tráfego
O teste fora do ar escolhe o candidato; o experimento na plataforma de anúncios decide pela taxa de cliques e pela conversão.
Deu certo quando: Experimento ativo com data de leitura marcada e métrica de decisão escrita antes de começar.
Erro comum: Encerrar o experimento no terceiro dia porque um lado saiu na frente.
No fim você tem: Um prompt escolhido por números medidos nos seus briefs, com o ruído conhecido e o veredito final dado pelo tráfego real.
# promptfooconfig.yaml - teste A/B de dois prompts de anúncio
description: "Títulos de pesquisa, prompt A (benefício) contra prompt B (prova social)"
prompts:
  - id: file://prompts/a_beneficio.txt
    label: A
  - id: file://prompts/b_prova_social.txt
    label: B
providers:
  - id: anthropic:messages:MODELO_GERADOR   # o mesmo modelo para A e B
    config:
      temperature: 0.7
defaultTest:
  options:
    provider:
      id: openai:MODELO_JUIZ               # juiz diferente do gerador
      config:
        temperature: 0
  assert:
    - type: javascript
      value: "output.split('\n')[0].length <= 30"
      metric: formato
    - type: llm-rubric
      value: "Título claro sobre a oferta do brief, com benefício concreto e chamada para ação. Repetir palavra-chave não conta."
      threshold: 0.7
      metric: persuasao
tests: file://briefs.csv

# Rodar:  npx promptfoo@latest eval -c promptfooconfig.yaml --no-cache
# Ver:    npx promptfoo@latest view
Pegue o último gráfico de melhoria que um fornecedor lhe mostrou e escreva ao lado quem mediu, com qual arranjo e em qual data. Qualquer campo em branco vira pergunta por escrito ao fornecedor. Sem resposta em cinco dias úteis, o número sai da apresentação ao comitê.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafoO Setup ensina permissões, contexto do projeto e escolha de modelo por custo. Essa preparação sustenta os exercícios de comparação de assistentes, criação do gerador de UTM e regras de projeto no curso de aprendizado por reforço e vibecoding.
- CursoAstra profundosugerido pelo grafo4 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Astra profundo”.
- CursoLetramento em IA para Executivossugerido pelo grafo5 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Letramento em IA para Executivos”.
- CursoVídeo com IA: do roteiro à publicaçãosugerido pelo grafo2 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Vídeo com IA: do roteiro à publicação”.
- Agentes de IA autônomos: como delegar e acompanharTestes e avaliação: que evidências permitem aprovar um pilotoExaminar conexões de Testes e avaliação: que evidências permitem aprovar um piloto
- Prompt Engineering para ExecutivosTestar a IA com 20 a 50 casos reais antes de liberarExaminar conexões de Testar a IA com 20 a 50 casos reais antes de liberar
- RLM: grandes acervosO que muda quando um agente melhoraExaminar conexões de O que muda quando um agente melhora
- Custos de IA e orçamentoBenchmarks: comparar testes de modelos com justiçaExaminar conexões de Benchmarks: comparar testes de modelos com justiça
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.