Vídeo com IA: Claude Code, Codex e ElevenLabs · Capítulo 21 de 25 · 26 min
Chamar Veo, Kling, Seedance e Runway por API com polling e custo controlado
Chame Veo na Agent Platform, Kling na fal, Seedance na Replicate e Runway num só script que consulta a tarefa, baixa o vídeo, mede com ffprobe e anota o custo.
Este capítulo faz parte do curso gratuito Vídeo com IA: Claude Code, Codex e ElevenLabs.
Toda API de vídeo é assíncrona: você envia o pedido, recebe um id de tarefa e volta a perguntar se terminou. Uma geração leva minutos, e quem trata isso como uma chamada HTTP comum espera 60 s, leva timeout, perde o id e manda gerar de novo. A cena sai paga duas vezes, e a segunda cópia aparece na fatura sem nunca chegar à sua pasta.
Nesta aula você escreve um script que fala com seis superfícies com o mesmo ciclo (enviar, gravar o id, consultar, baixar, conferir e anotar o custo): o Gemini Omni 1.1 Flash no Gemini API, o Veo 3.1 na Gemini Enterprise Agent Platform do Google Cloud (o antigo Vertex AI), a Runway, o Kling na fal, o Seedance 2.5 na Replicate e o MiniMax H3 como reserva barata. O nome do modelo e o preço continuam no modelos.toml da aula 19; o prompt vem de storyboard/prompts/, gerado na aula 20.
Entender o ciclo assíncrono de cada API
Polling é olhar o painel do aeroporto de tempos em tempos até o voo aparecer como aterrissado; webhook é o aeroporto mandar mensagem quando isso acontecer. O padrão do curso é polling com intervalo fixo de 10 s e tempo máximo de 15 min por rodada, porque funciona em qualquer fornecedor e não exige um servidor seu exposto na internet. O resultado chega como uma URL temporária, que expira: o script baixa o arquivo na mesma hora em que a tarefa termina.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Como cada API recebe o pedido e avisa que terminou
| Superfície | Enviar e consultar | Sinal de pronto |
|---|---|---|
| Gemini Omni 1.1 Flash no Gemini API | interactions.create com response_format de vídeo e entrega por URI; files.get com o id lido em output_video.uri | arquivo em ACTIVE no recurso Files (FAILED encerra); consulta sugerida a cada 5 s |
| Veo 3.1 Fast na Agent Platform | generate_videos devolve uma operation; operations.get com o nome dela | operation.done verdadeiro; sem bucket de saída, o vídeo vem nos bytes da resposta |
| Runway (gen4.5, seedance2_5) | POST /v1/image_to_video ou /v1/text_to_video; GET /v1/tasks/{id} | status SUCCEEDED e a URL em output[0] |
| Kling 3.0 Pro na fal | POST na fila queue.fal.run; GET em status_url | status COMPLETED; um GET em response_url devolve o JSON do resultado, com o vídeo em video.url |
| Seedance 2.5 na Replicate | POST /v1/models/bytedance/seedance-2.5/predictions; GET /v1/predictions/{id} | status succeeded e a URL em output |
| MiniMax H3 Max | POST /v2/video_generation; GET /v2/query/video_generation/{task_id} | task.status succeeded e a URL em task.content.url; failed ou cancelled encerram |
Cabeçalho da Runway: X-Runway-Version 2024-11-06. Ids de prévia do Veo no Gemini API saem em 22/10/2026; o script usa o id GA da Agent Platform.
Dois detalhes evitam a maior parte das falhas. Grave no estado tudo o que a consulta precisa (na Agent Platform, o nome da operation; na fal, as URLs de status e de resultado), porque é isso que permite consultar de novo depois de um Ctrl+C. E consulte o esquema do modelo antes de enviar: o script lê da Replicate a lista de campos que o Seedance 2.5 aceita e manda só esses, avisando quais ficaram de fora; na fal, o mesmo papel é do get_model_schema do MCP.
Chamar as seis APIs pelo mesmo script
O script tem uma função de envio e uma de consulta por fornecedor e um laço único de polling. Fila, estado em estado/jobs.json e a regra de nunca reenviar são o desenho idempotente da aula 23; aqui eles aparecem aplicados à consulta. O recuo em 429 e 5xx (esperar 5, 10, 20 e 40 s) vale para cada consulta, e 401 ou 403 encerram na hora, como a aula 3 ensina a ler. O desenho de limite de requisições do outro lado está em rate limiting e throttling.
O mesmo script em três linguagens
Python
Versão de referência, em Python 3.12 com google-genai e requests. O SDK ainda liga a Agent Platform pelo parâmetro vertexai=True, e por isso a chave do provedor no script continua vertex. Rode primeiro com --dry-run: ele lista cada cena com o custo estimado e não envia nada.
"""gerar_video.py: fila idempotente de geração de vídeo com polling, recuo, download,
verificação com ffprobe e registro de custo.

Lê storyboard/prompts/*.json e *.txt (aula 20) e config/modelos.toml (aula 19).
Grava estado/jobs.json (estado), midia/gerados/clips/<id>.mp4 e custos/custos.csv.
Provedores: gemini (Omni 1.1 Flash no Gemini API, consulta a cada 5 s), vertex (Veo 3.1 GA na Agent Platform,
o antigo Vertex AI), runway (gen4.5, imagem para vídeo), fal (Kling 3.0 Pro), replicate (Seedance 2.5)
e minimax (H3 Max, reserva barata).

Uso:  python scripts/gerar_video.py --dry-run      (mostra custo e ordem, não gasta)
      python scripts/gerar_video.py [--so c01,c03]
Pré-requisitos: Python 3.12, ffprobe no PATH,
      pip install google-genai requests
Variáveis no .env: GEMINI_API_KEY, GOOGLE_CLOUD_PROJECT, GOOGLE_CLOUD_LOCATION, RUNWAYML_API_SECRET, FAL_KEY,
      REPLICATE_API_TOKEN, MINIMAX_API_KEY, ASSETS_BASE_URL, TETO_VIDEO_USD
"""
import argparse
import base64
import csv
import datetime as dt
import json
import mimetypes
import os
import random
import subprocess
import sys
import time
import tomllib

import requests

ARQ_JOBS, DIR_CLIPS, ARQ_CUSTOS = "estado/jobs.json", "midia/gerados/clips", "custos/custos.csv"
INTERVALO_S, TEMPO_MAX_S = 10, 15 * 60          # consulta a cada 10 s; desiste da rodada em 15 min
INTERVALO_POR_PROVEDOR = {"gemini": 5}           # a doc do Omni sugere 5 s no recurso Files
TETO = float(os.environ.get("TETO_VIDEO_USD", "5"))

ap = argparse.ArgumentParser()
ap.add_argument("--dry-run", action="store_true")
ap.add_argument("--so", default="", help="ids separados por vírgula")
args = ap.parse_args()
for pasta in (DIR_CLIPS, "estado", "custos"):           # clipes, jobs.json e custos.csv
    os.makedirs(pasta, exist_ok=True)
with open("config/modelos.toml", "rb") as f:
    MODELOS = tomllib.load(f)


def agora() -> str:
    return dt.datetime.now(dt.timezone.utc).isoformat(timespec="seconds").replace("+00:00", "Z")


def ler_jobs() -> dict:
    if os.path.exists(ARQ_JOBS):
        with open(ARQ_JOBS, encoding="utf-8") as f:
            return json.load(f)
    return {"retrato_precos": MODELOS["retrato"], "teto_usd": TETO, "gasto_usd": 0.0, "cenas": {}}


def salvar_jobs(j: dict) -> None:
    tmp = ARQ_JOBS + ".tmp"                      # grava em arquivo temporário e troca: nunca fica pela metade
    with open(tmp, "w", encoding="utf-8") as f:
        json.dump(j, f, ensure_ascii=False, indent=2)
    os.replace(tmp, ARQ_JOBS)


def http(metodo: str, url: str, tentativas: int = 5, **kw) -> requests.Response:
    """Chamada HTTP com recuo exponencial em 429 e 5xx (5, 10, 20, 40 s, com folga aleatória).
    401 e 403 param na hora: chave errada não se resolve repetindo."""
    espera, limite = 5, kw.pop("timeout", 60)
    for i in range(tentativas):
        r = requests.request(metodo, url, timeout=limite, **kw)
        if r.status_code in (401, 403):
            sys.exit(f"HTTP {r.status_code} em {url}: chave ou permissão errada. Confira o .env.")
        if r.status_code == 429 or r.status_code >= 500:
            pausa = espera + random.uniform(0, 1)
            print(f"  HTTP {r.status_code}, esperando {pausa:.0f} s (tentativa {i + 1}/{tentativas})")
            time.sleep(pausa)
            espera *= 2
            continue
        r.raise_for_status()
        return r
    raise RuntimeError(f"{url}: esgotadas as {tentativas} tentativas")


def baixar(url: str, destino: str) -> None:
    """A URL de saída é temporária: baixe na hora, em blocos, para um .part e renomeie."""
    with requests.get(url, stream=True, timeout=300) as r:
        r.raise_for_status()
        with open(destino + ".part", "wb") as f:
            for bloco in r.iter_content(1 << 20):
                f.write(bloco)
    os.replace(destino + ".part", destino)


def data_uri(caminho: str) -> str:
    tipo = mimetypes.guess_type(caminho)[0] or "image/png"
    with open(caminho, "rb") as f:
        return f"data:{tipo};base64,{base64.b64encode(f.read()).decode()}"


def url_publica(caminho: str) -> str:
    return caminho if caminho.startswith("http") else os.environ["ASSETS_BASE_URL"].rstrip("/") + "/" + caminho


# ---------- Veo 3.1 Fast na Agent Platform (id GA; o preview do Gemini API sai em 22/10/2026) ----------
def _vertex():
    from google import genai
    return genai.Client(vertexai=True, project=os.environ["GOOGLE_CLOUD_PROJECT"],
                        location=os.environ.get("GOOGLE_CLOUD_LOCATION", "us-central1"))


def vertex_enviar(meta: dict, prompt: str) -> dict:
    from google.genai import types
    op = _vertex().models.generate_videos(
        model=meta["modelo"], prompt=prompt,
        config=types.GenerateVideosConfig(
            aspect_ratio=meta["proporcao"], resolution=meta["resolucao"],   # 1080p e 4K exigem 8 s
            duration_seconds=meta["duracao_s"], generate_audio=True,
            negative_prompt=meta["negative_prompt"] or None))
    return {"task_id": op.name}


def vertex_consultar(job: dict, destino: str):
    from google.genai import types
    client = _vertex()
    op = client.operations.get(types.GenerateVideosOperation(name=job["task_id"]))  # reabre pelo nome
    if not op.done:
        return "andando", None
    if op.error:
        return "falhou", str(op.error)
    if not op.response or not op.response.generated_videos:
        return "falhou", "operação sem vídeo na resposta (filtro de conteúdo?)"
    v = op.response.generated_videos[0].video
    if v.video_bytes:
        v.save(destino)                   # sem bucket de saída, o vídeo volta nos bytes da resposta
    elif v.uri and v.uri.startswith("http"):
        baixar(v.uri, destino)
    else:
        return "falhou", f"saída sem bytes nem URL https: {v.uri}"
    return "pronto", destino


# ---------- Gemini Omni 1.1 Flash no Gemini API (entrega por URI e consulta no recurso Files) ----------
def _gemini():
    from google import genai
    return genai.Client(api_key=os.environ["GEMINI_API_KEY"])


def gemini_enviar(meta: dict, prompt: str) -> dict:
    # sem negative_prompt, system instructions, temperature, top_p nem stop: os negativos já vêm
    # no corpo (linha Avoid) e a duração vai pedida no texto da camada CAMERA.
    # campos e chamadas conferidos na doc do Omni em 12/10/2026 (response_format, files.get, files.download)
    client = _gemini()
    partes = []
    # mesma ordem que a aula 20 numera: quadro inicial, quadro final, imagens de referência, vídeos
    imagens = [meta.get("primeiro_quadro"), meta.get("ultimo_quadro")]
    imagens += [r for r in meta.get("referencias", []) if not r.endswith(".mp4")]
    for caminho in filter(None, imagens):
        with open(caminho, "rb") as f:
            partes.append({"type": "image", "data": base64.b64encode(f.read()).decode(),
                           "mime_type": mimetypes.guess_type(caminho)[0] or "image/png"})
    for caminho in [r for r in meta.get("referencias", []) if r.endswith(".mp4")][:3]:
        partes.append({"type": "video", "uri": client.files.upload(file=caminho).uri})
    partes.append({"type": "text", "text": prompt})
    it = client.interactions.create(
        model=meta["modelo"], input=partes,
        response_format={"type": "video", "delivery": "uri",
                         "aspect_ratio": meta["proporcao"], "resolution": meta["resolucao"]})
    return {"task_id": it.output_video.uri}       # URI de um arquivo no recurso Files, não uma operation


def gemini_consultar(job: dict, destino: str):
    client = _gemini()
    nome = "files/" + job["task_id"].split("/files/")[-1].split(":")[0]   # a doc consulta por files/<id>
    arq = client.files.get(name=nome)
    estado = getattr(arq.state, "name", str(arq.state))   # PROCESSING, ACTIVE ou FAILED
    if estado == "FAILED":
        return "falhou", str(getattr(arq, "error", None) or "arquivo em FAILED")[:300]
    if estado != "ACTIVE":
        return "andando", None
    client.files.download(file=job["task_id"], destination=destino + ".part")
    os.replace(destino + ".part", destino)
    return "pronto", destino


# ---------- Runway gen4.5, imagem para vídeo (REST) ----------
RUNWAY = "https://api.dev.runwayml.com/v1"


def _h_runway() -> dict:
    return {"Authorization": f"Bearer {os.environ['RUNWAYML_API_SECRET']}",
            "X-Runway-Version": "2024-11-06", "Content-Type": "application/json"}


def runway_enviar(meta: dict, prompt: str) -> dict:
    if not meta["referencias"]:
        sys.exit(f"{meta['id']}: gen4.5 aqui é imagem para vídeo; informe uma referência")
    corpo = {"model": meta["modelo"], "promptImage": url_publica(meta["referencias"][0]),
             "promptText": prompt[:1000],
             "ratio": "720:1280" if meta["proporcao"] == "9:16" else "1280:720",
             "duration": meta["duracao_s"]}
    r = http("POST", f"{RUNWAY}/image_to_video", headers=_h_runway(), json=corpo)
    return {"task_id": r.json()["id"]}


def runway_consultar(job: dict, destino: str):
    d = http("GET", f"{RUNWAY}/tasks/{job['task_id']}", headers=_h_runway()).json()
    if d["status"] == "SUCCEEDED":
        baixar(d["output"][0], destino)
        return "pronto", destino
    if d["status"] in ("FAILED", "CANCELLED"):
        return "falhou", json.dumps(d)[:300]
    return "andando", None


# ---------- Kling 3.0 Pro pela fila da fal (REST) ----------
def _h_fal() -> dict:
    return {"Authorization": f"Key {os.environ['FAL_KEY']}", "Content-Type": "application/json"}


def fal_enviar(meta: dict, prompt: str) -> dict:
    # nomes dos campos: confira com get_model_schema no MCP da fal antes da primeira rodada
    corpo = {"prompt": prompt, "duration": str(meta["duracao_s"]),
             "aspect_ratio": meta["proporcao"], "generate_audio": True}
    d = http("POST", f"https://queue.fal.run/{meta['modelo']}", headers=_h_fal(), json=corpo).json()
    # a fila devolve as URLs de status e de resultado: guarde as duas no job
    return {"task_id": d["request_id"], "status_url": d["status_url"], "response_url": d["response_url"]}


def fal_consultar(job: dict, destino: str):
    st = http("GET", job["status_url"], headers=_h_fal()).json()["status"]
    if st != "COMPLETED":                                  # IN_QUEUE ou IN_PROGRESS
        return "andando", None
    try:                                                   # response_url é JSON, não o arquivo
        d = http("GET", job["response_url"], headers=_h_fal()).json()
    except requests.HTTPError as e:                        # falha do modelo volta como erro HTTP
        return "falhou", str(e)[:300]
    url = (d.get("video") or {}).get("url")
    if not url:
        return "falhou", json.dumps(d)[:300]
    baixar(url, destino)
    return "pronto", destino


# ---------- Seedance 2.5 na Replicate (REST) ----------
REPLICATE = "https://api.replicate.com/v1"


def _h_rep() -> dict:
    return {"Authorization": f"Bearer {os.environ['REPLICATE_API_TOKEN']}", "Content-Type": "application/json"}


def replicate_enviar(meta: dict, prompt: str) -> dict:
    desejado = {"prompt": prompt, "duration": meta["duracao_s"], "resolution": meta["resolucao"],
                "aspect_ratio": meta["proporcao"]}
    if meta.get("primeiro_quadro"):
        desejado["image"] = data_uri(meta["primeiro_quadro"])
    if meta.get("ultimo_quadro"):
        desejado["last_frame_image"] = data_uri(meta["ultimo_quadro"])
    # lê o esquema publicado do modelo e envia só os campos que ele aceita
    modelo = http("GET", f"{REPLICATE}/models/{meta['modelo']}", headers=_h_rep()).json()
    aceitos = modelo["latest_version"]["openapi_schema"]["components"]["schemas"]["Input"]["properties"]
    fora = [k for k in desejado if k not in aceitos]
    if fora:
        print(f"  {meta['id']}: campos ignorados pelo modelo: {fora}")
    entrada = {k: v for k, v in desejado.items() if k in aceitos}
    d = http("POST", f"{REPLICATE}/models/{meta['modelo']}/predictions",
             headers=_h_rep(), json={"input": entrada}).json()
    return {"task_id": d["id"]}


def replicate_consultar(job: dict, destino: str):
    d = http("GET", f"{REPLICATE}/predictions/{job['task_id']}", headers=_h_rep()).json()
    if d["status"] == "succeeded":
        saida = d["output"]
        baixar(saida[0] if isinstance(saida, list) else saida, destino)
        return "pronto", destino
    if d["status"] in ("failed", "canceled"):
        return "falhou", str(d.get("error"))[:300]
    return "andando", None


# ---------- MiniMax H3 Max (REST), reserva barata para b-roll ----------
def _h_mm() -> dict:
    return {"Authorization": f"Bearer {os.environ['MINIMAX_API_KEY']}", "Content-Type": "application/json"}


def minimax_enviar(meta: dict, prompt: str) -> dict:
    corpo = {"model": meta["modelo"], "content": [{"type": "text", "text": prompt}],
             "duration": meta["duracao_s"], "resolution": meta["resolucao"].upper(),
             "ratio": meta["proporcao"]}
    d = http("POST", "https://api.minimax.io/v2/video_generation", headers=_h_mm(), json=corpo).json()
    return {"task_id": d["task_id"]}


def minimax_consultar(job: dict, destino: str):
    d = http("GET", f"https://api.minimax.io/v2/query/video_generation/{job['task_id']}",
             headers=_h_mm()).json()
    t = d.get("task") or {}                                # a resposta vem dentro de "task"
    if t.get("status") == "succeeded":
        baixar(t["content"]["url"], destino)               # URL temporária: baixe na hora
        return "pronto", destino
    if t.get("status") in ("failed", "cancelled"):
        return "falhou", json.dumps(d)[:300]
    return "andando", None                                 # queued ou running


PROVEDORES = {"gemini": (gemini_enviar, gemini_consultar),
              "vertex": (vertex_enviar, vertex_consultar), "runway": (runway_enviar, runway_consultar),
              "fal": (fal_enviar, fal_consultar), "replicate": (replicate_enviar, replicate_consultar),
              "minimax": (minimax_enviar, minimax_consultar)}


def verificar(destino: str, meta: dict) -> tuple[float, list[str]]:
    """ffprobe confere duração (tolerância de 0,5 s), stream de vídeo e orientação."""
    out = subprocess.run(["ffprobe", "-v", "error", "-show_entries",
                          "stream=codec_type,width,height,r_frame_rate:format=duration",
                          "-of", "json", destino], capture_output=True, text=True, check=True).stdout
    info = json.loads(out)
    video = next((s for s in info["streams"] if s["codec_type"] == "video"), None)
    dur = float(info["format"]["duration"])
    erros = []
    if video is None:
        return dur, ["arquivo sem stream de vídeo"]
    if abs(dur - meta["duracao_s"]) > 0.5:
        erros.append(f"duração {dur:.2f} s, pedida {meta['duracao_s']} s")
    vertical = video["height"] > video["width"]
    if vertical != (meta["proporcao"] == "9:16"):
        erros.append(f"orientação {video['width']}x{video['height']} não bate com {meta['proporcao']}")
    return dur, erros


def registrar_custo(cid: str, job: dict, segundos: float) -> None:
    novo = not os.path.exists(ARQ_CUSTOS)
    with open(ARQ_CUSTOS, "a", newline="", encoding="utf-8") as f:
        w = csv.writer(f)
        if novo:
            w.writerow(["data", "cena", "provedor", "modelo", "segundos_medidos", "custo_estimado_usd"])
        w.writerow([agora(), cid, job["provedor"], job["modelo"], f"{segundos:.2f}", job["custo_estimado"]])


# ---------- 1) enviar o que falta, respeitando o teto ----------
jobs = ler_jobs()
filtro = set(filter(None, args.so.split(",")))
metas = []
for nome in sorted(os.listdir("storyboard/prompts")):
    if nome.endswith(".json"):
        with open(os.path.join("storyboard/prompts", nome), encoding="utf-8") as f:
            metas.append(json.load(f))

for meta in metas:
    cid = meta["id"]
    if filtro and cid not in filtro:
        continue
    m = MODELOS[meta["chave_toml"]]
    destino = f"{DIR_CLIPS}/{cid}.mp4"
    job = jobs["cenas"].setdefault(cid, {
        "status": "pendente", "provedor": m["provedor"], "modelo": m["id"], "task_id": None,
        "custo_estimado": round(max(meta["duracao_s"] * m["preco"][meta["resolucao"]],
                                    m.get("minimo_usd", 0.0)), 4),
        "arquivo": None, "enviado_em": None, "pronto_em": None})
    if os.path.exists(destino):                                   # idempotência 1: já baixado
        print(f"{cid} já existe, pulando")
        job.update(status="pronto", arquivo=destino)
        continue
    if job["status"] == "enviado":                                # idempotência 2: só consultar
        print(f"{cid} já enviado (task={job['task_id']}), só consultando")
        continue
    if jobs["gasto_usd"] + job["custo_estimado"] > jobs["teto_usd"]:
        print(f"{cid}: o teto de US$ {jobs['teto_usd']:.2f} seria excedido; parando antes de enviar")
        break
    if args.dry_run:
        print(f"{cid}: enviaria {m['id']} {meta['duracao_s']} s {meta['resolucao']} "
              f"por cerca de US$ {job['custo_estimado']:.2f}")
        continue
    with open(f"storyboard/prompts/{cid}.txt", encoding="utf-8") as f:
        prompt = f.read()
    enviar, _ = PROVEDORES[m["provedor"]]
    job.update(enviar(meta, prompt), status="enviado", enviado_em=agora())
    jobs["gasto_usd"] = round(jobs["gasto_usd"] + job["custo_estimado"], 4)   # conta no envio
    salvar_jobs(jobs)                                             # grava ANTES de consultar
    print(f"{cid} enviado task={job['task_id']} (cerca de US$ {job['custo_estimado']:.2f})")

if args.dry_run:
    sys.exit(0)

# ---------- 2) polling de tudo que está "enviado" ----------
por_id = {m["id"]: m for m in metas}
pendentes = [c for c, j in jobs["cenas"].items()
             if j["status"] == "enviado" and (not filtro or c in filtro)]
inicio = time.time()
proxima = dict.fromkeys(pendentes, 0.0)                       # relógio de consulta de cada cena
while pendentes and time.time() - inicio < TEMPO_MAX_S:
    for cid in list(pendentes):
        if time.time() < proxima[cid]:
            continue
        job = jobs["cenas"][cid]
        destino = f"{DIR_CLIPS}/{cid}.mp4"
        estado, info = PROVEDORES[job["provedor"]][1](job, destino)
        if estado == "andando":
            proxima[cid] = time.time() + INTERVALO_POR_PROVEDOR.get(job["provedor"], INTERVALO_S)
            continue
        pendentes.remove(cid)
        if estado == "falhou":
            job["status"] = "falhou"
            print(f"{cid} FALHOU: {info}")
        else:
            segundos, erros = verificar(destino, por_id[cid])
            job.update(status="reprovado" if erros else "pronto", arquivo=destino, pronto_em=agora())
            registrar_custo(cid, job, segundos)
            print(f"{cid} {'REPROVADO ' + '; '.join(erros) if erros else 'pronto'} "
                  f"{destino} US$ {job['custo_estimado']:.2f}")
        salvar_jobs(jobs)
    if pendentes:
        time.sleep(1)                                         # cada cena respeita o próprio intervalo

if pendentes:
    print(f"tempo da rodada esgotado; ainda em andamento: {pendentes}. Rode de novo para continuar.")
print(f"gasto acumulado: US$ {jobs['gasto_usd']:.2f} de US$ {jobs['teto_usd']:.2f}")
TypeScript
Mesma lógica em Node 20 com @google/genai e smol-toml, para quem monta o vídeo em Remotion ou HyperFrames e prefere um projeto só em TypeScript. O provedor gemini (Omni) está só na versão Python; para trazê-lo, peça ao Codex que traduza gemini_enviar e gemini_consultar mantendo a consulta a cada 5 s.
// scripts/gerar-video.ts: a mesma fila idempotente da versão Python, em TypeScript (Node 20+).
// Lê storyboard/prompts/*.json e *.txt (aula 20) e config/modelos.toml (aula 19); grava
// estado/jobs.json, midia/gerados/clips/<id>.mp4 e custos/custos.csv.
// Instalação: npm i @google/genai smol-toml && npm i -D tsx
// Uso:        npx tsx scripts/gerar-video.ts --dry-run     |     npx tsx scripts/gerar-video.ts
import { execFileSync } from "node:child_process";
import { appendFileSync, existsSync, mkdirSync, readFileSync, readdirSync, renameSync, writeFileSync } from "node:fs";
import { GenerateVideosOperation, GoogleGenAI } from "@google/genai";
import { parse } from "smol-toml";

type Meta = {
  id: string; chave_toml: string; modelo: string; provedor: string; duracao_s: number;
  resolucao: string; proporcao: string; referencias: string[];
  primeiro_quadro?: string | null; ultimo_quadro?: string | null; negative_prompt: string;
};
type Job = {
  status: "pendente" | "enviado" | "pronto" | "falhou" | "reprovado"; provedor: string; modelo: string;
  task_id: string | null; status_url?: string; response_url?: string; custo_estimado: number;
  arquivo: string | null; enviado_em: string | null; pronto_em: string | null;
};
type Estado = { estado: "andando" | "pronto" | "falhou"; info?: string };
type Provedor = { enviar(m: Meta, p: string): Promise<Partial<Job>>; consultar(j: Job, destino: string): Promise<Estado> };

const ARQ_JOBS = "estado/jobs.json", DIR_CLIPS = "midia/gerados/clips", ARQ_CUSTOS = "custos/custos.csv";
const INTERVALO_MS = 10_000, TEMPO_MAX_MS = 15 * 60_000;
const TETO = Number(process.env.TETO_VIDEO_USD ?? "5");
const DRY = process.argv.includes("--dry-run");
const env = (k: string): string => process.env[k] ?? (() => { throw new Error(`falta ${k} no .env`); })();
const dormir = (ms: number) => new Promise((r) => setTimeout(r, ms));
const agora = () => new Date().toISOString().replace(/\.\d{3}Z$/, "Z");
for (const d of [DIR_CLIPS, "estado", "custos"]) mkdirSync(d, { recursive: true });   // clipes, jobs.json e custos.csv
const MODELOS = parse(readFileSync("config/modelos.toml", "utf8")) as Record<string, any>;

function salvarJobs(j: unknown) {
  writeFileSync(ARQ_JOBS + ".tmp", JSON.stringify(j, null, 2));
  renameSync(ARQ_JOBS + ".tmp", ARQ_JOBS);           // troca atômica: o arquivo nunca fica pela metade
}

/** fetch com recuo exponencial em 429 e 5xx; 401 e 403 encerram na hora. */
async function http(url: string, init: RequestInit = {}, tentativas = 5): Promise<any> {
  let espera = 5_000;
  for (let i = 1; i <= tentativas; i++) {
    const r = await fetch(url, { ...init, signal: AbortSignal.timeout(60_000) });
    if (r.status === 401 || r.status === 403) throw new Error(`HTTP ${r.status} em ${url}: confira a chave no .env`);
    if (r.status === 429 || r.status >= 500) {
      const pausa = espera + Math.random() * 1_000;
      console.log(`  HTTP ${r.status}, esperando ${Math.round(pausa / 1000)} s (tentativa ${i}/${tentativas})`);
      await dormir(pausa);
      espera *= 2;
      continue;
    }
    if (!r.ok) throw new Error(`HTTP ${r.status} em ${url}: ${(await r.text()).slice(0, 300)}`);
    return r.json();
  }
  throw new Error(`${url}: esgotadas as ${tentativas} tentativas`);
}

async function baixar(url: string, destino: string) {
  const r = await fetch(url);                         // URL temporária: baixe na hora
  if (!r.ok) throw new Error(`download ${r.status}`);
  writeFileSync(destino + ".part", Buffer.from(await r.arrayBuffer()));
  renameSync(destino + ".part", destino);
}

const dataUri = (c: string) =>
  `data:image/${c.endsWith(".png") ? "png" : "jpeg"};base64,${readFileSync(c).toString("base64")}`;
const urlPublica = (c: string) => (c.startsWith("http") ? c : `${env("ASSETS_BASE_URL").replace(/\/$/, "")}/${c}`);

// ---------- Veo 3.1 Fast na Agent Platform (id GA; o SDK ainda usa vertexai: true) ----------
const vertex = () => new GoogleGenAI({ vertexai: true, project: env("GOOGLE_CLOUD_PROJECT"),
  location: process.env.GOOGLE_CLOUD_LOCATION ?? "us-central1" });
const veo: Provedor = {
  async enviar(m, prompt) {
    const op = await vertex().models.generateVideos({
      model: m.modelo, prompt,
      config: { aspectRatio: m.proporcao, resolution: m.resolucao, durationSeconds: m.duracao_s,
        negativePrompt: m.negative_prompt || undefined, numberOfVideos: 1, generateAudio: true },
    });
    return { task_id: op.name ?? null };
  },
  async consultar(j, destino) {
    const ref = new GenerateVideosOperation();
    ref.name = j.task_id!;                            // reabre a operação pelo nome gravado no jobs.json
    const op = await vertex().operations.getVideosOperation({ operation: ref });
    if (!op.done) return { estado: "andando" };
    if (op.error) return { estado: "falhou", info: JSON.stringify(op.error) };
    const v = op.response?.generatedVideos?.[0]?.video;
    if (v?.videoBytes) writeFileSync(destino, Buffer.from(v.videoBytes, "base64"));
    else if (v?.uri?.startsWith("http")) await baixar(v.uri, destino);
    else return { estado: "falhou", info: `saída sem bytes nem URL https: ${v?.uri}` };
    return { estado: "pronto" };
  },
};

// ---------- Runway gen4.5, imagem para vídeo ----------
const RUNWAY = "https://api.dev.runwayml.com/v1";
const hRunway = () => ({ Authorization: `Bearer ${env("RUNWAYML_API_SECRET")}`,
  "X-Runway-Version": "2024-11-06", "Content-Type": "application/json" });
const runway: Provedor = {
  async enviar(m, prompt) {
    if (!m.referencias.length) throw new Error(`${m.id}: gen4.5 aqui é imagem para vídeo`);
    const d = await http(`${RUNWAY}/image_to_video`, { method: "POST", headers: hRunway(), body: JSON.stringify({
      model: m.modelo, promptImage: urlPublica(m.referencias[0]), promptText: prompt.slice(0, 1000),
      ratio: m.proporcao === "9:16" ? "720:1280" : "1280:720", duration: m.duracao_s }) });
    return { task_id: d.id };
  },
  async consultar(j, destino) {
    const d = await http(`${RUNWAY}/tasks/${j.task_id}`, { headers: hRunway() });
    if (d.status === "SUCCEEDED") { await baixar(d.output[0], destino); return { estado: "pronto" }; }
    if (d.status === "FAILED" || d.status === "CANCELLED") return { estado: "falhou", info: JSON.stringify(d).slice(0, 300) };
    return { estado: "andando" };
  },
};

// ---------- Kling 3.0 Pro pela fila da fal ----------
const hFal = () => ({ Authorization: `Key ${env("FAL_KEY")}`, "Content-Type": "application/json" });
const fal: Provedor = {
  async enviar(m, prompt) {
    // nomes dos campos: confira com get_model_schema no MCP da fal antes da primeira rodada
    const d = await http(`https://queue.fal.run/${m.modelo}`, { method: "POST", headers: hFal(),
      body: JSON.stringify({ prompt, duration: String(m.duracao_s), aspect_ratio: m.proporcao, generate_audio: true }) });
    return { task_id: d.request_id, status_url: d.status_url, response_url: d.response_url };
  },
  async consultar(j, destino) {
    const s = await http(j.status_url!, { headers: hFal() });
    if (s.status !== "COMPLETED") return { estado: "andando" };       // IN_QUEUE ou IN_PROGRESS
    let d: any;                                                        // response_url é JSON, não o arquivo
    try { d = await http(j.response_url!, { headers: hFal() }); }
    catch (e) { return { estado: "falhou", info: String(e).slice(0, 300) }; }
    if (!d.video?.url) return { estado: "falhou", info: JSON.stringify(d).slice(0, 300) };
    await baixar(d.video.url, destino);
    return { estado: "pronto" };
  },
};

// ---------- Seedance 2.5 na Replicate ----------
const REP = "https://api.replicate.com/v1";
const hRep = () => ({ Authorization: `Bearer ${env("REPLICATE_API_TOKEN")}`, "Content-Type": "application/json" });
const replicate: Provedor = {
  async enviar(m, prompt) {
    const desejado: Record<string, unknown> = { prompt, duration: m.duracao_s, resolution: m.resolucao, aspect_ratio: m.proporcao };
    if (m.primeiro_quadro) desejado.image = dataUri(m.primeiro_quadro);
    if (m.ultimo_quadro) desejado.last_frame_image = dataUri(m.ultimo_quadro);
    const modelo = await http(`${REP}/models/${m.modelo}`, { headers: hRep() });
    const aceitos = modelo.latest_version.openapi_schema.components.schemas.Input.properties;
    const fora = Object.keys(desejado).filter((k) => !(k in aceitos));
    if (fora.length) console.log(`  ${m.id}: campos ignorados pelo modelo: ${fora.join(", ")}`);
    const input = Object.fromEntries(Object.entries(desejado).filter(([k]) => k in aceitos));
    const d = await http(`${REP}/models/${m.modelo}/predictions`, { method: "POST", headers: hRep(), body: JSON.stringify({ input }) });
    return { task_id: d.id };
  },
  async consultar(j, destino) {
    const d = await http(`${REP}/predictions/${j.task_id}`, { headers: hRep() });
    if (d.status === "succeeded") { await baixar(Array.isArray(d.output) ? d.output[0] : d.output, destino); return { estado: "pronto" }; }
    if (d.status === "failed" || d.status === "canceled") return { estado: "falhou", info: String(d.error).slice(0, 300) };
    return { estado: "andando" };
  },
};

// ---------- MiniMax H3 Max, reserva barata ----------
const hMm = () => ({ Authorization: `Bearer ${env("MINIMAX_API_KEY")}`, "Content-Type": "application/json" });
const minimax: Provedor = {
  async enviar(m, prompt) {
    const d = await http("https://api.minimax.io/v2/video_generation", { method: "POST", headers: hMm(), body: JSON.stringify({
      model: m.modelo, content: [{ type: "text", text: prompt }], duration: m.duracao_s,
      resolution: m.resolucao.toUpperCase(), ratio: m.proporcao }) });
    return { task_id: d.task_id };
  },
  async consultar(j, destino) {
    const d = await http(`https://api.minimax.io/v2/query/video_generation/${j.task_id}`, { headers: hMm() });
    const t = d.task ?? {};                                            // a resposta vem dentro de "task"
    if (t.status === "failed" || t.status === "cancelled") return { estado: "falhou", info: JSON.stringify(d).slice(0, 300) };
    if (t.status !== "succeeded") return { estado: "andando" };       // queued ou running
    await baixar(t.content.url, destino);
    return { estado: "pronto" };
  },
};

const PROVEDORES: Record<string, Provedor> = { vertex: veo, runway, fal, replicate, minimax };

/** ffprobe: duração (tolerância de 0,5 s), stream de vídeo e orientação. */
function verificar(destino: string, m: Meta): { segundos: number; erros: string[] } {
  const info = JSON.parse(execFileSync("ffprobe", ["-v", "error", "-show_entries",
    "stream=codec_type,width,height,r_frame_rate:format=duration", "-of", "json", destino], { encoding: "utf8" }));
  const v = info.streams.find((s: any) => s.codec_type === "video");
  const segundos = Number(info.format.duration);
  if (!v) return { segundos, erros: ["arquivo sem stream de vídeo"] };
  const erros: string[] = [];
  if (Math.abs(segundos - m.duracao_s) > 0.5) erros.push(`duração ${segundos.toFixed(2)} s, pedida ${m.duracao_s} s`);
  if ((v.height > v.width) !== (m.proporcao === "9:16")) erros.push(`orientação ${v.width}x${v.height} não bate com ${m.proporcao}`);
  return { segundos, erros };
}

function registrarCusto(id: string, j: Job, segundos: number) {
  if (!existsSync(ARQ_CUSTOS)) appendFileSync(ARQ_CUSTOS, "data,cena,provedor,modelo,segundos_medidos,custo_estimado_usd\n");
  appendFileSync(ARQ_CUSTOS, `${agora()},${id},${j.provedor},${j.modelo},${segundos.toFixed(2)},${j.custo_estimado}\n`);
}

async function main() {
  const jobs = existsSync(ARQ_JOBS) ? JSON.parse(readFileSync(ARQ_JOBS, "utf8"))
    : { retrato_precos: MODELOS.retrato, teto_usd: TETO, gasto_usd: 0, cenas: {} as Record<string, Job> };
  const metas: Meta[] = readdirSync("storyboard/prompts").filter((f) => f.endsWith(".json")).sort()
    .map((f) => JSON.parse(readFileSync(`storyboard/prompts/${f}`, "utf8")));

  // 1) enviar o que falta, respeitando o teto
  for (const m of metas) {
    const cfg = MODELOS[m.chave_toml];
    const destino = `${DIR_CLIPS}/${m.id}.mp4`;
    const job: Job = (jobs.cenas[m.id] ??= {
      status: "pendente", provedor: cfg.provedor, modelo: cfg.id, task_id: null,
      custo_estimado: Math.max(m.duracao_s * cfg.preco[m.resolucao], cfg.minimo_usd ?? 0),
      arquivo: null, enviado_em: null, pronto_em: null });
    if (existsSync(destino)) { console.log(`${m.id} já existe, pulando`); Object.assign(job, { status: "pronto", arquivo: destino }); continue; }
    if (job.status === "enviado") { console.log(`${m.id} já enviado (task=${job.task_id}), só consultando`); continue; }
    if (jobs.gasto_usd + job.custo_estimado > jobs.teto_usd) { console.log(`${m.id}: teto seria excedido; parando antes de enviar`); break; }
    if (DRY) { console.log(`${m.id}: enviaria ${cfg.id} ${m.duracao_s} s ${m.resolucao} por cerca de US$ ${job.custo_estimado.toFixed(2)}`); continue; }
    const prompt = readFileSync(`storyboard/prompts/${m.id}.txt`, "utf8");
    Object.assign(job, await PROVEDORES[cfg.provedor].enviar(m, prompt), { status: "enviado", enviado_em: agora() });
    jobs.gasto_usd = Math.round((jobs.gasto_usd + job.custo_estimado) * 1e4) / 1e4;   // conta no envio
    salvarJobs(jobs);                                                                // grava ANTES de consultar
    console.log(`${m.id} enviado task=${job.task_id}`);
  }
  if (DRY) return;

  // 2) polling de tudo que está "enviado"
  const porId = new Map(metas.map((m) => [m.id, m]));
  let pendentes = Object.entries(jobs.cenas as Record<string, Job>).filter(([, j]) => j.status === "enviado").map(([id]) => id);
  const inicio = Date.now();
  while (pendentes.length && Date.now() - inicio < TEMPO_MAX_MS) {
    for (const id of [...pendentes]) {
      const job: Job = jobs.cenas[id];
      const destino = `${DIR_CLIPS}/${id}.mp4`;
      const r = await PROVEDORES[job.provedor].consultar(job, destino);
      if (r.estado === "andando") continue;
      pendentes = pendentes.filter((x) => x !== id);
      if (r.estado === "falhou") { job.status = "falhou"; console.log(`${id} FALHOU: ${r.info}`); }
      else {
        const { segundos, erros } = verificar(destino, porId.get(id)!);
        Object.assign(job, { status: erros.length ? "reprovado" : "pronto", arquivo: destino, pronto_em: agora() });
        registrarCusto(id, job, segundos);
        console.log(`${id} ${erros.length ? "REPROVADO " + erros.join("; ") : "pronto"} ${destino} US$ ${job.custo_estimado.toFixed(2)}`);
      }
      salvarJobs(jobs);
    }
    if (pendentes.length) await dormir(INTERVALO_MS);
  }
  if (pendentes.length) console.log(`tempo da rodada esgotado; em andamento: ${pendentes.join(", ")}. Rode de novo.`);
  console.log(`gasto acumulado: US$ ${jobs.gasto_usd.toFixed(2)} de US$ ${jobs.teto_usd.toFixed(2)}`);
}

main().catch((e) => { console.error(e.message); process.exit(1); });
curl
O modo rascunho do Seedance 2.5 na Runway pede uma decisão humana no meio do ciclo, então ele fica num script à parte, em bash com curl e jq.
#!/usr/bin/env bash
# seedance_rascunho.sh: prévia 480p do Seedance 2.5 na Runway e, só depois do seu "s",
# promoção a 1080p (vale por 7 dias; as duas gerações são cobradas, cerca de
# US$ 1,00 + US$ 3,40 para 5 s). Mesmo ciclo do script: enviar, consultar, baixar, conferir.
# Uso: bash scripts/seedance_rascunho.sh c06
set -euo pipefail
CID="$1"
API="https://api.dev.runwayml.com/v1"
H=(-H "Authorization: Bearer $RUNWAYML_API_SECRET" -H "X-Runway-Version: 2024-11-06" -H "Content-Type: application/json")
PROMPT=$(jq -Rs . < "storyboard/prompts/${CID}.txt")      # texto do prompt como string JSON
DUR=$(jq .duracao_s "storyboard/prompts/${CID}.json")
mkdir -p midia/gerados/clips custos

esperar() {  # consulta a cada 10 s, no máximo 90 vezes (15 min); imprime a URL de saída
  for _ in $(seq 1 90); do
    R=$(curl -s "$API/tasks/$1" "${H[@]}")
    S=$(echo "$R" | jq -r .status)
    [ "$S" = "SUCCEEDED" ] && { echo "$R" | jq -r '.output[0]'; return 0; }
    { [ "$S" = "FAILED" ] || [ "$S" = "CANCELLED" ]; } && { echo "$R" >&2; return 1; }
    sleep 10
  done
  echo "tempo esgotado; a tarefa $1 segue na Runway, consulte de novo" >&2; return 1
}

# 1) prévia 480p (mínimo de US$ 0,80 por tarefa)
DRAFT_ID=$(curl -s -X POST "$API/text_to_video" "${H[@]}" \
  -d "{\"model\":\"seedance2_5\",\"promptText\":$PROMPT,\"ratio\":\"1280:720\",\"duration\":$DUR,\"draft\":true}" | jq -r .id)
echo "$DRAFT_ID" > "midia/gerados/clips/${CID}_draft.id"        # guarde o id antes de esperar
curl -s -o "midia/gerados/clips/${CID}_draft.mp4" "$(esperar "$DRAFT_ID")"
echo "prévia em midia/gerados/clips/${CID}_draft.mp4: assista antes de decidir"

# 2) aprovação humana antes de gastar na versão final
read -r -p "promover a 1080p? (s/N) " RESP
[ "$RESP" = "s" ] || { echo "não promovido; draftTaskId=$DRAFT_ID vale por 7 dias"; exit 0; }

FINAL_ID=$(curl -s -X POST "$API/text_to_video" "${H[@]}" \
  -d "{\"model\":\"seedance2_5\",\"draftTaskId\":\"$DRAFT_ID\"}" | jq -r .id)   # só model e draftTaskId
curl -s -o "midia/gerados/clips/${CID}.mp4" "$(esperar "$FINAL_ID")"
ffprobe -v error -show_entries stream=width,height,r_frame_rate:format=duration -of csv=p=0 "midia/gerados/clips/${CID}.mp4"
[ -f custos/custos.csv ] || echo "data,cena,provedor,modelo,segundos_medidos,custo_estimado_usd" > custos/custos.csv
echo "$(date -u +%FT%TZ),${CID},runway,seedance2_5,${DUR},$(echo "$DUR*0.20+$DUR*0.68" | bc)" >> custos/custos.csv
Cada clipe baixado passa pelo ffprobe da aula 4 antes de virar pronto: duração com tolerância de 0,5 s, presença de stream de vídeo e orientação (9:16 tem altura maior que a largura). Clipe que falha vira reprovado, com o motivo no terminal, e entra em custos/custos.csv do mesmo jeito, porque foi pago. O teto da semana é checado antes de cada envio, com o gasto contado no envio e não na entrega; o curso de LLM FinOps explica por que em teto de gasto: o que mandar ligar esta semana.
Consultar sem pagar duas vezes
Grave o id da tarefa antes da primeira consulta e nunca reenvie uma cena que já tem id.
- Consulte a cada 10 s e encerre a rodada em 15 min; a próxima rodada retoma.
- Em 429 na consulta, espere 5, 10, 20 e 40 s e consulte o mesmo id.
- Em 401 ou 403, pare: chave errada não melhora com nova tentativa.
- Baixe a URL de saída assim que a tarefa terminar; ela expira.
O teste: Um Ctrl+C no meio do polling seguido de nova rodada não cria tarefa nova.
alexandrecaramaschi.com/educacao/frontends-com-vibecoding
Três decisões aparecem em toda rodada. Se o .mp4 da cena já existe, o script pula; para regenerar de propósito, renomeie o arquivo antigo (c03_v1.mp4) em vez de apagar, e compare depois. Se o teto da semana chegou com cenas pendentes, troque o modelo das restantes no storyboard/cenas_video.json para a reserva (MiniMax-H3-Max a US$ 0,05 por segundo em 480p) e rode de novo, sem subir o teto no meio da rodada. Se a cena voltou reprovada por duração, confira se o modelo aceita aquele valor no TOML antes de reenviar. As chaves ficam só no .env, fora do repositório, como mostra o caso de chaves de API guardadas em Secrets.
Dois caminhos fora do ciclo de operation: Omni por URI e Kling pelo MCP
Chamar o Gemini Omni com entrega por URI
A aula 1 elege o gemini-omni-1.1-flash como padrão de movimento, e ele não segue o ciclo do Veo. O Omni não devolve uma operation: o pedido leva response_format com tipo vídeo e entrega por URI, a resposta traz em output_video.uri o id de um arquivo, e o script consulta o recurso Files até o estado ACTIVE (ou FAILED) antes de baixar. A doc sugere consultar a cada 5 s, e por isso o laço do gerar_video.py guarda um relógio por cena: o Omni volta a cada 5 s e os demais seguem nos 10 s. Desde 27/08/2026 esse id está em GA no Gemini API, e a chave fica no .env como GEMINI_API_KEY.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
O Omni não aceita negative_prompt, system instructions, temperature, top_p nem stop sequences, e a função de envio não manda nenhum deles: os negativos já chegam no corpo, na linha Avoid que o montar_prompt.py escreve. Se o envio voltar com erro 400 citando um campo, tire o campo do pedido em vez de tentar outro nome. Está pronto quando a cena do Omni aparece em estado/jobs.json com um id de arquivo, o terminal mostra o clipe pronto e uma segunda rodada só consulta. O corpo que gemini_enviar monta fica assim:
{
  "model": "gemini-omni-1.1-flash",
  "input": "SHOT: ... (texto de storyboard/prompts/c02.txt, com a linha Avoid no fim)",
  "response_format": {
    "type": "video",
    "delivery": "uri",
    "aspect_ratio": "16:9",
    "resolution": "720p"
  }
}
Chamar o Kling pelo MCP da fal no Claude Code
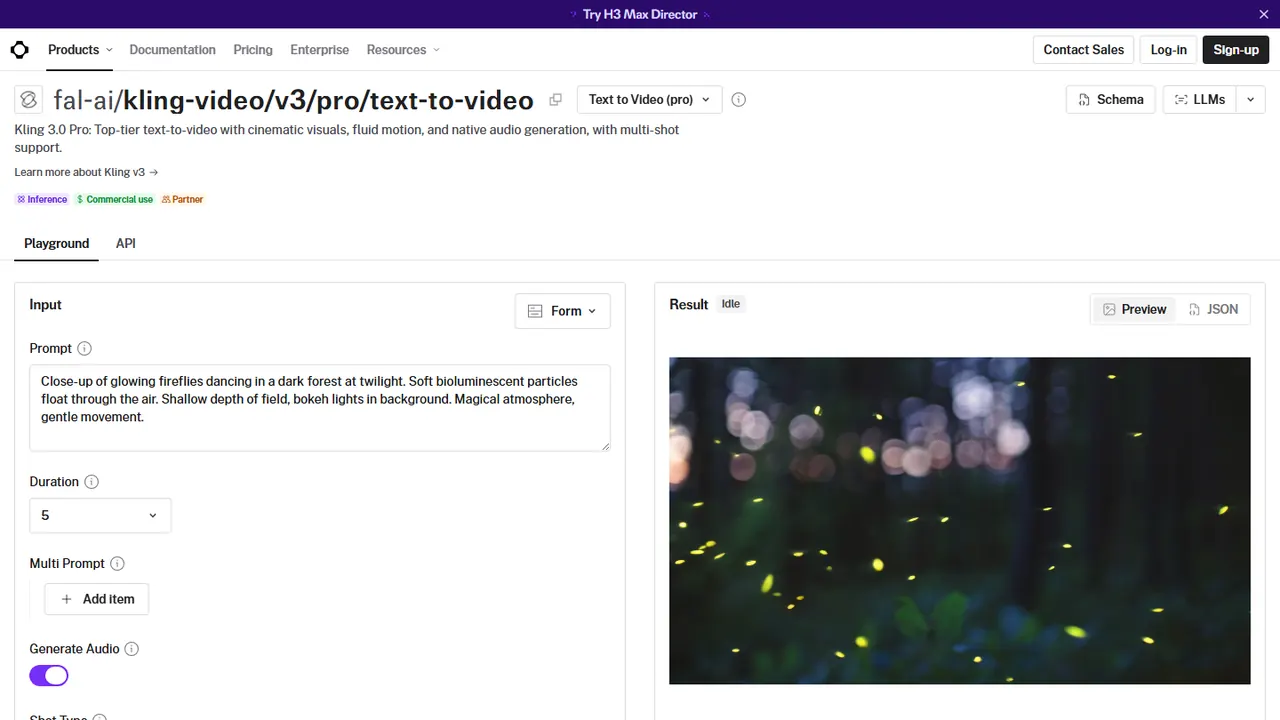
Com o MCP da fal instalado e autenticado por OAuth (passo a passo na aula 9), o Claude Code faz o mesmo ciclo pelas ferramentas get_model_schema, get_pricing, submit_job, check_job e get_job_result. A regra do CLAUDE.md, "não chamar API paga sem mostrar o custo estimado e pedir confirmação", vira um passo explícito do prompt: o agente mostra a saída de get_pricing e para.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Fazer a primeira rodada de geração por API
Os prompts de storyboard/prompts/ prontos (aula 20) e o modelos.toml da aula 19 no projeto.
Passo 1: Preencha o .env com as chaves e o teto
GEMINI_API_KEY, GOOGLE_CLOUD_PROJECT, GOOGLE_CLOUD_LOCATION, RUNWAYML_API_SECRET, FAL_KEY, REPLICATE_API_TOKEN, MINIMAX_API_KEY, ASSETS_BASE_URL e TETO_VIDEO_USD=5.
Deu certo quando: bash scripts/checar_ids.sh responde OK e o .env aparece no .gitignore.
Erro comum: Colar a chave no script ou no chat; ela mora só no .env.
Passo 2: Crie a FAL_KEY restrita ao Kling 3.0 Pro e com validade
Desde 09/10/2026 a fal cria chaves com preset de permissão, limitadas a modelos específicos e com data de expiração.
Deu certo quando: No painel da fal, a chave enxerga só fal-ai/kling-video/v3/pro/text-to-video e vence no fim da semana de produção.
Erro comum: Reaproveitar a chave antiga sem restrição; ela continua válida e alcança qualquer modelo da conta.
Passo 3: Rode python scripts/gerar_video.py --dry-run
Deu certo quando: Cada cena aparece com enviaria, o modelo e o custo estimado, sem nenhuma chamada paga.
Erro comum: Pular o dry-run e descobrir o custo na fatura.
Passo 4: Rode python scripts/gerar_video.py e acompanhe o polling
Deu certo quando: Linhas c01 enviado task=... e, minutos depois, c01 pronto midia/gerados/clips/c01.mp4 US$ 0.96.
Erro comum: Tempo máximo de 60 s; uma geração leva minutos, e o script espera até 15 min por rodada.
Passo 5: Interrompa com Ctrl+C e rode de novo
Deu certo quando: As cenas prontas aparecem como já existe, pulando e as enviadas só são consultadas.
Erro comum: Apagar estado/jobs.json entre rodadas; isso reenvia e paga tudo de novo.
Passo 6: Gere o rascunho do Seedance com bash scripts/seedance_rascunho.sh
Deu certo quando: A prévia 480p chega em midia/gerados/clips/ e o script pergunta se deve promover a 1080p.
Erro comum: Promover todo rascunho; cada promoção custa cerca de US$ 3,40 por 5 s.
Passo 7: Chame o Kling pelo MCP da fal com o prompt desta aula
Deu certo quando: O Claude mostra a conta do get_pricing, espera o seu sim e só então chama submit_job.
Erro comum: Usar o MCP sem autenticar em /mcp; o submit_job volta com erro de autorização.
Passo 8: Abra custos/custos.csv e confira o total da rodada
Deu certo quando: Uma linha por cena com segundos medidos e custo, somando o mesmo valor do gasto em jobs.json.
Erro comum: Montar o vídeo antes da revisão de quadros e achar a mão deformada depois do render.
No fim você tem: Clipes em midia/gerados/clips/, conferidos por ffprobe, com o custo de cada um anotado e nenhuma cena paga duas vezes.
Na Cozinha da Rafa, a rodada de quinta-feira do bolo de rolo enviou as cinco cenas da aula 19. O dry-run mostrou US$ 4,04 com teto de US$ 5,00. Durante o polling, um 429 do MiniMax na c02 foi absorvido pelo recuo de 10 s, sem reenvio. Um Ctrl+C no meio e a segunda rodada mostraram "c01 já existe, pulando" e "c03 já enviado, só consultando". O Kling da c04 passou pelo MCP da fal, com o preço mostrado antes do sim.
Quanto custou a rodada do bolo de rolo
US$ 4,04
Custo estimado da rodada
5 cenas, teto de US$ 5,00
29 s
Vídeo gerado
cerca de US$ 0,14 por segundo, em média
0
Cenas pagas duas vezes
depois de um Ctrl+C e uma segunda rodada
US$ 0,96
Cena mais cara
c01, Veo 3.1 Fast, 8 s em 1080p 9:16
Fonte: Preços de tabela de 09/10/2026 aplicados às cenas do exemplo da Cozinha da Rafa.
Rode hoje o gerar_video.py com uma cena barata (MiniMax-H3-Max em 480p) antes de soltar a fila inteira. Está pronto quando o clipe chega em midia/gerados/clips/, o ffprobe aprova a duração, custos/custos.csv ganha a linha da cena e uma segunda rodada não cria nenhuma tarefa nova. O custo anotado aqui entra no custo por minuto final da aula 25.
Guia prático: cancelar, limitar e reconciliar tarefas remotas
O polling da aula resolve a espera. Falta o que fazer com a tarefa que você não quer mais, a que ficou rodando sem fim e a que foi paga e nunca chegou ao estado/jobs.json. Este guia acrescenta o cancelamento por fornecedor, o tempo máximo pedido no próprio envio e um script de reconciliação, a conferência entre o que o fornecedor executou e o que o estado local registrou. Você sai sabendo achar tarefa órfã antes que a saída expire.
Funções, casos de uso e aplicações
Funções
Controles do ciclo assíncrono além do polling
| Função ou recurso | O que faz | Quando usar | Situação |
|---|---|---|---|
| Cabeçalho Cancel-After na Replicate | Cancela sozinha a predição depois do tempo pedido (s, m ou h; mínimo de 5 s) | Em todo envio de vídeo, com folga sobre o tempo normal do modelo | Em vigor em 12/10/2026 |
| GET /v1/predictions na Replicate | Lista as predições da conta, 100 por página, da mais recente para a mais antiga | Reconciliação diária com o estado/jobs.json | Em vigor em 12/10/2026 |
| Retenção de uma hora na Replicate | Entrada, saída e logs de predição criada por API são apagados depois de uma hora | Baixar o clipe na mesma rodada; a segunda rodada não pode ficar para o dia seguinte | Em vigor em 12/10/2026 |
| PUT .../requests/{id}/cancel na fal | Tira da fila na hora; se já está rodando, envia o sinal de cancelamento e pode terminar mesmo assim | Cena descartada no meio da rodada; leia CANCELLATION_REQUESTED ou ALREADY_COMPLETED | Em vigor em 12/10/2026 |
| X-Fal-Request-Start-Timeout e X-Fal-Queue-Priority: low | Prazo para a tarefa começar (sem limitar a geração) e prioridade baixa só para as suas tarefas | Rascunhos em lote que podem esperar e não devem ficar na fila para sempre | Em vigor em 12/10/2026 |
| DELETE /v1/tasks/{id} na Runway | Cancela uma tarefa em andamento ou apaga uma concluída | Cena enviada por engano, antes que a geração termine | Em vigor em 12/10/2026 |
| Webhook da fal e da Replicate | O fornecedor chama a sua URL ao terminar; a fal assina com ED25519 e repete até 31 vezes, a Replicate assina com HMAC | Só quando o pipeline roda num servidor na nuvem, com endereço público; no notebook, siga no polling | Em vigor em 12/10/2026 |
Casos de uso
Estúdio de conteúdo de uma rede de academias em Porto Alegre
Marketing digital
Dor
Um Ctrl+C antes de gravar o id deixou uma predição do Seedance rodando, paga e sem dono no estado.
Solução
Roda o reconciliar_replicate.py ao fim de cada rodada; a órfã aparece com id e status e é baixada à mão antes de completar uma hora.
Resultado
Observar, na semana seguinte, se o número de órfãs cai a zero depois de pôr Cancel-After em todo envio.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Coordenação de um curso livre de fotografia em Recife
Educação
Dor
Vinte rascunhos de b-roll na fal ficavam na fila em horário de pico e atrasavam a rodada de takes.
Solução
Os rascunhos saem com prioridade baixa e prazo de início de dez minutos; o que não começou nesse prazo volta como 504 e é reenviado na rodada da noite.
Resultado
Contar no log quantos rascunhos voltam por prazo de início; se forem muitos, mude a rodada de horário em vez de subir o prazo.
Cenário construído para fins didáticos. Números não correspondem a cliente específico.
Na prática
Duas mudanças pequenas no gerar_video.py e um script novo. No replicate_enviar, acrescente "Cancel-After": "20m" ao cabeçalho do POST; nada passa disso. O script abaixo só lê: compara as predições das últimas 24 horas com o estado/jobs.json e avisa o que precisa de mão humana.
"""reconciliar_replicate.py: compara as predições da conta na Replicate com estado/jobs.json.
Só lê. Uso (na raiz video-ia): python scripts/reconciliar_replicate.py"""
import datetime as dt
import json
import os

import requests

CAB = {"Authorization": "Bearer " + os.environ["REPLICATE_API_TOKEN"]}
jobs = json.load(open("estado/jobs.json", encoding="utf-8"))["cenas"]
por_task = {j["task_id"]: cid for cid, j in jobs.items() if j.get("provedor") == "replicate"}
agora = dt.datetime.now(dt.timezone.utc)

url, fim = "https://api.replicate.com/v1/predictions", False
while url and not fim:
    pagina = requests.get(url, headers=CAB, timeout=60).json()
    for p in pagina["results"]:
        criada = dt.datetime.fromisoformat(p["created_at"].replace("Z", "+00:00"))
        minutos = (agora - criada).total_seconds() / 60
        if minutos > 24 * 60:                      # lista vem da mais nova para a mais antiga
            fim = True
            break
        cid = por_task.get(p["id"])
        if cid is None:
            print(f"ÓRFÃ {p['id']} ({p['status']}, há {minutos:.0f} min): paga e fora do estado")
        elif p["status"] == "succeeded" and jobs[cid]["status"] != "pronto":
            aviso = "EXPIROU" if minutos >= 60 else f"BAIXE JÁ, restam {60 - minutos:.0f} min"
            print(f"{cid} {p['id']}: {aviso}")
        elif p["status"] in ("starting", "processing") and minutos > 20:
            print(f"{cid} {p['id']}: rodando há {minutos:.0f} min; avalie cancelar em {p['urls']['cancel']}")
    url = pagina.get("next")
print("Reconciliação concluída.")
Fechar a rodada sem deixar tarefa paga para trás
Passo 1: Ponha Cancel-After no envio da Replicate e prazo de início nos rascunhos da fal
Deu certo quando: O log do envio mostra os cabeçalhos e nenhuma tarefa passa de 20 min.
Erro comum: Usar o prazo de início da fal como limite de geração; ele só vale até a tarefa começar.
Passo 2: Rode a segunda rodada do gerar_video.py em menos de uma hora
Deu certo quando: Toda cena succeeded na Replicate vira pronto com o MP4 em midia/gerados/clips/.
Erro comum: Deixar a consulta para o dia seguinte e encontrar a saída apagada, com a cena paga.
Passo 3: Rode o reconciliar_replicate.py
Deu certo quando: A saída termina sem nenhuma linha ÓRFÃ ou BAIXE JÁ.
Passo 4: Cancele pelo id o que não serve mais, sem reenviar a cena
Replicate pela URL cancel, fal pelo PUT .../cancel, Runway pelo DELETE /v1/tasks/{id}.
Deu certo quando: O status remoto vira cancelado e o jobs.json registra o motivo.
Armadilhas
Webhook no notebook ou polling com reconciliação
Evitar
Coluna a evitar
- Abrir o notebook para a internet só para receber webhook
- Aceitar webhook sem conferir a assinatura do fornecedor
- Achar que cancelar garante que a tarefa não foi cobrada
- Confiar só no jobs.json para saber o que foi pago
Recomendado
Coluna recomendada
- Polling no notebook; webhook só em servidor na nuvem
- Verificar a assinatura e tratar o mesmo id repetido como já recebido
- Ler o status depois do cancelamento: ALREADY_COMPLETED foi pago
- Reconciliar com a lista do fornecedor ao fim de cada rodada
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- CursoClaude Code CLI: Programação com IA
- CursoAstra profundosugerido pelo grafoA quinta parte do Astra planeja o vídeo e edita o material bruto com o modelo dirigindo a ferramenta. O curso de vídeo com IA aprofunda esse trabalho com Claude Code, Codex e ElevenLabs, do roteiro à publicação. O grafo já sugeria esta ordem pela regra de entrada da trilha; com a ordem anterior curada, ela passa a ser declarada (Etapa 4, wave 3).
- CursoSetup Completo: do zero ao Claude Codesugerido pelo grafo7 capítulos de “Vídeo com IA: Claude Code, Codex e ElevenLabs” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code”.
Depois, siga para
- CursoFrontends com Vibecodingsugerido pelo grafo21 capítulos de “Frontends com Vibecoding” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoDo Agile ao Agentic Operating Modelsugerido pelo grafo5 capítulos de “Do Agile ao Agentic Operating Model” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoAgentes de IA Autônomos: Do Conceito à Produçãosugerido pelo grafo7 capítulos de “Agentes de IA Autônomos: Do Conceito à Produção” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
- CursoLLM FinOps: o custo da IA para quem assina o orçamentosugerido pelo grafo4 capítulos de “LLM FinOps: o custo da IA para quem assina o orçamento” usam conceitos apresentados em “Vídeo com IA: Claude Code, Codex e ElevenLabs”.
O mesmo assunto em outros cursos
- Agentes de IA Autônomos: Do Conceito à ProduçãoClaude Agent SDKExaminar conexões de Claude Agent SDK
- Frontends com VibecodingConstruir as cenas do orquestrador, do paralelismo e do robôExaminar conexões de Construir as cenas do orquestrador, do paralelismo e do robô
- Agentes de código para executivosComparar Claude e Gemini depois da troca pelo AntigravityExaminar conexões de Comparar Claude e Gemini depois da troca pelo Antigravity
- Prompt Engineering para ExecutivosCombinar vários modelos com rota, reserva e versão fixadaExaminar conexões de Combinar vários modelos com rota, reserva e versão fixada
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.
Laboratórios ao vivo deste curso
Cada laboratório monta a biblioteca real dentro da aula, com controles para você mexer e o código do exemplo para copiar. O texto de reserva descreve a demonstração para quem lê sem JavaScript. O link abre o capítulo já no ponto do laboratório.
MediaRecorder, Canvas 2D e Long Animation Frames (plataforma)
Grave a cena em tempo real e veja os quadros que se perdem
Suba as partículas, force um bloqueio de 300 ms e grave seis segundos; compare com o render quadro a quadro desta aula.
Pacote
Abrir no capítuloMontar vídeo em HTML com HyperFrames e escolher entre ele e o Remotionsem pacoteMotion
Ver agentes em paralelo trocando mensagens numa linha do tempo
Reproduza a cena, percorra o tempo pelo controle e compare o tempo de parede com a soma das barras de cada agente.
Pacote
Abrir no capítuloParalelizar cenas com subagentes sem estourar o limite das APIsmotionReact (sem dependência extra), com as APIs do Veo e do fal.ai
Prompt de vídeo em cinco camadas, pronto para a API
Escolha plano, câmera, luz, ação e áudio e copie o prompt e o JSON para o Veo ou para o fal.ai.
Pacote
Abrir no capítuloEscrever prompt de vídeo em cinco camadas e manter o personagem consistentereactReact (sem dependência extra), com o comando para o FFmpeg
Corte o vídeo apagando palavras da transcrição
Aperte as palavras para removê-las, ligue a remoção de pausas e copie o comando FFmpeg e a legenda SRT gerados.
Pacote
Abrir no capítuloRemover pausas e reenquadrar o vídeo de 16:9 para 9:16 com legenda por palavrareactReact (sem dependência extra)
Quanto custa cada etapa do seu pipeline de vídeo
Troque a ferramenta de cada etapa e o percentual de b-roll e veja qual etapa pesa no custo por minuto e por vídeo.
Pacote
Abrir no capítuloOrquestrar o pipeline com etapas idempotentes e teto de gastoreact