Bastidores: como este portal de cursos foi construído
Revisado em
Como o portal de cursos deste site é construído e mantido, mostrado por dentro: o motor que transforma arquivos TypeScript em páginas de curso, a pesquisa com fonte, os agentes de código em cópias isoladas, o SEO técnico, o certificado verificável e os portões que reprovam um pull request antes de ele chegar ao ar. Cada capítulo traz telas do portal, trechos reais do repositório e um roteiro para aplicar no seu site de marketing.
Parte 1O que foi entregue
Percorrer o portal no ar e mapear cada peça ao arquivo que a produz.
Este curso mostra por dentro como o portal de cursos de alexandrecaramaschi.com foi construído e é mantido. Cada capítulo pega uma peça que você vê na tela, mostra o arquivo que a produz, explica a decisão e termina com um roteiro para você aplicar no seu projeto de marketing.
Os repositórios do site, do worker que serve brasilgeo.ai e das ferramentas de apoio são privados. Por isso os trechos de código aparecem aqui copiados do repositório, com o caminho do arquivo, e não como link para clonar.
Bastidores do portal: o que foi entregue
O capítulo 1 em vídeo: a promessa do curso, o portal em números contados no repositório em 01/10/2026, da primeira versão de março ao portal de hoje, as telas da página inicial, do catálogo e de brasilgeo.ai, o que roda onde e o inventário do seu site em 20 minutos.
Transcrição
0:00Boas-vindas! Vamos direto ao ponto! Hoje, a gente vai fazer uma visita completa aos bastidores do portal de cursos de alexandrecaramaschi.com. A ideia desta nossa exploração é ver exatamente como tudo foi construído, revisado e publicado.
0:14É um mergulho direto na engenharia e na operação por trás do site, pensado especialmente para quem trabalha com marketing, conteúdo ou produto digital e quer entender, na prática, a mecânica de um portal de cursos.
0:25A promessa do curso, o portal em números, as telas do portal, o que roda onde, como ler o curso e, por fim, o inventário do site. Tudo amarrado diretamente na arquitetura real que faz a operação funcionar.
0:38Começando pela promessa do curso, que é o alinhamento da expectativa sobre o que entregamos aqui. A proposta é pegar cada peça que a gente vê na tela e descer até o arquivo que produz aquilo, explicando as decisões do caminho. Mas tem um detalhe importante.
0:53Como os repositórios são privados, os trechos de código mostrados aparecem sempre como cópias literais contendo o caminho exato do arquivo, sem links para clonar. O portal em números.
1:03Vamos ver a escala real dessa operação com os dados registrados na master no dia 1º de outubro de 2026. O catálogo conta com exatamente 65 cursos. Juntando o conteúdo de todos eles, a gente chega a 1.271 módulos.
1:20Entrando no detalhe da navegação, temos 409 capítulos que possuem uma URL própria, distribuídos em 13 cursos. E para sustentar toda essa estrutura de acesso, são 302 rotas de página. A evolução desse ambiente é bem interessante de notar.
1:38A página de bastidores nasceu em 26 de março de 2026, uma semana depois do primeiro commit, montada com agentes em paralelo. Naquela época inicial, eram apenas oito cursos e 83 módulos. Seis meses depois, o repositório bateu mais de 2.800 commits na master, mais de 5 mil arquivos em src e cerca de 1 milhão e meio de linhas de código.
2:01O que mudou não foi só o volume, mas o jeito inteiro de produzir, revisar e publicar conteúdo. As telas do portal. Agora a gente vai conectar esses dados que moram nos arquivos com o que realmente aparece na interface.
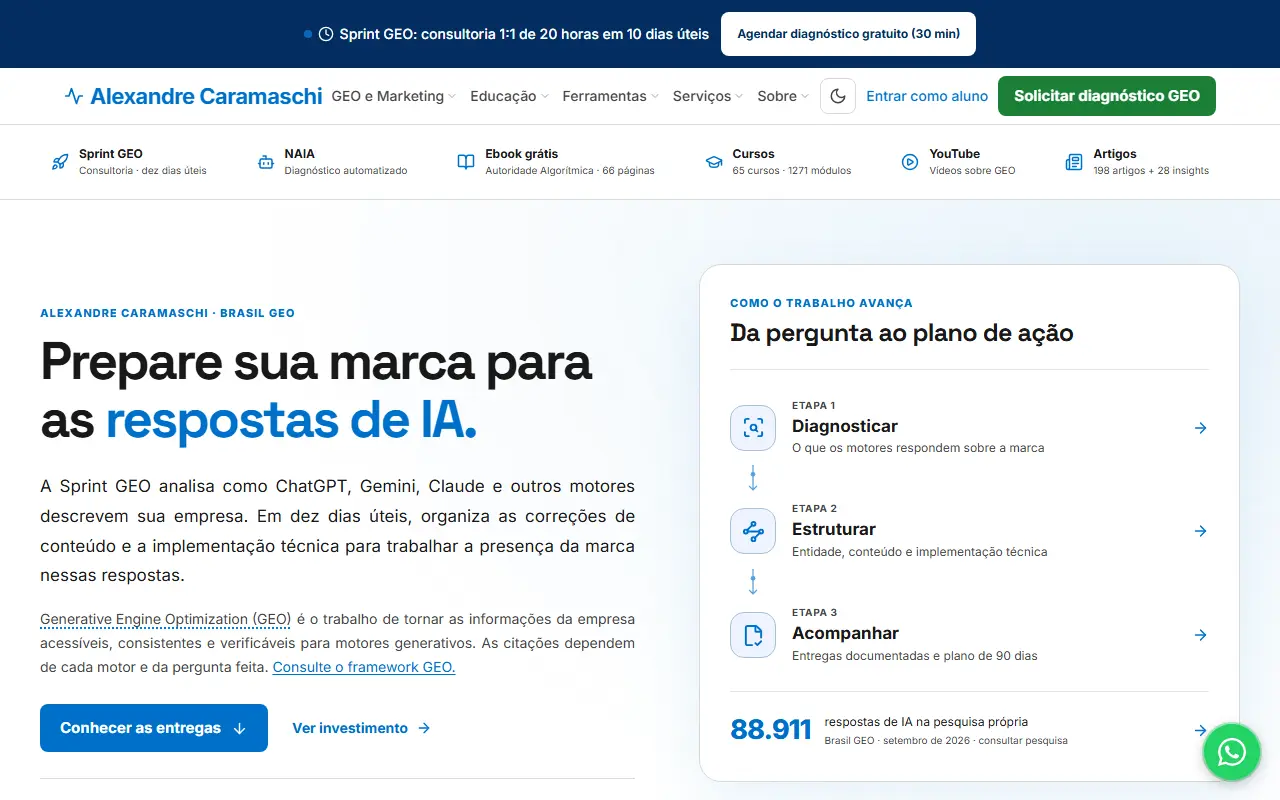
2:15Logo de cara, na página inicial, temos a barra de atalhos mostrando o total de cursos e módulos. E o grande ponto aqui é que esses números saem direto do catálogo no momento do build. Nunca, em hipótese alguma, alguém digita isso à mão no sistema.
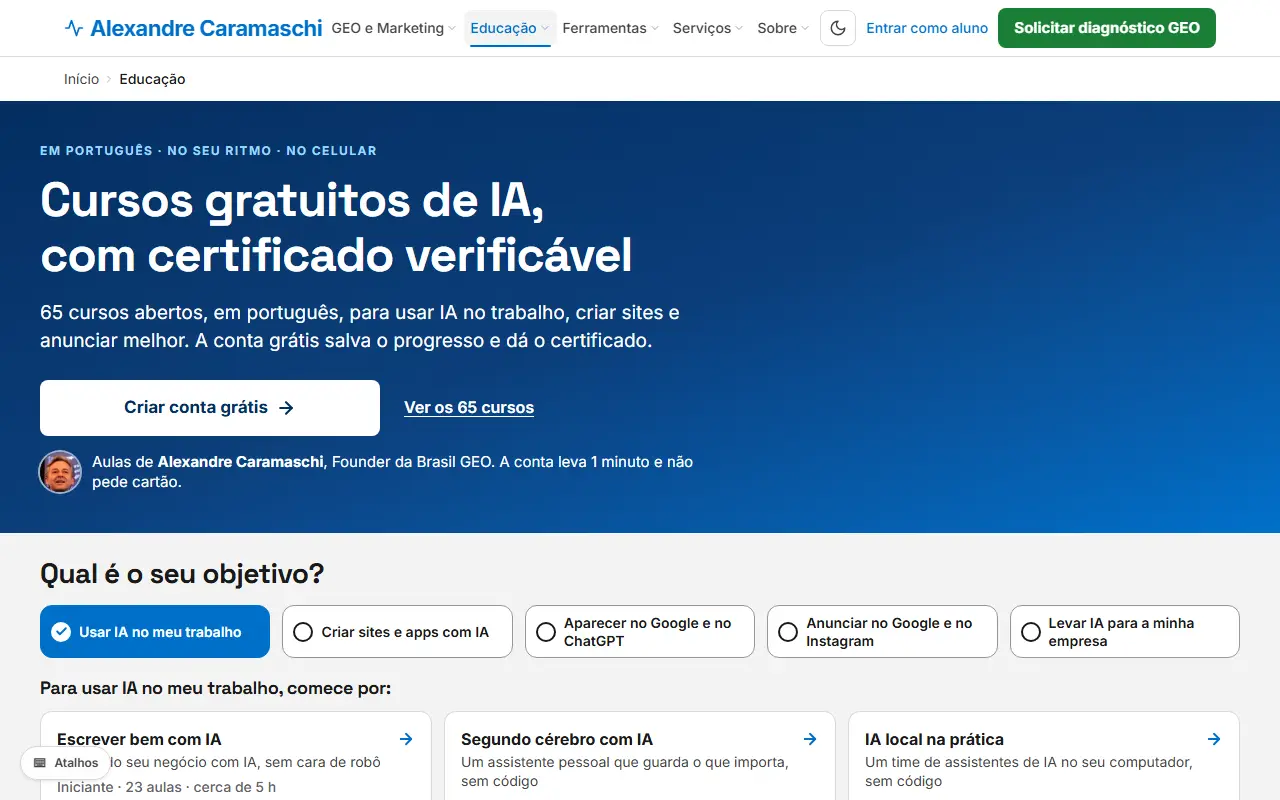
2:29Quando navegamos para o catálogo, não existe aquela lista exaustiva de opções logo na entrada. A primeira coisa que aparece é a pergunta. Qual é o seu objetivo? Cada resposta já filtra a vitrine e organiza tudo numa trilha focada, o que limpa o visual e facilita muito o acesso.
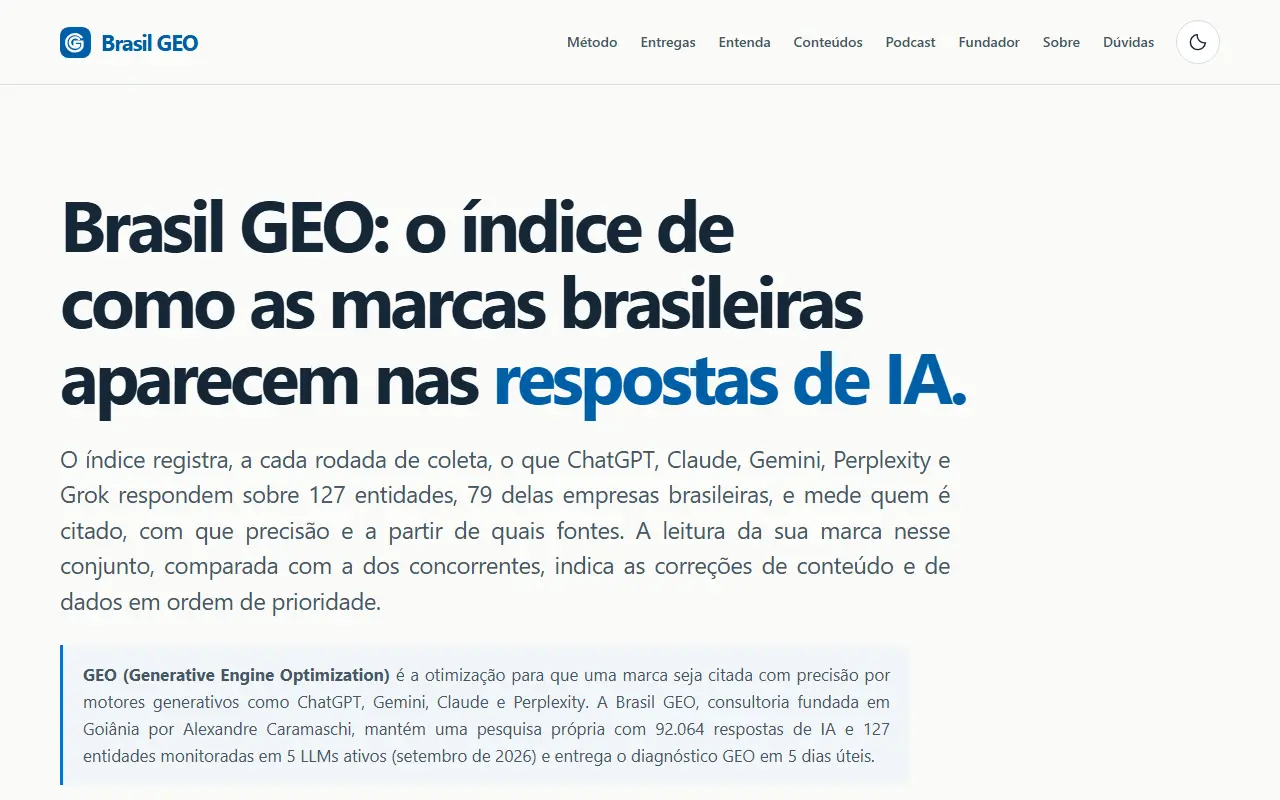
2:46E temos também o segundo site da operação, o brasilgeo.ai. Ele monitora como as marcas aparecem nas respostas de inteligência artificial. Só que essa peça roda de forma totalmente independente, servida por um Cloudflare Worker, a partir de outro repositório privado.
3:02O que roda onde? Com as telas mapeadas, a gente precisa levantar o capô e entender as tecnologias que gerenciam tudo isso. Esta tabela organiza exatamente o motor do projeto. O site e o portal rodam em Next.js, React e Tailwind CSS, hospedados na Vercel.
3:20O brasilgeo.ai fica num Cloudflare Worker. Toda a parte da conta do aluno e de progresso roda no Supabase. O e-mail transacional é disparado pelo Resend. A pesquisa acontece numa banca de modelos por API, enquanto a produção usa o Claude Code com os subagentes divididos em worktrees.
3:37Por fim, os portões de qualidade e o deploy dependem de fluxos no GitHub Actions e na Vercel. Mais adiante, cada uma dessas peças ganha um capítulo exclusivo para explicar como funciona. Como ler o curso Antes de partir para a execução, precisamos deixar as regras do jogo muito claras.
3:54Do que se vê no site até o arquivo interno, a leitura sempre traz o código em cópia literal com o caminho do arquivo. Cada processo indica o critério exato de deu certo e os erros mais comuns.
4:05E todos os cenários ilustrativos mostrados são exemplos montados para simplificar o entendimento, e não dados de clientes reais. O inventário do site. Entramos agora na aplicação prática imediata.
4:18Um mapeamento de 20 minutos do cenário atual antes de qualquer mudança. A gente monta uma planilha bem direta, só com quatro colunas. A peça, a ferramenta, quem mantém e onde mora o dado.
4:30O trabalho começa buscando as 20 páginas de destino com mais tráfego no GA4 nos últimos 90 dias. O sinal de acerto é ter uma lista focada, com endereço, sessões e conversões. A grande armadilha aqui é acabar listando o que a gente acha que é importante, no lugar de mapear o que realmente recebe visita do público.
4:50Na sequência, precisamos anotar onde mora o conteúdo de cada uma dessas páginas. O acerto significa que a linha tem um único lugar de origem. A armadilha que derruba a manutenção é encontrar uma página com o mesmo texto em dois lugares diferentes no CMS ou no código.
5:07No mapeamento da publicação, o objetivo é saber quem publica, como publica e quantos dias uma alteração leva para chegar ao ar. O acerto é ter esse prazo documentado. E a armadilha é um clássico. Confundir o momento em que o material foi aprovado com a hora em que ele realmente foi publicado no servidor.
5:25E, para finalizar esse inventário, escolhemos a primeira peça para transformar em código, geralmente a página com mais tráfego e mais retrabalho. Esse é o acerto da estratégia. A pior armadilha de todas é querer migrar o site inteiro de uma vez só.
5:39E com os números na mesa, as telas mapeadas e o inventário estruturado, o próximo passo é abrir o motor que transforma arquivos TypeScript em páginas de curso.
O que foi entregue, em conversa
Dois apresentadores percorrem o capítulo 1: por que os trechos de código vêm copiados do repositório, os números do portal, a história desde 26/03/2026, a barra de atalhos e o catálogo que abre pela pergunta de objetivo, a tabela do que roda onde e o inventário do site, com as quatro armadilhas.
Transcrição
0:00Então, nossa análise de hoje vai abrir as portas de um projeto bem interessante Com certeza! A gente vai explorar o primeiro capítulo do curso Bastidores: como este portal de cursos foi construído Isso! E o título desse capítulo inicial já vai direto ao ponto, né? Ele se chama O que foi entregue: o portal em telas Exato! E a promessa desse material é mostrar por dentro como o portal de cursos do domínio alexandrecaramaschi.com foi construído E não só construído, né? Como ele é mantido no dia a dia É bem focado em quem trabalha com marketing, conteúdo ou mesmo produto digital.
0:34A dinâmica que o texto propõe é bem prática. Cada capítulo pega uma peça específica, que a pessoa vê na tela, e mostra o arquivo exato que produz aquilo. Sabe que me lembra muito a ideia de visitar a cozinha de um restaurante que faz sucesso antes de decidir qual receita levar para a própria operação.
0:51É bem por aí. O material explica a decisão por trás de cada peça e sempre termina com um roteiro prático para quem lê aplicar no próprio projeto. Só que a gente precisa dar um aviso super importante logo de cara. Ah, sobre os repositórios, verdade.
1:04Isso. Os repositórios do site do Worker que serve o brasilgeo.ai e das ferramentas de apoio são todos privados. Totalmente fechados. E, por conta disso, os trechos de código que aparecem no material são copiados do repositório, sempre com o caminho do arquivo no topo.
1:20Não tem aquele link fácil para clonar o projeto inteiro, sabe? É, não tem. Mas para entender o peso dessa operação que eles estão abrindo, a gente precisa olhar para os números que o projeto alcançou. Pois é, eu achei esses dados bem chamativos.
1:33O texto traz um retrato baseado no repositório no dia 1º de outubro de 2026. E os números na vitrine são grandes. A contagem no catálogo marcava 65 cursos. Caramba, 65. E quando a gente soma tudo, dá 1.271 módulos. Muita coisa.
1:50E o texto também detalha como isso se divide, né? Sim. São 409 capítulos com URL própria, que ficam divididos em 13 cursos. Ah, tá. E na parte de estrutura de rotas de página, o sistema conta 302 rotas.
2:05Olha, ver isso pronto é uma coisa, mas o contraste com o histórico do projeto é o que mais chama atenção. É, a história curta deles, né? Isso. A página de bastidores nasceu no dia 26 de março de 2026.
2:16Isso foi só uma semana depois do primeiro commit do repositório. E eles criaram para registrar uma sessão onde oito cursos foram montados em paralelo, usando agentes. Exato. Naquela época, o projeto inteiro contava só com oito cursos e 83 módulos.
2:31E aí a gente pula para seis meses depois, naquele mesmo repositório, e o salto é visível. Conta os números de seis meses depois, porque são muitos dígitos. Olha, na master, que é a linha principal, eles bateram 2.825 alterações, os commits. Nossa.
2:45E na pasta src, que guarda os arquivos de código, o número chegou a 5.150 arquivos. E em linhas de código? Cerca de 1 milhão e meio de linhas de código, já contando os arquivos de dados que são gerados por script.
2:59É uma mudança bem radical de escala em só seis meses. Muito, mas a conclusão do texto sobre isso é bem direta. O que mudou de verdade não foi só o volume, sabe? Mudou a forma de trabalhar.
3:10Exatamente. Mudou o jeito de produzir, de revisar e de publicar o conteúdo. Faz sentido. E se o jeito de publicar mudou tanto, como fica a fachada disso tudo? As telas do portal que estão no ar? A experiência de quem visita, né?
3:24Isso. Começando pela página inicial de alexandrecaramaschi.com. Logo de cara, tem uma barra de atalhos. E essa barra mostra um número certinho de cursos e de módulos disponíveis. E tem um detalhe da engenharia ali que é fundamental. Ah, de não digitar o número.
3:39É. O texto frisa que esse número nunca é digitado à mão por alguém da equipe. Ele sai do catálogo na hora do build, né? Exato. O sistema puxa a informação real do catálogo no momento de montar a página. O que tira muito trabalho braçal de manutenção.
3:53E falando em catálogo, o catálogo de cursos deles tem uma lógica bem diferente. Sim. Ele não joga a lista de 65 cursos de uma vez na tela da pessoa. Ele abre fazendo uma pergunta, não é? Isso. A primeira coisa é a pergunta. Qual é o seu objetivo?
4:08Achei essa abordagem muito boa para não sobrecarregar quem navega. Pois é, e cada opção que a pessoa clica atua como um filtro. Ele direciona a vitrine para uma trilha específica. Como se fosse um caminho guiado.
4:20Isso. O texto cita exemplos como a trilha Usar IA no meu trabalho, ou então Anunciar no Google e no Instagram. Muito prático. E a segunda peça dessa operação que está no ar é o site brasilgeo.ai. Ah, sim. Esse site é servido por um Cloudflare Worker, e o código dele vem de um outro repositório privado.
4:39Não fica junto do portal. E a função dele é bem específica, né? É, ali se apresenta como um índice para mostrar como as marcas brasileiras aparecem nas respostas de IA.
4:48Bom, a gente falou bastante das telas, mas eu sei que quem cuida de sites fica logo pensando no motor, o que roda onde, peça por peça. Esse mapa da arquitetura é a parte mais técnica do capítulo. Vamos bater uma bola rápida sobre as ferramentas? Vamos.
5:03Começando pelo site e o portal de cursos, a base principal. Eles rodam usando Next.js, React e Tailwind CSS, tudo isso hospedado na Vercel. Perfeito. E o material deixa claro que há um capítulo adiante que explica bem essa parte. Joia.
5:19E aquele segundo site, o brasilgeo.ai, ele roda direto no Cloudflare Worker. E para quem quer entender como ele funciona, há um capítulo adiante no curso só sobre isso.
5:30Uhum. Aí, entrando na área do aluno, a parte de conta, do progresso nas aulas e do certificado, tudo isso usa o Supabase. Banco de dados, né? Isso. E o texto avisa que há um capítulo adiante para explicar essa integração do Supabase também.
5:45Bom, toda plataforma precisa mandar e-mail, certo? O e-mail transacional deles sai pelo Resend e, claro, há um capítulo adiante no material explicando esse envio. Agora, a parte de pesquisa e redação com fontes. Eles usam uma banca de modelos por API.
6:00E tudo isso roda em scripts fora do site principal. Não pesa o site, então. Exato. E o curso tem um capítulo adiante que explica toda essa estrutura. A parte de produção dos cursos em si, que é a linha de montagem, usa o Claude Code e funciona com subagentes e worktrees.
6:15E como é a divisão disso? Eles deixam uma pasta de trabalho separada por agente, para organizar. E quem quiser aprofundar, há um capítulo adiante focado em explicar isso. Para fechar a infraestrutura, tem a parte de portões de qualidade e o deploy, que ficam no GitHub Actions e também na Vercel.
6:31E, sim, há um capítulo adiante para explicar como isso é configurado. Com tanta peça diferente, o próprio curso traz uma instrução de como ler e absorver esse material, né? É, e o formato é super consistente.
6:44Todo capítulo sempre abre mostrando primeiro o que se vê no site. A interface visual. Isso. E aí ele desce até chegar no arquivo exato que gerou aquilo. E como os repositórios são privados, Os trechos de código que eles colocam lá são cópias literais.
6:59E eles vêm com o caminho do arquivo para dar contexto. E eu acho os guias de passo a passo deles bem pragmáticos. Eles não dão só o que fazer. Eles sempre trazem o critério de deu certo. E já avisam qual é o erro mais comum ali.
7:12Sabe aquele manual de montar móvel que avisa exatamente em qual buraco o parafuso costuma entrar torto? É essa a sensação. Ajuda muito. Nossa, ajuda demais. E tem um aviso importante sobre os estudos de caso que aparecem no material.
7:26Ah, sim, sobre os cenários, né? Isso. Os casos que estão marcados como cenário ilustrativo são exemplos montados só para aprendizado. O texto deixa claro que não são clientes reais da operação.
7:37Bom, sabendo como ler, o capítulo convida quem está acompanhando a olhar para o próprio site. É o exercício prático que eles chamam de inventário. É a hora de botar a mão na massa. E é para fazer o inventário do próprio site em uns 20 minutos.
7:50Usando uma planilha simples, né? Sim, só há quatro colunas. A pessoa anota qual é a peça, qual ferramenta roda aquilo, quem mantém e onde mora o dado. Então, a primeira tarefa é listar as páginas.
8:03Tem que ser as páginas que recebem tráfego pago ou tráfego orgânico. E o texto dá um direcionamento claro de onde tirar isso. A ideia é pegar as 20 primeiras páginas a partir do relatório de páginas de destino do GA4, olhando para os últimos 90 dias.
8:16Só que aí, o material aponta uma armadilha logo de cara. Aquela clássica de ego de projeto. Exato. A armadilha é listar as páginas que a equipe acha que são importantes, tipo a página institucional, e não as páginas que realmente recebem as visitas de fora.
8:32Os dados não mentem. Passando dessa fase, a próxima tarefa é anotar onde mora o conteúdo de cada uma dessas 20 páginas. Onde o texto está salvo, né? Isso. Se ele vive num CMS, se está num construtor de páginas, solto no código do repositório ou até numa planilha.
8:48E por que essa coluna é tão importante no exercício? Porque é ela que decide se um agente de código vai conseguir editar a página no futuro. E aqui tem outra armadilha mapeada. Qual? É quando a página tem o texto salvo em dois lugares diferentes.
9:01O agente vai lá, corrige a informação de um lado e a página continua errada no ar porque o dado puxa do outro lugar. Olha, dor de cabeça certa se não mapear isso. Aí, depois de mapear onde o dado mora, a pessoa tem que marcar quem publica aquele conteúdo e como ele é publicado.
9:17É entender o fluxo. E o objetivo principal aqui é medir o tempo médio entre pedir uma mudança na página e finalmente ver essa mudança no ar. E a armadilha dessa etapa é bem comum no dia a dia. Confundir o conteúdo que está aprovado com o conteúdo publicado.
9:31Exato. Porque o que conta não é o ok do revisor. A pergunta é, quando a página que o servidor entrega de fato mudou na tela? Bom, no fim do inventário, a missão é tomar uma decisão. Escolher a primeira peça que vai ser trazida para o código nesse modelo novo.
9:45Só uma peça para começar? Sim, e o critério que eles recomendam é cruzar duas coisas. Tem que ser a página com mais tráfego e que dá mais retrabalho. Junta o útil ao agradável. Mas tem que cuidar com a última armadilha, que o texto alerta bastante.
9:59É, não dá para tentar migrar o site inteiro de uma vez só. Senão a equipe fica semanas agarrada na estrutura sem conseguir publicar nada de novo no site. Tem que fazer aos poucos mesmo. E depois de passar por todo esse exercício, quem acompanhou a leitura chega no checkpoint do capítulo.
10:14Fechando essa primeira etapa. Isso, porque quem leu até aqui conseguiu percorrer as telas do portal no ar, entendeu de onde vêm aqueles números da vitrine e sabe qual capítulo do curso explica cada peça dessa estrutura. Fica tudo bem mapeado.
10:28E o texto já deixa o gancho para o que vem pela frente. O próximo passo lógico do material é abrir um motor que pega os arquivos TypeScript e transforma tudo em páginas de curso. Vai direto na linha de produção. Vai ser bem técnico e prático.
10:42Bom, a gente vai ficando por aqui. Obrigada a todos que acompanharam e que cuidam de sites no dia a dia e estão aí buscando refinar as operações digitais. É isso aí. Um abraço para todo mundo e até a nossa próxima análise. Tchau, tchau.
O portal em números, contados em 01/10/2026
65
cursos no catálogo
src/data/educacao-courses.ts
1.271
módulos somados
campo modules de cada curso
409
capítulos com URL própria
13 cursos no registro do motor
302
rotas de página
arquivos page.tsx em src/app
Fonte: Contagem no repositório landing-page-geo, branch master de 01/10/2026: entradas do catálogo, manifesto src/generated/course-chapters.json e git ls-files.
Da primeira versão ao portal de hoje
A página de bastidores nasceu em 26/03/2026, uma semana depois do primeiro commit do repositório, para registrar a sessão em que oito cursos foram montados com agentes em paralelo. Aquela versão contava 8 cursos e 83 módulos. Seis meses depois, o mesmo repositório tem 2.825 commits na master, 5.150 arquivos .ts e .tsx em src/ e cerca de 1,5 milhão de linhas, contando os arquivos de dados gerados por script e versionados. O que mudou não foi só o volume: mudou o jeito de produzir, revisar e publicar, e é isso que os capítulos seguintes mostram.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
O que roda onde
| Peça | Tecnologia em 01/10/2026 | Onde está | Capítulo que explica |
|---|---|---|---|
| Site e portal de cursos | Next.js 16.3.8, React 19.2.7, Tailwind CSS 4.3 | Vercel, repositório privado landing-page-geo | "O motor de cursos: conteúdo como código" |
| brasilgeo.ai | Cloudflare Worker | Cloudflare, repositório privado brasilgeo-worker | "SEO técnico: JSON-LD, sitemap, lastmod e llms.txt" |
| Conta do aluno, progresso e certificado | Supabase Auth e Postgres | Rotas em src/app/api | "Conta, progresso, certificado e gamificação" |
| E-mail transacional | Resend | Rota /api/certificate e formulário de contato | "Conta, progresso, certificado e gamificação" |
| Pesquisa e redação com fonte | Banca de modelos por API | Scripts fora do site | "Banca de modelos: pesquisa e redação com fonte" |
| Produção de cursos | Claude Code com subagentes e worktrees | Uma pasta de trabalho por agente | "Agentes em worktrees: produção em paralelo" |
| Portões de qualidade e deploy | GitHub Actions e Vercel | .github/workflows e scripts/ | "Gates do CI e deploy sem surpresa" |
Fonte: package.json e node_modules do repositório em 01/10/2026; cabeçalho Server das duas páginas iniciais.
Como ler este curso
- Cada capítulo abre com o que você vê no site e desce até o arquivo que produz aquilo.
- Os trechos de código são cópias literais, com o caminho do arquivo no comentário da primeira linha.
- Os blocos de passo a passo trazem o critério de "deu certo" e o erro mais comum, para você conferir sem depender de ninguém.
- Os casos de marketing marcados como cenário ilustrativo são exemplos montados para mostrar a aplicação, e não clientes reais.
Fazer o inventário do seu próprio site em 20 minutos
Antes de copiar qualquer peça deste portal, descubra o que o seu site já tem. Use uma planilha com quatro colunas: peça, ferramenta, quem mantém e onde mora o dado.
Passo 1: Liste as páginas que recebem tráfego pago ou orgânico
Abra o relatório de páginas de destino do GA4 dos últimos 90 dias e copie as 20 primeiras.
Deu certo quando: A lista tem endereço, sessões e conversões de cada página.
Erro comum: Listar as páginas que você acha importantes, e não as que recebem visita.
Passo 2: Anote onde mora o conteúdo de cada uma
CMS, construtor de páginas, código no repositório ou planilha. É essa coluna que decide se um agente de código consegue editar a página.
Deu certo quando: Cada linha tem um único lugar de origem.
Erro comum: Página com texto em dois lugares: o agente corrige um e o outro continua errado no ar.
Passo 3: Marque quem publica e como
Publicação manual, deploy automático a cada commit ou agência. Escreva o tempo médio entre pedir uma mudança e vê-la no ar.
Deu certo quando: Você sabe quantos dias uma correção de preço leva para chegar ao site.
Erro comum: Confundir "aprovado" com "publicado". A pergunta é quando a página servida mudou.
Passo 4: Escolha a primeira peça a trazer para código
Comece pela página com mais tráfego e mais retrabalho. "O motor de cursos: conteúdo como código" mostra como montar o molde, e "Agentes em worktrees: produção em paralelo" mostra como produzir as próximas.
Deu certo quando: Há uma página escolhida, com o motivo escrito numa frase.
Erro comum: Migrar o site inteiro de uma vez e ficar semanas sem publicar nada.
No fim você tem: Uma planilha de inventário que mostra o que já existe, onde está e por onde começar.
Você percorreu as telas do portal no ar, conferiu de onde vêm os números da vitrine e sabe qual capítulo explica cada peça. O próximo passo é abrir o motor que transforma arquivos TypeScript em páginas de curso.
Parte 2Como o conteúdo é produzido
O motor de cursos, a banca de modelos com fonte e os agentes em cópias de trabalho isoladas.
Parte 3Como chega aos buscadores e aos alunos
SEO técnico, conta do aluno, certificado verificável e medição da leitura.
Parte 4Como se mantém no ar e como replicar
Portões automáticos, filtro de build, conferência na página servida e o plano de quatro semanas.