Qual programa escolher para rodar a IA no Mac
Compare Ollama e MLX pela instalação, pela manutenção e pelo uso da pousada.
Este capítulo faz parte do curso gratuito Segundo cérebro com IA.
Quem instala, atualiza e recupera o serviço quando o responsável estiver de folga? Essa pergunta decide o programa que roda o modelo no Mac. Escolha esse programa com o técnico e aceite um modelo local só depois de uma prova em português, repetida três vezes e conferida no registro das chamadas. No Mac, a escolha é entre o Ollama e o MLX, e ela se faz pelo uso, não pela velocidade: quem vai instalar, quem vai cuidar da máquina depois e o que a recepção vai pedir a ela todo dia.
Esse programa se chama runtime (o programa que faz o modelo funcionar no computador). Pense no motor de um carro: o modelo é o combustível, e sem motor ele fica parado no tanque. O Ollama (programa que baixa e roda modelos no seu computador) atende quem quer instalar e usar. O MLX (ferramentas da Apple para rodar IA nos chips dela) atende quem programa.
Ver como texto
Dois motores dentro do Ollama e o MLX usado direto, fora dele
Uma caixa grande, o Ollama, programa que baixa e roda modelos. Dentro dela, dois motores lado a lado: llama.cpp, motor aberto, e MLX, motor da Apple. Abaixo, fora do Ollama, o MLX usado direto, para quem programa em Python. Rodapé: motor MLX no Ollama desde 30 de março de 2026.
Dentro do Ollama, o MLX já é um dos motores, ao lado do llama.cpp.
O que muda entre o Ollama e o MLX na hora de rodar um modelo?
Muda quem mexe na máquina, e, com uma pergunta por vez, muda pouco a velocidade. O MLX é a base aberta que a equipe de pesquisa da Apple publicou em novembro de 2023. Sozinho, ele não conversa com a recepção: quem roda um modelo em cima dele é um pacote para Python (linguagem em que o técnico escreve as instruções) ou um programa pronto, como o Ollama e o LM Studio.
Ver como texto
Repositório do MLX no GitHub, com a descrição do conjunto de ferramentas da Apple para aprendizado de máquina nos chips Apple Silicon.
Ver como texto
Página inicial do LM Studio, aplicativo de computador para baixar e conversar com modelos de IA rodando na própria máquina.
Já o Ollama junta tudo num aplicativo. Até março de 2026, ele rodava os modelos no Mac com o llama.cpp (o motor aberto que roda modelos em computador comum); desde então ganhou o motor do MLX, e as notas de versão de outubro de 2026 mostram o MLX atendendo famílias de modelos específicas, ao lado do llama.cpp. O programa muda quase todo dia: a versão 0.40.11 saiu em 24 de outubro de 2026, um dia depois da 0.40.10. Sobre a velocidade, as medições são de terceiros e apontam para lados diferentes, como mostra o teste de Zach Rattner, publicado no blog dele.
Ver como texto
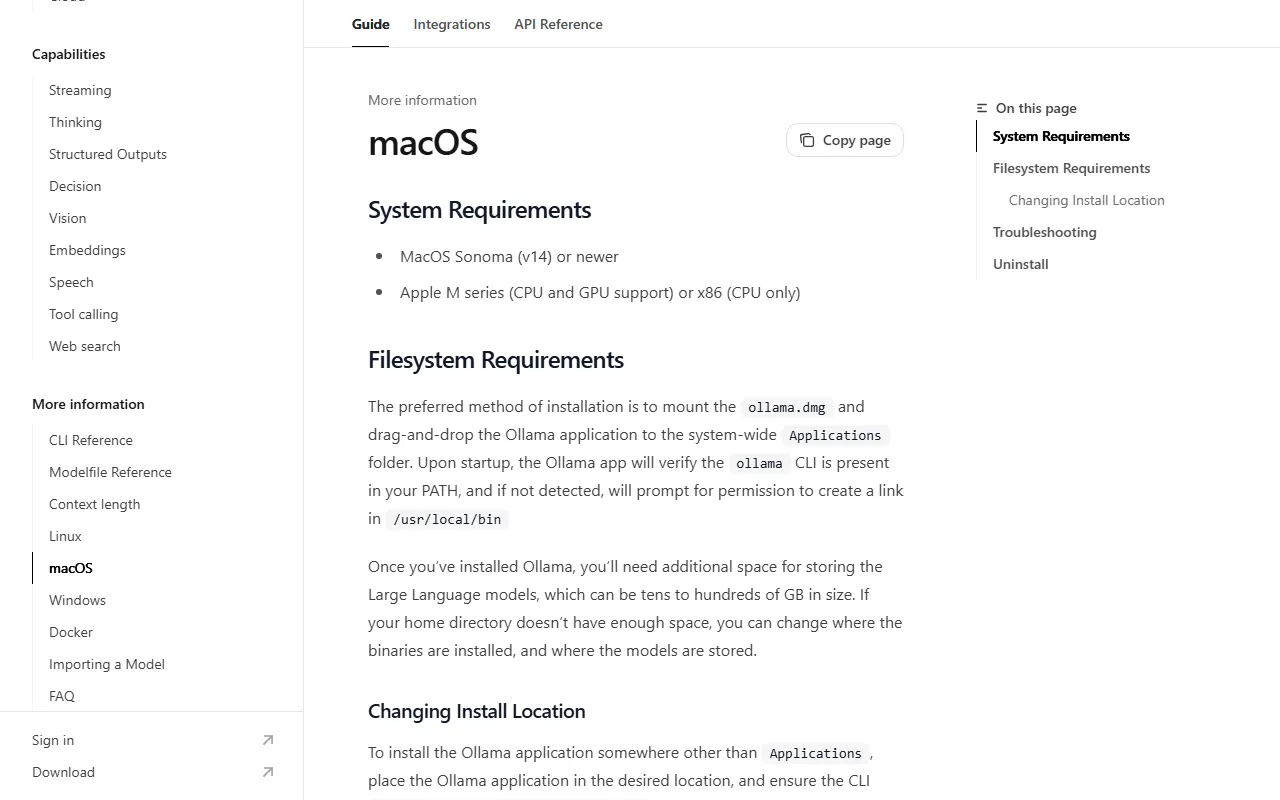
Documentação do Ollama para macOS, com requisitos do sistema, instalação do aplicativo e onde ficam os arquivos dos modelos.
| Modelo testado | MLX | Ollama |
|---|---|---|
| 27 bilhões, compactado em 4 bits | 30,89 tokens por segundo | 21,91 tokens por segundo |
| O mesmo, compactado em 8 bits | 19,53 tokens por segundo | 20,41 tokens por segundo |
| 30 bilhões, mistura de especialistas, 4 bits | 68,08 tokens por segundo | 83,32 tokens por segundo |
Medição de terceiro num Mac Studio com M1 Ultra e 128 GB. Token é o pedaço de palavra que o modelo escreve; mistura de especialistas é o modelo que liga só uma parte de si a cada token.
Um ganhou, um empatou e um perdeu. Para Rattner, a quantização (compactar o modelo, como salvar uma foto em qualidade menor) pesa mais do que o programa. Quem promete que um dos dois é sempre o mais veloz no Mac precisa dizer em qual modelo e em qual compactação mediu.
Com vários pedidos ao mesmo tempo, o programa pesa mais: num teste de setembro de 2026 num Mac com M5 Pro de 64 GB, o pacote que roda o MLX direto concluiu só 2 de 100 pedidos de agente sob carga alta, e o Ollama, rápido na conversa, ficou fora dos critérios mínimos do estudo. Se o agente passar a atender vários pedidos juntos, o técnico repete o teste com carga.
A conta que decide é a da memória, a mesma usada para escolher a máquina: parâmetros vezes bits, dividido por oito, mais até 20% e o espaço da conversa. Na estreia do motor MLX, o Ollama pediu Mac com mais de 32 GB para um modelo de 35 bilhões de parâmetros, que em 4 bits pesa perto de 17,5 GB antes da folga.
Ver como texto
A pergunta da recepção vai ao Mac do escritório e volta sem sair da pousada
Um contorno tracejado marca o que fica dentro da pousada. Dentro dele, três etapas ligadas por setas: a recepção faz a pergunta, o Mac do escritório roda o programa e o modelo, e a resposta volta à recepção. A ficha do hóspede fica dentro do contorno. Fora dele, a internet, que não entra no caminho.
Nos dois programas o caminho curto do desenho é o mesmo, e a pergunta sobre o cliente não sai do escritório.
Como decidir entre os dois pelo uso da recepção
A diferença aparece em quem instala e em quem mantém. Na pousada de exemplo, os dois programas acertaram a mesma pergunta de reservas com poucos segundos de diferença. O Ollama ficou porque entrou no Mac como qualquer aplicativo e a recepção aprendeu a reabri-lo sozinha; o MLX direto pedia Python e um pequeno programa que só o técnico entende.
| Critério | Ollama | MLX direto |
|---|---|---|
| Para quem | Quem quer instalar e usar | Quem programa em Python |
| O que é | Programa que baixa e roda modelos | Ferramentas da Apple para IA |
| Motor no Mac | llama.cpp e MLX | O próprio MLX |
| Quem cuida depois | Você ou a recepção | O técnico |
| Arrumar dados em campos fixos | Aceita formato fixo de resposta | Pede um programa do técnico |
Critérios da pousada de exemplo; a velocidade ficou fora porque os testes não apontam um vencedor fixo.
Se quem cuida da máquina é você ou a recepção, fique com o Ollama. Se houver um técnico que programa e quer ajustar o modelo, o MLX direto passa a compensar; ele pede o Python, e o curso "Setup de Vibecoding no Mac" ensina a instalar o Python no Mac, tela por tela. O mesmo Ollama roda modelos pequenos, de menos de 1 a 4 bilhões de parâmetros, que ocupam de 1 a 3,4 GB e arrumam as mensagens do dia em fichas de campos fixos.
Como aceitar um modelo local com uma prova em português
O programa escolhido não diz se o modelo serve. A prova serve quando é escrita em português, do jeito que o cliente escreve, e quando a resposta certa vira itens de sim ou não. Pesquisadores da Maritaca AI, empresa brasileira que desenvolve modelos avaliados no estudo, e do Jusbrasil trocaram a nota geral por esses itens em 1.000 conversas reais em português, em maio de 2026: com os itens, três juízes de famílias diferentes concordaram na ordem inteira dos modelos, o que a nota geral não conseguiu.
Duas práticas completam a prova. Do τ-bench, prova de 2024 da Sierra, empresa americana que vende agentes de atendimento, vem a repetição: a tarefa só conta se passar em todas as tentativas. De um estudo de julho de 2026 da VAIV Company e da Universidade Nacional de Seul, na Coreia do Sul, vem o registro: em 4 bits, a nota pode empatar enquanto crescem as chamadas a ferramentas que não existem. As telas de instalação estão no curso "IA Local na Prática", em as ferramentas que instalam clicando, sem terminal.
Aceitar um modelo local em sete passos
O técnico instala e roda; você escreve a prova e confere a folha.
Passo 1: Escreva dez perguntas reais em português, com a resposta certa ao lado
Do jeito que o cliente escreve, com a resposta tirada da planilha ou das fichas.
Passo 2: Transforme cada resposta certa em itens de sim ou não
Disse a diária de R$ 480? Ofereceu o quarto 3? Citou o horário do check-in?
Deu certo quando: Cada pergunta tem de dois a quatro itens que qualquer pessoa confere.
Passo 3: Peça ao técnico o Ollama pelo site oficial e um modelo da biblioteca que caiba com folga
Some até 20% ao tamanho do arquivo e deixe espaço para a conversa; se o modelo for usar ferramentas, confira na página dele se aceita.
Erro comum: Modelo maior que a memória deixa tudo lento, e arquivo baixado solto fica sem as regras da biblioteca.
Passo 4: Desligue a internet e rode as dez perguntas
Confira também nas opções do programa se o histórico de pedidos está desligado.
Deu certo quando: As respostas saem sem internet: o modelo roda dentro do escritório.
Passo 5: Rode cada pergunta três vezes e anote o tempo de cada resposta
Deu certo quando: A pergunta só conta como certa se passar nos itens as três vezes.
Passo 6: Peça o registro das chamadas de ferramenta e conte as erradas
Ferramenta que não existe ou campo preenchido errado.
Erro comum: O erro mais comum é olhar só a resposta; o conserto é uma coluna da folha só para o registro.
Passo 7: Fique com o menor modelo que acerta as três vezes e não chama ferramenta que não existe
Deu certo quando: A folha mostra o modelo, a versão, a compactação e zero chamada inexistente.
No fim você tem: Um modelo aceito por prova, rodando no Mac do escritório sem mandar nada pela internet.
Se dois modelos empatam nos acertos, fique com o que erra menos nas chamadas. Se um modelo acerta em inglês e erra em português, ele não serve ao balcão. O teste com a internet desligada prova que a ficha não saiu pela rede, mas não diz o que o programa gravou no Mac: num teste de setembro de 2026, pesquisadores acharam os pedidos guardados em arquivo pelo LM Studio na configuração padrão, e nenhum pedido guardado nem tentativa de falar com a internet no Ollama.
Guarde a folha com o nome e a versão exata do modelo, porque ela vira a linha de partida de qualquer troca. Como o programa muda depressa, as datas abaixo mostram em que pé ele está.
Como o MLX chegou ao Ollama
- 28 de novembro de 2023Concluído
A Apple abre o código do MLX
Ferramentas de IA para os chips da Apple, com licença aberta.
- 30 de março de 2026Concluído
O Ollama ganha o motor MLX em prévia
Para Mac com mais de 32 GB de memória.
- Outubro de 2026Agora
Versões quase diárias da série 0.40
As notas citam o MLX atendendo famílias de modelos específicas no Mac; a 0.40.11 saiu em 24/10/2026.
A linha do tempo explica por que você não precisa escolher motor: o Ollama decide qual usar em cada modelo. Combine com o técnico quem atualiza o programa, em que dia da semana, e repita a prova a cada versão nova do modelo.
A escolha está pronta quando a folha mostra as dez perguntas certas nas três rodadas, nenhuma chamada a ferramenta inexistente e as respostas saindo com a internet desligada. Se algo der errado no primeiro dia, o curso "IA Local na Prática" reúne as soluções rápidas para quando o programa ou o modelo falham. Com o modelo rodando dentro de casa, abra “Como testar um alerta de queda do Wi-Fi para a equipe” e liste os aparelhos que você quer que ele vigie.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoMCP para quem decidesugerido pelo grafo3 capítulos de “Segundo cérebro com IA” usam conceitos apresentados em “MCP para quem decide”.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafo2 capítulos de “Segundo cérebro com IA” usam conceitos apresentados em “Setup Completo: do zero ao Claude Code (Windows)”.
- CursoAgentes de IA autônomos: como delegar e acompanharsugerido pelo grafo2 capítulos de “Segundo cérebro com IA” usam conceitos apresentados em “Agentes de IA autônomos: como delegar e acompanhar”.
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.