Avaliar e melhorar agentes · ·
Encontrar o que os testes ainda não cobrem
Trate a ausência de falha como evidência limitada ao que foi testado.
Este capítulo faz parte do curso gratuito Avaliar e melhorar agentes.
Uma bateria de testes é um conjunto de verificações. Quando todas passam, você sabe que aqueles casos atenderam aos critérios. Ainda é preciso perguntar o que ficou fora: acessibilidade, dados inesperados, situações raras ou um comportamento que depende de outro serviço.
Ver como texto
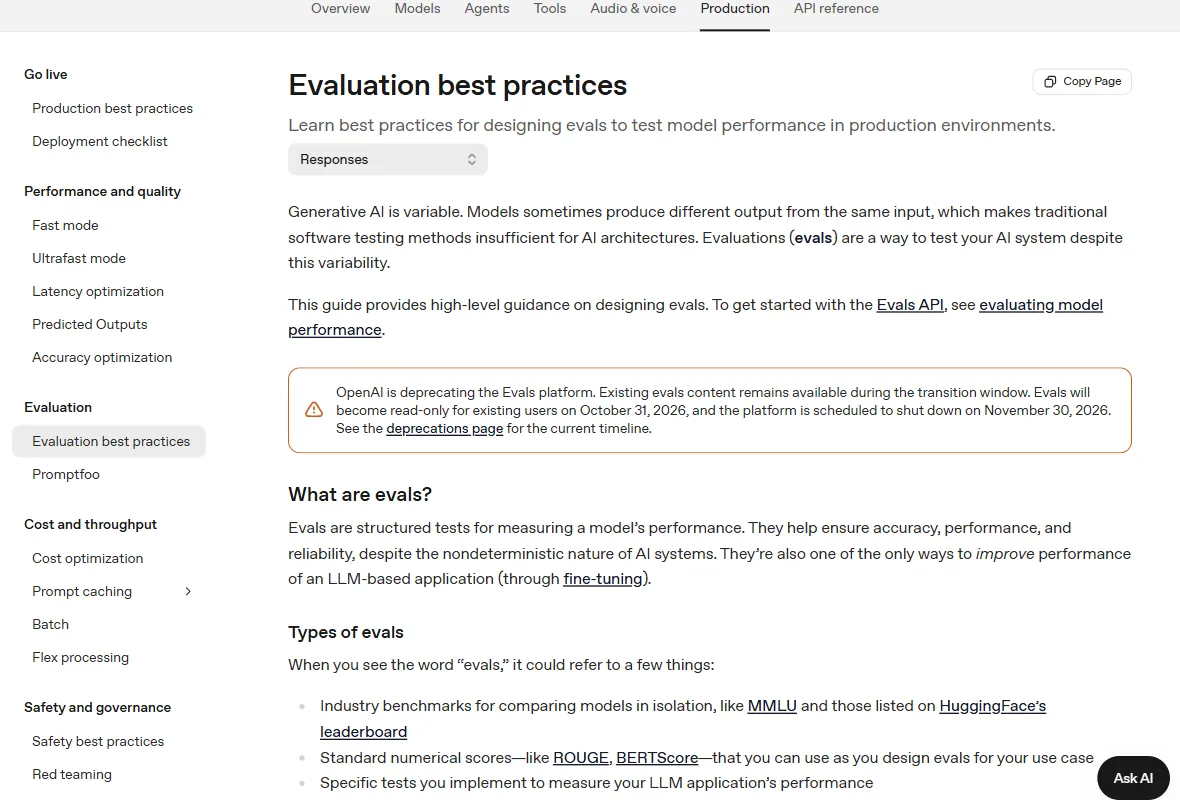
Guia da OpenAI de boas práticas de avaliação de sistemas de IA, com etapas e critérios para comparar resultados.
Você decide aqui quem, com nome e sobrenome, responde pela parte da qualidade que nenhum teste consegue medir. Se ninguém for nomeado, essa parte fica sem dono.
Mantenha um registro das limitações conhecidas e do responsável por cada uma. Isso permite escolher uma liberação menor quando o risco restante ainda é alto. A avaliação ganha valor quando informa também onde não consegue concluir.
Ver como texto
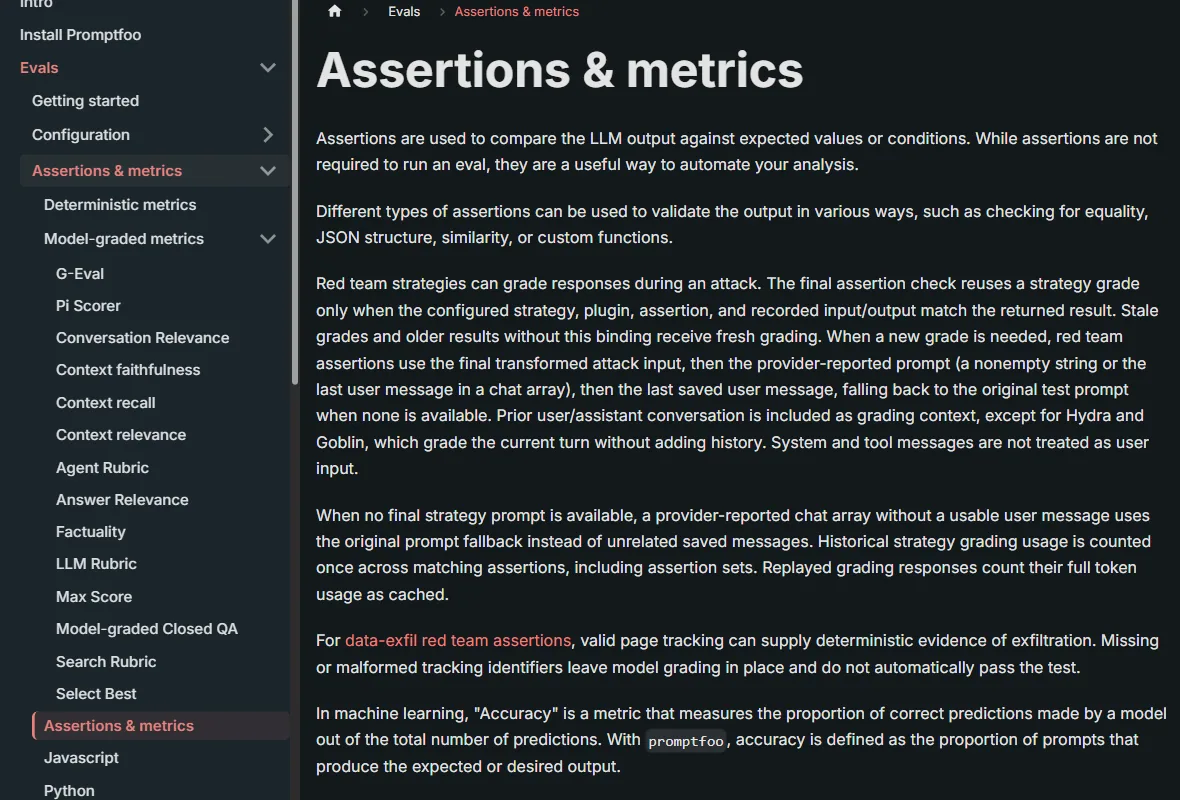
Documentação do Promptfoo mostrando verificações determinísticas e métricas avaliadas por modelos.
Exemplo: o formulário funciona com nomes curtos, mas ninguém testou nomes compostos e caracteres acentuados. O resultado verde não responde a esses casos. A equipe os acrescenta antes da publicação e guarda os exemplos para impedir que uma atualização futura reintroduza o defeito.
Ver como texto
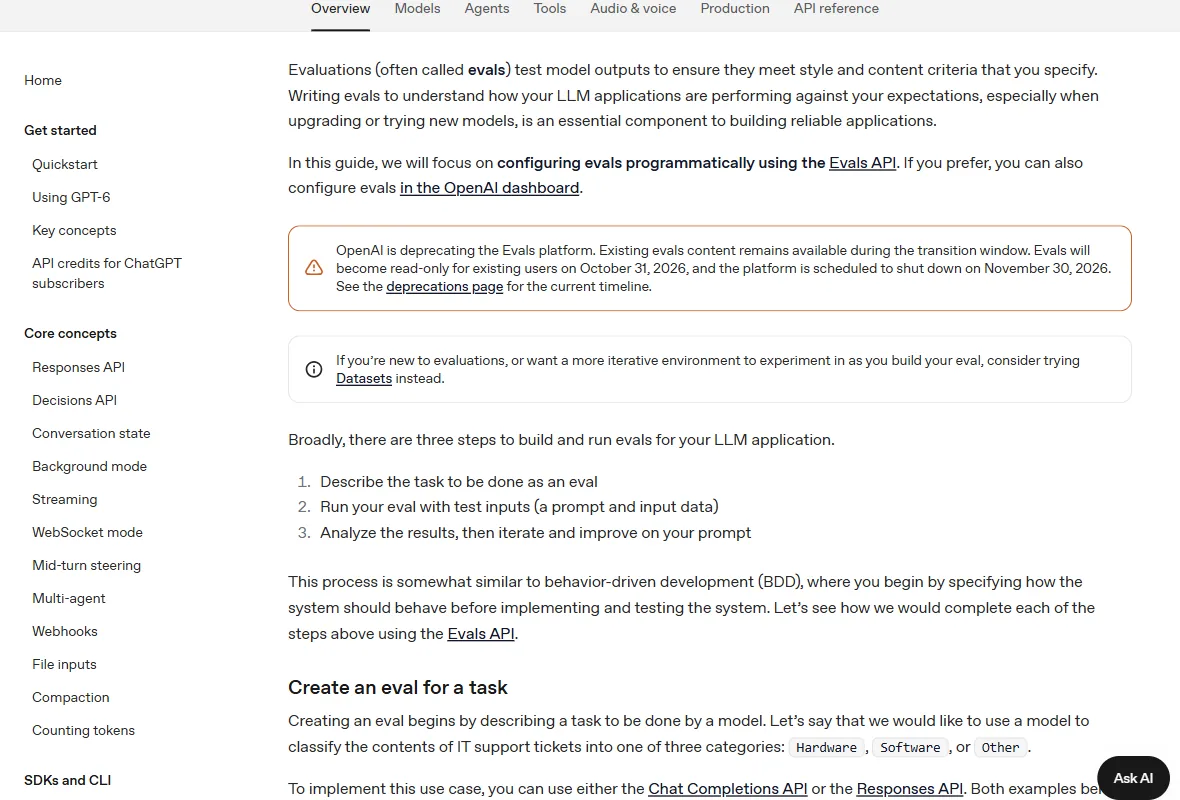
Documentação da OpenAI sobre configuração e execução de avaliações, com exemplos de tarefas e resultados.
Ver como texto
Uma bateria de testes verde cobre apenas o comportamento que alguém escreveu, e deixa descobertas três dimensões de qualidade: manutenibilidade, segurança fora do catálogo documentado e deriva de mundo, cada uma sem responsável nomeado por padrão
| Tipo de falha | O que o teste automático faz com ela | O que o silêncio dele significa |
|---|---|---|
| Falha de comportamento que alguém previu | Cobre bem: é exatamente para isso que a bateria existe | Verde aqui vale. O caso previsto funcionou hoje, com os dados de hoje |
| Falha de segurança muito documentada | Cobre razoavelmente: o código gerado passou em 82% dos casos de injeção de comando de banco de dados | Verde aqui vale bastante, porque o padrão de defesa está escrito em toda parte e o modelo o imita bem |
| Falha de segurança pouco documentada | Não cobre: 15% de aprovação na falha que injeta conteúdo na tela do usuário e 13% na que envenena o registro de eventos | Verde aqui não diz nada. O modelo imita o que está documentado em vez de raciocinar sobre segurança |
| Perda de manutenibilidade | Não mede, e não existe teste automático que meça | A refatoração caiu de 21% das linhas alteradas em 2022 para 3,8% em 2026, e as construções que mascaram erro subiram 47% |
| Deriva de mundo | Não mede: o teste compara com o mundo em que foi escrito | O desempenho cai sem nada quebrar, e o primeiro sintoma costuma chegar pelo cliente |
Fatiar a entrega em pedaços pequenos ajuda os três primeiros tipos, porque uma alteração de três linhas que falha aponta a causa, enquanto uma de trezentas dilui o sinal. Isso é decisão de qualidade do dado que alimenta a medição, além de higiene de repositório.
Existe um método que alcança boa parte do que a execução não alcança, e vale conhecer porque é o mais antigo da casa. Preferência humana é o método em que pessoas comparam duas respostas e dizem qual preferem, e o sistema aprende com essa comparação. Ele cobre clareza, tom, adequação e bom senso, tudo aquilo que nenhuma máquina executa para conferir.
Ele também é o mais caro, e por isso a indústria migrou para recompensa medida por execução assim que o código permitiu. Em software existe uma vantagem que outros domínios não têm: dá para rodar o resultado e ver se funciona. Onde essa vantagem acaba, o custo volta a ser hora de gente, e aí a conversa deixa de ser sobre tecnologia e passa a ser sobre quanto da sua folha você aloca em conferência.
A figura seguinte põe as três formas de julgar lado a lado com o custo declarado, porque é assim que essa decisão chega ao orçamento.
Ver como texto
Três formas de julgar a qualidade de uma entrega, em ordem crescente de custo: execução automática a cada mudança, revisão humana por amostra e comparação por preferência humana, com a cobertura e a limitação de cada uma
O silêncio de uma checagem significa apenas que ela não encontrou o problema que procura. Para reduzir falhas de controle, proteja os testes e os registros contra alterações feitas pelo próprio agente avaliado. A equipe precisa conseguir distinguir correção da entrega de mudança na regra que a aprova.
| Dimensão que o teste não cobre | Como você percebe que ela caiu | Evidência que você passa a exigir por trimestre | Nome do responsável e data |
|---|---|---|---|
| Manutenibilidade | O time começa a estimar mais alto para mexer no mesmo lugar | Duplicação de blocos, percentual de linhas refatoradas e frequência de reescrita, comparados com o trimestre anterior | |
| Segurança pouco documentada | Aparece em teste de invasão ou em incidente, nunca na esteira | Varredura específica das categorias de menor cobertura, com o resultado anterior ao lado | |
| Deriva de mundo | O desempenho cai sem que nada tenha quebrado nem mudado no sistema | Medição contra um conjunto novo de casos reais do trimestre, comparada com a linha de base |
A última coluna é o artefato. Preencha com nome de pessoa e data. Linha sem nome preenchido é a declaração honesta de que a dimensão está descoberta, e isso também é uma decisão, desde que seja consciente.
A dimensão descoberta que mais custa hoje é a segurança do app publicado. Em maio de 2026, a empresa de segurança RedAccess encontrou 380 mil aplicativos e páginas públicos criados com Lovable, Base44, Replit e Netlify, cerca de 5 mil deles com dados corporativos sensíveis. Na lista havia finanças internas de um banco brasileiro, prontuários e conversas de clientes.
A causa principal foi uma configuração: vários desses produtos publicavam o app como público por padrão, e buscadores indexavam as páginas. Replit e Lovable contestaram o método do estudo. Nenhum teste automatizado apontaria o problema, porque o app funcionava exatamente como foi pedido.
Guia prático: política de publicação para apps feitos com agente
Antes de publicar
0/3Na publicação
0/2Depois de publicar
0/2Três perguntas para testar a decisão antes da próxima reunião: (1) A bateria de testes ficou verde e o time pede autorização para promover a produção. Você autoriza, autoriza com condição ou segura, e com base em quê? (2) Ninguém na sua empresa responde hoje pela manutenibilidade do código gerado por agente. Você nomeia alguém nesta semana ou aceita a lacuna por escrito? (3) Qual evidência trimestral você passa a exigir a partir da próxima reunião, e de quem?
Nomeie hoje uma pessoa para cada dimensão que a bateria de testes deixa descoberta e adote a política de publicação acima para todo app feito com agente. Faça o inventário dos apps publicados fora da TI em trinta dias e confira se algum está aberto ao público sem dono nomeado.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
- CursoSetup Completo: do zero ao Claude Code (Windows)sugerido pelo grafoO Setup ensina permissões, contexto do projeto e escolha de modelo por custo. Essa preparação sustenta os exercícios de comparação de assistentes, criação do gerador de UTM e regras de projeto no curso de aprendizado por reforço e vibecoding.
- CursoAstra profundosugerido pelo grafo4 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Astra profundo”.
- CursoLetramento em IA para Executivossugerido pelo grafo5 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Letramento em IA para Executivos”.
- CursoVídeo com IA: do roteiro à publicaçãosugerido pelo grafo2 capítulos de “Avaliar e melhorar agentes” usam conceitos apresentados em “Vídeo com IA: do roteiro à publicação”.
- Modelo de trabalho com agentes de IAQue evidência mostra se a entrega funcionou?Examinar conexões de Que evidência mostra se a entrega funcionou?
- Software e IA para executivosO código ficou barato e a revisão continua caraExaminar conexões de O código ficou barato e a revisão continua cara
- Prompt Engineering para ExecutivosTestar a IA com 20 a 50 casos reais antes de liberarExaminar conexões de Testar a IA com 20 a 50 casos reais antes de liberar
- RLM: grandes acervosComo testar mudanças sem contaminar a avaliaçãoExaminar conexões de Como testar mudanças sem contaminar a avaliação
Terminou a leitura?
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.