E-E-A-T e Qualidade de Conteúdo · Capítulo 17 de 22 · 29 min
Ser recuperado e citado nas respostas geradas por IA
O que a documentação oficial do Google afirma sobre AI Overviews e AI Mode, o que é medição de terceiro, e onde a ponte entre E-E-A-T e citação por IA é inferência de mercado.
Este capítulo faz parte do curso gratuito E-E-A-T e Qualidade de Conteúdo.
Você vai sair deste módulo capaz de decidir três coisas: se vale investir em qualquer marcação, arquivo ou protocolo vendido como caminho para aparecer em resposta de IA; que número aceitar num relatório de visibilidade em IA; e o que responder quando alguém propuser bloquear um crawler para sair dos AI Overviews. Errar aqui custa caro nos dois sentidos. Contratar o que não funciona queima verba, e bloquear o crawler errado desliga distribuição sem tirar você de lugar nenhum.
[DOCUMENTADO] Desde 15 de maio de 2026 existe documentação permanente do Google sobre otimização para recursos de IA generativa da Busca, atualizada pela última vez em 10 de julho de 2026. Ela diz por escrito o que o mercado passou dois anos discutindo: AI Overviews e AI Mode recuperam páginas a partir dos sistemas de ranqueamento centrais da Busca, e para ser elegível basta estar indexado e elegível a snippet. Não há requisito técnico adicional, não existe schema especial e não é preciso criar arquivo legível por máquina para IA. Não existe índice paralelo de IA para você entrar.
Por que essa falta de novidade técnica é a informação mais cara do módulo
Se a recuperação sai do ranking central, então tudo que se vende como atalho paralelo compete com uma frase da documentação oficial. Você não precisa de fornecedor para verificar isso, precisa de dez minutos e do endereço da página.
Isso não significa que nada mudou. Mudou o que acontece depois da recuperação, e é aí que a decisão de conteúdo se desloca. A escala também mudou, e ela justifica a atenção do conselho: o Google declarou no I/O de 19 de maio de 2026 que o AI Mode passou de 1 bilhão de usuários ativos mensais em um ano, com consultas cerca de três vezes mais longas que a consulta tradicional. Consulta mais longa significa pergunta mais específica, e pergunta mais específica é exatamente o que a sua página precisa responder em um trecho isolado.
Registre a natureza do dado: número do próprio Google, divulgado por quem se beneficia da adesão, sem auditoria externa. Serve para dimensionar o fenômeno. Não serve como prova de retorno.
A busca com IA não contrata a agência inteira; contrata o melhor freelancer para cada tarefa
Um gerente precisa entregar um projeto. O jeito antigo, o SEO clássico, era contratar uma agência pela reputação: quem tem mais prêmios, mais anos de casa e mais portfólio leva o projeto inteiro. A busca generativa trabalha de outro jeito. Ela quebra o projeto em tarefas pequenas (é isso o query fan-out) e para cada tarefa contrata o melhor freelancer disponível naquele assunto específico, sem se importar de qual agência ele veio. A sua página não é contratada como um todo: cada parágrafo dela concorre, sozinho, para responder a uma sub-pergunta. Uma página menos famosa pode ganhar a tarefa com um único parágrafo mais limpo, e uma página cheia de autoridade pode não ser chamada para nenhuma.
Pare de otimizar a página como um currículo e comece a tratar cada seção como um freelancer que precisa responder a uma pergunta específica melhor que qualquer outro.
O mecanismo que muda o desenho da página, agora com nome oficial
[DOCUMENTADO] O guia do Google descreve query fan-out como um conjunto de consultas concorrentes e relacionadas, geradas pelo modelo para pedir mais informação e buscar resultados adicionais. A consulta do usuário não vai inteira até o índice. Ela é decomposta, cada sub-consulta recupera trechos específicos, e a resposta é montada a partir desse conjunto de trechos vindos de páginas diferentes. A cada novo turno da conversa a decomposição é refeita, usando o turno anterior como filtro de escopo.
A consequência é estrutural e editorial ao mesmo tempo. A página continua sendo a unidade de publicação, descoberta e indexação, e a recuperação em nível de trecho passa a decidir o que entra na resposta. Em vez de presumir que o artigo inteiro será avaliado como bloco, garanta que cada seção responda com clareza a uma subpergunta, preserve o contexto e mantenha a evidência ao lado da afirmação.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Aqui mora a tática mais vendida no Brasil neste momento, e ela está documentada como spam. Consultorias estão propondo mapear as consultas derivadas do fan-out e publicar uma página para cada uma. O próprio guia do Google avisa que criar conteúdo separado mirando essas consultas, com a finalidade de manipular ranqueamento, viola as políticas de spam. E em 15 de maio de 2026 a política de spam da Busca passou a declarar, na definição de spam, a tentativa de manipular respostas de IA generativa. Se alguém apresentar isso ao seu time como estratégia, a resposta é a URL da política, não uma discussão de opinião.
A tese deste módulo, declarada como inferência antes de ser usada
[INFERÊNCIA] Nenhuma plataforma de IA documentou usar E-E-A-T para escolher o que citar. Nem o Google, nem a OpenAI, nem a Microsoft, nem a Anthropic. E o próprio Google afirma que E-E-A-T não é, em si, fator de ranqueamento, e que os avaliadores humanos não controlam como as páginas ranqueiam, com o dado deles não entrando diretamente no algoritmo.
A ponte que o mercado desenha entre E-E-A-T e citação por IA é inferência, e vender inferência como mecanismo é o centro do problema deste mercado. A cadeia defensável existe, tem quatro elos, e cada elo perde força. Diga a cadeia inteira, com os elos à vista, sempre que precisar justificar o investimento. Quem só diz a conclusão está vendendo, não explicando.
- Etapa 1 de 4: 1. O recurso generativo recupera do índice da Busca
[DOCUMENTADO] Guia oficial: RAG sobre os sistemas de ranqueamento centrais. Elo firme.
- Etapa 2 de 4: 2. A Busca usa sinais que correlacionam com E-E-A-T
[DOCUMENTADO com ressalva] O Google diz usar uma combinação de fatores capaz de identificar conteúdo com bom E-E-A-T, e dar mais peso a isso em YMYL. Não existe variável chamada E-E-A-T.
- Etapa 3 de 4: 3. Ranquear bem correlaciona com ser citado
[OBSERVACIONAL] Correlação moderada, medida por terceiros, com variação forte por setor. Nenhum estudo público demonstra causa.
- Etapa 4 de 4: 4. Logo, E-E-A-T afeta citação de forma indireta, via ranking
[INFERÊNCIA] Só na medida em que ranking prevê citação. É esta a promessa que você pode fazer, e nenhuma maior.
Glossário rápido
RAG (retrieval-augmented generation)
Geração aumentada por recuperação. O sistema busca trechos de documentos reais e escreve a resposta a partir deles, em vez de responder só com o que o modelo memorizou no treino. É o desenho que o Google declara usar em AI Overviews e AI Mode.
Query fan-out
A abertura da pergunta do usuário em várias consultas derivadas, disparadas ao mesmo tempo. Termo usado pelo próprio Google na documentação de IA generativa.
Grounding
Ancoragem da resposta gerada em documentos recuperados, para que ela cite fonte em vez de inventar. Aparece na documentação do Google ligado aos apps Gemini e à API do Vertex AI, que são superfícies diferentes da Busca.
Citação com link
O seu endereço aparece na lista de fontes da resposta. Mede presença de link, e não diz se a marca foi escrita no texto que a pessoa lê.
Menção nominal
O nome da sua marca aparece escrito no corpo da resposta. É a métrica que sustenta discurso de marca, e ela não acompanha automaticamente a citação com link.
Zero-clique
Busca encerrada sem clique em nenhum resultado. É a métrica em que o efeito dos resumos de IA aparece de forma mais direta.
Google-Extended
Controle de robots.txt que governa treino dos modelos Gemini e grounding nos apps Gemini e na API do Vertex AI. A documentação afirma que ele não afeta a inclusão na Busca. Tratado adiante como a correção mais cara deste módulo.
llms.txt
Proposta de arquivo de texto na raiz do site, apresentada pelo mercado como caminho para citação em IA. O Google declarou que a Busca o ignora.
As três decisões estruturais que decorrem do fan-out
A primeira é colocar a resposta direta à pergunta principal no começo do documento, antes do contexto, da história e da justificativa. A evidência sobre posição da citação dentro da página é observacional e será qualificada em seguida, mas a decisão é barata e não tem contraindicação: um texto que responde antes de explicar também serve melhor o leitor humano que chegou com pressa.
A segunda é escrever cada seção como unidade que faz sentido fora da página. Se o quarto subtítulo do seu artigo depende de três parágrafos anteriores para significar alguma coisa, ele não sobrevive ao recorte. Na prática isso quer dizer repetir o sujeito em vez de usar pronome, nomear o objeto de novo em vez de escrever "ele", e recolocar a condição em vez de escrever "nesse caso".
A terceira é privilegiar elementos extraíveis: definição fechada, fato numérico com fonte ao lado, comparação em duas colunas, passo a passo numerado. Esses formatos são recortáveis por construção, e prosa contínua bem escrita não é.
Um estudo grande de abril de 2026 chega à mesma lista por caminho independente, e faz uma distinção que ainda não entrou no vocabulário do mercado. De um lado está a citação selecionada, que é a plataforma escolher citar um endereço. De outro está a citação absorvida, que é o conteúdo daquela página influenciar de fato o texto da resposta. As duas não coincidem, e a segunda é a que tem valor. O trabalho controlou 602 prompts e analisou mais de 21 mil citações válidas em três plataformas: as páginas com maior influência sobre a resposta tendem a ser mais longas, bem organizadas, semanticamente relevantes para a consulta e ricas nesses elementos extraíveis.
Onde as citações são extraídas dentro do documento (observacional, amostra pequena)
55%
Das citações em AI Overviews vêm dos primeiros 30% da página
Estudo de 100 páginas, CXL
24%
Vêm da faixa do meio, entre 30% e 60% do documento
Mesma amostra
21%
Vêm do terço final
Mesma amostra
Fonte: CXL, estudo de 100 páginas (03/2026). Amostra pequena, metodologia de blog, sem revisão por pares.
Antes de reorganizar o site inteiro com base nos números acima, leia o contrapeso. O achado de posição vem de amostra pequena e metodologia de blog, sem revisão por pares. E a revisão crítica de 45 estudos de GEO (Olivier Martinez, arXiv 2607.14035, 15/07/2026), tratada com a nota de fonte completa em "As quatro perguntas que decidem se uma página merece confiança", conclui que relevância tópica e posicionamento de contexto são os fatores reprodutíveis, e que nenhuma técnica revisada mostra efeito causal estável, longitudinal e entre plataformas. Colocar a resposta no topo é barato, reversível e coerente com boa redação, então faça. Refazer a arquitetura de informação do site apostando em um coeficiente de blog é caro, demorado e não tem lastro que o justifique.
O que muda entre otimizar para o resultado clássico e para a resposta gerada
Otimizar para o resultado clássico
Coluna do modelo clássico
- A unidade que compete é a página inteira
- Autoridade acumulada, links e histórico sustentam a posição
- A abertura pode contextualizar antes de responder
- Seções encadeadas: o quarto subtítulo depende dos três anteriores para significar alguma coisa
- Prosa contínua bem escrita já resolve
- O resultado que se mede é o clique no link azul
Otimizar para a resposta gerada
Coluna do modelo generativo
- A unidade que compete é o trecho que responde a uma sub-consulta
- Um parágrafo mais limpo sobre a sub-pergunta pode vencer a página mais autoritativa
- A resposta direta vem antes do contexto e da justificativa
- Cada seção precisa sobreviver ao recorte: repetir o sujeito, renomear o objeto, recolocar a condição
- Definição fechada, fato com fonte ao lado, comparação em duas colunas e passo numerado são recortáveis por construção
- Há dois resultados distintos a medir: ser citado com link e influenciar o texto da resposta
O número que você mais vai ouvir sobre GEO não entra neste curso, e vale saber por quê. O ganho de até 40% de visibilidade circula em quase todo material brasileiro de GEO. A fonte é real: o paper GEO: Generative Engine Optimization, apresentado no KDD em 2024, com submissão em novembro de 2023. O ganho foi medido no GEO-bench, um benchmark construído pelos próprios autores, contra um motor generativo montado por eles, sobre uma métrica interna de proeminência do texto dentro da resposta. Não foi medido no Google, não foi medido no ChatGPT, não é tráfego, não é clique e não é receita. Apresentar esse número como ganho esperado em 2026 é transpor experimento sintético de 2023 para produto comercial de outro ano.
A correção mais cara deste módulo, e provavelmente do curso: Google-Extended não controla AI Overviews, e nunca controlou. A documentação de crawlers do Google afirma, com estas palavras, que Google-Extended does not impact a site's inclusion in Google Search nor is it used as a ranking signal in Google Search. Ele governa se o conteúdo ajuda a melhorar os apps Gemini e as APIs generativas do Vertex AI, incluindo grounding. Quem no seu time bloqueou Google-Extended acreditando ter saído do AI Overviews bloqueou treino do Gemini e continuou dentro do AI Overviews. Vale conferir o robots.txt do seu site nesta semana: a decisão foi tomada em muitas empresas entre 2023 e 2025, sem revisão desde então.
O arquivo que o mercado vende e a Busca ignora
[DOCUMENTADO] O guia oficial do Google lista, na seção de desmonte de mitos, o que ignorar para a Busca: arquivos llms.txt e outras marcações "especiais", chunking de conteúdo, reescrever conteúdo só para sistemas de IA, buscar menções inautênticas e supervalorizar dados estruturados. A nota acrescentada em 15 de junho de 2026 diz que manter o arquivo não prejudica nem ajuda a visibilidade, porque a Busca simplesmente o ignora.
[OBSERVACIONAL] A Ahrefs analisou, em 15 de junho de 2026, 137 mil domínios do seu próprio Web Analytics. Cerca de 28% publicam llms.txt, o que dá aproximadamente 38 mil arquivos válidos, e 97% desses arquivos receberam zero requisição em maio de 2026. O limite de método vai junto: a base são clientes da Ahrefs, mais técnicos que a média da web, portanto não é amostra probabilística. O dado é da Ahrefs, e a atribuição a outra empresa que circula no mercado está errada.
Existe hoje um controle que de fato alcança os recursos generativos, e desde 31/08/2026 ele está disponível para todo site, inclusive o seu. Fica no Search Console, em Configurações, Search generative AI, e decide se o site aparece e ajuda a fundamentar respostas em AI Overviews, AI Mode e nos recursos generativos do Discover. O padrão é incluir. Quem exclui não recebe tráfego nem impressões desses recursos, e o controle não é usado como sinal de ranqueamento fora deles. Ele também não limita treinamento de modelo, que continua sendo assunto do Google-Extended. A armadilha agora é o inverso de antes: excluir o site por reflexo, sem olhar no relatório de IA generativa quanto da exposição vem dali.
O contra-exemplo que desmonta a versão preguiçosa da tese
[OBSERVACIONAL] A Similarweb mediu cerca de 600 mil eventos de citação nos Estados Unidos, entre janeiro e fevereiro de 2026, no ChatGPT em modo navegação e no Google AI Mode. Os domínios mais citados pelo ChatGPT foram a Wikipedia, com 13,15%, e o Reddit, com 11,97%, somando mais de um quarto de todas as citações. Wall Street Journal, New York Times e Bloomberg ficam fora do top 20, e o único veículo de imprensa que aparece é a Reuters, em sétimo, com 2,27%.
Uma enciclopédia colaborativa e um fórum aberto na frente de jornais com autoridade institucional máxima. Isso não derruba E-E-A-T como disciplina editorial. Derruba a ideia de que o modelo esteja aplicando E-E-A-T na hora de escolher a citação. A explicação mais simples é acesso: essas fontes são rastreáveis, sem paywall, densas em cobertura de cauda longa e fáceis de recuperar. Antes de atribuir uma ausência de citação à falta de autoridade, verifique se o seu conteúdo é alcançável.
O melhor dado disponível sobre o que o resumo de IA faz com o seu clique
Saharsh Agarwal, da Indian School of Business, e Ananya Sen, da Carnegie Mellon, conduziram o primeiro experimento de campo randomizado sobre AI Overviews. Foram 1.065 usuários americanos de Chrome desktop recrutados no Prolific, com coleta entre 7 de janeiro e 10 de fevereiro de 2026 e pré-registro na AEA RCT Registry. É desenho randomizado, com grupo de comparação, que é o que separa este trabalho da maior parte do que circula sobre o assunto.
Duas ressalvas precisam viajar coladas ao número, sempre. É working paper no SSRN, sem revisão por pares. E os números que a maior parte do mercado repete, de 38% e de zero-clique subindo de 54% para 72%, são da versão de abril, superada pela revisão de 17 de junho de 2026. Publicar o número velho em julho é publicar um dado que o próprio autor já corrigiu.
Experimento randomizado sobre AI Overviews (versão vigente do paper, 17/06/2026)
39,8%
De queda nos cliques orgânicos de saída
Nas consultas em que o AI Overview aparece
0,54 para 0,73
Busca sem clique, antes e com o resumo exibido
Zero-clique medido por consulta
1.065
Usuários americanos de Chrome desktop
Coleta de 07/01 a 10/02/2026, pré-registro na AEA RCT Registry
~41%
Das consultas acionaram AI Overview
Cliques patrocinados e frequência de busca não se moveram
Fonte: Agarwal e Sen, SSRN 6513059, revisão de 17/06/2026. Working paper, não revisado por pares.
Dois números vão aparecer na mesma apresentação do seu fornecedor, e eles não se contradizem: medem coisas diferentes. O de 76% diz que a maioria das páginas citadas ranqueia no top 10, olhando apenas as três citações mais visíveis de cada AI Overview, o que enviesa para as citações fortes. O de cerca de 17% olha todas as citações, incluindo a cauda longa, e por isso encontra muito menos sobreposição com o top 10. Somem-se a isso duas datas: ambos os estudos são de 2025, e uma parte do material em circulação neste mês os apresenta como dados de 2026. A redatação é do agregador, não do pesquisador. Se você usar qualquer um dos dois, use com a data certa e com o recorte declarado.
Três métricas que não são a mesma coisa
| Métrica | O que mede | O que ela esconde |
|---|---|---|
| Citation rate | Percentual de respostas que citam o seu domínio com link | Não diz se a marca foi nomeada no texto da resposta |
| Mention rate | Percentual de respostas que citam o nome da marca | Não diz se houve link, nem se a resposta foi influenciada pelo seu conteúdo |
| Share of model / share of voice | Sua fatia sobre o total de menções da categoria em um conjunto de prompts | Depende inteiramente do conjunto de prompts escolhido, que cada fornecedor define do seu jeito |
Nenhuma dessas métricas tem definição padronizada por órgão neutro. Comparar o número de duas ferramentas diferentes não é comparação.
Fonte: Definições de consenso de mercado; não há órgão padronizador
Por que separar essas três métricas decide orçamento
[OBSERVACIONAL] Análise de mercado sobre milhares de domínios e centenas de prompts identificou que boa parte das citações em respostas de IA são fantasmas. O domínio recebe o link, aparece na lista de fontes ao lado da resposta, e o nome da marca não é escrito em nenhum ponto do texto que o usuário efetivamente lê. Em um dos motores analisados, a taxa de citação é altíssima e a taxa de menção nominal fica uma ordem de grandeza abaixo.
Se o objetivo é tráfego, citação com link é a métrica correta, e o gargalo é a taxa de clique de dentro da resposta. Se o objetivo é marca, a métrica correta é menção nominal, e ela responde a um trabalho diferente, mais próximo de relações públicas e de presença em fonte que o modelo trata como referência do que de otimização de página. Aprovar verba sem essa separação é aprovar verba para um resultado que ninguém definiu.
Onde existe número de primeira parte sobre visibilidade em IA, e o que cada fonte não vê
| Fonte | O que entrega | A cegueira declarada |
|---|---|---|
| Search Console, relatório de IA generativa (03/06/2026) | Impressões, páginas, países, dispositivos e datas dentro dos recursos generativos | Sem cliques, sem CTR e sem consultas. Quem promete CTR de AI Overviews via Search Console está inventando |
| GA4, canal AI Assistants | Sessões vindas de assistentes de terceiros, como ChatGPT, Gemini, Deepseek, Copilot e Grok, quando o medium corresponde a ai-assistant | A documentação classifica AI Overviews e AI Mode dentro de Organic Search, fora deste canal. Sessão sem referenciador cai em Direct |
| Bing Webmaster Tools, Citation Share (16/06/2026) | Participação nas citações, além de Intents, Topics e Compare | Participação de mercado pequena no Brasil. É a única métrica de participação em citação em primeira parte que existe hoje |
O uso operacional dessas três fontes, com a montagem do grupo de canais customizado, está em "Escolher três indicadores defensáveis e recusar os outros".
Fonte: Google Search Central (03/06/2026); Ajuda do Google Analytics, definições de grupos de canais padrão; Bing Webmaster Blog (16/06/2026)
Uma parte da citação passou a depender de decisão humana, e não de otimização. Desde 27 de maio de 2026 o usuário pode marcar sites como fontes preferidas, e o link citado dentro de uma resposta de IA exibe selo quando vem de uma fonte que aquele usuário escolheu. Nenhuma configuração técnica alcança essa decisão, e nenhum concorrente a desloca com verba de mídia. Consequência de orçamento: lista de e-mail, comunidade, canal próprio e newsletter deixam de competir com a verba de busca e passam a alimentá-la.
Lacuna de método que precisa ser dita em qualquer reunião sobre este tema: não existe estudo público de citação por LLM com amostra brasileira ou em português. Similarweb, Ahrefs, BrightEdge, Pew e o experimento de Agarwal e Sen medem mercado estrangeiro, em outro idioma, com outro comportamento de busca e outra composição de imprensa. Todo número deste módulo é importado. Use como ordem de grandeza e como direção. Quem apresentar qualquer um deles como o comportamento do consumidor brasileiro está extrapolando sem base, e a pergunta que desmonta a apresentação cabe em uma linha: qual era o país da amostra?
Verificação rápida
Um relatório de agência mostra presença em 62% das respostas de IA para os nossos prompts. Qual é a primeira pergunta a fazer?
Guia prático: ler o relatório de IA generativa e decidir sobre o controle de inclusão. Duas mudanças de 31/08/2026 tiram este assunto do campo da hipótese. O relatório de desempenho em IA generativa, que estava em teste, foi liberado para todos os sites. O controle que inclui ou exclui o site de AI Overviews, AI Mode e dos recursos generativos do Discover também. Em 24/09/2026 os dois relatórios de desempenho ganharam o filtro de busca multimodal, que separa buscas feitas com imagem, como Lens e Circle to Search.
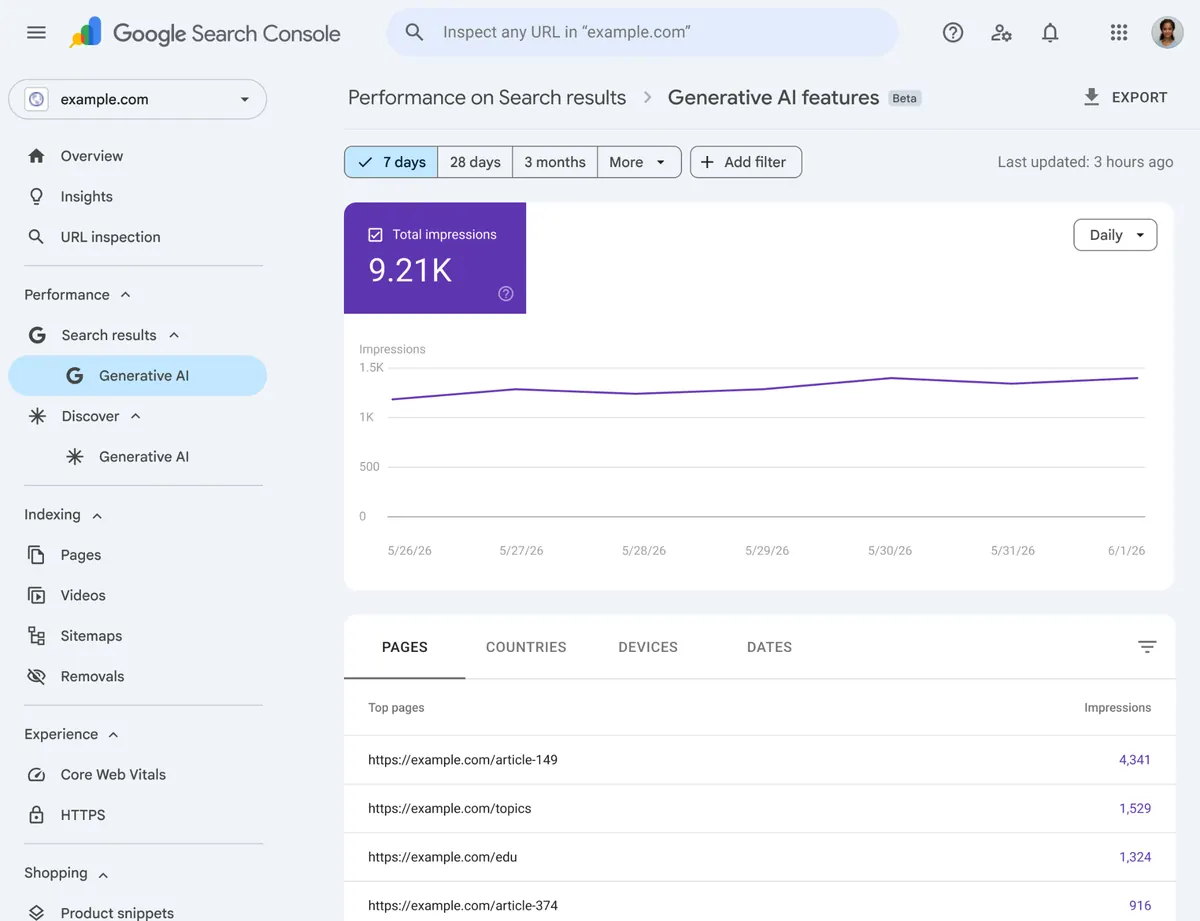
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Medir a exposição em IA generativa antes de mexer no controle
Seis passos para uma empresa de qualquer porte. O objetivo é decidir com número, e não com a manchete da semana.
Passo 1: Abra Desempenho, Resultados da pesquisa, IA generativa
O relatório fica abaixo do relatório de desempenho comum. Se ele não aparecer, o site ainda não teve impressões suficientes nesses recursos.
Deu certo quando: Você vê o total de impressões em AI Overviews e AI Mode no período.
Erro comum: Somar esse número ao relatório geral. Ele já está contido lá; o relatório novo só isola o recorte.
Passo 2: Ordene a aba Páginas e separe as dez primeiras
São as páginas que o Google mais usa para fundamentar respostas. Confira se cada uma tem autor identificado, data de revisão e fonte citada.
Deu certo quando: Uma lista curta de páginas com o dono editorial de cada uma.
Passo 3: Use o filtro de tipo de busca e compare texto com multimodal
O filtro multimodal, de 24/09/2026, mostra buscas feitas com imagem. Para e-commerce e negócio local, vale ver se páginas de produto e de loja aparecem ali.
Deu certo quando: Você sabe se a exposição vem de pergunta escrita ou de foto.
Passo 4: Exporte e cruze com cliques do relatório comum
O relatório de IA não traz cliques. Cruze as mesmas URLs no relatório geral para ver se o clique caiu enquanto a exposição em IA subiu.
Deu certo quando: Uma planilha com página, impressões em IA e cliques totais no mesmo período.
Passo 5: Abra Configurações, Search generative AI, e leia a opção atual
O padrão é incluir o site. Propriedades filhas herdam a escolha da propriedade pai, a não ser que alguém mude manualmente.
Deu certo quando: Você sabe qual opção vale para cada propriedade, inclusive subdomínios.
Erro comum: Excluir o site por reflexo. A exclusão zera impressões e tráfego vindos desses recursos e não limita treinamento de modelo, que é assunto do Google-Extended.
Passo 6: Leve a decisão ao comitê com o número do passo quatro
Excluir só faz sentido quando a página exposta em IA perde receita mensurável e a empresa aceita sumir das respostas.
Deu certo quando: A ata registra a opção escolhida, o número que a justificou e a data da próxima revisão.
No fim você tem: Um retrato de quanto da exposição do site vem de IA generativa, com as páginas responsáveis e uma decisão registrada sobre o controle.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Confirme antes de seguir: (1) Você sabe o que o guia oficial de 15/05/2026 afirma sobre requisito técnico, schema especial e arquivo para IA, e de qual índice os recursos generativos recuperam? (2) Consegue dizer a cadeia de quatro elos entre trabalho de E-E-A-T e citação por IA, apontando qual elo é documentado e qual é inferência? (3) Sabe explicar por que bloquear Google-Extended não tira ninguém do AI Overviews, e onde está a documentação que prova isso? (4) Consegue distinguir citation rate, mention rate e share of model, e dizer o que cada uma esconde? (5) Sabe dizer, sem consultar, qual foi o país da amostra de todo dado de citação deste módulo?
Exercício prático, em três tarefas com dono e prazo
Primeira: abra o robots.txt do seu site e verifique se existe bloqueio a Google-Extended. Se existir, pergunte a quem decidiu qual era o objetivo. Se a resposta for sair dos AI Overviews, o bloqueio não cumpriu o objetivo e a decisão precisa ser retomada com a documentação na mesa.
Segunda: escolha as cinco páginas mais importantes do site e verifique, em cada uma, se a resposta direta à pergunta principal aparece dentro dos primeiros 30% do texto. Meça por contagem de caracteres, não por impressão. Onde não aparecer, reescreva a abertura sem cortar o resto do material.
Terceira tarefa, e a que sustenta todo o resto
Monte um conjunto fixo de vinte prompts do seu mercado, escritos como o seu cliente escreveria, e registre hoje, prompt a prompt, se a marca aparece como link, como nome dentro do texto da resposta, como os dois, ou como nenhum. Guarde o conjunto congelado: trocá-lo depois invalida a série.
Esse registro é a linha de base de "Escolher três indicadores defensáveis e recusar os outros". Sem ele, qualquer melhora observada nos próximos meses será anedota, porque você não vai conseguir separar o efeito do seu trabalho do efeito de uma mudança que o motor fez sozinho.
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Veja o que estudar antes e para onde seguir depois, explore os conceitos e compare abordagens em outros cursos. Sugestões marcadas como “sugerido pelo grafo” vêm dos assuntos em comum, não do índice do curso.
Estude antes
- Descubra como a IA escolhe quem citarsugerido pelo grafoApresenta os conceitos “Citação por IA” e “Query fan-out”, usados em “Ser recuperado e citado nas respostas geradas por IA”.
- Cobre no relatório os números certos e ignore o restosugerido pelo grafoApresenta os conceitos “Citation share” e “Controle de IA generativa da Pesquisa”, usados em “Ser recuperado e citado nas respostas geradas por IA”.
- Destrave o que impede o robô de ler o sitesugerido pelo grafoApresenta o conceito “Google-Extended”, usado em “Ser recuperado e citado nas respostas geradas por IA”.
- CursoGEO Universal Frameworksugerido pelo grafo2 capítulos de “E-E-A-T e Qualidade de Conteúdo” usam conceitos apresentados em “GEO Universal Framework”.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Glossário Completo de SEO e GEO 2026Prepare a página para a IA recortar o seu trechoExaminar conexões de Prepare a página para a IA recortar o seu trecho
- GEO Universal FrameworkPublique conteúdo feito com IA dentro da regra do GoogleExaminar conexões de Publique conteúdo feito com IA dentro da regra do Google
- SEO ProgramáticoProteger o acervo nas atualizações de spam de 2026Examinar conexões de Proteger o acervo nas atualizações de spam de 2026
- Digital PR e Link Building na Era do GEOBlindar o programa de links contra as políticas de spamExaminar conexões de Blindar o programa de links contra as políticas de spam
Leve uma ideia para a prática
Escolha uma atividade no painel e volte a este curso quando quiser.
Atividades e evolução ficam reunidas no painel da sua conta.