SEO Programático · Capítulo 20 de 21 · 39 min
Anunciar o acervo com sitemap particionado e frescor honesto
Sitemap fatiado, índice próprio e data de atualização verdadeira fazem o buscador confiar no sinal de frescor do acervo.
Este capítulo faz parte do curso gratuito SEO Programático. Para marcar como concluído e salvar o progresso, abra este capítulo na página do curso.
Um sitemap errado não quebra o build nem dispara alerta, e ainda assim pode deixar a maior parte do acervo fora do alcance do buscador por dias. Sitemap é a lista de endereços que o site entrega ao buscador, como o índice de um catálogo impresso.
O sintoma que traz o praticante até aqui é sempre o mesmo. O catálogo foi publicado, o sitemap abre no navegador, o XML é válido, o Search Console aceitou o envio. Semanas depois, o relatório de páginas mostra uma fração das URLs. Nada acusou erro: nenhum build quebrou, nenhum status HTTP saiu do 200, nenhum log reclamou. Um sitemap pode estar tecnicamente perfeito e mesmo assim anunciar o conjunto errado de URLs, ou anunciar o conjunto certo com um carimbo de data que o motor decide ignorar. As duas falhas são silenciosas por construção, e é por isso que elas merecem um módulo próprio em vez de uma nota de rodapé.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Comece pelo caso que aconteceu aqui, porque ele ensina mais rápido que qualquer explicação abstrata. O arquivo é src/app/sitemap.ts deste próprio repositório, e a correção está datada de 26 de maio de 2026.
O código foi escrito na assinatura anterior: sitemap({ id }: { id: number }), com um switch (id) decidindo qual conjunto de URLs cada bucket serviria. No Next 16.0.0 o id passou a ser uma Promise que resolve para string, quando antes era valor síncrono. A Promise nunca casou com nenhum case, o fluxo caiu no default, e os oito arquivos passaram a servir a mesma lista do bucket 0.
Repare no formato da falha. O TypeScript não reclamou porque a assinatura declarada estava sintaticamente coerente com o corpo. O build passou. Os oito arquivos existiam e respondiam 200. O XML era válido. O único sinal disponível era abrir dois buckets diferentes e notar que o conteúdo era idêntico, que é exatamente o tipo de conferência que ninguém faz depois de um deploy verde. O custo foram cerca de 80 por cento das URLs do site fora do sitemap por seis dias, até o alerta do Search Console apontar impressões em páginas que não estavam anunciadas.
A API de sitemap do Next mudou várias vezes, e material escrito antes de outubro de 2025 ensina assinatura que não roda mais. O histórico versionado que importa:
- v13.3.0 introduziu o arquivo
sitemap. - v13.4.14 trouxe
changeFrequencyepriority. - v14.2.0 trouxe localizações, com
alternates.languagese saída emxhtml:link. - v16.0.0 mudou o
idparaPromise<string>.
A regra que sai daí vale além deste caso: quando um framework muda um tipo de síncrono para Promise, o erro resultante quase nunca aparece como erro de tipo. Aparece como comportamento silenciosamente errado, porque uma Promise é um objeto perfeitamente válido em quase toda operação que você faria com o valor original.
// src/app/sitemap.ts (Next 16) - exemplo resolvido completo
import type { MetadataRoute } from 'next';
import { carregarInventarioValidado } from '@/lib/radar/inventario';

const DOMINIO = 'https://radar.exemplo.com.br';
const POR_ARQUIVO = 50000; // limite do protocolo de sitemaps, aplicado por você

// generateSitemaps devolve a LISTA DE IDS. Nada mais.
export async function generateSitemaps() {
  const registros = await carregarInventarioValidado();
  const indexaveis = registros.filter((r) => r.decisao === 'index');
  const buckets = Math.max(1, Math.ceil(indexaveis.length / POR_ARQUIVO));
  return Array.from({ length: buckets }, (_, id) => ({ id }));
}

// ATENCAO: props.id e Promise<string> a partir do Next 16.0.0.
// Precisa de await E de conversao. Sem isso, todo bucket serve o bucket 0.
export default async function sitemap(props: {
  id: Promise<string>;
}): Promise<MetadataRoute.Sitemap> {
  const id = Number(await props.id);

  const registros = await carregarInventarioValidado();
  const indexaveis = registros.filter((r) => r.decisao === 'index');

  const inicio = id * POR_ARQUIVO;
  const fatia = indexaveis.slice(inicio, inicio + POR_ARQUIVO);

  return fatia.map((r) => ({
    url: DOMINIO + '/preco/' + r.combustivel + '/' + r.uf + '/' + r.slugMunicipio,
    // lastModified sai do dado, nunca de new Date(). Ver adiante neste modulo.
    lastModified: r.semanaReferenciaFim,
    changeFrequency: 'weekly' as const,
    priority: 0.6,
  }));
}O corte de 50.000 URLs por arquivo é responsabilidade sua. O Next não fatia sozinho: generateSitemaps apenas devolve a lista de ids, e o próprio exemplo da documentação oficial faz o particionamento à mão, com start = id * 50000. A saída fica em /.../sitemap/[id].xml. Se o seu gerador devolver 120.000 URLs num arquivo só, ele vai gerar, publicar e passar em qualquer teste de build que você tenha. Quem reprova é o consumidor do outro lado.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Aqui está o gap entre documentação e prática, e ele não está escrito em lugar nenhum, o que é a razão de merecer aula própria.
Com generateSitemaps, o Next serve os sub-sitemaps individuais em /sitemap/0.xml, /sitemap/1.xml e assim por diante. Ele não serve um sitemap index apontando para eles. E ainda reserva o path /sitemap.xml para a convenção de metadata, de modo que um route handler em src/app/sitemap.xml/route.ts conflita no build com a mensagem Conflicting route and metadata.
O resultado é a pior combinação possível para quem confia no caminho convencional: /sitemap.xml responde 404, o robots.txt aponta para um arquivo que não existe, e o build permanece verde. Existem dois caminhos para resolver, e eles não são equivalentes.
// Caminho A, adotado neste repositorio.
// 1) handler numa rota alternativa, que nao colide com o path reservado
// src/app/sitemap-index.xml/route.ts
import { resumirBuckets } from '@/lib/radar/inventario';

const DOMINIO = 'https://radar.exemplo.com.br';

export const dynamic = 'force-static';

export async function GET() {
  // Mesma fonte validada que alimenta generateSitemaps.
  // Cada bucket carrega o lastmod MAIS RECENTE das URLs que ele contem.
  const buckets = await resumirBuckets();

  const entradas = buckets
    .map(
      (b) =>
        '  <sitemap>\n' +
        '    <loc>' + DOMINIO + '/sitemap/' + b.id + '.xml</loc>\n' +
        '    <lastmod>' + b.lastmodMaisRecente.toISOString() + '</lastmod>\n' +
        '  </sitemap>',
    )
    .join('\n');

  const xml =
    '<?xml version="1.0" encoding="UTF-8"?>\n' +
    '<sitemapindex xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">\n' +
    entradas +
    '\n</sitemapindex>';

  return new Response(xml, {
    headers: {
      'Content-Type': 'application/xml; charset=utf-8',
      'Cache-Control': 'public, max-age=0, s-maxage=3600',
    },
  });
}// 2) rewrite beforeFiles, para que o caminho convencional sirva o indice com 200
// next.config.ts
import type { NextConfig } from 'next';
const nextConfig: NextConfig = {
async rewrites() {
return {
// beforeFiles roda ANTES do roteamento de arquivos e metadata,
// entao /sitemap.xml passa a servir o handler sem redirect.
beforeFiles: [
{ source: '/sitemap.xml', destination: '/sitemap-index.xml' },
],
afterFiles: [],
fallback: [],
};
},
};
export default nextConfig;
// Verificacao obrigatoria depois do deploy, porque build verde nao prova nada:
// curl -sI https://radar.exemplo.com.br/sitemap.xml | head -1
// -> tem que ser 200, nunca 308 nem 404
// curl -s https://radar.exemplo.com.br/sitemap.xml | grep -c '<sitemap>'
// -> tem que bater com o numero de buckets de generateSitemapsQual dos dois caminhos usar. O caminho A, handler em rota alternativa mais rewrite beforeFiles, mantém o índice como código explícito que você lê e testa, e preserva /sitemap.xml como URL canônica com resposta 200. Use quando o índice precisar de lógica própria, como lastmod agregado por bucket ou seções curadas convivendo com as geradas.
O caminho B, oferecido pela documentação, é aninhar sitemap.ts em segmentos de rota, gerando /produtos/sitemap.xml, /precos/sitemap.xml e assim por diante, e declarar cada um no robots.txt. Use quando as seções forem poucas, estáveis e naturalmente separadas por rota, porque nesse caso você troca código próprio por convenção do framework.
O critério é este: o caminho A custa código e ganha controle; o caminho B custa flexibilidade e ganha ausência de código. Evite escolher o A por hábito quando o seu catálogo tem três seções fixas.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Agora o lastmod, e comece pelo mecanismo antes da regra, porque a regra sozinha soa arbitrária.
O motor não tem como saber se uma página mudou sem buscá-la. Buscar tudo o tempo todo é caro para os dois lados, então ele precisa de alguma pista para decidir a frequência de revisita. O lastmod é essa pista. Gary Illyes, do Google, declarou publicamente que "the lastmod element in sitemaps is a signal that can help crawlers figure out how often to crawl your pages".
A formulação operacional mais clara veio do Bing, e vale como mecanismo geral independentemente de qual motor você tem em mente: o lastmod deve refletir a data real da última modificação do conteúdo da página, não o momento de geração do arquivo de sitemap, em ISO 8601 com timestamp, como registrou o blog do Bing Webmaster em 31 de julho de 2025.
Entenda o que acontece do lado de lá quando a regra é violada. Se todas as páginas declaram a mesma data, o campo deixa de conter informação: ele não separa mais o que mudou do que não mudou. Um sinal que não discrimina nada é um sinal que não serve para decidir nada, e passa a ser descontado.
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
// src/lib/radar/inventario.ts
// O carimbo de lastmod nasce no MODELO DE DADOS, não no gerador de sitemap.
import { z } from 'zod';

export const RegistroPrecoSchema = z.object({
  uf: z.string().length(2),
  slugMunicipio: z.string().regex(/^[a-z0-9-]+$/),
  combustivel: z.enum(['gasolina-comum', 'etanol', 'diesel-s10', 'glp']),
  precoMedio: z.number().positive(),
  numeroDePostos: z.number().int().nonnegative(),

  // Fim da semana de coleta da ANP a que este preco se refere.
  // Esta e a unica fonte legitima de lastmod para esta pagina.
  semanaReferenciaFim: z.coerce.date(),

  // Momento em que o pipeline rodou. NAO e lastmod: o pipeline roda
  // toda semana inteiro, inclusive sobre municipios sem coleta nova.
  ingeridoEm: z.coerce.date(),
});

export type RegistroPreco = z.infer<typeof RegistroPrecoSchema>;

// O mesmo carregamento validado alimenta generateStaticParams, a decisão
// de indexação seletiva e o sitemap. Uma fonte, três consumidores,
// zero divergência possível entre rota que existe e URL anunciada.
export async function carregarInventarioValidado(): Promise<RegistroPreco[]> {
  const bruto = await lerSerieAnp();
  return bruto.map((linha, i) => {
    const r = RegistroPrecoSchema.safeParse(linha);
    if (!r.success) {
      throw new Error('Registro invalido na linha ' + i + ': ' + r.error.message);
    }
    return r.data;
  });
}
O erro mais comum de gerador programático, com todas as letras: o gerador escreve lastmod igual ao momento do build. Como o build roda a cada deploy, toda página do catálogo passa a declarar que foi modificada hoje, inclusive as milhares que não mudaram nada. Você publica uma correção de CSS numa sexta e anuncia 5.570 páginas modificadas.
No Radar isso é fácil de enxergar porque cada município tem uma semana de referência própria, e município sem coleta nova simplesmente não mudou. Em projetos onde a granularidade de mudança é menos óbvia, a mesma regra continua valendo: se você não consegue apontar o campo do modelo de dados de onde o carimbo saiu, o carimbo está errado. new Date() dentro do gerador é sempre a resposta errada.
Falta corrigir uma expectativa que costuma vir junto, e é melhor corrigir de frente porque material antigo ensina o contrário: o Google não participa do IndexNow, e a lista de participantes consultada em 26/09/2026 confirma isso. IndexNow é um aviso que o site manda aos buscadores dizendo "esta página mudou", como um recado ao carteiro. Para o Google, o caminho continua sendo sitemap, descoberta por links e Search Console.
Duas afirmações que circulam e que são falsas, ambas com a mesma consequência prática de fazer o aluno acreditar que empurrou páginas para o Google:
- A Indexing API do Google permanece restrita a
JobPostingeBroadcastEventcomVideoObject. Usá-la para conteúdo genérico não é caminho aceito. - A URL Inspection API é somente leitura. Ela retorna o estado de indexação de uma URL e não submete nada.
Participam do IndexNow Bing, Yandex, Naver, Seznam, Yep e Amazon, com até 10.000 URLs por envio. É uma ferramenta real, para um conjunto real de motores, e vale usar. Só não é a que muita gente pensa que é.
O valor do IndexNow em 2026 mudou de natureza, e vale entender por quê. O Bing declara que sinais de frescor influenciam diretamente a velocidade com que atualizações aparecem em resultados e em respostas geradas por IA. Isso coloca a submissão rápida dentro do conjunto de grounding, não apenas dentro do índice de links azuis: uma atualização de preço que chega antes é uma atualização que pode ser usada como base de uma resposta gerada antes. Limites declarados pelo Bing, os mesmos que valem para o desenho do seu particionamento: 50.000 URLs por arquivo de sitemap e 50.000 arquivos filhos por index file, com busca imediata após a submissão e revisita ao menos diária. Em 10/02/2026, ao lançar o painel AI Performance em prévia pública, a Microsoft voltou a ligar o IndexNow à atualização das respostas do Copilot e do Bing.
// Trecho de um gerador real, com o defeito que este modulo ataca.
// Leia e identifique o que precisa mudar antes de seguir.
export default async function sitemap(props: {
  id: Promise<string>;
}): Promise<MetadataRoute.Sitemap> {
  const id = Number(await props.id);
  const registros = await carregarInventarioValidado();
  const fatia = registros.slice(id * 50000, id * 50000 + 50000);

  const agora = new Date(Date.now());

  return fatia.map((r) => ({
    url: DOMINIO + '/preco/' + r.combustivel + '/' + r.uf + '/' + r.slugMunicipio,
    lastModified: agora,
    changeFrequency: 'daily' as const,
    priority: 0.8,
  }));
}Aplique o capítulo ao gerador do seu acervo com cinco perguntas. (1) No trecho acima, qual campo do modelo de dados deve virar lastModified, e por que changeFrequency: 'daily' contradiz um dado semanal? (2) Se oito buckets servem conteúdo idêntico no Next 16, qual é a causa provável e por que o build não acusou nada? (3) Se /sitemap.xml responde 404 e o route handler quebra o build, qual das duas saídas serve ao seu catálogo? (4) Uma página marcada noindex em [Gerar tudo e publicar só o que tem dado](#indexacao-seletiva-em-render) pode ir ao sitemap? (5) Por que o sitemap deve consumir a mesma função validada de [Bloquear a publicação de registro inválido](#validacao-como-gate-de-build)?
Etapa do Radar neste módulo.
Estado inicial: o catálogo de rotas existe e [Gerar tudo e publicar só o que tem dado](#indexacao-seletiva-em-render) já decidiu, por página, quem é index e quem é noindex.
Estado final: sitemap index no ar, particionado, alimentado pela mesma fonte validada que gera as rotas, com lastmod refletindo a semana de referência do dado de cada município.
O que fazer
- Escolha o eixo de partição. Por UF é o corte natural do Radar, porque agrupa municípios que mudam junto na mesma coleta e mantém cada arquivo bem abaixo do limite. Por bucket de tamanho é a alternativa quando a distribuição é muito desigual.
- Implemente
generateSitemapsesitemapcom a assinatura da v16, filtrando o inventário pordecisao === 'index'antes de fatiar. - Escreva o handler do índice e o rewrite
beforeFiles, ou aninhesitemap.tspor segmento, conforme o critério que você mesmo justificou acima. - Derive
lastModifieddesemanaReferenciaFim, nunca do build.
Como conferir que chegou lá, e faça as quatro conferências, porque cada uma pega uma falha diferente
curl -sI .../sitemap.xmlretorna 200, não 308 nem 404.- A contagem de
<sitemap>no índice bate com o número de buckets devolvido porgenerateSitemaps. - Dois buckets quaisquer abertos lado a lado têm conteúdo diferente.
- Um município que não teve coleta nova na última semana mantém no sitemap a mesma data de
lastmoddo deploy anterior.
O guia abaixo é para quem contrata ou fiscaliza a equipe que implanta. Ele transforma as quatro conferências do Radar em entregas que um executivo cobra sem abrir o código, e destrava a decisão de aceitar ou devolver o sitemap de um acervo que acabou de ir ao ar.
Guia de implementação: receber um sitemap de acervo sem surpresa
Cinco entregas conferidas no navegador ou no Search Console, sem ferramenta paga.
Passo 1: Peça o eixo de partição por escrito
Por estado, por categoria ou por tamanho de lote, com o motivo da escolha.
Deu certo quando: Cada arquivo fica bem abaixo de 50.000 endereços e o eixo agrupa páginas que mudam juntas.
Erro comum: Um arquivo único que atravessa o limite quando o catálogo cresce por multiplicação.
Passo 2: Exija que /sitemap.xml responda 200
O endereço convencional precisa servir o índice, sem redirecionamento nem erro 404.
Deu certo quando: O índice abre no navegador e lista tantos arquivos quantos o gerador produziu.
Erro comum: Robots.txt apontando para um arquivo que não existe, com o build verde.
Passo 3: Compare dois arquivos lado a lado
Abra dois pedaços diferentes do sitemap e confira se trazem endereços diferentes.
Deu certo quando: Nenhum endereço aparece repetido entre dois pedaços.
Erro comum: Todos os pedaços servindo a mesma lista, o incidente de maio de 2026 deste repositório.
Passo 4: Audite a data de atualização
A data de cada página sai do dado, como a semana de coleta da ANP, e nunca do build.
Deu certo quando: Uma página sem coleta nova mantém a mesma data depois de um novo deploy.
Erro comum: Todas as páginas declarando a data de hoje, sinal que o buscador passa a descontar.
Passo 5: Separe Google de Bing no plano de indexação
IndexNow avisa Bing, Yandex, Naver, Seznam, Yep e Amazon; o Google lê sitemap e links.
Deu certo quando: O plano cita o Search Console para o Google e o IndexNow para os demais.
Erro comum: Fornecedor prometendo indexação acelerada no Google por IndexNow ou Indexing API.
No fim você tem: Um sitemap que anuncia só páginas indexáveis, com datas verdadeiras e envio certo para cada buscador.
Quem faz, quanto custa, como conferir
| Etapa | Quem faz | Prazo e esforço | Como conferir |
|---|---|---|---|
| Eixo de partição | Desenvolvedor com o analista de SEO | 2 horas; sem custo de licença | Documento de uma página com eixo e motivo |
| Índice em /sitemap.xml | Desenvolvedor | 4 a 8 horas | Resposta 200 no navegador e contagem de arquivos igual à do gerador |
| Comparação de pedaços | Analista de SEO | 30 minutos por deploy | Nenhum endereço repetido entre dois pedaços |
| Data de atualização | Engenheiro de dados | 2 a 4 horas | Página sem coleta nova mantém a data anterior |
| Plano por buscador | Analista de SEO | 2 horas; Search Console e Bing Webmaster Tools sem custo | Envio do sitemap aceito nos dois painéis |
Guia prático: anunciar o acervo nas telas oficiais. O guia acima diz o que cobrar do time técnico. Este mostra onde clicar depois que o índice de sitemaps está no ar, em dois painéis: o relatório de sitemaps do Search Console, para o Google, e o protocolo IndexNow, para Bing, Yandex, Naver, Seznam, Yep e Amazon.
Os limites que a ajuda do Search Console cita em 01/10/2026
- até 50 mil URLs e 50 MB, descompactado, por arquivo de sitemap;
- até 50 mil sitemaps filhos num mesmo índice;
- ao enviar um índice, o painel soma as URLs de todos os filhos e conta cada URL repetida uma vez só.
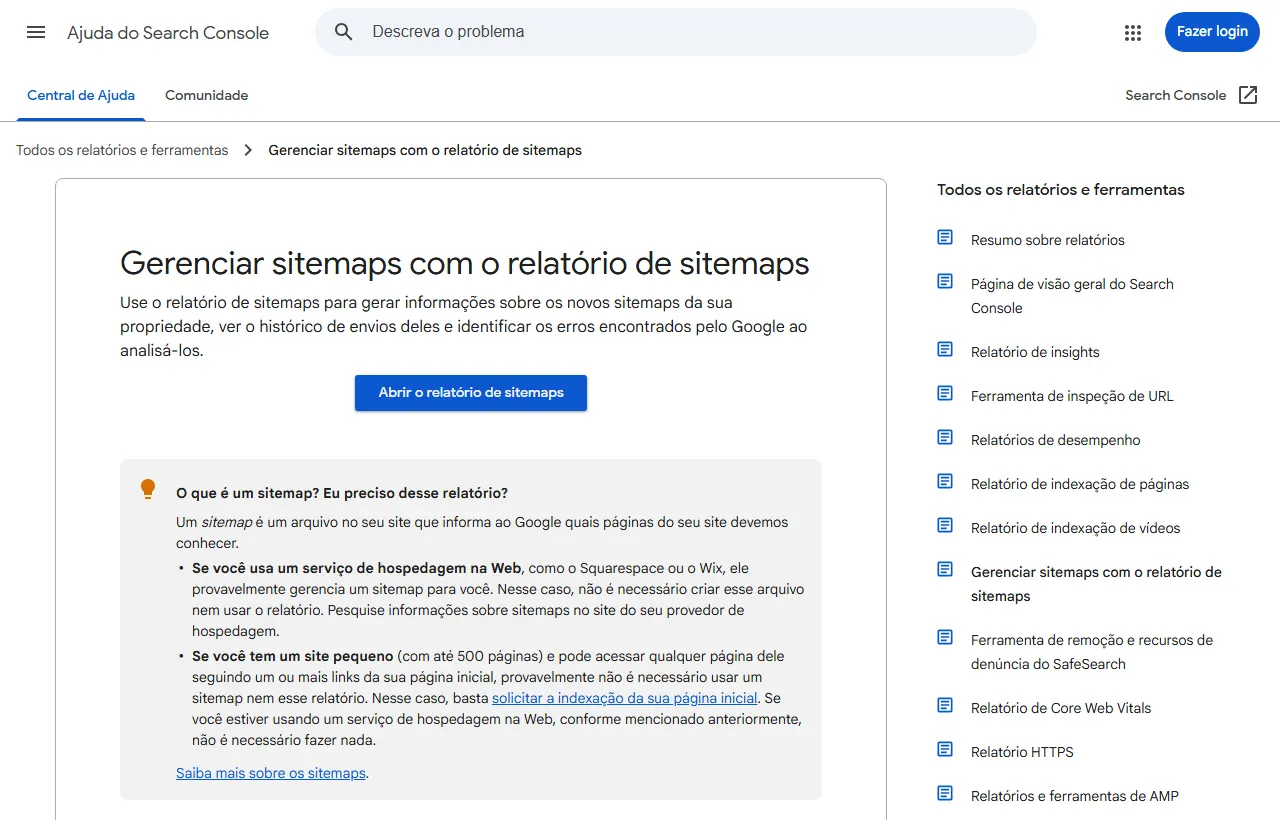
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Enviar o índice de sitemaps e acompanhar cada pedaço no Search Console
Seis passos, feitos por quem tem permissão de proprietário na propriedade. Reserve 20 minutos no dia do lançamento e 10 minutos uma semana depois.
Passo 1: Inspecione o endereço do índice antes de enviá-lo
Cole a URL de /sitemap.xml na barra de inspeção do topo do Search Console e rode o teste do URL publicado.
Deu certo quando: O teste mostra que o Google consegue buscar o arquivo, sem bloqueio no robots.txt.
Erro comum: Enviar um índice que responde 200 no navegador do desenvolvedor, mas fica atrás de autenticação de prévia.
Passo 2: Abra Sitemaps e cole o índice em Adicionar um novo sitemap
Envie só o índice. Os filhos aparecem sozinhos na lista depois do processamento.
Deu certo quando: O índice entra na tabela de sitemaps enviados com a data de hoje.
Erro comum: Enviar cada pedaço à mão e, no mês seguinte, esquecer o pedaço novo que o gerador criou.
Passo 3: Leia o status de cada linha
Processado quer dizer lido sem erro. Contém erros quer dizer lido com problema. Não foi possível buscar o sitemap quer dizer que o arquivo nem chegou.
Deu certo quando: Índice e filhos aparecem como Processado, e a soma de URLs descobertos bate com a contagem do gerador.
Erro comum: Ler Processado como indexado. O status diz que o arquivo foi lido, não que as páginas entraram no índice.
Passo 4: Abra um filho e filtre o relatório de indexação por ele
Cada pedaço vira um filtro no relatório de indexação de páginas. É assim que se lê o estado de um grupo de páginas, como um estado ou uma categoria.
Deu certo quando: Você sabe quantas páginas de cada pedaço estão indexadas, e não só o total do site.
Erro comum: Particionar por data de publicação e perder a leitura por grupo de template.
Passo 5: Repita a leitura sete dias depois
Anote, por pedaço, URLs descobertos e páginas indexadas, numa planilha com data.
Deu certo quando: A planilha mostra a curva de cada grupo, e um grupo parado se destaca dos outros.
Erro comum: Olhar só o gráfico agregado, que esconde um grupo inteiro sem indexação.
Passo 6: Para tirar um grupo, mude o sitemap e a página, não só o painel
Excluir um sitemap do relatório não faz o Google esquecer o arquivo nem as URLs listadas nele, segundo a própria ajuda.
Deu certo quando: As páginas retiradas saem do sitemap e passam a responder com noindex ou 404.
Erro comum: Apagar o sitemap no painel e esperar que as páginas sumam da busca.
No fim você tem: Um índice enviado uma vez, filhos lidos sem erro e uma planilha semanal com a indexação de cada grupo de páginas.
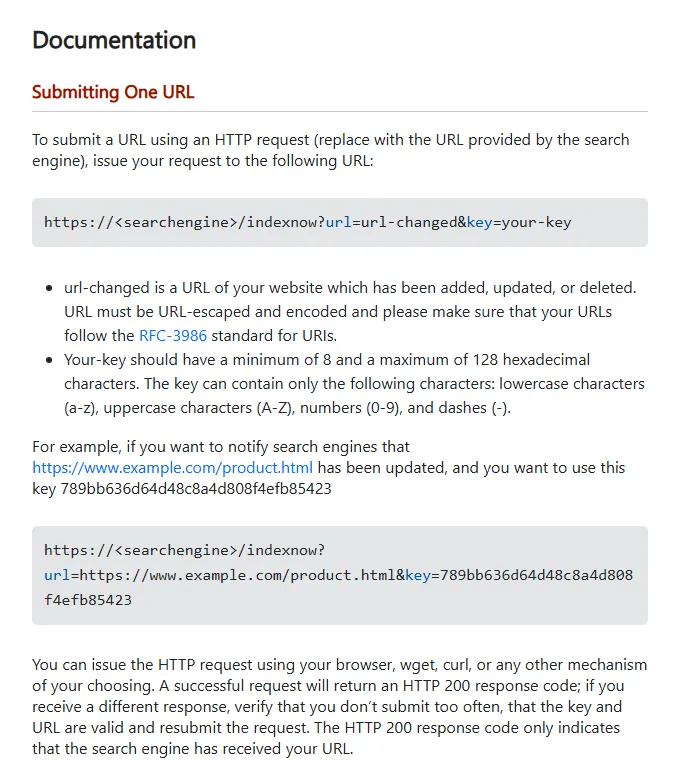
Se a figura ultrapassar a área visível, deslize para os lados. Pelo teclado, foque a figura e use as setas.
Ligar o IndexNow para os buscadores que participam do protocolo
Cinco passos para o desenvolvedor, com conferência do analista de SEO. O Google segue de fora do protocolo; para ele vale o guia anterior.
Passo 1: Gere uma chave e publique o arquivo de texto na raiz
A chave tem de 8 a 128 caracteres: letras, números e hífen. O arquivo com a chave fica em /<chave>.txt.
Deu certo quando: O endereço do arquivo abre no navegador e mostra só a chave.
Erro comum: Publicar a chave dentro de uma pasta, como /catalogo/. Uma chave nessa pasta só vale para as URLs abaixo dela.
Passo 2: Envie em lote, por POST, só o que mudou de dado
O corpo leva host, key e urlList, com até 10 mil URLs por envio. A lista sai do mesmo campo que alimenta o lastmod.
Deu certo quando: Cada lote enviado corresponde a páginas cuja data de atualização mudou nesta rodada.
Erro comum: Reenviar o acervo inteiro a cada deploy, o que gera o código 429 e tira o sinal de valor.
Passo 3: Leia o código de resposta e registre
A tabela abaixo traduz os seis códigos da documentação para a ação do time.
Deu certo quando: O registro de cada envio tem data, tamanho do lote e código recebido.
Erro comum: Tratar 200 como página indexada. A documentação diz que 200 só confirma o recebimento.
Passo 4: Confira o envio no Bing Webmaster Tools
Com o site verificado no painel do Bing, a área de IndexNow mostra as URLs recebidas pelo protocolo.
Deu certo quando: As URLs do último lote aparecem como recebidas no painel do Bing.
Erro comum: Enviar para um buscador participante e procurar o resultado no Search Console.
Passo 5: Cruze com o painel de IA do Bing depois de 30 dias
O capítulo "Medir o acervo dentro das respostas de IA" mostra como ler citações por grupo de páginas.
Deu certo quando: O grupo atualizado com frequência aparece com citações no painel de IA do Bing.
Erro comum: Atribuir ao IndexNow uma mudança de posição que veio de outro fator.
No fim você tem: Um aviso automático e enxuto para os buscadores do IndexNow, disparado só quando o dado da página muda.
// indexnow-lote.mjs  (Node 22+, sem dependência externa)
// uso: node indexnow-lote.mjs alteradas.txt
// alteradas.txt: uma URL por linha, só as páginas cujo lastmod mudou nesta rodada
import { readFileSync } from 'node:fs';

const HOST = 'www.exemplo.com.br';
const KEY = process.env.INDEXNOW_KEY; // a mesma chave publicada em /<chave>.txt
const LOTE = 10000; // teto por envio, segundo a documentação

const urls = readFileSync(process.argv[2], 'utf8')
  .split('\n')
  .map((l) => l.trim())
  .filter((l) => l.startsWith('https://' + HOST + '/'));

for (let i = 0; i < urls.length; i += LOTE) {
  const urlList = urls.slice(i, i + LOTE);
  const resp = await fetch('https://api.indexnow.org/indexnow', {
    method: 'POST',
    headers: { 'content-type': 'application/json; charset=utf-8' },
    body: JSON.stringify({ host: HOST, key: KEY, urlList }),
  });
  // 200 e 202: recebido. 403: chave não confere. 422: URL fora do host. 429: envio demais.
  console.log(new Date().toISOString(), 'lote', i / LOTE + 1, urlList.length, 'URLs, HTTP', resp.status);
  if (resp.status === 429) break; // pare e reveja o critério do que mudou
}
Os códigos de resposta do IndexNow e o que fazer com cada um
| Código | Significado na documentação | Ação do time |
|---|---|---|
| 200 | URL recebida | Registrar o lote; não é prova de indexação |
| 202 | URL recebida, validação da chave pendente | Conferir se o arquivo da chave responde na raiz |
| 400 | Formato inválido | Revisar o JSON e a codificação das URLs |
| 403 | Chave não validada | Comparar a chave do envio com o arquivo publicado |
| 422 | URLs não pertencem ao host ou ao esquema da chave | Filtrar URLs de outro domínio ou de outra pasta |
| 429 | Requisições demais, tratadas como spam | Parar e reduzir o envio ao que mudou de dado |
Fonte: IndexNow.org, Documentation, consulta em 01/10/2026.
Cobre do time técnico as cinco entregas na semana do lançamento. Confira no Search Console, em até 14 dias, se o sitemap enviado aparece com status de sucesso e se o número de páginas descobertas bate com a soma dos pedaços, com diferença inferior a 5%.
Perguntas frequentes deste capítulo
Meu catálogo tem 6.000 URLs, bem abaixo de 50.000. Preciso mesmo de particionamento e de índice?
Uma página marcada como noindex pelo gate de indexação seletiva pode ficar no sitemap?
Se eu não sei a data real de modificação de algumas páginas, é melhor omitir o lastmod ou colocar a data do build?
Preciso preencher changeFrequency e priority?
Enviei o sitemap pelo IndexNow. Isso acelera a indexação no Google?
Seu caderno neste capítulo
Abrir o caderno completoSelecione um trecho do capítulo para destacar ou anotar. Nos vídeos e áudios, use Anotar este momento. No teclado, selecione com Shift e as setas e use Alt+Shift+D para destacar ou Alt+Shift+N para anotar.
Salvo neste navegador. Entre na sua conta para levar o caderno a outros aparelhos.
Entre na sua conta para compartilhar o que aprendeu e convidar alguém para estudar com você.
Conexões deste capítulo
Explore os conceitos e compare abordagens em outros cursos. As conexões indicam assuntos relacionados; a sequência de estudo continua no índice do curso.
Conceitos deste capítulo
O mesmo assunto em outros cursos
- Vibecoding para SEOOrquestrando Tudo: Seu Toolkit SEO CompletoExaminar conexões de Orquestrando Tudo: Seu Toolkit SEO Completo
- Autoridade Temática e SEO de EntidadesComo parar de competir com o seu próprio siteExaminar conexões de Como parar de competir com o seu próprio site
- Search Console para decisãoConfirme que a página existe no índice antes de discutir posiçãoExaminar conexões de Confirme que a página existe no índice antes de discutir posição
- GEO Universal FrameworkRode o ciclo mensal e reporte em cinco linhasExaminar conexões de Rode o ciclo mensal e reporte em cinco linhas